leetcode-hot-100 (动态规划)
1、爬楼梯
题目链接:爬楼梯
题目描述:假设你正在爬楼梯。需要 n 阶你才能到达楼顶。
每次你可以爬 1 或 2 个台阶。你有多少种不同的方法可以爬到楼顶呢?
解答
方法一:原始动态规划
每到一个楼梯(记为
n
n
n),则能到这个位置的只能是
n
−
1
n-1
n−1 的位置走一步和
n
−
2
n-2
n−2 的位置走两步到达,因此可以建立一个关系
d
p
[
n
]
=
d
p
[
n
−
1
]
+
d
p
[
n
−
2
]
dp[n] = dp[n-1] + dp[n-2]
dp[n]=dp[n−1]+dp[n−2]。然后注意一下边界情况。
代码就比较的简单了:
class Solution {
public:
    int climbStairs(int n) {
        vector<int> dp(n + 1, 0);
        dp[1] = 1;
        dp[0] = 1;
        for (int i = 2; i <= n; i++)
            dp[i] = dp[i - 1] + dp[i - 2];
        return dp[n];
    }
};
方法二:滚动数组优化
可以发现,上述存储的是从 0 0 0 到 n n n 的所有情况,实际上不需要存储这么多,只需要保证最后能走到 n n n 阶的方法总数即可。于是可以使用滚动数组进行优化。
class Solution {
public:
    int climbStairs(int n) {
        // even 表示来到了偶数阶梯的方法数,初始是从 0 阶梯开始的
        int even = 1;
        // odd 表示来到了奇数阶梯的方法数
        int odd = 1;
        for (int i = 2; i <= n; i++) {
            if (i % 2 == 0)
                even = even + odd;
            else
                odd = odd + even;
        }
        // 之后返回的肯定是两者的最大值
        return max(odd, even);
    }
};
方法三:使用通项公式
实际上上述这个斐波拉切是一个数列,只要是数列的话,肯定是有一个数学公式的,因此只要知道其通项公式的话,这样编码解决这道题目也是可以的。
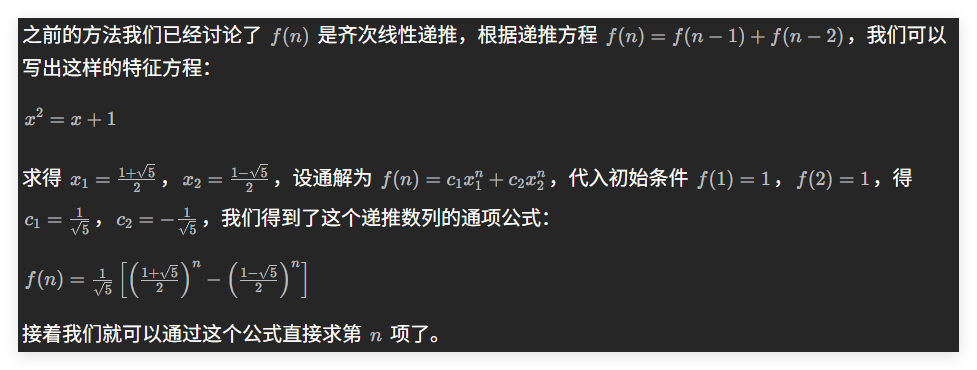
或者利用高中的思想有如下的解法:

public
class Solution {
public
    int climbStairs(int n) {
        double sqrt5 = Math.sqrt(5);
        double fibn =
            Math.pow((1 + sqrt5) / 2, n + 1) - Math.pow((1 - sqrt5) / 2, n + 1);
        return (int)Math.round(fibn / sqrt5);
    }
}
方法四:快速矩阵幂
还有一种,利用到了矩阵的相关知识,这里不详细赘述,想要了解的话,看官解:官方解答
2、杨辉三角
题目链接:杨辉三角
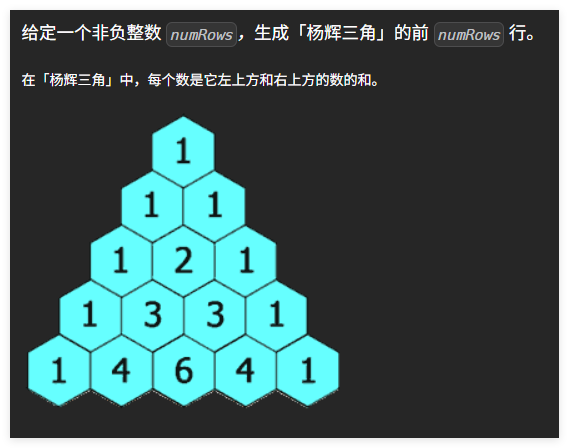
题目描述:
解答
方法一:数学知识
利用杨辉三角的数学知识,可以直接破题,数学性质比较好想,主要是编码需要注意的地方比较多。
- 1、如何构建一个行数为 n u m R o w s numRows numRows 的数组 : C++ 中直接就是 vector<vector> ret(numRows);
- 2、如何为每一行创建对应的列数 : 上个循环,然后直接 ret.resize( i + 1 )即可
- 3、每一行中第一个位置和最后一个位置的值是固定的,如何处理? 直接赋值即可。
有了上述的编码 t r i c k trick trick 后,于是可以写出代码如下:
class Solution {
public:
    vector<vector<int>> generate(int numRows) {
        vector<vector<int>> ret(numRows);
        for (int i = 0; i < numRows; i++) {
            // 把 ret[i] 这个 vector 的大小(元素个数)设置为 i + 1
            ret[i].resize(i + 1);
            // 每行第一个元素和最后一个元素赋值为 1
            ret[i][0] = ret[i][i] = 1;
            // 杨辉三角的数学性质
            for (int j = 1; j < i; j++)
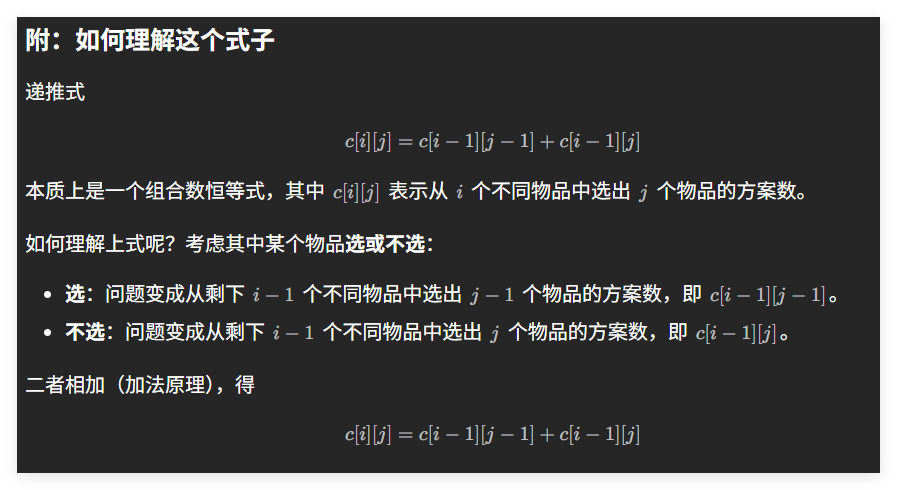
                ret[i][j] = ret[i - 1][j] + ret[i - 1][j - 1];
        }
        return ret;
    }
};
3、打家劫舍
题目链接:打家劫舍
题目描述:
你是一个专业的小偷,计划偷窃沿街的房屋。每间房内都藏有一定的现金,影响你偷窃的唯一制约因素就是相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警。
给定一个代表每个房屋存放金额的非负整数数组,计算你 不触动警报装置的情况下 ,一夜之内能够偷窃到的最高金额。
解答
方法一:动态规划
很显然,这道题目可以使用动态规划进行求解:
class Solution {
public:
    int rob(vector<int>& nums) {
        int len = nums.size();
        if (len == 0)
            return 0;
        if (len == 1)
            return nums[0];
        vector<int> dp(nums);
        dp[0] = nums[0];
        dp[1] = max(nums[0], nums[1]);
        for (int i = 2; i < len; i++) {
            dp[i] = max(dp[i - 2] + nums[i], dp[i - 1]);
        }
        return dp[len - 1];
    }
};
方法二:滚动数组优化
实际上,方法一的原始动态规划的话,前面的状态是不需要保存的,只需要当前位置前面的一个位置和前面的两个位置的值即可,因此可以使用滚动数组对上述方法进行空间上的优化。
class Solution {
public:
    int rob(vector<int>& nums) {
        int len = nums.size();
        if (len == 0)
            return 0;
        if (len == 1)
            return nums[0];
        nums[1] = max(nums[0], nums[1]);
        int first = nums[0], second = nums[1];
        for (int i = 2; i < len; i++) {
            int temp = max(first + nums[i], second);
            first = second;
            second = temp;
        }
        return second;
    }
};
这个 解答 写的不错哦。详细讲述了如何找出子问题和优化子结构的步骤。
4、完全平方数
题目链接:完全平方数
题目描述:给你一个整数 n ,返回 和为 n 的完全平方数的最少数量 。
完全平方数 是一个整数,其值等于另一个整数的平方;换句话说,其值等于一个整数自乘的积。例如,1、4、9 和 16 都是完全平方数,而 3 和 11 不是。
解答
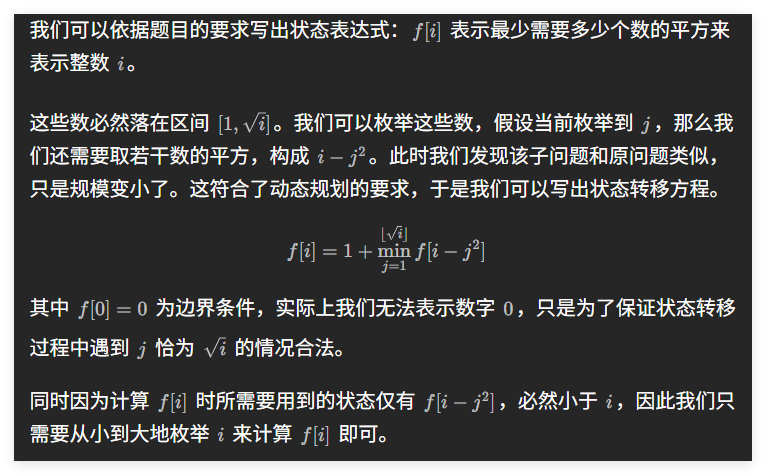
方法一:动态规划
class Solution {
public:
    int numSquares(int n) {
        // f[i] 表示:将数字 i 拆分成若干个完全平方数之和,所需的最少平方数个数
        // 例如:f[12] = 3,因为 12 = 4 + 4 + 4(3 个 4),是最少的
        vector<int> f(n + 1); // 创建大小为 n+1 的数组,初始化为 0

        // 从 1 开始遍历到 n,逐步计算每个 f[i]
        for (int i = 1; i <= n; i++) {
            // 初始化当前 f[i] 的最小值为一个极大值
            int minn = INT_MAX;

            // 枚举所有小于等于 i 的完全平方数
            // j 从 1 开始,j*j 就是完全平方数(1, 4, 9, 16...)
            for (int j = 1; j * j <= i; j++) {
                // 如果我们选择 j*j 作为一个平方数,
                // 那么剩下的部分就是 i - j*j
                // f[i - j*j] 是组成剩余部分所需的最少平方数个数
                // 所以总个数是 f[i - j*j] + 1(+1 是因为用了 j*j 这个数)
                minn = min(minn, f[i - j * j]);
            }

            // f[i] 就是所有可能中最小的那个值 + 1
            f[i] = minn + 1;
        }

        // 返回组成 n 所需的最少完全平方数个数
        return f[n];
    }
};
方法二:数学性质破题
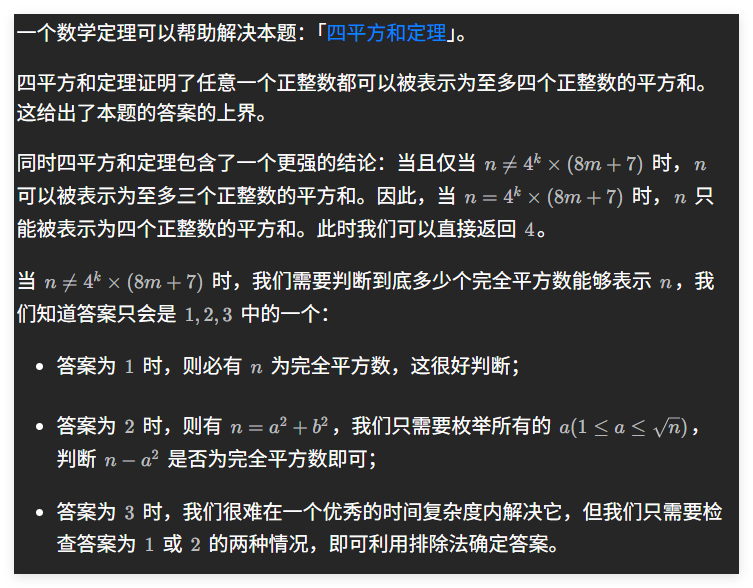
有一个定义叫 四平方和定理,其证明了任意一个正整数都可以被表示为至多四个正整数的平方和。这给出了本题的答案的上界。
class Solution {
public:
    // 辅助函数:判断 x 是否是一个完全平方数
    bool isPerfectSquare(int x) {
        int y = sqrt(x);              // 取 x 的平方根并向下取整
        return y * y == x;            // 如果 y² 正好等于 x,说明 x 是完全平方数
    }

    // 判断是否属于形如 4^a*(8b + 7) 的数(根据勒让德定理,这类数必须用 4 个平方数表示)
    bool checkAnswer4(int x) {
        while (x % 4 == 0) {          // 不断除以 4,相当于提取所有的因子 4^a
            x /= 4;
        }
        // 检查剩下的部分是否模 8 等于 7
        // 即:原数能否写成 4^a * (8b + 7)
        return x % 8 == 7;
    }

    // 主函数:返回组成 n 所需的最少完全平方数个数
    int numSquares(int n) {
        // 情况 1:如果 n 本身就是完全平方数,则只需要 1 个
        if (isPerfectSquare(n)) {
            return 1;
        }

        // 情况 2:如果 n 满足 4^a*(8b+7),根据勒让德定理,必须用 4 个平方数
        if (checkAnswer4(n)) {
            return 4;
        }

        // 情况 3:检查是否能由两个完全平方数组成
        // 枚举所有可能的 i²,使得 i² <= n
        for (int i = 1; i * i <= n; i++) {
            int j = n - i * i;        // 剩下的部分
            if (isPerfectSquare(j)) { // 如果剩下的部分也是完全平方数
                return 2;             // 那么 n = i² + j²,只需两个平方数
            }
        }

        // 情况 4:既不是 1、也不是 4、也不是 2,那根据定理只能是 3
        // (因为根据拉格朗日定理,最多只要 4 个;我们已经排除了 1、2、4)
        return 3;
    }
};
5、零钱兑换
题目链接:零钱兑换
题目描述:
给你一个整数数组 coins ,表示不同面额的硬币;以及一个整数 amount ,表示总金额。
计算并返回可以凑成总金额所需的 最少的硬币个数 。如果没有任何一种硬币组合能组成总金额,返回 -1 。
你可以认为每种硬币的数量是无限的。
解答
超时方法:回溯
回溯是一个比较简单但是时间复杂度比较高的方法(这题肯定会超时的),这里主要是为了理解这道题目并且学习一下回溯法的 b a c k t r a c k backtrack backtrack 函数需要如何写。
class Solution {
private:
    int minCoins; // 全局记录最少硬币数量
    // 回溯函数:尝试所有可能的硬币组合
    // coins: 硬币面值数组
    // remain: 当前还剩多少金额需要凑
    // count: 当前已经用了多少个硬币
    void backtrack(const vector<int>& coins, int remain, int count) {
        // 剪枝1:如果剩余金额小于0,说明这条路走不通
        if (remain < 0)
            return;
        // 如果刚好凑齐
        if (remain == 0) {
            // 更新全局最小值
            minCoins = min(minCoins, count);
            return;
        }
        // 剪枝2:如果当前硬币数已经超过已知最优解,无需继续
        if (count >= minCoins)
            return;
        // 尝试每一种硬币
        for (int coin : coins) {
            // 关键优化:我们可以允许重复使用硬币,所以不需要跳过之前的
            // 但由于可能会重复搜索相同路径(如 1+2 和 2+1),效率较低
            // 我们可以通过“只允许不降序选择”来去重(可选优化)

            // 这里我们不做顺序限制,暴力尝试所有硬币(允许乱序)
            // 但为了提高效率,建议配合排序 + 从大到小使用
            backtrack(coins, remain - coin, count + 1);
        }
    }

public:
    int coinChange(vector<int>& coins, int amount) {
        // 特殊情况处理
        if (amount == 0)
            return 0;
        if (amount < 0 || coins.empty())
            return -1;
        // 初始化最小硬币数为一个极大值
        minCoins = INT_MAX;
        // 可选优化:将硬币从大到小排序,有助于更快地接近目标,提前剪枝
        sort(coins.rbegin(), coins.rend());
        // 开始回溯搜索
        backtrack(coins, amount, 0);
        // 如果 minCoins 没被更新,说明无法凑出
        return minCoins == INT_MAX ? -1 : minCoins;
    }
};
方法一:动态规划
一个经典的完全背包类问题,使用 “完全背包” 的动态规划解法:
注释在代码中写的比较的详细,需要注意的点是:这里是先遍历硬币,再遍历金额,这样能避免重复计算或顺序混乱的问题。
class Solution {
public:
    int coinChange(vector<int>& coins, int amount) {
        // 创建 dp 数组,大小为 amount + 1,初始化为 INT_MAX(表示无法到达)
        // dp[i] 表示:凑出金额 i 所需的最少硬币个数
        vector<int> dp(amount + 1, INT_MAX);
        // 初始状态:凑出金额 0 需要 0 个硬币
        dp[0] = 0;
        // 遍历每一种硬币
        for (int coin : coins) {
            // 对于当前硬币 coin,更新所有大于等于 coin 的金额 i
            // 因为我们至少要用一次这个硬币才能影响这些状态
            for (int i = coin; i <= amount; i++) {
                // 如果前一个状态 dp[i - coin] 是可达的(不是 INT_MAX)
                // 我们就可以尝试用它来更新当前状态 dp[i]
                if (dp[i - coin] != INT_MAX) {
                    dp[i] = min(dp[i],           // 当前已知的最小值
                                dp[i - coin] + 1); // 使用一个 'coin' 硬币后的值
                }
            }
        }
        // 最终结果:dp[amount]
        // 如果仍然是 INT_MAX,说明无法凑出该金额,返回 -1
        // 否则返回最少硬币数
        return dp[amount] == INT_MAX ? -1 : dp[amount];
    }
};
方法二:记忆化搜索
回溯之所以超时,是因为重复计算了大量的元素,实际上,可以使用变量将算出来的值存储下来,后续遇到重复的就无需再计算了。这就是记忆化搜索,下面是官方解答:
class Solution {
private:
    vector<int> count;

public:
    int dp(vector<int>& coins, int rem) {
        if (rem < 0)
            return -1;
        if (rem == 0)
            return 0;
        // 记忆化检查
        if (count[rem - 1] != 0)
            return count[rem - 1];
        int Min = INT_MAX;
        // 尝试遍历每一种硬币
        for (int coin : coins) {
            int res = dp(coins, rem - coin);
            if (res >= 0 && res < Min)
                Min = res + 1;
        }
        count[rem - 1] = Min == INT_MAX ? -1 : Min;
        return count[rem - 1];
    }
    int coinChange(vector<int>& coins, int amount) {
        if (amount < 1)
            return 0;
        count.resize(amount);
        return dp(coins, amount);
    }
};
有的时候,子问题的结果会返回 0 ,这样上述若某个子问题返回 0 ,可能会被认为是 “未计算” 。 (虽然这道题目不会出现这种情况)。但是为了有一种良好的编码习惯,增加代码的可读性和可移植性,可以使用特殊值(如 -2)表示“未计算”,更清晰。
class Solution {
public:
    int dp(vector<int>& coins, int rem, vector<int>& memo) {
        if (rem < 0)
            return -1;
        if (rem == 0)
            return 0;
        if (memo[rem] != -2)
            return memo[rem]; // -2 表示未计算

        int Min = INT_MAX;
        for (int coin : coins) {
            int res = dp(coins, rem - coin, memo);
            if (res >= 0 && res < Min)
                Min = res + 1;
        }

        memo[rem] = (Min == INT_MAX) ? -1 : Min;
        return memo[rem];
    }

    int coinChange(vector<int>& coins, int amount) {
        vector<int> memo(amount + 1, -2); // memo[0..amount]
        return dp(coins, amount, memo);
    }
};
6、单词拆分
题目链接:单词拆分
题目描述:给你一个字符串 s 和一个字符串列表 wordDict 作为字典。如果可以利用字典中出现的一个或多个单词拼接出 s 则返回 true。
注意:不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
解答
依旧还是使用动态规划进行求解,这里的子问题可以如下理解:
dp[i]表示 从0到i - 1能否被字符串列表中的字符串表示。- dp[s.size()] 表示最终需要求解的问题。
- if
dp[i] =trueands.substr( i , j - i )出现在了字符串列表中,then dp[j] = true
以上就是我对这道题目的理解,那么实际上对于s.substr( i , j - i ) 是否出现在了字符串列表中,C++ 中提供了一个 STL 叫 unordered_set 。 这样每次查找的话,直接在这个 unordered_set 里面查找即可。
class Solution
{
public:
    bool wordBreak(string s, vector<string> &wordDict)
    {
        auto wordDictSet = unordered_set<string>();
        // 存在 hash 表中
        for (auto word : wordDict)
            wordDictSet.insert(word);

        auto dp = vector<bool>(s.size() + 1);
        dp[0] = true;
        for (int i = 1; i <= s.size(); i++)
        {
            for (int j = 0; j < i; j++)
            {
                if (dp[j] && wordDictSet.find(s.substr(j, i - j)) != wordDictSet.end())
                {
                    dp[i] = true;
                    break;
                }
            }
        }
        return dp[s.size()];
    }
};
下面的代码带有详细的注释:
class Solution {
public:
    /**
     * 判断字符串 s 是否可以被拆分成一个或多个在 wordDict 中出现的单词。
     * 使用动态规划(自底向上)的方法解决。
     *
     * @param s: 待拆分的字符串
     * @param wordDict: 单词字典(允许重复使用单词)
     * @return: 如果可以完全拆分,返回 true;否则返回 false
     */
    bool wordBreak(string s, vector<string>& wordDict) {
        // dp[i] 表示:字符串 s 的前 i 个字符(即 s[0:i))是否可以被成功拆分成字典中的单词
        // 例如:dp[3] = true 表示 s 的前 3 个字符(s[0..2])可以被拆分
        vector<bool> dp(s.size() + 1, false);

        // 初始状态:空字符串可以被“合法”拆分(作为递推的起点)
        dp[0] = true;

        // 外层循环:遍历字符串的每一个起始位置 i
        // i 表示当前检查的起始下标(从 0 开始)
        for (int i = 0; i < s.size(); i++) {
            // 如果 dp[i] 为 false,说明前 i 个字符无法被拆分
            // 那么就不能从位置 i 开始尝试匹配任何单词,直接跳过
            if (!dp[i])
                continue;

            // 如果 dp[i] 为 true,说明可以从位置 i 开始尝试匹配字典中的单词
            for (auto& word : wordDict) {  // 遍历字典中的每一个单词
                int wordLen = word.size(); // 当前单词的长度

                // 检查从位置 i 开始,是否有足够的空间容纳这个单词
                // 即:i + wordLen <= s.size(),避免 substr 越界
                if (i + wordLen <= s.size()) {
                    // 从 s 的位置 i 开始,截取长度为 wordLen 的子串
                    // 判断该子串是否与当前字典中的单词相等
                    string substrFromI = s.substr(i, wordLen);
                    if (substrFromI == word) {
                        // 如果匹配成功,说明我们可以用这个单词来扩展拆分
                        // 更新 dp[i + wordLen] 为 true
                        // 表示前 i + wordLen 个字符是可以被成功拆分的
                        dp[i + wordLen] = true;
                        // 注意:这里不需要 break,因为可能有多个单词能匹配
                    }
                }
                // 如果 i + wordLen > s.size(),说明这个单词太长,无法从位置 i 放下,跳过
            }
        }

        // 最终结果:整个字符串是否可以被完全拆分?
        // 即 dp[s.size()] 是否为 true
        return dp[s.size()];
    }
};
7、最长递增子序列
题目链接:最长递增子序列
题目描述:
给你一个整数数组 nums ,找到其中最长严格递增子序列的长度。
子序列 是由数组派生而来的序列,删除(或不删除)数组中的元素而不改变其余元素的顺序。例如,[3,6,2,7] 是数组 [0,3,1,6,2,2,7] 的子序列。
解答
方法一:dp
核心思路是:维护一个 dp 数组,其中 dp[i] 表示以 nums[i] 结尾的最长递增子序列的长度,初始值均为 1。通过两层循环遍历所有数对,对于每一对 i < j,如果 nums[j] > nums[i],则更新 dp[j] = max(dp[j], dp[i] + 1),即尝试将 nums[j] 接在以 nums[i] 结尾的递增子序列后面。同时用 max_num 记录过程中出现的最大长度,最终返回该值。
class Solution
{
public:
    int lengthOfLIS(vector<int> &nums)
    {
        int length = nums.size();
        vector<int> dp(length, 1);
        int max_num = 1;
        for (int i = 0; i < length; i++)
            for (int j = i + 1; j < length; j++)
                if (nums[j] > nums[i])
                {
                    dp[j] = max(dp[j], dp[i] + 1);
                    max_num = max(max_num, dp[j]);
                }
        return max_num;
    }
};
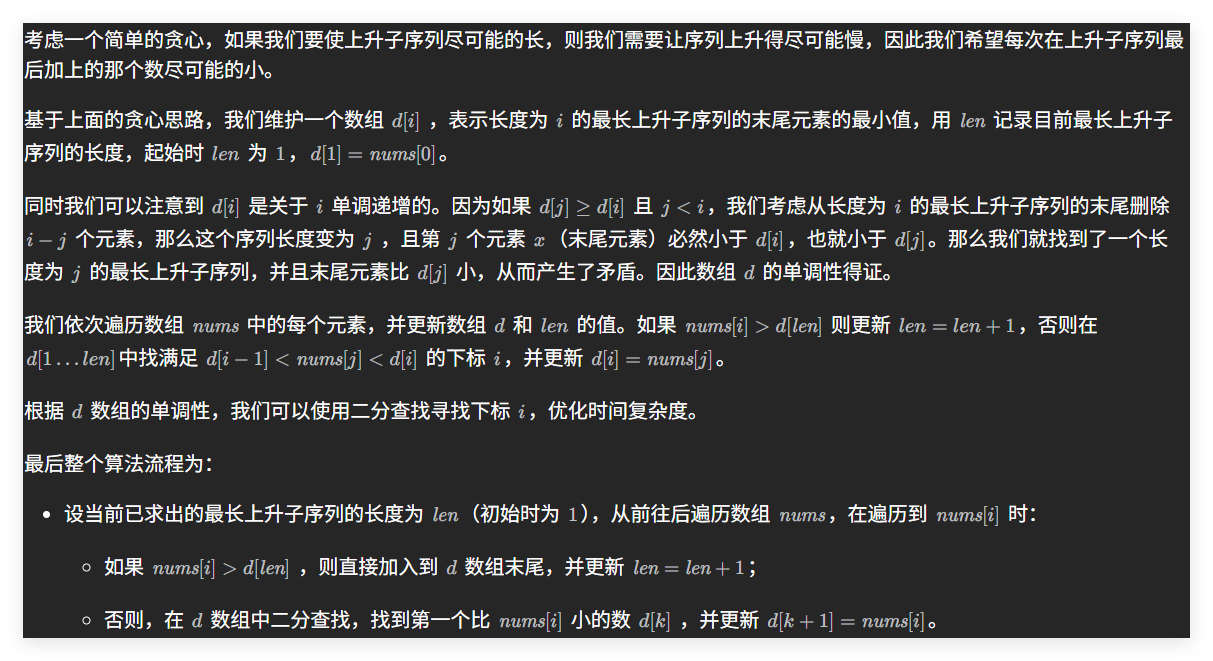
方法二:贪心 + 二分查找
class Solution {
public:
    /**
     * 求最长递增子序列(Longest Increasing Subsequence, LIS)的长度
     * 使用贪心策略 + 二分查找,时间复杂度 O(n log n)
     *
     * @param nums: 输入的整数数组
     * @return: 最长严格递增子序列的长度
     */
    int lengthOfLIS(vector<int>& nums) {
        int n = (int)nums.size();
        if (n == 0)
            return 0;  // 空数组,LIS 长度为 0

        // d[len] 表示:当前构造的“最小尾部”递增序列中,长度为 len 的子序列的最后一个元素的最小值
        // 例如:d[3] = 5 表示存在一个长度为 3 的递增子序列,其最后一个数最小可以是 5
        // 注意:d 数组本身维护的是一个递增序列(按索引),且 d[1..len] 是严格递增的
        vector<int> d(n + 1, 0);

        int len = 1;                    // 当前最长递增子序列的长度
        d[len] = nums[0];               // 初始化:第一个元素构成长度为 1 的序列

        // 从第二个元素开始遍历
        for (int i = 1; i < n; ++i) {
            // 情况 1:当前元素大于 d[len],说明它可以接在当前最长序列后面
            if (nums[i] > d[len]) {
                d[++len] = nums[i];     // 扩展长度,将 nums[i] 作为新的尾部
            }
            // 情况 2:当前元素不大于 d[len],说明不能直接扩展最长序列
            // 但我们希望维护更小的“尾部值”,以便后续能接上更多元素
            // 所以在 d[1..len] 中找到第一个大于等于 nums[i] 的位置,用 nums[i] 替换它
            else {
                int l = 1, r = len;     // 在区间 [1, len] 内二分查找
                int pos = 0;            // pos 记录最后一个满足 d[mid] < nums[i] 的位置
                                        // 即:我们要找的是“插入位置”的前一个位置

                while (l <= r) {
                    int mid = (l + r) >> 1;  // 等价于 (l + r) / 2,位运算更快

                    if (d[mid] < nums[i]) {
                        pos = mid;           // d[mid] < nums[i],说明可以更新左边界
                        l = mid + 1;         // 继续在右半部分找更大的满足条件的位置
                    } else {
                        r = mid - 1;         // d[mid] >= nums[i],说明太大了,往左找
                    }
                }
                // 此时 pos 是最大的满足 d[pos] < nums[i] 的索引
                // 所以 nums[i] 应该放在 d[pos + 1] 的位置,替换掉原来更大的值
                d[pos + 1] = nums[i];
                // 注意:这里不改变 len,因为我们不是在扩展长度,而是在优化已有长度的尾部值
            }
        }

        // 最终 len 就是最长递增子序列的长度
        // 注意:d 数组并不存储实际的 LIS,只用于维护各长度下的最小尾部值
        return len;
    }
};
8、乘积最大子数组
题目链接:乘积最大子数组
题目描述:
给你一个整数数组 nums ,请你找出数组中乘积最大的非空连续 子数组(该子数组中至少包含一个数字),并返回该子数组所对应的乘积。
测试用例的答案是一个 32-位 整数。
解答
方法一:动态规划
一句话,正数找正的最大值,负数找负的最大值。然后存下来,一直向后扩张,这样就是子问题的拓展。
class Solution {
public:
    int maxProduct(vector<int>& nums) {
        vector<long> maxF(nums.begin(), nums.end()),
            minF(nums.begin(), nums.end());
        for (int i = 1; i < nums.size(); ++i) {
            maxF[i] = max(maxF[i - 1] * nums[i],
                          max((long)nums[i], minF[i - 1] * nums[i]));
            minF[i] = min(minF[i - 1] * nums[i],
                          min((long)nums[i], maxF[i - 1] * nums[i]));
            if (minF[i] < INT_MIN) {
                minF[i] = nums[i];
            }
        }
        return *max_element(maxF.begin(), maxF.end());
    }
};
方法二:滚动数组优化 dp
上述方法一还是存储了很多不需要存储的数,这样空间复杂度比较的高。实际上,对于向后遍历的话,只需要存储前面数组的最大值(MAX)和最小值(MIN)即可,我这样到数组的某一个位置进行求解最大值的话,如果是正数,则利用到的只有最大值(MAX),如果是负数,则利用到的只有最小值(MIN)。这样就可以使用两个变量来进行空间上的优化了。
class Solution {
public:
    int maxProduct(vector<int>& nums) {
        long maxF = nums[0], minF = nums[0], ans = nums[0];
        int len = nums.size();
        for (int i = 1; i < len; i++) {
            long min_temp = minF, max_temp = maxF;
            maxF =
                max((long)nums[i], max(max_temp * nums[i], min_temp * nums[i]));
            minF =
                min((long)nums[i], min(min_temp * nums[i], max_temp * nums[i]));
            if (minF < INT_MIN)
                minF = nums[i];
            ans = max(maxF, ans);
        }
        return ans;
    }
};
9、分割等和子集
题目链接:分割等和子集
题目描述:给你一个 只包含正整数 的 非空 数组 nums 。请你判断是否可以将这个数组分割成两个子集,使得两个子集的元素和相等。
解答
错误的解法:贪心
我一开始想的很简单,就是贪心,先将数组进行排序,然后设置两个变量分别从左、从右进行相加遍历,然后再进行判断,于是我写出来的代码如下:
class Solution {
public:
    bool canPartition(vector<int>& nums) {
        sort(nums.begin(), nums.end());
        int len = nums.size();
        if (len == 1)
            return false;
        int left = 0, right = len - 1;
        int left_sum = nums[left], right_sum = nums[right];
        while (left < right - 1) {
            if (left_sum < right_sum) {
                left++;
                left_sum += nums[left];
            } else {
                right--;
                right_sum += nums[right];
            }
        }
        return left_sum == right_sum;
    }
};
结果错了!!!!!!!!
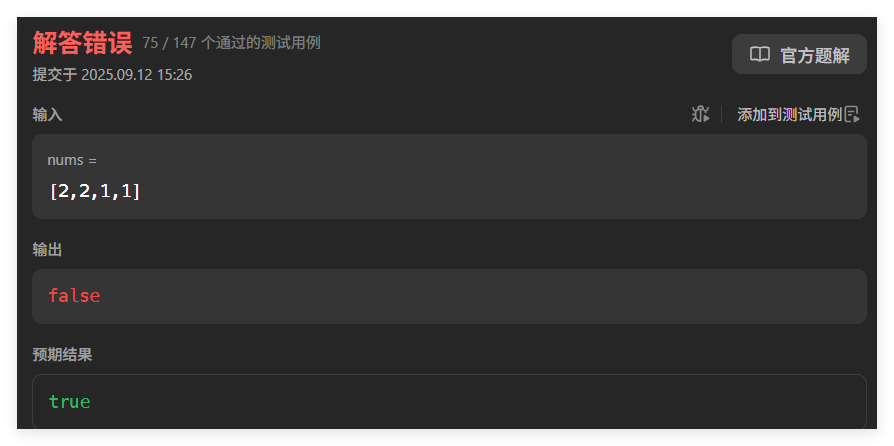
还是想的太简单了。不能简单的使用贪心思想。
方法一:dp
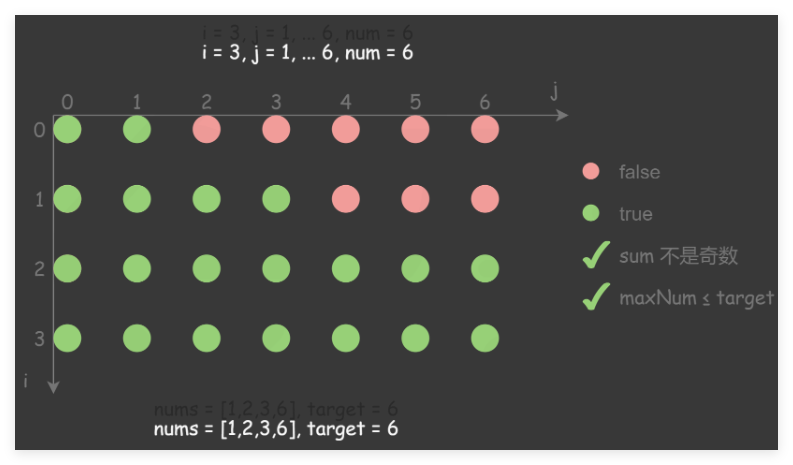
可以引入一个二维数组,进行动态规划的求解。需要注意的是,先判断总和是不是偶数,然后再进行相关的判断。
class Solution {
public:
    bool canPartition(vector<int>& nums) {
        int n = nums.size();
        if (n < 2)
            return false;
        int sum = accumulate(nums.begin(), nums.end(), 0);
        int maxNum = *max_element(nums.begin(), nums.end());
        if (sum % 2 == 1)
            return false;

        int target = sum / 2;
        // 最大的数超过了数组数字之和的一半,则肯定是不行的了
        if (maxNum > target)
            return false;

        // dp[i][j] 表示数组从 [0,i] 下标范围内选取若干整数其和是否为 j
        vector<vector<int>> dp(n, vector<int>(target + 1, 0));
        for (int i = 0; i < n; i++)
            dp[i][0] = true;

        dp[0][nums[0]] = true;
        for (int i = 1; i < n; i++) {
            int num = nums[i];
            for (int j = 1; j <= target; j++) {
                if (j >= num)
                    dp[i][j] = dp[i - 1][j] || dp[i - 1][j - num];
                else
                    dp[i][j] = dp[i - 1][j];
            }
        }
        return dp[n - 1][target];
    }
};
方法二:背包 dp
- 如果能分成两个等和子集,则总和必须为偶数。
- 设
sum = total / 2,问题转化为:能否从数组中选出若干数,使其和为sum? - 这就是一个 0-1 背包问题:容量为
sum,每个数最多用一次。
class Solution {
public:
    bool canPartition(vector<int>& nums) {
        int total = accumulate(nums.begin(), nums.end(), 0);
        // 奇数肯定不可能
        if (total % 2 == 1)
            return false;

        int target = total / 2;
        int len = nums.size();

        vector<bool> dp(target + 1, false);
        // 0 是肯定可以的
        dp[0] = true;

        // 遍历每个数字
        for (int num : nums)
            // 倒序遍历背包,防止一个数被重复利用
            for (int j = target; j >= num; j--)
                dp[j] = dp[j] || dp[j - num];
        return dp[target];
    }
};
方法三: bitset 运算
思路详见:灵神解法
class Solution {
public:
    bool canPartition(vector<int>& nums) {
        int s = reduce(nums.begin(), nums.end());
        // also you can write
        // int s = accumulate(nums.begin(), nums.end(), 0);

        if (s % 2)
            return false;
        s /= 2;
        // create state container bitset<N>
        // attention: N must be const expr
        bitset<10001> f;
        // init condition: can reach it not any pre-condition
        f[0] = 1;
        for (int x : nums)
            f |= f << x;
        // f << x    original is (x) ,but now is (i + x)
        // choose x or not , judged by the expression f |= f << x;

        // is equal to the following code:
        // for (int j = target; j >= x; j--) {
        // dp[j] = dp[j] || dp[j - x];}
        return f[s];
    }
};
比较模糊?不急,我来对测试用例给出上述解法的流程。
假设数组为:[ 1 , 5 , 11 , 5 ]
执行流程如下:
首先从左向右遍历整个数组,初始化为:
f = 000000000000...0000001   (只有第 0 位是 1)
     ↑
     表示:当前能凑出的和是 0
第一步:处理 x = 1
f << 1 → 把所有已有的和 +1
       → 原来能凑出 0 → 现在能凑出 1
       → f << 1 = 000000000000...0000010
然后合并:
f = f | (f << 1)
  = 000000000000...0000001   (原 f)
  | 000000000000...0000010   (f << 1)
  = 000000000000...0000011   → 能凑出 0 和 1
到此:当前能凑出的和:[ 0 , 1 ]
第二步:处理 x = 5
f << 5 → 把所有已有的和 +5
       → 0+5=5, 1+5=6
       → f << 5 = 000000000000...1100000
合并
f = f | (f << 5)
  = 000000000000...0000011   (原 f: 能凑出 0,1)
  | 000000000000...1100000   (f << 5: 能凑出 5,6)
  = 000000000000...1100011   → 能凑出 0,1,5,6
到此:当前能凑出的和:[ 0 , 1 , 5 , 6 ]
第三步:处理 x = 11
f << 11 → 把所有已有的和 +11
        → 0+11=11, 1+11=12, 5+11=16, 6+11=17
        → f << 11 = 0001000100000001100000000...(第11,12,16,17位为1)
合并
f = f | (f << 11)
  = 000000000000...001100011   (原 f: 0,1,5,6)
  | 0001000100000001100000000   (f << 11: 11,12,16,17)
  = 0001000100000001101100011   → 能凑出:0,1,5,6,11,12,16,17
到此:当前能凑出的和:[ 0 , 1 , 5 , 6 ,11 ,12 ,16 ,17]
注意:此时已经能凑出 11 了 !
第四步:处理 x = 5
f << 5 → 所有已有的和 +5
     → 0+5=5, 1+5=6, 5+5=10, 6+5=11, 11+5=16, 12+5=17, 16+5=21, 17+5=22
     → 新增:10,21,22(5,6,11,16,17 已存在)
合并
f = f | (f << 5)
  → 会新增 10,21,22
  → 最终能凑出的和更多,但我们只关心是否能凑出 11
最终判断:
f[11] == 1 → true
10、最长有效括号
题目链接:最长有效括号
题目描述:
给你一个只包含 ‘(’ 和 ‘)’ 的字符串,找出最长有效(格式正确且连续)括号 子串 的长度。
左右括号匹配,即每个左括号都有对应的右括号将其闭合的字符串是格式正确的,比如 “(()())”。
解答
我的错误理解
我看到这道题目的第一思路,是引入一个变量 left_sum,表示记录左括号的个数,然后遍历字符串,要是遇到了’(‘,则左括号++(也就是 left_sum++),dp[i] = dp[i-1],直接继承前面的最大值,要是遇到了右括号’)',则左括号–,要是 left_sum>=0 ,表示有匹配的左括号,直接就是 dp[i] = dp[i-1] + 2 ,要是 left_sum<0 ,表示没有,这样直接将左括号赋值为 0,重新下面的判断。dp[i] 存储的是字符串 0 到 i-1 的最大有效括号.
但是!!!
这是错误的思路,为啥呢?假设 s = “())()”
i:  0 1 2 3 4
    ( ) ) ( )

上述逻辑:
i=0: '(' → left=1, dp[0]=0
i=1: ')' → left>0 → left=0, dp[1]=0+2=2 ✅
i=2: ')' → left=0 → left<0? no, but left==0 → 无法匹配 → left=0, dp[2]=dp[1]=2 ❌ 但这里已经断了!
i=3: '(' → left=1, dp[3]=2
i=4: ')' → left>0 → dp[4]=2+2=4 ❌ 错了!因为 i=2 断开了
题目要求的是必须是连续的子括号串,而我对题目的理解是可以不连续,因此编码就出错了!!!
因此看清楚题意是非常重要的。
方法一:
class Solution {
public:
    int longestValidParentheses(string s) {
        int n = s.size();
        if (n == 0)
            return 0;

        vector<int> dp(n, 0); // dp[i]: 以 s[i] 结尾的最长有效括号长度
        int maxLen = 0;

        for (int i = 1; i < n; i++) {
            if (s[i] == ')') {
                if (s[i - 1] == '(') {
                    // 形如 ...()
                    dp[i] = (i >= 2 ? dp[i - 2] : 0) + 2;
                } else {
                    // 形如 ...))
                    // 先跳过前面的有效段,看是否有个 '(' 能匹配
                    int j = i - dp[i - 1] - 1; // 匹配的位置
                    if (j >= 0 && s[j] == '(') {
                        dp[i] = dp[i - 1] + 2;
                        // 加上前一段的有效长度(如果有)
                        if (j > 0) {
                            dp[i] += dp[j - 1];
                        }
                    }
                    // 否则 dp[i] = 0(默认值)
                }
                maxLen = max(maxLen, dp[i]);
            }
            // s[i] == '(' 时 dp[i] = 0(已初始化)
        }
        return maxLen;
    }
};
方法二:双指针法
这是官方的一种解答,非常的巧妙,详见 :官方解答
class Solution {
public:
    int longestValidParentheses(string s) {
        int left = 0, right = 0, maxLen = 0;

        // 从左往右扫
        for (char c : s) {
            if (c == '(')
                left++;
            else
                right++;
            if (left == right) {
                maxLen = max(maxLen, 2 * right);
            } else if (right > left) {
                left = right = 0;
            }
        }

        left = right = 0;
        // 从右往左扫
        for (int i = s.size() - 1; i >= 0; i--) {
            char c = s[i];
            if (c == '(')
                left++;
            else
                right++;
            if (left == right) {
                maxLen = max(maxLen, 2 * left);
            } else if (left > right) {
                left = right = 0;
            }
        }

        return maxLen;
    }
};
方法三 : 栈
这是官方的一种解答,非常的巧妙,详见 :官方解答
class Solution {
public:
    int longestValidParentheses(string s) {
        int maxans = 0;
        stack<int> stk;
        stk.push(-1);

        for (int i = 0; i < s.length(); i++) {
            if (s[i] == '(')
                stk.push(i);
            else {
                stk.pop();
                if (stk.empty())
                    stk.push(i);
                else
                    maxans = max(maxans, i - stk.top());
            }
        }
        return maxans;
    }
};
🧠 核心思想:用「栈」模拟匹配过程 + 「索引差」计算长度
✅ 关键洞察:
有效括号的本质是:每一个
')'都能和前面某个未匹配的'('成功配对。
我们可以用一个栈来模拟这个配对过程:
- 栈里存的是 字符的索引(index),不是字符本身
- 每当我们遇到一个
')',就尝试用栈顶的'('索引去匹配它 - 匹配成功后,当前
i和新的栈顶之间的距离,就是当前有效括号的长度
🔍 逐行解析代码
class Solution {
public:
    int longestValidParentheses(string s) {
        int maxans = 0;           // 记录最长有效长度
        stack<int> stk;           // 存储括号的索引
        stk.push(-1);             // 关键!哨兵节点
🌟 为什么 stk.push(-1)?
这是整个算法最巧妙的设计!
-1是一个虚拟的左边界- 它的作用是:当栈中只剩下这个哨兵时,表示从当前位置开始的括号序列已经“不合法”或“断开”了
- 后续如果遇到无法匹配的
')',我们就用当前i替换这个-1,作为新的“左边界”
👉 类似于链表中的 dummy head,避免边界判断。
🔁 开始遍历字符串
        for (int i = 0; i < s.length(); i++) {
            if (s[i] == '(')
                stk.push(i);   // 遇到 '(',把它的索引入栈
- 所有未匹配的
'('的索引都存在栈里 - 栈顶永远是最近一个未匹配的
'('的位置
            else {  // s[i] == ')'
                stk.pop();  // 尝试匹配:弹出栈顶(期望是一个 '(')
- 遇到
')',我们尝试匹配 - 先
pop()—— 表示“我试图用这个')'去匹配栈顶的'('”
✅ 匹配成功后,怎么算长度?
                if (stk.empty())
                    stk.push(i);  // 无法匹配,当前 ')' 成为新的左边界
                else
                    maxans = max(maxans, i - stk.top());  // 计算当前有效长度
            }
        }
这里有两个分支,是理解的关键!
🧩 分支 1:stk.empty() → 无法匹配
if (stk.empty())
    stk.push(i);
说明什么?
- 我们
pop()之后栈空了 - 意味着:没有
'('可以匹配这个')' - 这个
')'是非法的、多余的
👉 那么,从下一个字符开始的有效括号,不能再跨越这个 ')'
所以,我们把这个 ')' 的位置 i 当作新的左边界入栈。
相当于:“从
i+1开始才可能有新的有效括号”
🧩 分支 2:!stk.empty() → 匹配成功
else
    maxans = max(maxans, i - stk.top());
说明什么?
pop()之后栈还不空- 说明我们刚刚成功匹配了一对
():')'匹配了栈里的某个'(' - 此时,栈顶是上一个未匹配的
'('或 上一个非法')'的位置 - 那么,从
stk.top() + 1到i的子串就是一个有效的括号串
所以,当前有效长度 = i - stk.top()
因为
stk.top()是“左边界”,有效串从stk.top()+1开始,到i结束
🌰 举个例子:s = "(()"
i:  0  1  2
    (  (  )
       ↑
| i | s[i] | 操作 | 栈状态 | 说明 |
|---|---|---|---|---|
stk.push(-1) | [-1] | 初始化 | ||
| 0 | ‘(’ | stk.push(0) | [-1, 0] | 入栈 |
| 1 | ‘(’ | stk.push(1) | [-1, 0, 1] | 入栈 |
| 2 | ‘)’ | stk.pop() → 弹出 1stk 变成 [-1, 0]非空 → i - stk.top() = 2 - 0 = 2 | maxans = 2 | 成功匹配,长度=2 |
✅ 返回 2,正确!
🌰 再看一个复杂例子:s = ")()())"
i:  0 1 2 3 4 5
    ) ( ) ( ) )
| i | s[i] | 操作 | 栈状态 | 说明 |
|---|---|---|---|---|
stk.push(-1) | [-1] | 初始化 | ||
| 0 | ‘)’ | stk.pop() → 栈空 → stk.push(0) | [0] | 非法 ),设为新边界 |
| 1 | ‘(’ | stk.push(1) | [0, 1] | 入栈 |
| 2 | ‘)’ | stk.pop() → 弹出 1栈非空 → stk.top()=0i - stk.top() = 2 - 0 = 2 | maxans = 2 | 匹配成功,长度=2 |
| 3 | ‘(’ | stk.push(3) | [0, 3] | 入栈 |
| 4 | ‘)’ | stk.pop() → 弹出 3栈非空 → stk.top()=0i - stk.top() = 4 - 0 = 4 | maxans = 4 | 长度=4 |
| 5 | ‘)’ | stk.pop() → 弹出 0栈空 → stk.push(5) | [5] | 非法 ),设为新边界 |
✅ 最终返回 4,对应子串 "()()",正确!
🎯 为什么这个方法能处理“连续有效串”?
比如 "()()":
- 第一次匹配在
i=2,长度2-0=2 - 第二次匹配在
i=4,长度4-0=4 - 因为中间没有非法
')'把栈清空,所以左边界一直是0 - 所以第二次直接算出了整个
()()的长度
这就是 栈顶始终维护“上一个非法位置” 的妙处!
✅ 总结:破题的关键点
| 技巧 | 作用 |
|---|---|
🌟 stk.push(-1) | 设置初始左边界,避免越界 |
| 📥 栈存索引 | 不只是匹配,还能计算长度 |
🔄 遇到 ')' 就 pop | 模拟匹配过程 |
⚠️ stk.empty() → push(i) | 当前 ')' 非法,成为新边界 |
📏 i - stk.top() | 当前有效串长度(从边界后一位到 i) |
🧠 算法本质
这不是一个单纯的“括号匹配”问题,而是一个“最大连续合法区间”问题。
栈在这里的作用是:
- 维护未匹配的
'('和非法')'的位置stk.top()始终是当前有效串的左边界前一个位置i - stk.top()就是当前有效长度
✅ 复杂度分析
- 🕒 时间复杂度:
O(n),每个元素最多入栈出栈一次 - 💾 空间复杂度:
O(n),栈最多存n个索引
🏁 总结一句话
这段代码的“破题”关键是:用栈维护“上一个非法位置”作为左边界,每当成功匹配一个
')',就用i - stk.top()计算当前有效长度,从而动态更新最大值。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 17
 0
- 0


 已为社区贡献7条内容

所有评论(0)