软件设计师_第十三章:数据结构(重难点!!!)
目录
复杂度
时间复杂度
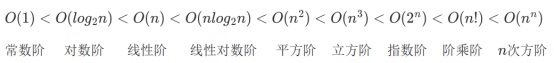
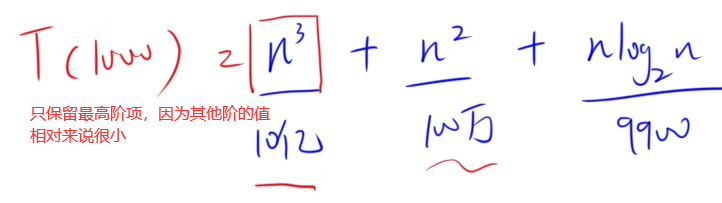
加法规则:多项相加,保留最高阶项,并将系数化为1
乘法规则:多项相乘都保留,并将系数化为1
加法乘法混合规则:先小括号再乘法规则最后加法规则
时间复杂度估算看最内层循环,如若没有循环和递归则为O(1)
递归(展开式求复杂度)
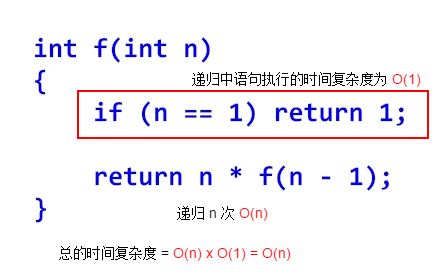
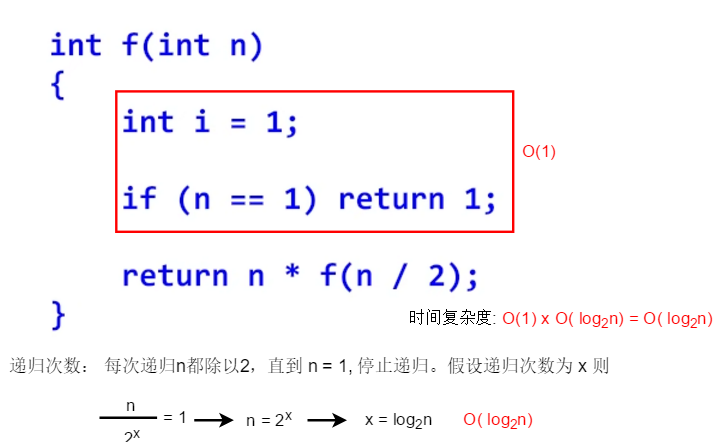
递归的次数× 每次递归的时间复杂度(适用于每次递归时间复杂度不变的情况)
递归时间复杂度不变的情况
递归时间复杂度变的情况
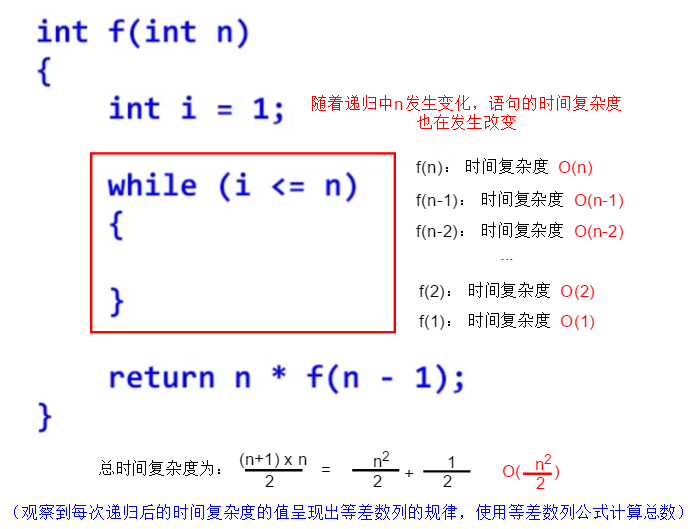
空间复杂度
空间复杂度 O(1)
如果算法执行所需要的临时空间不随着某个变量n的大小而变化,即此算法空间复杂度为一个常量,可表示为 O(1)
递归(展开式求复杂度)
递归的次数× 每次递归的空间复杂度(适用于每次递归空间复杂度不变的情况)
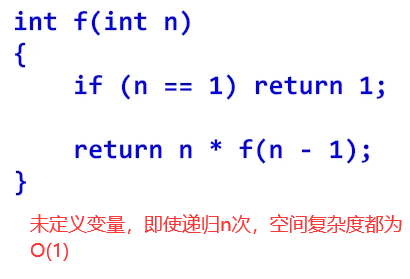
递归空间复杂度不变的情况
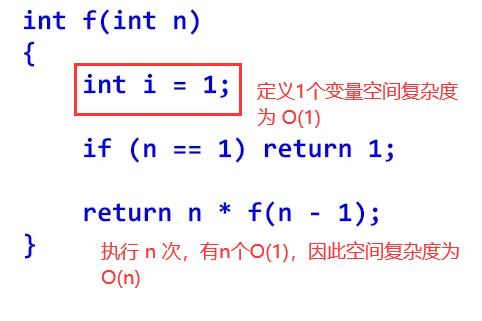
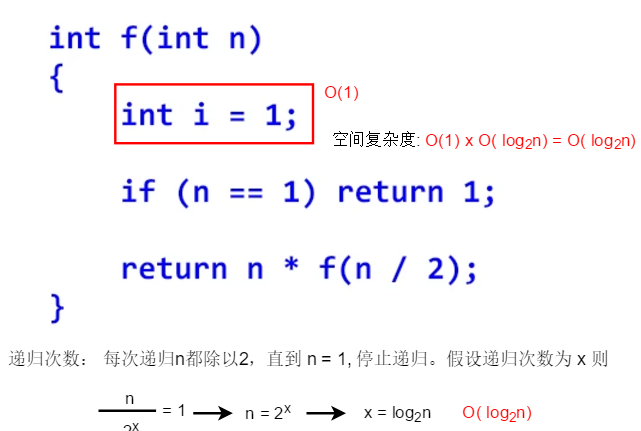
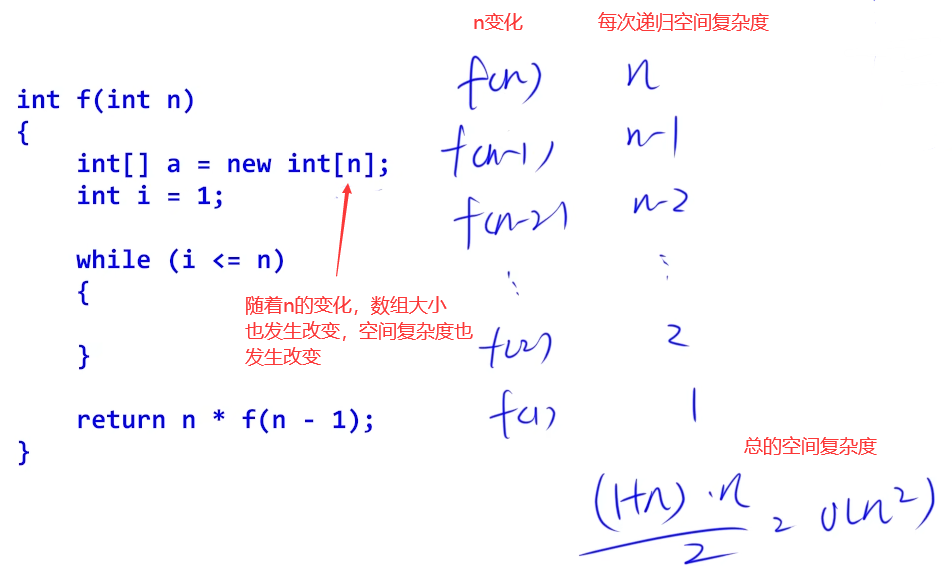
递归空间复杂度变的情况
渐近符号
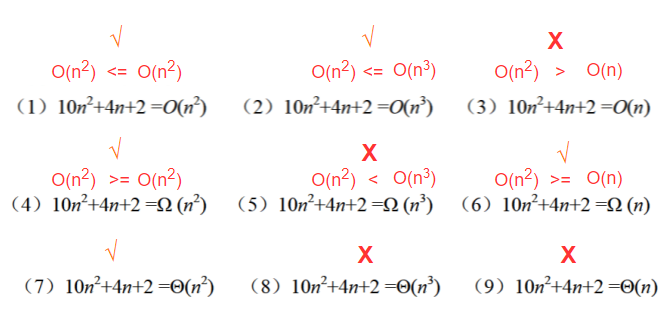
主方法求解复杂度
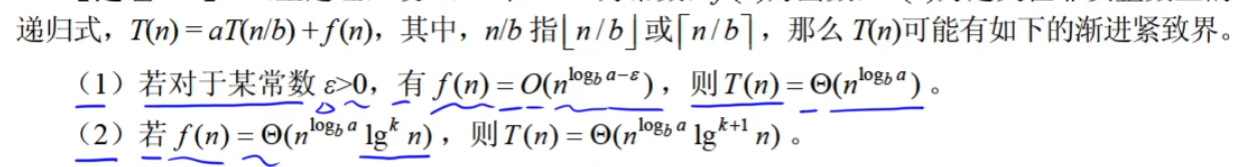
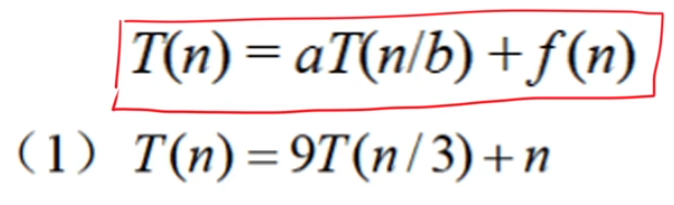
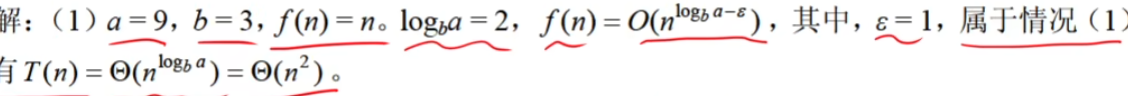
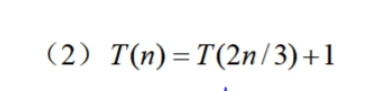
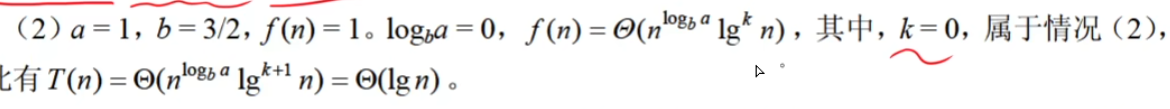
线性结构
顺序表:
采用顺序存储,优点是可以随机存取表中的元素;
缺点是插入和删除操作需要移动大量的元素。
时间复杂度
插入、删除操作最好时间复杂度为 O(1),平均和最坏时间复杂度都为 O(n)
查找最好、最坏、平均情况都为 O(1)
单链表:
采用链式存储,优点是插入和删除操作不需要移动大量的元素,只需要修改指针;
缺点是不能随机访问表中的元素。
时间复杂度
查找、插入、删除操作最好时间复杂度为 O(1),平均和最坏时间复杂度都为 O(n)
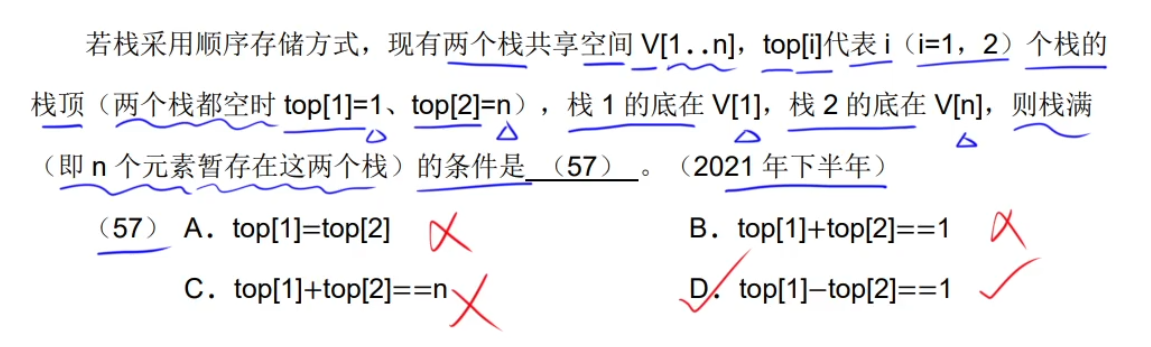
栈
刷题
队列
1、队列是否已满
maxSize: 队列长度
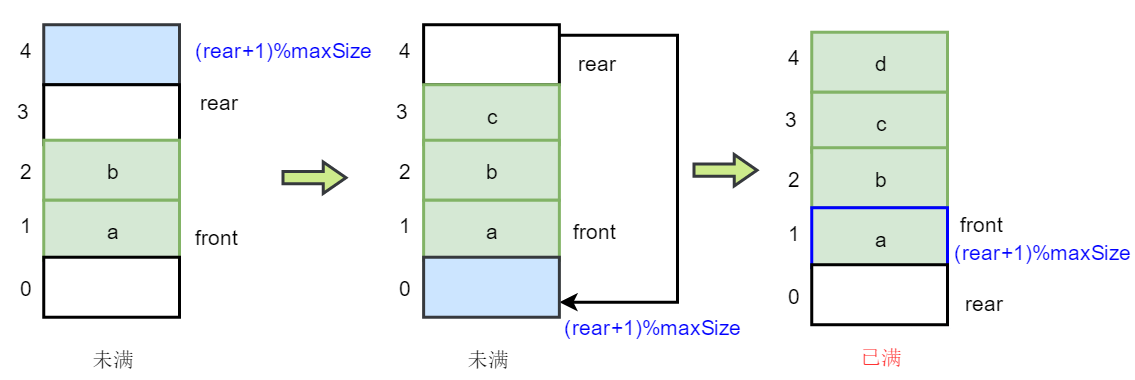
如果 (rear +1)%maxSize = front 表示队列已满
2、队列有效数据个数
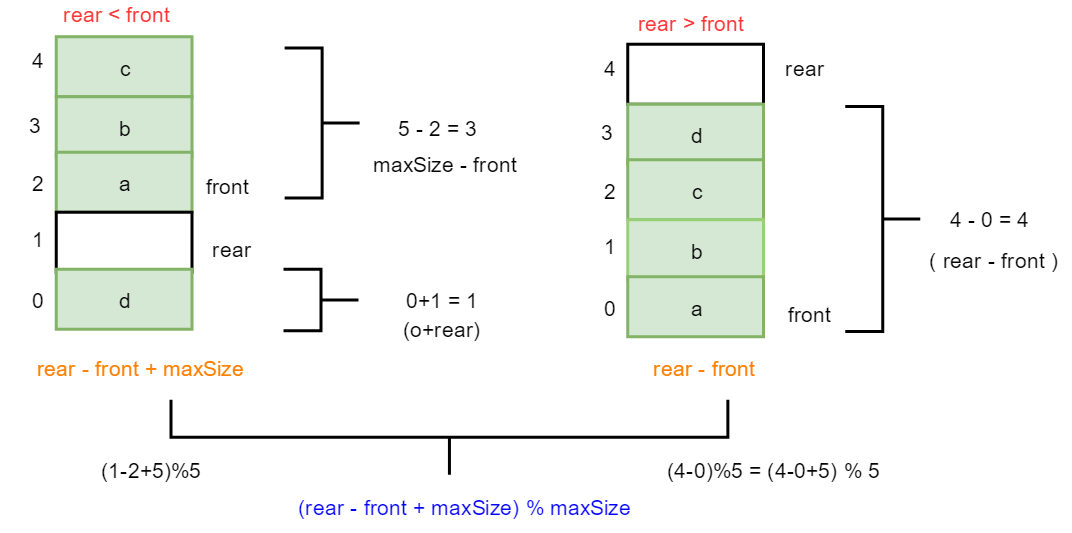
循环队列的队尾和队头,队长
队尾:rear,队头:front,队长:size
队尾=(front+size-1+M)%M
队头=(rear-size+1+M)%M
队长=(rear-front+M)%M
刷题
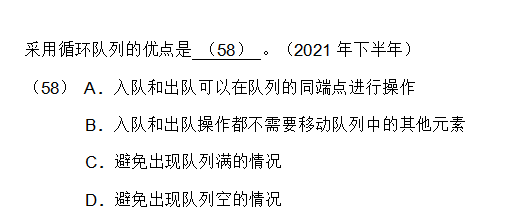
B
串
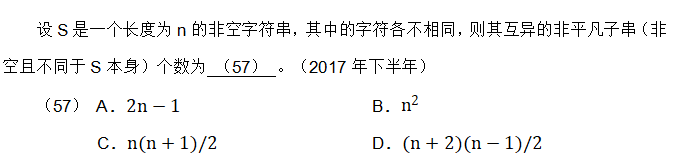
D
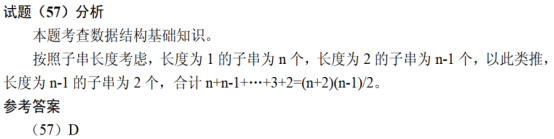
串的模式匹配
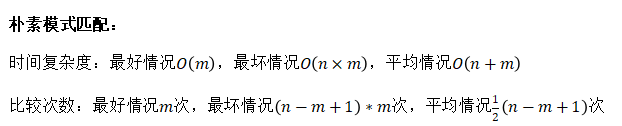
KMP next数组
概念
前缀: 包含首位字符但不包含末位字符的字串
后缀: 包含末位字符但不包含首位字符的字串
next数组定义: 当主串与模式串的某一位字符不匹配时,模式串要回退的位置
next[ j ]: 其值 = 第 j 位字符前面 j-1 位字符组成的字串的前后缀重合字符数+1
next 数组值推导
部分匹配表
| j | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
| 模式串T | a | b | a | b | a | a | a | b | a |
| next[j] | 0 | 1 | 1 | 2 | 3 | 4 | 2 | 2 | 3 |
| a | ab | aba | a | a | ab |
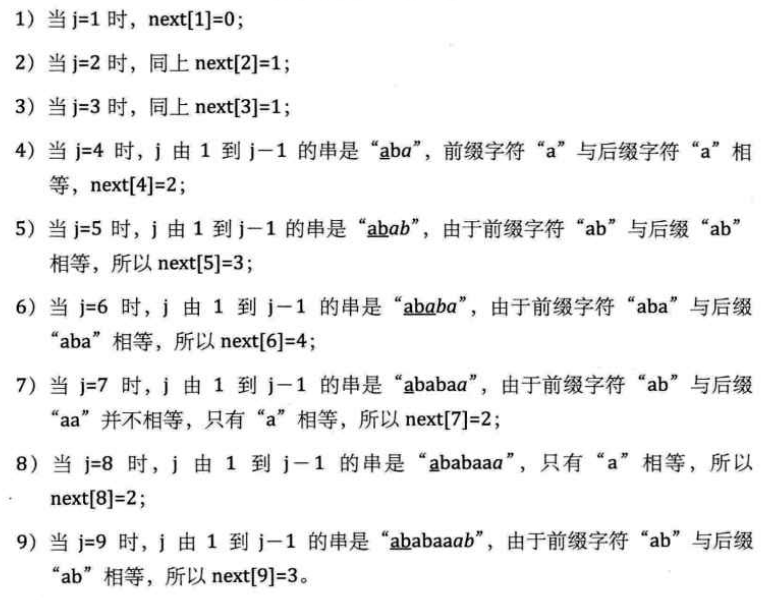
矩阵
数组
一 概述(记❤)
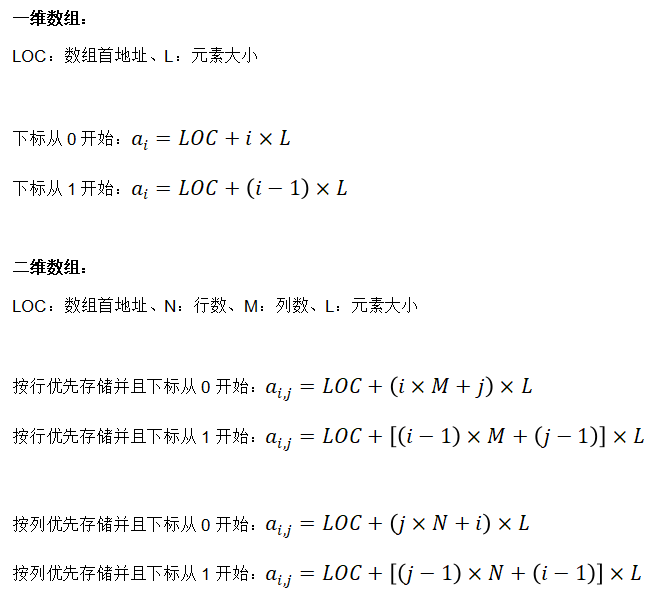
刷题(注意审题!!)
矩阵(刷题!!)
对称矩阵的三个区域
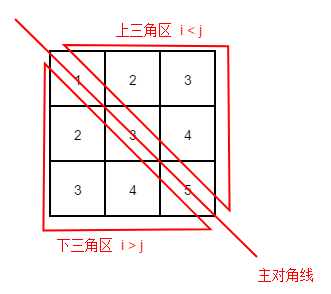
存储
一般存储下三角区和主对角线的元素,将这些元素放到一维数组中
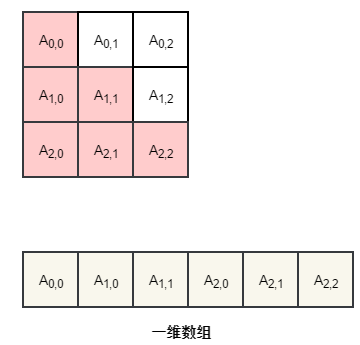
第一行: 1 个元素
第二行: 2 个元素
第三行: 3个元素
.....
第n行: n 个元素
可以看到这是个等差数列,等差数列求和公式: 总数 = (a1+an)n/2
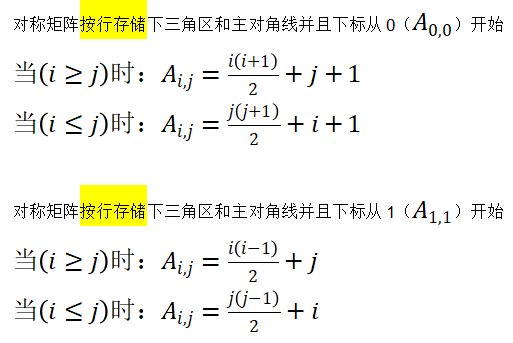
求 Ai,j 前共有多少个元素(记❤)
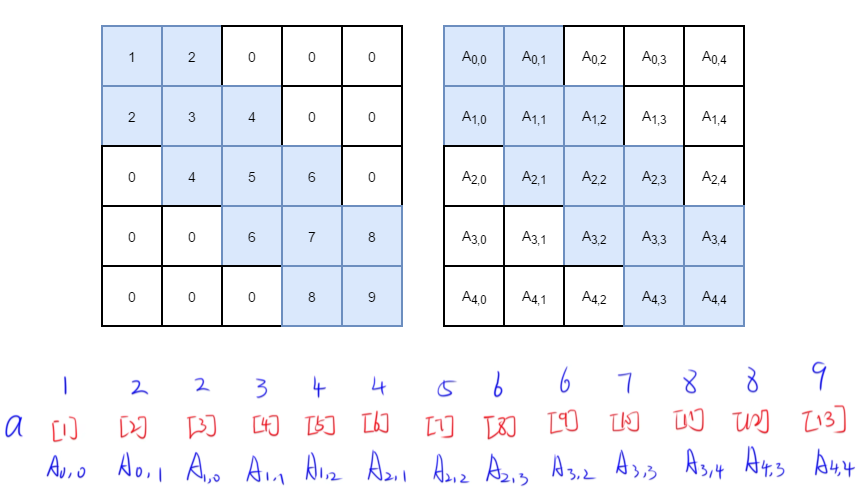
三对角矩阵
只有中间存储数据,下三角和上三角的值都是0
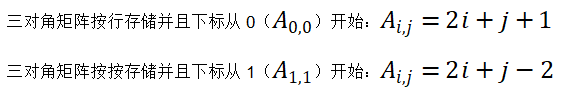
稀疏矩阵
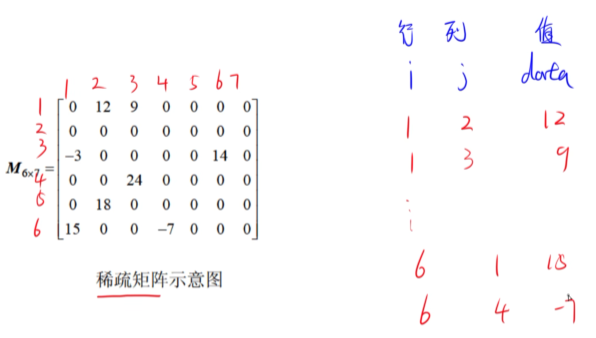
稀疏矩阵的三元组表的顺序存储结构称为三元组顺序表,常用的三元组表的链式存储结构是十字链表。
用三元组表存储矩阵中非0元素的个数
树
基本概述和性质
1 基本概念
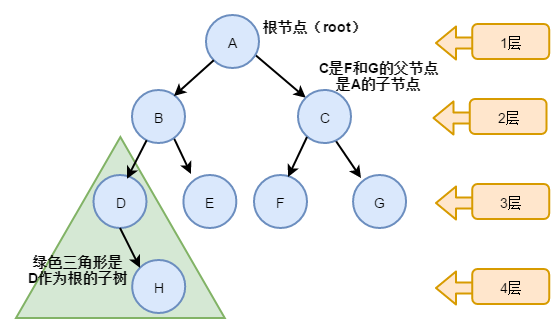
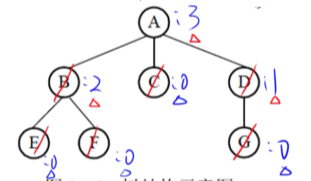
节点的度: 一个节点的子树的个数。例如 A 节点有2个子树,度为2。
树的高度(深度): 一棵树的最大层数。当前树的最大层数是4,所以树的高度是4
树的度:树中节点的度的最大值
2 性质
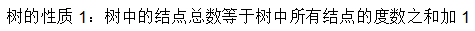
节点总数: 3 + 2 + 1 + 1 = 7

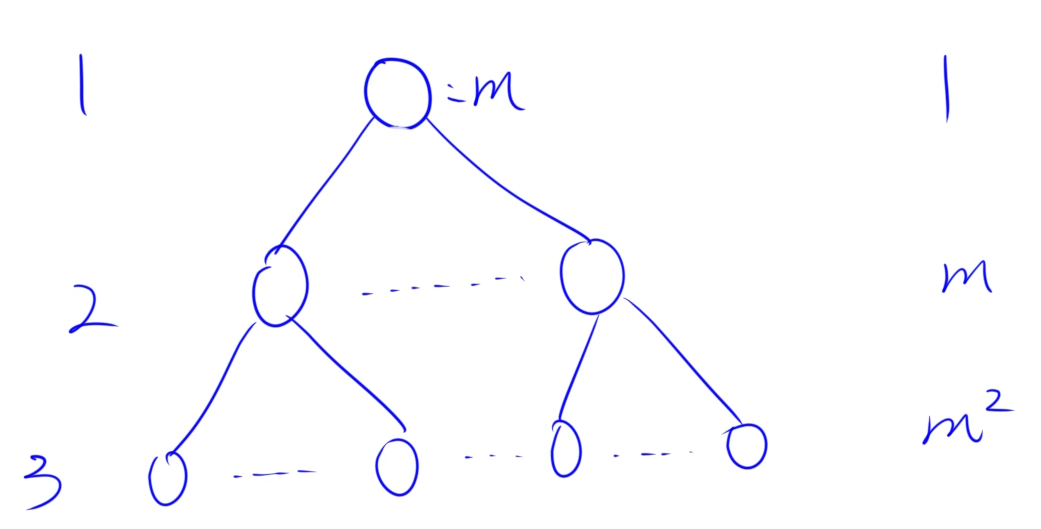
度为m的树: 树中节点的度的最大值为m
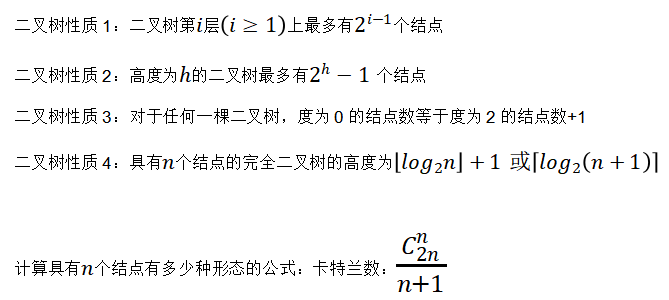
性质2 的意思是,每个节点的度都为m,则第 i 层上至多有 m 的 i-1 次方个结点
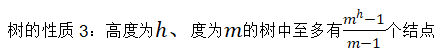
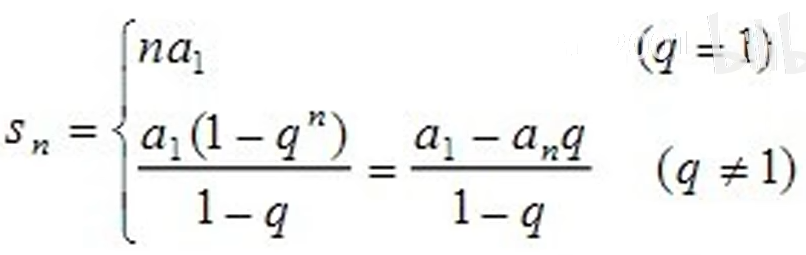

二叉树
二叉存储结构
顺序存储
需要维护结点和左、右孩子的关系:结点编号为n,则左孩子为2n,右孩子为 2n+1。
链式存储
有二叉链表和三叉链表。对于n个结点的二叉树,二叉链表的空指针为n + 1,三叉链表的空指针为n + 2。
二叉树遍历
先序遍历:根左右
中序遍历:左根右
后序遍历:左右根
层序遍历:从上到下、从左往右依次遍历
通过序列构造二叉树必须有中序序列
平衡二叉树和二叉排序树
平衡二叉树
- 二叉树中的任意一个结点的左右子树高度之差的绝对值不超过1.关注分支结点即可,叶子结点满足上述要求。
二叉排序树:
- 根结点的关键字大于左子树所有结点的关键字,小于右子树所有结点的关键字,左右子树也是一颗二叉排序树。
- 中序遍历得到的序列是有序序列
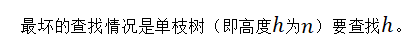
哈夫曼树
哈夫曼树中权值越大的结点离根结点越近,权值越小的结点离根结点越远。
哈夫曼树只有度为0和度为2的结点,没有度为1的结点。
n个权值构造的哈夫曼树具有2n-1个结点。
wpl最小的二叉树
给定n个权值作为n个叶子节点,构造一棵二叉树,若该树的带权路径长度(wpl)达到最小,称这样的二叉树为最优二叉树,也称赫夫曼树。
赫夫曼树是带权路径长度最短的树,权值较大的节点离根较近。
| 路径 | 在一棵树中,从一个节点往下可以达到的孩子或孙子节点之间的路径 |
| 路径长度 | 通路中分支的数目。若规定根节点的层数为1,则从根节点到第L层节点的路径长度为 L-1 |
| 节点的权 | 若将树中节点赋给一个有某种意义的数值,则这个数值称为该节点的权 |
| 节点带权路径长度 | 节点的带权路径长度为从根节点到该节点之间的路径长度与该节点的权的乘积 |
哈夫曼编码
1 基本介绍
- 赫夫曼编码是一种编码方式,属于一种算法
- 赫夫曼编码是赫夫曼树在电讯通信中经典的应用之一
- 赫夫曼编码广泛地用于数据压缩,压缩率通常在 20%~90%之间
- 赫夫曼编码是可变长编码(VCL)的一种,Huffman于1952年提出一种编码方法,称之为最佳编码
赫夫曼压缩注意事项:
- 如果文件本身就是经过压缩处理的,那么使用赫夫曼编码再压缩效率不会有明显变化,比如视频,ppt等文件(这些文件实际上都是经过压缩处理过的,打开时会有停顿,实际在进行解压)。
- 赫夫曼编码是按字节来处理的,因此可以处理所有文件(二进制文件,文本文件)。
- 如果一个文件中的内容重复的数据不多,压缩效果也不会很明显
定长编码
i like like like java do you like a java // 共40个字符(包括空格)
对应ASCII码
| 105,32,108,105,107,101,32,108,105,107,101,32,108,105,107,101,32,106,97,118,97,32,100,111,32,121,111,117,32,108,105,107,101,32,97,32,106,97,118,97 |
对应二进制, 按照二进制来传递信息,总的长度是359(包括空格)
| 01101001 00100000 01101100 01101001 01101011 01100101 00100000 01101100 01101001 01101011 01100101 00100000 01101100 01101001 01101011 01100101 00100000 01101010 01100001 01110110 01100001 00100000 01100100 01101111 00100000 01111001 01101111 01110101 00100000 01101100 01101001 01101011 01100101 00100000 01100001 00100000 01101010 01100001 01110110 01100001 |
赫夫曼编码(无损处理[压缩])(重点!!!)
步骤:
- 统计每个字符出现的次数
- 将次数作为权值构建赫夫曼树
- 根据赫夫曼树,给各个字符,规定编码(赫夫曼编码)
- 按照上面的赫夫曼编码,对要发送的字符串进行编码(使用的是无损压缩)
例如:
i like like like java do you like a java
统计各个字符出现的次数,作为权值
| d | y | u | j | v | o | l | k | e | i | a | 空格 |
| 1 | 1 | 1 | 2 | 2 | 2 | 4 | 4 | 4 | 5 | 5 | 9 |
构建赫夫曼树
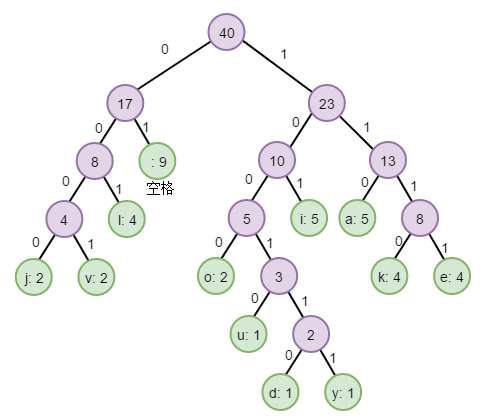
根据赫夫曼树,给各个字符规定编码,向左的路径为0,向右的路径为1, 编码如下:
| 空格 | 01 | l | 001 | j | 0000 | v | 0001 |
| i | 101 | o | 1000 | u | 10010 | d | 100110 |
| y | 100111 | a | 110 | k | 1110 | e | 1111 |
该编码为前缀编码,每个字符的编码均不是另外一个字符编码的前缀
i like like like java do you like a java 对应的编码 (长度: 133)
1010100110111101111010011011110111101001101111011110100001100001110011001101000011001111000100100100110111101111011100100001100001110
相对于前面的定长编码压缩了 (359-133)/359 = 62.9%
注意:
赫夫曼树根据排序方法不同,也可能不太一样,这样对应的赫夫曼编码也不完全一样,但是wpl是一样的
例如,在构建赫夫曼树时,有可能权值是一样的,那么形成的赫夫曼树不一样
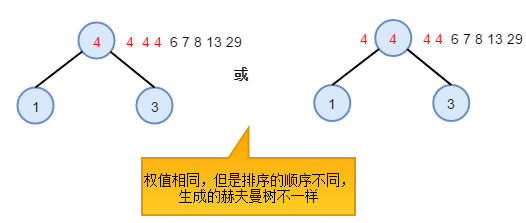
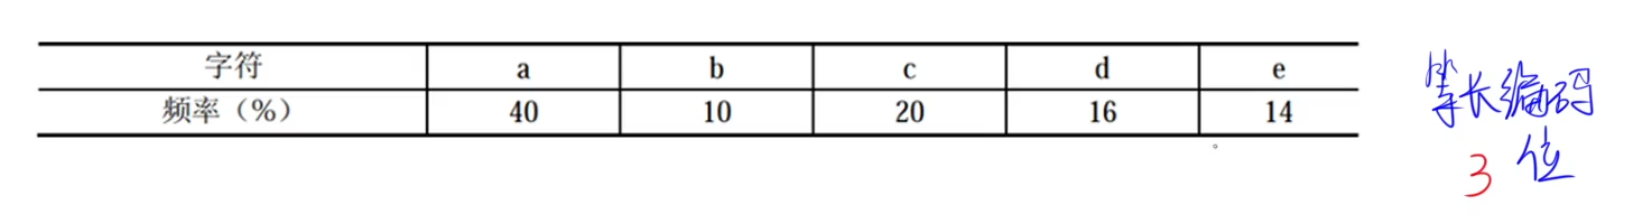
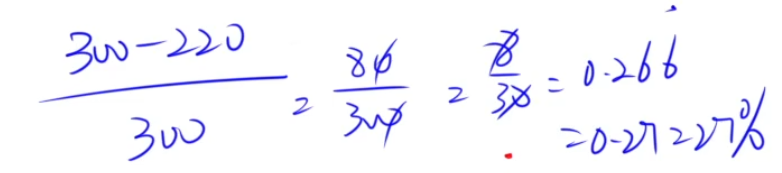
求解压缩比步骤:
等长编码:用二进制表示这五个字符,最少需要三位
求出哈夫曼树
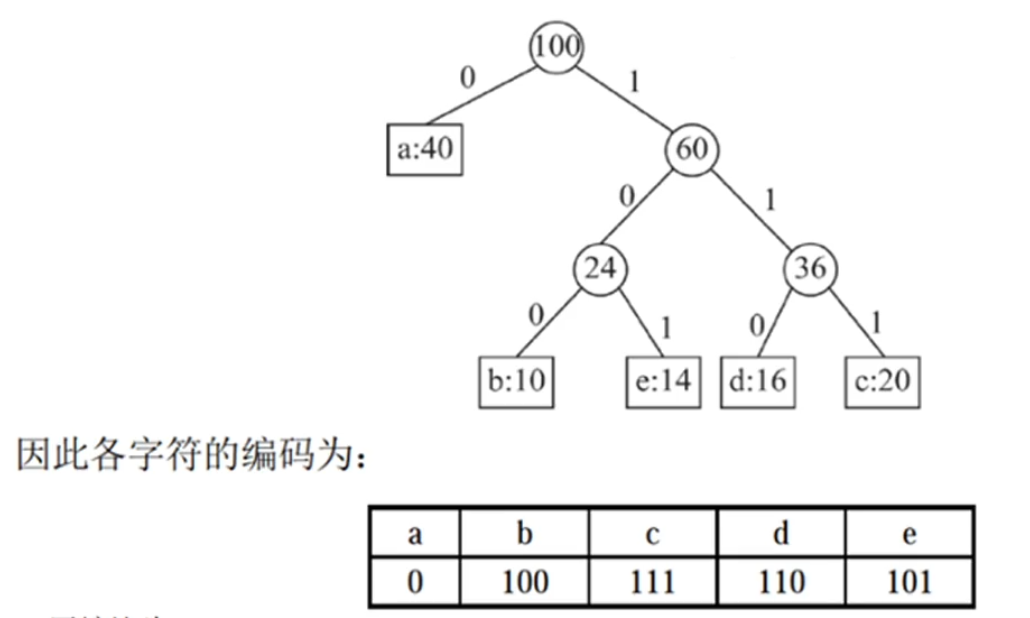
用等长编码100个字符:300位
用哈夫曼编码100个字符:220位
压缩比:
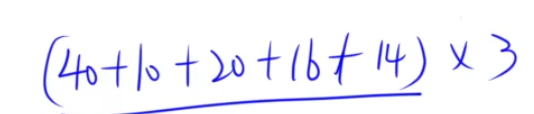
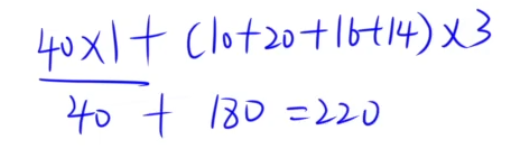
图
基本概念
一 概述
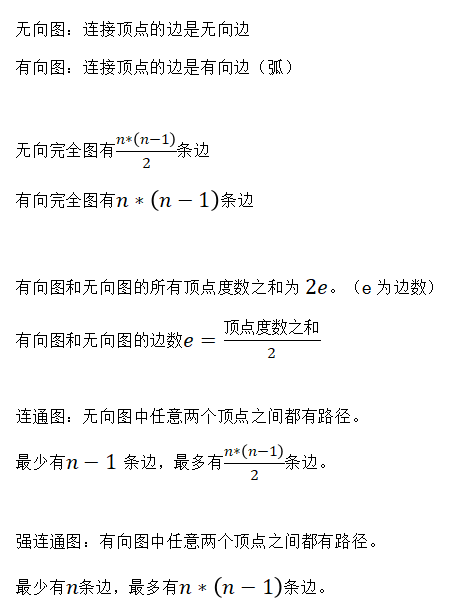
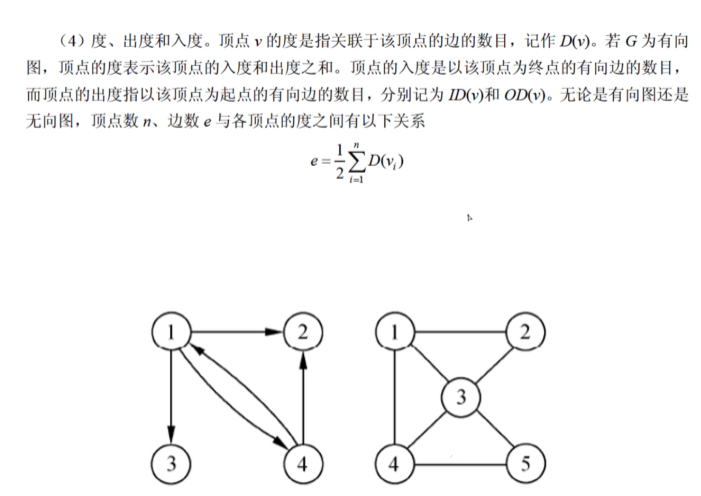
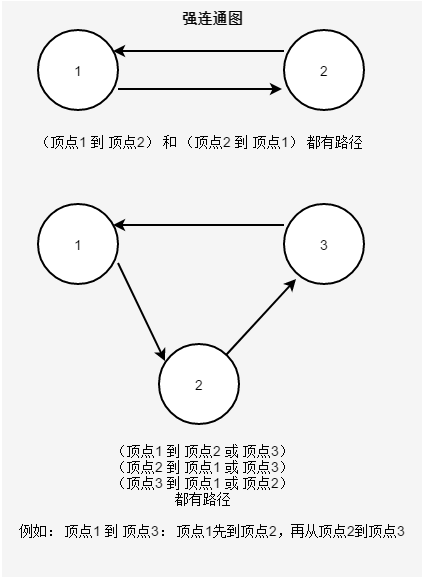
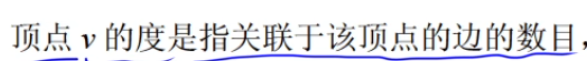
度:
所有图的所有顶点的度数之和为两倍的边数
----------------------------------------------------------------------------------
有向图:
出度:
入度:
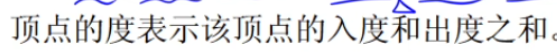


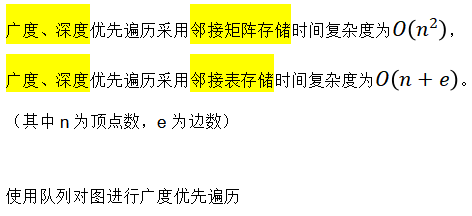
邻接矩阵和邻接表
一 邻接矩阵
邻接矩阵更适合存储稠密图(边数很多的图)
完全图(每个顶点都和剩余的顶点有一条边)更适合采用邻接矩阵存储
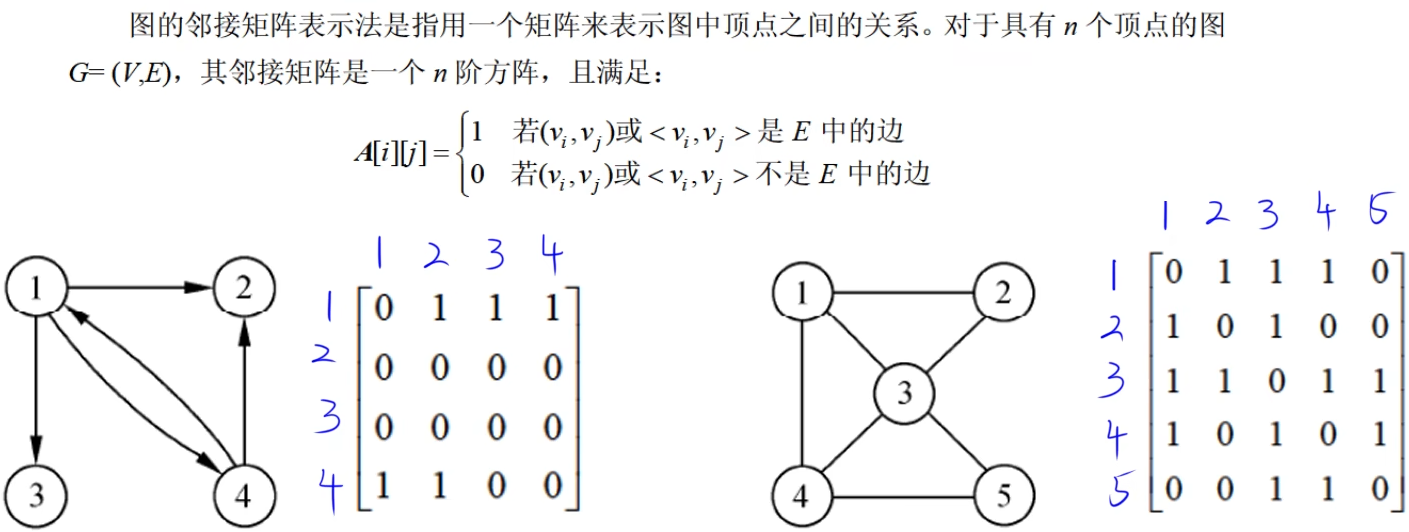
A[i][j]=1表示顶点i和顶点j之间有一条无向边
A[i][j]=0表示顶点i和顶点j之间没有边
| 有向图 | 无向图 | |
| 非零元素个数 | e | 2e |
| 对称矩阵 | 有向图的邻接矩阵不一定是对称矩阵 | 无向图的邻接矩阵是对称矩阵 |
| 度的个数 | 顶点i的出度等于第i行非零元素个数,入度等于第i列非零元素个数,顶点i的度=顶点i的出度+入度 | 顶点i的度等于邻接矩阵第i行(列)中非零元素个数 |
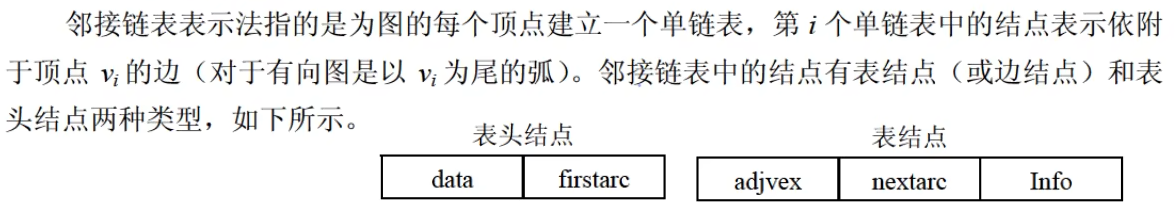
二 邻接表
邻接表更适合存储稀疏图(边数很少的图)
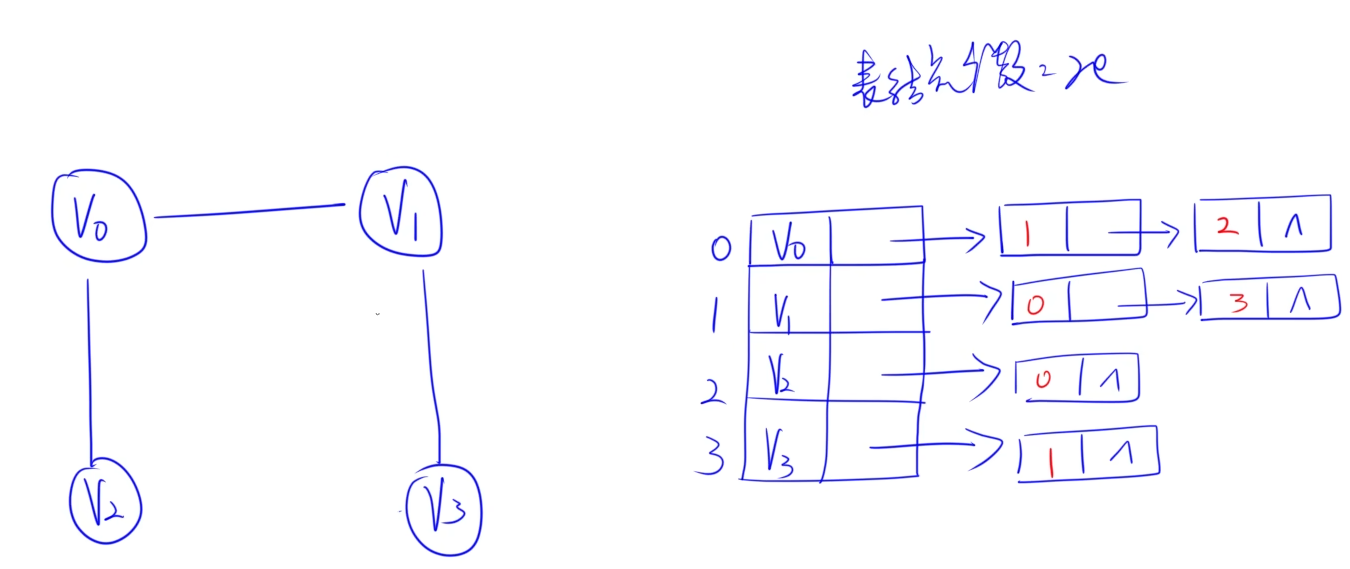
无向图采用邻接表存储有2e个表结点(e为边数)
有向图采用邻接表存储有n+e个表结点(n为结点数,e为边数)
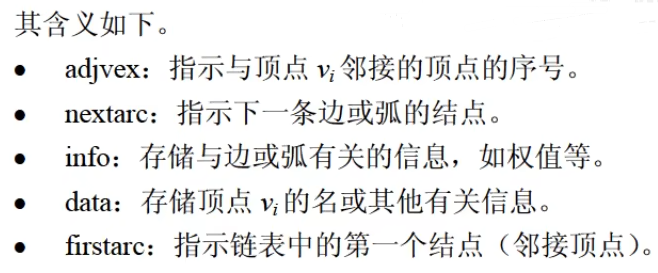
有向图
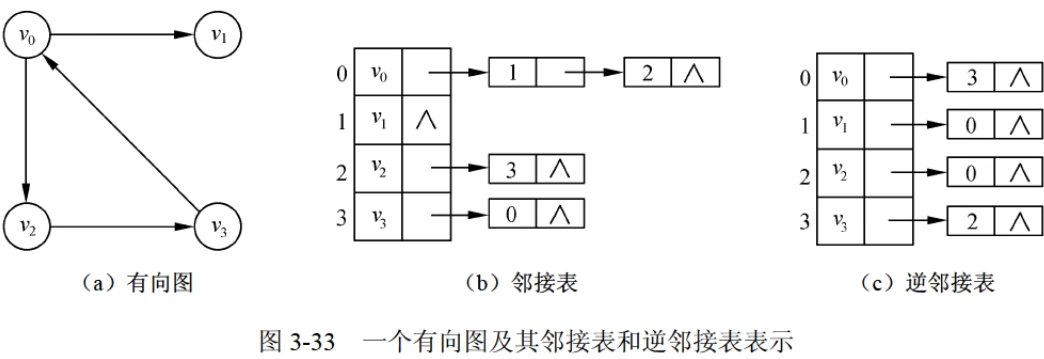
无向图
图的遍历
一 概述
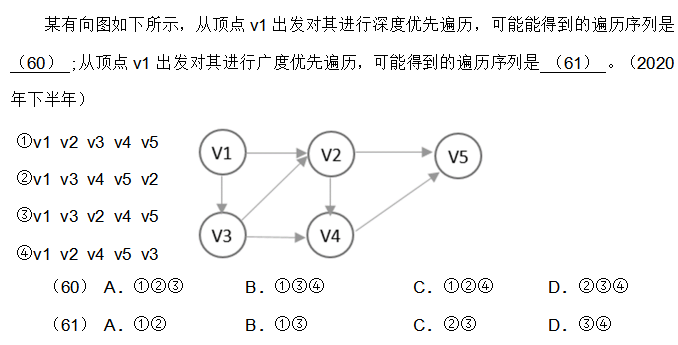
DB
深度优先遍历
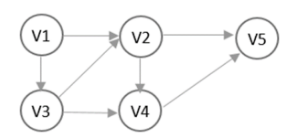
- v1 到 v2, v2 并没有有向边到v3,因此 1 不是深度优先遍历
- v1 到 v3, v3到v4, v4 到 v5,此时 v5 已经没有邻接节点,返回到v4,v4 没有可访问的邻接节点返回到v3, v3没有可访问的邻接节点,返回到v1,v1 访问v2
广度优先遍历
依照广度优先遍历的特点,从v1 出发会先将邻接节点 v2 v3 遍历完
- v1 v2 v3
- v1 v3 v2
拓扑排序
AOV 网
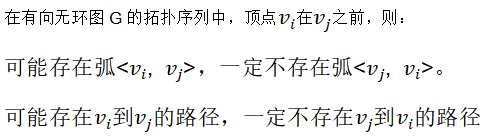
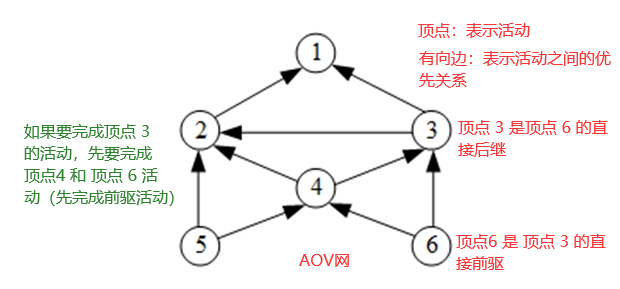
2 拓扑排序
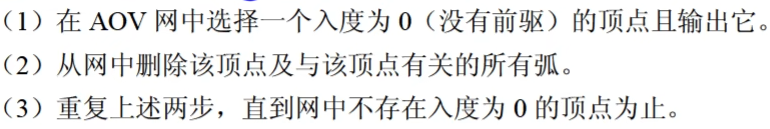
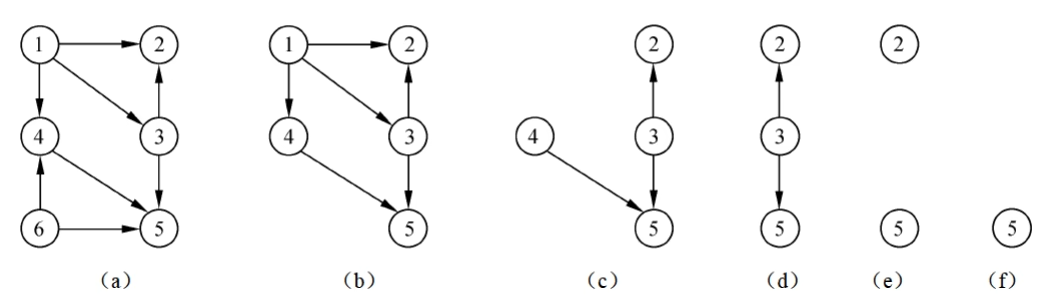
得到的拓扑排序为: 6,1,4,3,2,5
查找
静态查找、二分查找
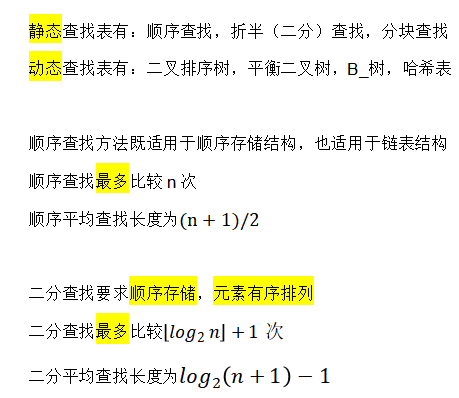
二分查找去中值默认下取整,下取整没有正确答案时再考虑上取整
哈希表
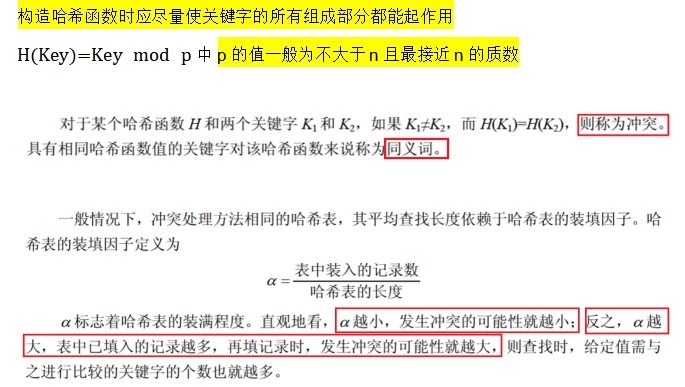
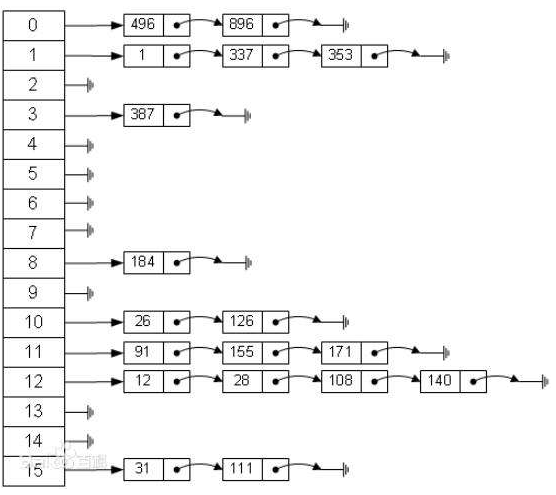
散列表(Hash table, 也叫哈希表), 是根据关键码值(key value)而直接进行访问的数据结构,它通过把关键码值映射到表中一个位置来访问记录,以加快查找速度。这个映射函数叫做散列函数,存放记录的数组叫做散列表。可以使用哈希表做缓存。
key -传送-> 散列函数 -计算-> 记录位置 -寻找-> 获取数据
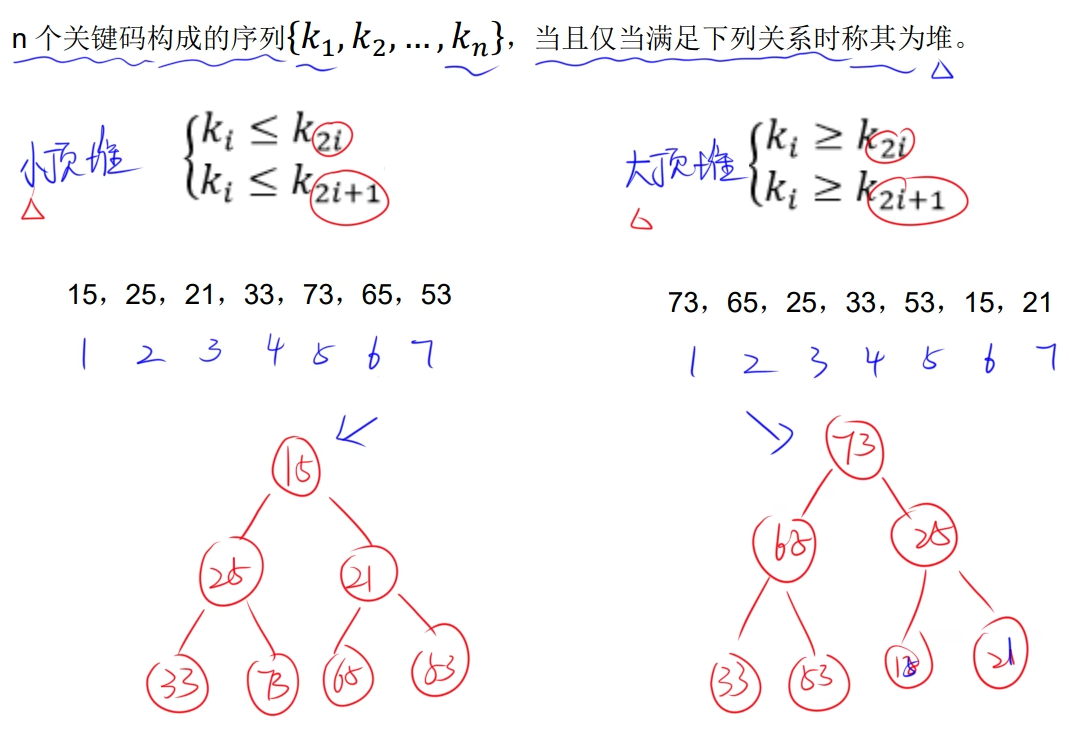
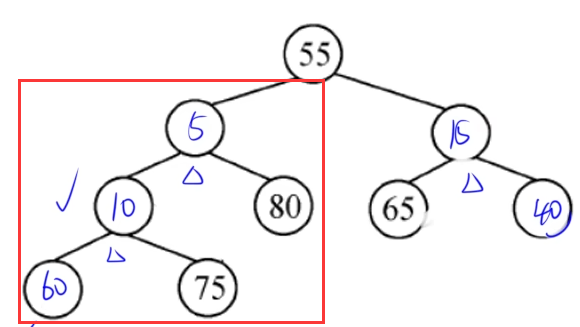
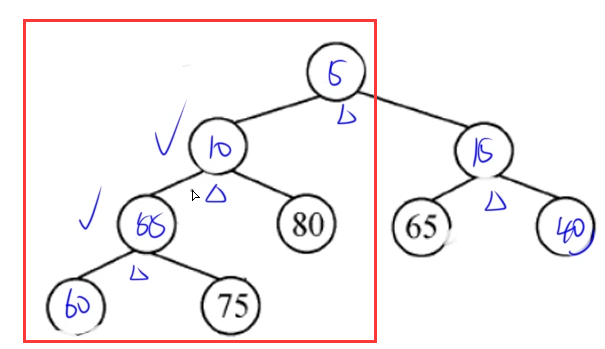
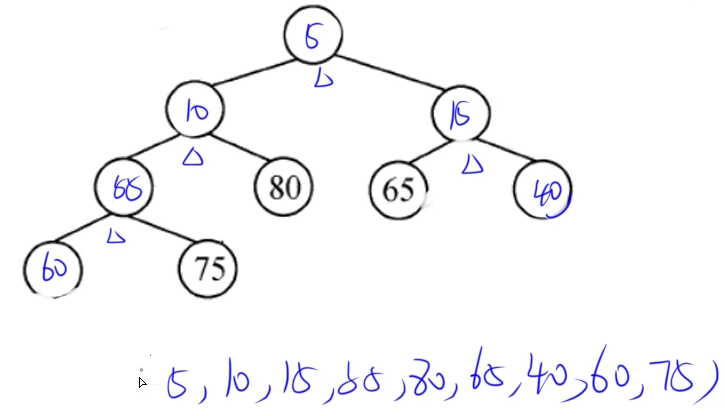
堆
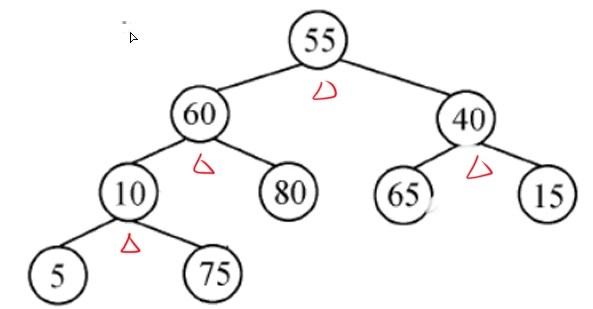
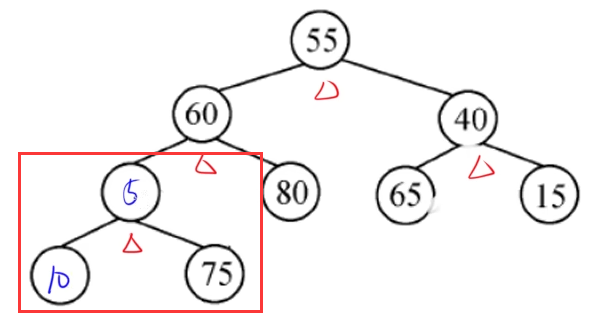
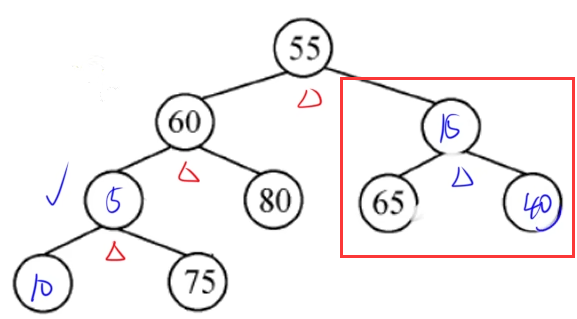
1 判断是否是小顶堆大顶堆
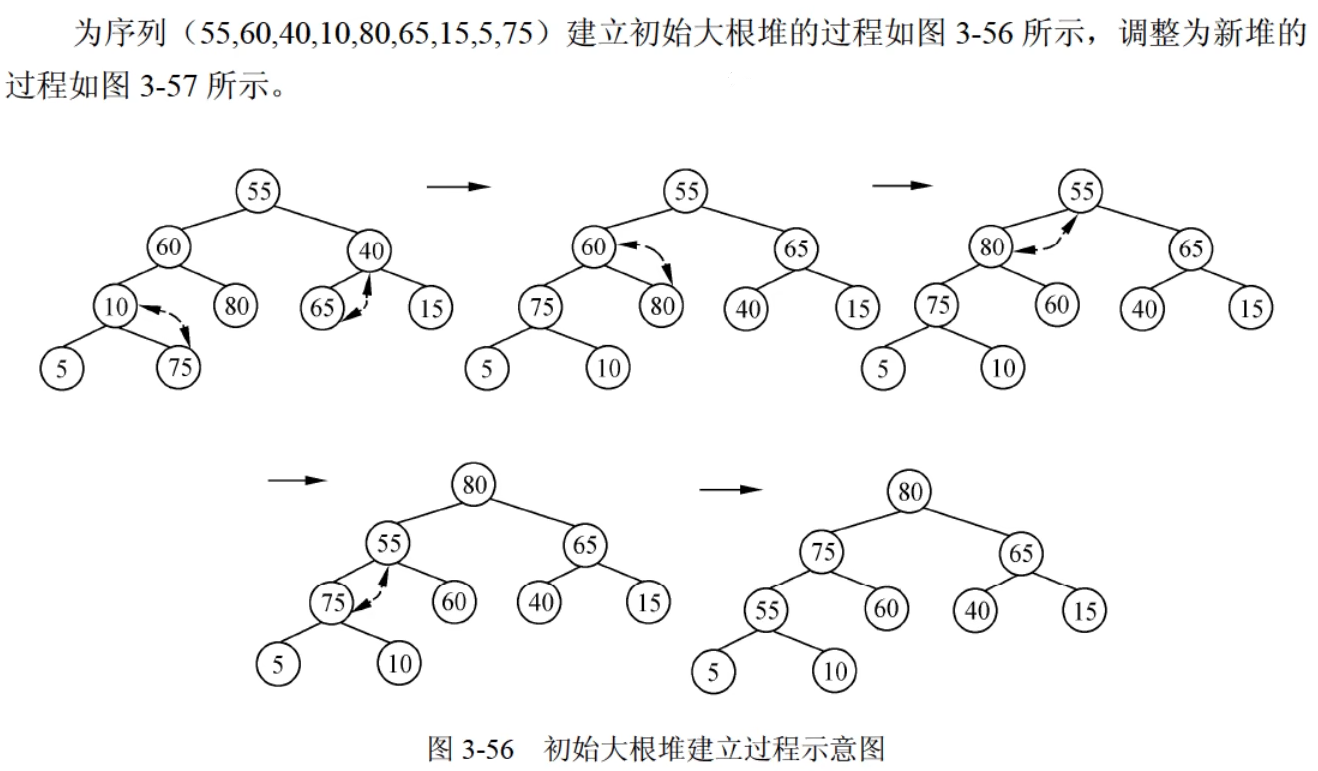
调整大顶堆
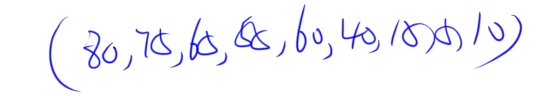
调整小顶堆
排序
直接插入排序和希尔排序
一 概述
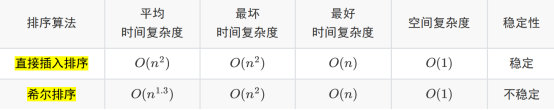
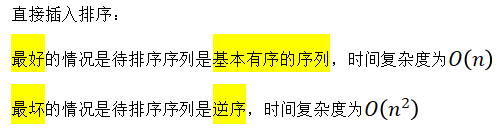
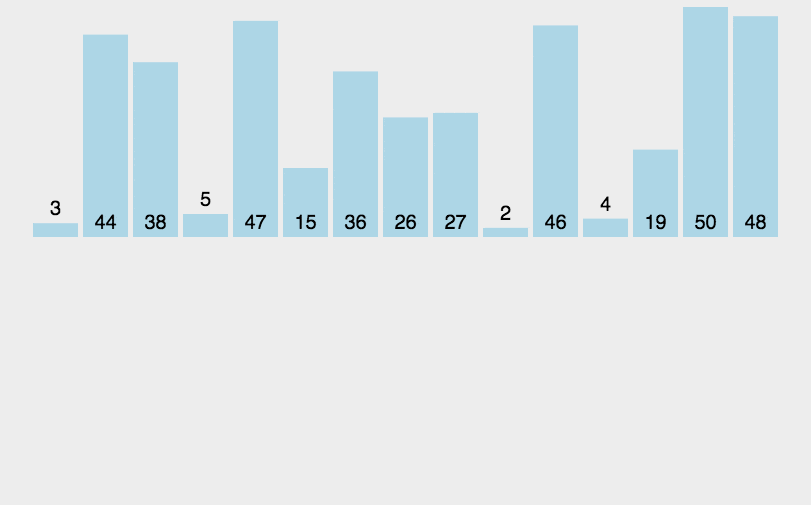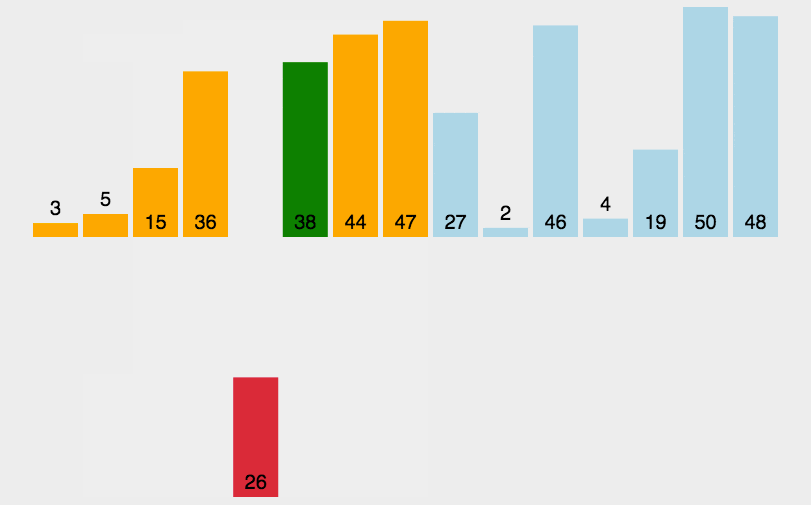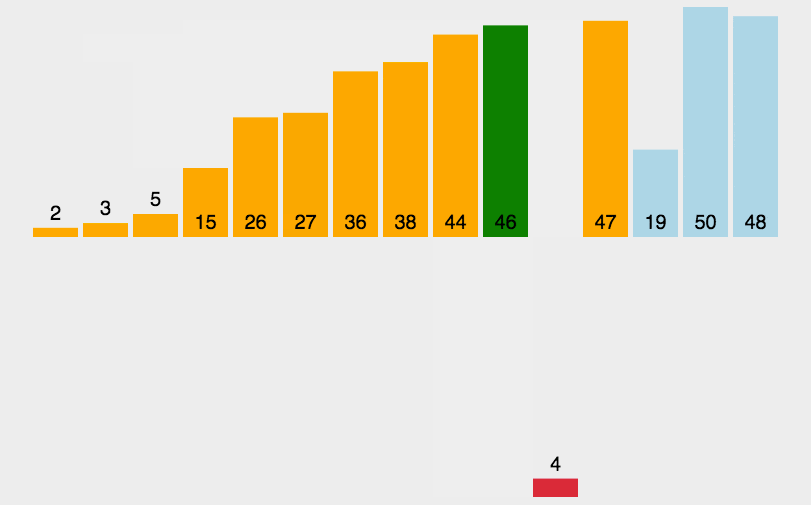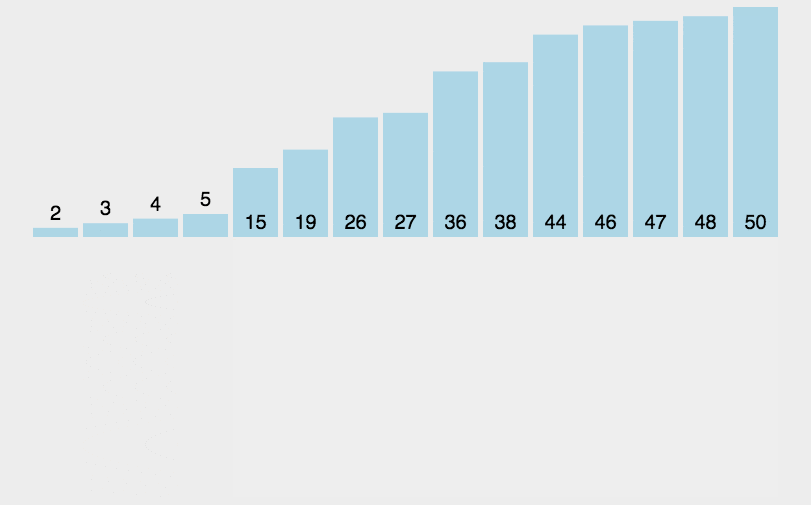
插入排序和冒泡排序一样,也有一种优化算法,叫做拆半插入。
public static void insertionSort(int[] arr) {
	// 待插入的数为从下标为1开始,因为先把下标为0的固定住了
    for (int i = 1; i < arr.length; i++) {
    	// 循环与前面的有序序列的每个值进行比较,若有序序列的下标小于0则中断循环
        for (int j = i - 1; j >= 0; j -= 1) {
            if (arr[j] > arr[j + 1]) {
                int temp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = temp;
            }
        }
    }
}
希尔排序了解即可(上午题没考过)
插入排序的代码实现虽然没有冒泡排序和选择排序那么简单粗暴,但它的原理应该是最容易理解的了,因为只要打过扑克牌的人都应该能够秒懂。插入排序是一种最简单直观的排序算法,它的工作原理是通过构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入。
public static void shellSort(int[] arr) {
    for (int step = arr.length / 2; step > 0; step /= 2) {
        //核心代码就是插入排序,把所有的一替换成step
        for (int i = step; i < arr.length; i++) {
            for (int j = i - step; j >= 0; j -= step) {
                if (arr[j] > arr[j + step]) {
                    int temp = arr[j];
                    arr[j] = arr[j + step];
                    arr[j + step] = temp;
                }
            }
        }
    }
}
简单选择排序和堆排序
简单选择排序
每一次遍历确定一个位置上的元素
- 第一个开始从左向右
- 找到这个位置右边的最小元素,然后交换到这里
- 进行下一个位置
public static void selectionSort(int[] arr) {
	// 5个元素只需要选择4次,因为最后一个默认为最大的
    for (int i = 0; i < arr.length - 1; i++) {
        int minIndex = i;
        // 从第二个元素开始比较,找出最小值下标
        for (int j = i + 1; j < arr.length; j++) {
            if (arr[j] < arr[minIndex]) {
                minIndex = j;
            }
        }
        if (minIndex != i) {
            int temp = arr[minIndex];
            arr[minIndex] = arr[i];
            arr[i] = temp;
        }
    }
}
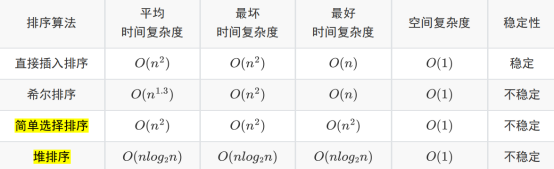
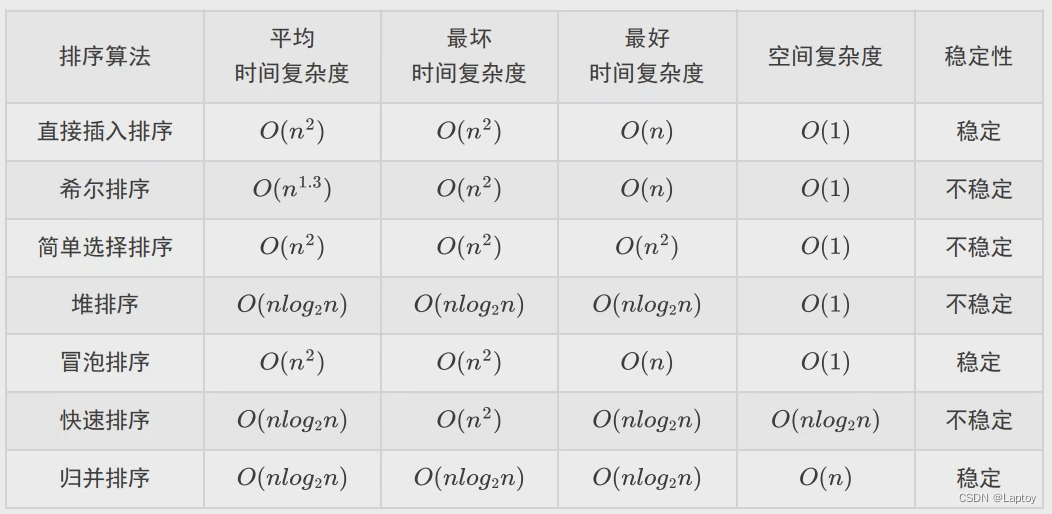
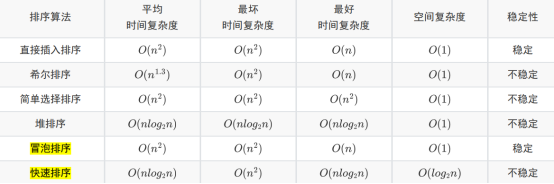
直接背简单选择排序和堆排序的时间、空间复杂度和稳定性即可。
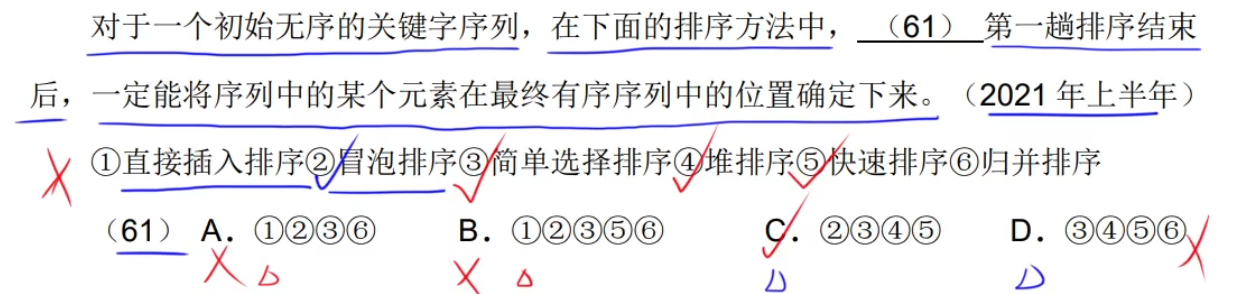
简单选择排序和堆排序都是在一次排序后就确定一个元素的最终位置
冒泡排序
- 第一个开始从左向右
- 拿左边元素和右边比较,左边大就交换,一直交换到最后一个元素
- 这就确保了从左边开始,一直能找出最大的元素放在最右边
- 这里就唯一确定了右边最大的元素的位置,那么就要确定第二大位置的元素了
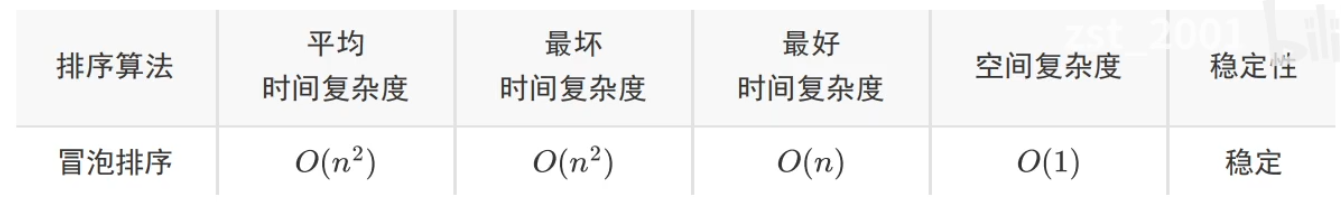
public static void bubbleSort(int[] arr) {
    for (int i = 0; i < arr.length - 1; i++) {
        for (int j = 0; j < arr.length - 1 - i; j++) {
            if (arr[j] > arr[j + 1]) {
                int temp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = temp;
            }
        }
    }
}
快速排序
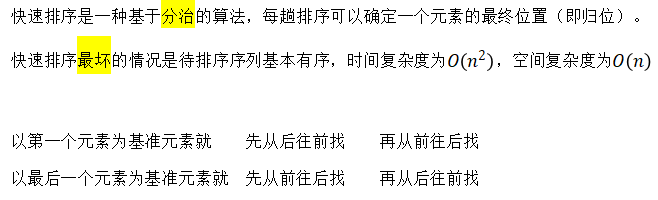
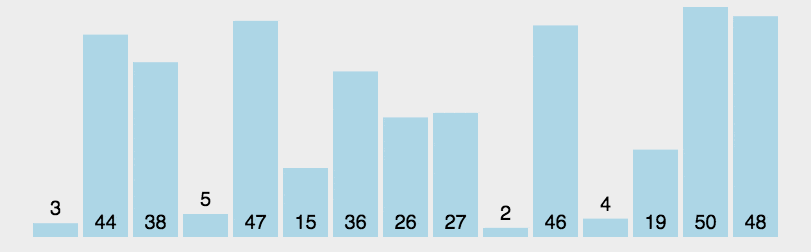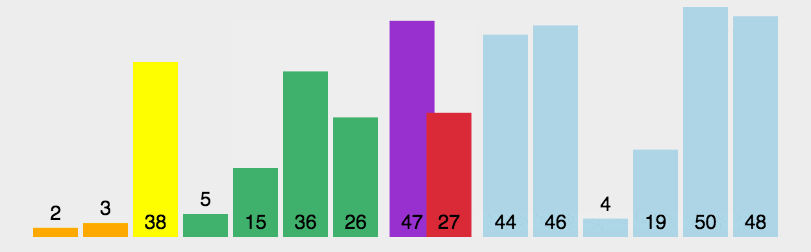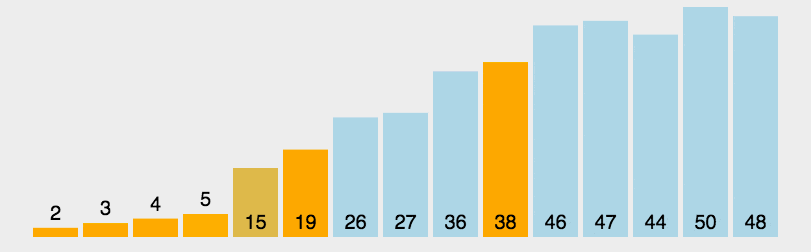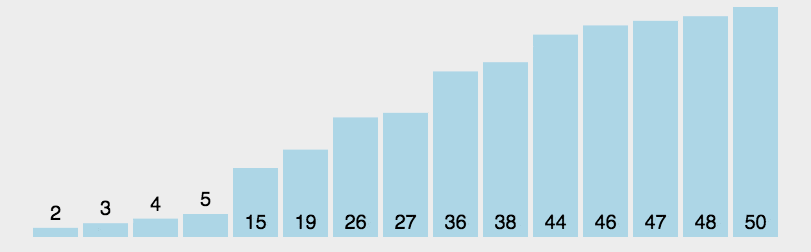
// 首元素为基准值
public static void quickSort(int[] arr, int left, int right) {
    if (left >= right) {
        return;
    }
    int i = left, j = right, pivot = arr[i];

    while (i < j) {
    	// 从右开始找比基准值小的元素
        while (i < j && arr[j] >= pivot) j--;
        // 将该元素放在最左侧
        arr[i] = arr[j];
        // 从左开始找比基准值大的元素
        while (i < j && arr[i] <= pivot) i++;
        arr[j] = arr[i];
    }
    arr[i] = pivot;

    quickSort(arr, left, i - 1);
    quickSort(arr, i + 1, right);
}
归并排序
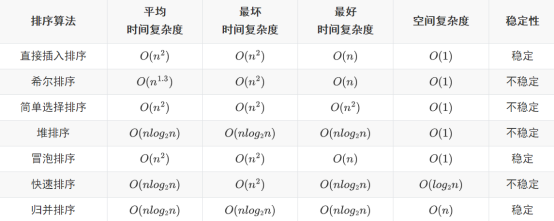
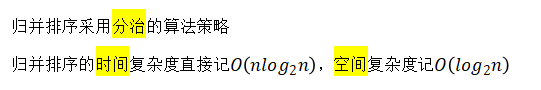
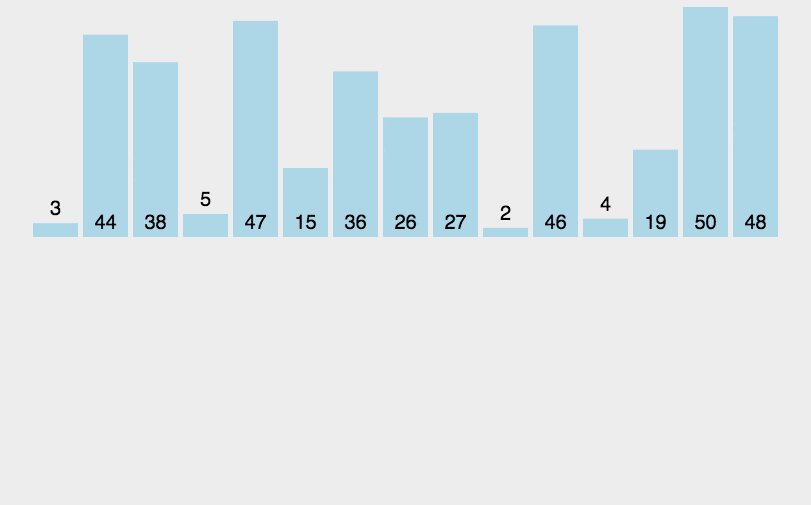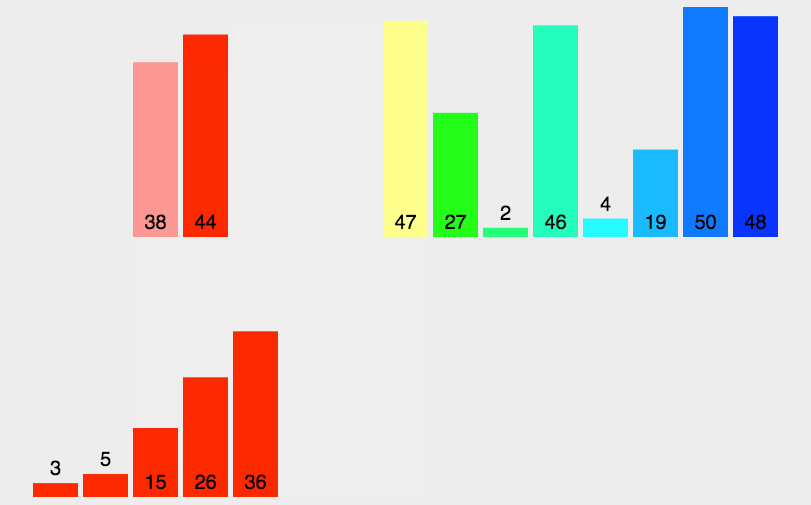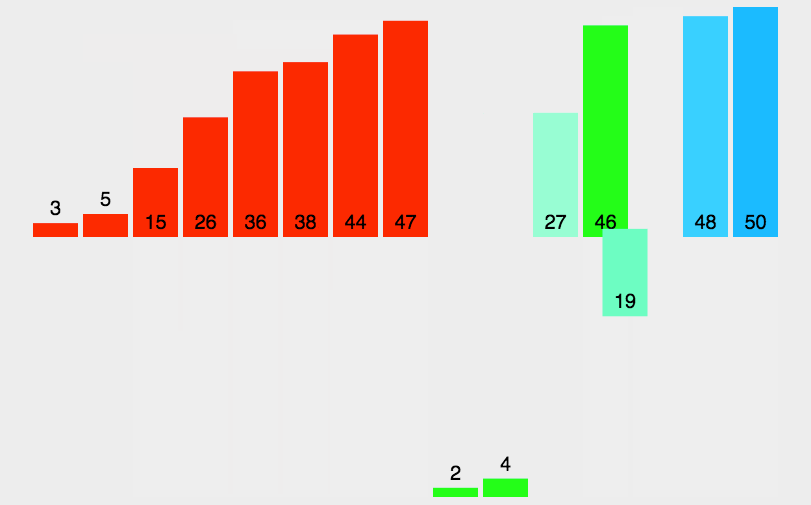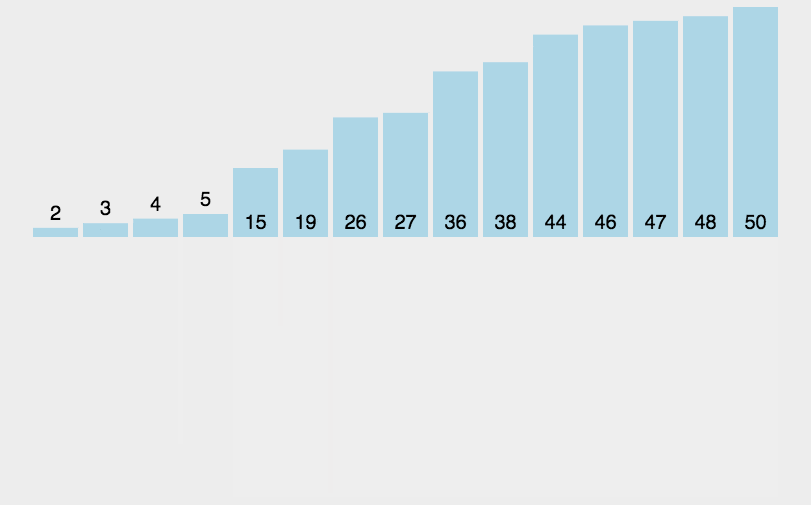
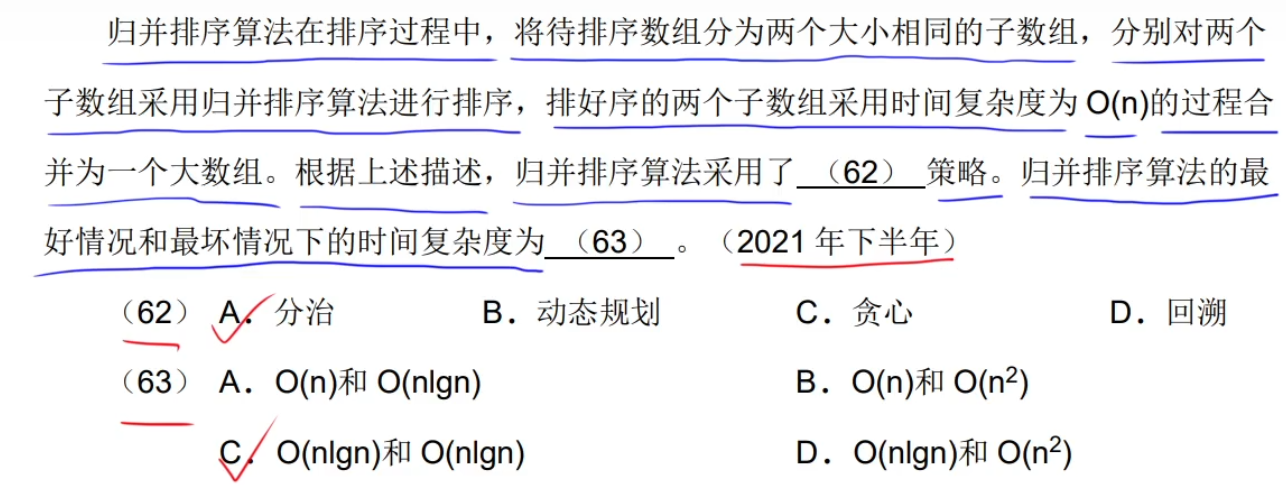
归并排序(Merge sort)是建立在归并操作上的一种有效的排序算法。该算法是采用分治法(Divide and Conquer)的一个非常典型的应用。
作为一种典型的分而治之思想的算法应用,归并排序的实现由两种方法:
- 自上而下的递归(所有递归的方法都可以用迭代重写,所以就有了第 2 种方法);
- 自下而上的迭代;
// 分+合 默认值
public static void mergeSort(int[] arr) {
    mergeSort(arr, 0, arr.length - 1, new int[arr.length]);
}

// 分+合
public static void mergeSort(int[] arr, int left, int right, int[] temp) {
    if (left < right) {
        int mid = (left + right) / 2;

        // 向左分解
        mergeSort(arr, left, mid, temp);
        // 向右分解
        mergeSort(arr, mid + 1, right, temp);

        // 合并
        merge(arr, left, mid, right, temp);
    }
}

// 治
public static void merge(int[] arr, int left, int mid, int right, int[] temp) {
    int i = left;    // 左边序列初始索引
    int j = mid + 1; // 右边序列初始索引
    int t = 0;       // temp数组的当前索引

    // 1)先把左右序列按顺序填充到temp数组,直到左右序列有一方处理完毕
    while (i <= mid && j <= right) {
        // 如果左序列的值小于右序列则进行存放并将左序列指针右移
        if (arr[i] < arr[j]) {
            temp[t] = arr[i];
            t++;
            i++;
        } else { // 如果右序列的值小于等于左序列则进行存放并将右序列指针右移
            temp[t] = arr[j];
            t++;
            j++;
        }
    }

    // 2)把有剩余数据的一边序列全部填充到temp
    // 如果左边还有剩余
    while (i <= mid) {
        temp[t] = arr[i];
        t++;
        i++;
    }
    // 如果右边还有剩余
    while (j <= right) {
        temp[t] = arr[j];
        t++;
        j++;
    }

    // 3)将temp数组的元素拷贝回arr
    t = 0;
    int tempLeft = left;
    while (tempLeft <= right) {
        arr[tempLeft] = temp[t];
        t++;
        tempLeft++;
    }
}
归并排序的最好最坏时间复杂度相等
第一趟排序就能确定某个元素的位置:
冒泡、简单选择、堆、快速

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献1条内容

所有评论(0)