解锁LightRAG:在Dify低代码平台构建高效RAG应用
引言:挣脱传统RAG的枷锁,拥抱轻量化新范式
自大语言模型(LLM)问世以来,检索增强生成(Retrieval-Augmented Generation, RAG)技术便成为业界公认的、解决模型"幻觉"问题、引入外部私有知识的关键路径。通过将信息检索与文本生成相结合,RAG系统能够为LLM提供实时、准确、可追溯的知识源,从而生成更可靠、更具上下文的回答。然而,随着应用的深入,传统RAG方案的局限性也日益凸显。
传统RAG面临着一个核心瓶颈: 上下文理解不足。多数RAG系统依赖扁平化的数据表示,将文档切割成独立的文本块(Chunks)。这种方式割裂了知识间的内在联系,导致模型难以理解和回答需要跨文档、多跳转推理的复杂问题,最终产出碎片化的答案。
现有工作缺乏对实体间相互联系的充分探索,导致面对复杂的高级问题时无法有效结合多个方面的信息进行联系和总结。比如当被问到 “电动汽车的增长如何影响城市空气质量和公共交通设施?” 这样复杂的问题时,传统 RAG 系统可能会分别检索到关于电动汽车、空气污染和公共交通挑战的文档,但难以将这些信息整合成一个连贯的回答,无法解释电动汽车的普及如何改善空气质量,进而影响公共交通规划。
在此背景下,一个为效率与深度而生的轻量化、图增强RAG框架------LightRAG应运而生。它由香港大学等团队研发,旨在通过创新的架构设计,以更低的资源消耗实现更优的检索性能和上下文理解能力。
本文的核心议题,正是探索如何在不修改Dify这一领先的低代码LLM应用开发平台源码的前提下,将LightRAG的强大能力与Dify的敏捷开发特性无缝结合,实现"1+1>2"的协同效应,为开发者提供一套构建下一代智能知识库的全新范式。
第一部分:深度解构LightRAG------为何它既"轻"又"强"?
要理解如何集成,必先理解其本质。LightRAG并非对现有RAG技术的简单修补,而是一次从底层设计哲学出发的重构。它旨在解决传统RAG乃至其变体GraphRAG在上下文理解、检索效率和动态数据适应性上的核心挑战。
LightRAG的诞生背景
尽管GraphRAG等方案尝试引入知识图谱来增强上下文,但它们往往流程复杂,例如微软的GraphRAG依赖社区发现和摘要生成,这在某些场景下增加了不必要的开销。LightRAG则采取了更为精简和直接的路径,其核心理念是:将图结构作为索引和检索的核心,而非附加层,并通过一系列创新设计,在"轻量化"和"强大性能"之间取得精妙平衡。
核心创新一:图谱化文本索引 (Graph-based Text Indexing)
LightRAG的第一个颠覆性创新在于其知识索引方式。它不再将文本视为孤立的数据块,而是致力于将非结构化文本转化为一个高度结构化、关系明确的知识图谱。这一过程克服了传统RAG基于"孤立文本块"进行相似度搜索的局限性,能够捕捉实体之间深层次、跨越多个文档的复杂关系。
该过程主要分为三步曲,均由LLM深度参与:
- 实体与关系抽取 (Entity & Relationship Extraction):首先,将原始文档切分为可管理的文本块(Chunks)。接着,利用LLM强大的自然语言理解能力,从每个Chunk中识别出关键实体(如人、组织、概念)作为图谱的"节点",并抽取出它们之间的关系(如"诊断"、“影响”、“属于”)作为图谱的"边"。
- LLM赋能的键值对生成 (LLM Profiling for Key-Value Pair Generation):为图谱中的每个实体(节点)和关系(边),LightRAG会再次调用LLM生成一个优化的键值对(K-V)。其中,Key是用于高效检索的关键词或短语,而Value则是一段总结性的描述文本。这种方法比单纯依赖向量嵌入进行模糊匹配更为精准和高效。
- 去重与合并(Deduplication):在处理海量文档时,同一个实体或关系可能在不同地方被多次提及。LightRAG通过一个去重函数,智能地识别并合并这些来自不同文本源的相同实体与关系,从而优化图谱结构,减少冗余,提升后续图操作的效率。
核心创新二:双层检索范式 (Dual-level Retrieval Paradigm)
拥有了知识图谱后,如何高效地利用它来回答问题是关键。LightRAG为此设计了精巧的"双层检索范式",旨在同时兼顾查询的精确性(Precision)与广度(Comprehensiveness),能够灵活应对从"具体事实查询"到"抽象概念推理"的各类用户问题。
其核心在于,对用户的每个查询,LightRAG都会利用LLM提取出两个层级的关键词:
- 低层检索 (Low-Level Retrieval):这一层聚焦于具体的实体和细节。它通过从用户查询中提取的"低层关键词"(如人名、地名、产品型号、法规条款等专业术语)来精确匹配知识图谱中的特定节点。这保证了对于事实性问题的回答准确无误。
- 高层检索 (High-Level Retrieval):这一层则关注抽象的概念和主题。它通过提取"高层关键词"(如"经济影响"、“环境后果”、"风险评估"等)来匹配图谱中的关系或聚合多个相关节点的信息。这使得LightRAG能够进行跨文档、多跳的知识推理,回答那些需要综合分析才能得出结论的复杂问题。
这种混合检索策略,结合了图结构与向量表示,使得LightRAG能够高效地利用局部和全局信息,极大地提升了检索的相关性和全面性。
核心创新三:高效增量更新 (Incremental Update)
针对传统RAG知识库更新成本高、时效性差的痛点,LightRAG提出了高效的增量更新机制。当有新文档需要加入知识库时,系统无需对整个知识库进行全量重新索引。
其机制非常简洁:新文档会经过与初始索引相同的图谱化处理流程,生成一个新的子图。然后,这个新子图会被无缝地合并到现有的主知识图谱中(通过节点和边的并集操作)。
这一设计的价值是巨大的:它极大地降低了计算开销和维护成本,确保知识库能够以近乎实时的方式响应动态变化的数据环境,这对于新闻、金融、法律等时效性要求高的领域至关重要。
第二部分:Dify平台解析------RAG应用开发的"敏捷工作台"
在深入探讨集成方案之前,我们有必要了解集成的另一端------Dify。Dify作为一个强大的LLM应用开发平台,其设计初衷就是为了简化和加速AI应用的构建、部署和管理过程。
Dify定位
Dify是一个开源的、可视化的LLM应用开发平台,它将复杂的后端技术栈(如模型管理、RAG管道、Agent工作流)封装在直观的界面之下,让开发者能够通过"拖拉拽"的方式快速构建从原型到生产级别的AI应用。其核心价值在于"敏捷性",极大地降低了AI应用的开发门槛。
与集成相关的核心功能
对于我们即将展开的集成任务,Dify的以下几个核心功能至关重要:
- 知识库管理与API:Dify拥有完善的知识库功能,支持多种文件格式的上传。更重要的是,它提供了RESTful API,允许程序化地创建、管理知识库和文档分段。这是我们实现"外部处理,内部调用"方案的基石。
- 工作流 (Workflow):这是Dify的"大脑"。工作流提供了一个可视化的画布,开发者可以通过拖拽不同的功能节点(如LLM、代码执行、HTTP请求等)并连接它们,来构建复杂的应用逻辑。其中,"HTTP请求"节点是我们实现与外部LightRAG服务实时通信的关键所在。
- Agent与工具(Agent&Tools): Dify的Agent能力使LLM能够自主规划任务流程,并依次调用多个工具来完成复杂操作。这些工具可以是内部功能模块,也可以是外部API(如LightRAG服务)封装而成的自定义工具。Agent在推理过程中根据任务需求,动态选择并调用合适的工具,从而实现更高程度的自动化与智能化处理。这种方式提升了LLM在实际应用中的灵活性与执行效率。
- **外部知识库插件(External Knowledge)**: Dify设计了灵活的插件系统,允许开发者接入自建的或第三方的知识库服务。通过开发一个符合Dify规范的插件,我们可以让LightRAG像Dify的原生知识库一样被无缝使用,这是最高级的集成方式。
第三部分【核心章节】:鱼与熊掌兼得------LightRAG与Dify的集成方案与实战
现在,我们进入核心环节:如何将LightRAG的"强大"与Dify的"敏捷"结合起来。我们将探讨两种由浅入深、各有侧重的集成方案。
集成原则
所有方案都严格遵守一个核心原则:不修改Dify平台的任何源代码。我们将在应用层面,通过服务编排和插件开发等方式,实现两者的协同工作,确保方案的通用性和可维护性。
方案一:API服务化,工作流编排 (LightRAG as a Service + Dify Workflow)
思路:这是最能发挥LightRAG优势的方案。我们将LightRAG作为一个独立的、专门负责高级检索的微服务来部署。在Dify中,我们构建一个工作流(Workflow),当用户提出问题时,工作流首先通过HTTP请求节点,实时调用LightRAG的查询API。LightRAG执行其强大的双层图谱检索,返回最相关的、高度浓缩的上下文信息。然后,工作流将这些上下文连同原始问题一起,作为Prompt喂给LLM节点进行最终的答案生成。
实施流程:
-
部署LightRAG服务:按照LightRAG官方文档,配置好
.env文件后,使用lightrag-server或lightrag-gunicorn命令启动API服务。服务启动后,可以通过浏览器访问其Swagger UI(通常在http://localhost:9621/docs),查看和测试所有API端点。 -
Dify工作流设计:
           背景知识:
           ---
           {{http_request_1.body.context}}
           ---
           请根据以上背景知识,回答用户的问题。如果背景知识无法回答,请明确告知。

           用户问题:{{userInput}}
-
结束节点:将LLM节点的输出连接到结束节点,作为应用的最终答复。
-
Prompt:精心设计Prompt,将用户问题和从HTTP节点获取的上下文结合起来。HTTP节点的输出可以通过变量
{{http_request_1.body.context}}(具体路径取决于LightRAG API的返回结构)来引用。 -
请求URL:填写LightRAG服务的查询端点,如
http://your-lightrag-host:9621/query。 -
请求方法:选择
POST。 -
Headers:设置
Content-Type为application/json。 -
Body:选择
raw格式,内容为JSON。在这里,我们将开始节点的输入变量嵌入其中:{"query": "{{userInput}}", "mode": "hybrid"}。hybrid模式能同时利用低层和高层检索。 -
在Dify中创建一个新的"工作流"应用。
-
开始节点:默认存在,定义应用的输入变量,例如
userInput。 -
HTTP请求节点:这是核心。从节点库中拖入一个"HTTP请求"节点。
-
LLM节点:拖入一个大语言模型节点(如GPT-4)。
优劣分析:
- 优点:完美利用了LightRAG的双层图谱检索能力,能够处理极其复杂的、需要深度推理的查询,回答质量最高。架构解耦,职责清晰。
- 缺点:需要额外部署和维护一个LightRAG服务,对系统架构和运维提出了一定要求。
方案二(进阶):开发Dify外部知识库插件
思路:此方案追求最无缝、最原生的集成体验。我们为LightRAG开发一个符合Dify"外部知识库"规范的插件。一旦安装,用户在Dify应用中配置知识库时,就可以像选择原生知识库一样,直接选择"LightRAG知识库"。Dify在后台会自动调用我们插件定义的API来完成检索。
实施概要:
- 理解Dify插件机制:首先需要深入研究Dify的插件开发文档。外部知识库插件本质上是一个遵循特定API契约的HTTP服务。Dify会向该服务的一个标准端点(如
/retrieval)发送查询请求。 - 创建中间适配层服务:使用Python的FastAPI或Flask等框架,创建一个新的Web服务。这个服务作为"适配器",其作用是:
- 对外,暴露一个完全符合Dify外部知识库API规范的
/retrieval接口。 - 对内,接收到Dify的请求后,将其转换为LightRAG能理解的查询格式,然后调用已部署的LightRAG服务的
/query接口。 - 最后,将LightRAG返回的结果,再次包装成Dify要求的格式返回。
- 在Dify中配置和使用:将这个适配器服务部署后,在Dify的"知识库"->"连接外部知识库"中,填入该服务的URL和必要的认证信息,即可完成插件的添加。之后,在任何应用中都可以直接选用这个外部知识库。
价值:此方案提供了最佳的用户体验和最高的集成度,将LightRAG的能力"内化"为Dify平台的一部分。然而,它的开发成本也是最高的,需要对Dify和LightRAG的API都有深入的理解。
第四部分:动手实践------从零开始搭建集成环境
本部分将以方案一(API服务化,工作流编排)为例,提供一个手把手的教程,让开发者能够快速复现其核心流程。
环境搭建
-
安装LightRAG:确保你的Python环境(推荐3.10+)已就绪,然后执行:
pip install lightrag-hku -
配置环境变量:在你的项目根目录创建一个名为
.env的文件。LightRAG支持多种后端,这里以Ollama为例:# .env file LLM_BINDING=ollama LLM_MODEL=qwen2:7b # 你本地Ollama中已有的模型 EMBEDDING_BINDING=ollama EMBEDDING_MODEL=mxbai-embed-large # 你本地Ollama中已有的嵌入模型 EMBEDDING_DIM=1024确保你的Ollama服务正在运行且已拉取所需模型。
-
启动LightRAG服务:在项目根目录(
.env文件所在目录)打开终端,运行:lightrag-server --port 9621如果看到服务成功启动的日志,说明环境已就绪。
文档索引
你可以通过LightRAG提供的Web UI(访问http://localhost:9621)上传文档,也可以使用API。这里展示使用curl上传一个文本文件example.txt:
# 创建一个示例文档
echo"LightRAG是一个轻量级的RAG框架,它使用知识图谱来增强检索能力。Dify是一个低代码AI应用平台。" > example.txt

# 使用curl上传文件
curl -X POST "http://localhost:9621/documents/file" \
-F "file=@example.txt" \
-F "description=A test document about LightRAG and Dify"
上传成功后,LightRAG会自动在后台进行索引。你可以访问Web UI的"Knowledge Graph"页面,查看生成的知识图谱,直观感受文本是如何被结构化的。

LightRAG提供的Web UI,可以直观地探索文档索引后生成的知识图谱
Dify配置演练
现在回到Dify平台,创建一个工作流应用。以下是HTTP请求节点和LLM节点的详细配置:
1. HTTP请求节点配置
-
节点名称:可命名为
Query\_LightRAG -
请求URL:
http://<你的内网IP或localhost>:9621/query(确保Dify能访问到LightRAG服务) -
请求方法:
POST -
**Body (raw, application/json)**:
{
    "query": "{{#start.userInput#}}",
    "mode": "hybrid"
}
2. LLM节点配置
-
节点名称:可命名为
Generate\_Answer -
Prompt模板:
你是一个专业的问答助手。请严格根据下面提供的“背景知识”来回答“用户问题”。

[背景知识]
{{#Query_LightRAG.body.context#}}

[用户问题]
{{#start.userInput#}}

请生成你的回答:
将"开始"节点连接到Query\_LightRAG节点,再将Query\_LightRAG节点连接到Generate\_Answer节点,最后连接到"结束"节点。保存并发布工作流。
端到端测试
在Dify应用的调试界面,输入一个需要结合我们上传的文档内容才能回答的问题,例如:“LightRAG和Dify分别是什么?”
点击运行,你将能观察到整个流程:
- Dify将问题发送给
Query\_LightRAG节点。 - 该节点调用LightRAG服务,LightRAG执行图谱检索,返回包含两个实体及其描述的上下文。
- 返回的上下文被填充到
Generate\_Answer节点的Prompt中。 - LLM基于高质量的上下文,生成准确、全面的回答。
至此,我们成功地在不修改任何一方代码的情况下,将LightRAG的深度检索能力与Dify的敏捷开发流程完美结合。
结论:当轻量遇上敏捷,释放企业知识生产力
本文深入剖析了LightRAG框架如何通过图谱化文本索引、双层检索范式和高效增量更新三大创新,有效解决了传统RAG在上下文理解、资源消耗和知识时效性方面的核心痛点。同时,我们详细探讨并实践了在Dify低代码平台中集成LightRAG的两种可行方案。
核心总结与建议
- 方案一(API服务化+工作流编排):是本文推荐的最佳实践。它最大化地发挥了LightRAG的优势,尤其适合需要处理复杂、跨领域、需要深度推理的查询的企业级应用。
- 方案二(开发插件):为追求极致原生体验和大规模部署的团队提供了终极方向,但需要更高的开发投入。
当LightRAG的"轻盈而强大"遇上Dify的"敏捷而全面",我们看到的不仅仅是两个工具的简单叠加,而是一种全新的、能够高效构建企业级智能知识中枢的潜力。展望未来,将LightRAG服务作为Dify Agent的一个核心工具,将使其能够自主地进行"检索-分析-决策"的长链条任务,例如自动生成市场分析报告、进行法律案例比对等,真正将企业沉睡的知识数据转化为可行动的生产力。这,正是LightRAG与Dify结合带给我们的未来启示:智能,可以既轻盈又强大,既深度又敏捷。
大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?
答案当然是这样,大模型必然是新风口!
那如何学习大模型 ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:
最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!
在这个版本当中:
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
一、大模型经典书籍(免费分享)
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。
二、640套大模型报告(免费分享)
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、大模型系列视频教程(免费分享)

四、2025最新大模型学习路线(免费分享)
我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。
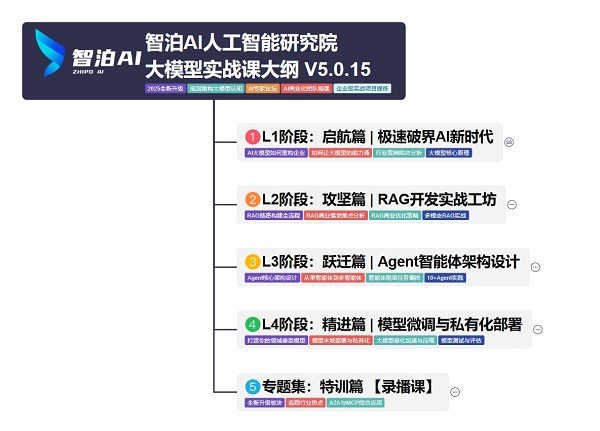
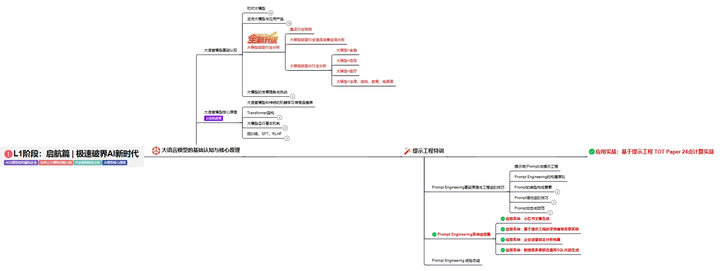
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
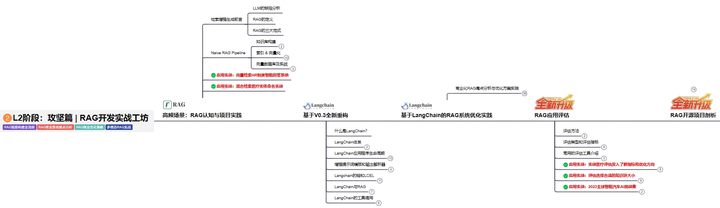
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
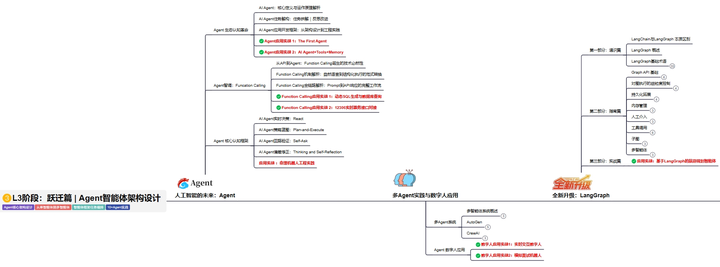
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
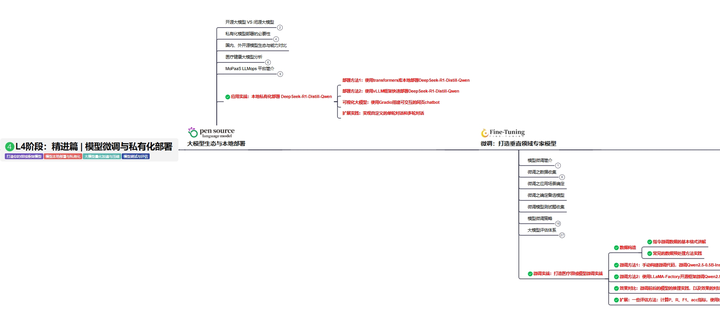
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
L5阶段:专题集丨特训篇 【录播课】
全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 12
 0
- 0


 已为社区贡献33条内容

所有评论(0)