一文搞懂大模型的知识蒸馏(Knowledge Distillation),大模型入门到精通,收藏这篇就足够了!
你刚买了最新的iPhone,兴奋地想要在手机上运行GPT、Qwen、DeepSeek等主流大模型。然而现实却给了你一记重锤——即使是最强的手机芯片,也根本跑不动那个拥有1750亿参数的庞然大物。
能不能让小模型拥有大模型的智慧?
这就是知识蒸馏要解决的问题。就像武功传承一样——让高手(大模型)把经验传授给徒弟(小模型)。
这篇文章会告诉你:
- 为什么大模型的"谦虚"比"自信"更有价值?
- 小模型如何学习大模型的思考过程?
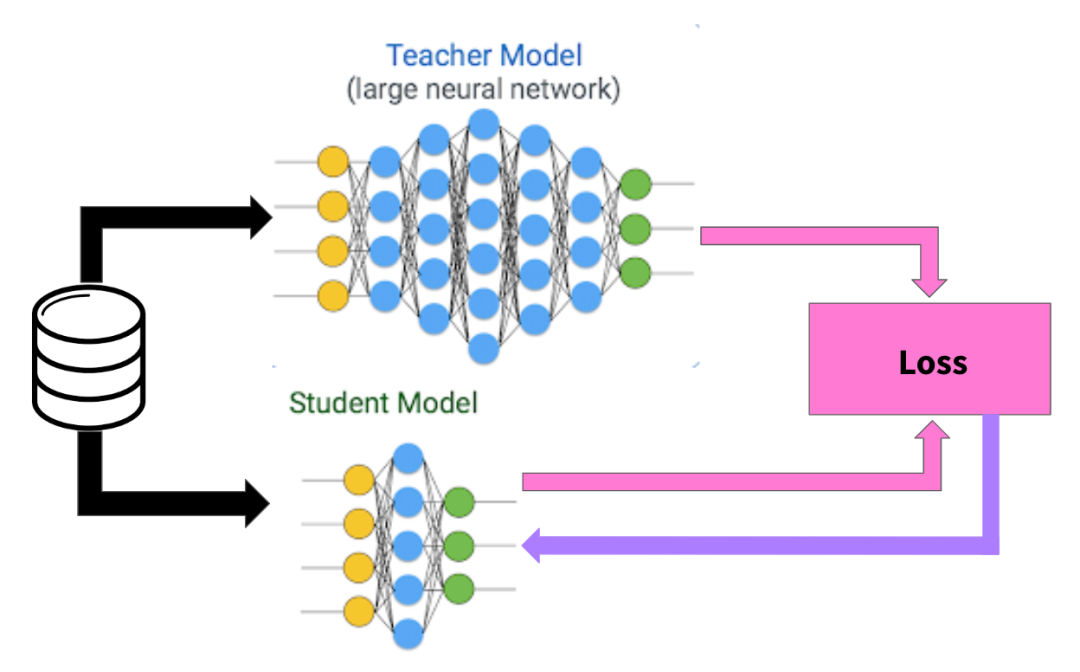
一、模型温度:让模型"说出真心话"
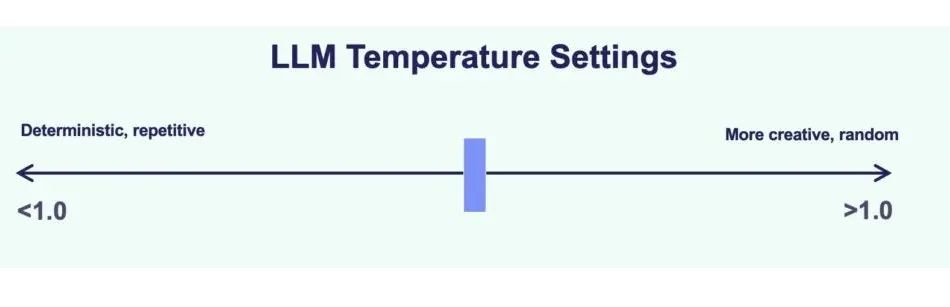
模型的温度参数(Temperature)是什么?
(1)从一个翻译例子说起
研究人员训练了一个超大的翻译模型,翻译质量接近人类专业译者。当他们要把"我很饿"翻译成英文时,模型给出了标准答案:“I am hungry”。
但是,当研究人员深入查看模型内部时,发现了一个有趣的现象。模型的"内心独白"其实是这样的:
输入:"我很饿"模型的思考过程:
- “I am hungry” (最佳翻译) - 85%
- “I’m hungry” (口语化) - 12%
- “I feel hungry” (更正式) - 2%
- “I am starving” (更强烈) - 1%
你看,这个大模型不只是知道标准答案,它还理解了语言的细微差别:什么时候用缩写,什么时候用正式表达,甚至知道"饿"的不同程度。这些概率分布包含了模型对语言的深层理解。
(2)温度参数(Temperature),控制模型"谦虚"程度的开关
如何让模型把这些宝贵的"内心想法"表达出来?这就是温度参数发挥作用的地方。在实际操作中,我们用一个叫"温度"(Temperature)的参数来控制模型输出概率分布的"平滑程度"。
-
低温度(T=1):模型很"自信",输出:[85%, 15%, 0%, 0%] - 只关注最优答案
-
高温度(T=5):模型变"谦虚",输出:[45%, 35%, 15%, 5%] - 承认其他可能性
(3)为什么"谦虚"的模型更有价值?
这就像问一个翻译专家:“这句话怎么翻译?”
(1)自信的专家(低温度):“I am hungry!就这样翻译!”
→ 学生只学到了答案,没学到思考过程
(2)谦虚的专家(高温度):“主要是’I am hungry’,不过口语中也可以说’I’m hungry’,如果想表达更强烈的饥饿感可以用’I’m starving’,正式场合可能更适合’I feel hungry’…”
→ 学生不仅学到了答案,还学到了语言的微妙差别和使用场景
温度参数本质上是在控制模型"教学"的方式。高温度让模型变成一个好老师,不仅给出答案,还解释为什么这样回答,什么情况下可以有其他选择。
这种"谦虚"的概率分布包含了模型的核心智慧,正是知识蒸馏技术想要传递给小模型的宝贵知识。
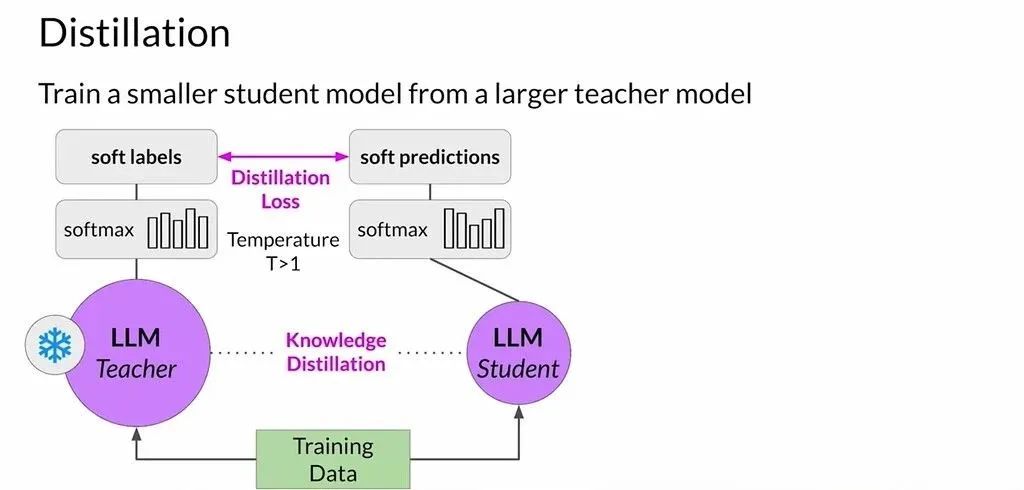
二、知识蒸馏:让小模型"偷师学艺"
知识蒸馏(Knowledge Distillation)如何让小模型"偷师学艺"?
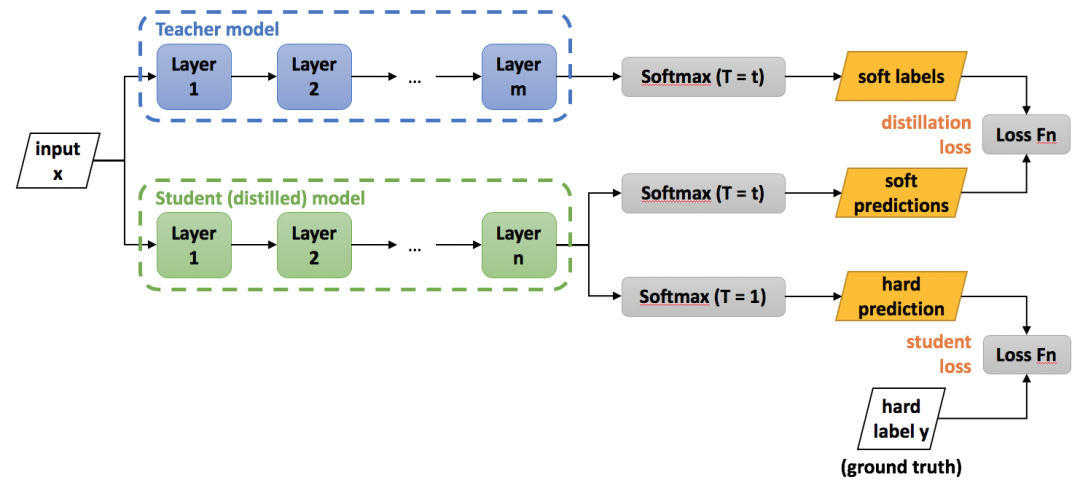
知识蒸馏的巧妙之处在于,让小模型不只学习答案,更要学习大模型的"思考过程"。
还是刚才的例子。
大模型(老师):"我很饿"应该翻译成:
- “I am hungry” - 85%
- “I’m hungry” - 12%
- “I feel hungry” - 2%
- “I am starving” - 1%
小模型(学生):我不只要学会输出"I am hungry",还要理解为什么其他翻译也有一定可能性,以及它们之间的微妙区别。
这样训练出来的小模型,就能在遇到"我饿死了"时,知道应该选择更强烈的表达"I’m starving"。
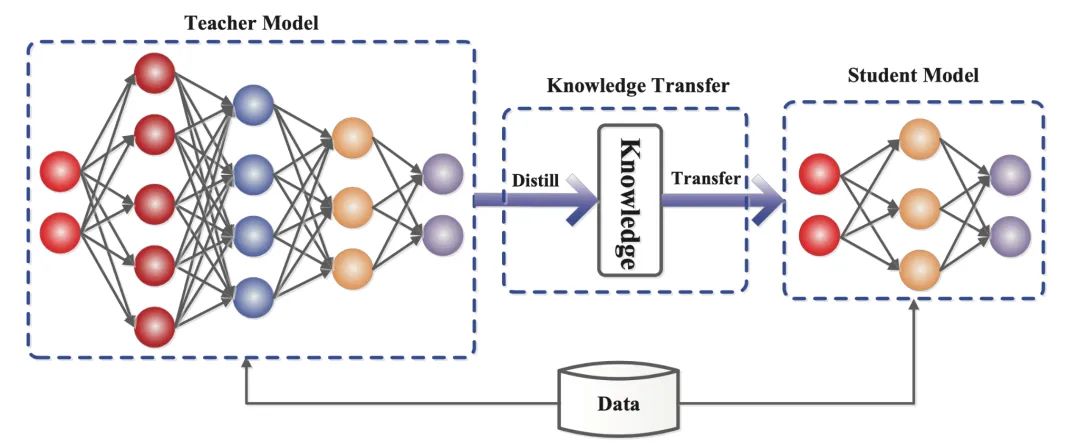
知识蒸馏(Knowledge Distillation)的训练过程是什么?
知识蒸馏的训练分为两个阶段:
(1)第一阶段:训练老师
用海量数据训练一个大而强的翻译模型,不在乎模型大小和推理速度,只追求翻译质量。
(2)第二阶段:老师教学生
- 给老师和学生看同一个中文句子
- 老师输出"软"概率分布(包含多种翻译可能性)
- 学生不只学标准答案,更学老师的概率分布
- 逐渐让学生的思考方式接近老师
这个过程就像一个经验丰富的译者在指导新手:不只告诉你怎么翻译,还告诉你为什么这样翻译,什么情况下可以有其他选择。
大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?
答案当然是这样,大模型必然是新风口!
那如何学习大模型 ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:
最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!
在这个版本当中:
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
一、大模型经典书籍(免费分享)
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。
二、640套大模型报告(免费分享)
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、大模型系列视频教程(免费分享)

四、2025最新大模型学习路线(免费分享)
我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。
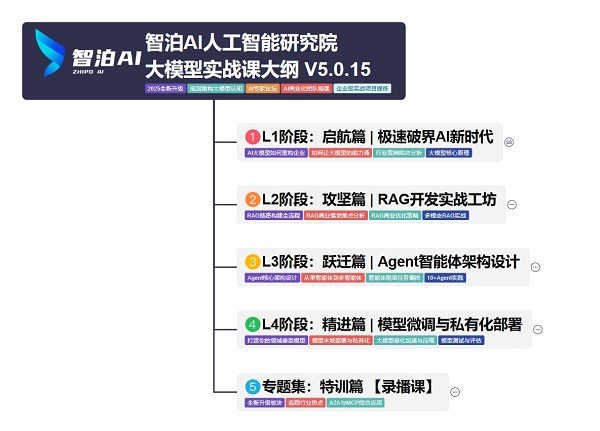
L1阶段:启航篇丨极速破界AI新时代
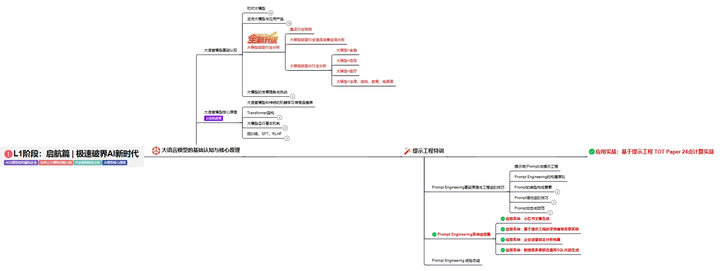
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
L2阶段:攻坚篇丨RAG开发实战工坊
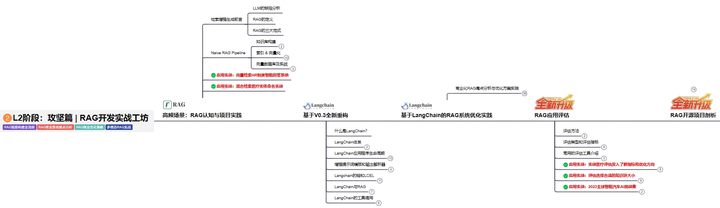
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
L3阶段:跃迁篇丨Agent智能体架构设计
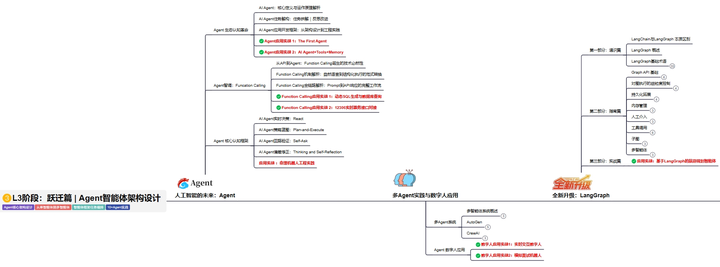
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
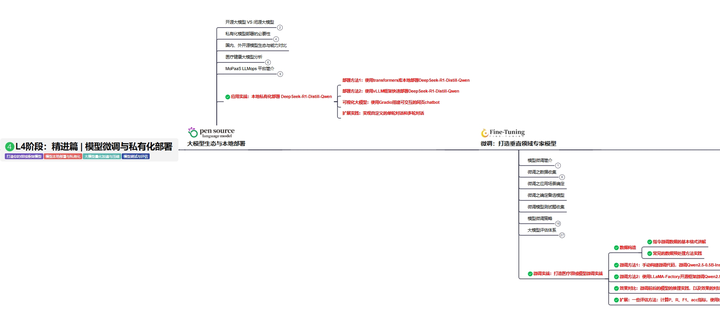
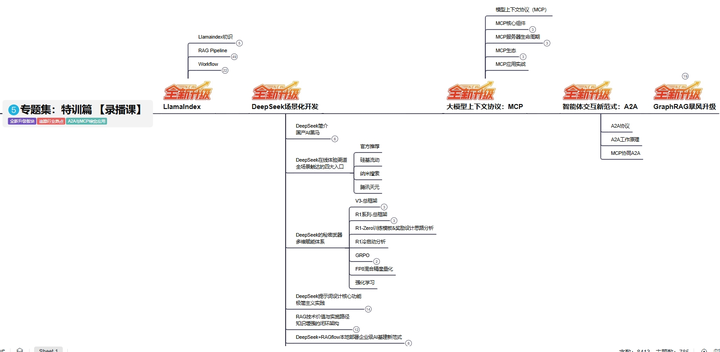
L5阶段:专题集丨特训篇 【录播课】
全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献33条内容

所有评论(0)