代码性能测试——benchmark库
·
在平常的代码开发中,我们一般用
googletest做单元测试用例,如果需要对代码如某个函数的执行时间或效率进行测量,一般用benchmark。
benchmark 是一个用于性能测试和基准测试的库。它主要用于测量代码执行的时间、效率等性能指标,帮助开发者评估不同实现之间的效率差异,或者测试特定代码片段在不同环境下的表现。
具体来说,benchmark 的作用包括:
- 性能测量:能够精确测量代码的执行时间,可以帮助开发者识别性能瓶颈。
- 比较不同实现:通过对比多个实现的执行时间,帮助开发者选择最优方案。
- 自动化基准测试:自动执行测试,减少人工干预,可以用于自动化性能评估。
- 准确性:通过多次运行来消除偶然的误差,提供更稳定的数据。
1.benchmark 安装
- 下载 benchmark 库
- 编译 benchmark 库
创建一个构建目录并使用CMake进行编译和安装:
git clone https://github.com/google/benchmark.git
git clone https://github.com/google/googletest.git benchmark/googletest # 因为编译benchmark需要googletest

cd benchmark
mkdir build
cd build
cmake .. -DCMAKE_BUILD_TYPE=Release
make -j$(nproc)
sudo make install # 安装到系统目录下
2.benchmark 介绍
2.1 示例
#include <benchmark/benchmark.h>

static void BM_SomeFunction(benchmark::State& state) {
// 在此处执行设置
for (auto _ : state) {
	// 此代码获得计时
     SomeFunction();
    benchmark::DoNotOptimize();
    }
 }

// 将该函数作为benchmark
BENCHMARK(BM_SomeFunction);
// 运行benchmark测试
BENCHMARK_MAIN();
benchmark::State& state:是 Google Benchmark 提供的一个状态对象,用于控制测试的执行。state 管理测试循环,保证代码在性能测试过程中多次执行,以获得稳定的性能结果。for (auto _ : state):是一个范围循环,benchmark::State 对象提供了类似范围的迭代支持。该循环将根据 Google Benchmark 自动确定的迭代次数运行测试代码,直到Google Benchmark认为已经收集到足够的数据为止。这种结构确保每次运行都具有相同的执行环境,帮助减少外部噪声带来的影响。benchmark::DoNotOptimize():是 Google Benchmark 提供的一个工具函数,用来防止编译器对测试代码进行优化。以确保测试中的代码不会被跳过或优化掉。这样可以确保测试结果更接近真实性能。BENCHMARK(BM_SomeFunction):这行代码注册了定义的 BM_SomeFunction 的benchmark测试,让 Google Benchmark 能够在主函数中自动调用。BENCHMARK_MAIN():是 Google Benchmark 的主函数入口,它会自动运行所有注册的benchmark测试。
2.2 benchmark 测试说明
在 for (auto _ : state) 循环中插入想要测试的代码,Benchmark 会多次执行该代码,并统计每次运行的时间,最终输出平均执行时间、CPU时间等。
默认情况下,Benchmark会自动测量每次迭代的时间。但有时可能需要排除一些准备工作的时间,可以使用state.PauseTiming()和state.ResumeTiming()来暂停和恢复计时:
for (auto _ : state) {
  state.PauseTiming();
  // 不需要计入时间的函数
  SomeFunctionNoTimekeeping();
  state.ResumeTiming();

  SomeFunction();
}
2.3 benchmark 计时
Benchmark 库使用标准库中的 std::chrono 提供的高精度时钟(通常是 std::chrono::high_resolution_clock)来进行计时。这是C++中的高精度时钟,通常提供纳秒级别的精度,在运行代码之前和之后记录时钟时间,计算代码执行所耗费的时间。
Benchmark 的 State 类会控制迭代次数,并在性能测试开始和结束时调用时钟进行时间测量。
benchmark::State 会自动控制测试运行的起始时间、迭代次数和循环。在测试完成后,Benchmark 会汇总这些数据,输出迭代次数、平均执行时间等性能指标。
3.示例
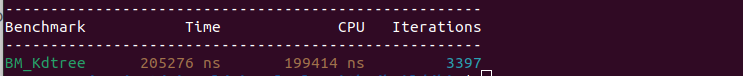
测试kdTree()耗时
#include <pcl/console/time.h>
#include <pcl/point_cloud.h> //点类型定义头文件
#include <pcl/kdtree/kdtree_flann.h> //kdtree类定义头文件

int kdTreeTest()
{
    srand(time(NULL)); //用系统时间初始化随机种子
    //创建一个PointCloud<pcl::PointXYZ>
    pcl::PointCloud<pcl::PointXYZ>::Ptr cloud(new pcl::PointCloud<pcl::PointXYZ>);

    // 随机点云生成
    cloud->width  = 1000; //此处点云数量
    cloud->height = 1;    //表示点云为无序点云
    cloud->points.resize(cloud->width * cloud->height);

    for (size_t i = 0; i < cloud->points.size(); ++i) //循环填充点云数据
    {
        cloud->points[i].x = 1024.0f * rand() / (RAND_MAX + 1.0f); // // 产生数值为0-1024的浮点数
        cloud->points[i].y = 1024.0f * rand() / (RAND_MAX + 1.0f);
        cloud->points[i].z = 1024.0f * rand() / (RAND_MAX + 1.0f);
    }
    //创建KdTreeFLANN对象,并把创建的点云设置为输入,创建一个searchPoint变量作为查询点
    pcl::KdTreeFLANN<pcl::PointXYZ> kdtree; // pcl::KdTreeFLANN<PointT, Dist>::setInputCloud (const PointCloudConstPtr
                                            // &cloud, const IndicesConstPtr &indices)
    //设置搜索空间
    kdtree.setInputCloud(cloud);
    //设置查询点并赋随机值
    pcl::PointXYZ searchPoint;
    searchPoint.x = 1024.0f * rand() / (RAND_MAX + 1.0f);
    searchPoint.y = 1024.0f * rand() / (RAND_MAX + 1.0f);
    searchPoint.z = 1024.0f * rand() / (RAND_MAX + 1.0f);

    // K 临近搜索
    //创建一个整数(设置为10)和两个向量来存储搜索到的K近邻,两个向量中,一个存储搜索到查询点近邻的索引,另一个存储对应近邻的距离平方
    int K = 10;

    std::vector<int> pointIdxNKNSearch(K);         //存储查询点近邻索引
    std::vector<float> pointNKNSquaredDistance(K); //存储近邻点对应距离平方
    //打印相关信息
    std::cout << "K nearest neighbor search at (" << searchPoint.x << " " << searchPoint.y << " " << searchPoint.z
              << ") with K=" << K << std::endl;

    if (kdtree.nearestKSearch(searchPoint, K, pointIdxNKNSearch, pointNKNSquaredDistance) > 0) //执行K近邻搜索
    {
        //打印所有近邻坐标
        for (size_t i = 0; i < pointIdxNKNSearch.size(); ++i)
            std::cout << "    " << cloud->points[pointIdxNKNSearch[i]].x << " " << cloud->points[pointIdxNKNSearch[i]].y
                      << " " << cloud->points[pointIdxNKNSearch[i]].z
                      << " (squared distance: " << pointNKNSquaredDistance[i] << ")" << std::endl;
    }
    /**********************************************************************************
     下面的代码展示查找到给定的searchPoint的某一半径(随机产生)内所有近邻,重新定义两个向量
     pointIdxRadiusSearch  pointRadiusSquaredDistance来存储关于近邻的信息
     ********************************************************************************/
    // 半径 R内近邻搜索方法

    std::vector<int> pointIdxRadiusSearch;         //存储近邻索引
    std::vector<float> pointRadiusSquaredDistance; //存储近邻对应距离的平方

    float radius = 256.0f * rand() / (RAND_MAX + 1.0f); //随机的生成某一半径
    //打印输出
    std::cout << "Neighbors within radius search at (" << searchPoint.x << " " << searchPoint.y << " " << searchPoint.z
              << ") with radius=" << radius << std::endl;

    // 假设我们的kdtree返回了大于0个近邻。那么它将打印出在我们"searchPoint"附近的10个最近的邻居并把它们存到先前创立的向量中。
    if (kdtree.radiusSearch(searchPoint, radius, pointIdxRadiusSearch, pointRadiusSquaredDistance) >
        0) //执行半径R内近邻搜索方法
    {
        for (size_t i = 0; i < pointIdxRadiusSearch.size(); ++i)
            std::cout << "    " << cloud->points[pointIdxRadiusSearch[i]].x << " "
                      << cloud->points[pointIdxRadiusSearch[i]].y << " " << cloud->points[pointIdxRadiusSearch[i]].z
                      << " (squared distance: " << pointRadiusSquaredDistance[i] << ")" << std::endl;
    }

    return 0;
}

#include <benchmark/benchmark.h>
#include <gtest/gtest.h>

static void BM_Kdtree(benchmark::State &state)
{
    // 运行基准测试
    for (auto _ : state) {
        kdTreeTest();
    }
}
// 注册基准测试
BENCHMARK(BM_Kdtree);

BENCHMARK_MAIN();
输出:
测量排序算法性能
#include <benchmark/benchmark.h>
#include <vector>
#include <algorithm>

// 选择排序算法
void selectionSort(std::vector<int>& arr) {
    for (size_t i = 0; i < arr.size(); ++i) {
        size_t minIdx = i;
        for (size_t j = i + 1; j < arr.size(); ++j) {
            if (arr[j] < arr[minIdx]) {
                minIdx = j;
            }
        }
        std::swap(arr[i], arr[minIdx]);
    }
}

// 快速排序算法
void quickSort(std::vector<int>& arr, int low, int high) {
    if (low < high) {
        int pivot = arr[high];
        int i = low - 1;
        for (int j = low; j < high; ++j) {
            if (arr[j] < pivot) {
                ++i;
                std::swap(arr[i], arr[j]);
            }
        }
        std::swap(arr[i + 1], arr[high]);
        int pi = i + 1;
        quickSort(arr, low, pi - 1);
        quickSort(arr, pi + 1, high);
    }
}

// 基准测试函数,使用 Google Benchmark 库
static void BM_SelectionSort(benchmark::State& state) {
    std::vector<int> arr = {5, 2, 9, 1, 5, 6};
    for (auto _ : state) {
        selectionSort(arr);
    }
}

// 快速排序基准测试
static void BM_QuickSort(benchmark::State& state) {
    std::vector<int> arr = {5, 2, 9, 1, 5, 6};
    for (auto _ : state) {
        quickSort(arr, 0, arr.size() - 1);
    }
}

// 注册基准测试
BENCHMARK(BM_SelectionSort);
BENCHMARK(BM_QuickSort);

// 定义测试入口
BENCHMARK_MAIN();
输出:
2025-08-24T22:37:58+08:00
Running ./three_dim_test
Run on (20 X 4600 MHz CPU s)
CPU Caches:
  L1 Data 48 KiB (x10)
  L1 Instruction 32 KiB (x10)
  L2 Unified 1280 KiB (x10)
  L3 Unified 24576 KiB (x1)
Load Average: 0.88, 0.85, 0.80
-----------------------------------------------------------
Benchmark                 Time             CPU   Iterations
-----------------------------------------------------------
BM_SelectionSort        160 ns          160 ns      4371089
BM_QuickSort            217 ns          218 ns      3213221

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献7条内容

所有评论(0)