【论文阅读】FedWiper: Federated unlearning via universal adapter
FedWiper: Federated unlearning via universal adapter -- 通过通用适配器的联邦遗忘
论文来源
| 名称 | FedWiper: Federated unlearning via universal adapter |
|---|---|
| 期刊 | TIFS 2025 |
| 作者 | Shuai Zhao , Junying Zhang , Xindi Ma , Member, IEEE, Qi Jiang , Zhuo Ma , Senior Member, IEEE, Sheng Gao , Zuobin Ying , Member, IEEE, and Jianfeng Ma , Member, IEEE |
| DOI | DOI: 10.1109/TIFS.2025.3557671 |
背景
- 联邦学习中的隐私保护: 随着像GDPR这样的隐私法规越来越严格,删除用户数据及其对机器学习模型影响的需求日益增加。联邦学习虽然在训练时保护了数据的本地性,但使得“遗忘”操作变得复杂,因为数据的贡献是分散的并且被聚合在一起。
- 现有遗忘方法的局限性:
- 中心化遗忘: 像SISA或ARCANE这样的方法需要访问所有数据,这在联邦学习中不可行。
- 近似联邦学习遗忘: 大多数现有的联邦学习遗忘方法(例如FedEraser)是近似的,它们试图让遗忘后的模型在统计上与从头开始重新训练的模型相似,但不能保证完全移除影响。这带来了潜在的隐私风险。
- 任务特定性: 当前的遗忘方法主要集中在分类任务上,缺乏对更复杂模型和任务(如目标检测或语义分割)的通用性。
- 效率: 从头重新训练 (Retrain-from-Scratch, RfS) 是精确遗忘的黄金标准,但计算成本非常高,尤其是在联邦学习中。
TDLR
FedWiper 基于“分而治之”策略和快速重训练范式。
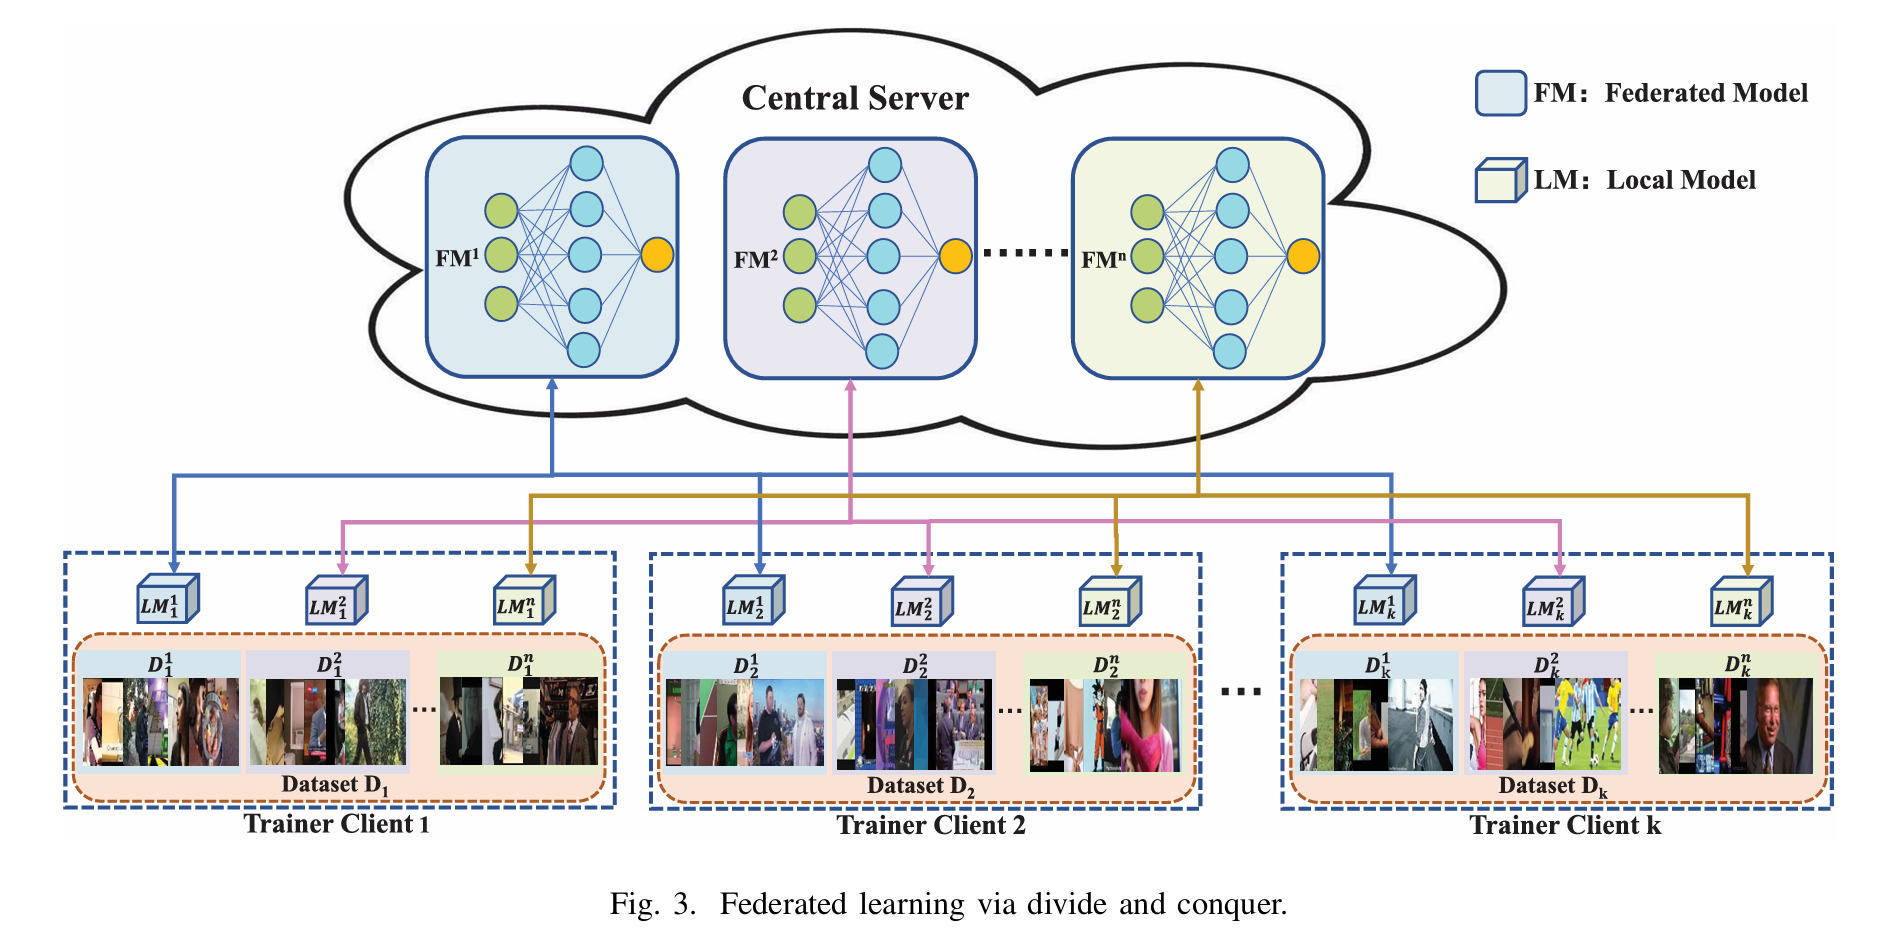
- 多个联邦子模型: FedWiper 不是训练一个全局的联邦模型,而是训练多个( n n n 个)联邦子模型。每个客户端的本地数据集被分成多个分片 (shard),每个分片贡献给一个特定的子模型。当需要擦除数据时,这缩小了影响范围——只需要重新训练相关的子模型。
- Uni-Adapter (通用适配器): 这是一个至关重要的即插即用模块。
- 目的: 减轻因在较小数据集分片上训练子模型而导致的性能下降,并减少通信开销。
- 结构: 通常由几个(例如两个)卷积层组成,灵感来自于自然语言处理中的适配器模块。它被设计成轻量级的,可以调整通道数并包含残差连接。
- 注入: Uni-Adapter 被注入到预训练模型的主干网络中的多个关键位置(在重要的层/块之后)。主干模型的权重被冻结。
- 训练: 在联邦训练(以及遗忘时的重训练)期间,只有 Uni-Adapter 和可能最终的全连接层 (FC) 被训练,并在客户端和服务器之间进行通信。与更新整个模型相比,这显著降低了通信成本和训练时间。
- 投票聚合 (Voting Aggregation): 当进行预测时,输入样本会被送到客户端上的所有 n n n 个本地子模型。这些子模型的输出(置信度)会被聚合(例如,通过平均每个类别的置信度),并基于这个聚合结果做出最终预测。
系统及威胁模型
实体
系统结构如图:
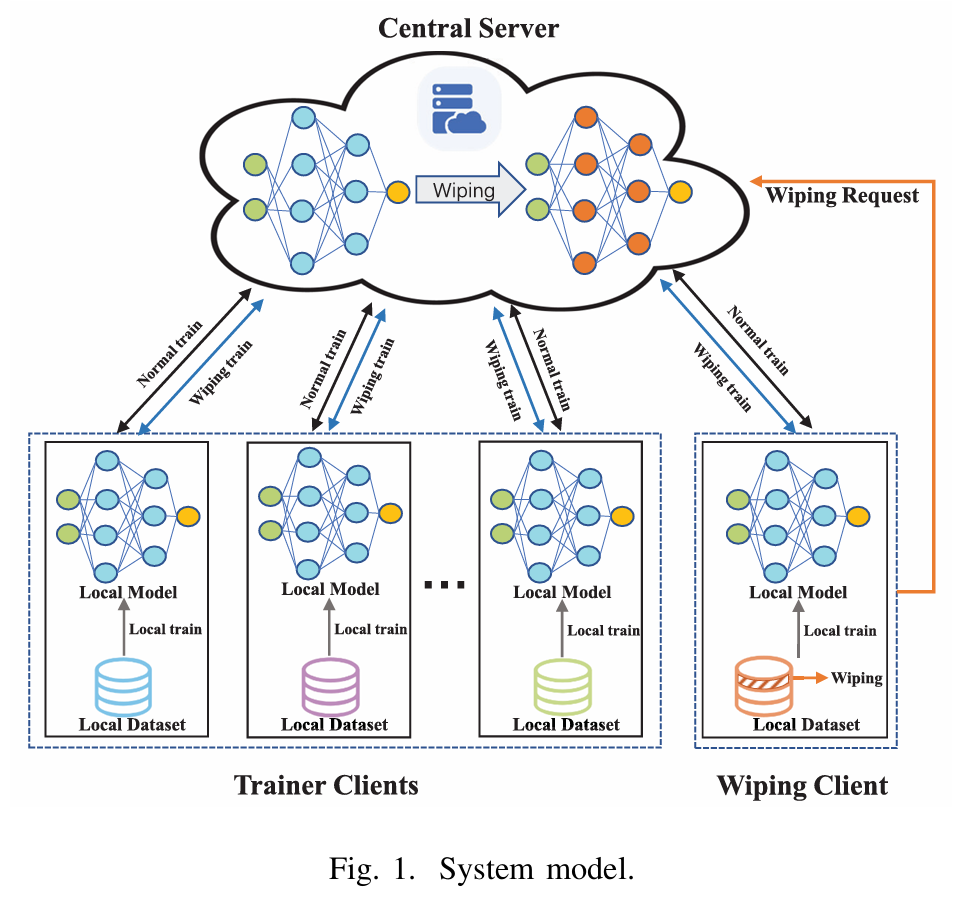
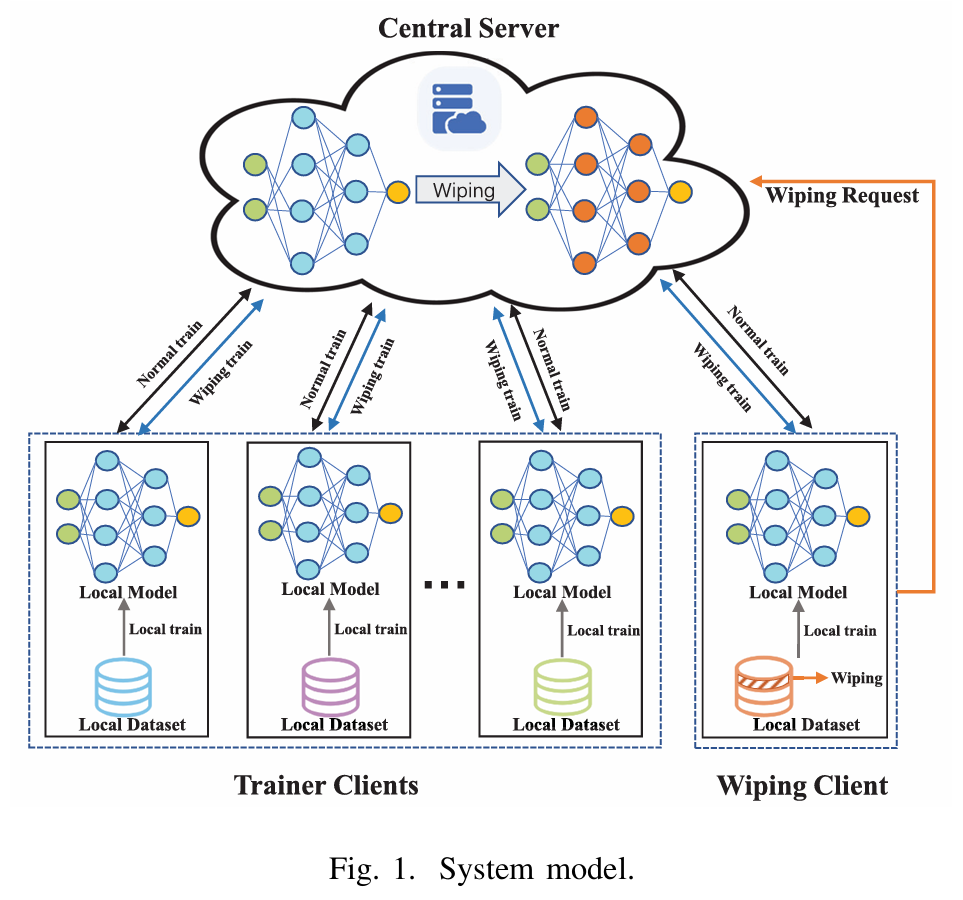、训练客户端(TCs)和擦除客户端(WC),擦除客户端在模型训练中仍然是训练客户端。
- 中央服务器(CS)。在模型训练过程中,CS 作为聚合服务器,将所有客户端本地训练的模型整合成统一的全局联邦模型。若接收到擦除客户端的数据删除请求,CS 会协调多个训练客户端在联邦模型中执行对 WC 数据的遗忘学习训练。在整个遗忘学习过程中,CS 结合每个训练客户端训练的模型,并将遗忘后的联邦模型分发给所有客户端。
- 数据擦除客户端(WC)。WC 作为模型遗忘服务的启动器。在联邦模型训练完成后,WC 会根据隐私泄露的担忧,发起对训练好的联邦模型进行数据遗忘的请求。WC 可以尝试在多个层面实现数据遗忘,例如样本层、类别层、客户端层等。
- 训练客户(TCs)。TC是模型训练的参与客户。在联邦学习模型训练过程中,TCs与WC共同训练全局联邦模型。在遗忘训练过程中,CS将WC的遗忘请求传达给所有TCs。所有TCs配合CS完成联邦模型的数据遗忘,最终获得数据遗忘后的全局模型。
威胁模型
在本文中,将中央服务器和客户端均视为可信实体,而系统存在外部敌手,敌手会捕获客户端后发起投毒攻击、后门攻击、推理攻击。
方法展开
通用适配器 Uni-Adapter 的结构
Uni-Adapter 旨在实现具备即插即用特性的联邦遗忘。Uni-Adapter 是一种通用适配器,因为它可以通过调整其内部结构来注入任意模型。适配器的概念通常用于自然语言处理(NLP)中大型模型的微调。因此,Uni-Adapter 天生适合对预训练模型进行微调。简而言之,就是将一个冻结的预训练模型拆分为多个小型特征提取器,并在每个小型特征提取器之后添加层。这些层的的是获得对客户端数据更全面的视角。Uni-Adapter 能够提升特征提取器的效率,使其能够专门学习客户端拥有的样本。Uni-Adapter 的简化结构如图所示。
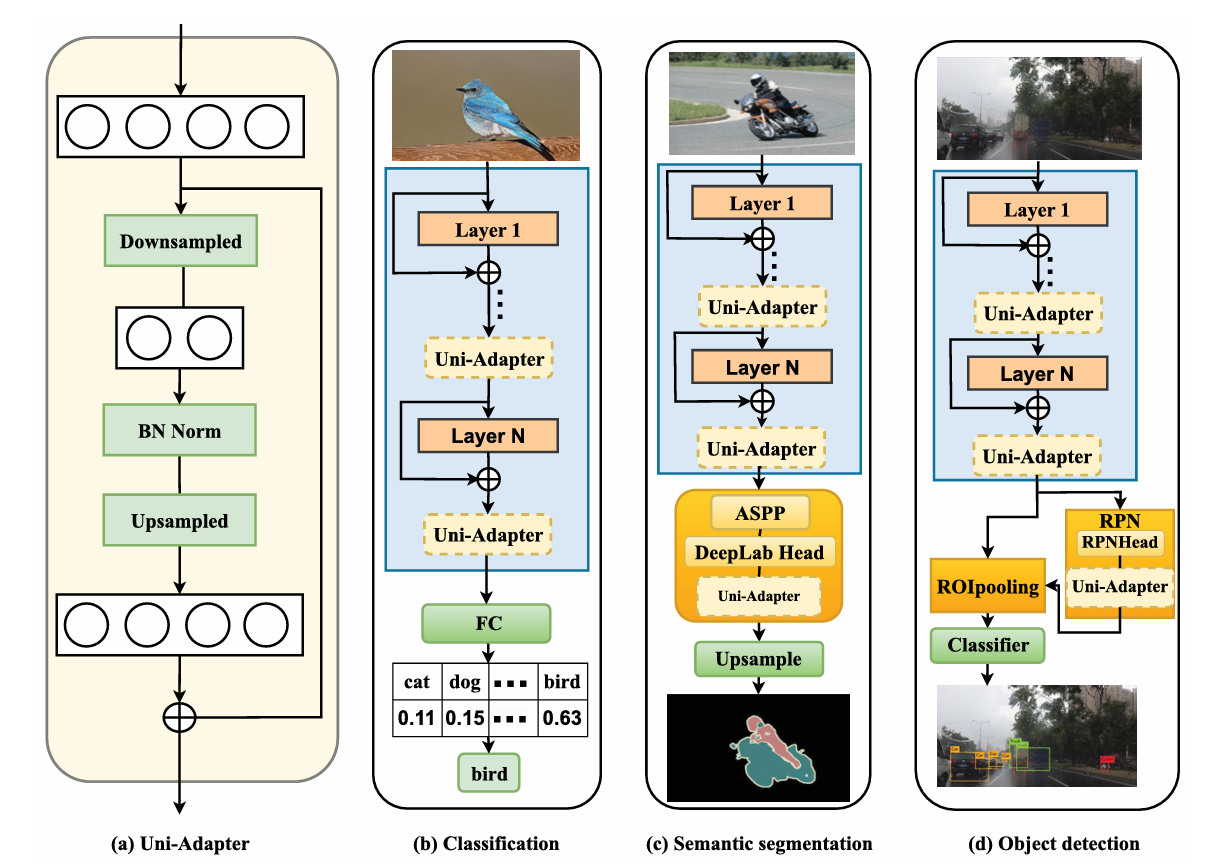
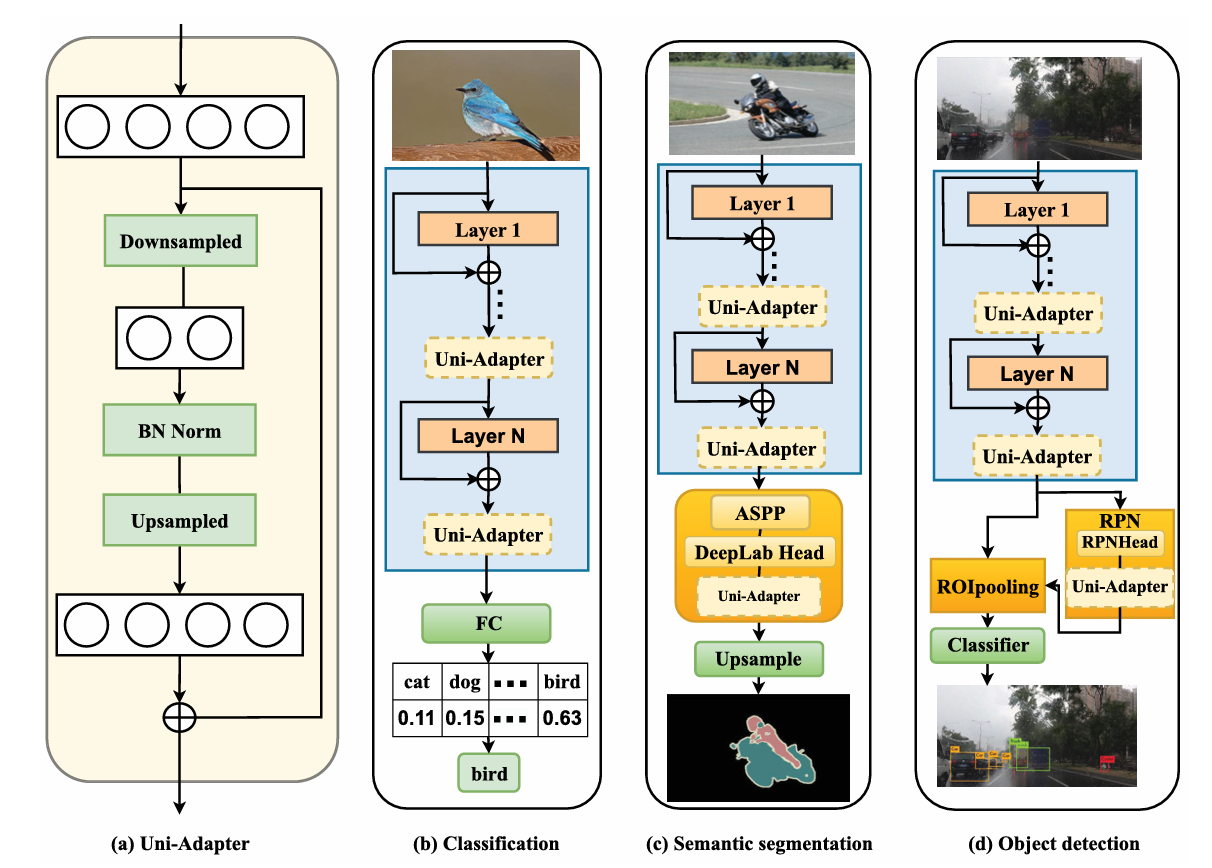
 统一适配器注入:在中心服务器(CS)与客户端之间更新多个联邦学习(FL)子模型会导致相当大的通信开销。此外,采用多个FL子模型显著减少了每个子模型的训练数据集规模,这可能大幅降低模型的准确性。在训练多个FL子模型之前,将通用适配器注入到预训练的FL子模型主干网络中。随后,冻结子模型,仅训练通用适配器。通过这种方式,客户端与CS之间需要更新的参数仅包含通用适配器,从而显著降低通信成本。更重要的是,在冻结的预训练FL子模型上进一步训练通用适配器,克服了因使用过小集而导致模型准确性下降的缺点。
(2) 子模型训练:FedWiper根据数据集粒度训练多个本地子模型,记为客户端
k
k
k 的
L
M
k
1
LM_k^1
LMk1、
L
M
k
2
LM_k^2
LMk2、···、
L
M
k
n
LM_k^n
LMkn。其他客户端采用相同流程,导致每个客户端生成
n
n
n 个本地子模型。随后,各客户端训练并上传各自的
n
n
n 个本地统一适配器至CS。CS利用收集的统一适配器更新并获得
n
n
n 个FL子模型,记为
F
M
=
{
F
M
1
,
F
M
2
,
⋅
⋅
⋅
,
F
M
n
}
FM = \{FM^1, FM^2, ···, FM^n\}
FM={FM1,FM2,⋅⋅⋅,FMn}。例如,
F
M
1
FM^1
FM1 是通过聚合
L
M
1
1
LM_1^1
LM11、
L
M
2
1
LM_2^1
LM21、···、
L
M
K
1
LM_K^1
LMK1 获得的联邦子模型。
(3) 投票聚合:当客户端需要使用未训练的子模型进行预测时,输入样本会被送入客户端的 n n n 个本地子模型中。每个子模型都会为输入样本提供一个置信度。这 n n n 个多维置信度通过投票过程进行聚合。 FedWiper 中使用的聚合方法是将这 n n n 个多维置信度相加以获得平均值。平均置信度代表了 n n n 个本地子模型的共同预测目标,最高值被视为最终的预测结果。 n n n 个置信度的聚合计算公式如下:
Y l a b e l = f ( m a x ( 1 n ∑ i = 1 n Y i ) ) Y_{label}=f(max(\frac{1}{n} \sum_{i=1}^{n} Y_i )) Ylabel=f(max(n1∑i=1nYi))
其中 Y i Y_i Yi 表示客户端中第 i i i 个联邦子模型的最终置信度, f ( ⋅ ) f (·) f(⋅) 表示平均置信度中最大值的位置。
- 联邦快速且精确的遗忘学习
遗忘学习过程可总结为一系列步骤。以客户端 K K K 作为示例。当 WC 请求删除私有数据时,执行以下步骤:- 步骤 1:锁定 WC 客户端中被遗忘的分片 D k i D_k^i Dki(其中 i ∈ [ 1 , n ] i \in [1, n] i∈[1,n])。
- 步骤 2:从 D k i D_k^i Dki中移除需删除的样本。
- 步骤 3:使用 D k i D_k^i Dki 中剩余的数据重新训练本地子模型 L M k i LM_k^i LMki。
- 步骤 4:所有客户端,包括 TC 和 WC,与 CS 交互并重新训练联邦学习子模型 F M i FM^i FMi。
- 步骤 5:CS 将未学习的子模型 F M i FM^i FMi分发给 TC 和 WC,以更新其参数并使用各自的分片训练本地子模型。
- 步骤 6:重复步骤 3 至 5。通过遵循这六个步骤,可以通过重新训练实现联邦学习中的快速删除学习。该方法仅针对每个客户端受影响的分片重新训练部分联邦学习子模型。
FedWiper 以下优势:
- 较少的数据集用于再训练。
- 需要重新训练的参数更少。
- 通信成本:假设 Uni-Adapter 的通信成本记为 X 1 X_1 X1,联邦学习(FL)模型的通信成本记为 X 2 X_2 X2,通常可以表示为 X 2 X_2 X2大于10倍的 X 1 X_1 X1( X 2 > 10 X 1 X_2 > 10X_1 X2>10X1)。设FedWiper中每个训练客户端的FL模型数量为 N N N。基于此,冻结主干网络的FL预训练模型与中央服务器之间传递的参数数量可表示为 $M_1 = N × X 1 N×X_1 N×X1,而未冻结主干网络的FL预训练模型与中央服务器之间传递的参数数量为 M 2 = X 2 M_2 = X_2 M2=X2。在上述条件下,当每个训练客户端的FL模型数量 N N N 小于或等于10时,可以保证 M 1 < M 2 M_1 < M_2 M1<M2。因此,在这种情况下,所提出方法的通信成本小于或等于RfS。
总结
优点
-
实现了精确遗忘 (Exact Unlearning)
与许多追求近似遗忘的方法不同,FedWiper 的目标是彻底移除被遗忘数据的影响,使其模型状态与从未见过该数据时训练的模型等价。这提供了目前理论上最强的隐私保证。
-
显著提升了精确遗忘的效率
相比于“黄金标准”的从头重训练 (RfS),FedWiper 通过“分而治之”(子模型)和 Uni-Adapter 机制,大大减少了遗忘操作所需的时间和计算资源。实验表明其速度可以有数倍的提升。
-
降低了通信成本
通过冻结主干网络,仅训练和传递轻量级的 Uni-Adapter 参数(以及少量任务头参数),显著减少了联邦学习过程中客户端与服务器之间的通信开销。
-
保持了较好的模型性能
尽管子模型训练基于较小的数据分片,但通过利用强大的预训练模型骨干、Uni-Adapter 的有效微调以及投票聚合策略,FedWiper 能够在很大程度上保持模型的准确率,性能损失控制在可接受范围内。
-
实现了多任务通用性 (Universal Unlearning)
Uni-Adapter 的灵活性使得 FedWiper 不仅适用于图像分类,还能成功应用于目标检测、语义分割、图文检索等多种复杂机器学习任务的遗忘,打破了以往联邦遗忘方法大多局限于分类任务的局面。
-
有效抵御特定攻击
实验证明,FedWiper 能够有效移除后门攻击的影响,并将成员推理攻击的成功率降低到接近随机猜测的水平,增强了模型的安全性和用户隐私。
-
机制设计清晰且具有创新性
“子模型 + Uni-Adapter + 快速重训练”的组合是一种新颖且逻辑清晰的联邦遗忘解决方案。
缺点
-
初始训练开销可能增加
虽然遗忘高效,但在正常的联邦学习训练阶段,需要并行训练 n n n 个联邦子模型。这可能比训练一个单一的全局模型需要更多的初始训练时间和计算资源(尽管每个子模型的单次训练可能因为 Uni-Adapter 而更快)。
-
子模型数量 n n n 的选择是一个需要权衡的超参数
n n n 过小,遗忘效率提升有限; n n n 过大,数据分片过小,可能严重影响子模型性能。找到最优的 n n n 值需要针对具体任务和数据集进行实验和调整。
-
对客户端数据量的隐性要求
为了保证每个数据分片仍有足够的数据进行有效训练,FedWiper 可能更适合每个客户端本身拥有较大数据量的场景。对于数据极其稀疏的客户端,效果可能会打折扣。
-
Uni-Adapter 设计和注入策略的调优
Uni-Adapter 的具体结构(例如瓶颈维度、激活函数)以及在主干网络中的注入位置和数量,都可能影响最终性能。这些参数的选择可能需要一定的领域知识和实验探索。
-
“精确遗忘”在复杂分布式环境下的严格验证挑战
虽然论文的机制设计旨在实现精确遗忘,并且通过与 RfS 的行为对比和安全测试来间接验证,但在高度随机和异构的真实联邦学习环境中,严格证明参数级别的完全一致性(即 Mu = MDu)仍然是一个非常困难的理论和实践挑战。
-
依赖高质量的预训练模型
FedWiper 的性能在很大程度上受益于强大的预训练模型骨干提供的通用特征。如果预训练模型质量不高,或者与下游任务差异过大,Uni-Adapter 的微调效果可能会受限。
-
投票聚合的额外开销
虽然投票聚合能提升性能,但在客户端进行推理时,需要将输入分别通过 n 个本地子模型,这会增加推理的计算时间和延迟。
总结来说,FedWiper 是一项在联邦遗忘领域具有重要创新和实用价值的工作。它成功地将精确遗忘的理念与高效执行和多任务通用性结合起来,为解决“被遗忘权”问题提供了有力的技术方案。然而,像所有研究一样,它也有其适用条件和需要进一步探索的方面。其优点在于强大的隐私保证、显著的效率提升和前所未有的任务通用性;缺点则主要集中在参数调优的复杂性、对数据和预训练模型的依赖,以及在某些极端场景下的性能表现。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 36
 0
- 0


 已为社区贡献4条内容

所有评论(0)