数据结构课程设计:构建图书管理系统

简介:数据结构课程设计是计算机科学与技术专业的实践环节,本项目以图书管理系统为主题,展示数据结构在软件开发中的应用。学生将利用C语言实现基于链表、树、栈、队列和哈希表的数据结构,以处理图书信息的存储、查询、添加、删除和修改等操作,并注重文件I/O、编程规范、设计模式以及系统测试,提升解决实际问题的能力。
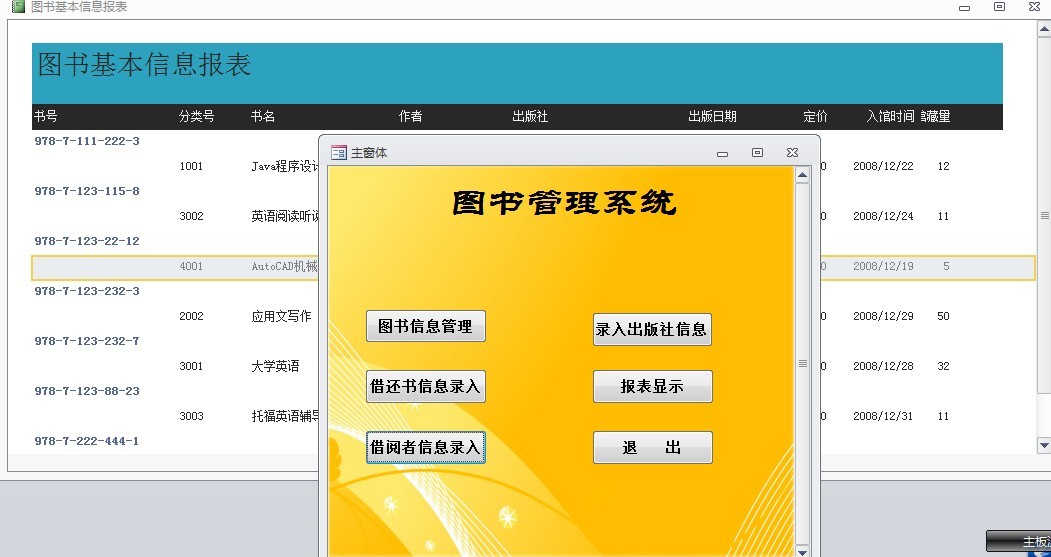
1. 数据结构在软件开发中的应用
数据结构是软件开发的基石,它直接影响到程序的效率和性能。理解并运用适当的数据结构可以大幅提高软件的运行效率,同时也是编写清晰、高效、可维护代码的关键。
1.1 数据结构与软件性能
在软件开发过程中,数据结构的选择和实现决定了数据的存储方式和访问速度。例如,数组和链表在内存存储上有本质的不同,而树形结构和散列表(哈希表)则能提供更快的查找性能。选择合适的数据结构,可以优化算法效率,减少资源消耗,从而提升整个软件系统的性能。
1.2 数据结构在软件工程中的角色
数据结构不仅在单个程序中扮演着重要角色,它在软件工程的多个阶段中都有着广泛的应用。从需求分析、系统设计到编码实现,甚至在软件测试和性能优化中,正确使用数据结构可以提高开发效率,确保软件质量,并且使软件更容易扩展和维护。
1.3 应对复杂性的工具
随着软件系统变得越来越复杂,数据结构成为管理复杂性的关键工具。通过合适的数据结构抽象问题,能够将复杂系统分解为可管理的子部分,进而提升软件的整体复杂度管理能力。这对于开发高质量、高性能的软件系统来说至关重要。
在下一章中,我们将探讨链表这种基础数据结构在图书信息管理系统中的具体应用,理解它如何帮助我们组织和管理数据。
2. 链表在图书信息管理中的应用
2.1 链表的数据结构理论
2.1.1 链表的基本概念和特点
链表是一种常见的数据结构,由一系列节点组成,每个节点包含数据部分和指向下一个节点的指针。链表的优点在于它的动态性,可以根据需要进行节点的插入和删除操作,无需像数组那样移动数据块,也不会浪费预先分配的大量空间。
在实际应用中,链表特别适合实现图书管理系统中的动态数据结构,比如可以将每本图书的信息作为一个节点存储在链表中。当添加或删除图书时,只需修改相邻节点的指针指向即可,非常灵活且效率高。
2.1.2 链表与数组的对比分析
与数组相比,链表在某些方面具有优势,比如:
- 动态大小:链表可以动态地增加或减少节点,无需预先定义大小,而数组一旦定义大小,扩容会相对复杂。
- 插入和删除效率:链表在插入或删除节点时,只需修改相邻节点的指针,而数组可能需要移动多个元素。
- 内存利用:链表不需要像数组那样连续存储空间,更有效地使用了内存碎片。
然而,链表也存在不足:
- 访问速度:链表无法通过索引直接访问数据,访问任何节点都需要从头节点开始遍历,效率低于数组的随机访问。
- 存储开销:每个链表节点除了数据部分外,还额外存储指针,占用更多的内存空间。
2.2 链表操作的实现细节
2.2.1 链表节点的创建和删除
在编程实现链表时,我们通常需要定义节点结构,并提供创建和删除节点的方法。以下是使用C语言实现链表节点创建和删除的基本示例:
#include <stdio.h>
#include <stdlib.h>

// 定义链表节点结构体
typedef struct Node {
    int data;               // 数据部分
    struct Node* next;      // 指向下一个节点的指针
} Node;

// 创建一个新节点
Node* createNode(int data) {
    Node* newNode = (Node*)malloc(sizeof(Node)); // 分配内存空间
    if(newNode == NULL) {
        printf("Memory allocation error!\n");
        return NULL;
    }
    newNode->data = data; // 设置数据
    newNode->next = NULL; // 初始化指针
    return newNode;
}

// 删除一个节点
void deleteNode(Node** head, int key) {
    Node* temp = *head;
    Node* prev = NULL;
    // 如果头节点就是要删除的节点
    if(temp != NULL && temp->data == key) {
        *head = temp->next; // 改变头节点
        free(temp);         // 释放内存
        return;
    }
    // 查找要删除的节点
    while(temp != NULL && temp->data != key) {
        prev = temp;
        temp = temp->next;
    }
    // 如果没有找到
    if(temp == NULL) return;
    // 从链表中删除节点
    prev->next = temp->next;
    free(temp);
}

int main() {
    Node* head = NULL;
    head = createNode(1);
    head->next = createNode(2);
    head->next->next = createNode(3);
    // 删除节点2
    deleteNode(&head, 2);
    // 打印剩余节点
    Node* current = head;
    while(current != NULL) {
        printf("%d ", current->data);
        current = current->next;
    }
    return 0;
}
代码逻辑逐行解读:
- 定义了一个 Node 结构体,其中包含 data 用于存储数据和 next 指针用于指向下一个节点。
- createNode 函数用于创建一个新的链表节点,并返回指向该节点的指针。
- deleteNode 函数用于删除链表中的一个节点,它接受一个指向头节点指针的指针和要删除节点的值。
- 在 main 函数中,创建了一个简单的链表,并演示了如何删除一个节点。
2.2.2 链表的遍历和搜索算法
遍历链表意味着访问链表中的每个节点,通常从头节点开始,沿着 next 指针移动,直到到达链表末尾。链表的遍历是一个基本的操作,它经常与其他算法结合使用,如搜索、排序等。
以下是一个简单地遍历链表的示例:
// 遍历链表并打印数据部分
void printList(Node* node) {
    while(node != NULL) {
        printf("%d ", node->data);
        node = node->next;
    }
}
这个函数遍历整个链表,并打印出每个节点的数据。
链表搜索算法用于查找特定数据的节点。最简单的搜索方法是遍历链表,比较每个节点的数据部分,直到找到匹配项或链表结束。
2.3 链表在图书管理系统中的实践
2.3.1 图书信息存储结构的设计
在图书管理系统中,我们可以使用链表来存储和管理图书信息。每个节点可以包含以下信息:
- 图书ID:唯一标识每本图书的编号。
- 图书标题:图书的名称。
- 作者:图书的作者。
- 出版社:出版图书的出版社。
- ISBN:国际标准书号。
- 借阅状态:图书是否被借出。
结构体定义如下:
typedef struct BookNode {
    int id;
    char title[100];
    char author[50];
    char publisher[50];
    char isbn[20];
    int isBorrowed;
    struct BookNode* next;
} BookNode;
2.3.2 图书的增删改查操作实现
在链表结构中实现图书的增删改查操作是管理图书信息的基础。这里以“增加图书”操作为例来说明其操作细节:
// 增加图书到链表
void addBook(BookNode** head, BookNode* newBook) {
    // 如果是第一个节点,则赋值给头指针
    if(*head == NULL) {
        *head = newBook;
    } else {
        // 否则,找到链表末尾,添加新节点
        BookNode* current = *head;
        while(current->next != NULL) {
            current = current->next;
        }
        current->next = newBook;
    }
}
逻辑分析和参数说明:
- addBook 函数接受指向头节点指针的指针 head 和要添加的节点 newBook 。
- 如果头节点为空,则直接将新节点设为头节点。
- 否则,遍历链表找到最后一个节点,并将新节点添加到链表末尾。
对于删除、修改和查询操作,基本思路类似,只需在遍历链表的过程中进行相应的操作即可。
至此,我们已经概述了链表在图书信息管理中的应用。通过链表的灵活操作,可以实现对图书信息的有效管理和快速检索。在接下来的章节中,我们将进一步探讨其他数据结构如二叉搜索树、哈希表在图书管理系统中的应用,以及它们各自的优势和实现细节。
3. 二叉搜索树实现快速查找图书
3.1 二叉搜索树的基础知识
3.1.1 二叉搜索树的定义和性质
二叉搜索树(BST,Binary Search Tree)是一种特殊的二叉树,它允许快速查找、添加和删除节点。在二叉搜索树中,每个节点都有一个键值,且满足以下性质:
- 节点的左子树只包含键值小于该节点键值的节点。
- 节点的右子树只包含键值大于该节点键值的节点。
- 左右子树也必须分别为二叉搜索树。
3.1.2 二叉搜索树的构建过程
构建一个二叉搜索树,通常是从一个空树开始,然后插入一系列的值。插入的值首先作为根节点,随后每个插入的值都与树中已有的节点比较,根据大小关系放到左子树或右子树。
以下是构建一个简单二叉搜索树的伪代码示例:
class TreeNode:
    def __init__(self, key):
        self.left = None
        self.right = None
        self.val = key

def insert(root, key):
    if root is None:
        return TreeNode(key)
    else:
        if root.val < key:
            root.right = insert(root.right, key)
        else:
            root.left = insert(root.left, key)
    return root
在此代码中, insert 函数会递归地找到合适的位置插入新节点。二叉搜索树的这种性质使得查找操作非常高效,最坏情况下时间复杂度为 O(log n)。
3.2 二叉搜索树的操作和优化
3.2.1 树的遍历算法:前序、中序、后序
二叉搜索树可以使用不同的遍历算法来实现节点的顺序访问,包括前序、中序和后序遍历。对于二叉搜索树,中序遍历特别有用,因为它将树中的所有节点以升序的方式遍历。
伪代码示例:
def inorder_traversal(root):
    if root:
        inorder_traversal(root.left)
        visit(root)
        inorder_traversal(root.right)

def preorder_traversal(root):
    if root:
        visit(root)
        preorder_traversal(root.left)
        preorder_traversal(root.right)

def postorder_traversal(root):
    if root:
        postorder_traversal(root.left)
        postorder_traversal(root.right)
        visit(root)
3.2.2 平衡二叉树(AVL树)的应用
在二叉搜索树中,极端情况下树可能会退化成一个链表(例如,当插入的值是递增或递减序列时),此时查找效率会下降到 O(n)。为了优化这个问题,引入了平衡二叉树的概念,其中最著名的代表是AVL树。
AVL树是一种自平衡的二叉搜索树,对于任何节点,其左右子树的高度差不超过1。在插入和删除节点后,AVL树通过旋转操作来重新平衡树,从而保持了较好的性能。
3.3 二叉搜索树在图书查找中的应用
3.3.1 图书快速检索的实现
假设我们有一个包含大量图书信息的二叉搜索树,每本书用它的ISBN作为键值。通过二叉搜索树,我们可以快速检索到任何一本特定的书。
def search(root, key):
    if root is None or root.val == key:
        return root
    if root.val < key:
        return search(root.right, key)
    return search(root.left, key)
在上面的代码中, search 函数演示了如何在二叉搜索树中查找特定键值的节点。
3.3.2 查找性能的分析和优化
二叉搜索树的查找性能依赖于树的深度。理想情况下,树是平衡的,使得查找性能达到最优。在实际应用中,可能会遇到树不平衡的情况,这时需要使用AVL树等平衡树技术来保证查找性能。
下面是一个使用二叉搜索树进行图书检索并计算操作次数的表格,展示了平衡与不平衡树的性能差异:
| 操作 | 平衡二叉树(AVL) | 不平衡二叉搜索树 |
|---|---|---|
| 查找 | 最坏 O(log n) | 最坏 O(n) |
| 插入 | 最坏 O(log n) | 最坏 O(n) |
| 删除 | 最坏 O(log n) | 最坏 O(n) |
在构建和维护二叉搜索树时,开发者可以通过以下策略来优化性能:
- 定期检查树的平衡性,并应用旋转操作来重新平衡。
- 在插入或删除操作时,使用递归或迭代方法来更新节点。
通过这种方式,二叉搜索树能够提供高效的图书检索功能,大大提升图书信息管理系统的用户体验。
4. 栈和队列处理用户操作和请求调度
4.1 栈和队列的理论基础
栈和队列是两种常用的线性数据结构,它们在处理用户操作和请求调度方面发挥着重要作用。理解它们的定义、特点和算法实现对于高效地管理图书系统至关重要。
4.1.1 栈和队列的定义与特点
栈(Stack) 是一种后进先出(LIFO, Last In First Out)的数据结构。在栈中,最后一个进入的元素将是最先被移除的。你可以将栈想象成一摞盘子,最后放上的盘子必须先拿下来。
队列(Queue) 是一种先进先出(FIFO, First In First Out)的数据结构。在队列中,最先加入的元素将是最先被移除的。想象一下排队买票,最先排队的人将最先买到票。
4.1.2 栈和队列的算法实现
栈的算法实现 通常包括以下操作: push (进栈)、 pop (出栈)、 peek (查看栈顶元素)和 isEmpty (判断栈是否为空)。
class Stack:
    def __init__(self):
        self.stack = []
    def push(self, value):
        """将一个元素压入栈顶"""
        self.stack.append(value)
    def pop(self):
        """弹出栈顶元素"""
        if not self.isEmpty():
            return self.stack.pop()
        else:
            return None
    def peek(self):
        """获取栈顶元素"""
        if not self.isEmpty():
            return self.stack[-1]
        else:
            return None
    def isEmpty(self):
        """判断栈是否为空"""
        return len(self.stack) == 0

# 测试栈的操作
stack = Stack()
stack.push(1)
stack.push(2)
print(stack.peek())  # 输出 2
print(stack.pop())   # 输出 2
print(stack.isEmpty())  # 输出 False
队列的算法实现 主要包括: enqueue (入队)、 dequeue (出队)、 front (查看队首元素)和 isEmpty (判断队列是否为空)。
class Queue:
    def __init__(self):
        self.queue = []
    def enqueue(self, value):
        """将一个元素加入队尾"""
        self.queue.append(value)
    def dequeue(self):
        """移除队首元素"""
        if not self.isEmpty():
            return self.queue.pop(0)
        else:
            return None
    def front(self):
        """获取队首元素"""
        if not self.isEmpty():
            return self.queue[0]
        else:
            return None
    def isEmpty(self):
        """判断队列是否为空"""
        return len(self.queue) == 0

# 测试队列的操作
queue = Queue()
queue.enqueue(1)
queue.enqueue(2)
print(queue.front())  # 输出 1
print(queue.dequeue())  # 输出 1
print(queue.isEmpty())  # 输出 False
在实现栈和队列时,需要特别注意的是出栈和出队操作。栈通过 pop 方法直接移除最后添加的元素,而队列则通过 dequeue 方法移除最先添加的元素,这直接体现了它们后进先出和先进先出的特点。
4.2 栈和队列在图书管理系统中的应用
4.2.1 用户操作的后进先出处理
在图书管理系统中,用户操作往往需要按照时间顺序来处理。举个例子,如果用户有多次借阅操作,系统需要按照这些操作的逆序来归还图书,这时栈的后进先出特性就显得非常有用。
# 假设用户有多次借阅操作,我们需要逆序归还
borrow_stack = Stack()
borrow_stack.push("Book1")
borrow_stack.push("Book2")
borrow_stack.push("Book3")

# 归还操作,后借阅的先归还
while not borrow_stack.isEmpty():
    print("Returning:", borrow_stack.pop())
输出将会是:
Returning: Book3
Returning: Book2
Returning: Book1
4.2.2 请求调度的先进先出策略
对于系统中的请求调度,比如打印请求或图书搜索请求,我们需要按照请求到达系统的顺序来处理,这时队列的先进先出特性就派上了用场。
# 用户请求队列
request_queue = Queue()
request_queue.enqueue("Search Request")
request_queue.enqueue("Print Request")
request_queue.enqueue("Search Request")

# 处理请求队列
while not request_queue.isEmpty():
    print("Processing:", request_queue.dequeue())
输出将会是:
Processing: Search Request
Processing: Print Request
Processing: Search Request
4.3 实现用户界面与请求处理
4.3.1 图书借阅和归还流程的栈实现
在用户界面中,我们可以使用栈来管理用户的图书借阅和归还流程。当用户完成图书借阅时,借阅信息被压入栈中。归还时,操作逆序执行,先从栈中弹出最新的借阅记录进行归还。
4.3.2 图书预约和查询请求的队列管理
对于用户的图书预约和查询请求,我们可以使用队列来管理这些请求。当请求到达时,它们将被加入队列尾部。根据队列的FIFO原则,系统将按照它们的到达顺序依次处理每个请求。
graph LR
A[开始请求] --> B{检查队列}
B -->|队列为空| C[处理请求]
B -->|队列非空| D[排队等待]
C --> E[移除请求]
D -->|等待处理| E
E --> F[返回结果]
通过本节的介绍,我们了解了栈和队列在处理用户操作和请求调度方面的理论基础和实际应用。栈的后进先出策略适合于需要逆序处理的场景,而队列的先进先出策略则适合于按到达顺序处理的场景。在实际的图书管理系统中,这两种数据结构可以根据需要灵活运用来提高系统的性能和用户体验。
5. 哈希表用于图书分类和标签索引
5.1 哈希表的概念及其在软件中的应用
5.1.1 哈希表的原理和构造
哈希表是一种通过哈希函数来映射和存储数据的结构,其主要目的是实现快速的键值对检索。在哈希表中,每个元素的存储位置都由哈希函数计算得到,这使得访问元素的时间复杂度接近于 O(1)。
构建哈希表通常涉及以下几个步骤:
- 定义哈希函数:哈希函数将输入(通常是键)映射到一个整数,这个整数决定数据存储的索引位置。
- 处理哈希冲突:由于不同的键可能映射到同一个索引,需要有一种机制来解决这些冲突。常见的冲突解决方法包括链表法、开放寻址法等。
- 动态扩展:随着数据量的增长,哈希表可能需要动态扩展以保持高效的查找性能。
5.1.2 哈希冲突的解决方法
哈希冲突是哈希表实现中不可避免的问题,解决冲突的方法主要有以下几种:
- 链表法(Separate Chaining) :在每个哈希桶中,使用一个链表来存储所有散列到该位置的元素。
- 开放寻址法(Open Addressing) :当发生冲突时,按照某种规则在数组中寻找下一个空闲的存储位置。
- 线性探测:按顺序检查数组直到找到一个空位置。
- 二次探测:基于探测次数的平方数来确定探测序列。
- 双重散列:使用另一个哈希函数来确定探测序列。
5.2 哈希表在图书管理系统中的实现
5.2.1 图书分类和标签的哈希索引
在图书管理系统中,哈希表可以用来实现图书的分类和标签索引。每个图书对象可以包含一个或多个分类标签,这些标签作为键值对存储在哈希表中。
例如,可以为每本书创建一个哈希表,键是分类名或标签,值是包含该分类或标签的所有图书的列表。
5.2.2 哈希表的动态扩展和优化
随着图书数量的增加,为了保持哈希表的高效性能,需要实现动态扩展策略。当负载因子(已存储元素与哈希表容量的比例)超过某个阈值时,可以通过重新计算哈希值和重新分配元素来扩展哈希表的容量。
优化哈希表性能的措施包括:
- 选择合适的哈希函数以最小化冲突。
- 根据实际数据分布调整哈希表的初始大小。
- 定期进行哈希表的重建(rehashing)以保持负载因子在合理范围内。
5.3 哈希表操作的实践案例分析
5.3.1 快速检索图书分类和标签
通过使用哈希表,图书的检索可以根据分类或标签进行非常快速的操作。例如,给定一个分类名,可以在常数时间复杂度内找到所有属于该分类的图书。
class Book:
    def __init__(self, title, tags):
        self.title = title
        self.tags = tags

class Library:
    def __init__(self):
        self.books_by_tag = {}

    def add_book(self, book):
        for tag in book.tags:
            if tag not in self.books_by_tag:
                self.books_by_tag[tag] = []
            self.books_by_tag[tag].append(book)

    def get_books_by_tag(self, tag):
        return self.books_by_tag.get(tag, [])

# 示例用法
library = Library()
book1 = Book("The Great Gatsby", ["Fiction", "Classic"])
library.add_book(book1)
print(library.get_books_by_tag("Fiction"))  # 输出: [Book("The Great Gatsby", ["Fiction", "Classic"])]
5.3.2 哈希表性能评估与调整
评估哈希表性能的一个关键指标是查找操作的平均时间复杂度。理想情况下,这个值应该接近常数时间。如果哈希表中冲突过多,查找时间可能会增加。
性能评估通常涉及:
- 计算哈希表的负载因子。
- 监控平均查找时间。
- 根据性能监控结果调整哈希表的策略。
调整策略可能包括:
- 调整哈希表的容量。
- 更换哈希函数。
- 实现更加高效的冲突解决算法。
通过定期评估和调整,可以确保哈希表在图书管理系统中维持最优的性能。
简介:数据结构课程设计是计算机科学与技术专业的实践环节,本项目以图书管理系统为主题,展示数据结构在软件开发中的应用。学生将利用C语言实现基于链表、树、栈、队列和哈希表的数据结构,以处理图书信息的存储、查询、添加、删除和修改等操作,并注重文件I/O、编程规范、设计模式以及系统测试,提升解决实际问题的能力。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献20条内容

所有评论(0)