第 92 场周赛:转置矩阵、具有所有最深节点的最小子树、回文质数、获取所有钥匙的最短路径
Q1、转置矩阵
1、题目描述
给你一个二维整数数组 matrix, 返回 matrix 的 转置矩阵 。
矩阵的 转置 是指将矩阵的主对角线翻转,交换矩阵的行索引与列索引。
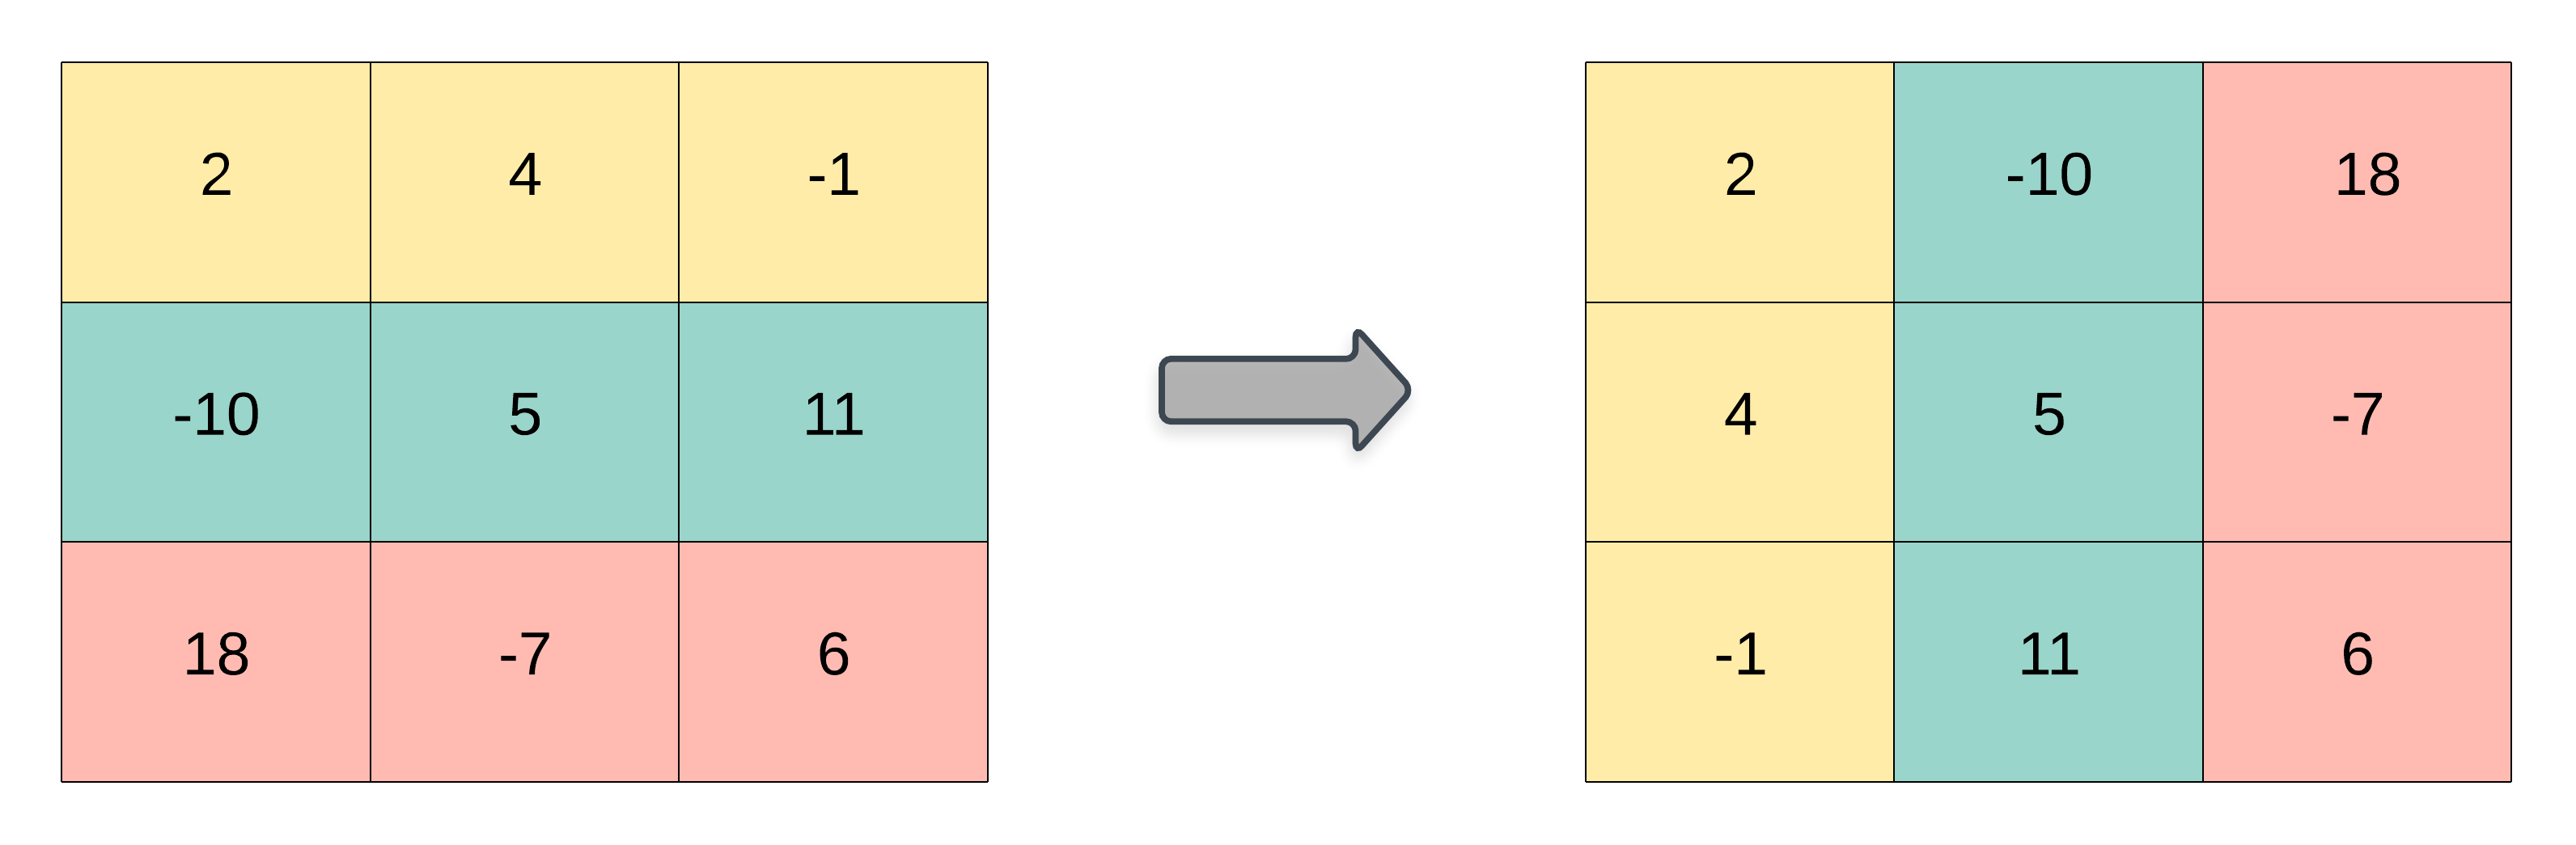
示例 1:
输入:matrix = [[1,2,3],[4,5,6],[7,8,9]]
输出:[[1,4,7],[2,5,8],[3,6,9]]
示例 2:
输入:matrix = [[1,2,3],[4,5,6]]
输出:[[1,4],[2,5],[3,6]]
提示:
m == matrix.lengthn == matrix[i].length1 <= m, n <= 10001 <= m * n <= 105-109 <= matrix[i][j] <= 109
2、解题思路
矩阵转置是指将原矩阵的行和列进行交换。具体来说,如果原矩阵在位置 (i,j) 有元素,那么在转置矩阵中该元素应该位于位置 (j,i)。
对于 m×n 的矩阵,其转置矩阵是 n×m 的矩阵。
3、代码实现
C++
class Solution {
public:
    vector<vector<int>> transpose(vector<vector<int>>& matrix) {
        // 获取原矩阵的行数
        int n = matrix.size();
        // 获取原矩阵的列数
        int m = matrix[0].size();
        // 创建转置矩阵,行数为m,列数为n,初始化为0
        vector<vector<int>> ret(m, vector<int>(n));

        // 遍历原矩阵的每一行
        for (int i = 0; i < n; ++i) {
            // 遍历原矩阵的每一列
            for (int j = 0; j < m; ++j) {
                // 将原矩阵(i,j)位置的元素放到转置矩阵(j,i)位置
                ret[j][i] = matrix[i][j];
            }
        }

        // 返回转置后的矩阵
        return ret;
    }
};
Java
class Solution {
    public int[][] transpose(int[][] matrix) {
        // 获取原矩阵的行数
        int n = matrix.length;
        // 获取原矩阵的列数
        int m = matrix[0].length;
        // 创建转置矩阵,行数为m,列数为n
        int[][] ret = new int[m][n];

        // 遍历原矩阵的每一行
        for (int i = 0; i < n; i++) {
            // 遍历原矩阵的每一列
            for (int j = 0; j < m; j++) {
                // 将原矩阵(i,j)位置的元素放到转置矩阵(j,i)位置
                ret[j][i] = matrix[i][j];
            }
        }

        // 返回转置后的矩阵
        return ret;
    }
}
Python
class Solution:
    def transpose(self, matrix: List[List[int]]) -> List[List[int]]:
        # 获取原矩阵的行数
        n = len(matrix)
        # 获取原矩阵的列数
        m = len(matrix[0])

        # 创建转置矩阵,行数为m,列数为n,初始化为0
        # 使用列表推导式创建二维数组
        ret = [[0] * n for _ in range(m)]

        # 遍历原矩阵的每一行
        for i in range(n):
            # 遍历原矩阵的每一列
            for j in range(m):
                # 将原矩阵(i,j)位置的元素放到转置矩阵(j,i)位置
                ret[j][i] = matrix[i][j]

        # 返回转置后的矩阵
        return ret
# 方法二:使用内置函数(Python特有)
class Solution:
    def transpose(self, matrix: List[List[int]]) -> List[List[int]]:
        # 使用zip函数配合解包操作符*来实现转置
        # zip(*matrix)会将matrix的每一行作为参数传给zip
        # zip会将所有参数的第0个元素组成一个元组,第1个元素组成一个元组,以此类推
        # 最后使用列表推导式将每个元组转换为列表
        return [list(row) for row in zip(*matrix)]
4、复杂度分析
- 时间复杂度: O(m×n),其中 m 是原矩阵的行数,n 是原矩阵的列数。我们需要遍历原矩阵的每个元素一次。
- 空间复杂度: O(m×n),需要创建一个新的矩阵来存储转置结果。
Q2、具有所有最深节点的最小子树
1、题目描述
给定一个根为 root 的二叉树,每个节点的深度是 该节点到根的最短距离 。
返回包含原始树中所有 最深节点 的 最小子树 。
如果一个节点在 整个树 的任意节点之间具有最大的深度,则该节点是 最深的 。
一个节点的 子树 是该节点加上它的所有后代的集合。
示例 1:
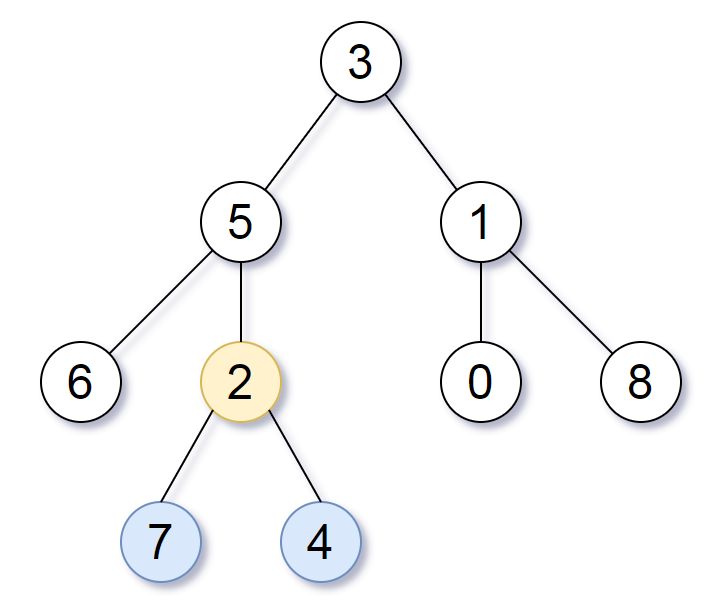
输入:root = [3,5,1,6,2,0,8,null,null,7,4]
输出:[2,7,4]
解释:
我们返回值为 2 的节点,在图中用黄色标记。
在图中用蓝色标记的是树的最深的节点。
注意,节点 5、3 和 2 包含树中最深的节点,但节点 2 的子树最小,因此我们返回它。
示例 2:
输入:root = [1]
输出:[1]
解释:根节点是树中最深的节点。
示例 3:
输入:root = [0,1,3,null,2]
输出:[2]
解释:树中最深的节点为 2 ,有效子树为节点 2、1 和 0 的子树,但节点 2 的子树最小。
提示:
- 树中节点的数量在
[1, 500]范围内。0 <= Node.val <= 500- 每个节点的值都是 独一无二 的。
2、解题思路
-
递归计算深度:从根节点出发,递归计算左右子树的深度。
-
比较左右子树深度 :
- 如果左子树的深度 > 右子树的深度,说明最深节点在左子树,返回左子树的结果。
- 如果右子树的深度 > 左子树的深度,说明最深节点在右子树,返回右子树的结果。
- 如果左右子树深度相同,说明当前节点是这些最深节点的最近公共祖先,返回当前节点。
3、代码实现
C++
class Solution {
public:
    TreeNode* subtreeWithAllDeepest(TreeNode* root) {
        return dfs(root).first; // 返回最深节点的最近公共祖先
    }

    // 辅助函数,返回 {最深节点的最近公共祖先, 当前子树的最大深度}
    pair<TreeNode*, int> dfs(TreeNode* root) {
        if (!root) {
            return {nullptr, 0}; // 空节点,深度为0
        }

        auto left = dfs(root->left);   // 递归左子树
        auto right = dfs(root->right); // 递归右子树

        if (left.second > right.second) {
            return {left.first, left.second + 1}; // 最深节点在左子树
        }
        if (left.second < right.second) {
            return {right.first, right.second + 1}; // 最深节点在右子树
        }

        // 左右子树深度相同,当前节点是LCA
        return {root, left.second + 1};
    }
};
Java
class Solution {
    public TreeNode subtreeWithAllDeepest(TreeNode root) {
        return dfs(root).node; // 返回最深节点的最近公共祖先
    }

    // 辅助类,存储节点和深度
    static class Result {
        TreeNode node;
        int depth;

        Result(TreeNode node, int depth) {
            this.node = node;
            this.depth = depth;
        }
    }

    private Result dfs(TreeNode root) {
        if (root == null) {
            return new Result(null, 0); // 空节点,深度为0
        }

        Result left = dfs(root.left); // 递归左子树
        Result right = dfs(root.right); // 递归右子树

        if (left.depth > right.depth) {
            return new Result(left.node, left.depth + 1); // 最深节点在左子树
        }
        if (left.depth < right.depth) {
            return new Result(right.node, right.depth + 1); // 最深节点在右子树
        }

        // 左右子树深度相同,当前节点是LCA
        return new Result(root, left.depth + 1);
    }
}
Python
class Solution:
    def subtreeWithAllDeepest(self, root: Optional[TreeNode]) -> Optional[TreeNode]:
        def dfs(node):
            if not node:
                return (None, 0)  # 空节点,深度为0

            left, left_depth = dfs(node.left)   # 递归左子树
            right, right_depth = dfs(node.right) # 递归右子树

            if left_depth > right_depth:
                return (left, left_depth + 1)   # 最深节点在左子树
            if left_depth < right_depth:
                return (right, right_depth + 1) # 最深节点在右子树

            # 左右子树深度相同,当前节点是LCA
            return (node, left_depth + 1)

        return dfs(root)[0]  # 返回最深节点的最近公共祖先
4、复杂度分析
- 时间复杂度:
O(N),每个节点仅访问一次。 - 空间复杂度:
O(H),递归栈的深度取决于树的高度。
Q3、回文质数
1、题目描述
给你一个整数 n ,返回大于或等于 n 的最小 回文质数。
一个整数如果恰好有两个除数:1 和它本身,那么它是 质数 。注意,1 不是质数。
- 例如,
2、3、5、7、11和13都是质数。
一个整数如果从左向右读和从右向左读是相同的,那么它是 回文数 。
- 例如,
101和12321都是回文数。
测试用例保证答案总是存在,并且在 [2, 2 * 108] 范围内。
示例 1:
输入:n = 6
输出:7
示例 2:
输入:n = 8
输出:11
示例 3:
输入:n = 13
输出:101
提示:
1 <= n <= 108
2、解题思路
方法一:生成回文数并检查是否为质数
- 生成回文数:
- 对于奇数长度的回文数,如
12321,可以将其视为123和21(即123的前两位的反转)。 - 对于偶数长度的回文数,如
1221,可以视为12和21(即12的反转)。
- 对于奇数长度的回文数,如
- 检查是否为质数:
- 对于生成的每个回文数,检查其是否为质数。
- 优化 :
- 跳过偶数长度的回文数,因为除了
11,其他偶数长度的回文数都能被11整除(例如1221可以分解为11 × 111)。 - 当
n在10,000,000到100,000,000之间时,直接跳到100,000,000,因为在这个范围内没有回文质数(因为偶数长度的回文数都能被11整除)。
- 跳过偶数长度的回文数,因为除了
方法二:逐个检查回文数
-
从
n开始逐个检查:- 检查当前数是否为回文数。
- 如果是回文数,再检查是否为质数。
-
优化 :
- 跳过偶数,因为除了
2,其他偶数不可能是质数。 - 当
n在10,000,000到100,000,000之间时,直接跳到100,000,000。
- 跳过偶数,因为除了
3、代码实现
C++
// 方法一: 生成回文数并检查是否为质数
class Solution {
public:
    int primePalindrome(int n) {
        if (n <= 2) {
            return 2; // 2是最小的回文质数
        }
        if (n <= 3) {
            return 3;
        }
        if (n <= 5) {
            return 5;
        }
        if (n <= 7) {
            return 7;
        }
        if (n <= 11) {
            return 11; // 11是唯一的偶数长度回文质数
        }

        // 生成奇数长度的回文数
        for (int L = 1; L <= 5; ++L) { // L是前半部分的长度
            for (int root = pow(10, L - 1); root < pow(10, L); ++root) {
                string s = to_string(root);
                string rev(s.rbegin() + 1, s.rend());  // 反转前半部分(去掉第一个字符)
                int x = stoi(s + rev); // 构造回文数
                if (x >= n && isPrime(x)) {
                    return x;
                }
            }
        }
        return -1; // 题目保证有解,这里不会执行
    }

private:
    bool isPrime(int n) {
        if (n < 2) {
            return false;
        }
        int sqrtN = sqrt(n);
        for (int d = 2; d <= sqrtN; ++d) {
            if (n % d == 0) {
                return false;
            }
        }
        return true;
    }
};
// 方法二: 逐个检查回文数
class Solution {
public:
    int primePalindrome(int n) {
        while (true) {
            if (n == reverse(n) && isPrime(n)) {
                return n;
            }
            ++n;
            // 跳过 10,000,000 到 100,000,000 之间的数
            if (10000000 < n && n < 100000000) {
                n = 100000000;
            }
        }
    }

private:
    bool isPrime(int n) {
        if (n < 2) {
            return false;
        }
        int sqrtN = sqrt(n);
        for (int d = 2; d <= sqrtN; ++d) {
            if (n % d == 0) {
                return false;
            }
        }
        return true;
    }

    int reverse(int n) {
        int ans = 0;
        while (n > 0) {
            ans = ans * 10 + (n % 10);
            n /= 10;
        }
        return ans;
    }
};
Java
// 方法一: 生成回文数并检查是否为质数
class Solution {
    public int primePalindrome(int n) {
        if (n <= 2)
            return 2;
        if (n <= 3)
            return 3;
        if (n <= 5)
            return 5;
        if (n <= 7)
            return 7;
        if (n <= 11)
            return 11;

        // 生成奇数长度的回文数
        for (int L = 1; L <= 5; ++L) {
            int start = (int) Math.pow(10, L - 1);
            int end = (int) Math.pow(10, L);
            for (int root = start; root < end; ++root) {
                String s = Integer.toString(root);
                String rev = new StringBuilder(s.substring(0, s.length() - 1)).reverse().toString();
                int x = Integer.parseInt(s + rev);
                if (x >= n && isPrime(x)) {
                    return x;
                }
            }
        }
        return -1; // 题目保证有解
    }

    private boolean isPrime(int n) {
        if (n < 2)
            return false;
        int sqrtN = (int) Math.sqrt(n);
        for (int d = 2; d <= sqrtN; ++d) {
            if (n % d == 0)
                return false;
        }
        return true;
    }
}
// 方法二: 逐个检查回文数
class Solution {
    public int primePalindrome(int n) {
        while (true) {
            if (n == reverse(n) && isPrime(n)) {
                return n;
            }
            ++n;
            // 跳过 10,000,000 到 100,000,000 之间的数
            if (10_000_000 < n && n < 100_000_000) {
                n = 100_000_000;
            }
        }
    }

    private boolean isPrime(int n) {
        if (n < 2)
            return false;
        int sqrtN = (int) Math.sqrt(n);
        for (int d = 2; d <= sqrtN; ++d) {
            if (n % d == 0)
                return false;
        }
        return true;
    }

    private int reverse(int n) {
        int ans = 0;
        while (n > 0) {
            ans = ans * 10 + (n % 10);
            n /= 10;
        }
        return ans;
    }
}
Python
# 方法一: 生成回文数并检查是否为质数
class Solution:
    def primePalindrome(self, n: int) -> int:
        if n <= 2:
            return 2
        if n <= 3:
            return 3
        if n <= 5:
            return 5
        if n <= 7:
            return 7
        if n <= 11:
            return 11

        # 生成奇数长度的回文数
        for L in range(1, 6):  # L是前半部分的长度
            start = 10 ** (L - 1)
            end = 10 ** L
            for root in range(start, end):
                s = str(root)
                rev = s[:-1][::-1]  # 反转前半部分(去掉最后一个字符)
                x = int(s + rev)
                if x >= n and self.is_prime(x):
                    return x
        return -1  # 题目保证有解

    def is_prime(self, n: int) -> bool:
        if n < 2:
            return False
        sqrt_n = int(math.sqrt(n))
        for d in range(2, sqrt_n + 1):
            if n % d == 0:
                return False
        return True
# 方法二: 逐个检查回文数
class Solution:
    def primePalindrome(self, n: int) -> int:
        while True:
            if self.is_palindrome(n) and self.is_prime(n):
                return n
            n += 1
            # 跳过 10,000,000 到 100,000,000 之间的数
            if 10_000_000 < n < 100_000_000:
                n = 100_000_000

    def is_prime(self, n: int) -> bool:
        if n < 2:
            return False
        sqrt_n = int(math.sqrt(n))
        for d in range(2, sqrt_n + 1):
            if n % d == 0:
                return False
        return True

    def is_palindrome(self, n: int) -> bool:
        return str(n) == str(n)[::-1]
4、复杂度分析
- 时间复杂度:
- 方法一:生成回文数的时间为
O(L),其中L是数字的长度。质数检查的时间为O(√N)。 - 方法二:最坏情况下需要检查
O(N)个数,每个数的检查时间为O(√N)。
- 方法一:生成回文数的时间为
- 空间复杂度:
O(1),只使用了常数空间。
Q4、获取所有钥匙的最短路径
1、题目描述
给定一个二维网格 grid ,其中:
- ‘.’ 代表一个空房间
- ‘#’ 代表一堵墙
- ‘@’ 是起点
- 小写字母代表钥匙
- 大写字母代表锁
我们从起点开始出发,一次移动是指向四个基本方向之一行走一个单位空间。我们不能在网格外面行走,也无法穿过一堵墙。如果途经一个钥匙,我们就把它捡起来。除非我们手里有对应的钥匙,否则无法通过锁。
假设 k 为 钥匙/锁 的个数,且满足 1 <= k <= 6,字母表中的前 k 个字母在网格中都有自己对应的一个小写和一个大写字母。换言之,每个锁有唯一对应的钥匙,每个钥匙也有唯一对应的锁。另外,代表钥匙和锁的字母互为大小写并按字母顺序排列。
返回获取所有钥匙所需要的移动的最少次数。如果无法获取所有钥匙,返回 -1 。
示例 1:
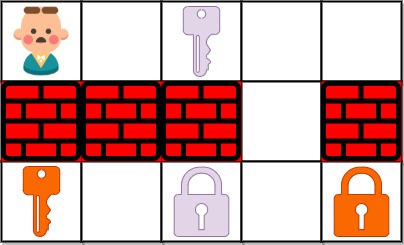
输入:grid = ["@.a..","###.#","b.A.B"]
输出:8
解释:目标是获得所有钥匙,而不是打开所有锁。
示例 2:
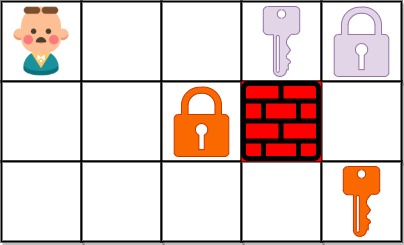
输入:grid = ["@..aA","..B#.","....b"]
输出:6
示例 3:
输入: grid = ["@Aa"]
输出: -1
提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 30grid[i][j]只含有'.','#','@','a'-``'f``'以及'A'-'F'- 钥匙的数目范围是
[1, 6]- 每个钥匙都对应一个 不同 的字母
- 每个钥匙正好打开一个对应的锁
2、解题思路
- BFS(广度优先搜索):适用于寻找最短路径。
- 状态表示:除了位置
(x, y),还需要记录当前持有的钥匙状态(用位掩码表示)。 - 队列处理:在队列中存储位置和钥匙状态,每次移动时更新状态:
- 遇到钥匙,更新掩码。
- 遇到锁,检查是否有对应钥匙。
- 终止条件:当收集到所有钥匙时返回当前步数。
3、代码实现
C++
class Solution {
public:
    int shortestPathAllKeys(vector<string>& grid) {
        int m = grid.size(), n = grid[0].size();
        int startX = 0, startY = 0;
        unordered_map<char, int> keyToIndex;

        // 找到起点和所有钥匙的索引
        for (int i = 0; i < m; ++i) {
            for (int j = 0; j < n; ++j) {
                if (grid[i][j] == '@') {
                    startX = i;
                    startY = j;
                } else if (islower(grid[i][j])) {
                    if (!keyToIndex.count(grid[i][j])) {
                        int idx = keyToIndex.size();
                        keyToIndex[grid[i][j]] = idx;
                    }
                }
            }
        }

        // 队列存储 (x, y, mask)
        queue<tuple<int, int, int>> q;
        // 距离数组,初始化为 -1
        vector<vector<vector<int>>> dist(m, vector<vector<int>>(n, vector<int>(1 << keyToIndex.size(), -1)));

        q.emplace(startX, startY, 0);
        dist[startX][startY][0] = 0;

        const int dirs[4][2] = {{-1, 0}, {1, 0}, {0, -1}, {0, 1}};

        while (!q.empty()) {
            auto [x, y, mask] = q.front();
            q.pop();

            for (int i = 0; i < 4; ++i) {
                int nx = x + dirs[i][0];
                int ny = y + dirs[i][1];

                if (nx >= 0 && nx < m && ny >= 0 && ny < n &&
                    grid[nx][ny] != '#') {
                    if (grid[nx][ny] == '.' || grid[nx][ny] == '@') {
                        if (dist[nx][ny][mask] == -1) {
                            dist[nx][ny][mask] = dist[x][y][mask] + 1;
                            q.emplace(nx, ny, mask);
                        }
                    } else if (islower(grid[nx][ny])) {
                        int idx = keyToIndex[grid[nx][ny]];
                        int newMask = mask | (1 << idx);
                        if (dist[nx][ny][newMask] == -1) {
                            dist[nx][ny][newMask] = dist[x][y][mask] + 1;
                            if (newMask == (1 << keyToIndex.size()) - 1) {
                                return dist[nx][ny][newMask];
                            }
                            q.emplace(nx, ny, newMask);
                        }
                    } else if (isupper(grid[nx][ny])) {
                        int idx = keyToIndex[tolower(grid[nx][ny])];
                        if ((mask & (1 << idx)) && dist[nx][ny][mask] == -1) {
                            dist[nx][ny][mask] = dist[x][y][mask] + 1;
                            q.emplace(nx, ny, mask);
                        }
                    }
                }
            }
        }

        return -1;
    }
};
Java
class Solution {
    public int shortestPathAllKeys(String[] grid) {
        int m = grid.length, n = grid[0].length();
        int startX = 0, startY = 0;
        Map<Character, Integer> keyToIndex = new HashMap<>();

        // 找到起点和所有钥匙的索引
        for (int i = 0; i < m; i++) {
            for (int j = 0; j < n; j++) {
                char c = grid[i].charAt(j);
                if (c == '@') {
                    startX = i;
                    startY = j;
                } else if (Character.isLowerCase(c)) {
                    keyToIndex.putIfAbsent(c, keyToIndex.size());
                }
            }
        }

        // 队列存储 {x, y, mask}
        Queue<int[]> q = new LinkedList<>();
        int[][][] dist = new int[m][n][1 << keyToIndex.size()];
        for (int i = 0; i < m; i++) {
            for (int j = 0; j < n; j++) {
                Arrays.fill(dist[i][j], -1);
            }
        }

        q.offer(new int[] { startX, startY, 0 });
        dist[startX][startY][0] = 0;

        int[][] dirs = { { -1, 0 }, { 1, 0 }, { 0, -1 }, { 0, 1 } };

        while (!q.isEmpty()) {
            int[] curr = q.poll();
            int x = curr[0], y = curr[1], mask = curr[2];

            for (int[] dir : dirs) {
                int nx = x + dir[0];
                int ny = y + dir[1];

                if (nx >= 0 && nx < m && ny >= 0 && ny < n && grid[nx].charAt(ny) != '#') {
                    char c = grid[nx].charAt(ny);
                    if (c == '.' || c == '@') {
                        if (dist[nx][ny][mask] == -1) {
                            dist[nx][ny][mask] = dist[x][y][mask] + 1;
                            q.offer(new int[] { nx, ny, mask });
                        }
                    } else if (Character.isLowerCase(c)) {
                        int idx = keyToIndex.get(c);
                        int newMask = mask | (1 << idx);
                        if (dist[nx][ny][newMask] == -1) {
                            dist[nx][ny][newMask] = dist[x][y][mask] + 1;
                            if (newMask == (1 << keyToIndex.size()) - 1) {
                                return dist[nx][ny][newMask];
                            }
                            q.offer(new int[] { nx, ny, newMask });
                        }
                    } else if (Character.isUpperCase(c)) {
                        int idx = keyToIndex.get(Character.toLowerCase(c));
                        if ((mask & (1 << idx)) != 0 && dist[nx][ny][mask] == -1) {
                            dist[nx][ny][mask] = dist[x][y][mask] + 1;
                            q.offer(new int[] { nx, ny, mask });
                        }
                    }
                }
            }
        }

        return -1;
    }
}
Python
class Solution:
    def shortestPathAllKeys(self, grid: List[str]) -> int:
        m, n = len(grid), len(grid[0])
        startX, startY = 0, 0
        keyToIndex = {}

        # 找到起点和所有钥匙的索引
        for i in range(m):
            for j in range(n):
                c = grid[i][j]
                if c == '@':
                    startX, startY = i, j
                elif c.islower():
                    if c not in keyToIndex:
                        keyToIndex[c] = len(keyToIndex)

        # 队列存储 (x, y, mask)
        q = deque()
        dist = [[[-1] * (1 << len(keyToIndex)) for _ in range(n)] for _ in range(m)]
        q.append((startX, startY, 0))
        dist[startX][startY][0] = 0

        dirs = [(-1, 0), (1, 0), (0, -1), (0, 1)]

        while q:
            x, y, mask = q.popleft()

            for dx, dy in dirs:
                nx, ny = x + dx, y + dy
                if 0 <= nx < m and 0 <= ny < n and grid[nx][ny] != '#':
                    c = grid[nx][ny]
                    if c == '.' or c == '@':
                        if dist[nx][ny][mask] == -1:
                            dist[nx][ny][mask] = dist[x][y][mask] + 1
                            q.append((nx, ny, mask))
                    elif c.islower():
                        idx = keyToIndex[c]
                        newMask = mask | (1 << idx)
                        if dist[nx][ny][newMask] == -1:
                            dist[nx][ny][newMask] = dist[x][y][mask] + 1
                            if newMask == (1 << len(keyToIndex)) - 1:
                                return dist[nx][ny][newMask]
                            q.append((nx, ny, newMask))
                    elif c.isupper():
                        idx = keyToIndex[c.lower()]
                        if (mask & (1 << idx)) and dist[nx][ny][mask] == -1:
                            dist[nx][ny][mask] = dist[x][y][mask] + 1
                            q.append((nx, ny, mask))

        return -1
4、复杂度分析
- 时间复杂度:
O(m × n × 2^k),其中m和n是网格的行列数,k是钥匙数量。 - 空间复杂度:
O(m × n × 2^k),用于存储访问状态。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 123
 0
- 0


 已为社区贡献3条内容

所有评论(0)