Linux环境下C语言实现MD5加密算法

简介:MD5是一种广泛使用的哈希算法,能够将任意长度的数据转换为128位的摘要。在Linux系统编程中,C语言是基础,因此用C语言实现MD5加密对于系统级开发和安全应用至关重要。本文将介绍MD5算法原理、数据预处理、状态变量、消息块处理、C语言编程技巧、内存管理、位操作、二进制与十六进制转换、错误处理以及性能优化。通过阅读源代码文件”md5”,读者可以深入理解MD5算法的具体实现,并探索如何进一步扩展其功能。
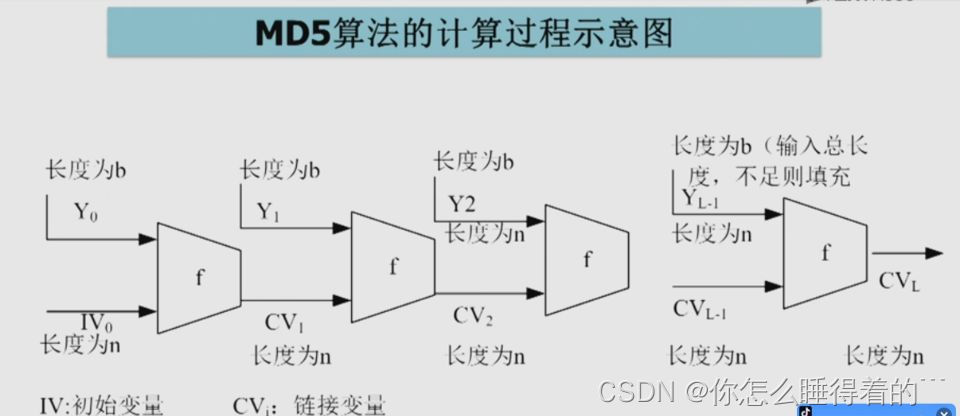
1. MD5算法原理介绍
MD5(Message-Digest Algorithm 5)是广泛用于数据完整性检查的一种散列函数,它能产生出一个128位(16字节)的散列值(hash value),通常用一个32位十六进制数表示。MD5设计的初衷是为了提供安全的数据完整性保护,在网络数据传输中广泛应用于验证数据是否在传输过程中被篡改。
MD5算法的核心是一个“压缩函数”,它能够将512位的数据块转换成一个128位的输出。这个过程主要包括四个步骤:初始化、填充、分组处理、输出最终散列值。通过这些步骤,MD5算法能够将任意长度的数据转换为一个固定长度的散列值,这一特性让它成为了密码学和软件安全中的一个重要工具。
尽管MD5提供了一定级别的数据完整性验证,但它并不是一个用于加密的算法,它不具备可逆性。MD5容易受到碰撞攻击,所以它不适合用于安全性要求高的场合,但理解MD5的工作原理对于理解现代加密算法仍具有基础性意义。在接下来的章节中,我们将详细探讨MD5的工作流程,包括它的数据预处理方法、状态变量维护、消息块处理流程,以及如何在编程实践中使用MD5算法。
2. 数据预处理方法
2.1 MD5算法中的填充规则
2.1.1 数据填充的基本原则
在MD5算法中,填充操作的目的是为了使得输入的数据长度符合算法的处理要求。输入的原始数据长度必须是512位的整数倍。为了达到这个目的,算法通过添加一个1比特后跟若干个0比特的方式来填充数据。填充规则如下:
- 如果原始数据长度(以比特为单位)对512取模的结果是448,则不需要填充;
- 否则,需要填充至长度刚好为512的倍数。填充的比特数等于448减去原始数据长度对512取模的结果,且填充的比特串以1比特开始,后面跟着若干个0比特。
2.1.2 填充步骤和实例解析
填充的具体步骤如下:
- 计算原始数据长度对512取模后的余数;
- 根据余数确定需要填充的比特数;
- 在原始数据的末尾添加1比特;
- 从计算出的比特数中减去1,用该数量的0比特填充;
- 追加64位的原始数据长度信息(以比特为单位,高字节在前)。
举个例子,假设原始数据长度为1000比特:
- 首先计算出1000对512取模得到余数,余数为488;
- 需要填充的比特数是448 - 488 = -40,由于填充比特数不能为负,我们实际上要填充的比特数是512 - 488 = 24;
- 在原始数据的末尾添加1比特;
- 接着添加23个0比特;
- 最后追加64位的长度信息,表示原始数据长度为1000比特。
2.2 数据分组处理
2.2.1 分组的目的和方法
MD5算法将输入的数据分为若干个512比特的分组进行处理。分组处理的目的在于确保MD5算法能够对任何长度的数据进行处理,它将长数据划分成适合算法处理的固定长度数据块。
分组方法如下:
- 将输入数据视为512比特的块序列;
- 每个块被进一步划分为16个32比特的字;
- 这些字会被用来作为消息扩展函数的输入参数,进而用于加密过程中的非线性函数。
2.2.2 分组流程和注意事项
分组流程分为以下几个步骤:
- 将原始数据按照512比特分组;
- 将每个512比特分组再细分为16个32比特的子分组;
- 对于每个分组,计算出对应的消息摘要。
进行分组处理时需注意的几个事项:
- 确保每个分组的长度都是512比特,如果原始数据长度不足以构成一个新的分组,则需要进行填充;
- 在实际编程实现时,需要考虑数据的字节序问题,因为MD5算法的参考实现是基于小端字节序的,所以如果是在大端字节序的机器上实现,需要进行字节序转换;
- 分组处理是循环进行的,每次处理一个分组的数据,直到所有数据处理完毕;
- 要保留原始数据的长度信息,这个信息将用于最后的输出阶段。
// 示例代码块,展示如何在C语言中进行数据分组
void process_data_group(unsigned char* data_group, uint32_t* words) {
    for (int i = 0; i < 16; i++) {
        // 假设read_data函数可以从data_group中读取一个32比特的字并转换成大端字节序
        words[i] = read_data(data_group + i * 4);
    }
    // 进行分组处理的其他操作...
}
在上述代码块中, process_data_group 函数展示了如何从512比特的数据块中提取16个32比特的字。 read_data 函数的实现依赖于特定的硬件平台和数据字节序要求。代码中的逻辑分析和参数说明对于理解整个分组处理流程非常关键。
graph TD
A[开始数据分组] --> B[读取512比特分组数据]
B --> C[将分组划分为16个32比特的字]
C --> D[进行分组处理]
D --> E[结束数据分组]
通过以上流程图,可以形象地表示数据分组处理的步骤。每一步都是清晰和有序的,以确保数据被正确地分组和处理。
在下一节中,我们将探讨状态变量的维护和它在MD5算法中的作用。
3. MD5状态变量维护
3.1 状态变量的作用和定义
3.1.1 状态变量的初始化
MD5算法的核心是通过一系列的变换,将输入的任意长度的消息转换为固定长度的散列值。这些变换的执行依赖于四个状态变量,它们分别代表了消息处理过程中的不同阶段。状态变量在MD5算法中扮演着至关重要的角色,因为它们记录了当前处理的中间状态,且最终它们的值决定了最终生成的MD5散列。
在算法开始执行前,这四个状态变量必须被初始化为特定的常数值。这些初始化值如下:
- A: 0x67452301
- B: 0xefcdab89
- C: 0x98badcfe
- D: 0x10325476
这些值是按照自然顺序的字母表排列的十六进制数。在MD5的上下文中,这些字母代表了初始状态,并且每个变量都代表了消息摘要的一个128位的部分。
在代码中,通常会有一个步骤来初始化这些状态变量,如下所示的C语言代码片段:
uint32_t state[4];

void initialize_state(uint32_t *state) {
    state[0] = 0x67452301;
    state[1] = 0xefcdab89;
    state[2] = 0x98badcfe;
    state[3] = 0x10325476;
}

// 调用函数以初始化状态变量
initialize_state(state);
上述代码定义了一个名为 state 的数组,用于存储四个状态变量,并且定义了一个名为 initialize_state 的函数来设置这些变量的初始值。调用这个函数之后,状态变量便准备就绪,可以用于后续的MD5处理。
3.1.2 状态变量的更新机制
MD5算法通过不断更新这些状态变量来逐步处理输入的消息。在MD5的四轮处理中,每一轮都会根据当前消息块的内容和一系列操作来更新这四个状态变量的值。更新机制确保了每个消息块都影响着最终的散列值。
MD5的状态更新是通过应用四组不同的辅助函数和四个固定常数实现的。每一轮使用不同的辅助函数(记作F、G、H、I),以及一组不同的常数,这些常数是根据四次多项式函数生成的。
下面的伪代码描述了在每一轮中状态变量是如何更新的:
for each 16-word message block {
    let a, b, c, d = state[0], state[1], state[2], state[3];
    // 四轮中每轮的函数和常数
    for each 16 rounds {
        let (func, constant) = get_round_function_and_constant(round_number);
        a = b + ((a + func(b, c, d) + X[k] + constant) <<< s);
        // 循环左移操作
        b = a;
        c = b;
        d = c;
    }
    state[0] += a;
    state[1] += b;
    state[2] += c;
    state[3] += d;
}
在这个伪代码中, get_round_function_and_constant 是一个辅助函数,用于获取每一轮的辅助函数和常数。 X[k] 表示当前消息块中的第k个16位字。 <<< s 表示循环左移操作,其具体位数 s 取决于当前轮次。每一轮结束后, a 、 b 、 c 和 d 的值会累加到状态变量中。
最终,所有消息块处理完毕后,状态变量即为最终的散列值。需要注意的是,MD5算法在每轮结束后都会更新状态变量的值,这样保证了消息内容的微小变化都将导致最终散列值的显著变化,即具有雪崩效应。
3.2 状态变量的数学表示
3.2.1 状态变量与MD5算法的关联
在MD5算法中,状态变量的更新过程可以视为数学上的变换,这是算法核心设计的一个重要方面。每个状态变量在每一轮中都参与了一个复杂的非线性变换,这些变换设计得十分精巧,目的是为了提高算法对初始输入值的敏感性,以及在不同消息块之间的扩散速度。
这四个状态变量的每一轮变换可以表示为:
A = B + ((A + f(B, C, D) + X[i] + T[i]) <<< S)
B = A
C = B
D = C
其中, f 是当前轮次中选定的辅助函数, X[i] 是当前处理消息块中的第 i 个字, T[i] 是第 i 个轮次常数,而 <<< S 表示左移操作,其中 S 是轮次依赖的位移量。
3.2.2 状态变量在加密过程中的变化
在MD5的每一轮处理中,状态变量都经历着一个复杂的变换,这个变换包括对输入数据的选取和处理、辅助函数的计算、以及最终与状态变量的结合。每一轮变换之后,状态变量会发生变化,而这种变化是累积的,直至最后计算出最终的散列值。
这个过程可以用下图展示:
graph LR
A[开始] --> B[消息填充]
B --> C[分组处理]
C --> D[初始化状态变量]
D --> E[消息块循环]
E --> F[四轮辅助函数操作]
F --> G[更新状态变量]
G --> H[循环结束?]
H -- 否 --> E
H -- 是 --> I[输出最终散列值]
每一轮结束后,状态变量的值都受到输入消息块、轮次函数、轮次常数和位移量的影响,产生一系列变化。状态变量是MD5算法中保持连续性和累积性的关键元素,它们的最终状态是消息摘要的代表。
graph LR
style A fill:#f9f,stroke:#333,stroke-width:2px
style B fill:#ccf,stroke:#f66,stroke-width:2px
style C fill:#cfc,stroke:#333,stroke-width:2px
style D fill:#fcc,stroke:#333,stroke-width:2px

A[状态变量A] -->|轮次1| B[更新后的A]
A -->|轮次2| C[更新后的A]
A -->|轮次3| D[更新后的A]
B -->|轮次4| A
C -->|轮次4| B
D -->|轮次4| C
从上图可以看到,状态变量A在四个轮次中的更新是相互关联的。每一轮都会计算新的A值,然后将其传递给下一轮,同时保留前一轮的结果,用于计算当前轮次的其它变量(B、C、D)。这种交织的计算方式,保证了算法的安全性和复杂性。
状态变量的这些变换和更新机制是MD5算法设计中的关键元素,也是理解MD5算法如何将输入数据转换为散列值的核心。每个阶段的精确操作确保了MD5能够为不同的输入数据生成具有较高一致性的散列值。
4. MD5消息块处理流程
消息块是MD5算法中用于分步处理消息的基本单元。每一个消息块都经过一系列复杂的运算过程,最终对整个消息的MD5散列值产生影响。了解消息块的处理流程对于深入理解MD5算法的运作机制至关重要。
4.1 消息块的概念和结构
4.1.1 消息块的组成
MD5将输入数据按512位(64字节)分组,每组称为一个消息块。消息块的结构是由原始数据填充至512位长度后形成的固定长度的消息。在填充过程中,第一个填充位是1,其余都是0。之后紧跟的是64位的长度字段,表示原始数据的长度,使得每个消息块的大小为448+64位。
4.1.2 消息块与加密的关系
消息块的每一个部分都会在MD5的四轮迭代运算中发挥作用。通过这种分块方式,MD5算法能够将任意长度的输入消息转化为固定长度的散列值。每个消息块独立地参与运算,但最终生成的散列值会综合考虑所有消息块的信息。
4.2 消息块处理的具体步骤
4.2.1 消息扩展过程详解
消息扩展过程是为了在每一轮迭代中生成16个32位字。原始的消息块是16个32位字,通过一个扩展函数将这16个字扩展到64个字,以供四轮运算使用。这个扩展函数相当于是将原始消息块的一个“平铺”版本转换成一个“扩展”的版本。
// 伪代码表示消息扩展函数
void message_extension(uint32_t *X, uint32_t *T)
{
    for (int i = 16; i < 64; ++i) {
        uint32_t s = sin_table[i];
        T[i] = X[i - 3] ^ X[i - 8] ^ X[i - 14] ^ X[i - 16];
        T[i] = (T[i] << s) | (T[i] >> (32 - s));
        X[i] = X[i - 16] + T[i];
    }
}
4.2.2 四轮非线性函数处理
MD5算法的四轮非线性函数处理是其核心运算部分,通过四个不同的非线性函数对消息块进行处理,依次为:F, G, H, 和 I。每一轮使用不同的非线性函数,并且循环使用消息扩展得到的64个32位字。
每一轮运算包含16个步骤,每一个步骤都使用到当前状态下的四个32位变量、一个非线性函数、和一个扩展出的32位消息字。每轮结束时,会更新这四个状态变量,为下一轮运算做准备。
MD5算法的每个步骤可以表示为:
// 伪代码表示四轮非线性函数处理
for (int i = 0; i < 64; ++i) {
    uint32_t temp = state[i % 4] + f[i] + X[i] + T[i / 16];
    state[i % 4] = state[(i + 3) % 4] + (temp << s[i]) + (temp >> (32 - s[i]));
}
在这个过程中,状态变量(由四个32位的寄存器组成)会受到消息字的直接或间接影响,并与非线性函数和之前的状态值相结合,最终形成了MD5散列值中的四个32位部分。
以上内容只展示了MD5消息块处理流程中的两个关键步骤:消息扩展和四轮非线性函数处理。理解和掌握这两个步骤对于深入分析MD5算法,以及未来可能的优化和改进工作都是至关重要的。
5. C语言编程技巧和实现
5.1 C语言中MD5加密函数的构建
5.1.1 函数框架和主要参数
在C语言中构建MD5加密函数,首先需要定义一个清晰的函数框架,明确函数的输入和输出,以及必要的辅助数据结构。MD5加密函数的核心输入是一个字符串(待加密的信息),输出是经过加密处理后的32字符长的十六进制数字串,代表了MD5哈希值。
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

// MD5加密函数声明
void md5加密函数(const char *input, char output[33]);

// 主函数入口
int main(int argc, char *argv[]) {
    const char *text = "Hello, World!";
    char md5_hash[33];

    md5加密函数(text, md5_hash);
    printf("MD5(%s) = %s\n", text, md5_hash);

    return 0;
}

// MD5加密函数定义
void md5加密函数(const char *input, char output[33]) {
    // 此处省略了具体的MD5实现细节
    // ...
}
在这个例子中,我们定义了一个 md5加密函数 ,它接受一个 const char* 类型的输入字符串 input ,并输出一个33字符长(包括终止的空字符)的字符串 output 。输出字符串包含32个MD5哈希的十六进制表示,加上一个空字符。
5.1.2 函数的模块化实现
MD5算法的实现相当复杂,涉及到逻辑运算、位运算等。在实际编码中,推荐将MD5算法的各个步骤进行模块化处理,这样代码的可读性和可维护性会更高。
void md5加密函数(const char *input, char output[33]) {
    // 数据预处理
    MD5_CTX context;
    MD5Init(&context);

    // 输入填充与分组
    MD5Update(&context, input, strlen(input));

    // 结果处理和输出
    unsigned char result[16];
    MD5Final(result, &context);

    // 转换为32字符的十六进制字符串
    for (int i = 0; i < 16; i++) {
        sprintf(output + (i * 2), "%02x", result[i]);
    }
}
在上面的代码片段中,使用了MD5的三个辅助函数: MD5Init , MD5Update , 和 MD5Final 。这些函数是MD5算法不同阶段的封装,分别用于初始化上下文、更新消息内容和计算最终的哈希值。
5.2 字符串与缓冲区的处理
5.2.1 字符串处理技巧
在C语言中,字符串处理是MD5加密中不可或缺的一部分。处理字符串时,需要特别注意字符串的结尾标志( null 终止符),以及可能对加密结果产生影响的字符编码问题。
// 字符串处理函数
void processString(const char *str, char *processed) {
    while (*str) {
        if (isalpha(*str) || isdigit(*str)) {
            // 这里仅举例处理字母和数字字符,实际处理应根据需求进行
            *processed++ = *str;
        }
        str++;
    }
    *processed = '\0'; // 添加字符串结尾
}

// 在md5加密函数中使用字符串处理函数
void md5加密函数(const char *input, char output[33]) {
    char processedInput[1024];
    processString(input, processedInput);

    MD5_CTX context;
    MD5Init(&context);
    MD5Update(&context, processedInput, strlen(processedInput));
    unsigned char result[16];
    MD5Final(result, &context);

    for (int i = 0; i < 16; i++) {
        sprintf(output + (i * 2), "%02x", result[i]);
    }
}
在 processString 函数中,我们遍历输入字符串,并且仅复制字母和数字字符到 processed 字符串中,这可以用于一些简单的字符过滤。
5.2.2 缓冲区操作和安全性考虑
处理数据时,缓冲区的使用需要特别小心。缓冲区溢出是C语言中常见的安全问题。在实现MD5时,需要确保对缓冲区的读写不会超过其边界,并且在操作字符串时要正确处理空字符。
// 安全字符串复制函数
char *safeStrCopy(char *dest, const char *src) {
    char *ptr = dest;
    while (*src) {
        *ptr++ = *src++;
    }
    *ptr = '\0'; // 添加字符串结尾
    return dest;
}

// 使用安全字符串复制函数来避免缓冲区溢出
void md5加密函数(const char *input, char output[33]) {
    char processedInput[1024];
    safeStrCopy(processedInput, input);

    MD5_CTX context;
    MD5Init(&context);
    MD5Update(&context, processedInput, strlen(processedInput));
    unsigned char result[16];
    MD5Final(result, &context);

    for (int i = 0; i < 16; i++) {
        sprintf(output + (i * 2), "%02x", result[i]);
    }
}
在上述代码中, safeStrCopy 函数通过在复制过程中检查源字符串的终止字符来防止缓冲区溢出。这是一种常见的防御性编程实践,能显著降低安全漏洞的风险。
通过以上内容,我们探讨了如何在C语言中实现MD5加密函数,从函数的框架设计到具体实现,再到字符串与缓冲区的处理技巧。这些内容对于理解MD5算法在实际编程中的应用至关重要。
6. 内存管理和性能优化策略
在软件开发中,内存管理是保持程序稳定性和性能的关键因素。随着应用变得越来越复杂,如何合理地管理内存以及如何优化性能成为了开发者必须面对的问题。本章节将深入探讨内存分配与释放的重要性,以及性能优化的策略和实践案例。
6.1 内存分配与释放的重要性
6.1.1 动态内存管理原则
动态内存管理是C语言中常见的内存操作技术,包括内存的申请(malloc、calloc)、调整(realloc)和释放(free)。理解其原则,对于避免内存泄漏、碎片化等问题至关重要。
- 申请内存时,应明确大小和目的 ,避免申请过大或过小的内存块。
- 使用内存前,应检查指针是否为NULL ,确保内存确实申请成功。
- 调整内存大小时,需要考虑原有数据的复制和新内存的申请 ,以适应数据的变化需求。
- 释放内存后,应将指针设置为NULL ,防止野指针的出现。
6.1.2 内存泄漏的预防与检测
内存泄漏是在程序运行过程中由于忘记释放已经不再使用的内存所造成的资源浪费。预防和检测内存泄漏,通常可以采取以下措施:
- 使用静态代码分析工具 ,如Valgrind,它们可以在开发阶段提供内存泄漏的警告。
- 实现良好的内存管理规范 ,例如,为每个内存申请操作编写对应的释放代码。
- 编写自动化测试 ,在测试过程中检查内存使用情况,以检测潜在的内存泄漏。
6.2 性能优化的方法与实践
6.2.1 优化原则和常见方法
性能优化是一个持续的过程,它要求开发者了解程序的瓶颈,并采取相应措施提升效率。
- 原则一:测量是优化的基础 ,没有数据支持的优化是盲目的。
- 原则二:优化工作应从上至下进行 ,首先优化程序中最耗时的部分。
- 原则三:避免过度优化 ,优化可能带来代码的复杂化,应当权衡利弊。
常见的性能优化方法有:
- 算法优化 :选择更高效的算法来降低时间复杂度。
- 数据结构优化 :根据访问模式选择合适的存储结构。
- 并行计算 :使用多线程或多进程来提升计算密集型任务的性能。
- 缓存优化 :合理利用缓存,减少内存访问延迟。
6.2.2 实际代码优化案例分析
以MD5算法的C语言实现为例,一个关键的优化点是在处理消息块时减少不必要的内存分配和复制操作。下面是一个优化前后的代码对比:
// 优化前的代码示例:使用临时数组存储中间结果
uint32_t temp[64];
memcpy(temp, state, 16 * sizeof(uint32_t));

// 循环处理消息块
for (int i = 0; i < 64; ++i) {
    // 复制操作
    memcpy(temp + i * 4, buffer + i * 4, 4 * sizeof(uint32_t));
    // 其他处理
}

// 优化后的代码示例:直接在状态变量上进行操作
uint32_t state[16];
// 直接操作状态变量,避免额外的内存复制
for (int i = 0; i < 64; ++i) {
    // 直接处理,无需复制
    update_state(state, buffer[i]);
}

void update_state(uint32_t* state, uint32_t block) {
    // 状态更新逻辑
}
在这个例子中,通过直接在状态变量上进行操作,避免了不必要的内存复制,减少了操作时间和资源消耗。代码也变得更加简洁明了。
通过这些优化方法,可以在保证算法正确性的同时,大幅度提升性能。然而,优化时需要细心和耐心,因为每一处细微的改动都可能对整个系统的性能产生影响。
简介:MD5是一种广泛使用的哈希算法,能够将任意长度的数据转换为128位的摘要。在Linux系统编程中,C语言是基础,因此用C语言实现MD5加密对于系统级开发和安全应用至关重要。本文将介绍MD5算法原理、数据预处理、状态变量、消息块处理、C语言编程技巧、内存管理、位操作、二进制与十六进制转换、错误处理以及性能优化。通过阅读源代码文件”md5”,读者可以深入理解MD5算法的具体实现,并探索如何进一步扩展其功能。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献25条内容

所有评论(0)