【数据库】MySQL 高可用架构与数据可靠性方案概览
参考链接:https://www.bilibili.com/video/BV1m44y1Q7ZF
一、高可用架构对比分析
1. Multi Master Replication Manager (MMM) - 廉颇老矣(单主模式)
核心概述:基于Perl脚本的MySQL主从复制监控与故障迁移工具,同一时间仅一台主服务器对外提供写服务。
官方资源:http://mysql-mmm.org/
核心特性
- 优势:
- 支持读写VIP配置,实现读写请求高可用
- 工具包完整,无需额外开发脚本
- 故障转移后可持续监控集群状态
- 局限:
- 故障处理机制简单,存在数据丢失风险(建议搭配半同步复制缓解)
- 社区维护停滞,不支持GTID复制
- 已不推荐在新架构中使用
架构说明:
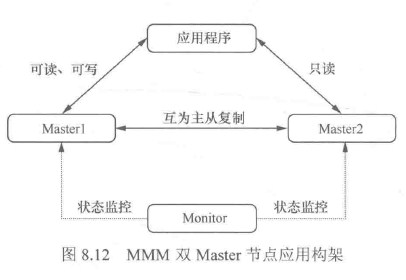
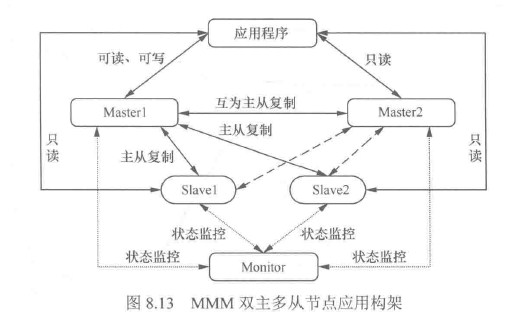
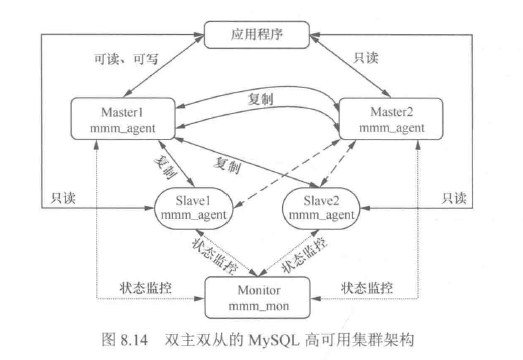
MMM 架构由监控节点(monitor)、主节点(master)、从节点(slave)及 VIP(虚拟 IP)组成。
- 监控节点:通过perl脚本定时检测主从节点健康状态,管理VIP漂移与角色切换;
- 主节点:对外提供写服务,通过异步复制将数据同步至从节点;
- 从节点:仅处理读请求,实时同步主节点数据;
- VIP:分为写VIP(绑定主节点)和读VIP(绑定从节点),故障时自动漂移至健康节点,确保应用访问地址不变。
架构图
- MMM双Master节点应用架构
- 在双Master节点的基础上,增加多个Slave节点,即可实现双主多从节点应用架构
- 双主双从的MYSQL高可用集群架构
参考:https://blog.csdn.net/weixin_33827590/article/details/92576485
2. MHA (Master High Availability) - 霓虹国佳作(单主模式)
核心概述:由日本DeNA公司开发的主从集群故障自动切换工具,通过Manager+Node架构实现秒级故障转移。
官方资源:https://github.com/yoshinorim/mha4mysql-manager
核心特性
- 优势:
- 自动监测Master故障并完成Slave提升与重新指向
- 可扩展性强,支持多节点集群扩展
- 与半同步复制兼容性极佳,减少数据丢失风险
- 三节点/多节点架构降低整体不可用概率
- 局限:
- 至少需三节点,资源消耗较高
- 故障排查逻辑复杂,对运维能力要求高
- 依赖原生复制保证一致性,仍存在数据不一致风险
- 可能因网络分区导致脑裂
架构说明:
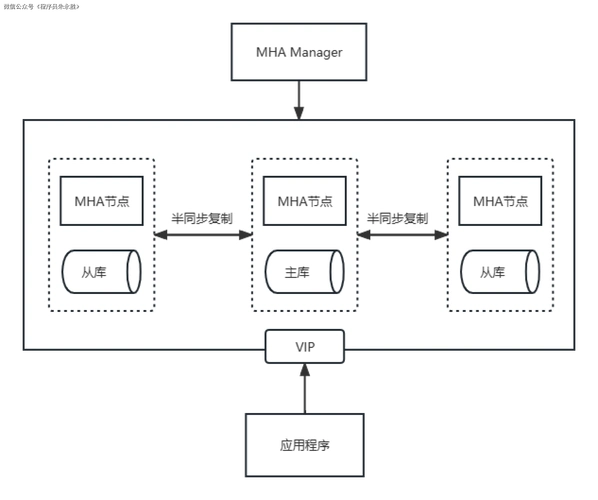
MHA采用“Manager+Node”分布式架构,核心组件包括:
- Manager节点:1台(可部署在独立服务器或从节点),负责监控主节点健康状态、触发故障转移、协调节点角色切换;
- Node节点:部署在所有MySQL服务器(主节点+从节点),通过ssh通信执行具体操作(如复制binlog、提升从节点为主节点等);
- 主从复制链路:主节点通过异步/半同步复制向从节点同步数据,从节点需开启binlog以便故障时相互同步缺失数据;
- 故障转移流程:Manager检测到主节点故障后,通过Node从存活从节点中选择最优节点(数据最新)提升为主节点,其余从节点重新指向新主节点。
架构图
参考:https://blog.csdn.net/ver_mouth__/article/details/125505968
3. MySQL Group Replication (MGR) - 后起之秀(单/多主模式)
核心概述:MySQL 5.7.17+内置的高可用插件,基于Raft协议实现数据强一致性与自动故障转移。
官方资源:https://dev.mysql.com/doc/refman/5.7/en/group-replication.html
核心特性
- 模式支持:
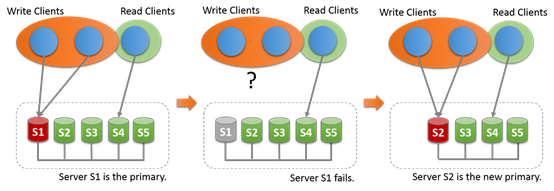
- 单主模式(推荐):自动选举primary节点处理写请求,所有节点可处理读请求
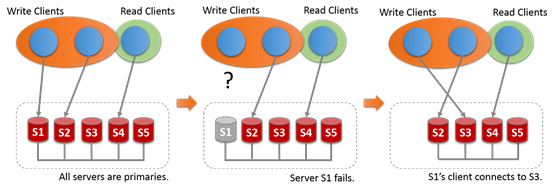
- 多主模式:支持多节点并行写入(尚不成熟)
- 优势:
- 数据强一致性,事务提交需集群多数节点确认(N/2+1)
- 自动选主与故障转移,集群可用性高
- 延迟显著低于异步复制,接近实时同步
- 插件化实现,部署使用简单
- 局限:
- 仅支持InnoDB引擎,依赖GTID与row格式日志
- 不支持间隙锁,需设置隔离级别为read_committed
- 多主模式不支持外键,最多支持9个节点
- DDL语句无原子性,需手动校验一致性
架构说明:
MGR基于插件化实现,核心组件与机制包括:
- 集群节点:最少3个节点(确保多数派),每个节点需启用Group Replication插件,支持InnoDB引擎与GTID;
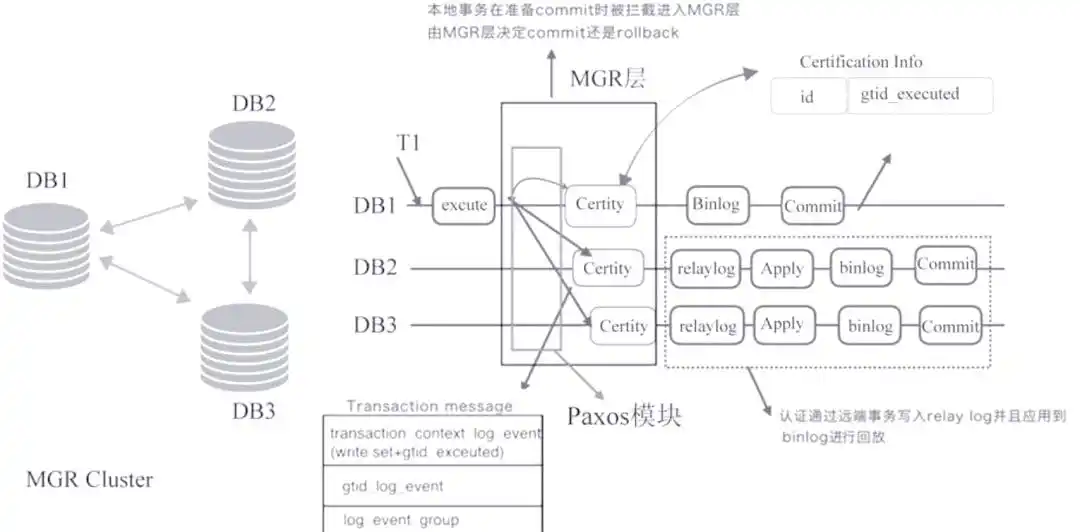
- 通信层:节点间通过TCP/IP协议交换事务信息,使用组通信引擎(Group Communication System)实现消息广播;
- Raft协议:用于集群成员管理、primary节点选举及事务一致性确认(提交前需多数节点持久化事务日志);
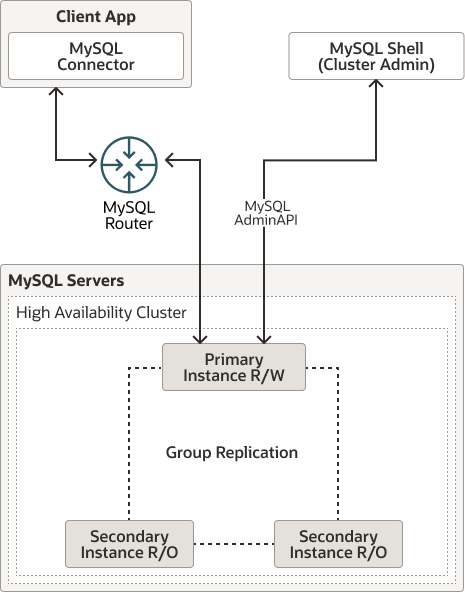
- 单主模式下:自动选举1个primary节点处理写请求,其余节点(secondary)仅处理读请求,primary故障后自动从secondary中选举新主;
- 多主模式下:所有节点均可处理写请求,但需避免写入冲突(依赖应用层控制)。
架构图
MGR协议
MGR单主
MGR多主
MySQL Innodb Cluster(官方 MGR+MySQL Router)
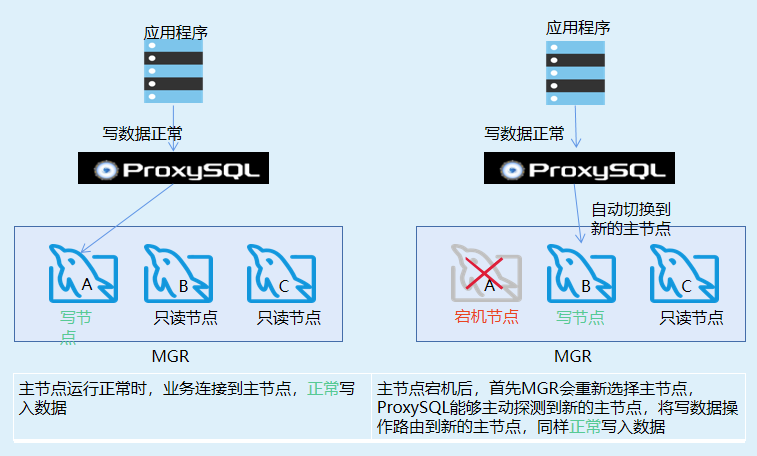
MGR+ProxySQL
4. MySQL Cluster - 官方亲儿子(多主模式)
核心概述:MySQL官方集群方案,基于NDB存储引擎实现数据实时冗余与分布式存储。
官方资源:https://dev.mysql.com/doc/refman/8.0/en/mysql-cluster.html
核心特性
- 优势:
- 全官方组件,无第三方依赖,兼容性强
- 数据强一致性,通过NDB引擎实时备份冗余数据
- 支持多节点并行写入,分布式处理请求
- 局限:
- 国内应用案例少,运维经验不足
- 依赖NDB存储引擎,与常规引擎差异较大
- 配置复杂,至少需三节点部署
架构说明:
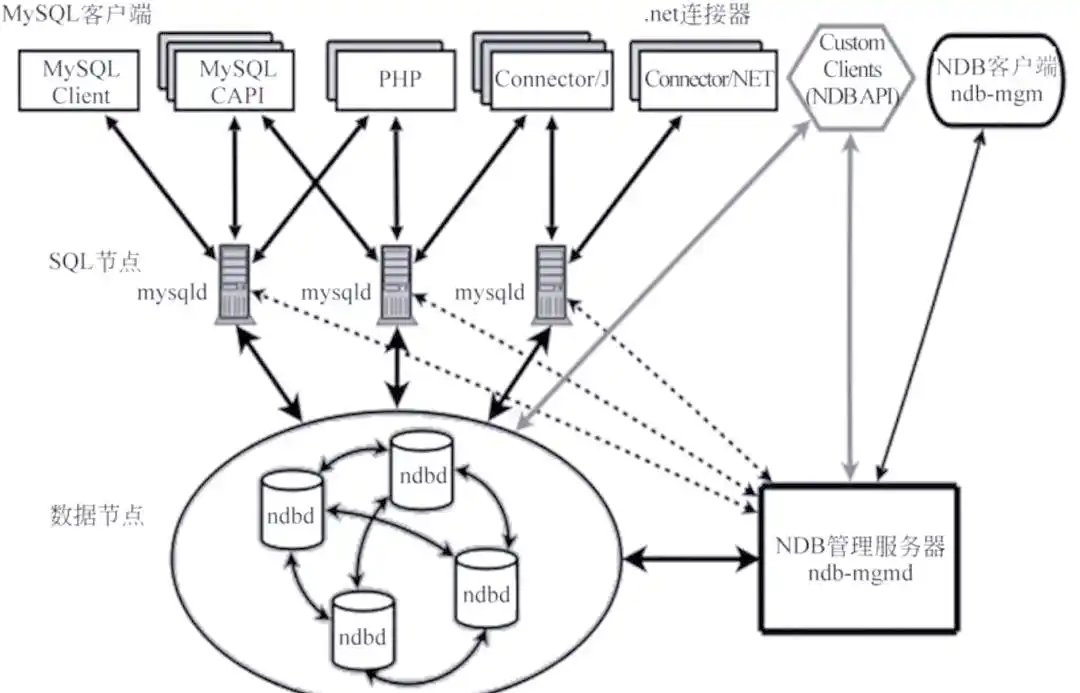
MySQL Cluster由三类核心节点组成,形成分布式存储与计算架构:
- SQL节点:提供MySQL协议接口,接收应用请求并转发至NDB节点,可水平扩展(增加节点分担读负载);
- NDB节点(数据节点):基于NDB存储引擎存储数据,数据自动分片并冗余(默认副本数为2),确保单节点故障不丢失数据;
- 管理节点:1个(或主从备份),负责集群配置管理、节点监控、故障恢复协调(如NDB节点故障时触发数据重平衡);
- 数据流向:应用请求经SQL节点解析后,由NDB节点处理并同步至冗余节点,事务提交需所有副本确认,保证强一致性。
架构图
5. Galera Cluster - 三方优秀方案(多主模式)
核心概述:基于Galera协议的多主同步复制集群,支持数据强一致性与自动故障转移。
官方资源:https://galeracluster.com/
核心特性
- 优势:
- 多主写入架构,数据实时强一致
- 社区成熟,互联网企业大规模应用案例丰富
- 自动故障转移与节点上下线管理
- 局限:
- 需为MySQL打wsrep补丁,维护成本增加
- 仅支持InnoDB引擎,至少需三节点
- 多节点写入存在性能开销,高并发场景需谨慎
架构说明:
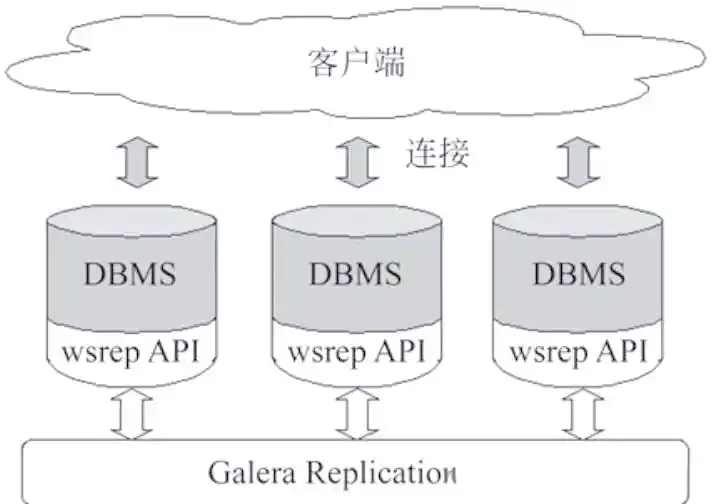
Galera Cluster是基于MySQL的同步复制集群,核心组件与机制包括:
- 集群节点:最少3个节点(确保仲裁能力),每个节点需安装Galera插件与wsrep补丁,支持InnoDB引擎;
- Galera协议:基于乐观锁与认证机制实现事务同步——事务在本地执行后,需将写集(write-set)广播至所有节点,经冲突检测通过后,所有节点原子性提交或回滚;
- 仲裁机制:节点故障时,存活节点需超过半数(N/2+1)才能维持集群可用,否则进入非同步状态;
- 自动故障转移:节点故障后自动被排除出集群,恢复后自动同步数据并重新加入,无需手动干预;
- 多主写入:所有节点均可处理写请求,写集同步确保数据一致,避免传统主从的延迟问题。
架构图
6. Percona XtraDB Cluster (PXC) - 既生瑜何生亮(多主模式)
核心概述:基于Galera协议的衍生方案,专注于MySQL高可用与可扩展性。
官方资源:https://www.percona.com/mysql/software/percona-xtradb-cluster
核心特性
- 优势:
- 同步复制,事务要么全节点提交,要么全回滚
- 多主写入支持,任意节点可处理写请求
- 本地节点查询无需远程访问,读负载扩展能力强
- 局限:
- 新增节点需全量复制数据,开销大
- 写操作会同步至所有节点,无法解决写扩展问题
- 数据冗余度高(节点数=数据副本数)
架构说明:
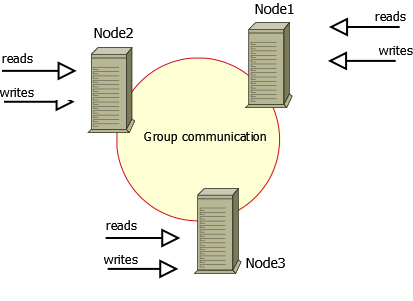
PXC基于Galera协议扩展,架构与Galera Cluster类似,核心差异在于集成Percona优化组件:
- 节点组件:每个节点包含Percona Server(优化版MySQL)、XtraDB存储引擎(InnoDB增强版)及Galera复制插件;
- 同步机制:采用“写集复制”——事务在本地执行后,写集经哈希校验后广播至所有节点,通过冲突检测(基于主键/唯一键)确保并发写入一致性;
- 状态同步:新增节点时通过SST(State Snapshot Transfer,全量同步)或IST(Incremental State Transfer,增量同步)从现有节点获取数据,加入集群后实时同步事务;
- 高可用保障:依赖Galera协议的仲裁机制,节点故障时自动隔离,存活节点超过半数即可维持服务,支持自动恢复与重加入。
架构图
7. Orchestrator - 可视化的MySQL拓扑管理与故障转移工具(单主模式)
核心概述:由GitHub社区维护的开源MySQL高可用工具,主打可视化拓扑管理与自动/手动故障转移,支持基于GTID或传统binlog的主从复制架构,尤其擅长复杂主从拓扑(如级联复制、多主一从)的监控与管理。
官方资源:https://github.com/openark/orchestrator
核心特性
- 优势:
- 可视化拓扑与监控:提供Web UI直观展示MySQL集群主从关系、复制延迟、节点健康状态,支持拓扑导出,降低运维复杂度。
- 灵活故障转移:支持自动、手动触发,故障转移时智能选“最优从节点”,自动更新其他从节点复制指向。
- 强拓扑管理能力:支持级联复制、双主互备等复杂拓扑,可手动调整拓扑结构并自动同步配置。
- 兼容性广:支持MySQL 5.6+、MariaDB等主流数据库版本,兼容GTID与传统binlog复制,不依赖特定存储引擎。
- 低侵入性:无需在MySQL节点部署Agent,通过MySQL账号远程访问,对数据库节点性能无额外消耗。
- 局限:
- 仅支持单主架构,不支持多主并行写入,无法解决写操作水平扩展问题。
- 只负责拓扑管理与故障转移,不处理数据同步逻辑,数据一致性依赖MySQL原生复制,存在主从延迟或数据丢失风险。
- 自动故障转移需手动开启并提前配置故障检测阈值、避免脑裂规则,配置不当易误触发。
- 原生Web界面无细粒度权限管理,需结合反向代理或第三方工具实现访问控制。
架构说明:
Orchestrator采用“中心化服务+无Agent节点”架构。
- Orchestrator服务节点:1台主服务(可多台部署实现自身高可用),定时通过MySQL协议访问集群节点,采集状态数据存储至元数据库(支持MySQL/PostgreSQL),提供Web UI与API接口。
- MySQL集群节点:无需部署Agent,开放MySQL端口,为Orchestrator配置有基础权限的数据库账号,建议开启GTID。
- 故障转移流程:
- Orchestrator检测到主节点故障。
- 自动筛选“候选主节点”,排除异常从节点,优先选复制延迟小、线程正常的节点。
- 提升候选节点为主节点,停止其复制线程并重置主节点身份(GTID模式无需此操作)。
- 自动重新配置其他从节点复制指向新主节点。
- 发送故障转移通知,记录操作日志至元数据库。
架构图
Orchestrator典型架构(单服务节点+MySQL一主多从集群)
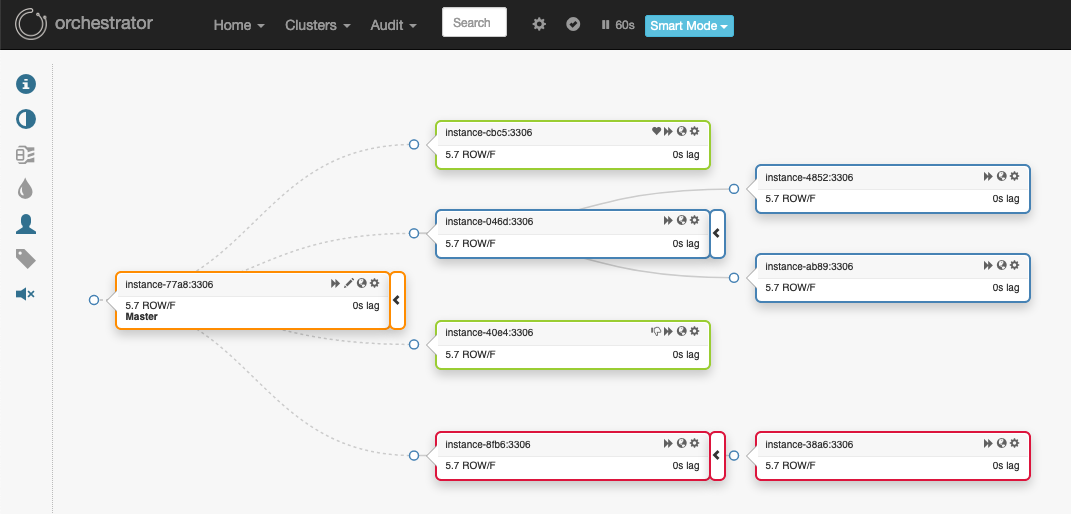
(注:实际生产环境中,Orchestrator服务节点建议部署2台(主从模式),共享元数据库,避免Orchestrator自身单点故障;MySQL集群支持级联复制拓扑,Web UI可清晰展示“主→从→从”的层级关系)
8. Vitess - 大规模分布式解决方案(分片+多主模式)
核心概述:由YouTube开发的分布式MySQL集群解决方案,专注于大规模数据场景下的水平扩展与高可用,通过分片(Sharding)和集群管理实现PB级数据支撑与高并发处理。
官方资源:https://vitess.io/、https://github.com/vitessio/vitess
核心特性
- 优势:
- 支持自动分片与动态扩缩容,解决单库数据量与并发瓶颈
- 每个分片内置主从架构,结合自动故障转移实现高可用
- 兼容MySQL协议,应用迁移成本低
- 读写分离与负载均衡自动化,无需手动配置
- 支持跨区域部署,提升多活能力
- 局限:
- 架构复杂,运维门槛高,需专业团队支持
- 对某些MySQL高级特性(如存储过程、触发器)支持有限
- 小规模集群部署性价比低
- 分片规则设计需提前规划,后期调整成本高
架构说明:
Vitess采用分层架构,核心组件包括:
- VTGate:请求入口层,负责SQL解析、路由到对应分片、结果合并,支持读写分离
- VTTablet:部署在每个MySQL节点的代理,管理实例生命周期、复制同步与健康检查
- Keyspace:逻辑数据库单元,可按规则拆分为多个Shard(分片)
- Shard:每个分片是独立的MySQL主从集群(1主多从),负责存储部分数据
- VTTopo:基于etcd/ZooKeeper存储集群元数据(拓扑结构、分片规则等)
- Vtctl:命令行工具,用于集群管理(分片拆分、主从切换等)
故障转移机制:
- VTTablet实时监控MySQL实例状态,发现主库故障后上报
- 系统自动从该分片的从库中选举新主(优先选择数据最新节点)
- VTTopo更新元数据,VTGate感知变化并将请求路由至新主
- 原主库恢复后自动作为从库重新加入集群
架构图
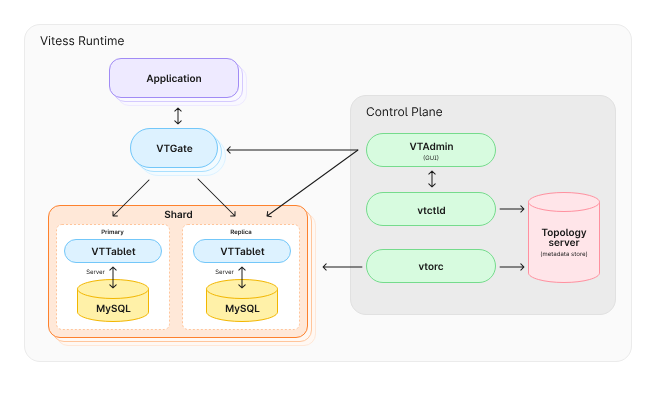
总结:Vitess特别适合数据量巨大(千万级以上表)、并发请求高(数万QPS)且持续增长的业务场景,如电商平台、社交网络等。但需注意其架构复杂度带来的运维成本,小规模业务可优先选择MGR或Galera Cluster等轻量方案。实际选型时,应结合业务规模、团队技术栈与长期发展规划综合评估。
二、数据可靠性方案对比
1. RAID10 - 原始方案(RAID1+0)
核心原理:先做镜像(RAID1)再做条带(RAID0),兼顾冗余与性能。
适用场景:银行、金融等对数据安全性要求极高的场景(需配合异地备份应对天灾)。
优势:硬件级冗余,读写性能均衡;局限:机房单点风险,无跨地域容错能力。
2. SAN共享存储 - 钞能力方案
核心原理:通过存储区域网络(SAN)实现多节点共享数据存储,依赖存储本身的高可用。
优势:
- 不依赖数据库逻辑,数据一致性由存储层保障
- 两节点即可部署,切换逻辑简单
- 避免MySQL逻辑错误导致的数据不一致
局限:
- 共享存储自身需实现高可用,成本高昂
- 无自动故障转移能力,需配合其他工具
3. DRBD 磁盘复制 - 系统自带方案
核心原理:Linux内核级块设备复制技术,实时同步本地磁盘数据至远程节点。
优势:
- 系统原生支持,无需额外软件
- 数据实时复制,本地故障时可切换至远程节点
- 部署成本低,适合中小规模场景
局限:
- 依赖底层系统配置,跨平台兼容性差
- 同步性能受网络带宽影响大
三、选型建议参考
数据库架构选型
| 架构方案 | 适用场景 | 推荐指数 | 关键考量因素 |
|---|---|---|---|
| MMM | 老旧系统维护、低成本单主架构需求 | ★★☆☆☆ | 不推荐新架构使用,需搭配半同步复制 |
| MHA | 单主架构、需自动故障转移的传统业务 | ★★★☆☆ | 配合半同步复制降低数据丢失风险 |
| MGR/Innodb Cluster) | 数据强一致、轻量级部署需求 | ★★★★★ | 版本≥5.7.17,节点数≤9,依赖InnoDB |
| MySQL Cluster | 官方技术依赖、分布式存储需求 | ★★★☆☆ | 需专业NDB引擎运维能力 |
| Galera Cluster | 多主写入、高可用要求高的互联网场景 | ★★★★☆ | 需接受补丁维护成本,避免高并发写入 |
| PXC | 需Percona生态优化、多主读扩展场景 | ★★★★☆ | 新增节点成本高,写性能受节点数影响 |
| Orchestrator | 复杂主从拓扑、需可视化运维场景 | ★★★★☆ | 依赖MySQL原生复制,需配置防脑裂规则 |
| Vitess | 超大规模数据(PB级)、高并发读写场景 | ★★★★☆ | 需专业团队运维,适合业务高速增长期 |
存储架构选型
| 存储方案 | 适用场景 | 推荐指数 | 关键考量因素 |
|---|---|---|---|
| RAID10+异地备份 | 金融级数据安全、容忍机房级故障 | ★★★★☆ | 硬件成本与备份策略配套 |
| SAN共享存储 | 高预算、追求存储层与数据库解耦 | ★★★☆☆ | 共享存储高可用设计是核心 |
| DRBD | 中小规模场景、依赖系统级冗余 | ★★★☆☆ | 网络带宽需满足实时同步需求 |
总结:实际架构设计中,建议采用“数据库架构+存储架构”的组合方案(如MGR+RAID10、Galera Cluster+异地备份),兼顾高可用性与数据可靠性。选型时需重点评估业务对一致性强度、写入模式、成本预算的核心需求,同时匹配团队运维能力,避免过度设计或架构短板。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献2条内容

所有评论(0)