小杰python高级(five day)——pandas库
1.更换python解释器
安装好虚拟仿真本地服务平台后,可以更换python解释器
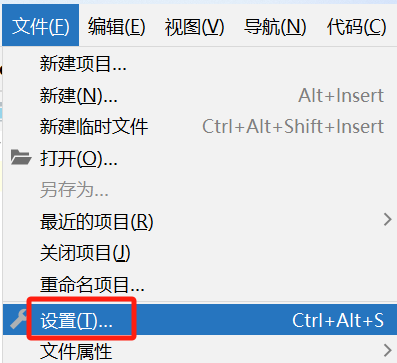
- File中点击Setting
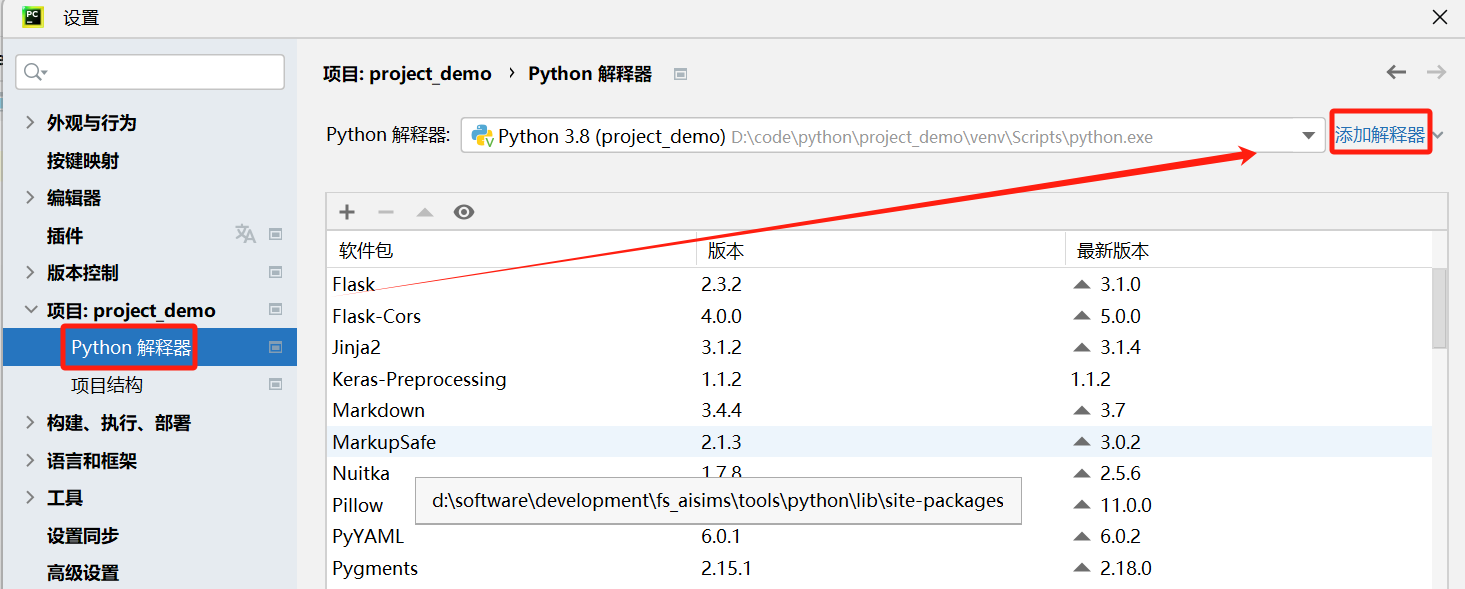
2.添加新的编译器路径
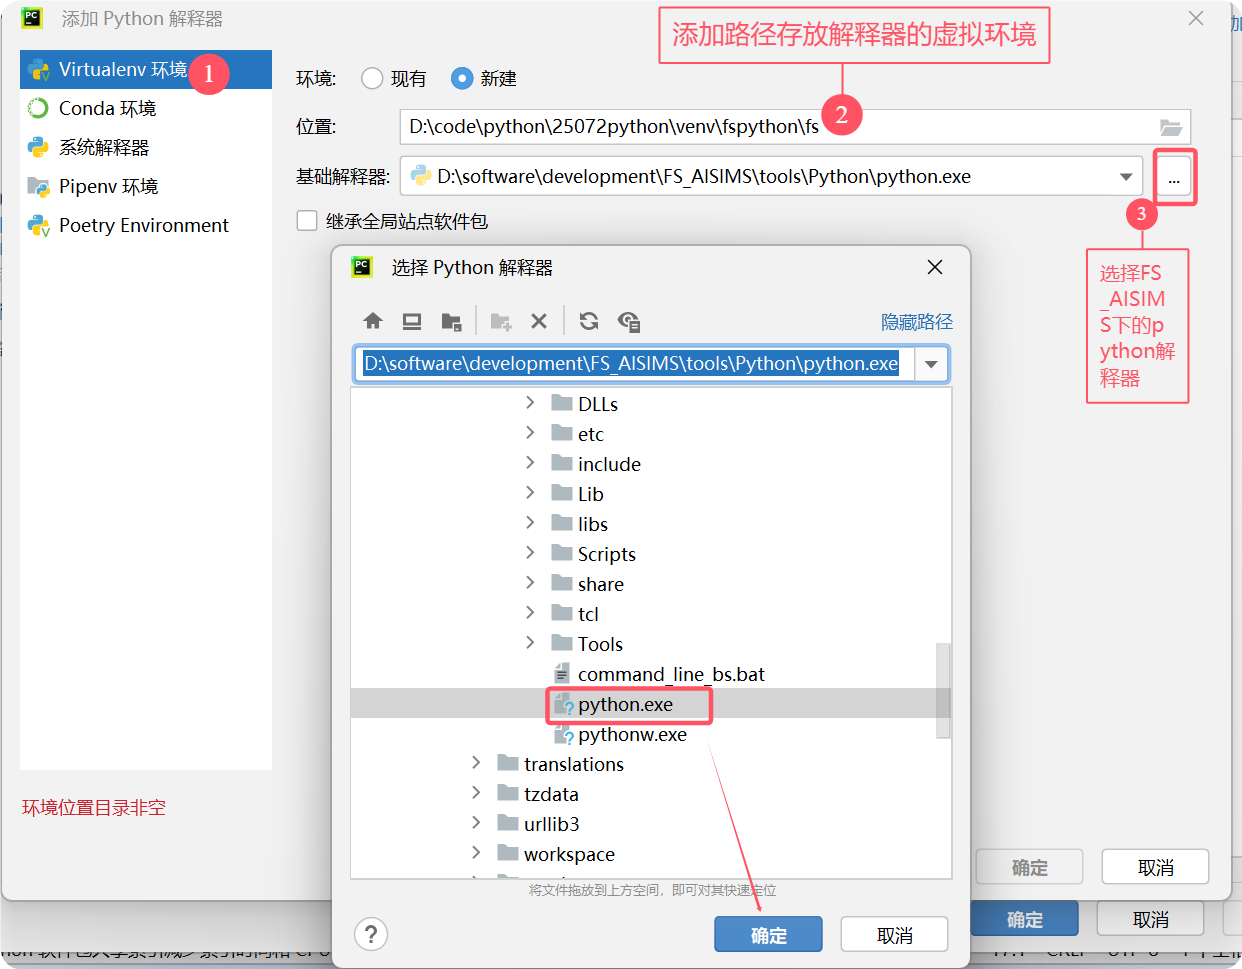
3.环境配置好后,重启pycharm即可使用。
2. pandas库
Pandas是一个基于NumPy的Python数据分析库,它在数据分析领域扮演着至关重要的角色。
Pandas的主要作用有以下几点:
- Pandas提供了一系列易于使用的数据结构和工具,包括Series(一维标签化数据结构)和DataFrame(二维标签化数据结构)。
- Pandas擅长处理和分析结构化数据,如表格数据、时间序列数据等
- Pandas支持从多种数据源读取数据,包括CSV文件、Excel文件、SQL数据库、网页等
- Pandas提供了强大的数据分组和聚合功能,如求和、计数、平均值、中位数等
- Pandas与Matplotlib、Seaborn等数据可视化库结合使用,可以轻松地绘制各种图表,如线图、柱状图、散点图、箱线图等。
3. Series
Series是Pandas中的一维标签化数据结构,它可以存储任何数据类型(整数、字符串、浮点数、Python对象等),Series对象中每个元素都有一组索引与之对应,可以将其看做是特殊的字典。
(1) Series 创建
pandas.Series(data=None, index=None, dtype=None, name=None, copy=False, fastpath=False)
参数:data:表示传入的数据,可以是列表、数组、字典等。
index:表示索引,唯一且与数据长度相等。如果不指定,默认会自动创建一个从0开始的整数索引。
dtype:数据类型,默认会自己判断。可以显式指定数据类型以确保数据的一致性。
name:设置Series的名称,方便后续操作。
copy:拷贝数据,默认为False。如果设置为True,则会复制数据以避免在原始数据上进行修改。
fastpath:内部参数,通常不需要用户指定。
import numpy as np
import pandas as pd
# 通过列表创建
# se = pd.Series([1,2,3,4,5])
# 通过元组创建
# se = pd.Series((1,2,3,4,5))
# 通过numpy数组创建
# arr = np.array([1,2,3,4,5])
# 通过字典创建,将键作为索引
# data = {'a':1, 'b':2, 'c':3, 'd':4}
# se = pd.Series(data)

# 手动指定元素索引
ind = ['a','b','c','d','e']
se = pd.Series([1,3.4,'w',{'s':10},5], index=ind)
print(type(se))
print(se)
(2) Series 访问
Series的访问有四种方式:
- 位置索引
直接通过默认索引进行访问
- 标签索引
使用标签进行索引,与访问字典中的元素类似。
- 切片索引
通过start:stop进行切片,开始值与终止值可以省略。
第一种是使用位置切片,其使用方法与列表的切片类似;遵循左闭右开,只包含start,不包含stop
第二种是使用标签切片,其语法与位置切片类似,遵循左右都闭合,即既包含start,又包含stop。
- 函数访问
get()
get(key, default=None):通过标签来获取Series中的元素
参数:key: 你想要获取的元素的标签。
default: 可选参数,如果key不在标签中,返回这个默认值。如果没有指定,默认为 None。
head(n=5):返回Series的前n个元素,默认为前5个。
tail(n=5):返回Series的后n个元素,默认为后5个。
isin():判断Series中的每个元素是否在指定的一组值中,它会返回一个与原Series长度相同的布尔型Series,其中对应位置为True表示该位置的元素在指定的值集合中,False则表示不在。
import numpy as np
import pandas as pd

ind = ['a','b','c','d','e']
se = pd.Series([1,2,3,4,5], index=ind)

# 1.位置索引
# print(se[1])
# # 2.标签索引
# print(se['b'])
# # 3.切片索引
# print(se[0:2])
# print(se['a':'c'])
# 4.函数访问
# print(se.get(1))
# 当指定的索引超出了数据索引范围返回Not Found
# print(se.get('w', 'Not Found'))
# 访问前5个数据
# print(se.head())
# 访问后四个数据
# print(se.tail(4))

# 判断series中是否存在指定的值,返回bool类型Series数据
val = [2, 5]
print(se.isin(val))
(3) Series 属性
values:返回Series的值数组,以NumPy数组的形式返回。
index:返回Series的索引数组,索引用于标识每个数据点的位置。
dtype:返回Series的数据类型,例如int64、float64或object等。
size:返回Series的大小,即数据点的数量。
shape:返回Series的形状,以元组的形式表示,对于Series来说,其形状是一个一维数组的长度。
name:返回Series的名称,可以通过在创建Series时指定name参数来设置。
hasnans:返回数据中是否包含NaN值,存在NaN返回True否则返回False。
is_unique:用于返回数组中的元素是否为独一无二的,如果所有的元素都是独一无二的,即数组中没有重复元素,那么就返回True,否则返回False。
empty:用来表示Series数组是否为空,返回值一个布尔值,如果数组里一个元素都没有就返回True,否则返回False。
axes:用于返回series对象索引的列表。
补充:None或 np.nan表示空
import numpy as np
import pandas as pd

ind = ['a','b','c','d','e']
se = pd.Series([1,2,3,4,5], index=ind, name='ser')

# 获取值
print(se.values)
# 获取索引
print(se.index)
# 获取元素类型
print(se.dtype)
# 获取数据个数
print(se.size)
# 获取形状
print(se.shape)
# 获取名称
print(se.name)
# 判断是否有None值,有返回True
print(se.hasnans)
# 判断数据是否独一无二,是返回True
print(se.is_unique)
# 判断是否为空
print(se.empty)
# 获取索引的列表
print(se.axes)
4. Dataframe
DataFrame是Pandas库中的另一个核心数据结构,它用于表示二维表格型数据;它类似于Excel中的表格或SQL表,具有行和列。
DataFrame由一组有序的列组成,每列可以是不同的数据类型(如数值、字符串、布尔型值等)。DataFrame既有行索引也有列索引,提供了丰富的功能来进行数据访问、筛选、分割、合并、重塑、聚合以及转换等操作。
(1)Dataframe 创建
pandas.DataFrame(data=None, index=None, columns=None, dtype=None, copy=False)
参数:
data:数据输入,可以是ndarray、series、list、dict等类型。如果为dict,则dict的键会被用作列名,除非columns参数被显式指定。
index:行标签索引,如果没有提供,则默认为整数索引。
columns:列标签,如果没有提供且没有通过data参数传递列名,则默认为整数索引。
dtype:数据类型,可选。如果指定,则数据类型会被强制转换为dtype类型。
copy:复制数据,默认为False。如果为True,则复制数据以避免在原始数据上进行修改。
import numpy as np
import pandas as pd

# 根据列表创建
# df = pd.DataFrame([['zhangsan',24],['lisi',30],['wangwu',18]])
# 根据字典创建
# data = {'name':['zhangsan','lisi','wangwu'], 'age':[24, 30, 18]}
# 根据numpy数组创建
data = np.random.rand(2,3)
# 行标签
ind = ['a', 'b']
# 列标签
col = ['aa', 'bb', 'cc']
# 指定行列标签
df = pd.DataFrame(data, index=ind, columns=col)
print(df)
(2)Dataframe 访问
- 通过中括号访问数据,注意先指定列标签再指定行标签
data = {'name':['zhangsan','lisi','wangwu'], 'age':[24, 30, 18]}
ind = ['a', 'b', 'c']
df = pd.DataFrame(data, index=ind)
# 访问元素时,先指定列在指定行标签
print(df['name'])
print(df['name'][0])
print(df['name']['a'])
# 以列表的方式列出访问的列
print(df[['name','age']])
- 通过函数进行访问
df.loc[row_label, column_label]
功能:是基于标签的索引,用于通过行标签和列标签访问数据。
参数:row_label:行标签,可以是单个标签、标签列表、切片或布尔数组。
column_label:列标签,可以是单个标签、标签列表、切片或布尔数组
df.iloc[row_position, column_position]
功能:是基于位置的索引,用于通过行和列的位置访问数据。
参数:row_position:行的位置,可以是整数、整数列表、切片或布尔数组。
column_position:列的位置,可以是整数、整数列表、切片或布尔数组。
data = {'name':['zhangsan','lisi','wangwu'], 'age':[24, 30, 18]}
ind = ['a', 'b', 'c']
df = pd.DataFrame(data, index=ind)

# 通过loc指定标签进行访问
print(df.loc['a','name'])
# 通过iloc指定位置进行访问
print(df.iloc[1, 1])
(3)Dataframe 属性
index:返回行标签。
columns:返回列标签。
axes:返回行轴和列轴的列表。
values:返回DataFrame中的数据,以NumPy数组的形式。
dtypes:返回DataFrame中各列的数据类型。
shape:返回DataFrame的形状,即数据的维度(行数和列数)。
size:返回DataFrame中的元素个数。
ndim:返回DataFrame的维度(对于DataFrame来说,总是2)。
empty:判断DataFrame是否为空,如果为空则返回True,否则返回False。
T:返回DataFrame的转置。
5 数据操作
(1)数据清洗
1. dropna
dropna(axis=0, inplace=False)
功能:删除包含NaN值的行
参数:axis:用于指定按哪个轴删除缺失值,默认为0(一维数据结构不用修改)
inplace:True,直接在原数据上删除缺失值
False,返回一个删除了缺失值的新结构
2. fillna
fillna(value=None)
功能:填充NaN的值(不修改原数据)
参数:value:可以是单个值,也可以是字典(对不同的列填充不同的值),或者一个 Series。
返回值:新的数据结构
3. isnull
isnull()
功能:检测数据对象中的缺失值,它会返回一个布尔型结构,其中每个元素表示原数据对应位置的值是否为缺失值(NaN)。
4. drop_duplicates
drop_duplicates(keep='first', inplace=False, ignore_index=False)
功能:用于去除数据对象中的重复项
参数:keep:决定了如何处理重复项
first:默认值,保留第一次出现的重复项
last:保留最后一次出现的重复项
False:不保留任何重复项,即删除所有重复项
ignore_index:默认False,True表示重置索引为默认整数索引
import numpy as np
import pandas as pd

data = {'name':['zhangsan',np.NAN,'wangwu', np.NAN], 'age':[np.NAN, 14, 20, 14], 'height':[np.NAN, 14, 20, 14]}
ind = ['a', 'b', 'c', 'd']
df = pd.DataFrame(data, index=ind)
print(df)
print('--------------')
# 1.删除包含None的行或列
# ret = df.dropna(axis=0, inplace=True)
# 2.将数据中的None进行填充值
# ret = df.fillna(0)
# val = pd.Series({'a':20, 'b':25, 'c':27})
# print(val)
# ret = df.fillna({'age':val})
# print(ret)
# 3.判断数据结构中是否有None值,返回布尔类型的数据结构
# ret = df.isnull()
# print(ret)
# 4.在Dataframe中删除重复的行数据
# last为保留最后一次的重复项,ignore_index:重置索引为位置索引
ret = df.drop_duplicates(keep='last', ignore_index=True)
print(ret)
(2)数据转换
1. replace
DataFrame.replace(to_replace=None, value=None, inplace=False, limit=None, regex=False, method='pad')
功能:替换特定的值、一系列值或者使用字典映射进行替换
参数:to_replace:要替换的值,标量、列表、字典都可以
value:替换后的新值,格式和to_replace相同
inplace:True,则直接在原 数据上修改,不返回新的对象
2. transform
函数在 Pandas 中用于对数据进行逐行或逐列的转换操作,它通常接受一个函数(内置函数或自定义函数)作为参数,并将该函数应用于 DataFrame 的每一列或每一行,返回Dataframe和原数组形状一致
DataFrame.transform(func, axis=0, *args, **kwargs)
功能:对DataFrame中的数据进行自定义转换操作
参数:func:应用于DataFrame的函数。这个函数可以是内置函数,或者自定义的函数
import numpy as np
import pandas as pd

def div(x):
    return x/2

data = {'chines':[45, 67, 89], 'math':[78, 67, 90]}
df = pd.DataFrame(data)
print(df)
print('----------------')

# 替换某个数据
# ret = df.replace([45,67], [100, 99])
# ret = df.replace({45:88, 78:90})
# print(ret)

# 将Dataframe中所有数据根据指定的函数或表达式功能进行转换
# 使用内置函数进行转换
# ret = df.transform(np.log)
# 使用lambda表达式进行转换
# ret = df.transform(lambda x:x**2)
# 使用自定义函数进行转换
# ret = df.transform(div)
# 传递的函数是多个参数的情况,可以使用lambda表达式
ret = df.transform(lambda x:np.power(x, 0.5))
print(ret)
(3)数据排序
1. sort_values
函数是用于对 DataFrame 或 Series 的数据进行排序。它可以根据一个或多个列的值对数据进行升序或降序排列
DataFrame.sort_values(by, axis=0, ascending=True, inplace=False, kind='quicksort', na_position='last', ignore_index=False, key=None)
功能:根据一个或多个列的值对 DataFrame 进行排序
参数:
by: 用于排序的列名或列名列表
axis:默认0,对Series无效
ascending:默认True,True:升序,False:降序
inplace:默认False,True:在原始数据上修改
kind:排序算法,默认quicksort(快排)
na_position:默认last,表示NAN放在末尾,first放在开头
ignore_index:默认False,True表示重置索引为默认整数索引
key:函数,默认为None,排序前执行自定义函数
data = {'chinese':[90, 67, 89], 'math':[80, 78, 90]}
df = pd.DataFrame(data)
print(df)
print('------------------------')
# 根据指定的列标签进行行排序
ret = df.sort_values('chinese')
# 当指定多列时,第一列的值相同时再判断第二列的大小
ret = df.sort_values(['chinese','math'])
# 根据指定的行标签进行列排序
ret = df.sort_values(0, axis=1, ascending=False)
print(ret)
2. sort_index
DataFrame.sort_index(axis=0, level=None, ascending=True, inplace=False, kind='quicksort', na_position='last', sort_remaining=True, ignore_index=False, key=None)
功能:根据索引对 DataFrame 进行排序
ind = ['a', 'c', 'b']
data = {'chinese':[90, 67, 89], 'aath':[80, 78, 90]}
df = pd.DataFrame(data, index=ind)
print(df)
print('------------------------')
# 按照索引进行排序
ret = df.sort_index(axis=1)
print(ret)
(4)数据筛选
根据条件或布尔数组进行数据筛选。
import numpy as np
import pandas as pd

ind = ['a', 'c', 'b']
data = {'chinese':[90, 67, 89], 'aath':[80, 78, 90]}
df = pd.DataFrame(data, index=ind)
print(df)
print('------------------------')
# 根据条件进行筛选数据
# ret = df['chinese'] > 80
# print(df[ret])

# 根据布尔列表筛选数据
cond = [True, False, False]
print(df[cond])
(5)数据拼接
pandas.concat(objs, *, axis=0, join='outer', ignore_index=False, keys=None, levels=None, names=None, verify_integrity=False, sort=False, copy=None)
功能:将多个Pandas数据沿着一个轴连接起来
参数:objs:参与连接的Pandas对象的列表或元组
axis:连接的轴,0:沿着行方向连接,1沿着列方向连接
join:outer:取所有索引的并集 inner:取所有索引的交集
ignore_index:默认False,True表示重置索引为默认整数索引
inplace:默认False,True:在原始数据上修改
kind:排序算法,默认quicksort(快排)
ind = ['a', 'c', 'b']
data = {'chinese':[90, 67, 89], 'math':[80, 78, 90]}
df = pd.DataFrame(data, index=ind)
print(df)
print('------------------------')

# 按行增长方向将多个数据进行拼接
# new = pd.DataFrame({'chinese':[100], 'math':[80]}, index=['d'])
# ret = pd.concat([df, new], axis=0)
# 按列增长方向将多个数据进行拼接
new = pd.DataFrame({'english':[80,78,67]})
ret = pd.concat([df, new], axis=1)
print(ret)
6.统计计算
count sum min max var std quantile discribe min_count value_counts ascending sort dropna
count(axis=0, numeric_only=False)
功能:用于计算 DataFrame 中非 NaN 值的数量
参数:axis:统计的方向,0:按列,1:按行
sum(axis=0, skipna=True, numeric_only=False, min_count=0)
功能:用于计算 DataFrame 中数值的总和
参数:axis: 统计的方向,0:按列,1:按行
skipna: 布尔值,默认为 True,则在计算总和时会忽略 NaN 值。
numeric_only: 布尔值,默认为 False。如果为 True,则只对数值列进行求和,忽略非数值列。
min_count: int,默认为 0。这个参数指定了在计算总和之前,至少需要非 NaN 值的最小数量。如果某个分组中的非 NaN 值的数量小于 `min_count`,则结果为 NaN。
mean(axis=0, skipna=True, numeric_only=False, **kwargs)
功能:用于计算 DataFrame 中数值的平均值
min(axis=0, skipna=True, numeric_only=False, **kwargs)
功能:用于计算 DataFrame 中数值的最小值
max(axis=0, skipna=True, numeric_only=False, **kwargs)
功能:用于计算 DataFrame 中数值的最大值。
var(axis=0, skipna=True, ddof=1, numeric_only=False, **kwargs)
功能:用于计算 DataFrame 中数值的方差
std(axis=0, skipna=True, ddof=1, numeric_only=False, **kwargs)
功能:用于计算 DataFrame 中数值的标准差
quantile(q=0.5, axis=0, numeric_only=False, interpolation='linear', method='single')
功能:计算 DataFrame 中数值的分位数。
describe(percentiles=None, include=None, exclude=None)
功能:生成DataFrame中数值列的统计摘要,会返回一个DataFrame
返回值:包括计数、平均值、标准差、最小值、25%分位数、50%分位数(中位数)、75%分位数和最大值等。
value_counts(subset=None, normalize=False, sort=True, ascending=False, dropna=True)
功能:用于计算Series中各个值出现的频率或个数的一个方法。
参数:subset:可选参数,用于指定要进行计算操作的列名列表。如果未指定,则对整个DataFrame的所有列进行操作。
normalize:布尔值,默认为False。如果设置为True,则返回每个值的相对频率,而不是计数。
sort:布尔值,如果设置为True,则结果将按计数值降序排序。
ascending:布尔值,当`sort=True`时,此参数指定排序顺序。如果设置为True,则结果将按计数值升序排序。
dropna:布尔值,如果设置为True,则在计数之前排除缺失值。
补充:分位数的计算方式:排序数据:首先,将数据集按升序排列。
确定分位数的位置:分位数是将数据集分成等大小的几个部分的值,如果位置是一个整数,那么分位数就是该位置的值。如果位置不是一个整数,那么分位数是该位置的整数部分和下一个整数部分的值的平均值
位置=p ×(n+1) p:百分比(25% 50% 75%) n:数的个数
线性插值法:
位置=p*(n-1)
[1,2,3,4,5]
位置:1
[1,2,3,4]
位置:0.75
1+0.75*(2-1)=1.75
import pandas as pd

ind = ['a', 'c', 'b']
data = {'chinese':[90, 90, 89], 'math':[80, 80, 90]}
df = pd.DataFrame(data, index=ind)
print(df)
print('------------------------')

# print(df.count(axis=1))
# print(df.sum(axis=1))
# se = pd.Series([1,2,3,4])
# print(se.quantile(0.25))  # 67 89 90
print(df.value_counts(['chinese']))
7.分组和聚合
1. groupby
用于将数据分组,并允许对分组后的数据进行聚合、转换、应用函数等操作。返回值是一个 DataFrameGroupBy 对象,可以对 DataFrameGroupBy 对象应用聚合函数,如 sum、mean、max、min 。
DataFrame.groupby(by=None, axis=0, level=None, as_index=True, sort=True, group_keys=True, observed=False, dropna=True)
功能:用于将数据分组,并允许对这些分组进行操作
参数:by:是一个键(列名)、键的列表或函数,用于分组
axis:用于分组的轴
返回值:是一个 DataFrameGroupBy 对象,是一个可以对分组数据进行进一步操作的对象
DataFrameGroupBy.get_group(分组名)
功能:根据分组名获取分组后的数据
import pandas as pd

data = {
    'Abc': ['A', 'B', 'A', 'B', 'C', 'A', 'C', 'B'],
    'Value1': [10, 20, 30, 40, 50, 60, 70, 80],
    'Value2': [1, 2, 3, 4, 5, 6, 7, 8]
}
df = pd.DataFrame(data)
print(df)
# 对数据进行分组
ret = df.groupby('Abc')
# 分组后返回值是DataframeGroupby类型,直接访问类中的统计函数
print(ret.sum())
# 获取DataframeGroupby类对象中某一类的数据
data = ret.get_group('A')
print(data)
2. agg
DataFrame.agg(func=None, axis=0, *args, **kwargs)
功能:用于对数据进行聚合操作
参数:func:可以是一个函数、函数列表或函数字典。用于指定聚合操作。
axis:0,表示按行聚合;如果设置为 1,则按列聚合。
data = {
    'Value1': [10, 20, 30, 40, 50, 60, 70, 80],
    'Value2': [1, 2, 3, 4, 5, 6, 7, 8]
}
df = pd.DataFrame(data)
print(df)
# 对数据进行聚合操作(可以对数据进行多个聚合操作)
# ret = df.agg([np.sum, np.mean, min])
# 可以指定某一列进行某个操作
ret = df.agg({'Value1':sum, 'Value2':min})
print(ret)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 26
 0
- 0


 已为社区贡献3条内容

所有评论(0)