实现Spring AOP数据库读写分离

简介:Spring AOP作为一种面向切面编程工具,能够在不更改代码的前提下增强程序功能。本文将深入探讨如何利用Spring AOP实现数据库操作的读写分离,以优化系统性能。通过分离读写操作至不同数据库实例,主库只处理写操作,从库处理读操作,从而减轻主库压力并提升响应速度。文章详细介绍了在Spring MVC和Spring+MyBatis环境下配置多个数据源、实现数据源路由逻辑,并通过AOP切点表达式决定数据源的使用。最后,文章强调了实现读写分离时需要考虑的数据同步和故障切换等问题。
1. Spring AOP的应用及优势
Spring AOP(面向切面编程)是Spring框架中的一个重要组件,它允许开发者将横切关注点从业务逻辑代码中分离出来,以减少代码重复、提高模块化程度。本章将探讨Spring AOP的基本原理、核心优势以及在实际开发中的应用。
1.1 AOP基本概念及其优势
面向切面编程(AOP)通过在运行时,动态地将代码织入到业务逻辑中,实现了业务逻辑代码与系统服务(如日志、安全等)的分离。这种解耦合的方式不仅增强了代码的可重用性,还提高了开发效率和系统的可维护性。
1.1.1 AOP核心思想
AOP的核心思想是将程序中的交叉关注点模块化,例如日志记录、事务管理和安全检查等。AOP允许将这些关注点与业务逻辑分离,通过声明的方式定义这些关注点如何与业务逻辑交互联结。
1.1.2 AOP与Spring框架的集成
Spring AOP利用代理模式实现面向切面编程,将拦截器与目标对象编织在一起形成代理对象。在Spring框架中,AOP与Spring IoC容器的集成紧密,使得开发者可以在声明Bean时轻松地添加切面逻辑。
1.2 Spring AOP的实际应用
Spring AOP的使用场景非常广泛,它不仅可以在Spring应用中用于日志记录、事务管理等常规功能,还可以用于性能监控、安全控制等高级场景。
1.2.1 AOP在日志记录中的应用
通过AOP,开发者可以轻松地为应用添加日志记录功能,而无需修改业务代码。通过定义一个切面,并在该切面中指定切点(Pointcut)和通知(Advice),可以实现对关键操作的自动记录。
1.2.2 AOP在事务管理中的应用
在处理数据库操作时,事务管理是一项基本需求。通过Spring AOP,开发者可以定义一个事务切面,自动为符合条件的方法开启和提交事务,极大地简化了事务管理的复杂性。
1.2.3 AOP的高级应用
除了常规的AOP应用,Spring AOP还可用于性能监控、安全控制等高级场景。例如,可以创建一个性能监控切面,用于记录方法执行时间,从而帮助开发者分析性能瓶颈。
通过本章的学习,我们将了解到Spring AOP的核心原理和在实际开发中如何运用这一强大的工具来简化代码和提高系统的稳定性和可维护性。接下来,我们将进一步探讨如何通过读写分离技术来优化数据库性能,并且利用Spring AOP在其中发挥关键作用。
2. 读写分离基本概念和数据库优化策略
2.1 读写分离的基本概念
2.1.1 读写分离定义及核心思想
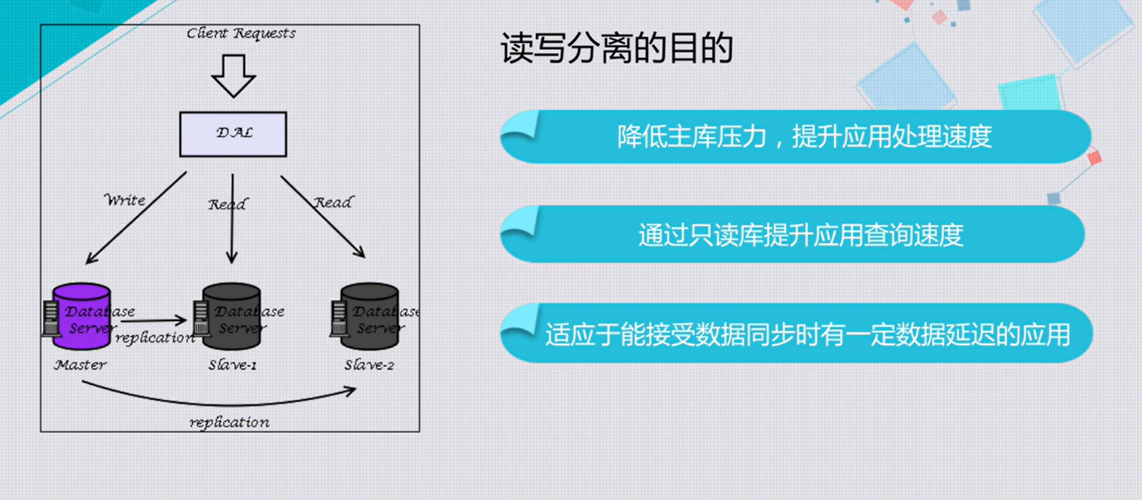
读写分离是数据库架构中的一个重要概念,主要用来提高数据库的性能和可用性。这种架构通过将读和写操作分散到不同的数据库服务器上来实现负载均衡。核心思想在于数据库的读操作数量远大于写操作,因此可以通过分离读和写来优化性能。
读写分离架构的核心在于将数据库分为主数据库(Master)和从数据库(Slave)。主数据库负责处理所有的写请求,而从数据库则用来处理读请求。主从之间通过复制机制同步数据,以保证数据的一致性。
2.1.2 读写分离在数据库中的实际应用场景
在实际的业务场景中,读写分离架构被广泛应用于高并发的在线系统中。例如,在电商网站、社交媒体平台、金融交易系统中,用户的查询请求(读操作)远远多于订单创建、信息修改等写操作。通过实施读写分离,可以有效降低主数据库的负载,提升读取性能。
2.2 数据库优化策略
2.2.1 传统数据库架构的痛点分析
在没有读写分离的传统数据库架构中,所有的读和写操作都由单一的数据库服务器处理。这会导致几个问题:
- 性能瓶颈: 当读写请求量增加时,单个数据库服务器的CPU、内存和磁盘I/O成为性能瓶颈。
- 可用性问题: 如果数据库服务器出现故障,整个系统可能都无法访问。
- 可维护性差: 单一数据库难以进行维护和升级操作,因为这些操作往往需要停机。
2.2.2 读写分离与数据库优化的关联
通过实施读写分离,可以将数据库的负载分散到多个服务器上,从而缓解性能瓶颈问题。此外,主从分离架构还提供了故障转移的能力,增加了系统的可用性。读操作可以分散到多个从服务器上执行,而写操作仍然只由主服务器处理,这样可以保证数据的一致性,同时提高整体系统的性能。
读写分离还能简化数据库的维护工作。在维护期间,可以将读请求转移到从服务器,从而不影响主服务器的写操作,保证了系统的持续运行。
实现读写分离的实践技巧和优化步骤
数据库读写分离的实现不仅涉及到架构设计,还需要具体的实践技巧和优化步骤:
- 选择合适的数据库架构: 根据应用的需求选择合适的读写分离架构,例如一主多从、双主或多主模式。
- 使用成熟的中间件或工具: 利用现成的数据库中间件(如MyCAT、ShardingSphere)或开源工具(如MySQL Proxy)来实现读写分离。
- 确保数据一致性: 在进行读写分离的同时,保证数据最终一致性,可以采用异步复制或半同步复制等机制。
- 监控和调优: 实施读写分离后,应密切监控系统的性能,并根据监控结果进行调整和优化。
通过这些步骤,可以在保证数据一致性的同时,提升数据库的整体性能和系统的可用性。在下一章节中,我们将详细介绍如何配置主从数据源和动态数据源路由,以支持读写分离策略的实施。
3. 配置主从数据源和动态数据源路由
数据库作为现代IT系统中的核心组件,它的性能与稳定性直接影响整个系统的可用性。在高并发环境下,传统的单数据库架构往往会成为瓶颈。为了提高系统的性能和稳定性,采用读写分离架构和动态数据源路由是一种常见的优化方案。本章将探讨如何配置主从数据源以及实现动态数据源路由,并提供实际应用实践。
3.1 主从数据源的配置与管理
3.1.1 主从复制原理及配置要点
主从复制是一种数据备份的方式,它可以将主数据库的更改实时复制到一个或多个从数据库中。这种架构不仅可以提高数据的可用性,还可以通过将读操作分配给从库,来提高系统的读取性能。
主从复制原理
主从复制的基本原理包括:
- 数据变更捕获: 主库上的数据修改操作(如INSERT、UPDATE、DELETE)被捕捉。
- 数据传输: 捕获的数据变更被传输到从库。
- 数据应用: 在从库上重放这些变更,更新从库的数据状态。
配置要点
配置主从复制时,需要关注以下几个要点:
- 网络延迟: 主从库之间的网络延迟会影响数据同步的实时性。
- 数据一致性: 如何确保主库和从库之间的数据一致性是一大挑战。
- 故障转移: 需要确保主库故障时,能够平滑地切换到从库继续服务。
3.1.2 动态数据源路由的实现机制
在读写分离架构下,动态数据源路由是核心组件之一。它负责根据请求的类型(读或写),动态地路由到正确的数据源。
动态数据源路由的机制
动态数据源路由通常依赖于中间件或者框架提供的功能,比如Spring框架的 AbstractRoutingDataSource ,它允许开发者实现自定义的数据源选择策略。
动态数据源路由实现步骤
- 继承
AbstractRoutingDataSource类: 实现自定义的数据源路由逻辑。 - 配置数据源: 在应用程序中配置主库和从库数据源。
- 设置数据源键值: 在线程上下文中设置数据源键值,以指示当前操作需要使用哪个数据源。
- 数据源键值解析: 在请求处理过程中,根据数据源键值来解析并选择对应的数据源。
3.2 动态数据源路由的应用实践
3.2.1 数据源路由的关键代码解析
在实现动态数据源路由时,关键在于如何在代码中动态地选择和切换数据源。以下是一段关键的Java代码示例,展示了如何通过实现 AbstractRoutingDataSource 来创建一个动态数据源路由器。
public class DynamicDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        // 返回当前线程绑定的数据源标识
        return DataSourceContextHolder.getDataSourceType();
    }
}
在这段代码中, determineCurrentLookupKey 方法是自定义数据源选择逻辑的关键。 DataSourceContextHolder 是一个用于在线程上下文中存储数据源键值的工具类。
3.2.2 实现动态切换数据源的策略和技巧
实现动态数据源切换时,策略和技巧至关重要。以下是一些推荐的策略和技巧:
- 数据源上下文管理: 使用
ThreadLocal或者类似机制来管理数据源上下文,保证线程安全。 - 注解驱动: 使用注解来标记读写操作,然后在数据源路由器中解析这些注解来决定使用哪个数据源。
- 性能考量: 在数据源切换过程中,确保操作的性能开销最小化。
public class DataSourceContextHolder {
    private static final ThreadLocal<String> contextHolder = new ThreadLocal<>();

    public static void setDataSourceType(String dataSourceType) {
        contextHolder.set(dataSourceType);
    }

    public static String getDataSourceType() {
        return contextHolder.get();
    }

    public static void clearDataSourceType() {
        contextHolder.remove();
    }
}
以上代码展示了 DataSourceContextHolder 如何使用 ThreadLocal 来存储和清除当前线程的数据源键值。
动态数据源路由的实现可以极大地提升读写分离架构的灵活性和扩展性。在下一章中,我们将深入了解如何通过AOP切点表达式来进一步细化读写操作,从而实现更加精确的数据源管理。
4. 实现AOP切点表达式匹配读写操作
4.1 AOP切点表达式的理解与应用
4.1.1 AOP切点表达式基本概念
AOP(面向切面编程)是Spring框架中的一项强大功能,它允许开发者将横切关注点(如日志、安全等)从业务逻辑中解耦出来。在AOP中,切点(Pointcut)是用来定义切面如何应用于程序的具体位置或操作。切点表达式是用于指定特定连接点的表达式。
在Spring AOP中,切点表达式使用AspectJ提供的语法,表达式由多个指示符组成,这些指示符可以匹配方法名、参数类型、注解等。通过编写切点表达式,开发者可以精确控制何时以及如何将切面织入到目标对象中。
4.1.2 如何编写切点表达式匹配特定操作
编写切点表达式首先需要明确目标是匹配哪种类型的操作。例如,如果要匹配所有的写操作,可能需要匹配那些在数据库上执行了修改的方法。这里有一些常用的指示符:
-
execution: 匹配方法执行连接点。 -
within: 限制匹配范围到某个类型内的连接点。 -
args: 限制匹配连接点,其参数是指定类型的实例。 -
@annotation: 限定匹配带有特定注解的方法。
编写一个简单的切点表达式来匹配所有带有 @Transactional 注解的方法,其可能的切点表达式如下:
execution(* *..*Service.*(..)) && @annotation(org.springframework.transaction.annotation.Transactional)
在这个表达式中, execution 指示符用于匹配所有的 Service 层方法, @annotation 用于匹配带有 @Transactional 注解的方法。
4.2 切点表达式在读写分离中的应用
4.2.1 利用AOP切点表达式定位读写操作
在数据库读写分离的场景下,通常需要区分哪些操作是读操作,哪些是写操作。利用AOP切点表达式,可以非常容易地定位这些操作。例如,写操作通常会涉及 insert 、 update 、 delete 等SQL语句,而读操作通常是 select 语句。
我们可以通过切点表达式来定位这些数据库操作:
// 定位写操作
execution(* com.example.service..*.*(..) && execution(* com.example.service..*.*(..) && !execution(* com.example.service..*.select*(..)))
// 定位读操作
execution(* com.example.service..*.select*(..))
通过这样的切点表达式,我们能够精确地匹配出服务层中所有的写操作和读操作,从而为实现读写分离策略提供基础。
4.2.2 结合Spring AOP实现操作分离的实例
下面结合一个实际的例子来展示如何通过Spring AOP的切点表达式实现读写分离。假设我们有一个用户服务 UserService ,其中包含了增加、更新和查询用户的三个方法。
首先定义一个简单的读写分离切面:
@Aspect
@Component
public class分离的实例阅读分离切面 {
    @Pointcut("execution(* com.example.service.UserService.add*(..))")
    public void addMethod() {}
    @Pointcut("execution(* com.example.service.UserService.update*(..))")
    public void updateMethod() {}
    @Pointcut("execution(* com.example.service.UserService.select*(..))")
    public void selectMethod() {}
    @Around("addMethod() || updateMethod()")
    public Object writeOperation(ProceedingJoinPoint joinPoint) throws Throwable {
        // 切换到主数据源
        // 执行方法
        return joinPoint.proceed();
    }
    @Around("selectMethod()")
    public Object readOperation(ProceedingJoinPoint joinPoint) throws Throwable {
        // 切换到从数据源
        // 执行方法
        return joinPoint.proceed();
    }
}
在上面的例子中, addMethod 、 updateMethod 和 selectMethod 通过切点表达式定义了需要匹配的方法。在 writeOperation 和 readOperation 两个环绕通知中,分别处理写操作和读操作。在方法执行之前,可以根据业务需求切换对应的数据源。
通过这种方式,我们可以有效地将读写操作分离,以提高数据库操作的性能和效率。此外,在实际应用中,可能还需要考虑事务管理、异常处理等多方面的因素。
5. 使用自定义注解在服务层实现数据源切换
在现代的微服务架构中,动态数据源切换是数据库管理的一个常见需求。通过在服务层实现数据源切换,可以有效地对不同类型的数据库操作(如读写操作)进行区分,并在需要时动态地切换数据源。在本章节中,我们将深入探讨如何使用自定义注解来实现这一目标,包括自定义注解的设计、应用以及数据源切换的实现机制。
5.1 自定义注解的设计与应用
5.1.1 自定义注解的定义方法和原理
在Java中,注解(Annotation)是JDK 5.0版本引入的一种机制,它提供了一种为程序元素设置元数据的方式。自定义注解可以通过@interface关键字来定义,注解的成员变量以无参数的方法形式声明,并且在使用时可以提供默认值。自定义注解的作用主要是用于提供信息给编译器,而这些信息可以在编译期或者运行时被工具读取和处理。
自定义注解的基本定义结构如下:
@Target(ElementType.METHOD) // 表明注解的作用目标是方法
@Retention(RetentionPolicy.RUNTIME) // 表明注解的存储周期是运行时
public @interface DataSourceSwitcher {
    String value() default "default"; // 注解成员,定义数据源名称,默认值为default
}
5.1.2 注解在服务层的应用场景分析
自定义注解在服务层的应用场景非常广泛。例如,当我们需要在一个服务方法中明确指定使用特定的数据源进行操作时,就可以使用自定义注解来标明。比如,一个简单的读操作可以被标记为使用“slave”数据源,而写操作则被标记为使用“master”数据源。
在服务层使用自定义注解可以帮助开发者清晰地识别方法所涉及的数据库操作类型,同时也为AOP切面提供了处理依据,从而实现更加灵活的数据源切换逻辑。
5.2 数据源切换的实现机制
5.2.1 结合自定义注解实现动态数据源切换
要结合自定义注解实现动态数据源切换,首先需要在数据源配置中加入对注解的支持。这通常通过AOP切面来实现,当方法执行时,切面会根据方法上的注解动态地切换到指定的数据源。
下面是一个简单的AOP切面实现示例,展示如何在方法执行前根据注解切换数据源:
@Aspect
@Component
public class DataSourceAspect {

    @Autowired
    private DataSource dataSource;

    @Around("@annotation(dataSourceSwitcher)")
    public Object switchDataSource(ProceedingJoinPoint point, DataSourceSwitcher dataSourceSwitcher) throws Throwable {
        try {
            // 根据注解中指定的数据源名称设置当前线程的数据源
            DbContextHolder.setDataSource(dataSourceSwitcher.value());
            return point.proceed();
        } finally {
            // 清除数据源设置,以便下一个方法使用默认数据源或另一个数据源
            DbContextHolder.clearDataSource();
        }
    }
}
在这个切面中,我们使用了 @Around 注解来包裹目标方法的执行。 DbContextHolder 是一个用于存储当前线程数据源的工具类。该切面在方法执行前后设置和清除数据源,确保数据源的正确切换和恢复。
5.2.2 数据源切换的代码实现和注意事项
实现动态数据源切换的代码相对复杂,需要注意以下几点:
- 确保每个线程都有独立的数据源上下文(例如使用ThreadLocal存储),以防止数据源在并发时发生冲突。
- 在方法执行完毕后,一定要清除数据源设置,避免对后续方法造成影响。
- 在事务管理中,确保事务管理器能够识别数据源的变化,特别是在进行跨数据源事务时。
- 对于异常情况,要处理好数据源的恢复逻辑,避免由于异常导致的数据源状态不一致问题。
通过上述的实现和注意事项,我们可以灵活地根据业务需求实现数据源的动态切换,提高系统的灵活性和可维护性。
6. 读写分离带来的性能和并发能力提升
在现代IT架构中,数据库性能的优化往往关系到整个系统的响应速度和稳定性。读写分离作为一种有效的数据库优化策略,可以在提高性能的同时增强系统的并发能力。
6.1 性能提升的理论分析
6.1.1 数据库读写分离对性能的正面影响
读写分离的核心思想是将数据库的读和写操作分散到不同的服务器上执行,以此来提高系统的性能和可扩展性。在读写分离架构中,写操作(如INSERT、UPDATE、DELETE)通常只在主数据库上执行,而读操作(如SELECT)则在多个从数据库上执行。这种分离可以有效减轻主数据库的压力,因为读操作往往占数据库操作的绝大多数。
读写分离对于性能的正面影响可以总结为以下几点:
- 减轻主数据库压力 :读操作被分散到多个从数据库,减少对主数据库的直接读请求,从而减轻主数据库的负担。
- 提高读取速度 :从数据库可以配置在不同的地理位置,可以更靠近最终用户,减少数据访问的延迟。
- 系统可扩展性提升 :增加从数据库的数量可以线性扩展读取能力,以应对不断增长的用户请求。
6.1.2 并发能力提升的理论依据
数据库操作的并发能力直接关系到能够同时处理多少用户请求。在没有读写分离的情况下,所有的读写请求都由同一个数据库实例处理,这会导致资源争抢,影响并发性能。通过读写分离,读操作的压力被分散,从而每个数据库实例可以更好地服务并发请求。
提升并发能力的理论依据主要包括:
- 减少锁竞争 :写操作在主数据库上执行,而读操作在从数据库上执行,减少了读写操作之间的锁竞争。
- 负载均衡 :通过动态路由和负载均衡技术,可以将读请求分散到不同的从数据库,每个数据库处理的请求量减少,从而提高并发性能。
- 资源优化分配 :可以根据业务需求和读写操作的负载情况,对主从数据库的硬件配置进行优化,如增加从数据库的内存、CPU等资源来提升读取性能。
6.2 实际案例分析与性能测试
6.2.1 具体案例中读写分离实施效果分析
在实际的项目应用中,一个典型的读写分离案例是社交媒体平台的数据库架构。该平台每天需要处理数百万次的读写请求,其中绝大多数是读取数据操作。实施读写分离策略后,我们对系统进行了性能监控和分析。
实施效果分析如下:
- 性能监控 :监控显示,在高峰时段,读操作的平均响应时间减少了30%,主数据库的写操作请求量降低,系统整体稳定。
- 业务影响 :用户界面响应更加迅速,减少了用户等待时间,提高了用户体验。
- 资源使用情况 :从数据库的CPU使用率在高负载时段提高了20%,而主数据库的CPU使用率有所下降。
6.2.2 性能测试结果及其对业务的影响评估
为了更精确地评估读写分离带来的性能提升,对实施读写分离前后进行了严格的性能测试。测试结果如下:
- 吞吐量测试 :读写分离后,系统的总吞吐量提升了约40%。特别是在读操作集中的时段,吞吐量提升更加明显。
- 响应时间测试 :读操作的响应时间减少了35%,写操作的响应时间保持稳定。
- 业务影响评估 :由于性能的提升,业务的增长和扩展变得更加灵活,同时降低了运维成本。
通过以上分析,我们可以看到读写分离不仅仅是一个理论上的优化,它在实际应用中确实能够带来显著的性能提升和并发能力增强。下一章节我们将探讨在实现数据同步和故障切换过程中可能会遇到的实际问题和解决策略。
简介:Spring AOP作为一种面向切面编程工具,能够在不更改代码的前提下增强程序功能。本文将深入探讨如何利用Spring AOP实现数据库操作的读写分离,以优化系统性能。通过分离读写操作至不同数据库实例,主库只处理写操作,从库处理读操作,从而减轻主库压力并提升响应速度。文章详细介绍了在Spring MVC和Spring+MyBatis环境下配置多个数据源、实现数据源路由逻辑,并通过AOP切点表达式决定数据源的使用。最后,文章强调了实现读写分离时需要考虑的数据同步和故障切换等问题。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献20条内容

所有评论(0)