【数据结构】堆(heap)
目录
一、堆的概念
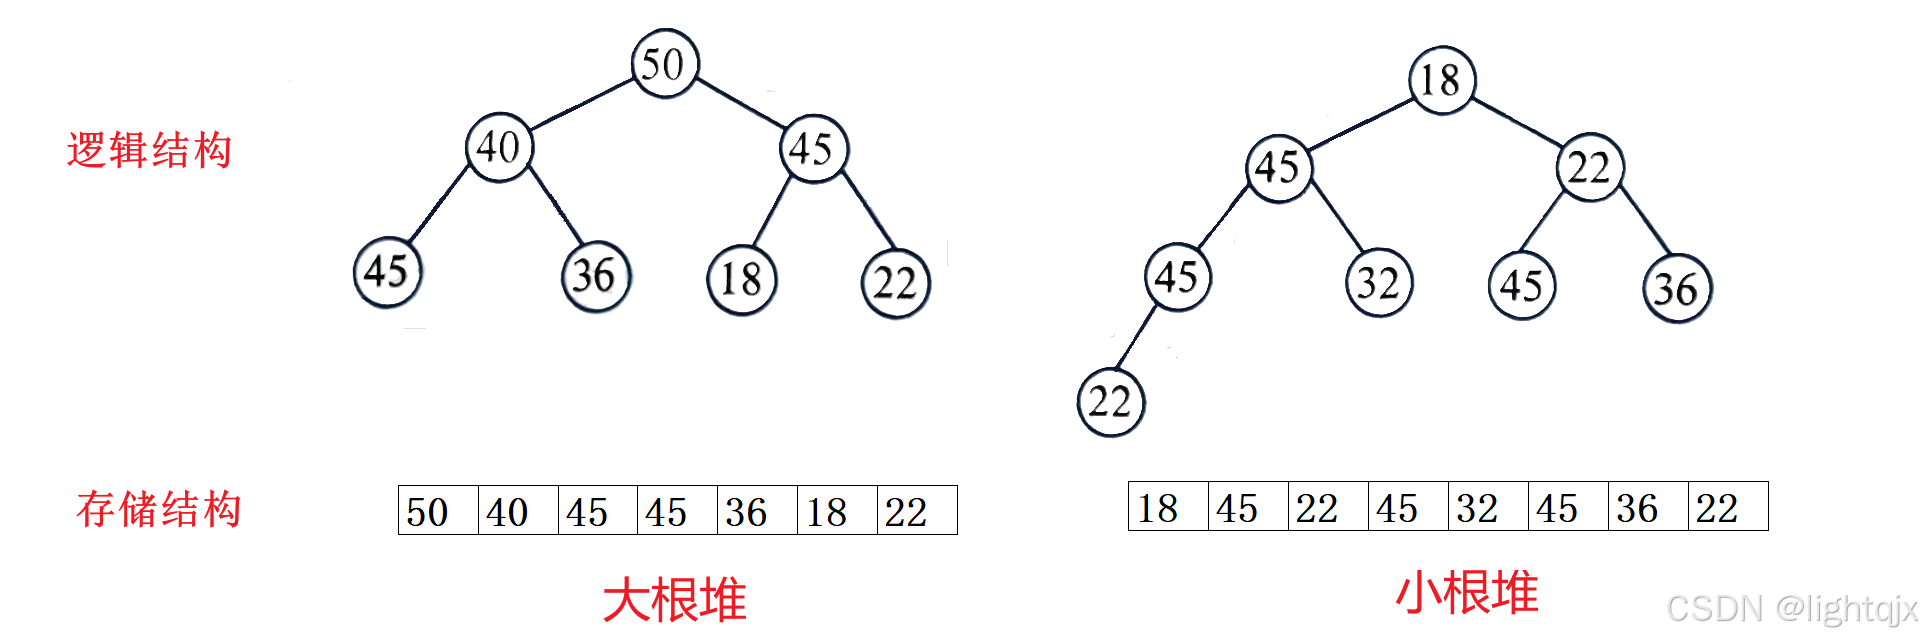
堆是数据结构中的一种常用结构,本质上来说堆是一种完全二叉树。
对于一组数据,将它的所有元素都按照完全二叉树的顺序存储方式存储在一个一维数组中,并让它满足:每个结点的值都小于或等于其左、右孩子结点的值,或者每个结点的值都大于或等于其左、右孩子结点的值。则称为小堆(或大堆)。
分类:
- 如果每个(所有)结点的值都小于或等于(≤)其左、右孩子结点的值,即根结点最小,则被称为小根堆。
- 如果每个(所有)结点的值都大于或等于(≥)其左、右孩子结点的值,即根结点最大,则被称为大根堆。
图示:
二、堆的实现
在堆中数据是存储在一维数组中的,堆的存储结构定义就可以和顺序表一样,定义一维数组,如下
typedef int HPDataType;
typedef struct Heap
{
	HPDataType* a;
	int size;// 大小
	int capacity;// 容量
}Heap;
1. 堆的向下调整算法
堆的向下调整算法是实现堆的一个重要操作,一般当对二叉树的顶部不符和当前整个堆的逻辑,然后向下调整顶部。
(1)小堆
如果这里有一个数组,逻辑上可以将它看做一颗完全二叉树,并且在这个数组中根结点的左孩子和右孩子都是一个小堆。如图:

对于根结点27这个数据,在这个完全二叉树中,如果要将它变成一个小堆,这就需要将27向下调整。向下调整就是将要调整的结点和它的左孩子和右孩子中较小(小堆是比较较小的一个)的一个进行比较,如果要调整的结点数据比左孩子和右孩子中较小孩子大,就需要交换它们两个,再将交换后的这个数据在与它的左孩子和右孩子中较小的一个进行比较,重复上述操作,直到这个数据比它的左孩子和右孩子中较小的一个还小或者没有孩子时才停止,如图:
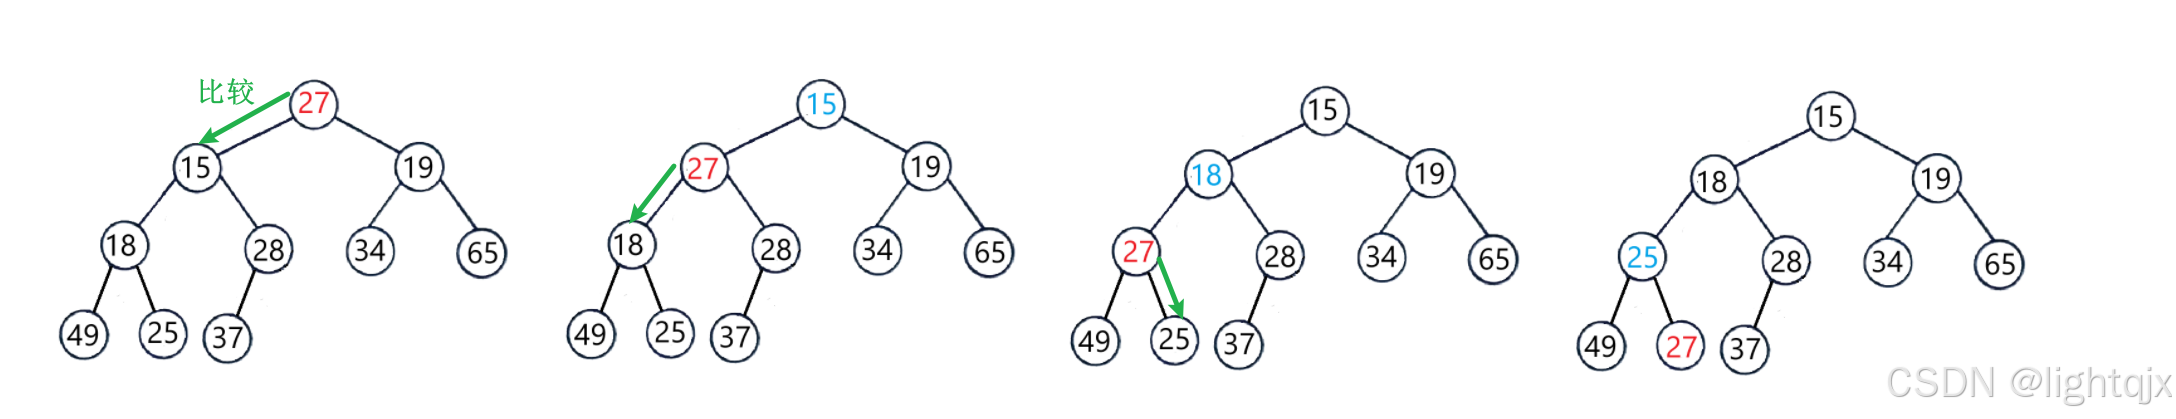
这就是向下调整的基本逻辑操作。
需要注意的是要执行向下调整算法必须要满足要调整的结点的左右孩子一定都是小堆(因为这里建的是小堆,如果建的是大堆,左右孩子就必须是大堆了)
要实现这个算法,需要传递三个参数:数组a,堆中数据的个数n,要调整的结点在一维数组中的下标parent。先找到它的左孩子(可以用到完全二叉树的性质child=2 * parent + 1),判断是否有孩子,再找左右孩子较小的一个,进行比较,如果比左右孩子较小的一个大,就交换。
则C语言实现如下:
void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}
void AdjustDown(HPDataType* a, int n, int parent)
{
	int child = 2 * parent + 1;//左孩子
	while (child < n)
	{
		//找左右孩子较小的一个
		if (child + 1 < n && a[child] > a[child + 1])
		{
			child++;
		}

		if (a[parent] > a[child])
		{
			Swap(&a[parent], &a[child]);
			parent = child;
			child = 2 * parent + 1;
		}
		else
		{
			break;
		}
	}
}
以上操作是对小堆中的向下调整算法的实现。
(2)大堆
对于大堆,和小堆类似, 向下调整就是将要调整的结点和它的左孩子和右孩子中较大(大堆是比较较大的一个)的一个进行比较,如果要调整的结点数据比左孩子和右孩子中较大孩子小,就需要交换它们两个,再重这种操作。(必须要满足要调整的结点的左右孩子一定都是大堆)
则C语言实现如下:
void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}
void AdjustDown(HPDataType* a, int n, int parent)
{
	int child = 2 * parent + 1;//左孩子
	while (child < n)
	{
		//找左右孩子较大的一个
		if (child + 1 < n && a[child] < a[child + 1])
		{
			child++;
		}

		if (a[parent] < a[child])
		{
			Swap(&a[parent], &a[child]);
			parent = child;
			child = 2 * parent + 1;
		}
		else
		{
			break;
		}
	}
}
总结:
通过上述操作可以发现实现算法,传递三个参数:数组a,堆中数据的个数n,要调整的结点在一维数组中的下标parent是固定的,从参数可以理解到,只要在parent的左右孩子都满足小堆(或大堆),就可以对该结点进行向下调整。
2. 堆的向上调整算法
堆的向上调整算法,一般是当二叉树的尾部不符和当前整个堆的逻辑,然后对它向上进行调整。
(1)小堆
对于小堆,如图。这里有一个数组,除了最后一个数据外,其余的数据可以构成一个小堆。
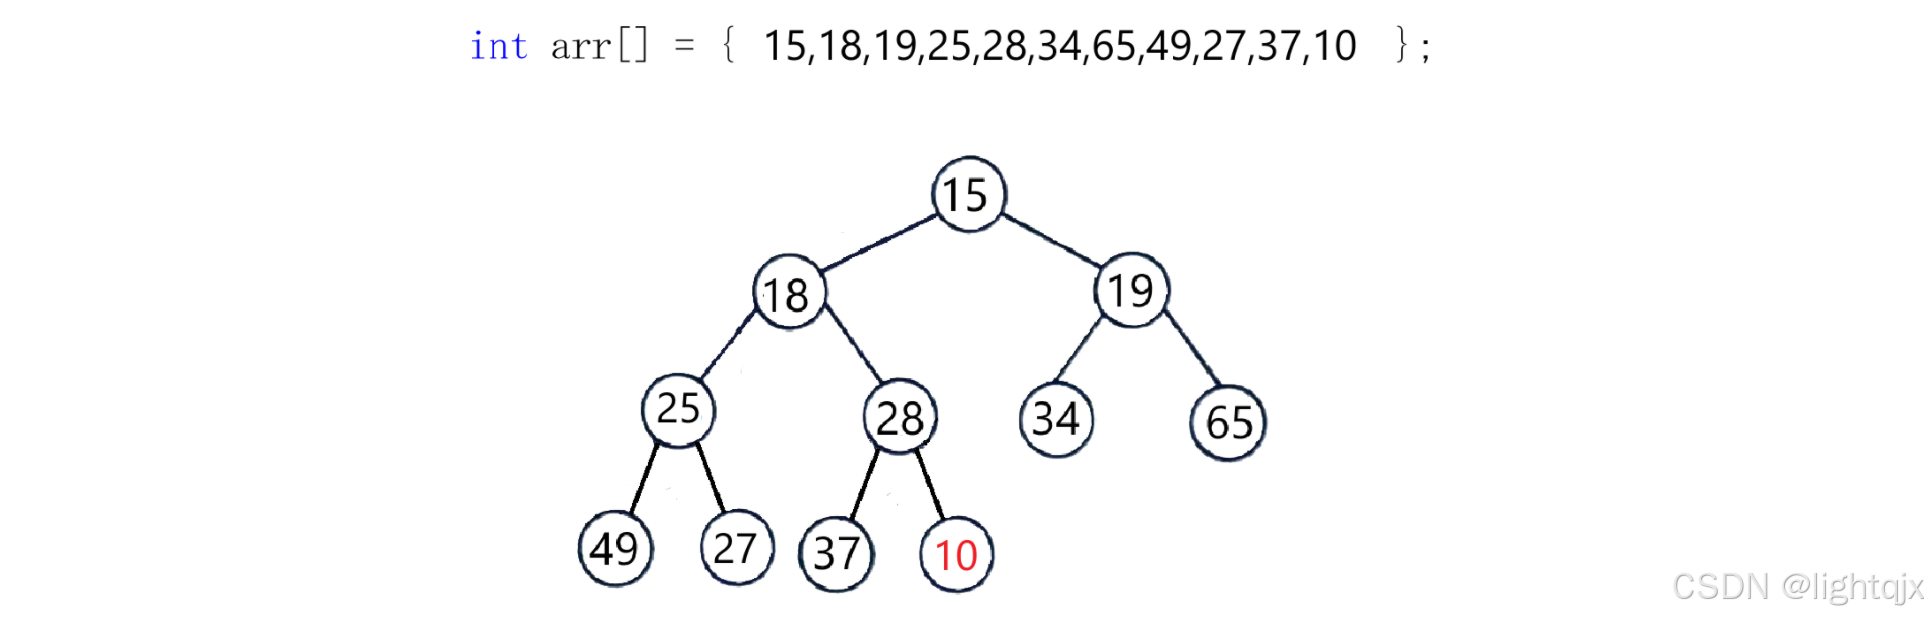
如果要让这个数据能够够成一个小堆,就需要将10进行向上调整。向上调整的方式是要将要调整的数据与它的双亲结点进行比较,如果小于它的双亲结点,那就交换;然后再次和此时的双亲结点进行比较,如果小于它的双亲结点,就交换,直到小于它的双亲结点或者和根结点比较完。如图:

这就是向上调整的基本逻辑操作。
向上调整需要注意的是要保证除了要调整的整个数据外,其余的数据可以构成一个小堆(对于建的小堆而言)。
实现它需要传递三个参数:数组a,堆中数据的个数n,要调整的结点在一维数组中的下标child。这里要找的是要调整结点的双亲结点(完全二叉树性质:parent = (child - 1) / 2),判断是否根结点,进行比较,如果该结点比双亲结点小,就交换。则C语言实现如下:
void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}
void AdjustUp(HPDataType* a, int child)
{
	int parent = (child - 1) / 2;
	while (child > 0)
	{
		if (a[parent] > a[child])
		{
			Swap(&a[parent], &a[child]);
			child = parent;
			parent = (child - 1) / 2;
		}
		else
		{
			break;
		}
	}
}
以上操作是对小堆中的向上调整算法的实现。
(2)大堆
在大堆中,每个结点的值都大于或等于其左、右孩子结点的值。和小堆类似,但当要调整的数据与它的双亲结点进行比较时,如果大于它的双亲结点,才会交换。交换后再重复这个操作。这就是大堆的向上调整。这里必须要保证除了要调整的整个数据外,其余的数据可以构成一个大堆。
则C语言实现如下:
void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}
void AdjustUp(HPDataType* a, int child)
{
	int parent = (child - 1) / 2;
	while (child > 0)
	{
		if (a[parent] < a[child])
		{
			Swap(&a[parent], &a[child]);
			child = parent;
			parent = (child - 1) / 2;
		}
		else
		{
			break;
		}
	}
}
总结:
对于大堆和小堆的向上调整,参数:数组a,堆中数据的个数n,要调整的结点在一维数组中的下标child是固定的,必须要保证除了要调整的整个数据外,其余的数据可以构成一个大堆。这样就能对指定的结点进行调整。一般来说,对于向上调整,常常调整的只有当最后一个元素不满足时对它进行调整。
3. 堆的插入
已知一个可以构成堆的数组,现在需要插入一个数。在堆中插入数据的操作是:先将数据插入到数组尾部,再通过向上调整将整个数组调整为堆。如图小堆为例:

C语言实现如下:
// 堆的插入
void HeapPush(Heap* php, HPDataType x)
{
	assert(php);
	//扩容
	if (php->size == php->capacity)
	{
		HPDataType* tmp = (HPDataType*)realloc(php->a, sizeof(HPDataType) * php->capacity * 2);
		if (tmp == NULL)
		{
			perror("realloc fail");
			return;
		}
		php->a = tmp;
		php->capacity *= 2;
	}
	//数据插到数组尾
	php->a[php->size] = x;
	php->size++;
	//向上调整
	AdjustUp(php->a, php->size - 1);
}
如果是对大堆进行调整,就要使用对大堆的向上调整方式。
4. 堆的删除
堆的删除删除的是堆顶的元素,它的具体操作是:先将数组中第一个元素与最后一个与元素交换,然后再对此时的第一个(堆顶元素)进行向下调整,如图小堆为例:

C语言实现如下:
// 堆的删除-从堆顶开始删除
void HeapPop(Heap* php)
{
	assert(php);
	assert(!HeapEmpty(php));//判空
	//1.将堆顶的元素与最后一个元素交换
	Swap(&php->a[0], &php->a[php->size-1]);
	php->size--;
	//2.向下调整
	AdjustDown(php->a, php->size, 0);
}
如果是对大堆进行调整,就要使用对大堆的向下调整方式。
5. 堆的创建
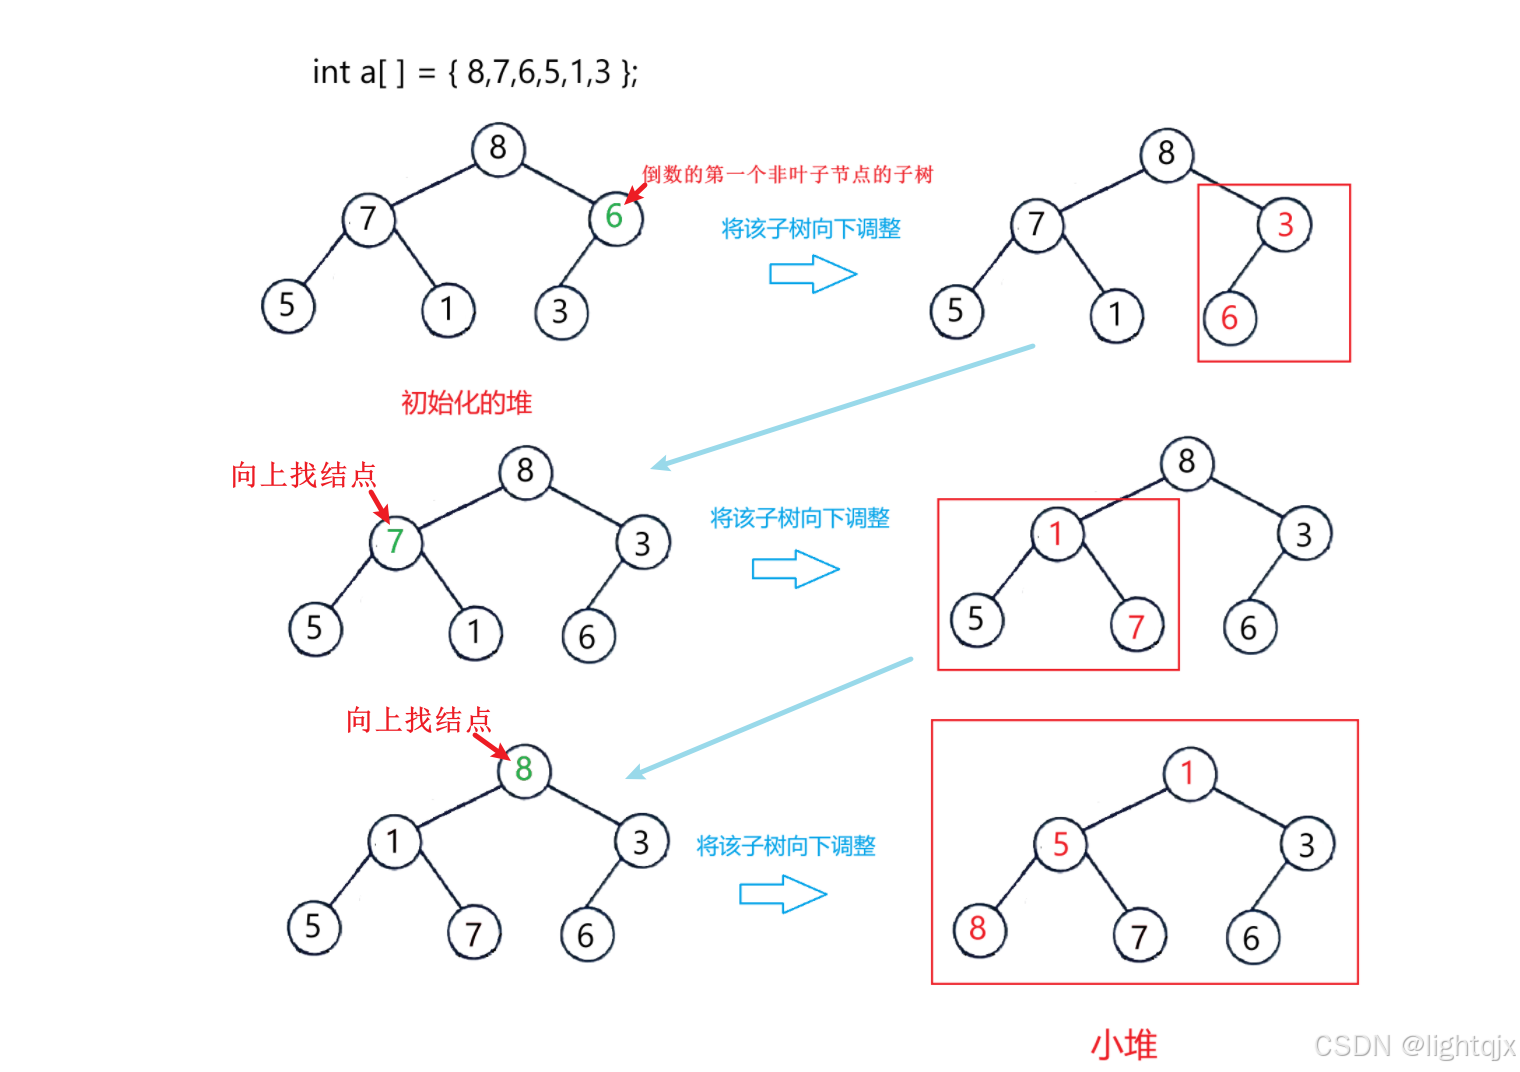
首先给出一个随机的数组,虽然可以将这个数组逻辑上看成一个完全二叉树,但此时这还不是堆,因为它还不满足每个结点的值都小于或等于其左、右孩子结点的值。此时如果要来将它调整成堆的话,就需要从倒数的第一个非叶子节点的子树开始调整,一直调整到根节点的树,就可以调整成想要的堆。
(1)建小堆
在小堆中,每个结点的值都小于或等于其左、右孩子结点的值。如果要建小堆,如图:
C语言实现如下:
void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}
//向下调整
void AdjustDown(int* a, int n, int parent)
{
	int child = 2 * parent + 1;//左孩子
	while (child < n)
	{
		//找左右孩子较小的一个
		if (child + 1 < n && a[child] > a[child + 1])
		{
			child++;
		}

		if (a[parent] > a[child])
		{
			Swap(&a[parent], &a[child]);
			parent = child;
			child = 2 * parent + 1;
		}
		else
		{
			break;
		}
	}
}
// 堆的构建
void HeapCreate(Heap* hp, HPDataType* a, int n)
{
	int i;
	for (i = hp->size; i < n + hp->size; i++)
	{
		hp->a[i] = a[i];
	}
	i = (n - 1 - 1) / 2;//找到倒数的第一个非叶子节点的子树
	for (; i >= 0; i--)
	{
		AdjustDown(hp->a, n, i);
	}
}
(2)建大堆
在大堆中,每个结点的值都大于或等于其左、右孩子结点的值。如果要建大堆,如图:
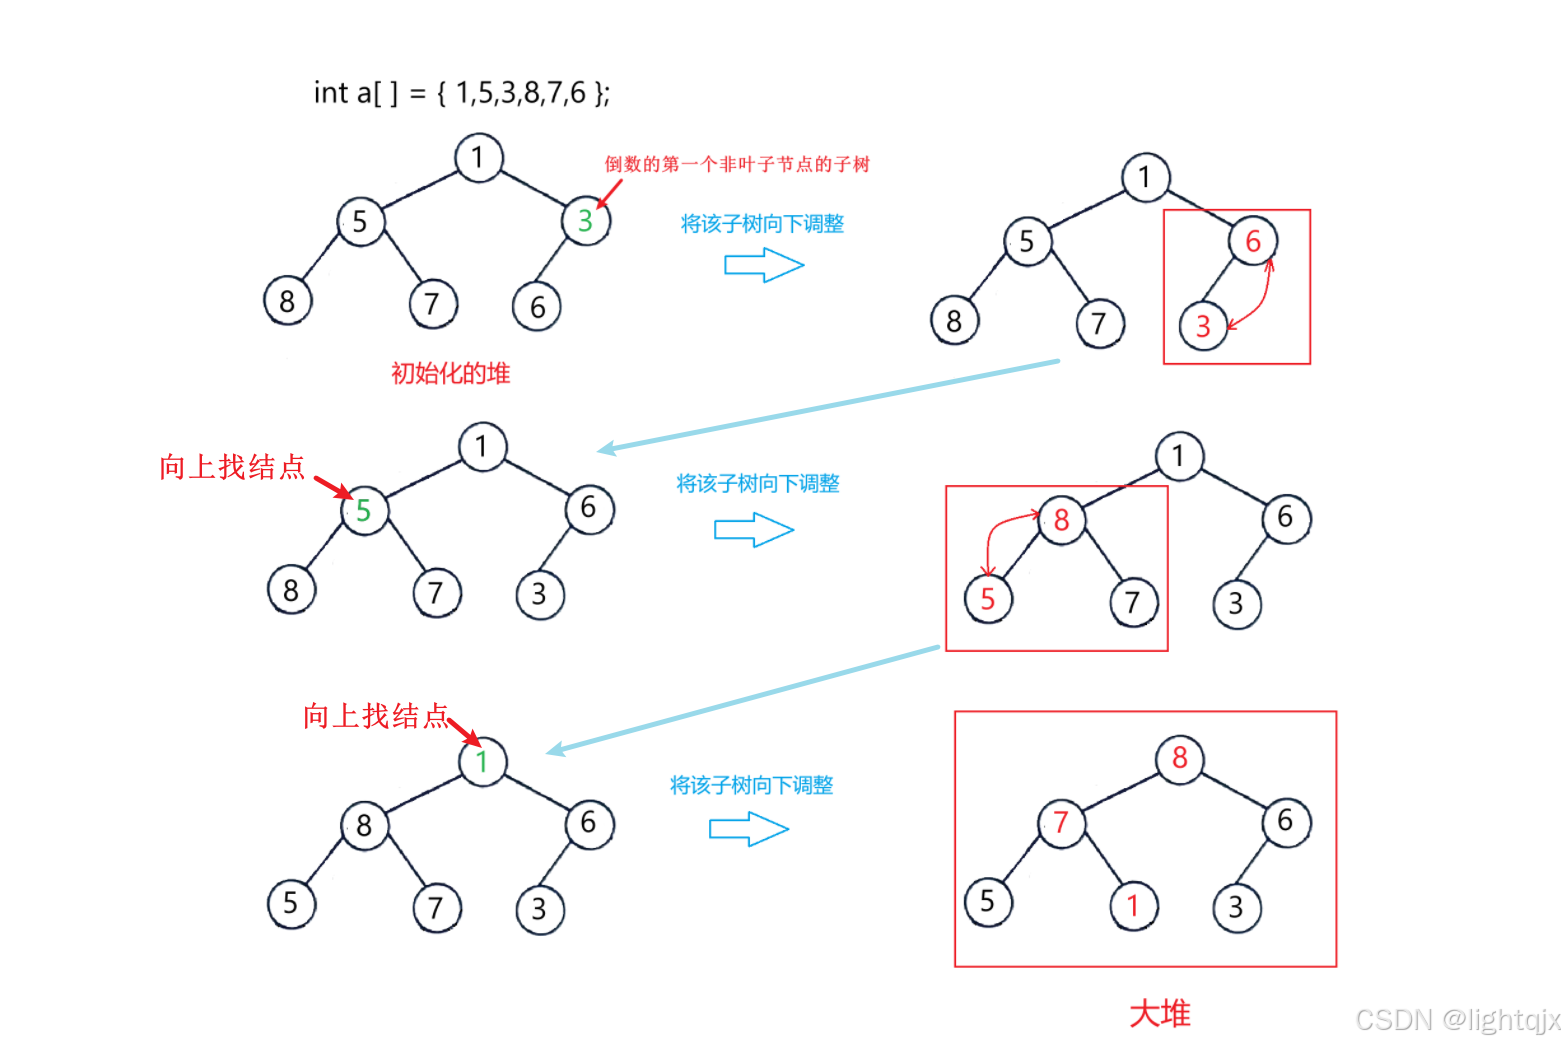
C语言实现如下:
void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}
//向下调整-建大堆
void AdjustDown(int* a, int n, int parent)
{
	int child = 2 * parent + 1;//左孩子
	while (child < n)
	{
		//找左右孩子较大的一个
		if (child + 1 < n && a[child] < a[child + 1])
		{
			child++;
		}

		if (a[parent] < a[child])
		{
			Swap(&a[parent], &a[child]);
			parent = child;
			child = 2 * parent + 1;
		}
		else
		{
			break;
		}
	}
}
// 堆的构建
void HeapCreate(Heap* hp, HPDataType* a, int n)
{
	int i;
	for (i = hp->size; i < n + hp->size; i++)
	{
		hp->a[i] = a[i];
	}
	i = (n - 1 - 1) / 2;//找到倒数的第一个非叶子节点的子树
	for (; i >= 0; i--)
	{
		AdjustDown(hp->a, n, i);
	}
}
总结:
可以发现,建立大堆和建立小堆的代码实现几乎是一样的,它们只有在建立时所使用的向下调整的大门有点不同。因此就可以通过向下调整算法来判断建立的是大堆还是小堆。
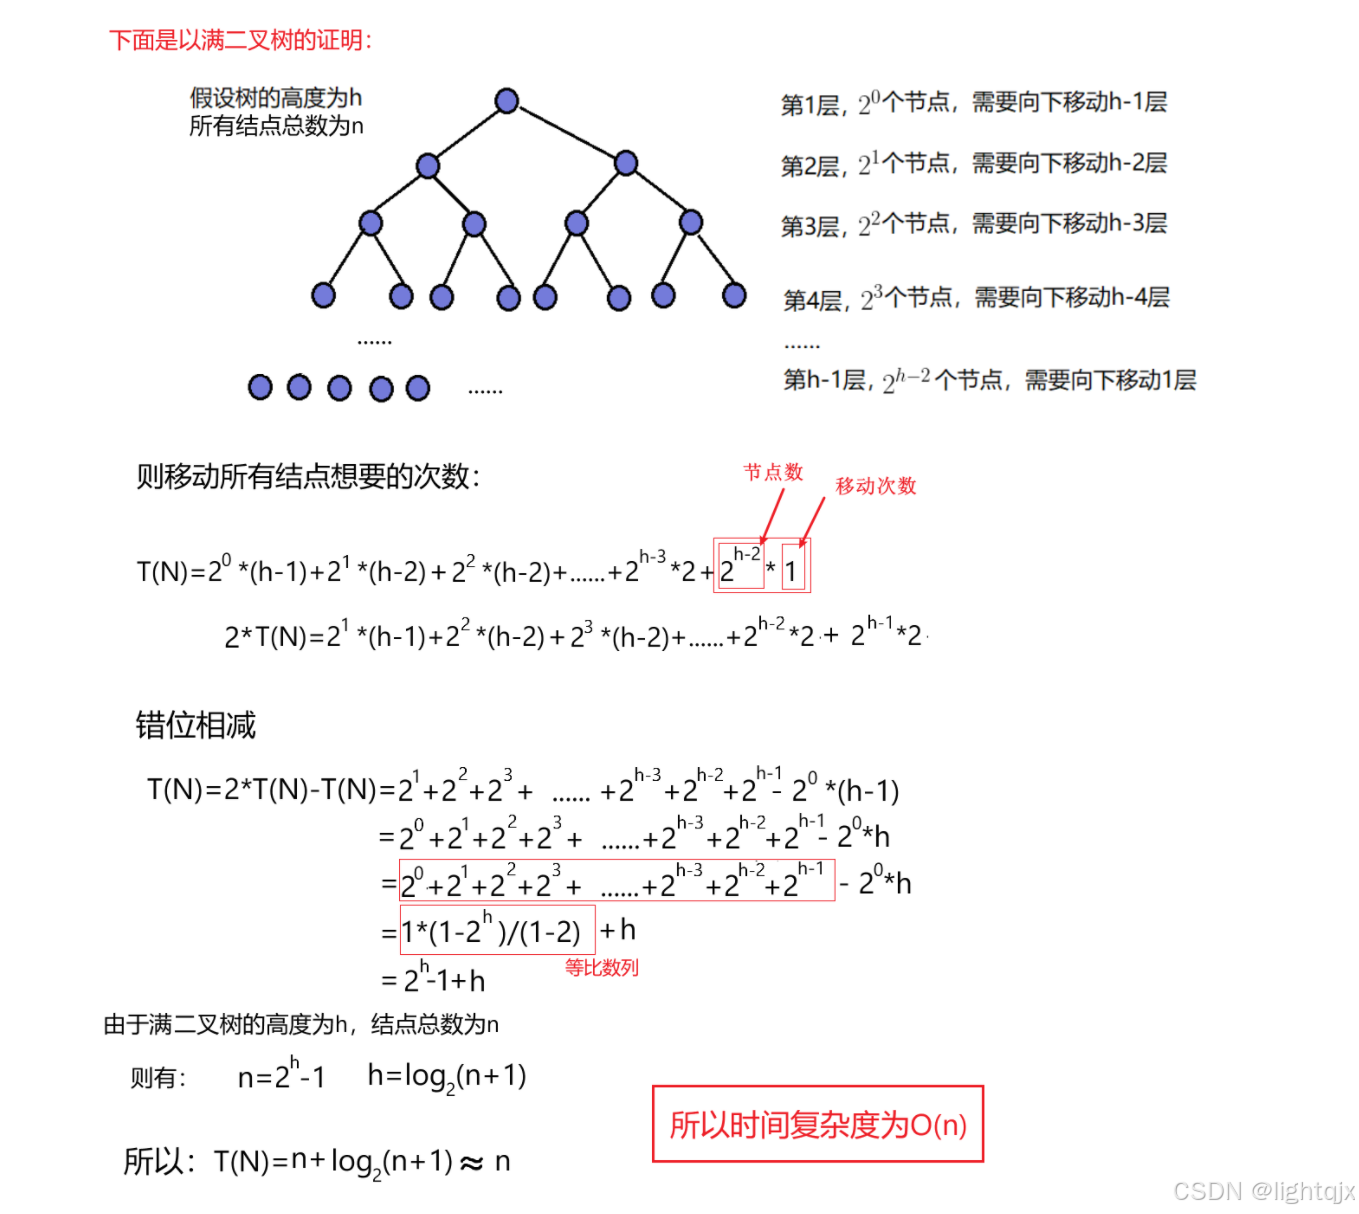
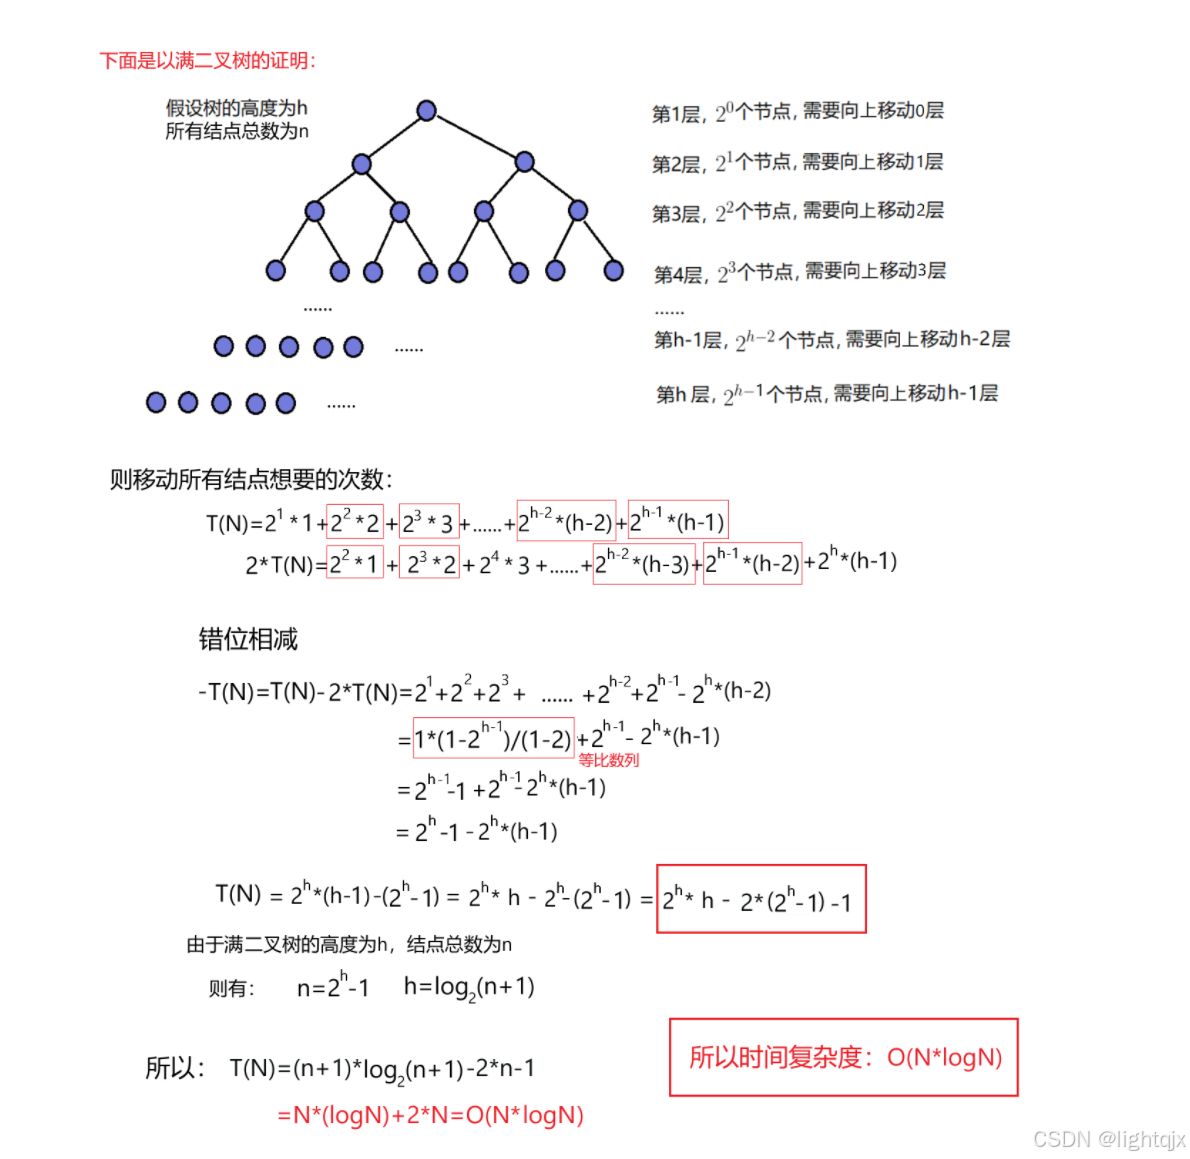
6. 建堆的时间复杂度
建堆的时间复杂度为:O(n)。
如图是向下调整算法建堆的证明:
如图是向上调整算法建堆的证明:
7. 取堆顶的数据
只需要返回堆中的这个数组第一个元素即可。C语言实现如下:
// 取堆顶的数据
HPDataType HeapTop(Heap* php)
{
	assert(php);
	return php->a[0];
}
8. 堆的数据个数
由于在顶定义时就已经定义的堆的有效数据个数的大小,所以此时就只需要返回size的数据即可。C语言实现如下:
// 堆的数据个数
int HeapSize(Heap* php)
{
	assert(php);
	return php->size;
}
9. 堆的判空
判空只需要判断有效数据个数size是否为0,C语言实现如下:
// 堆的判空
bool HeapEmpty(Heap* php)
{
	assert(php);
	return php->size == 0;
}
三、堆的应用
1. 堆排序
堆排序是堆的常见应用。
进行堆排序,第一步需要建堆。
- 排升序(从小到大):建大堆
- 排降序(从大到小):建小堆
第二步是利用堆删除思想来进行排序。
为什么呢?其原因如下:
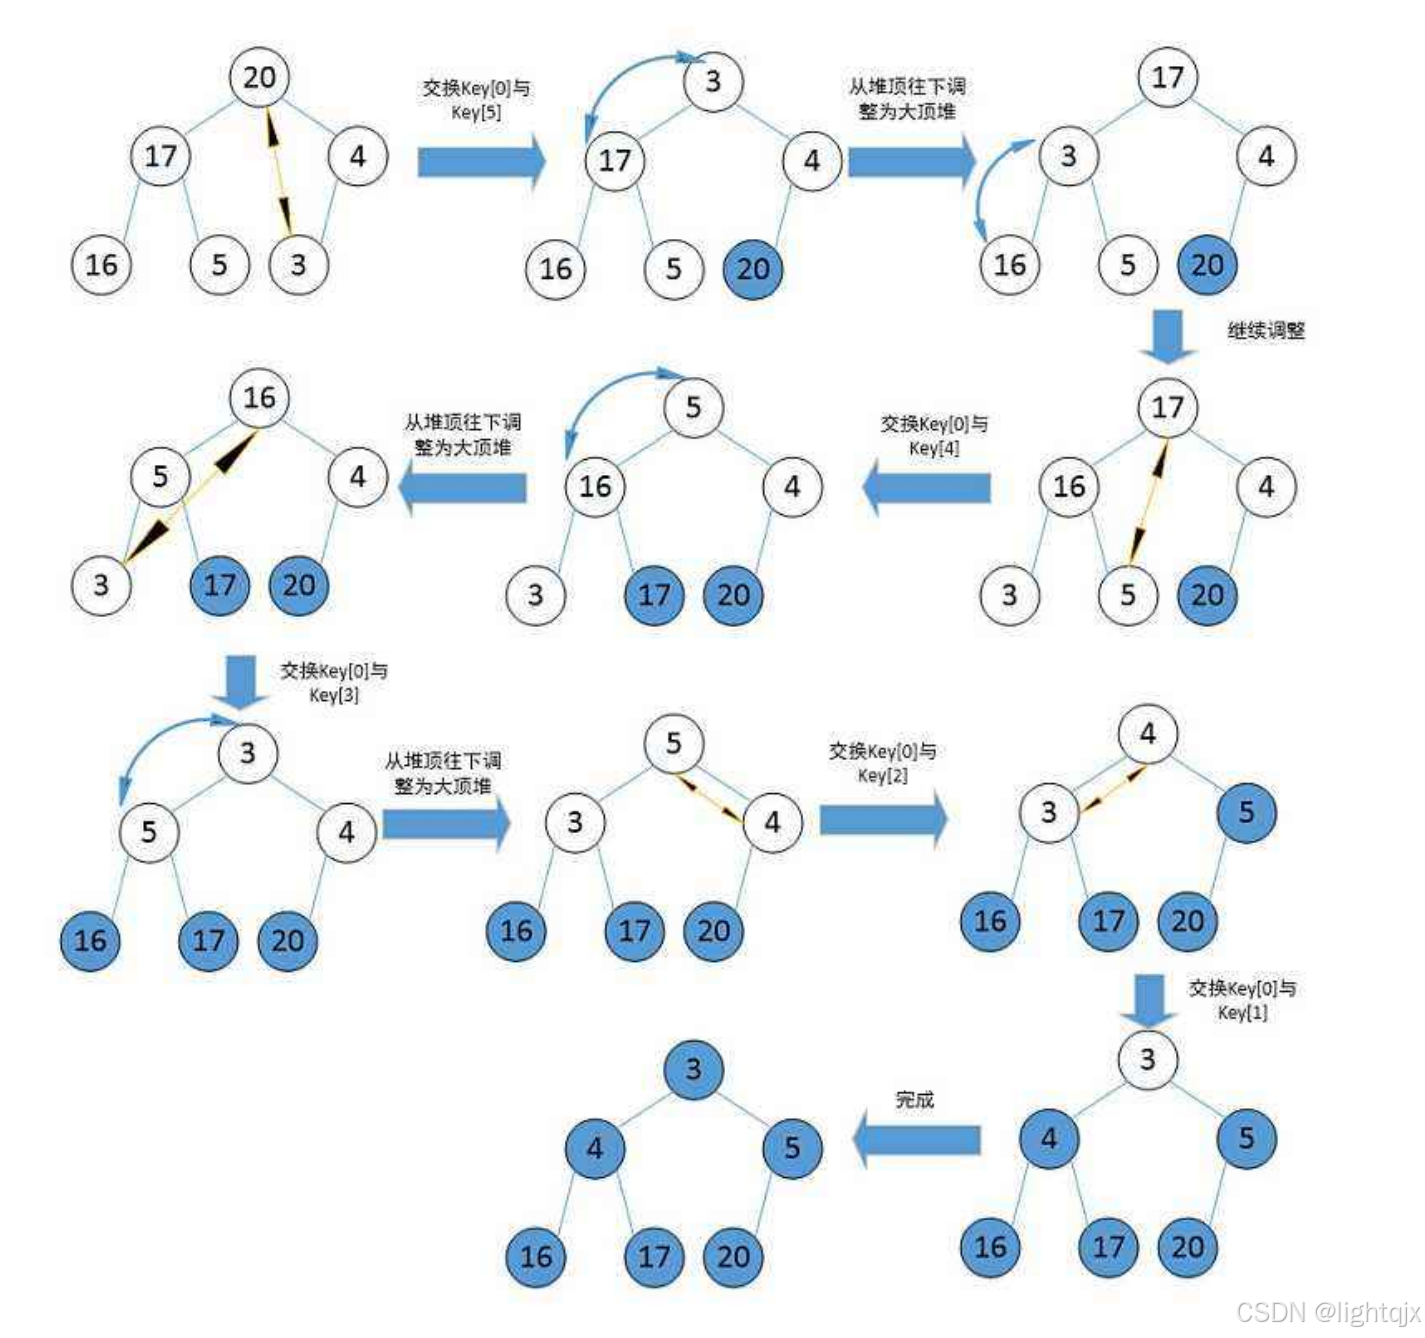
我们知道,堆的删除是通过将堆顶元素与最后一个元素进行交换来实现的。如果是大堆,堆顶的元素是最大的,删除操作就是要将堆顶元素,也就是最大元素换到最后去,那么,此时在最后的元素就变成了最大的一个元素了。此时的堆只会考虑除交换到最后这个位置之前的所有元素了,在进行一次向下调整后堆顶元素又变成了此时这个堆的最大的一个元素了,又进行交换,就将原先第二大的元素排到了原数组的倒数第二个位置了,......,依次类推,将堆删除完,也就将数组排完了顺序。
对于小堆,也是同样的道理。
如图是一个建大堆排升序的参考示意图(一个大堆经过逐步删除,来排升序):
C语言实现如下:
void HeapSort(int* a, int n)
{
	//1.将原数组建成一个堆
	for (int i = (n - 1 - 1) / 2; i >= 0; i--)
	{
		AdjustDown(a, n, i);
	}
	//2.实现堆的删除思想
	for (int end = n - 1; end > 0; end--)
	{
		Swap(&a[end], &a[0]);//交换
		AdjustDown(a, end, 0);//向下调整,end表示此时的堆的数据个数
	}
}
对于不同的排序效果,只需要调整建堆的方式就行了。
2. TOP-K问题
TOP-K问题:即求数据结合中前K个最大的元素或者最小的元素,一般情况下数据量都比较大。
比如,要在100亿个数据中,找出前50个最大的数据。
我们一般看到这种问题,第一时间想到的就是通过排序来求解。但这会出现一个问题:当数据特别大时,我们的程序可能会崩溃,排序是解决不了的(可能数据都不能一下子全部加载到内存中)。
因此,在我们遇到这样的问题时,最佳的方法就是使用堆。它的基本思路是:
1. 用数据集合中前K个元素来建堆
- 如果要找前k个最大的元素,就建小堆
- 如果要找前k个最小的元素,就建大堆
2. 用剩余的N-K个元素依次与堆顶元素来比较,不满足则替换堆顶元素
以找前k个最大的元素,建小堆为例。首先,我们使用了这个数据的前k个元素来建了一个小堆,此时,堆顶元素是当前这k个中元素中最小的元素。然后我们就继续遍历后面的除了这k个元素的其他元素,如果遇到比堆顶元素个更大的元素,就替换掉堆顶元素,再对这个堆顶的元素进行向下调整。遍历直到所以数据都访问完,这时的在堆中的这k这元素就是在所有元素中最大的k个元素了。
原理:维护一个大小为 K 的小顶堆。堆顶是这 K 个数中最小的。遍历所有数据,当遇到比堆顶更大的数时,就替换掉堆顶,确保堆里始终是目前见过的最大的 K 个数。
对于在N个数中找最大当前K个元素。
当N是100亿,100亿个整数要占用的内存就是40G左右,可以发现,这写数据量是恐怖的。
所以当数据很大时,内存就存不下了,数据就会利用磁盘文件存储数据了。
所以下面代码实现操作就采用了文件操作。
代码实现:
#include<stdio.h>
#include<assert.h>
#include<stdlib.h>
#include<time.h>
void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}
void AdjustDown(int* a, int n, int parent)
{
	int child = 2 * parent + 1;//左孩子
	while (child < n)
	{
		//找左右孩子较小的一个
		if (child + 1 < n && a[child] > a[child + 1])
		{
			child++;
		}

		if (a[parent] > a[child])
		{
			Swap(&a[parent], &a[child]);
			parent = child;
			child = 2 * parent + 1;
		}
		else
		{
			break;
		}
	}
}
void PrintTopK(const char* file, int k)
{
	// 1.建堆--用a中前k个元素建小堆
	int* topk = (int*)malloc(sizeof(int) * k);
	assert(topk);

	FILE* fout = fopen(file, "r");
	if (fout == NULL)
	{
		perror("fopen error");
		return;
	}

	// 读出前k个数据并建小堆
	for (int i = 0; i < k; ++i)
	{
		fscanf(fout, "%d", &topk[i]);
	}
	for (int i = (k - 2) / 2; i >= 0; --i)
	{
		AdjustDown(topk, k, i);
	}

	// 2.将剩余N-k个元素依次与堆顶元素比较
	int val = 0;
	int ret = fscanf(fout, "%d", &val);
	while (ret != EOF)
	{
		if (val > topk[0])
		{
			topk[0] = val;
			AdjustDown(topk, k, 0);
		}
		ret = fscanf(fout, "%d", &val);
	}

	//打印这k个数
	for (int i = 0; i < k; i++)
	{
		printf("%d ", topk[i]);
	}
	printf("\n");

	free(topk);
	fclose(fout);
}

void CreateNDate()
{
	// 造数据
	int N = 10000;
	srand((unsigned int)time(NULL));
	const char* file = "data.txt";
	FILE* fin = fopen(file, "w");
	if (fin == NULL)
	{
		perror("fopen error");
		return;
	}

	for (size_t i = 0; i < N; ++i)
	{
		int x = rand() % 10000;
		fprintf(fin, "%d\n", x);
	}
	fclose(fin);
}

int main()
{
	//CreateNDate();//运行一次该代码即可,因为每次运行该代码都会重新产生随机数
	PrintTopK("data.txt", 10);
	return 0;
}
以上便是关于堆的基本知识介绍及其应用。
感谢各位观看、支持!!!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献6条内容

所有评论(0)