一、数据结构与算法——第2章:线性表
目录
2.1线性表的定义和基本操作
2.1.1线性表的定义
线性表是具有相同数据类型的n(n≥0)个数据元素的有限序列,其中n为表长,当n=0时线性表是一个空表。若用L命名线性表,则其一般表示为:L=(a1,a2,…,a,a+1,…,an)式中,a₁是唯一的“第一个”数据元素,也称表头元素;an是唯一的“最后一个”数据元素,也称表尾元素。除第一个元素外,每个元素有且仅有一个直接前驱。除最后一个元素外,每个元素有且仅有一个直接后继(“直接前驱”和“前驱”、“直接后继”和“后继”通常被视为同义词)。以上就是线性表的逻辑特性,这种线性有序的逻辑结构正是线性表名字的由来。
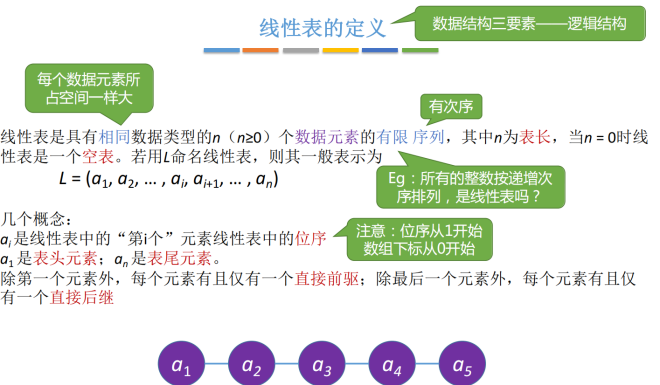
由此,我们得出线性表的特点如下:
●表中元素的个数有限。
●表中元素具有逻辑上的顺序性,表中元素有其先后次序。
●表中元素都是数据元素,每个元素都是单个元素。
●表中元素的数据类型都相同,这意味着每个元素占有相同大小的存储空间。
●表中元素具有抽象性,即仅讨论元素间的逻辑关系,而不考虑元素究竟表示什么内容。
2.1.2线性表的基本操作
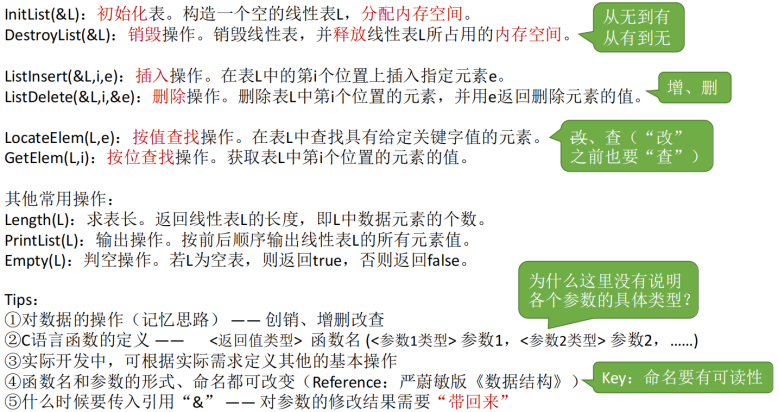
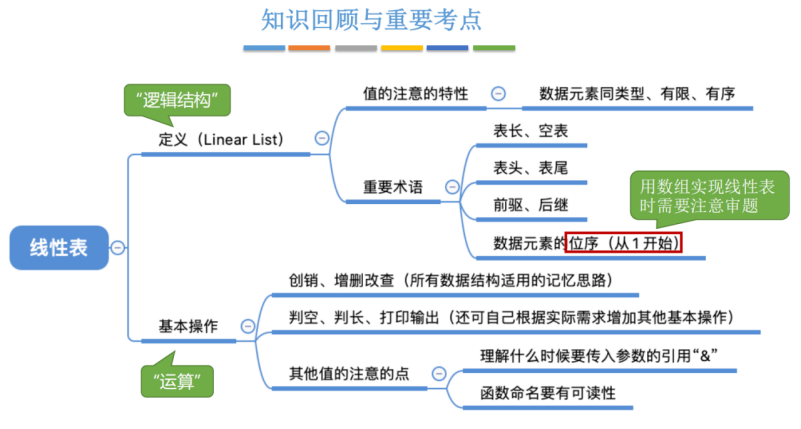
一个数据结构的基本操作是指其最核心、最基本的操作。其他较复杂的操作可通过调用其基本操作来实现。线性表的主要操作如下。
●InitList(&L):初始化表。构造一个空的线性表L,分配内存空间。
●DestroyList(&L):销毁操作。销毁线性表,并释放线性表工所占用的内存空间。
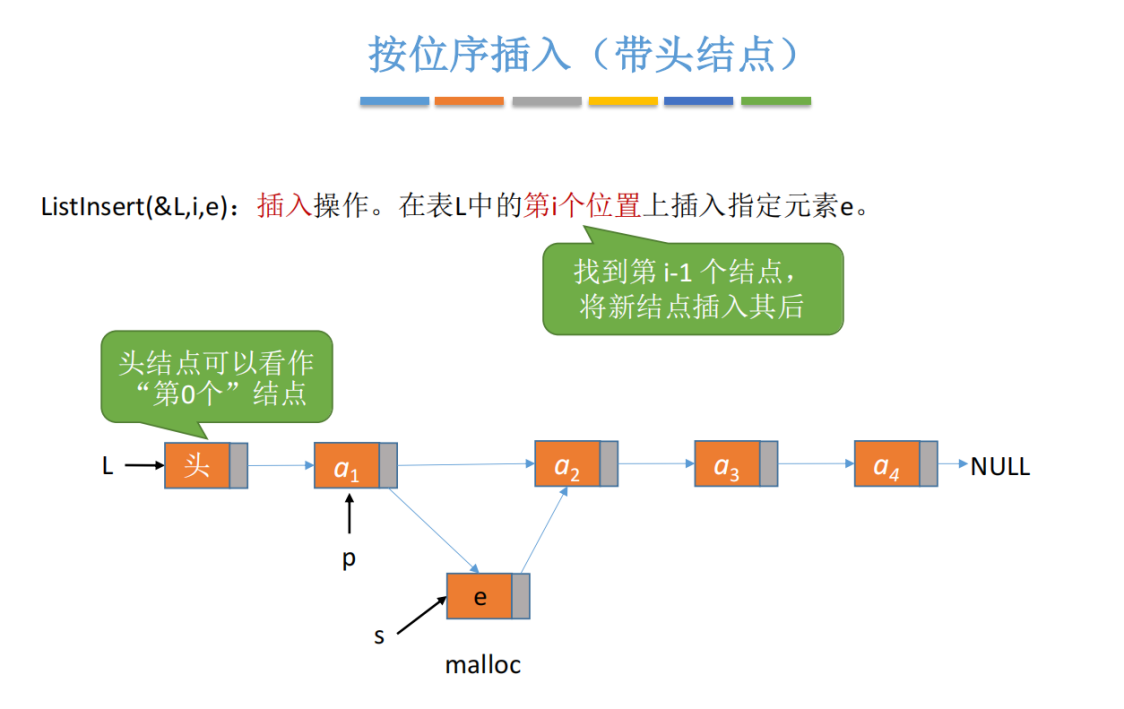
●ListInsert(&L,i,e):插入操作。在表L中的第i个位置上插入指定元素e。
●ListDelete(&L,i,&e):删除操作。删除表L中第i个位置的元素,并用e返回删除元素的值。
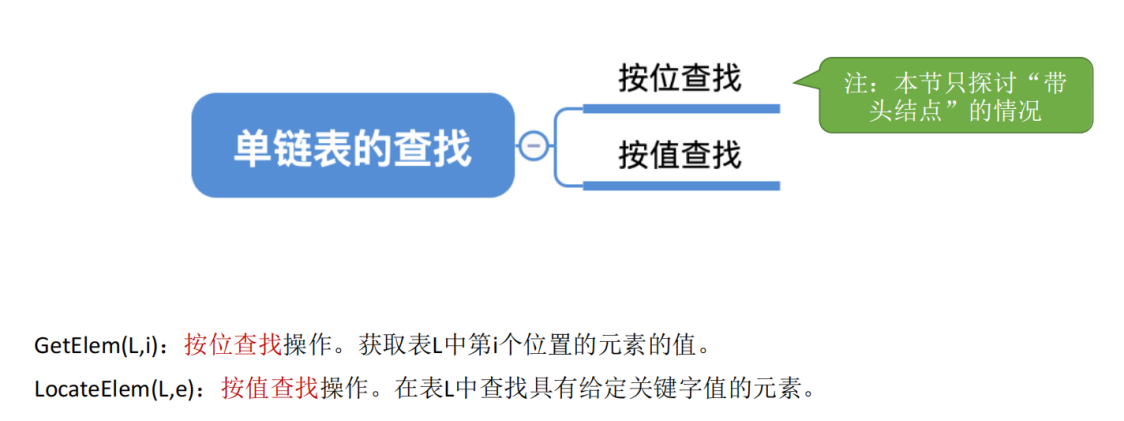
●LocateElem(L,e):按值查找操作。在表L中查找具有给定关键字值的元素。
●GetElem(L,i):按位查找操作。获取表L中第i个位置的元素的值。
●Length(L):求表长。返回线性表工的长度,即L中数据元素的个数。
●PrintList(L):输出操作。按前后顺序输出线性表L的所有元素值。
●Empty(L):判空操作。若L为空表,则返回true,否则返回false。
2.2线性表的顺序表示
2.2.1顺序表的定义
命题追踪——(算法题)顺序表的应用
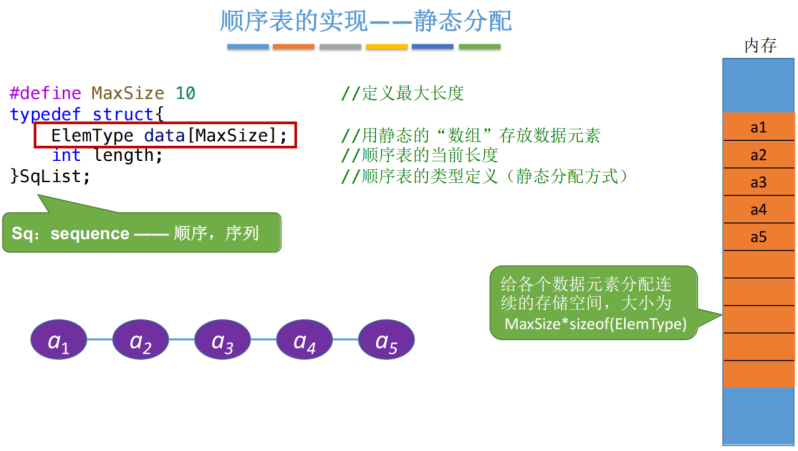
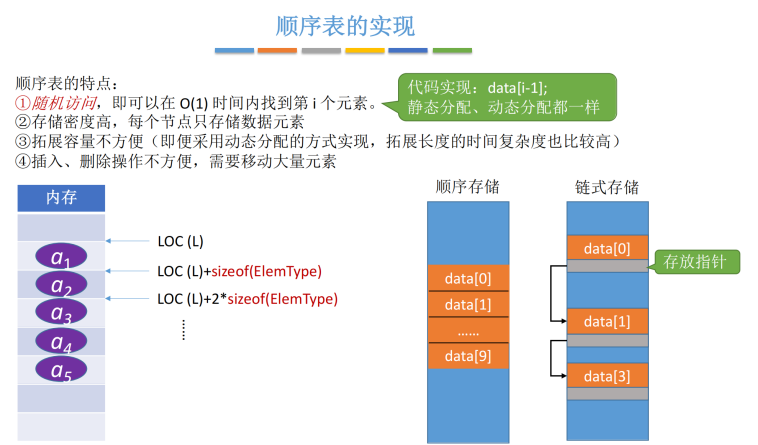
线性表的顺序存储也称顺序表。它是用一组地址连续的存储单元依次存储线性表中的数据元素,从而使得逻辑上相邻的两个元素在物理位置上也相邻。第1个元素存储在顺序表的起始位置,第i个元素的存储位置后面紧接着存储的是第i+1个元素,称i为元素a,在顺序表中的位序。因此,顺序表的特点是表中元素的逻辑顺序与其存储的物理顺序相同。
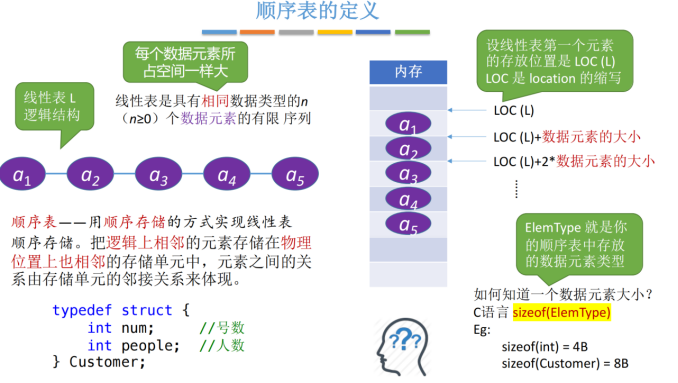
假设顺序表工存储的起始位置为LOC(A),sizeof(ElemType)是每个数据元素所占用存储空间的大小,则表工所对应的顺序存储结构如图2.1所示。
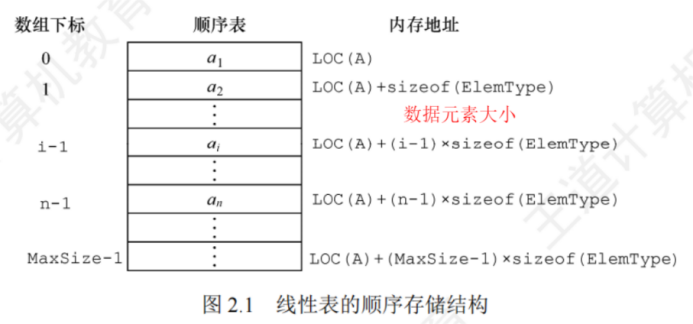
每个数据元素的存储位置都和顺序表的起始位置相差一个和该数据元素的位序成正比的常数,因此,顺序表中的任意一个数据元素都可以随机存取,所以线性表的顺序存储结构是一种随机存取的存储结构。通常用高级程序设计语言中的数组来描述线性表的顺序存储结构。
线性表中元素的位序是从1开始的,而数组中元素的下标是从0开始的。的顺序表存储结构描述为:
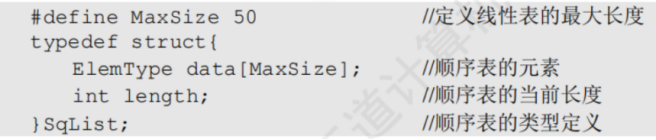
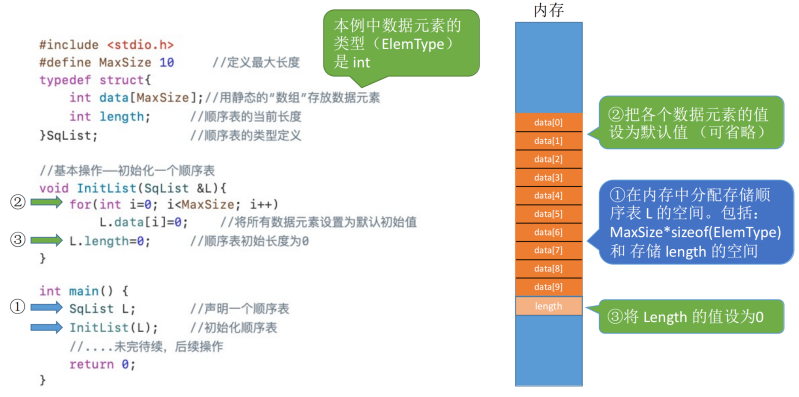
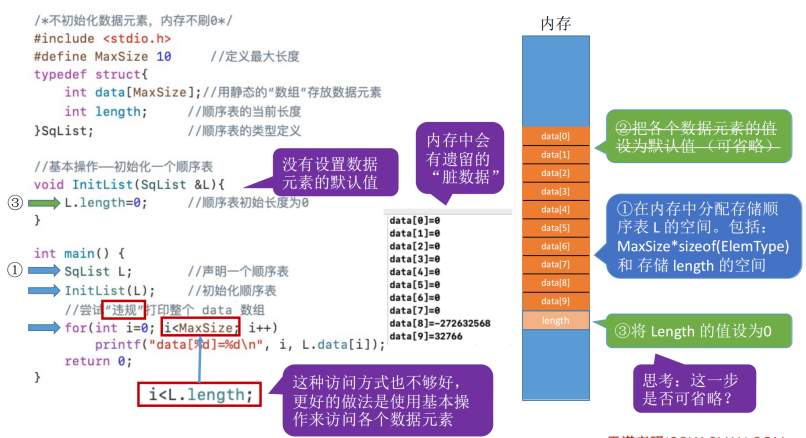
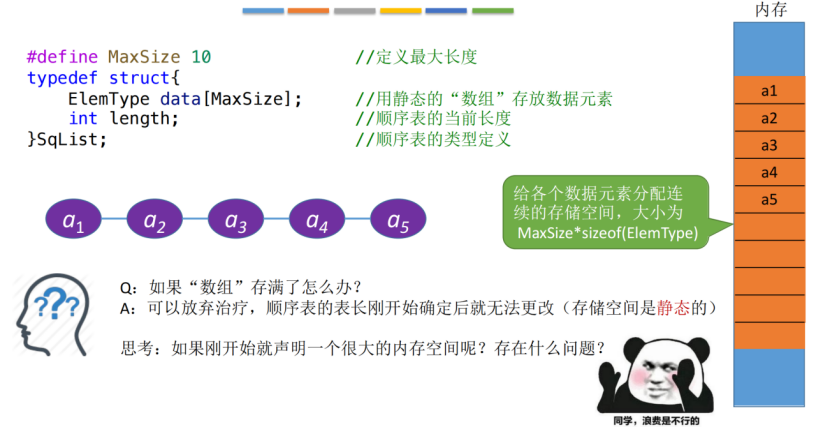
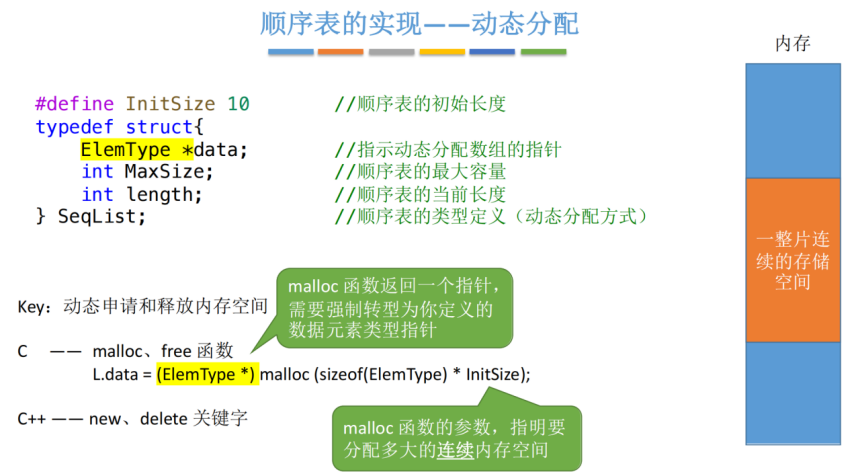
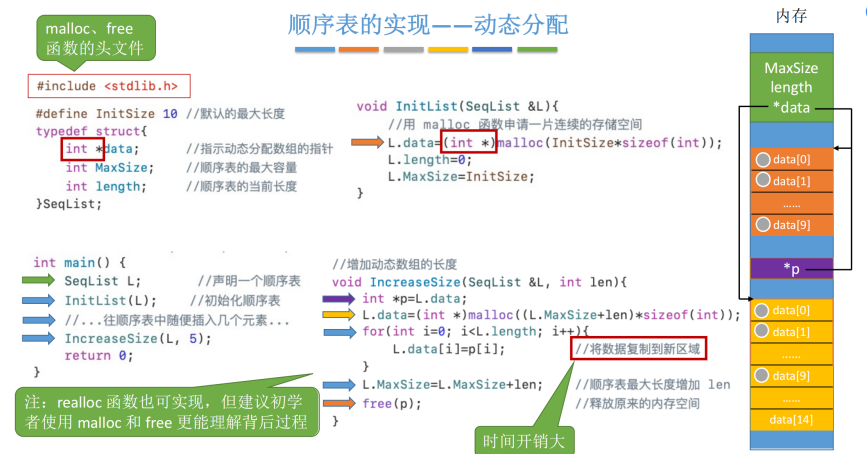
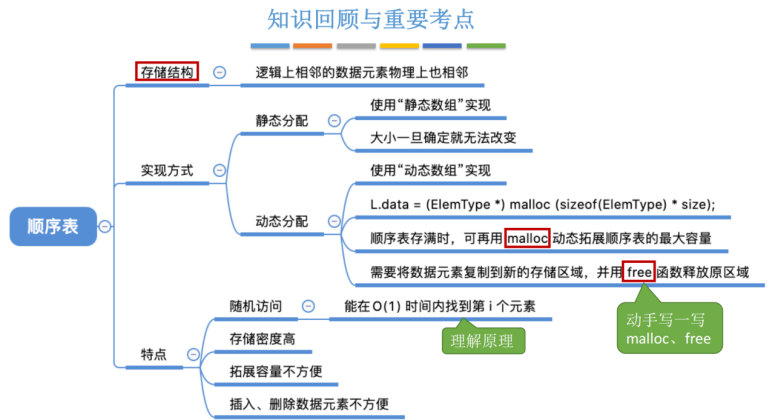
一维数组可以是静态分配(如上)的,也可以是动态分配的。对数组进行静态分配时,因为数组的大小和空间事先已经固定,所以一旦空间占满,再加入新数据就会产生溢出,进而导致程序崩溃。而在动态分配(如下)时,存储数组的空间是在程序执行过程中通过动态存储分配语句分配的,一旦数据空间占满,就另外开辟一块更大的存储空间,将原表中的元素全部拷贝到新空间,从而达到扩充数组存储空间的目的,而不需要为线性表一次性地划分所有空间。动态分配的顺序表存储结构描述为:
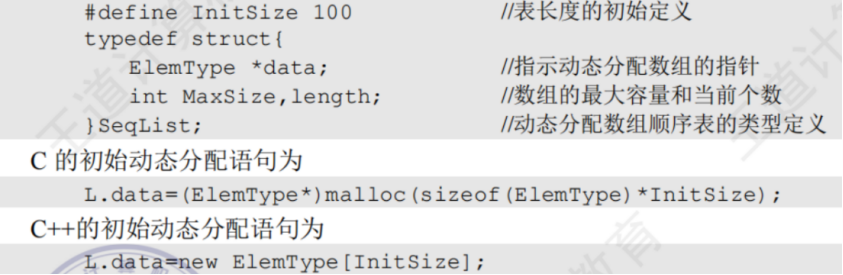
注意:动态分配并不是链式存储,它同样属于顺序存储结构,物理结构没有变化,依然是随机存取方式,只是分配的空间大小可以在运行时动态决定。
顺序表的优点:
①可进行随机访问,即可通过首地址和元素序号可以在O(1)时间内找到指定的元素。
②存储密度高,每个结点只存储数据元素。
顺序表的缺点:
①拓展容量不方便,元素的插入和删除需要移动大量的元素,插入操作平均需要移动n/2个元素,删除操作平均需要移动(n-1)/2个元素。
②插入、删除操作不方便,顺序存储分配需要一段连续的存储空间,不够灵活。
2.2.2顺序表上基本操作的实现
顺序表上操作的时间复杂度分析:
这里仅讨论顺序表的初始化、插入、删除和按值查找,其他基本操作的算法都很简单。
在各种操作的实现中(包括严蔚敏老师撰写的教材),往往可以忽略边界条件判断、变量定义、内存分配不足等细节,即不要求代码具有可执行性,而重点在于算法的思想。
1.顺序表的初始化
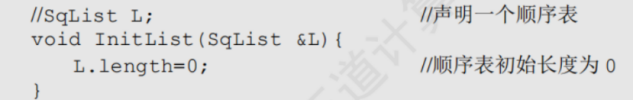
静态分配和动态分配的顺序表的初始化操作是不同的。静态分配在声明一个顺序表时,就已为其分配了数组空间,因此初始化时只需将顺序表的当前长度设为0。
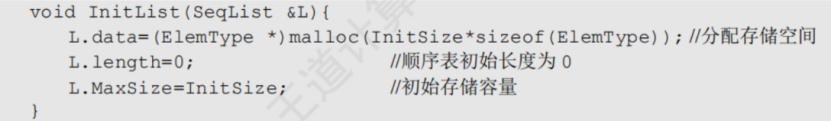
动态分配的初始化为顺序表分配一个预定义大小的数组空间,并将顺序表的当前长度设为0。MaxSize指示顺序表当前分配的存储空间大小,一旦因插入元素而空间不足,就进行再分配。
2.插入操作
在顺序表工的第i(1<=i<=L.length+1)个位置插入新元素e。若i的输入不合法,则返回false,表示插入失败;否则,将第i个元素及其后的所有元素依次往后移动一个位置,腾出一个空位置插入新元素e,顺序表长度增加1,插入成功,返回true。
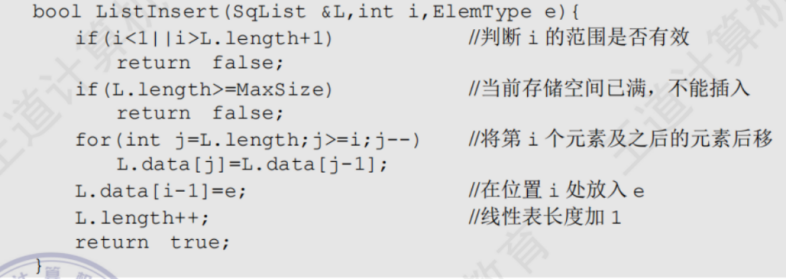
注意:区别顺序表的位序和数组下标。为何判断插入位置是否合法时if语句中用length+1,而移动元素的for语句中只用length?
最好情况:在表尾插入(i=n+1),元素后移语句将不执行,时间复杂度为0(1)。最好时间复杂度=O(1)
最坏情况:在表头插入(i=1),元素后移语句将执行n次,时间复杂度为O(n)。最坏时间复杂度=O(n)
平均情况:假设pi(p₁=1/(n+1))是在第i个位置上插入一个结点的概率,则在长度为n的线性表中插入一个结点时,所需移动结点的平均次数为
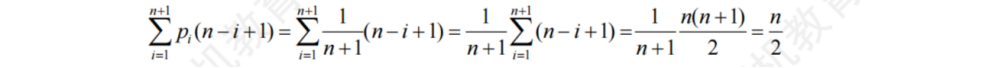
因此,顺序表插入算法的平均时间复杂度为0(n)。平均时间复杂度=O(n)
3.删除操作
删除顺序表工中第i(1<=i<=L.length)个位置的元素,用引用变量e返回。若i的输入不合法,则返回false;否则,将被删元素赋给引用变量e,并将第i+1个元素及其后的所有元素依次往前移动一个位置,返回true。
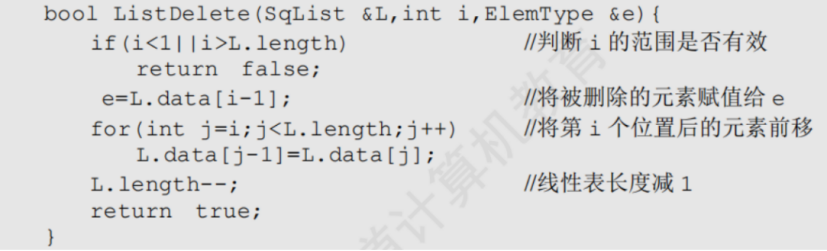
最好情况:删除表尾元素(i=n),无须移动元素,时间复杂度为0(1)。最好时间复杂度=O(1)
最坏情况:删除表头元素(i=1),需移动除表头元素外的所有元素,时间复杂度为O(n)。最坏时间复杂度=O(n)
平均情况:假设pi(p₁=1/n)是删除第i个位置上结点的概率,则在长度为n的线性表中删除一个结点时,所需移动结点的平均次数为
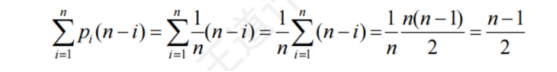
因此,顺序表删除算法的平均时间复杂度为0(n)。
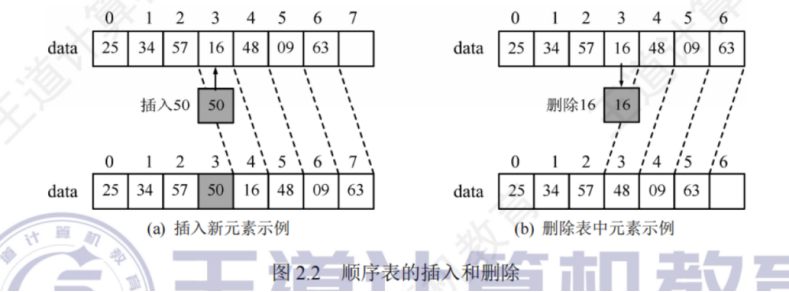
可见,顺序表中插入和删除操作的时间主要耗费在移动元素上,而移动元素的个数取决于插入和删除元素的位置。图2.2所示为一个顺序表在进行插入和删除操作前、后的状态,以及其数据元素在存储空间中的位置变化和表长变化。在图2.2(a)中,将第4个至第7个元素从后往前依次后移一个位置,在图2.2(b)中,将第5个至第7个元素从前往后依次前移一个位置。
4.按值查找(顺序查找)
在顺序表工中查找第一个元素值等于e的元素,并返回其位序。
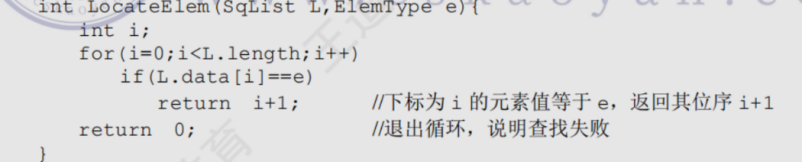
最好情况:查找的元素就在表头,仅需比较一次,时间复杂度为0(1)。最好时间复杂度=O(1)
最坏情况:查找的元素在表尾(或不存在)时,需要比较n次,时间复杂度为O(n)。最坏时间复杂度=O(n)
平均情况:假设p(p=1/n)是查找的元素在第i(1<=i<=L.length)个位置上的概率,
则在长度为n的线性表中查找值为e的元素所需比较的平均次数为
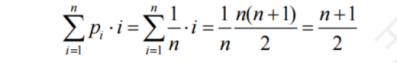
因此,顺序表按值查找算法的平均时间复杂度为0(n)。
顺序表的按序号查找非常简单,即直接根据数组下标访问数组元素,其时间复杂度为0(1)。
2.3线性表的链式表示
顺序表的存储位置可以用一个简单直观的公式表示,它可以随机存取表中任一元素,但插入和删除操作需要移动大量元素。链式存储线性表时,不需要使用地址连续的存储单元,即不要求逻辑上相邻的元素在物理位置上也相邻,它通过“链”建立元素之间的逻辑关系,因此插入和删除操作不需要移动元素,而只需修改指针,但也会失去顺序表可随机存取的优点。
2.3.1单链表的定义
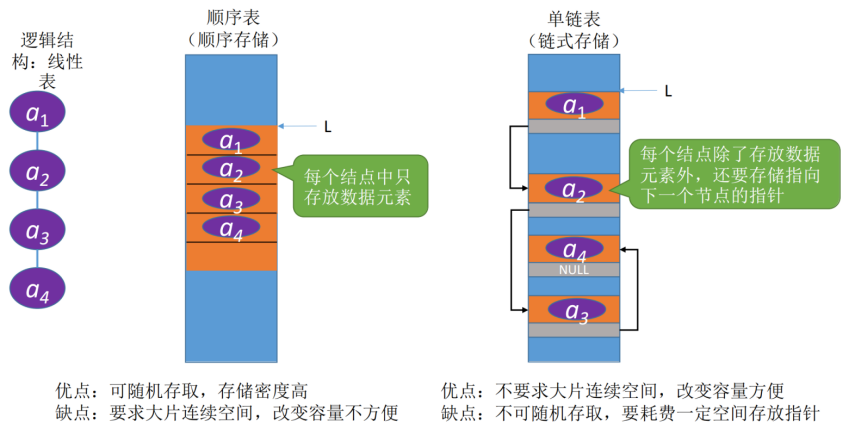
单链表的应用:
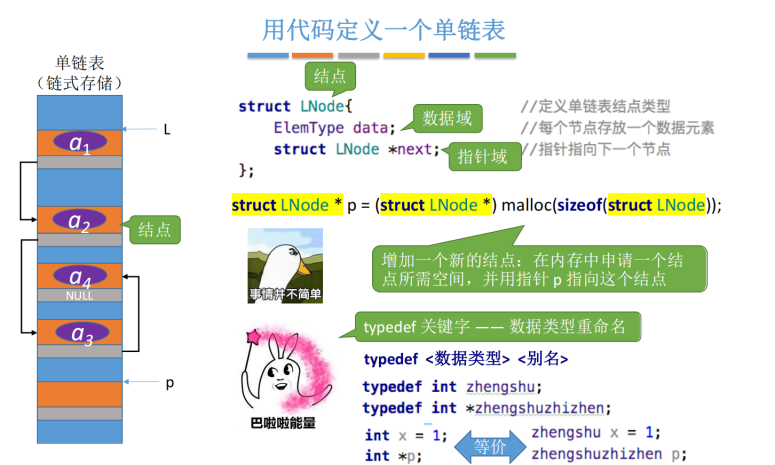
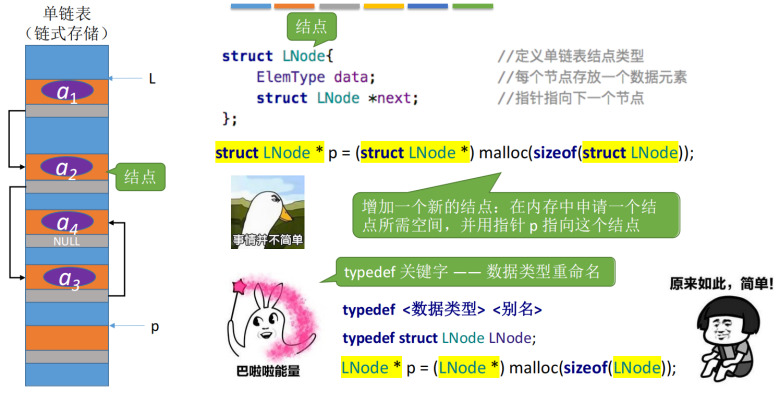
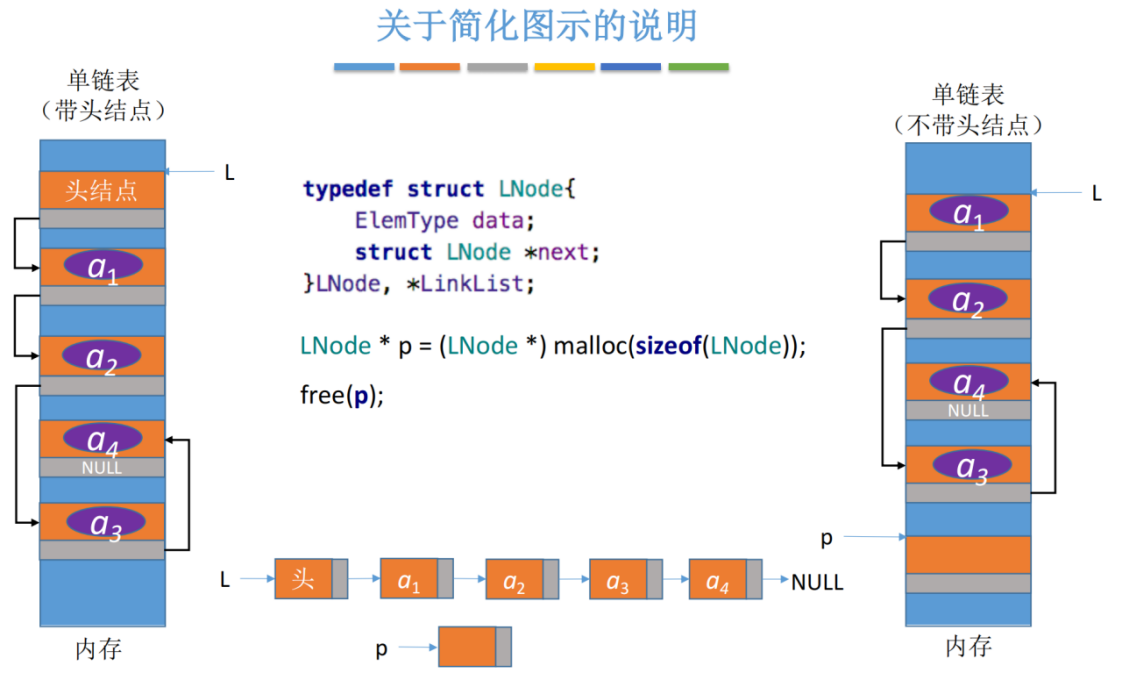
线性表的链式存储也称单链表,它是指通过一组任意的存储单元来存储线性表中的数据元素。为了建立数据元素之间的线性关系,对每个链表结点,除存放元素自身的信息外,还需要存放一个指向其后继的指针。单链表结点结构如图2.3所示,其中data为数据域,存放数据元素;next为指针域,存放其后继结点的地址。
| data | next |
图2.3单链表结点结构
优点:不要求大片连续空间,改变容量方便。
缺点:不可随机存取,要耗费一定空间存放指针。
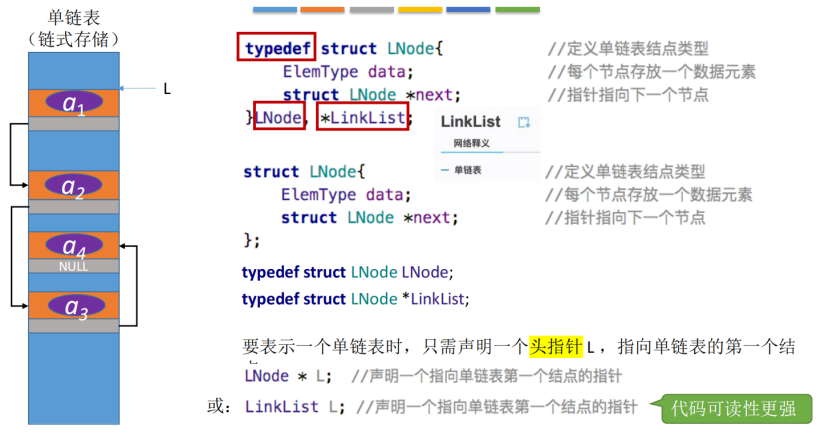
单链表中结点类型的描述如下:
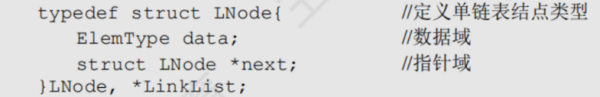
利用单链表可以解决顺序表需要大量连续存储单元的缺点,但附加的指针域,也存在浪费存储空间的缺点。单链表的元素离散地分布在存储空间中,因此是非随机存取的存储结构,即不能直接找到表中某个特定结点。查找特定结点时,需要从表头开始遍历,依次查找。
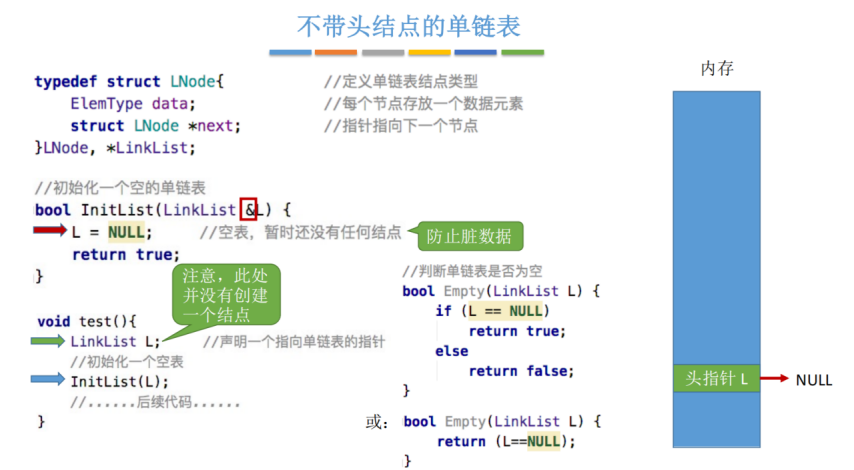
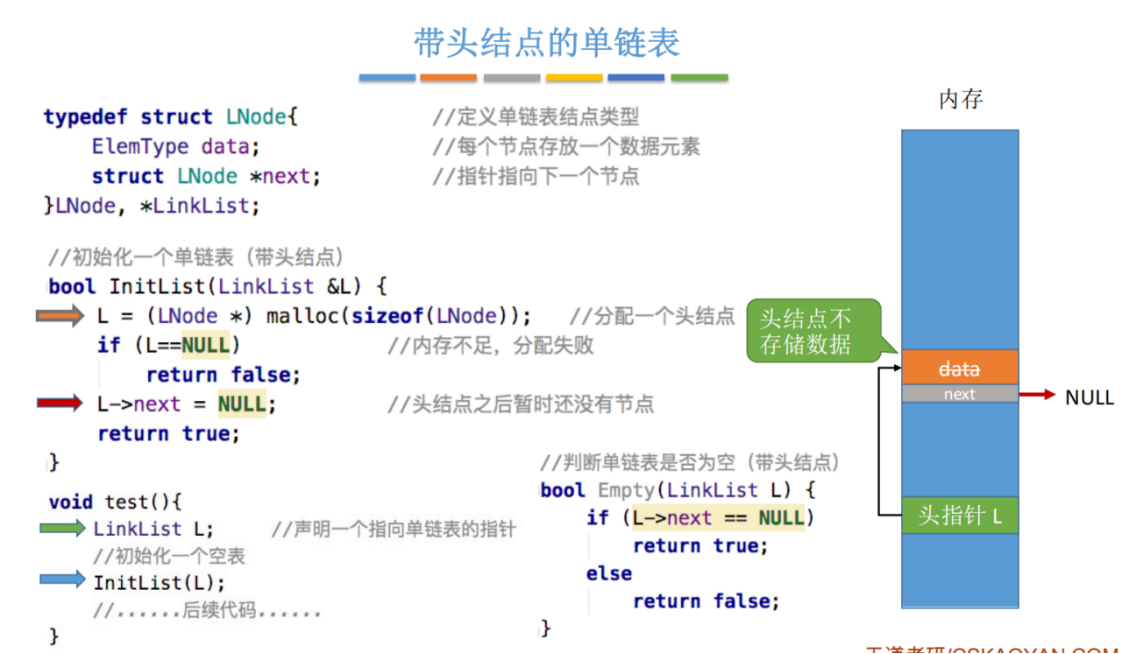
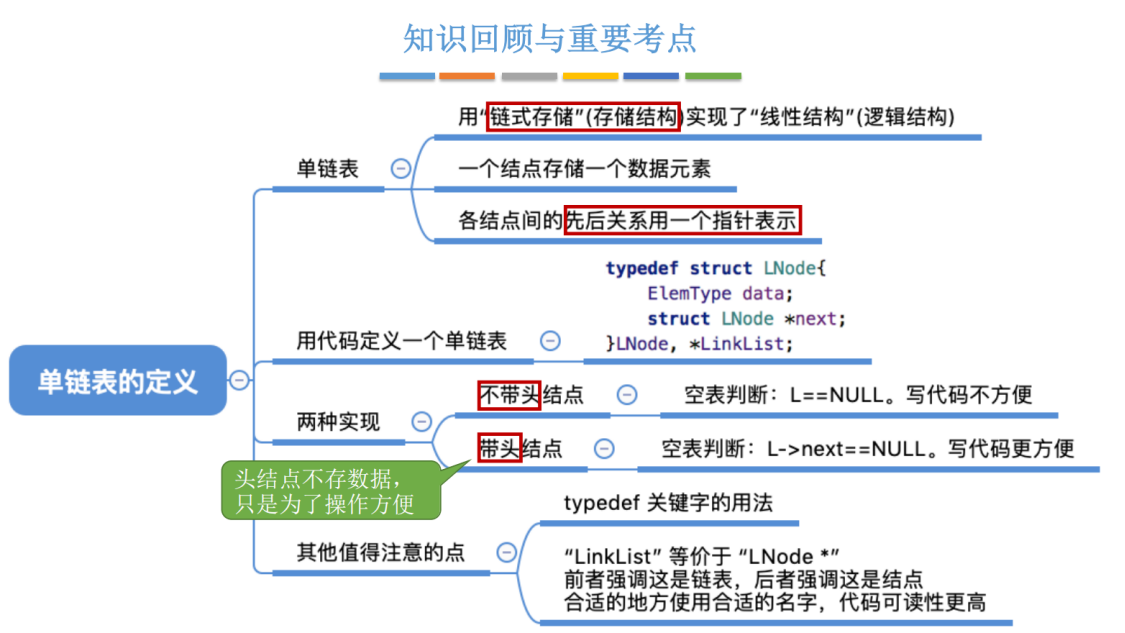
通常用头指针工(或head等)来标识一个单链表,指出链表的起始地址,头指针为NULL时表示一个空表。此外,为了操作上的方便,在单链表第一个数据结点之前附加一个结点,称为头结点。头结点的数据域可以不设任何信息,但也可以记录表长等信息。单链表带头结点时,头指针工指向头结点,如图2.4(a)所示。单链表不带头结点时,头指针工指向第一个数据结点,如图2.4(b)所示。表尾结点的指针域为NULL(用“^”表示)。
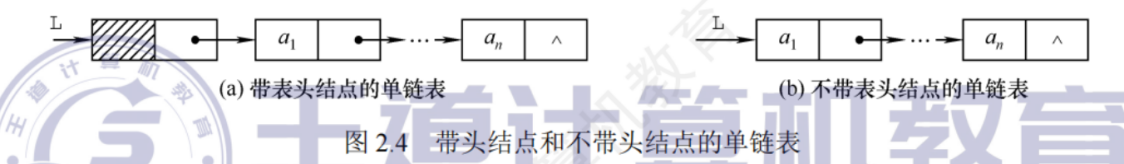
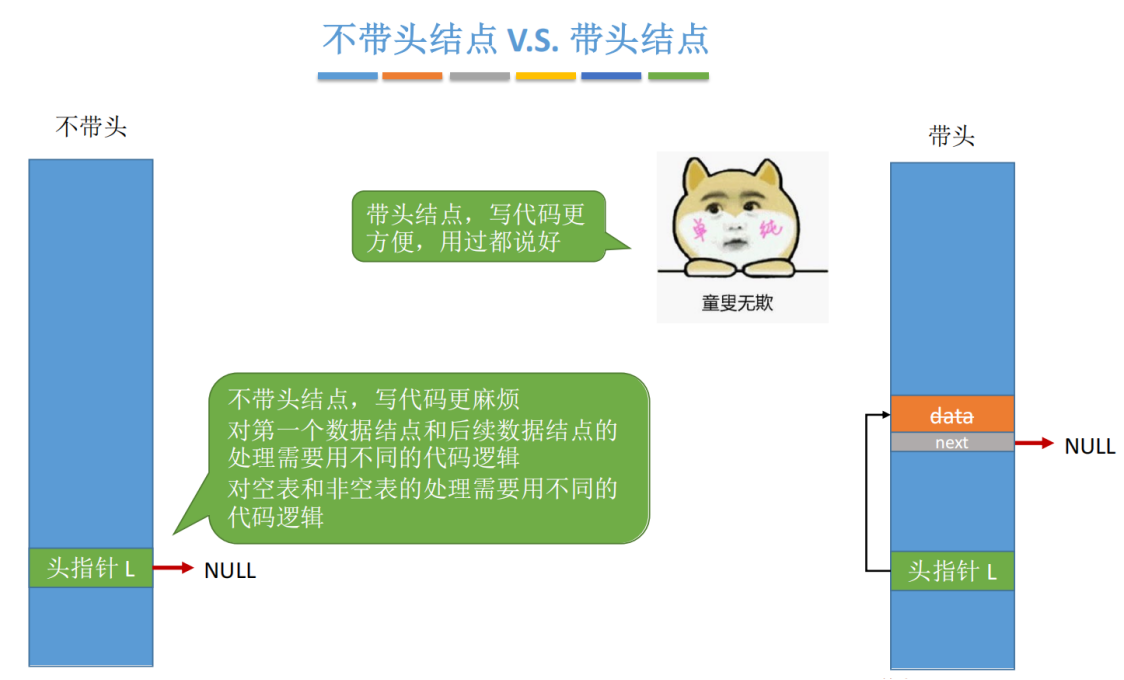
头结点和头指针的关系:不管带不带头结点,头指针都始终指向链表的第一个结点,而头结点是带头结点的链表中的第一个结点,结点内通常不存储信息。
引入头结点后,可以带来两个优点
①第一个数据结点的位置被存放在头结点的指针域中,因此在链表的第一个位置上的操作和在表的其他位置上的操作一致,无须进行特殊处理。
②无论链表是否为空,其头指针都是指向头结点的非空指针(空表中头结点的指针域为空),因此空表和非空表的处理也就得到了统一。
2.3.2单链表上基本操作的实现
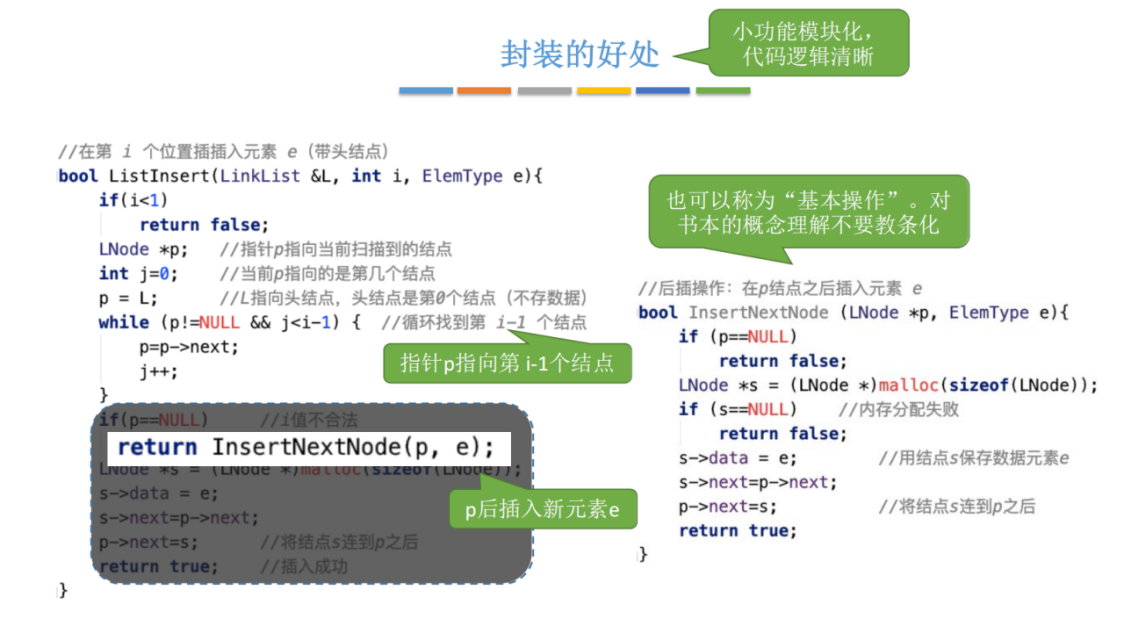
带头结点单链表的操作代码书写较为方便,如无特殊说明,本节均默认链表带头结点。
1.单链表的初始化
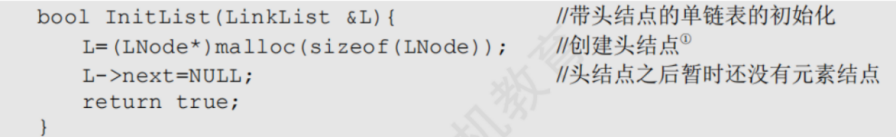
带头结点和不带头结点的单链表的初始化操作是不同的。带头结点的单链表初始化时,需要创建一个头结点,并让头指针指向头结点,头结点的next域初始化为NULL。
不带头结点的单链表初始化时,只需将头指针工初始化为NULL。


注:设p为指向链表结点的结构体指针,则*p表示结点本身,因此可用p->data或(*p).data访问*p这个结点的数据域,二者完全等价。成员运算符(.)左边是一个普通的结构体变量,而指向运算符(->)左边是一个结构体指针。通过(*p).next可以得到指向下一个结点的指针,因此(*(*p).next).data就是下一个结点中存放的数据,或者直接用p->next->data。
2.求表长操作
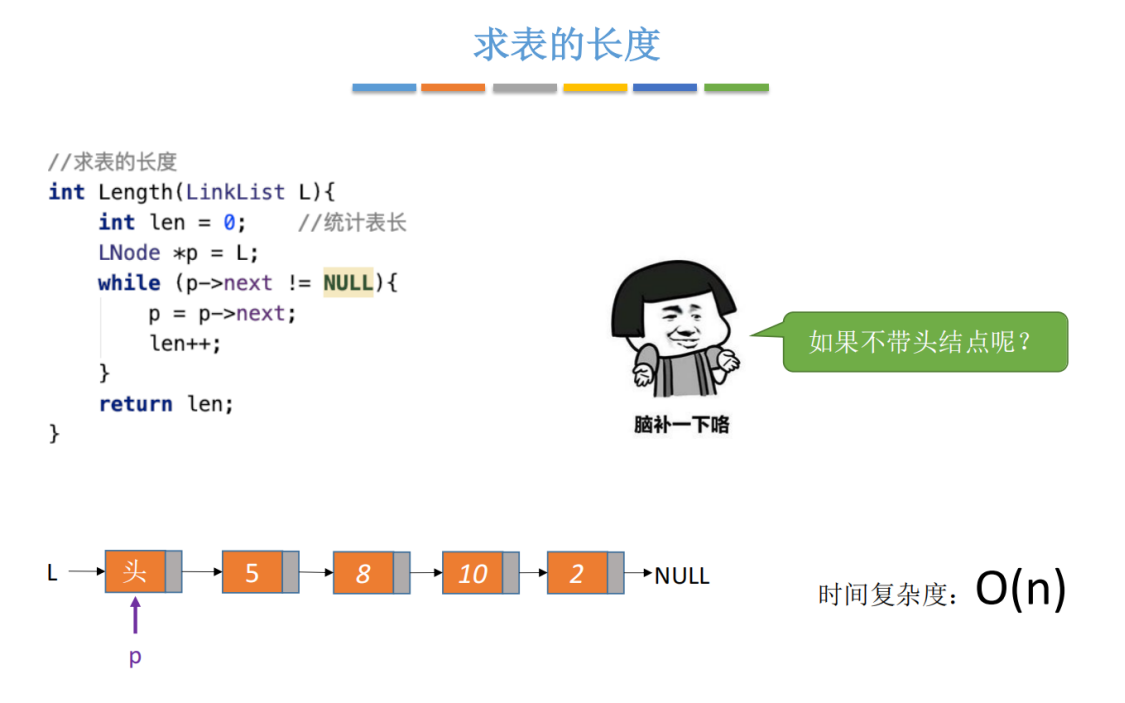
求表长操作是计算单链表中数据结点的个数,需要从第一个结点开始依次访问表中每个结点,为此需设置一个计数变量,每访问一个结点,其值加1,直到访问到空结点为止。
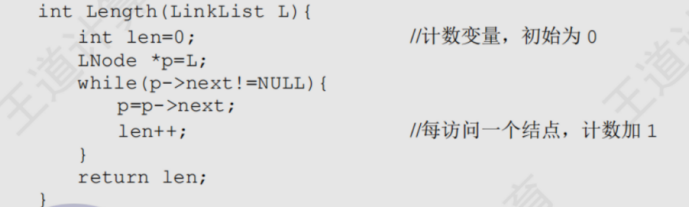
求表长操作的时间复杂度为O(n)。另需注意的是,因为单链表的长度是不包括头结点的,因此不带头结点和带头结点的单链表在求表长操作上会略有不同。
3.按序号查找结点
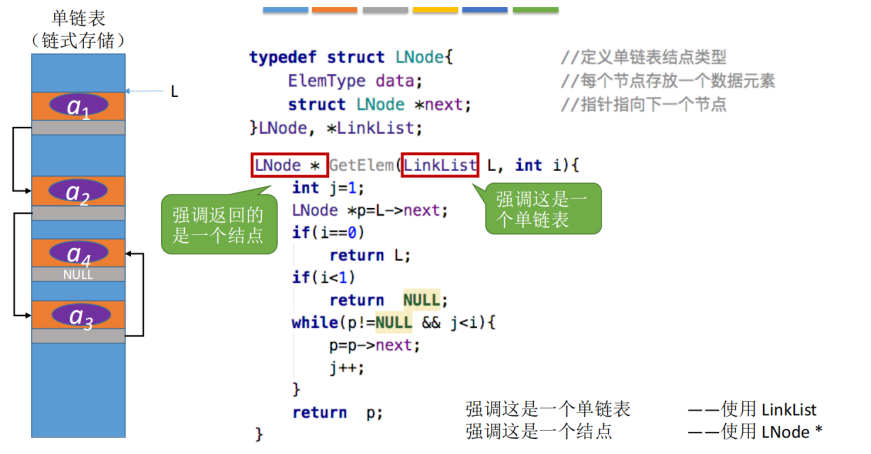
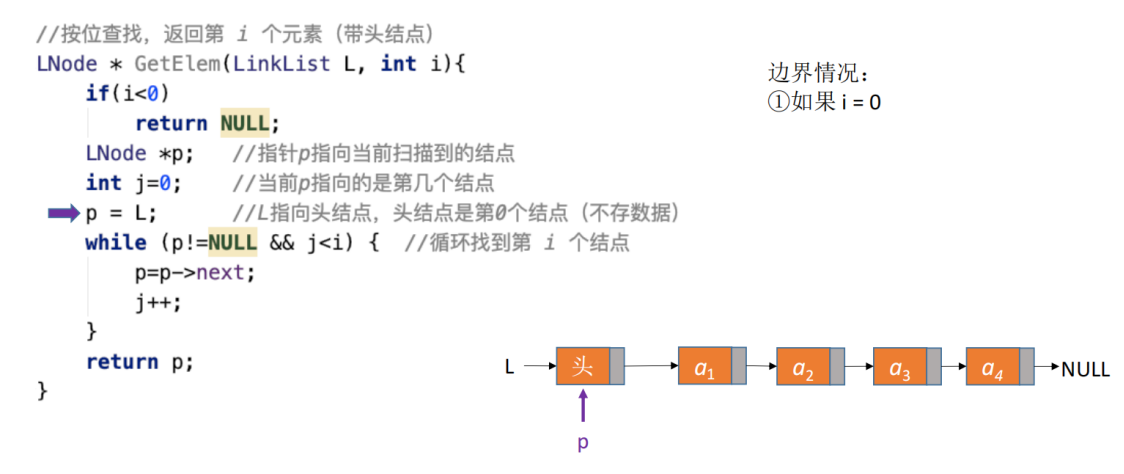
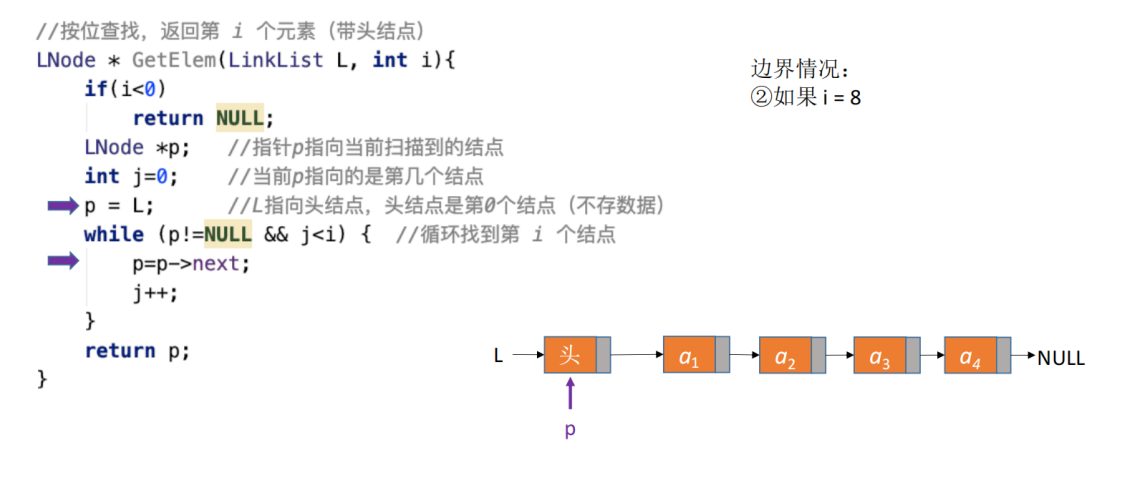
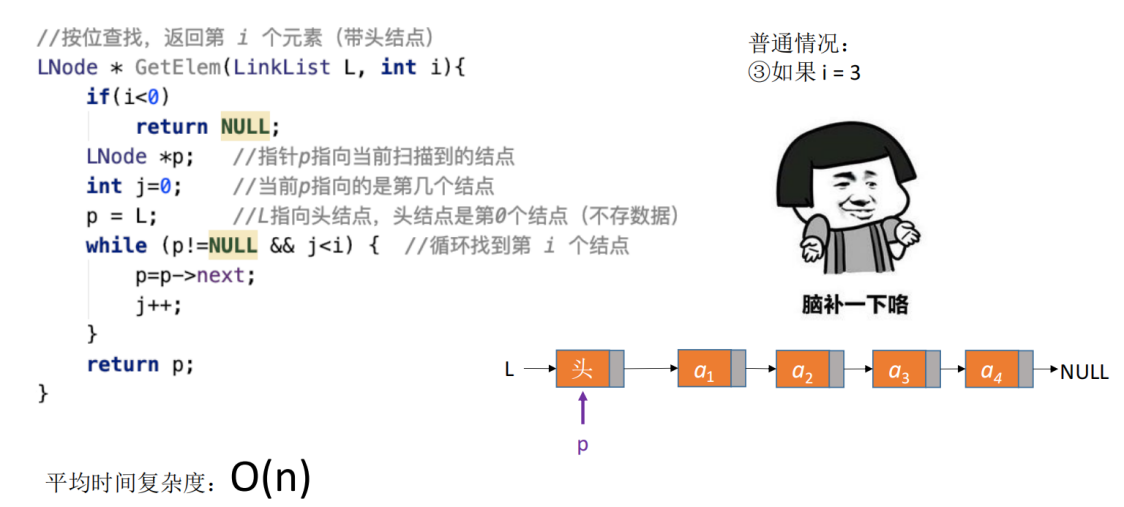
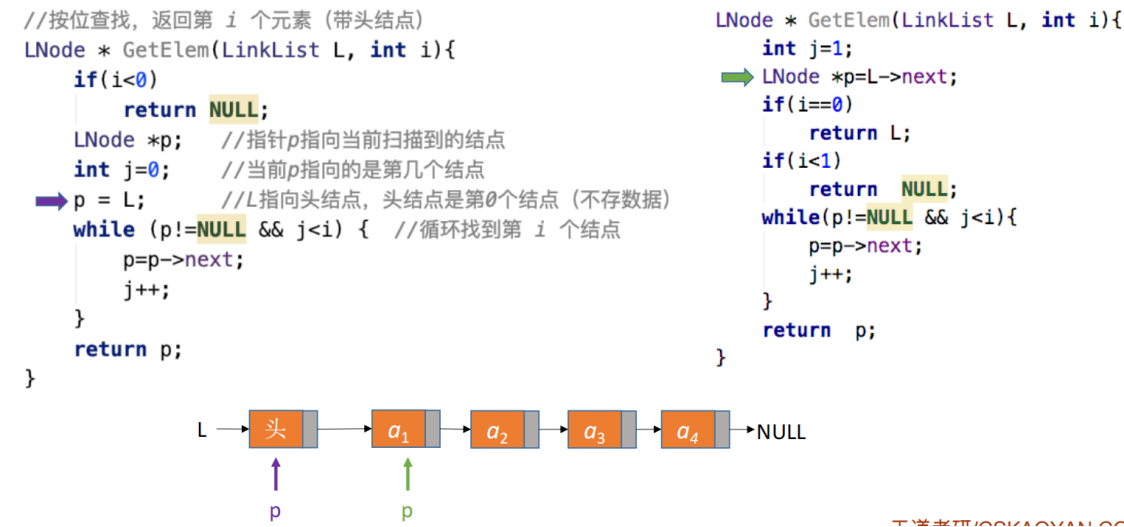
从单链表的第一个结点开始,沿着next域从前往后依次搜索,直到找到第i个结点为止,则返回该结点的指针;若i大于单链表的表长,则返回NULL。
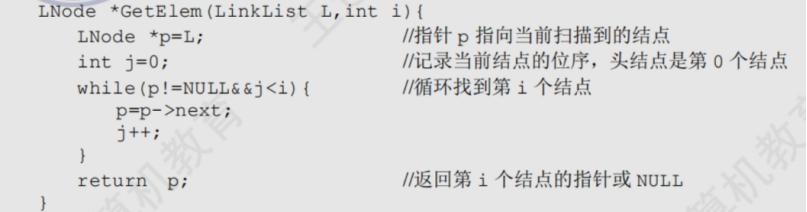
按序号查找操作的时间复杂度为0(n)。
4.按值查找表结点
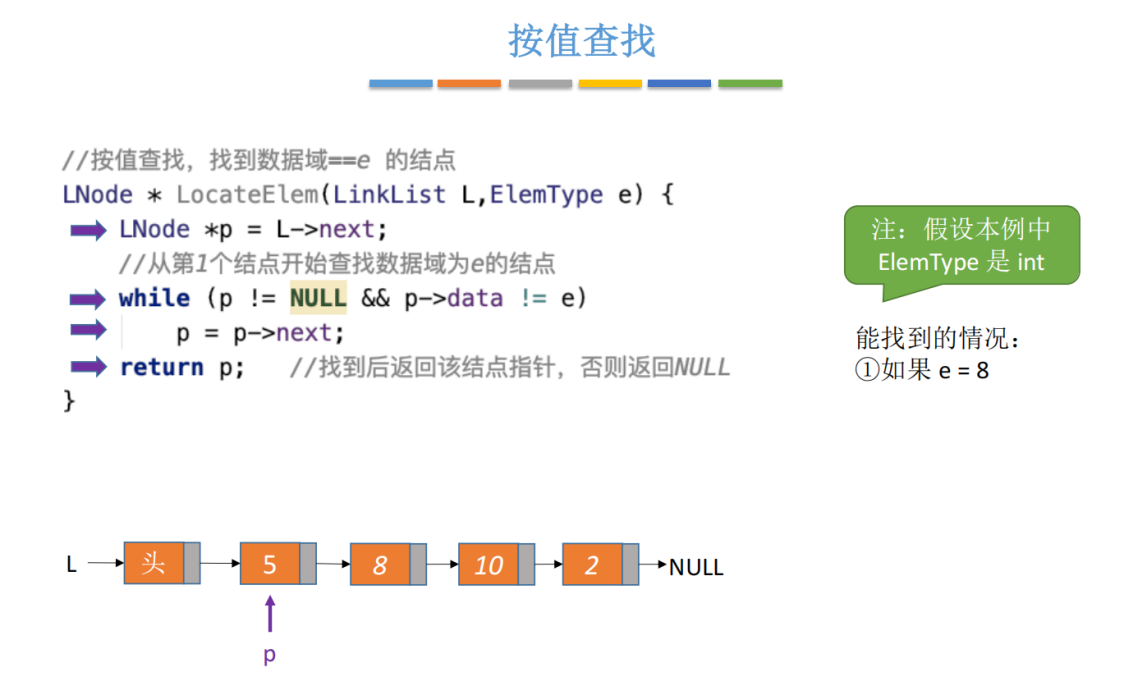
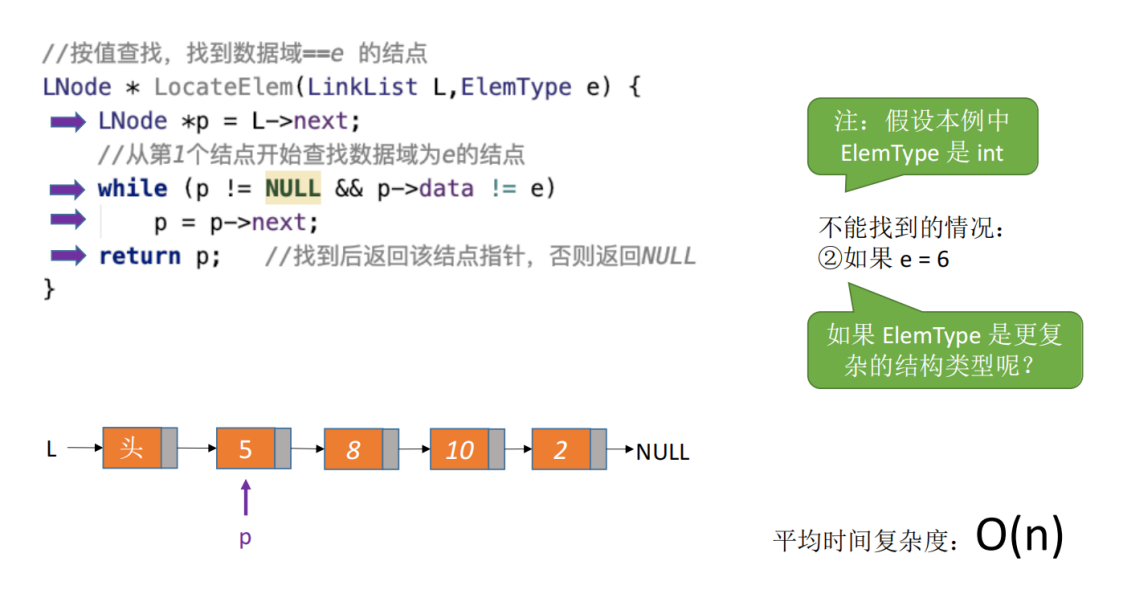
从单链表的第一个结点开始,从前往后依次比较表中各结点的数据域,若某结点的data域等于给定值e,则返回该结点的指针;若整个单链表中没有这样的结点,则返回NULL。
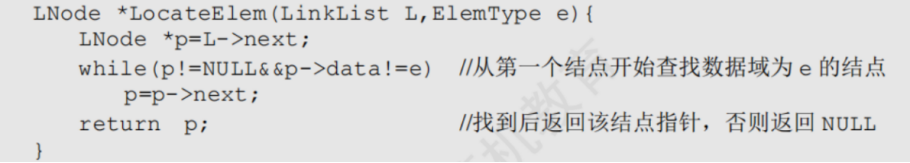
按值查找操作的时间复杂度为O(n)。
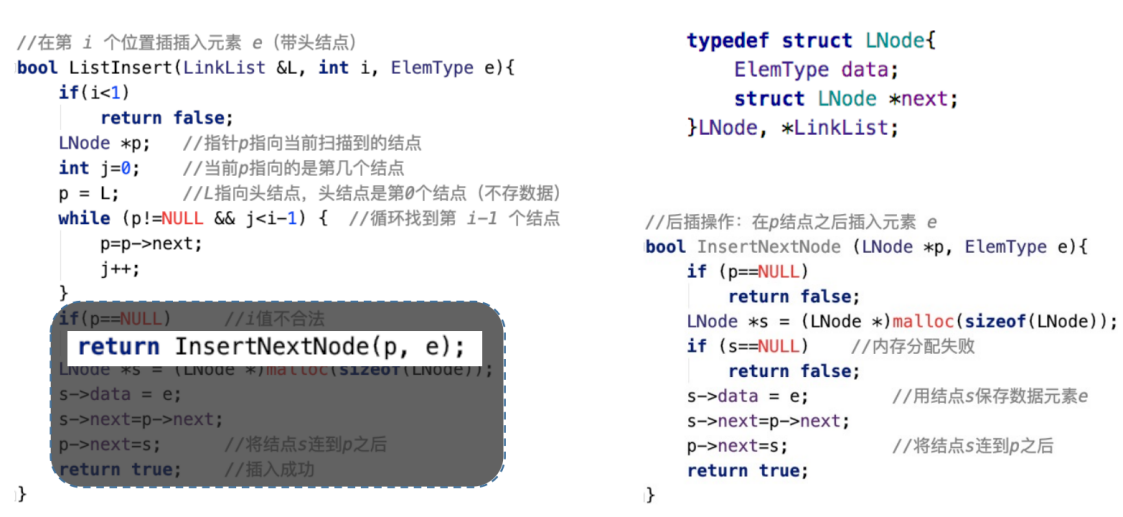
5.插入结点操作
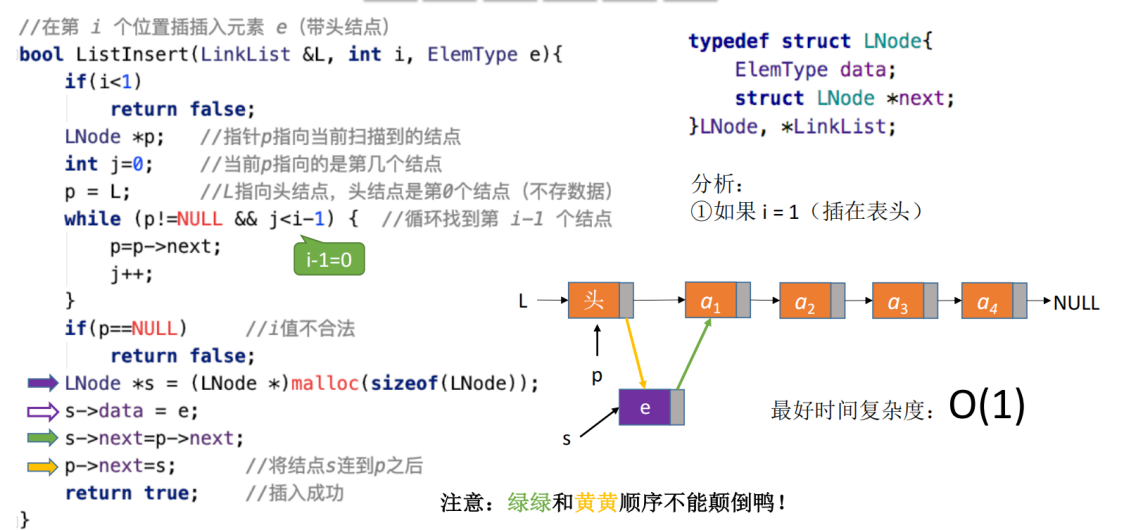
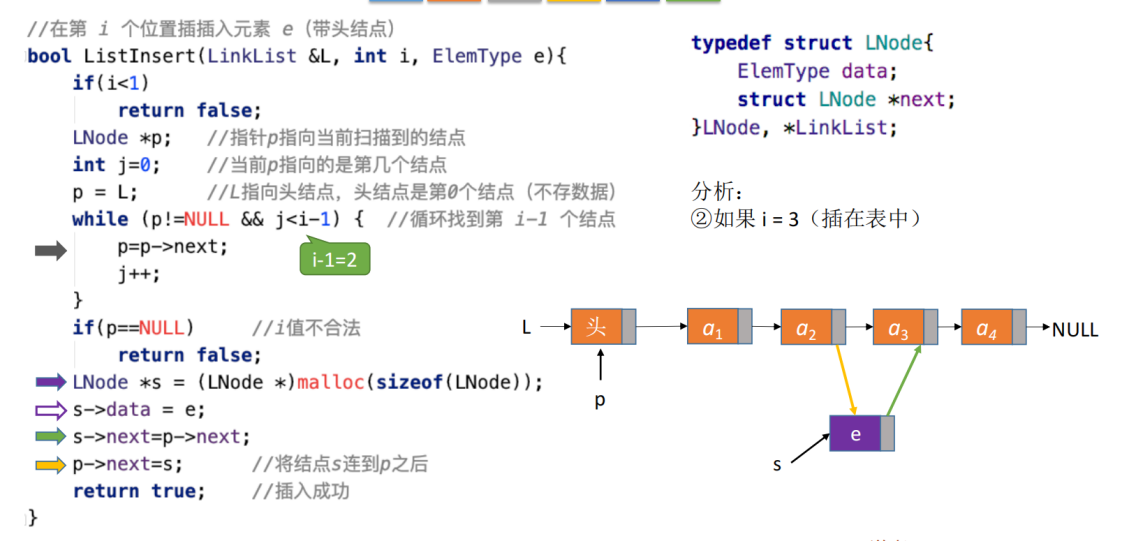
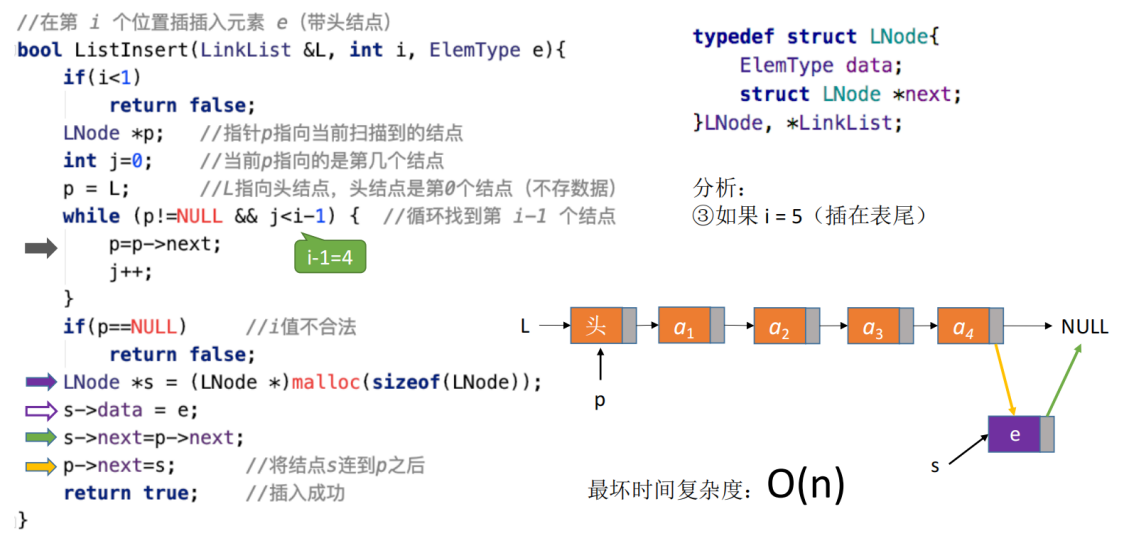
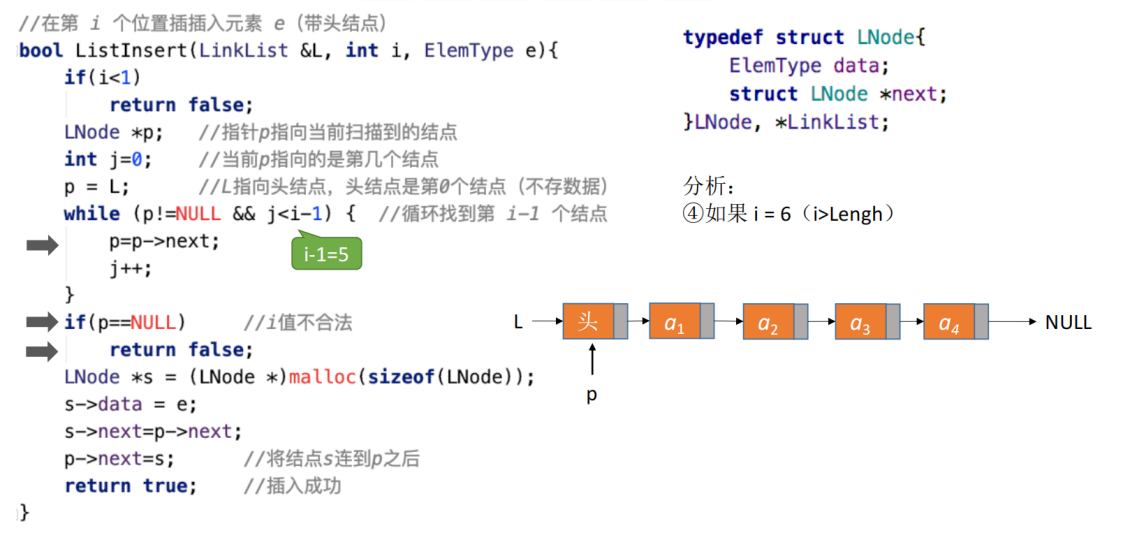
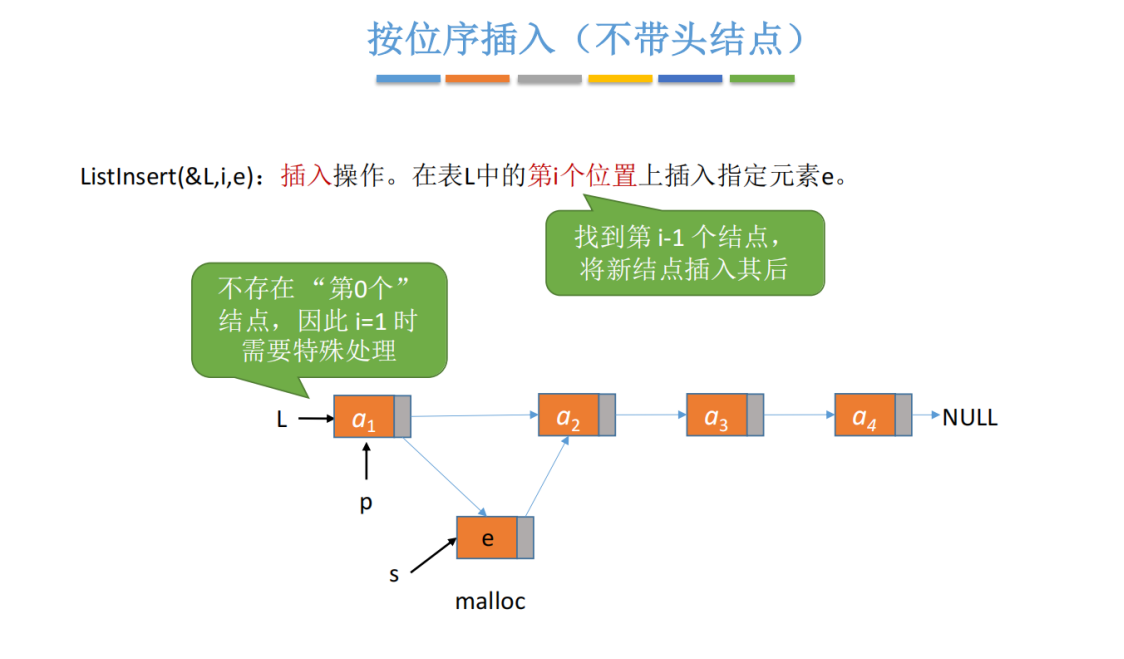
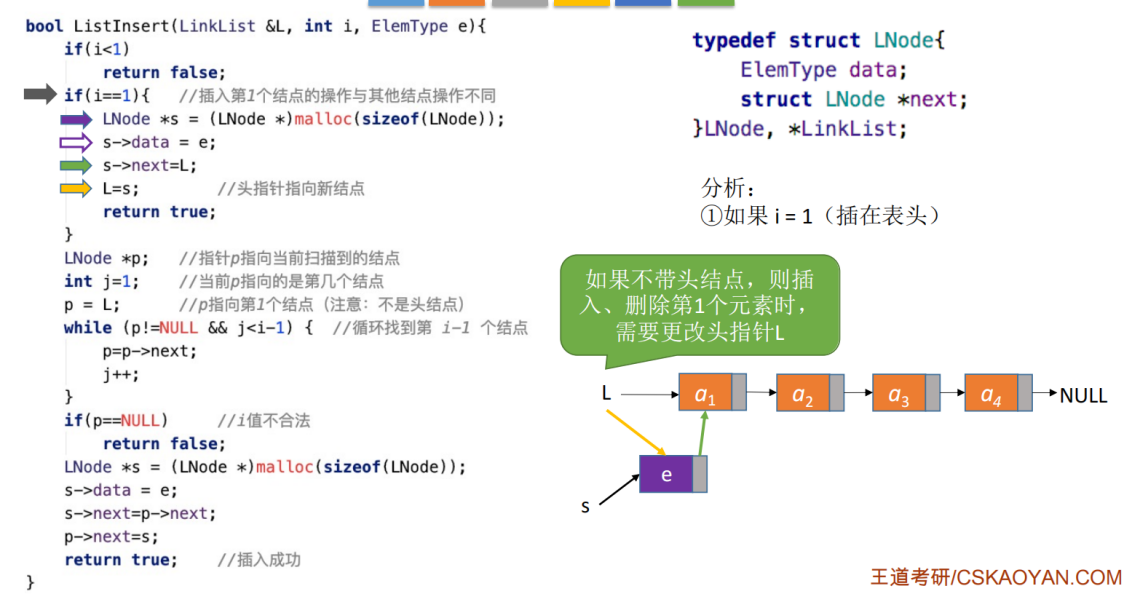
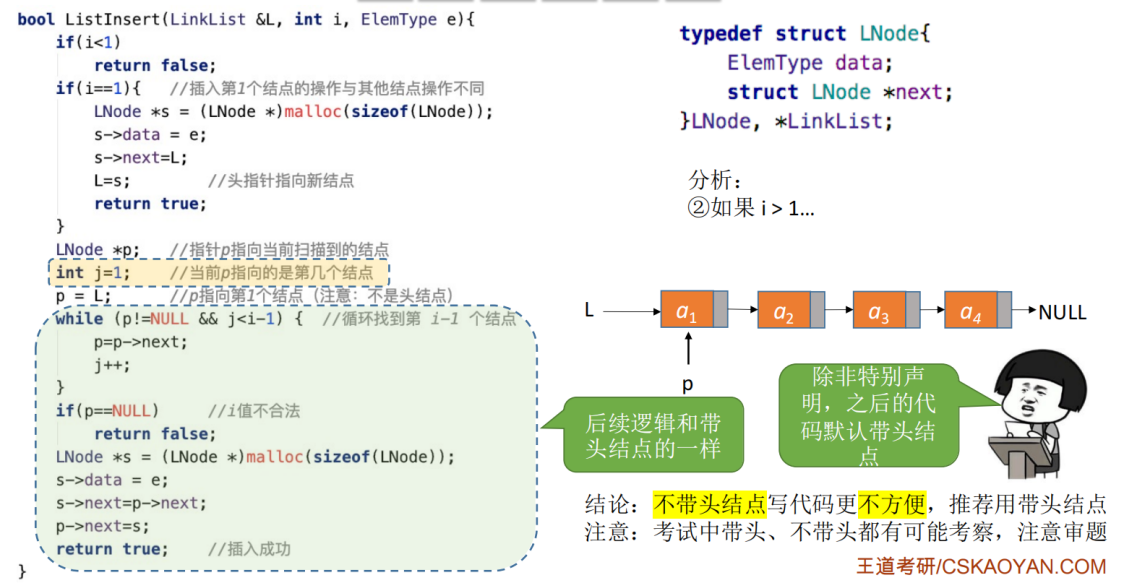
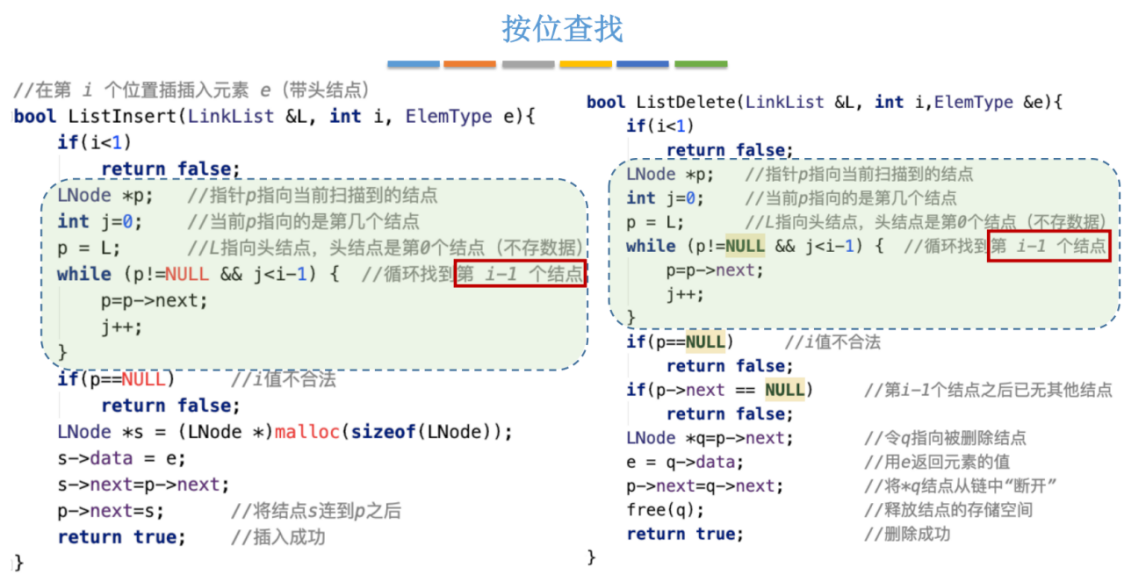
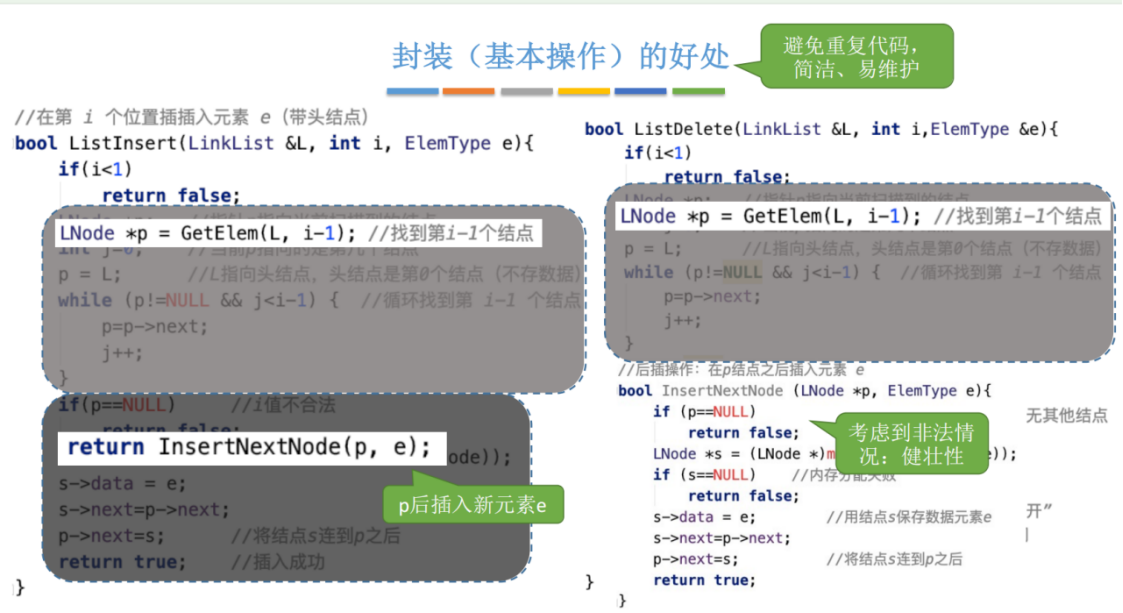
插入结点操作将值为x的新结点插入到单链表的第i个位置。先检查插入位置的合法性,然后找到待插入位置的前驱,即第i-1个结点,再在其后插入。其操作过程如图2.5所示。
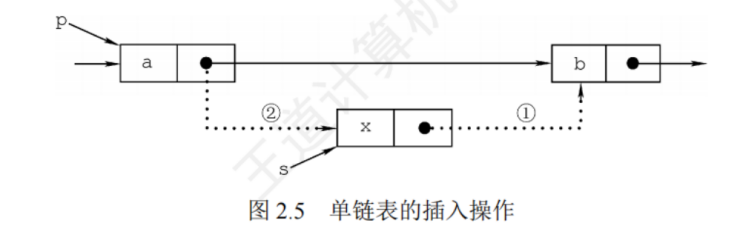
单链表插入操作的过程:
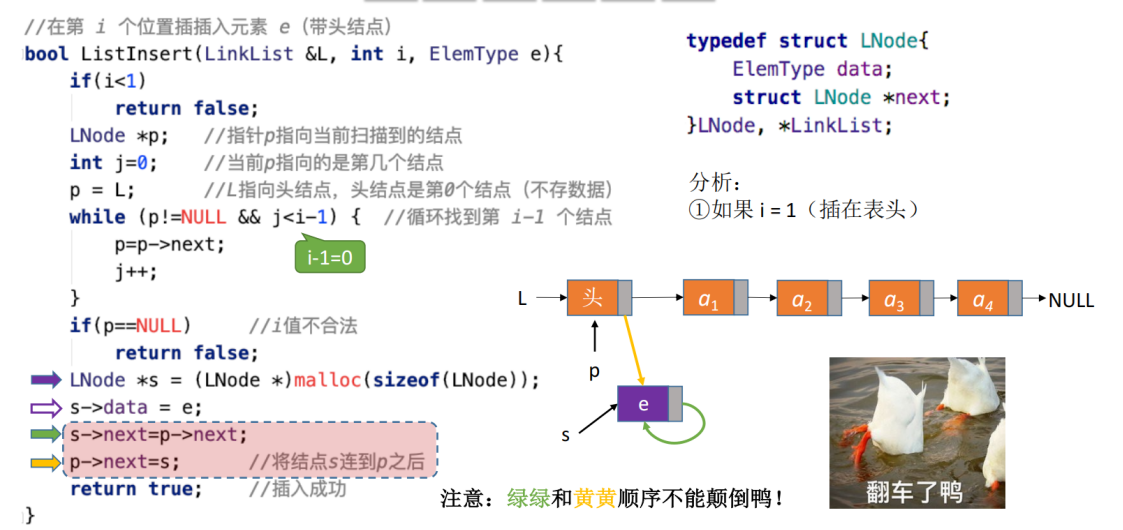
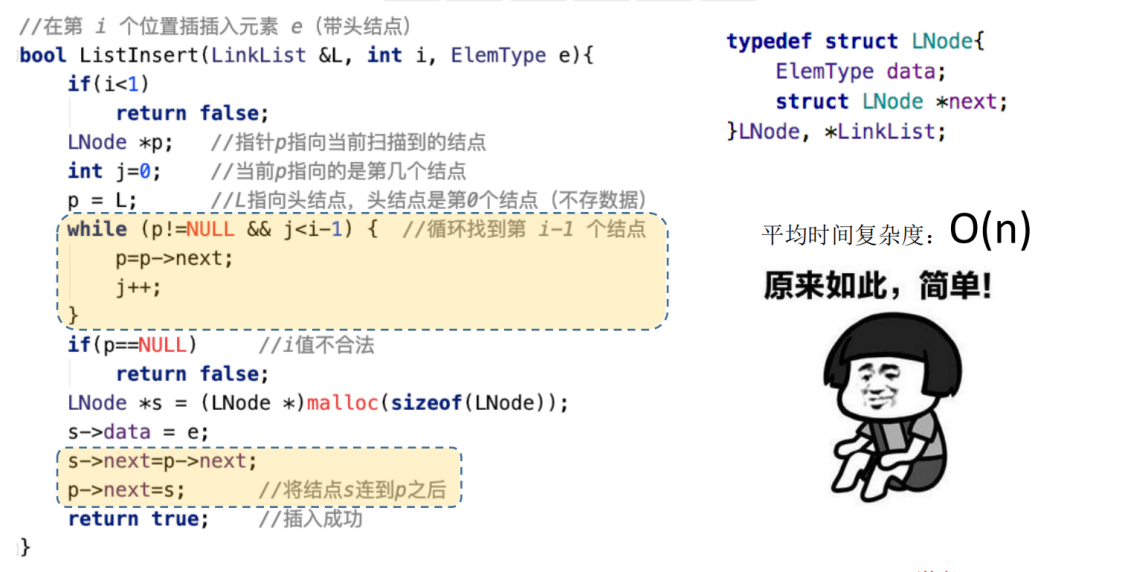
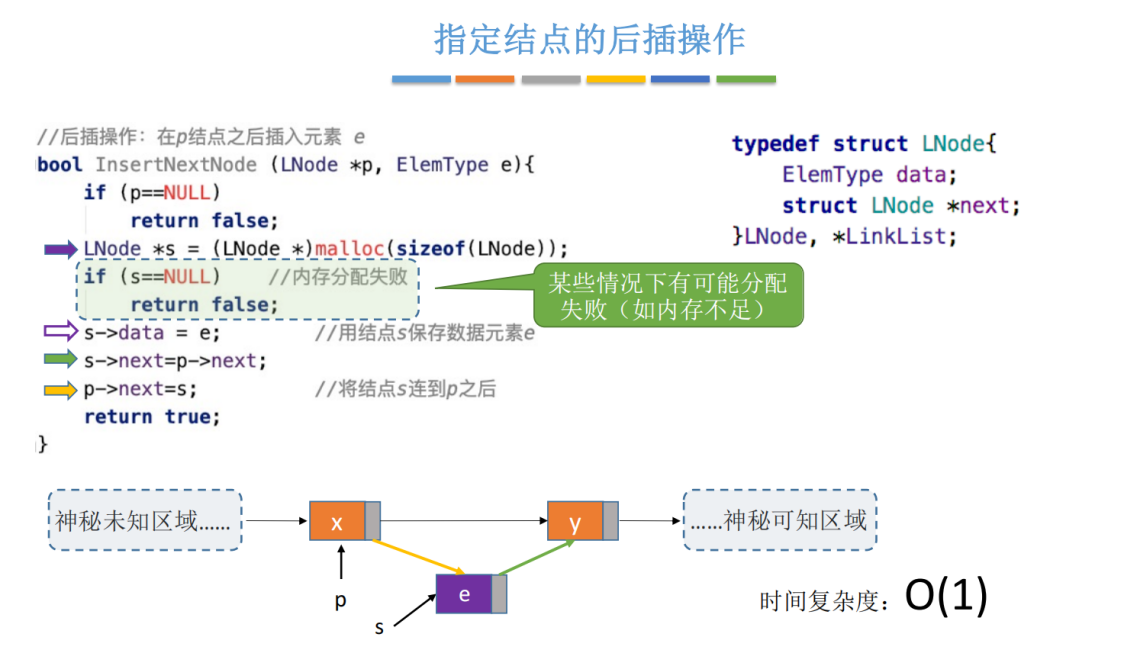
首先查找第i-1个结点,假设第i-1个结点为*p,然后令新结点*s的指针域指向*p的后继,再令结点*p的指针域指向新插入的结点*s。
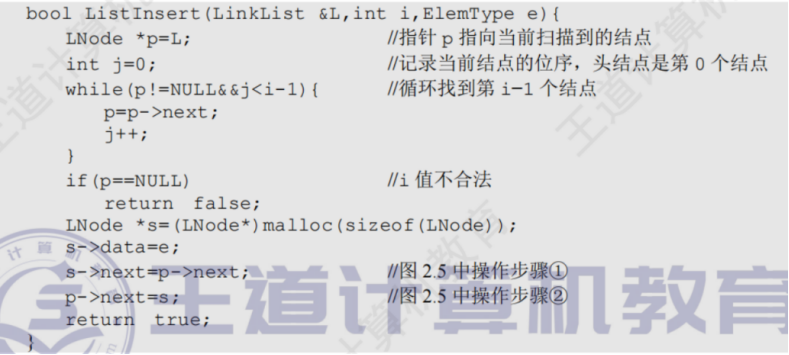
插入时,①和②的顺序不能颠倒,否则,先执行p->next=s后,指向其原后继的指针就不存在了,再执行s->next=p->next时,相当于执行了s->next=s,显然有误。本算法主要的时间开销在于查找第i-1个元素,时间复杂度为0(n)。若在指定结点后插入新结点,则时间复杂度仅为0(1)。需注意的是,当链表不带头结点时,需要判断插入位置i是否为1,若是,则要做特殊处理,将头指针工指向新的首结点。当链表带头结点时,插入位置i为1时不用做特殊处理。
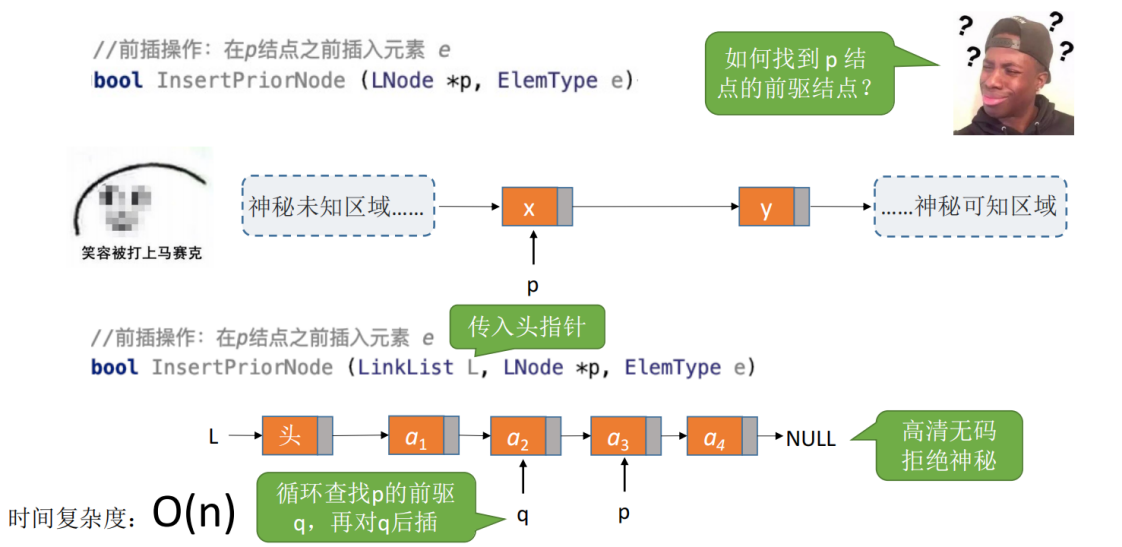
扩展:对某一结点进行前插操作。
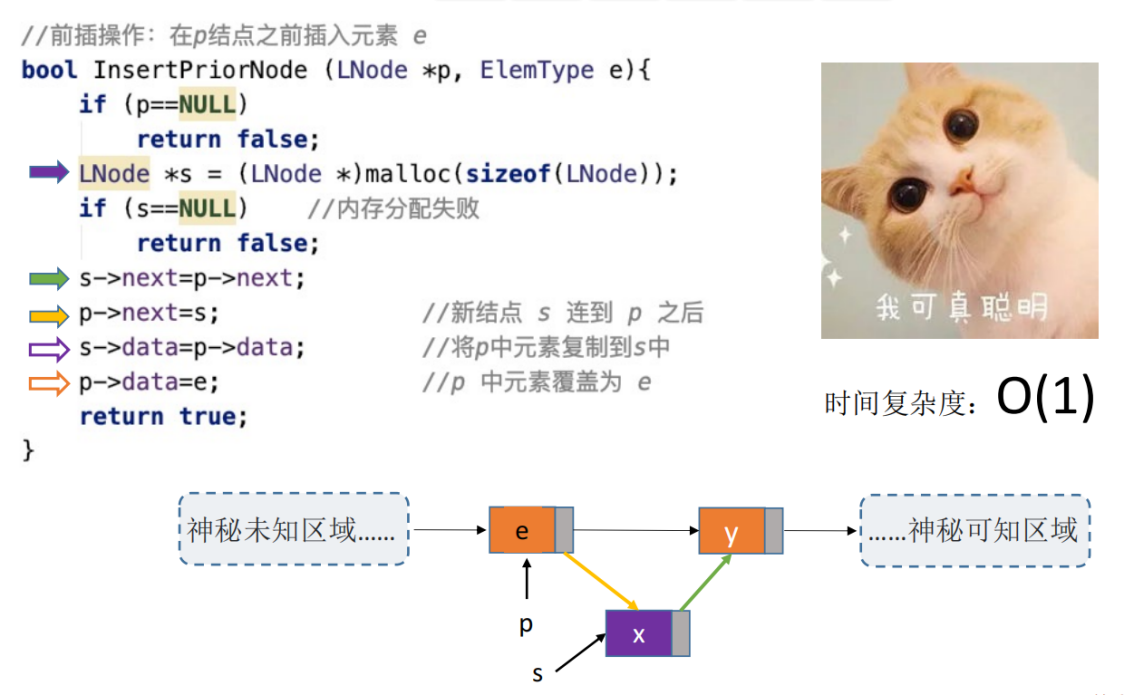
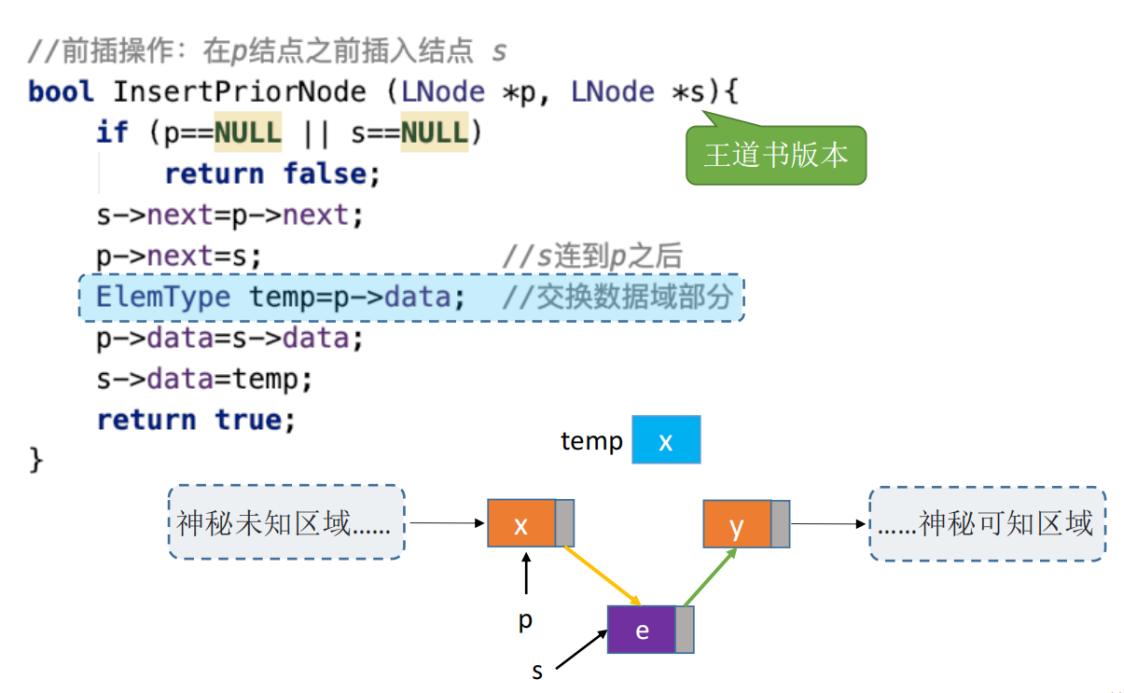
前插操作是指在某结点的前面插入一个新结点,后插操作的定义刚好与之相反。在单链表插入算法中,通常都采用后插操作。以上面的算法为例,先找到第i-1个结点,即插入结点的前驱,再对其执行后插操作。由此可知,对结点的前插操作均可转化为后插操作,前提是从单链表的头结点开始顺序查找到其前驱结点,时间复杂度为0(n)。
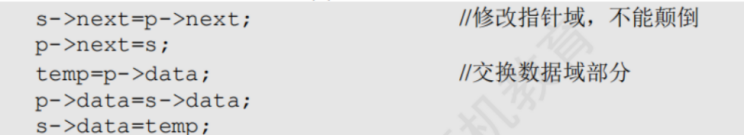
此外,可采用另一种方式将其转化为后插操作来实现,设待插入结点为*s,将*s插入到*p的前面。我们仍然将*s插入到*p的后面,然后将p->data与s->data交换,这样做既满足逻辑关系,又能使得时间复杂度为0(1)。该方法的主要代码片段如下:
6.删除结点操作
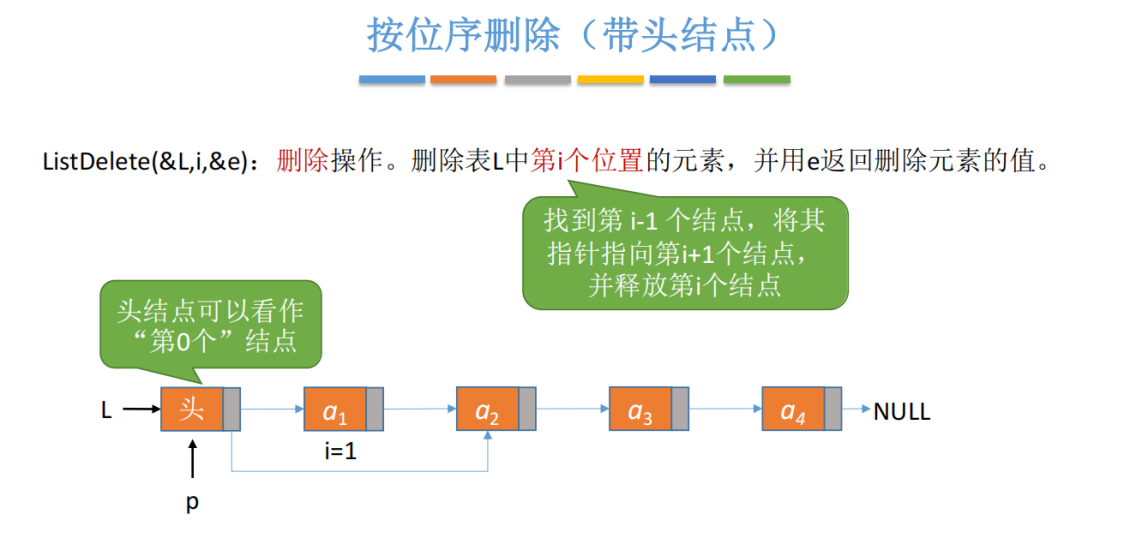
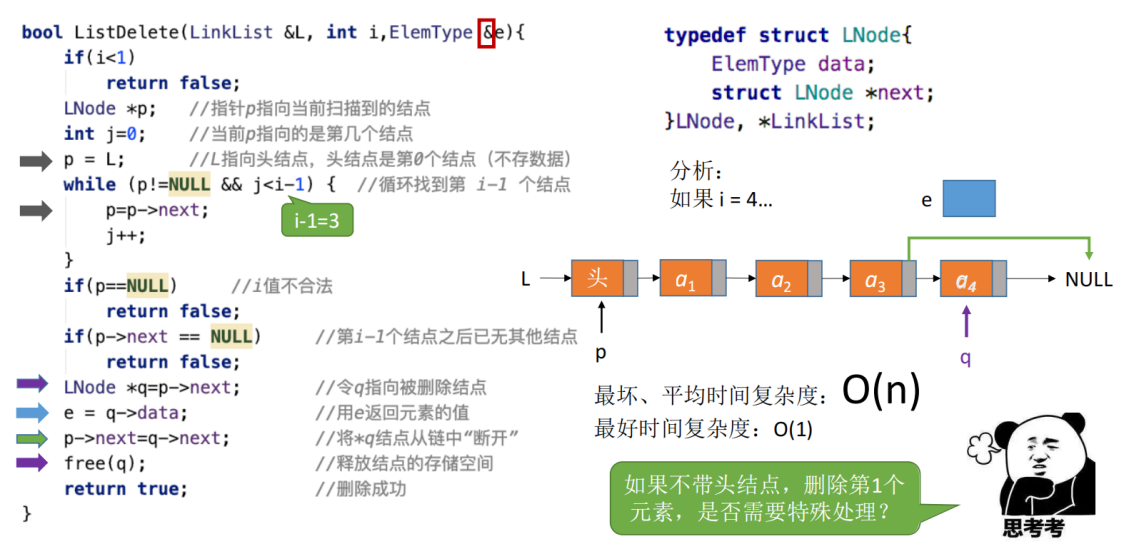
删除结点操作是将单链表的第i个结点删除。先检查删除位置的合法性,然后查找表中第i-1个结点,即被删结点的前驱,再删除第i个结点。其操作过程如图2.6所示。
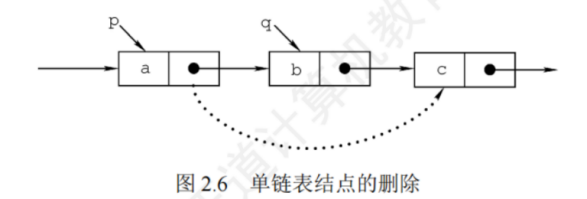
假设结点*p为找到的被删结点的前驱,为实现这一操作后的逻辑关系的变化,仅需修改*p的指针域,将*p的指针域next指向*q的下一结点,然后释放*q的存储空间。
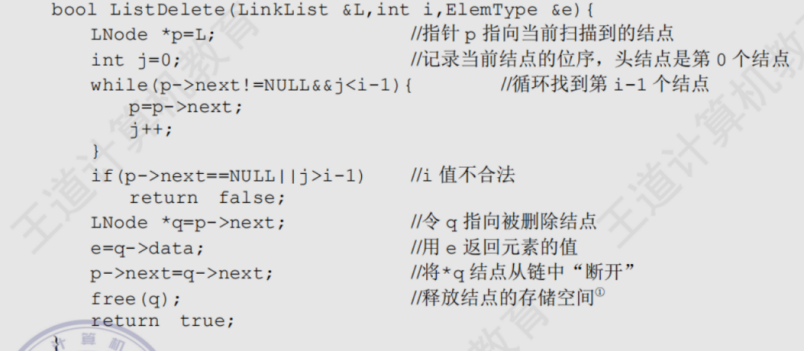
同插入算法一样,该算法的主要时间也耗费在查找操作土,时间复杂度为O(n)。当链表不带头结点时,需要判断被删结点是否为首结点,若是,则要做特殊处理,将头指钎工指向新的首结点。当链表带头结点时,删除首结点和删除其他结点的操作是相同的。
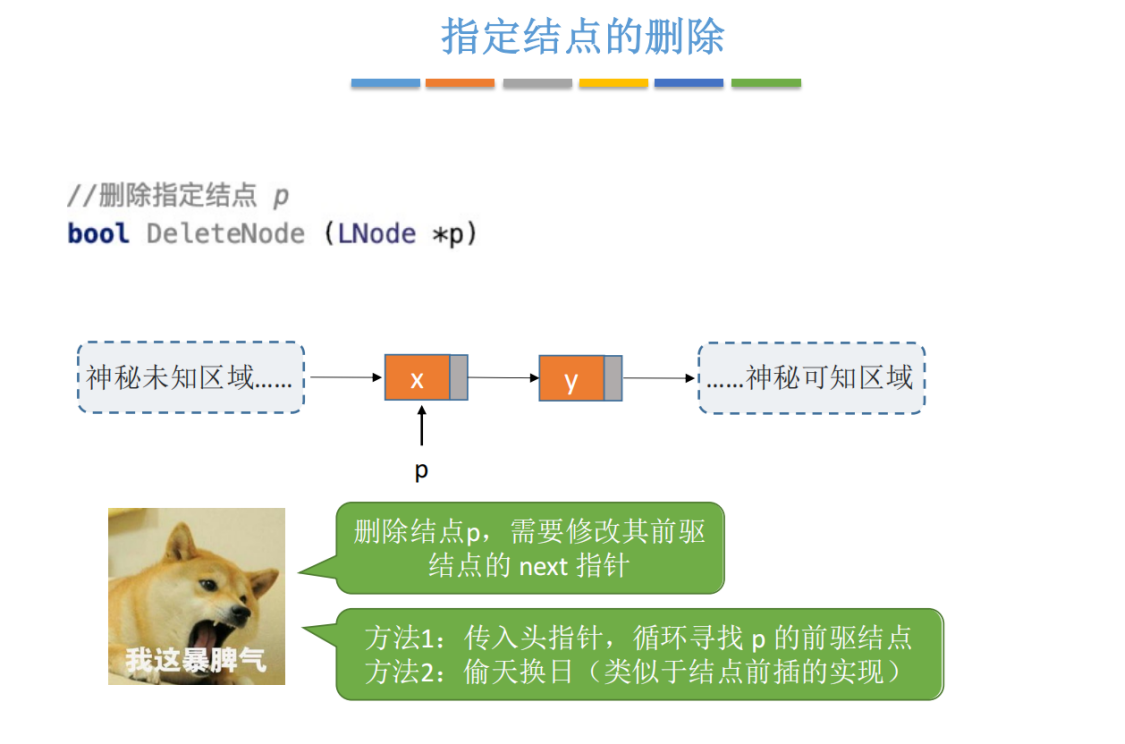
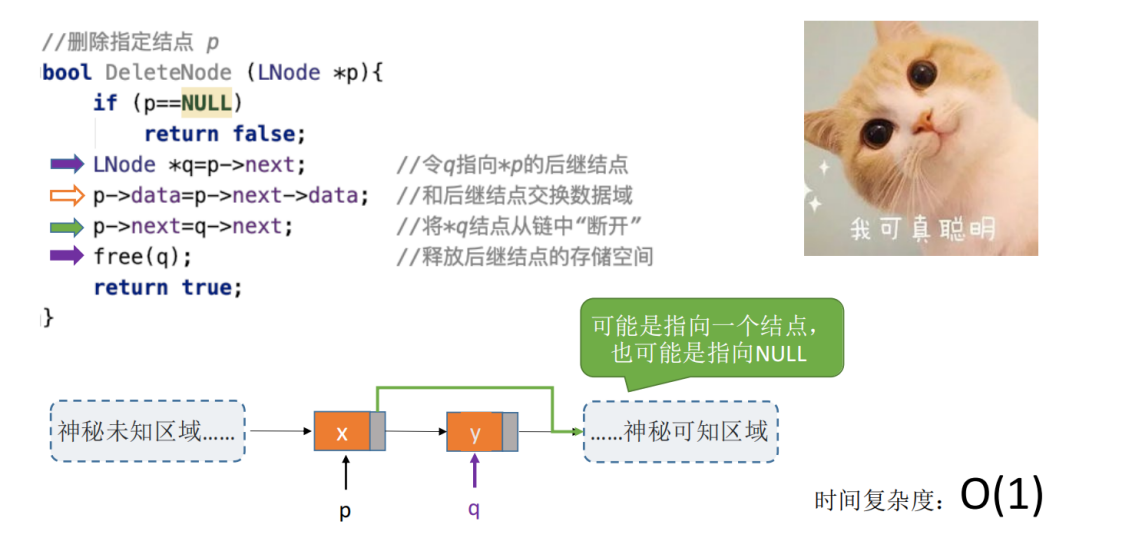
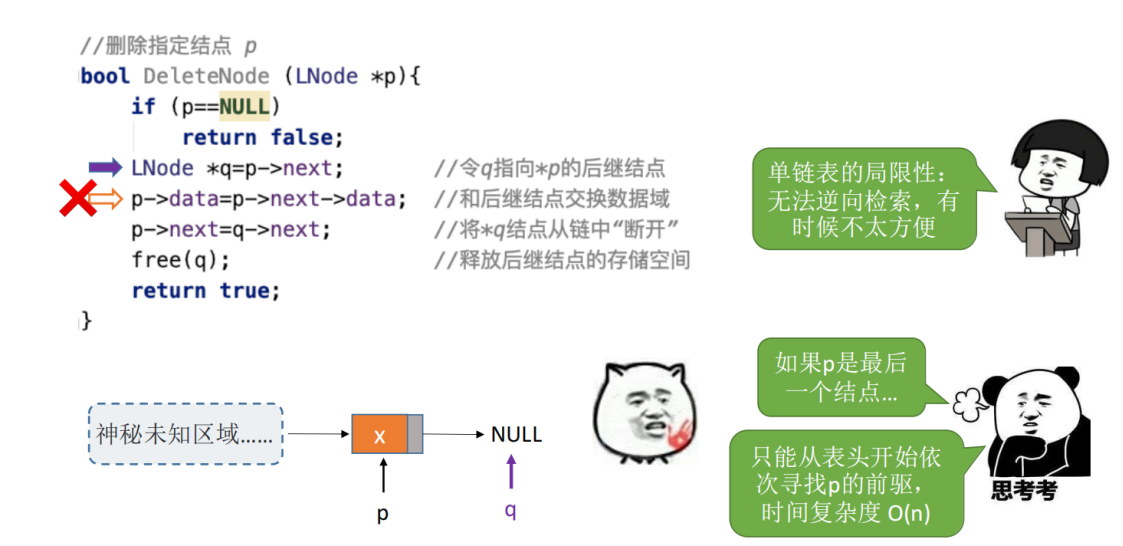
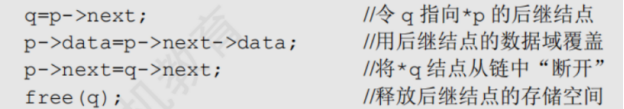
扩展:删除结点*p。
要删除某个给定结点*p,通常的做法是先从链表的头结点开始顺序找到其前驱,然后执行删除操作。其实,删除结点*p的操作可用删除*p的后继来实现,实质就是将其后继的值赋予其自身,然后再删除后继,也能使得时间复杂度为O(1)。该方法的主要代码片段如下:
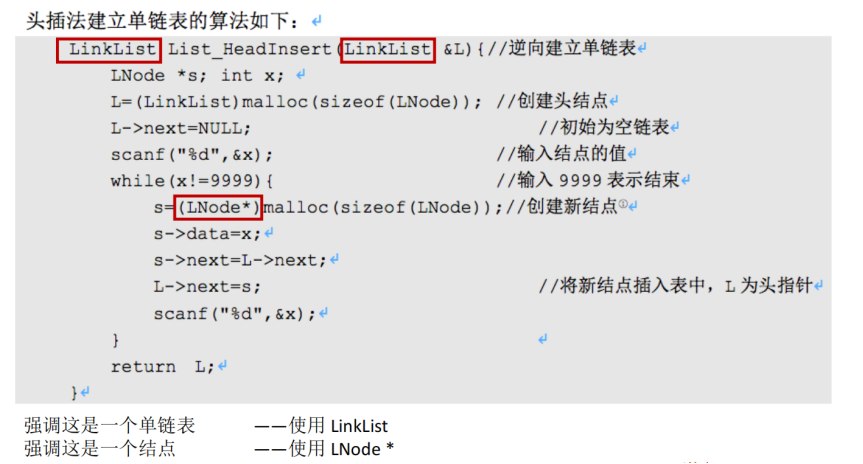
7.采用头插法建立单链表
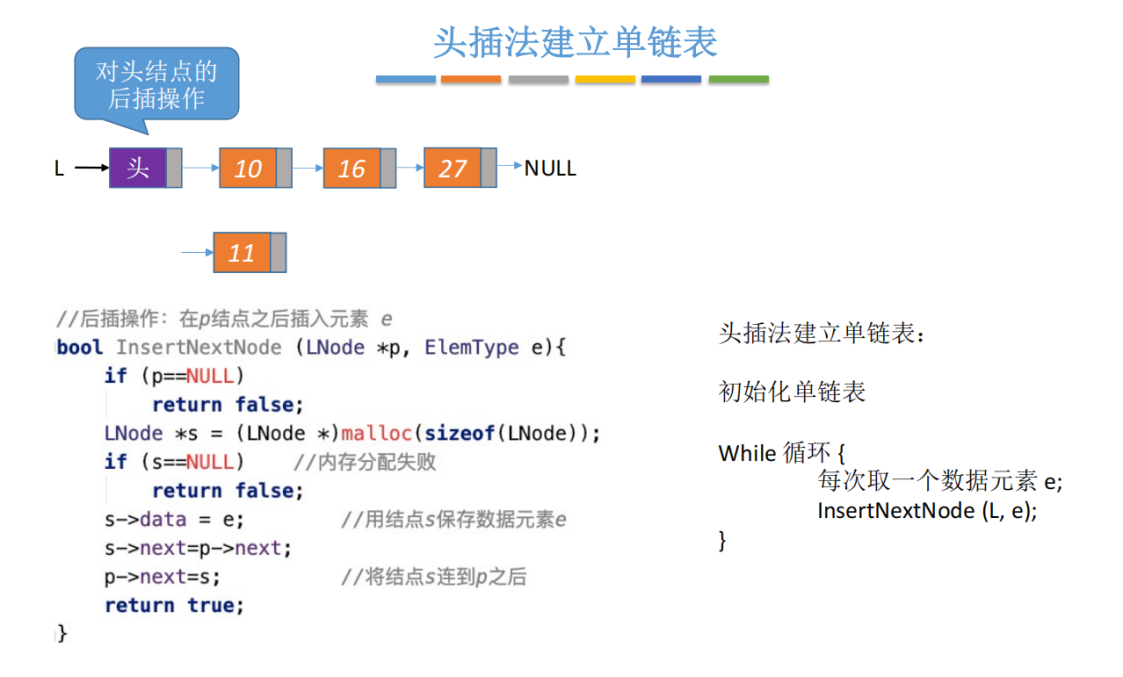
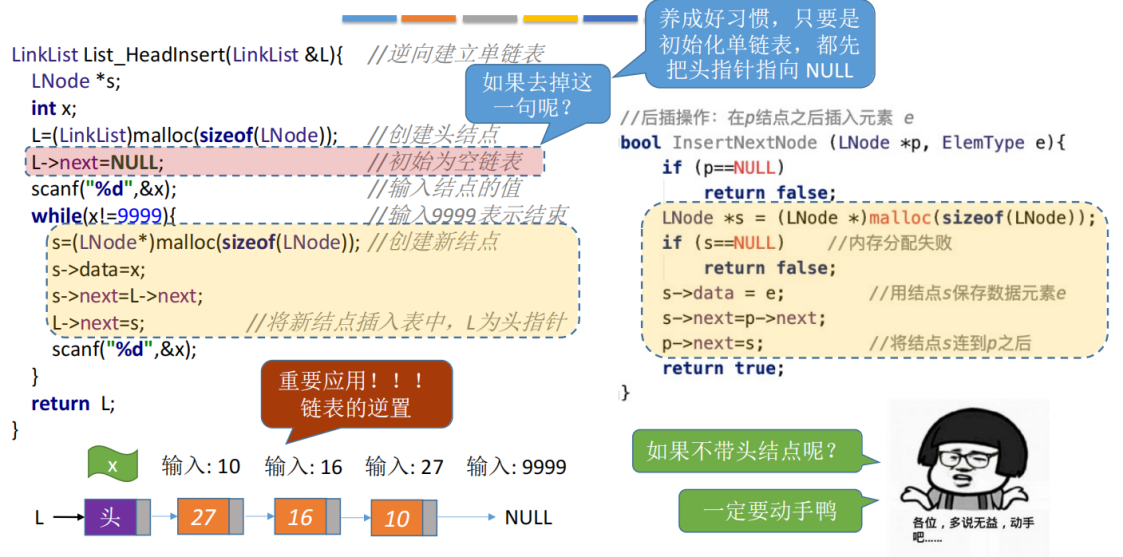
该方法从一个空表开始,生成新结点,并将读取到的数据存放到新结点的数据域中,然后将新结点插入到当前链表的表头,即头结点之后,如图2.7所示。算法实现如下:
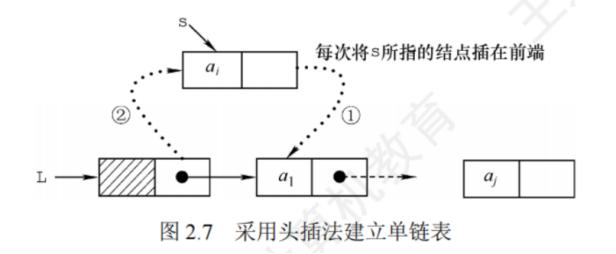
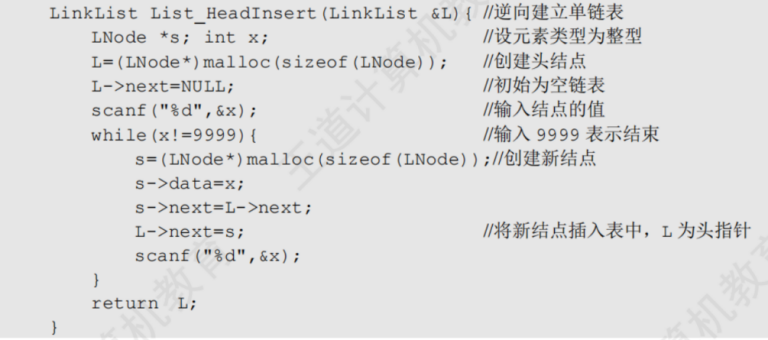
采用头插法建立单链表时,读入数据的顺序与生成的链表中元素的顺序是相反的,可用来实现链表的逆置。每个结点插入的时间为0(1),设单链表长为n,则总时间复杂度为0(n)。
8.采用尾插法建立单链表
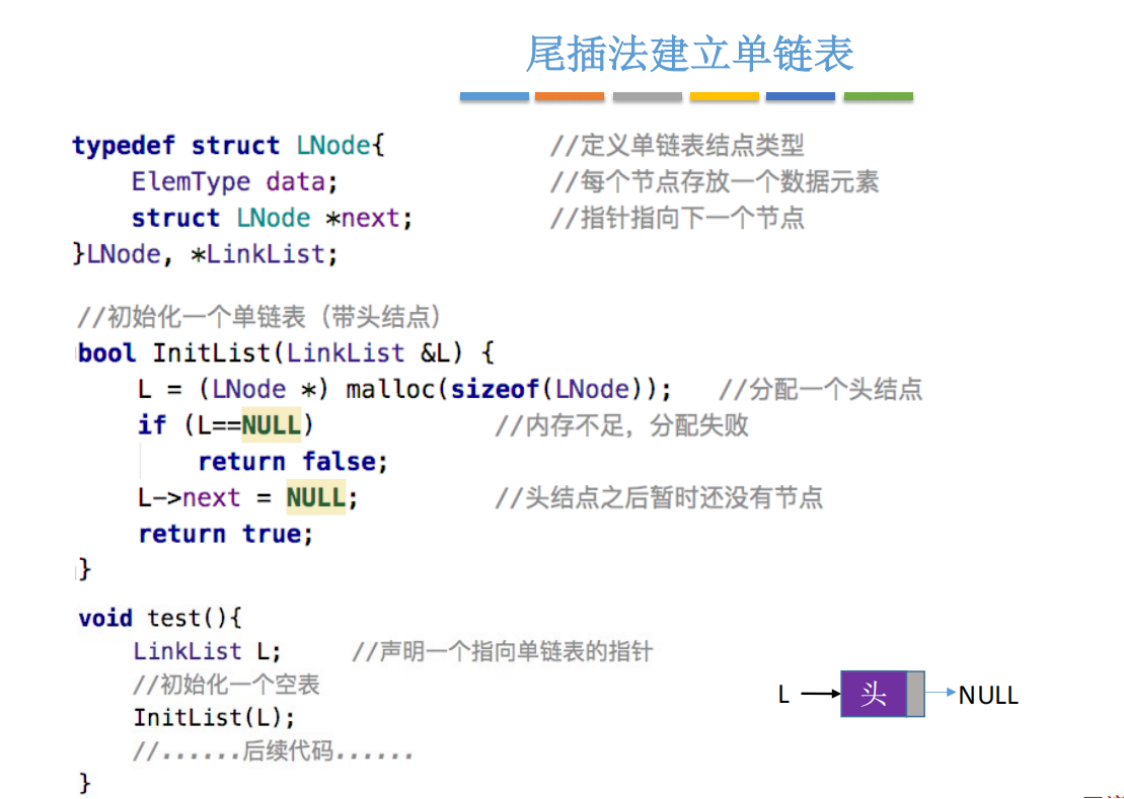
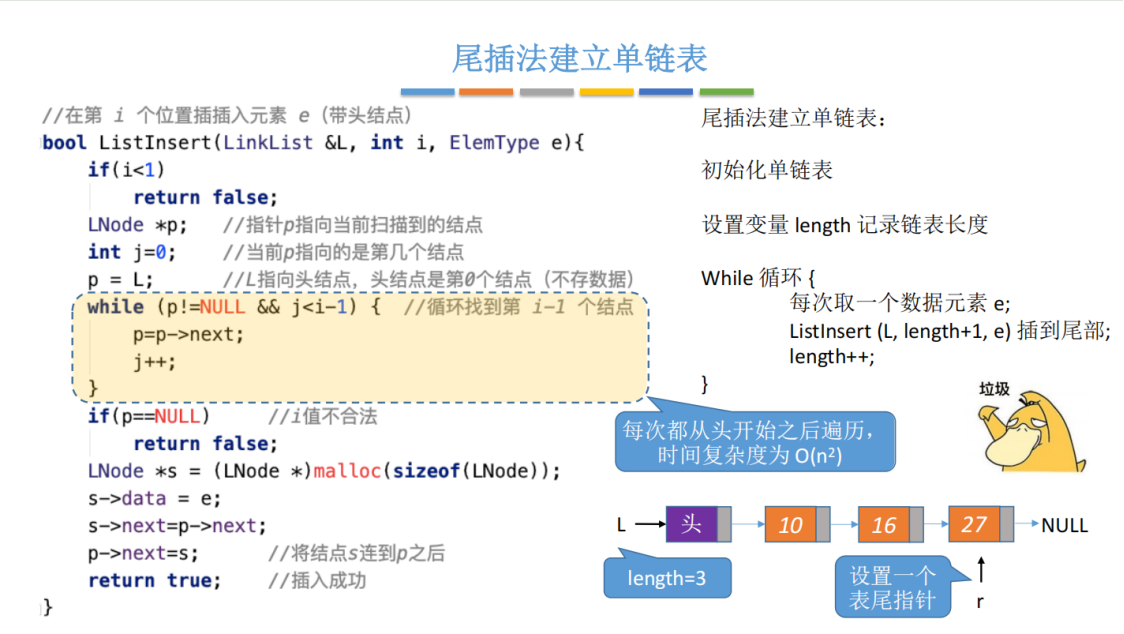
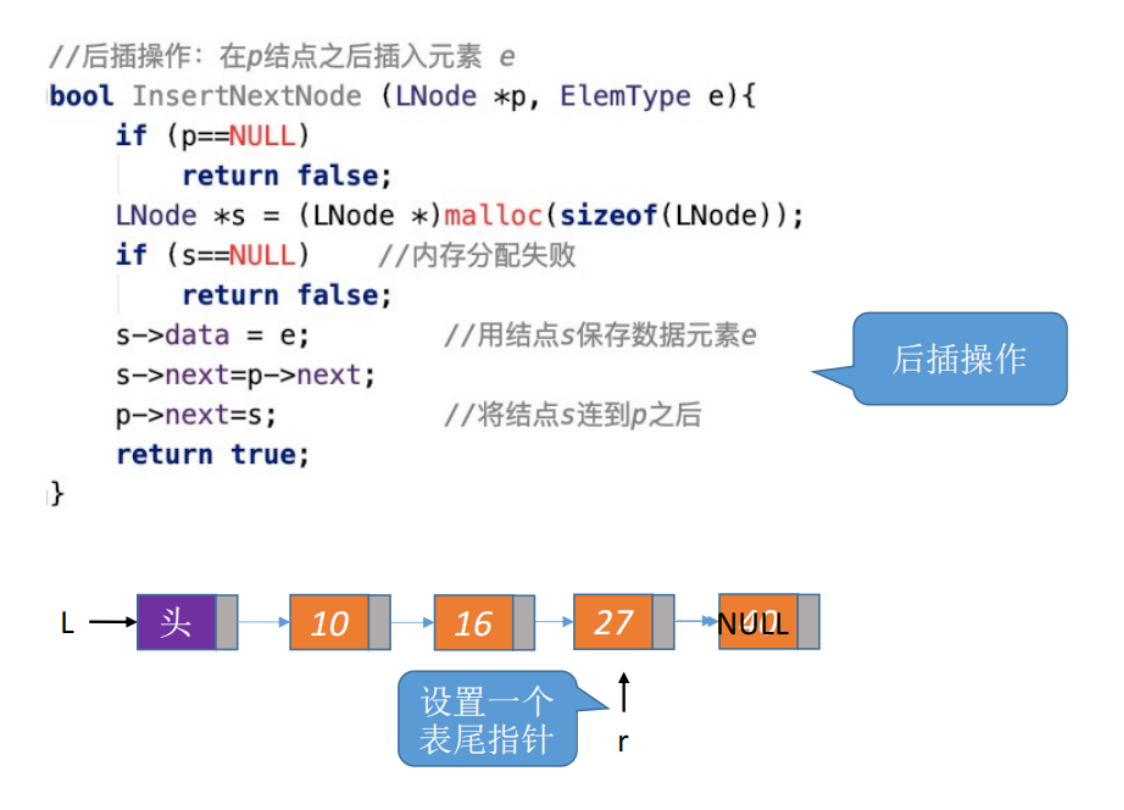
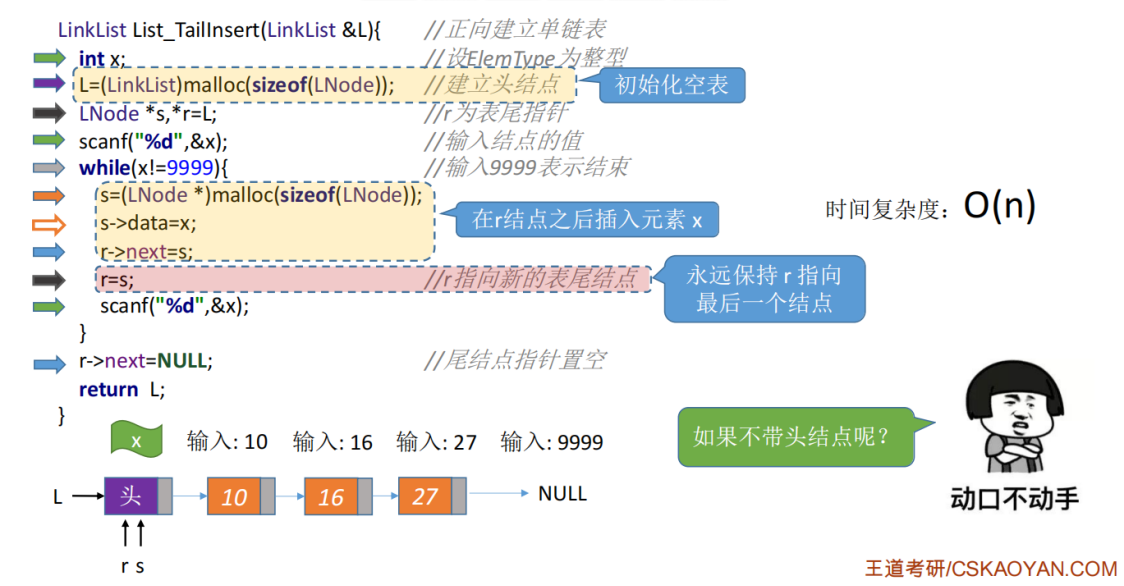
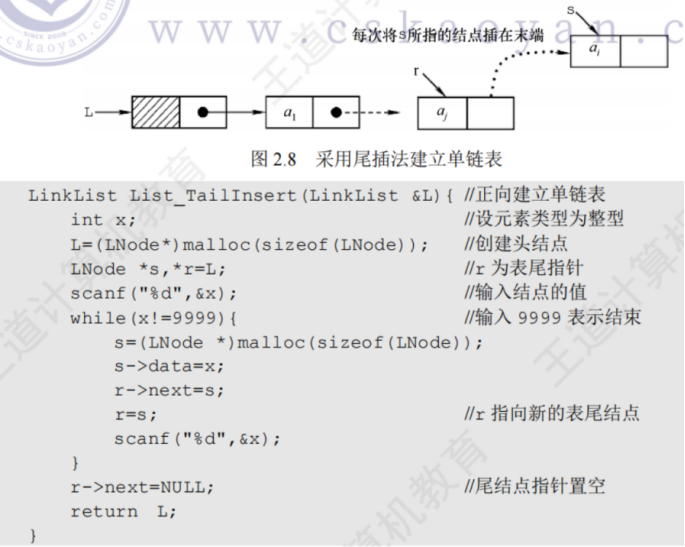
头插法建立单链表的算法虽然简单,但生成的链表中结点的次序和输入数据的顺序不一致。若希望两者次序一致,则可采用尾插法。该方法将新结点插入到当前链表的表尾,为此必须增加一个尾指针r,使其始终指向当前链表的尾结点,如图2.8所示。算法实现如下:
2.3.3双链表
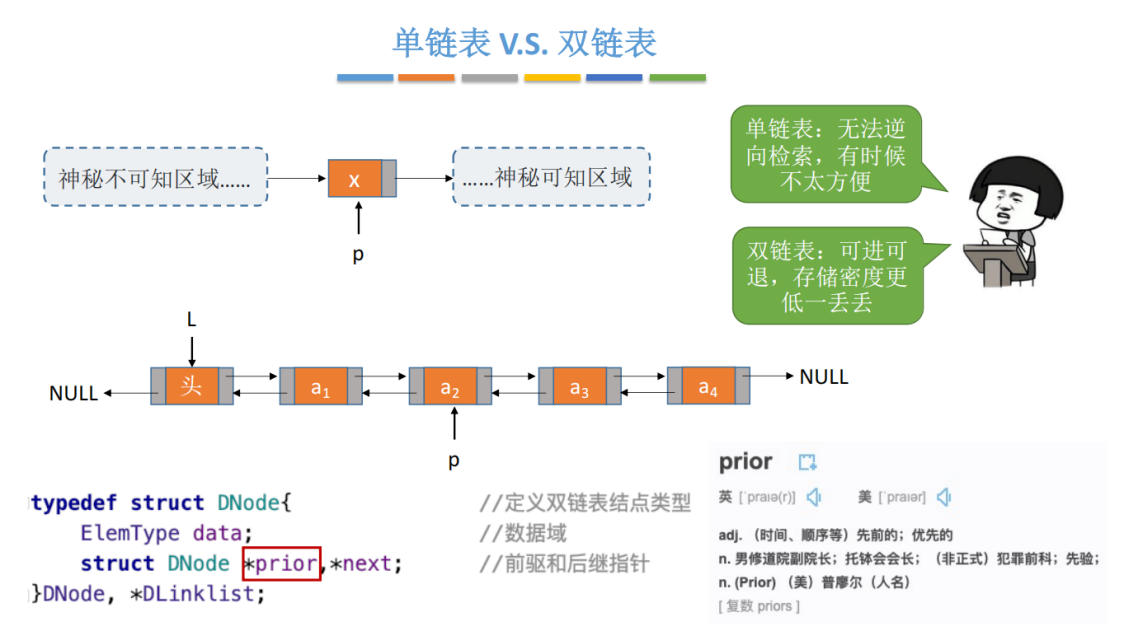
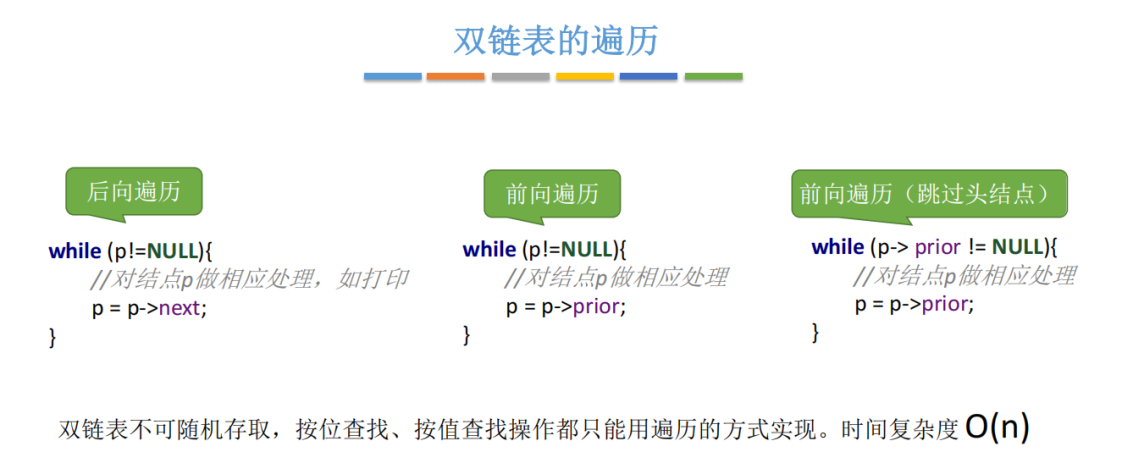
单链表结点中只有一个指向其后继的指针,使得单链表只能从前往后依次遍历。要访问某个结点的前驱(插入、删除操作时),只能从头开始遍历,访问前驱的时间复杂度为0(n)。
为了克服单链表的这个缺点,引入了双链表,双链表结点中有两个指针prior和分别指向其直接前驱和直接后继,如图2.9所示。表头结点的prior域和尾结点的next域都是NULL。
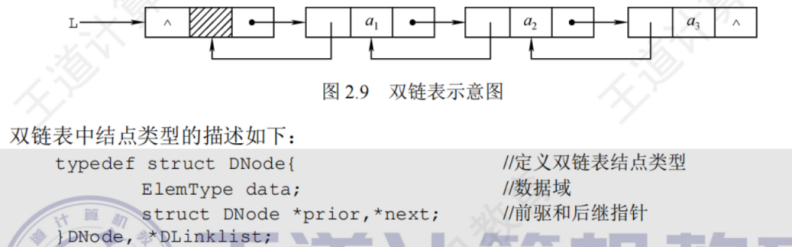
双链表在单链表结点中增加了一个指向其前驱的指针prior,因此双链表的按值查找和按位查找的操作与单链表的相同。但双链表在插入和删除操作的实现上,与单链表有着较大的不同。这是因为“链”变化时也需要对指针prior做出修改,其关键是保证在修改的过程中不断链。此外,双链表可以很方便地找到当前结点的前驱,因此,插入、删除操作的时间复杂度仅为0(1)。
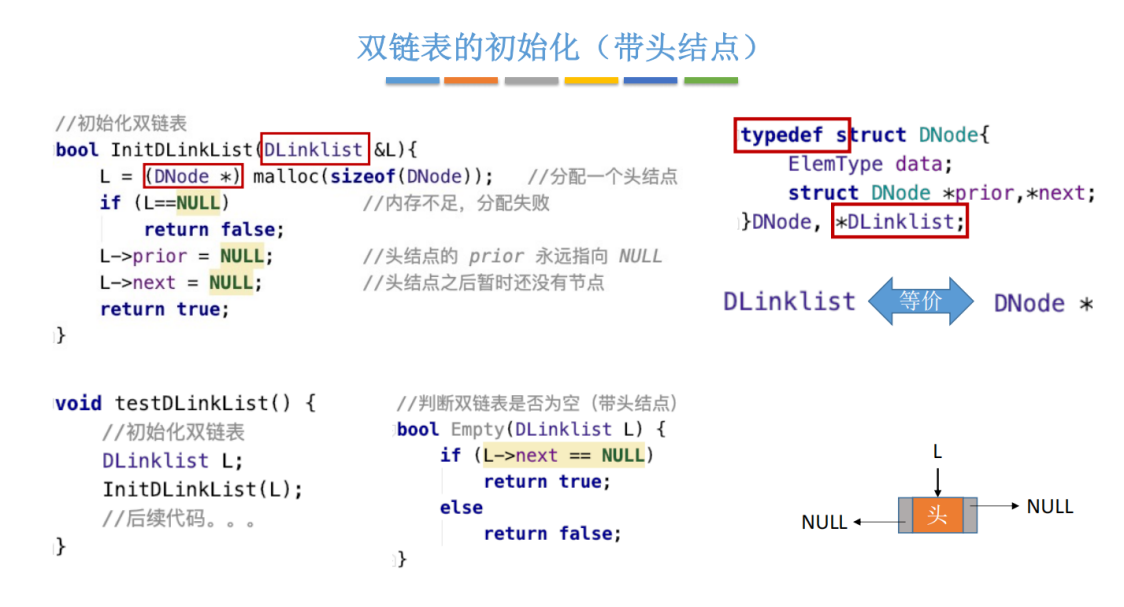
1.双链表的插入操作
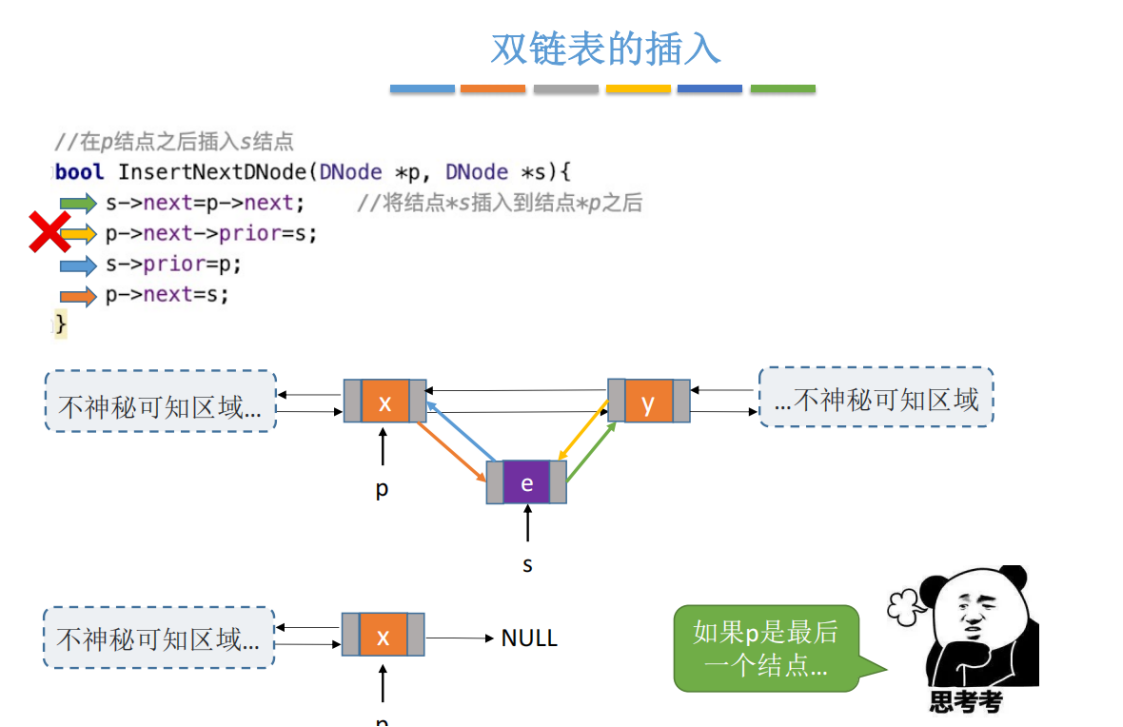
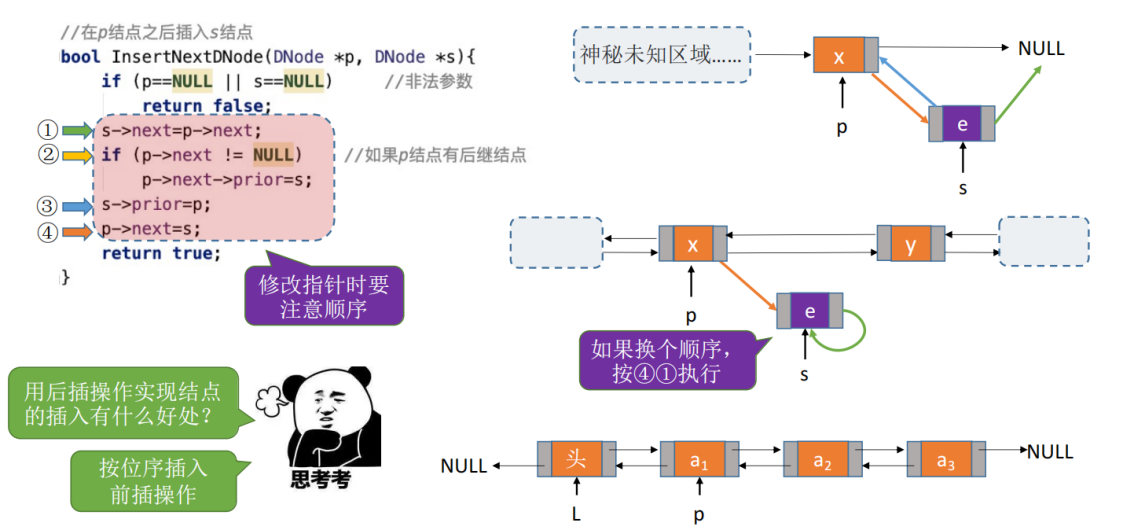
在双链表中p所指的结点之后插入结点*s,其指针的变化过程如图2.10所示。
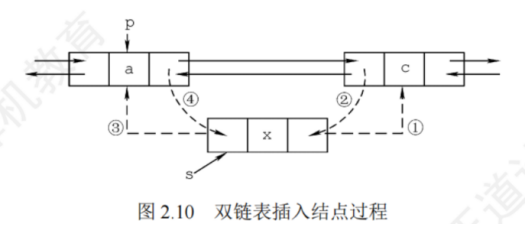
双链表中插入操作的实现:
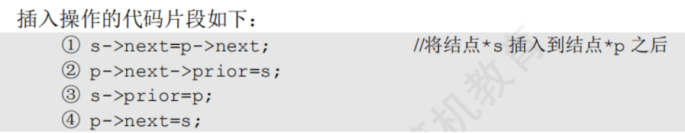
上述代码的语句顺序不是唯一的,但也不是任意的,①步必须在④步之前,否则*p的后继结点的指针就会丢掉,导致插入失败。为了加深理解,读者可以在纸上画出示意图。若问题改成要求在结点*p之前插入结点*s,请读者思考具体的操作步骤。
2.双链表的删除操作
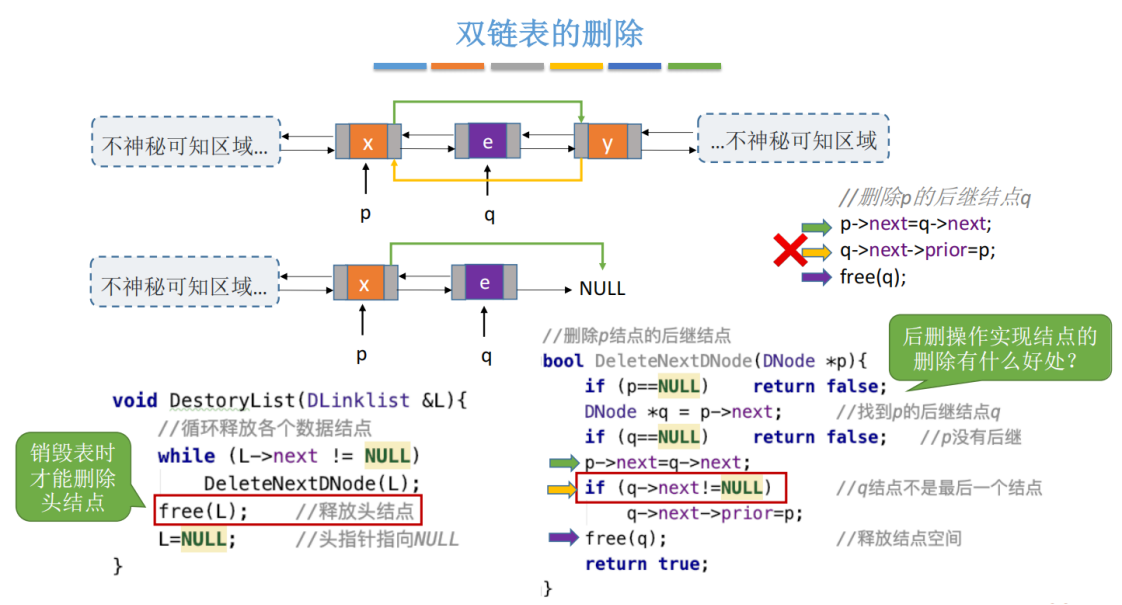
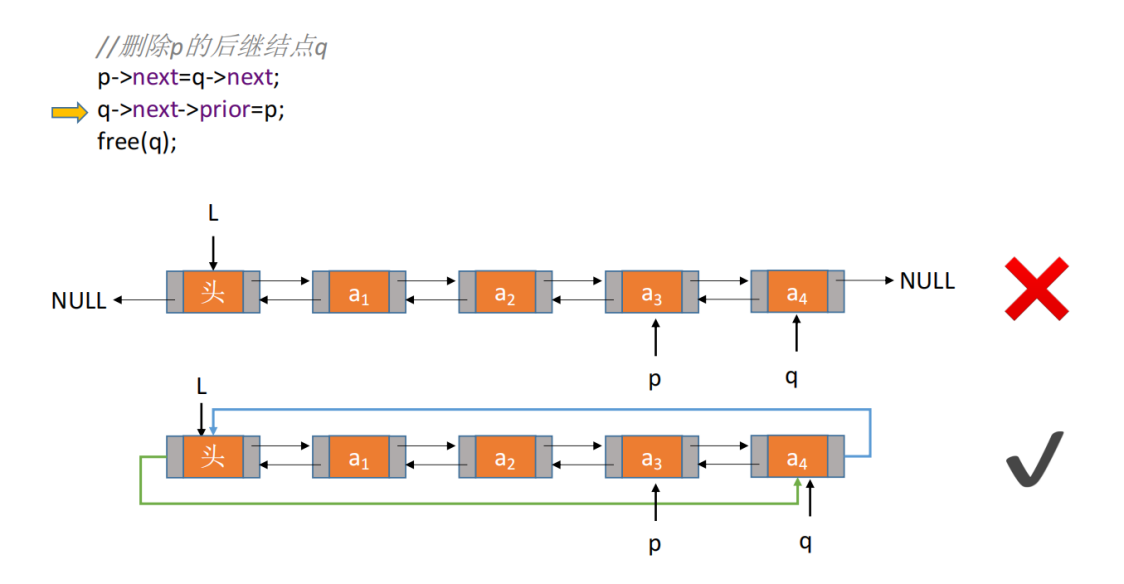
删除双链表中结点*p的后继结点*q,其指针的变化过程如图2.11所示。
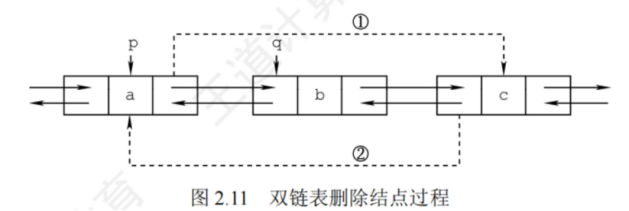
双链表中删除操作的实现:删除操作的代码片段如下:
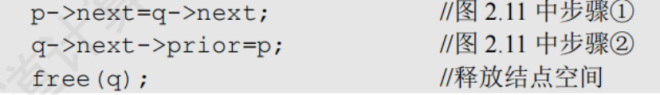
若问题改成要求删除结点*q的前驱结点*p,请读者思考具体的操作步骤。在建立双链表的操作中,也可采用如同单链表的头插法和尾插法,但在操作上需要注意指针的变化和单链表有所不同。
2.3.4循环链表
1.循环单链表
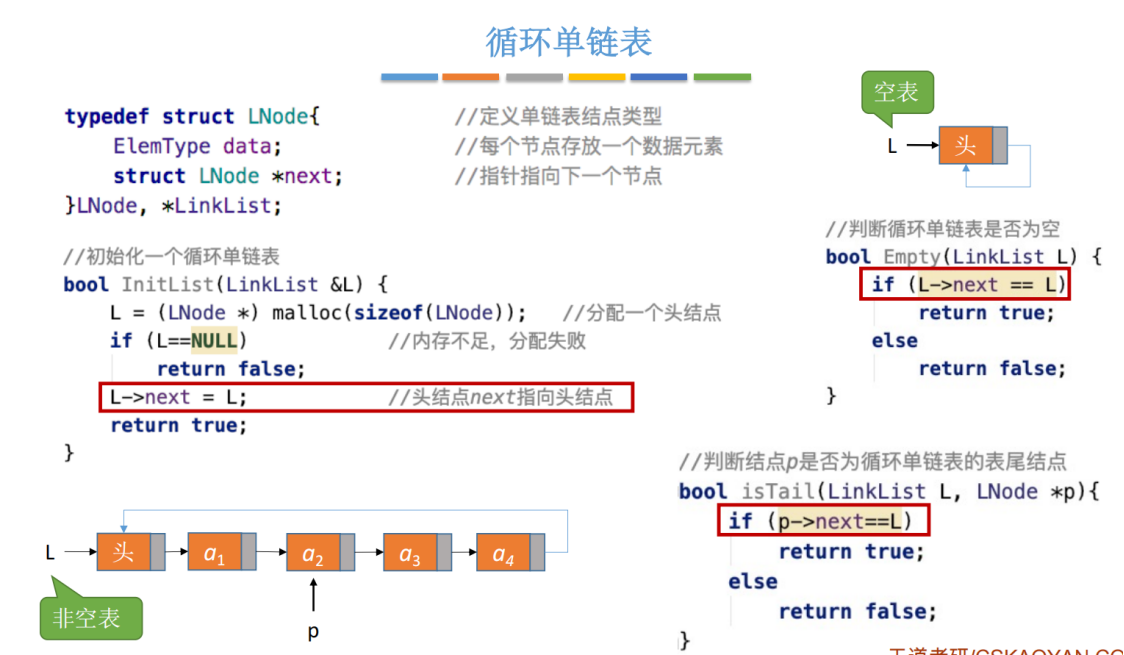
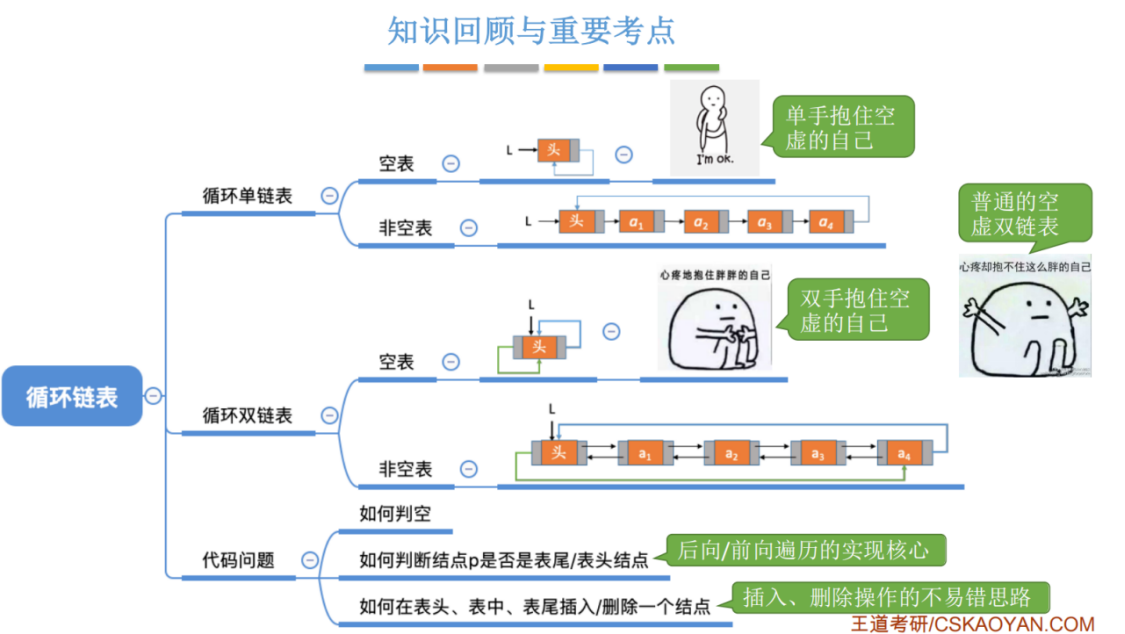
循环单链表和单链表的区别在于,表中最后一个结点的指针不是NULL,而改为指向头结点,从而整个链表形成一个环,如图2.12所示。在循环单链表中,表尾结点*r的next域指向工,故表中没有指针域为NULL的结点,因此,循环单链表的判空条件不是头结点的指针是否为空,而是它是否等于头指针工。
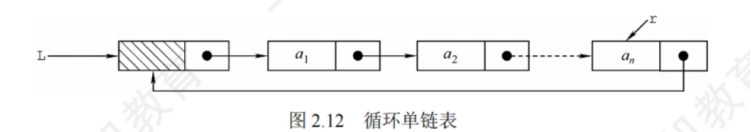
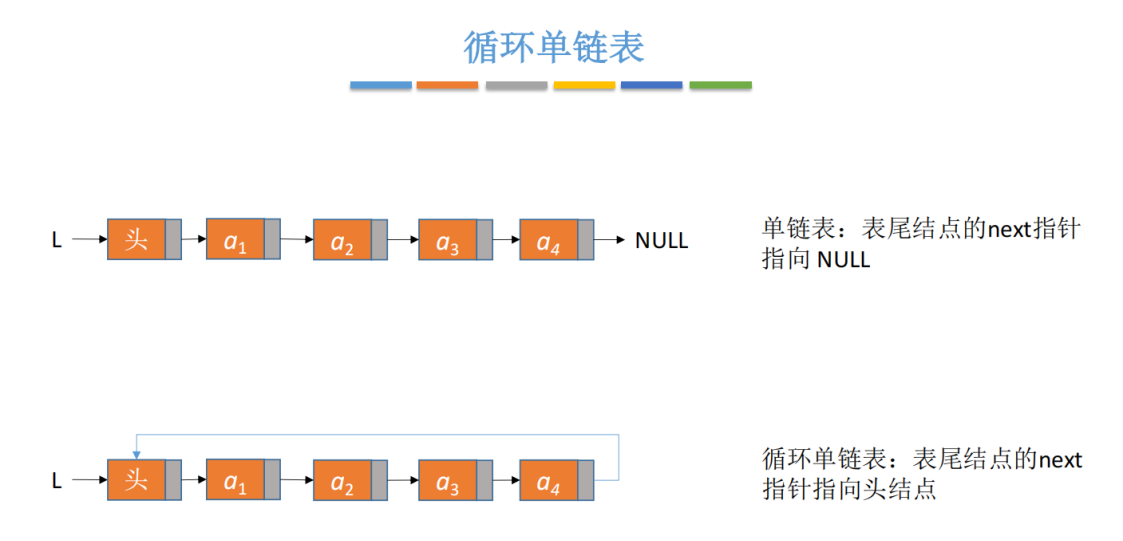
循环单链表中删除首元素的操作:
循环单链表的插入、删除算法与单链表的几乎一样,所不同的是,若操作是在表尾进行,则执行的操作不同,以让单链表继续保持循环的性质。当然,正是因为循环单链表是一个“环”,所以在任何位置上的插入和删除操作都是等价的,而无须判断是否是表尾。
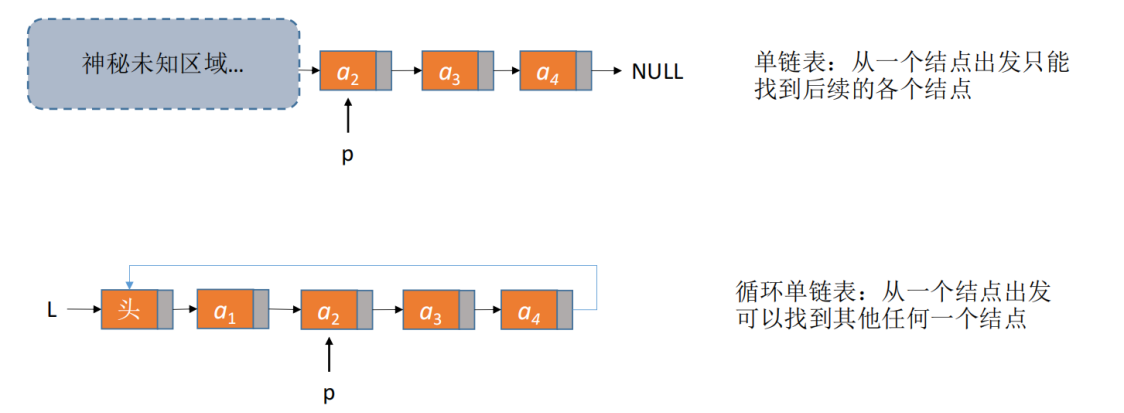
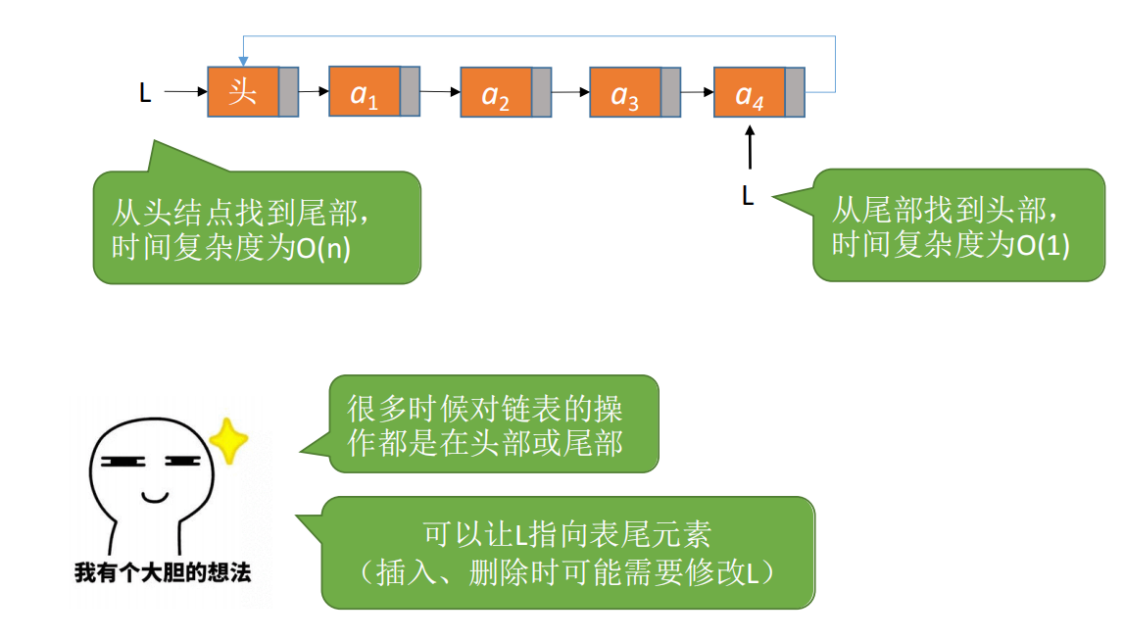
在单链表中只能从表头结点开始往后顺序遍历整个链表,而循环单链表可以从表中的任意一个结点开始遍历整个链表。有时对循环单链表不设头指针而仅设尾指针,以使得操作效率更高。其原因是,若设的是头指针,对在表尾插入元素需要O(n)的时间复杂度,而若设的是尾指针r,r->next即头指针,对在表头或表尾插入元素都只需要O(1)的时间复杂度。
2.循环双链表
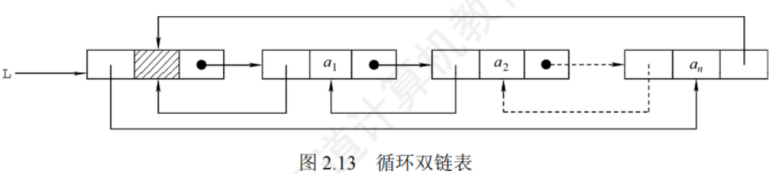
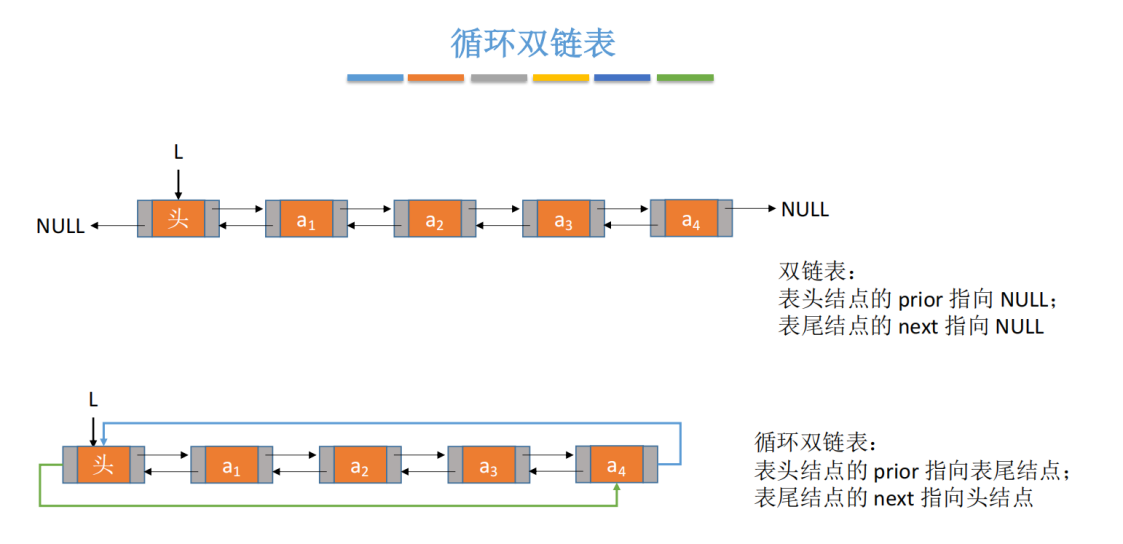
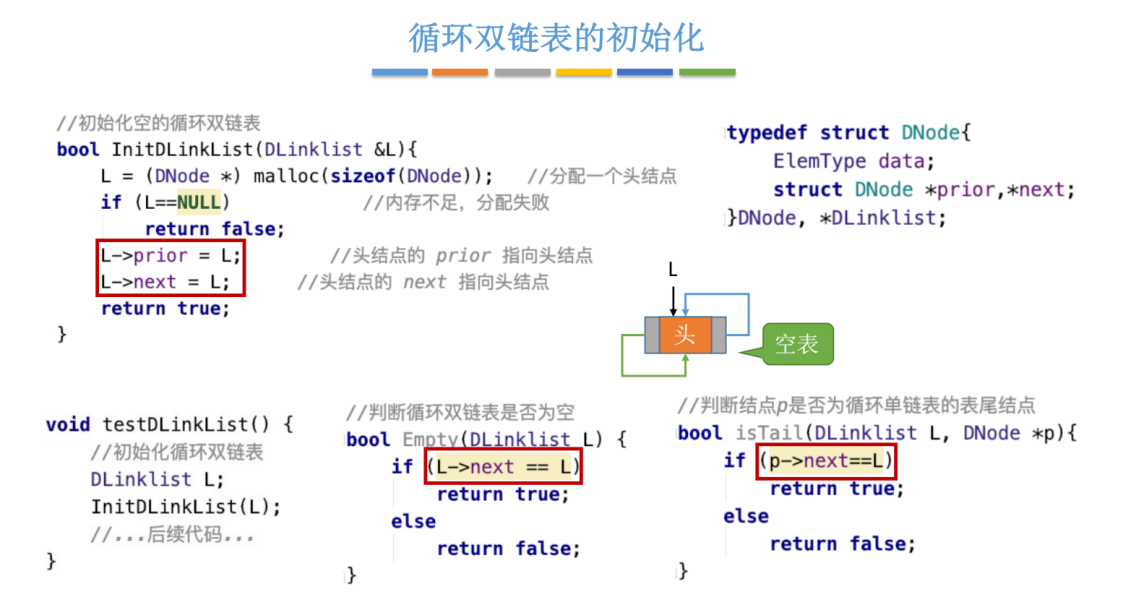
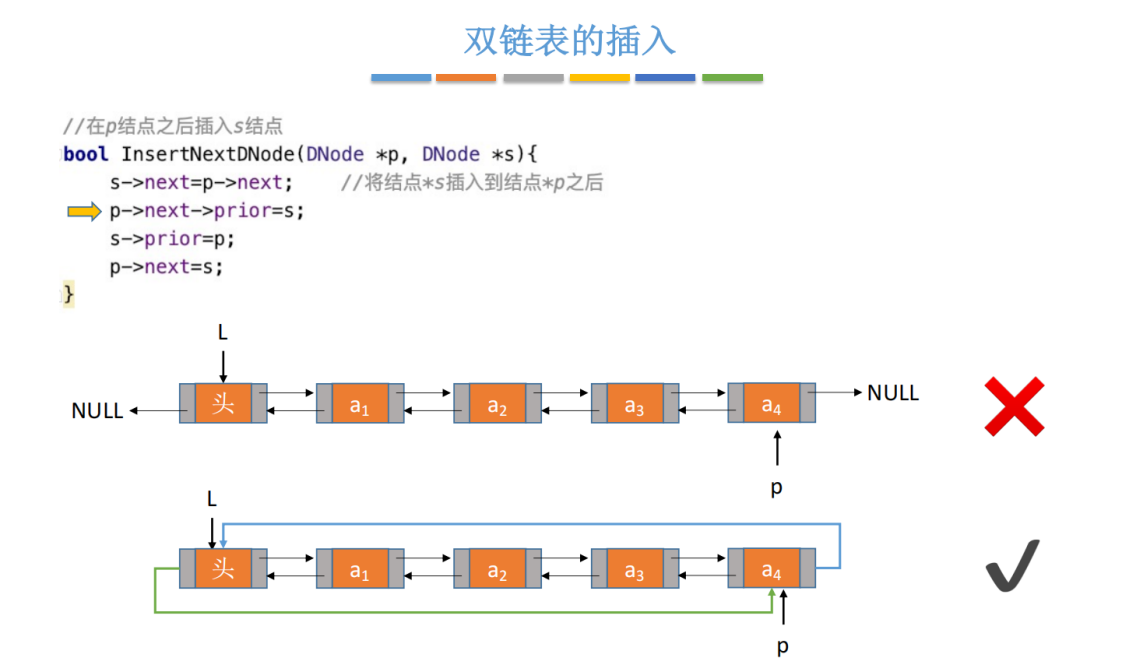
由循环单链表的定义不难推出循环双链表。不同的是,在循环双链表中,头结点的prior指针还要指向表尾结点,如图2.13所示。当某结点*p为尾结点时,p->next==L;当循环双链表为空表时,其头结点的prior域和next域都等于L。
2.3.5静态链表
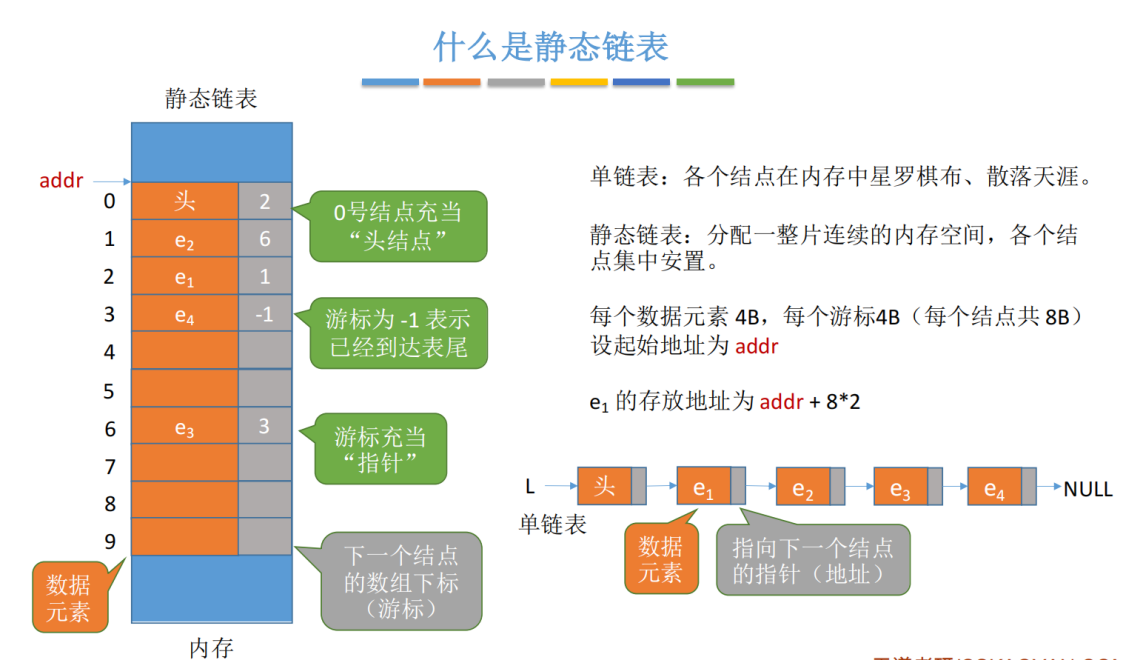
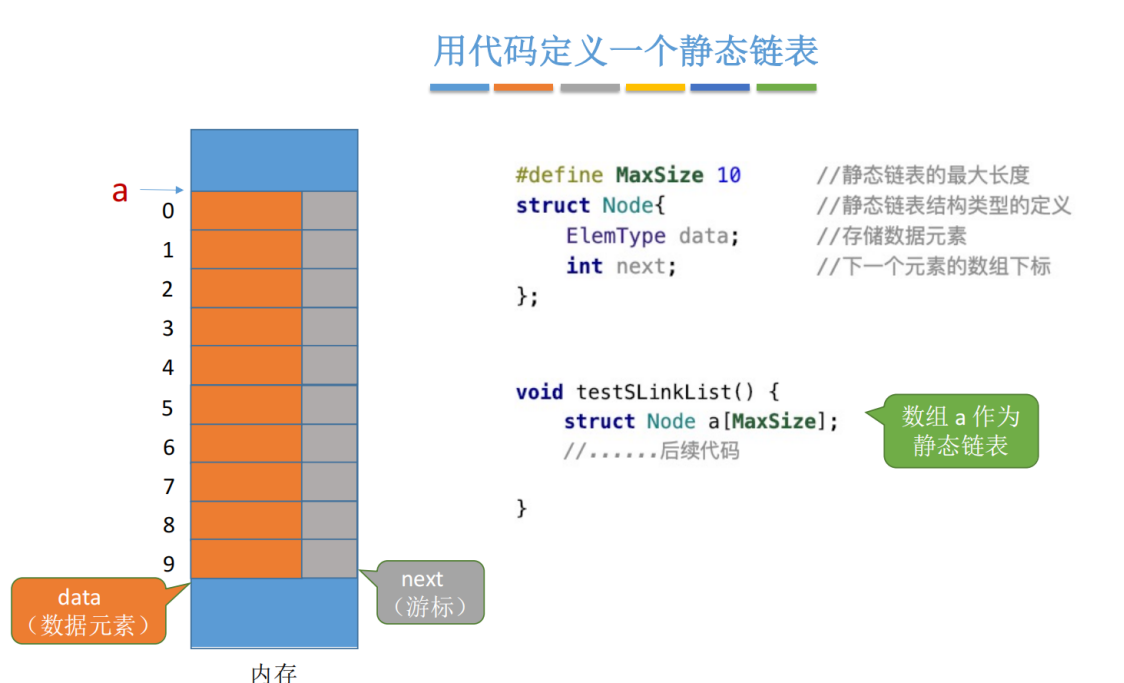
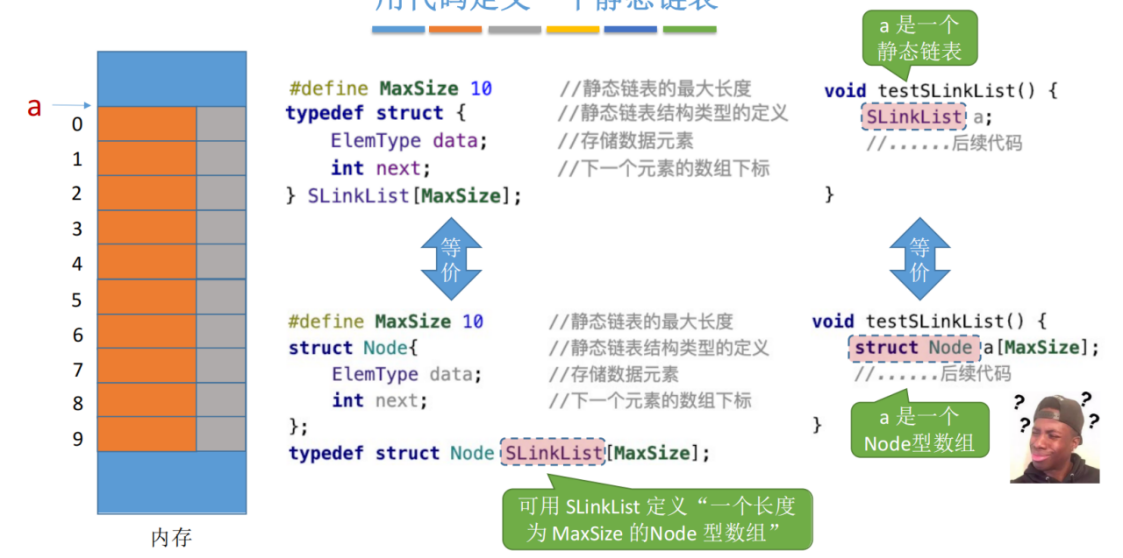
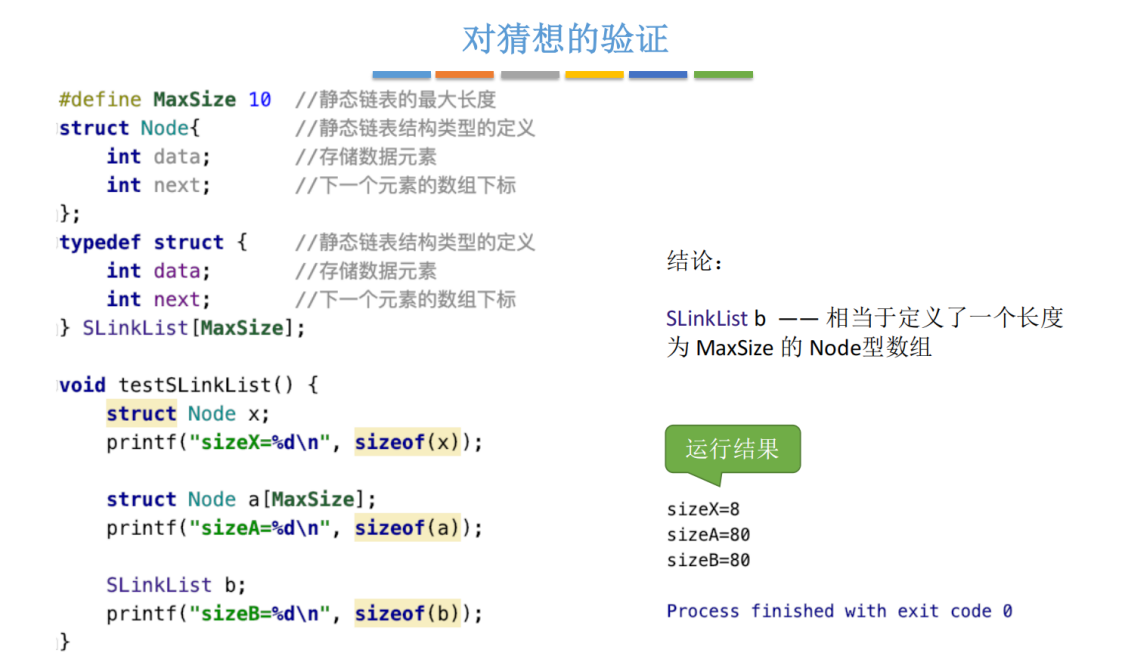
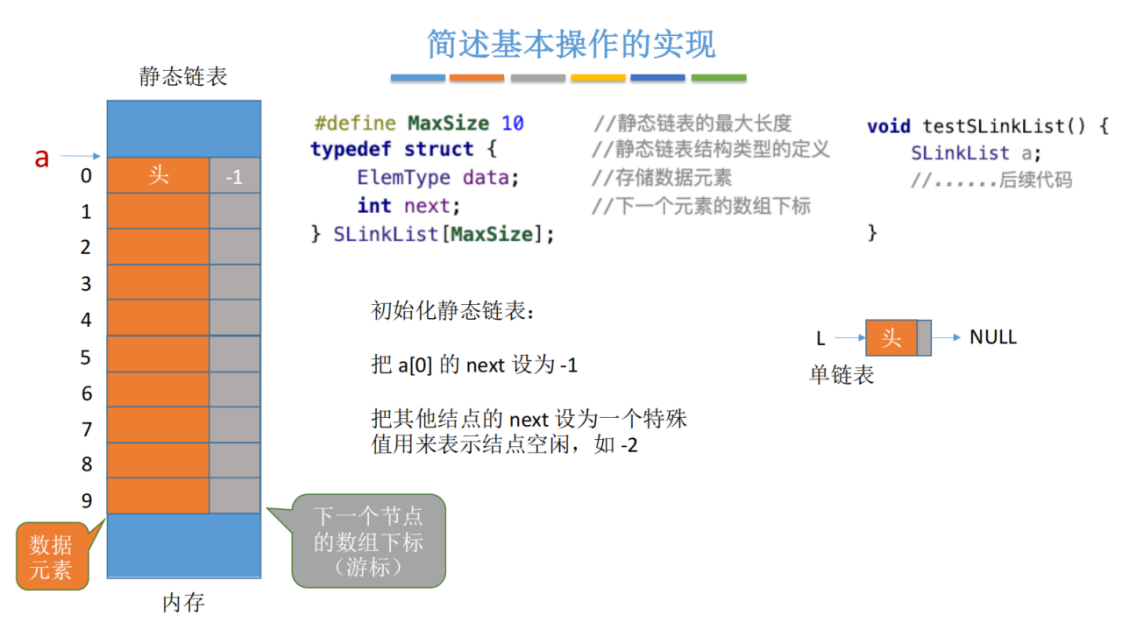
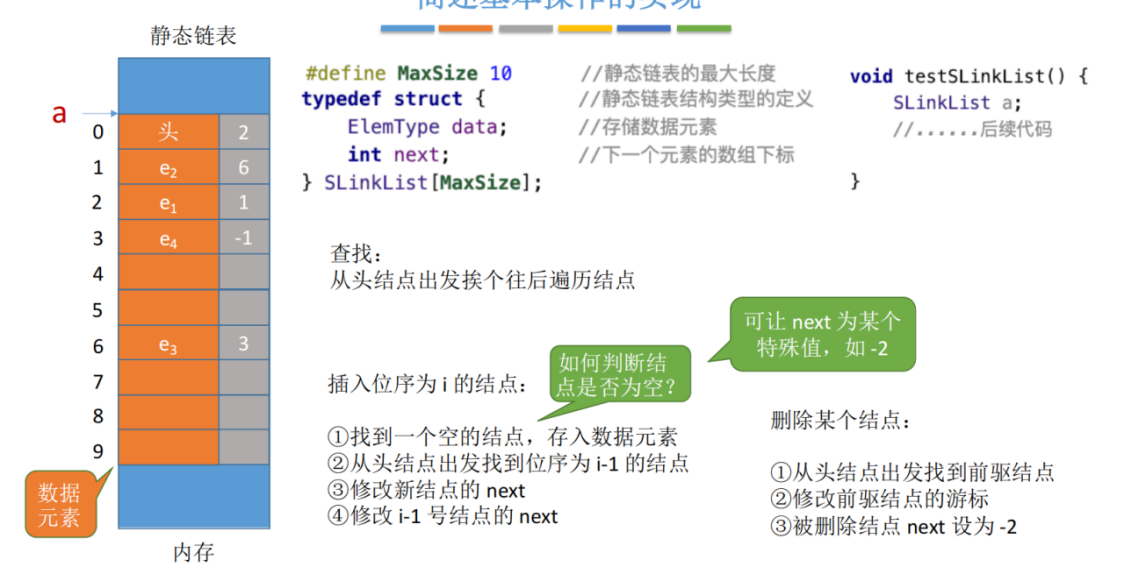
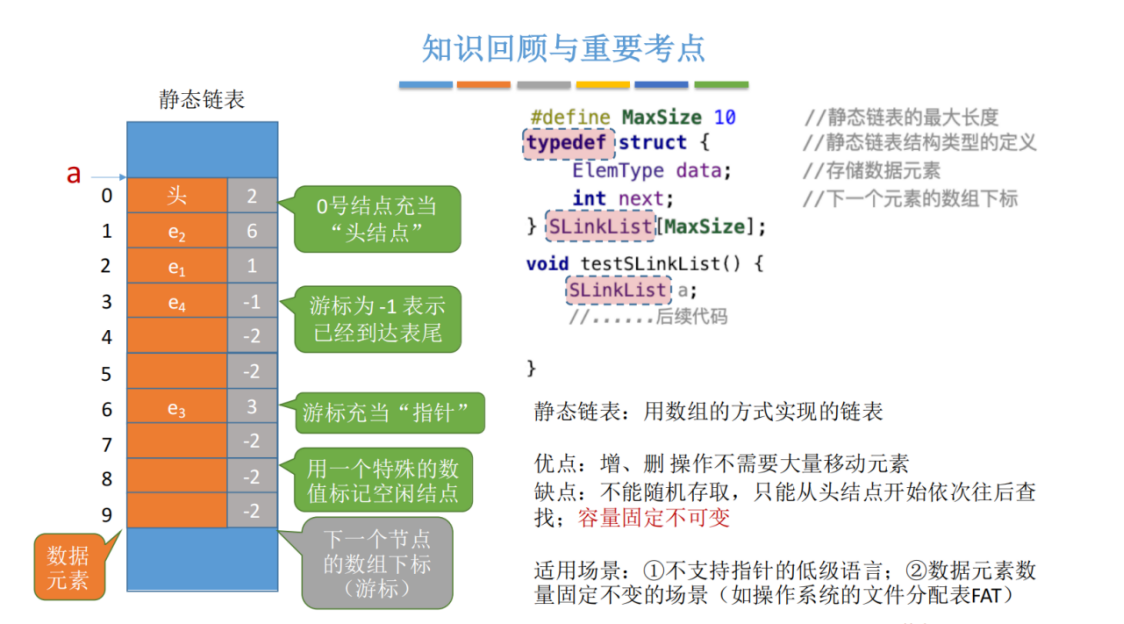
静态链表是用数组来描述线性表的链式存储结构,结点也有数据域data和指针域next,与前面所讲的链表中的指针不同的是,这里的指针是结点在数组中的相对地址(数组下标),也称游标。和顺序表一样,静态链表也要预先分配一块连续的内存空间。静态链表和单链表的对应关系如图2.14所示。
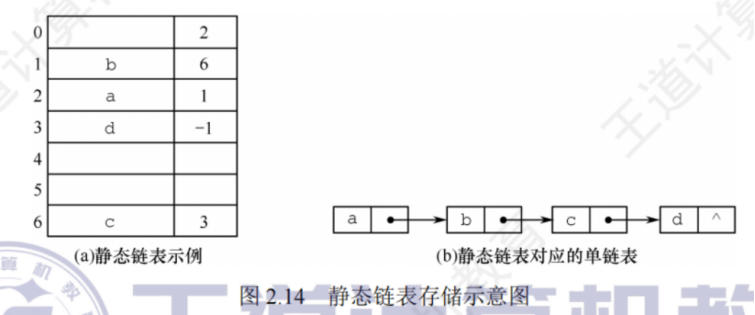
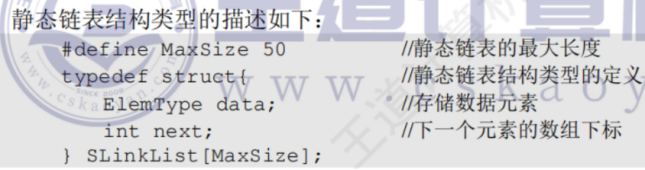
静态链表以next==-1作为其结束的标志。静态链表的插入、删除操作与动态链表的相同,只需要修改指针,而不需要移动元素。总体来说,静态链表没有单链表使用起来方便,但在一些不支持指针的高级语言(如Basic)中,这是一种非常巧妙的设计方法。
2.3.6顺序表和链表的比较
1.存取(读/写)方式
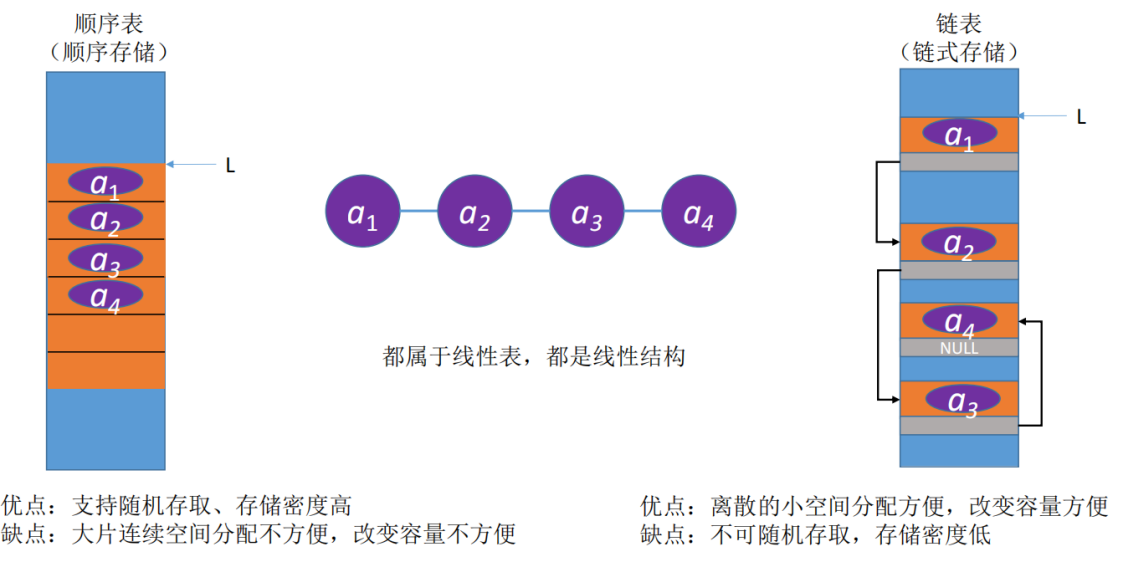
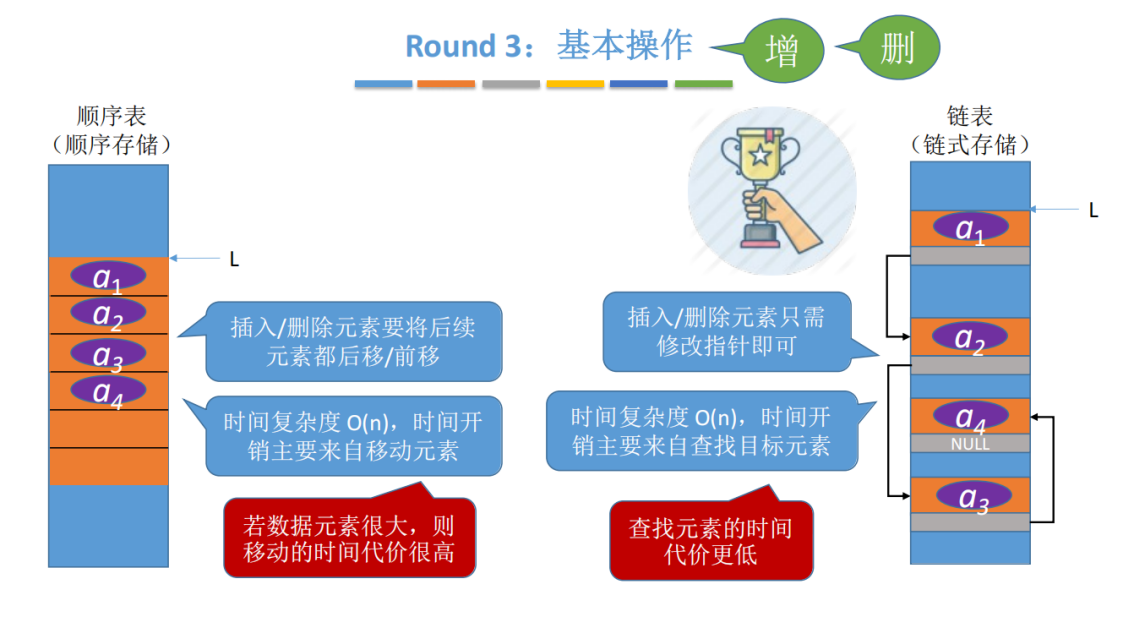
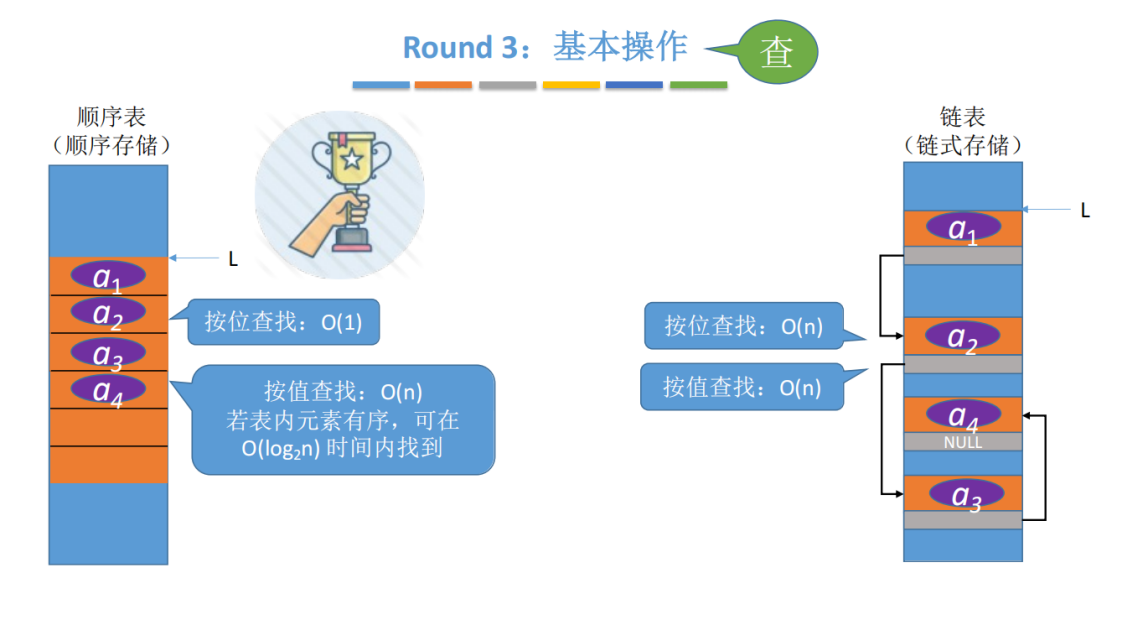
顺序表既可以顺序存取,也可以随机存取,链表只能从表头开始依次顺序存取。例如在第i个位置上执行存取的操作,顺序表仅需一次访问,而链表则需从表头开始依次访问i次。
2.逻辑结构与物理结构
采用顺序存储时,逻辑上相邻的元素,对应的物理存储位置也相邻。而采用链式存储时,逻辑上相邻的元素,物理存储位置不一定相邻,对应的逻辑关系是通过指针链接来表示的。
3.查找、插入和删除操作
对于按值查找,顺序表无序时,两者的时间复杂度均为O(n);顺序表有序时,可采用折半查找,此时的时间复杂度为O(log₂n)。对于按序号查找,顺序表支持随机访问,时间复杂度仅为0(1),而链表的平均时间复杂度为O(n)。顺序表的插入、删除操作,平均需要移动半个表长的元素。链表的插入、删除操作,只需修改相关结点的指针域即可。
4.空间分配
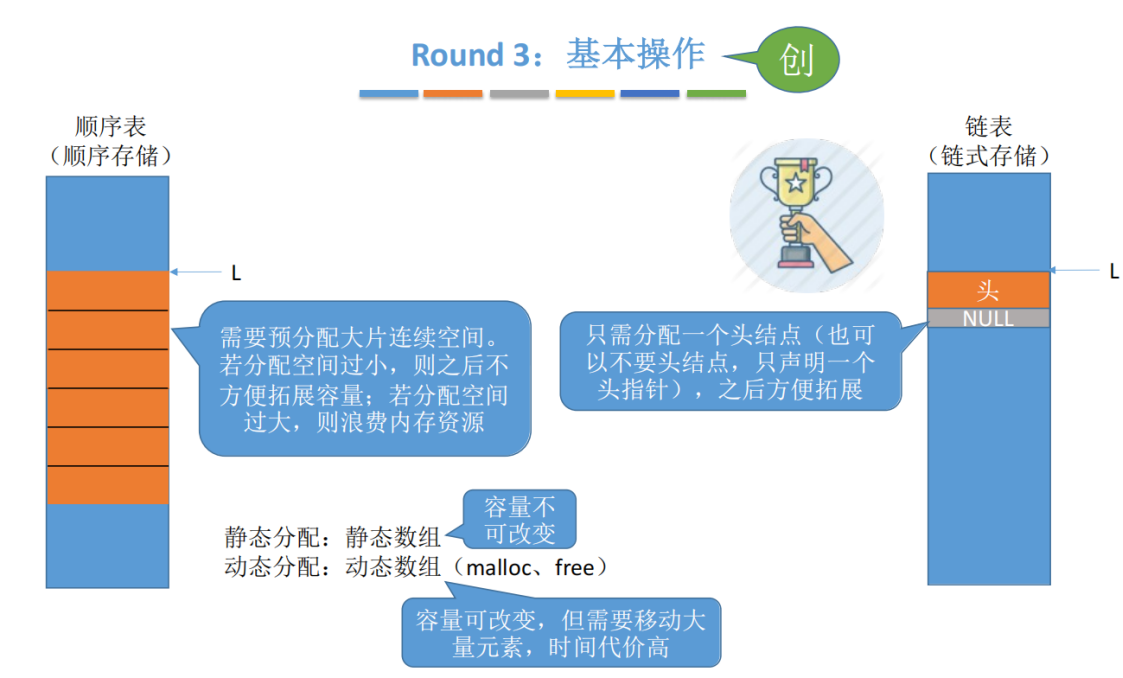
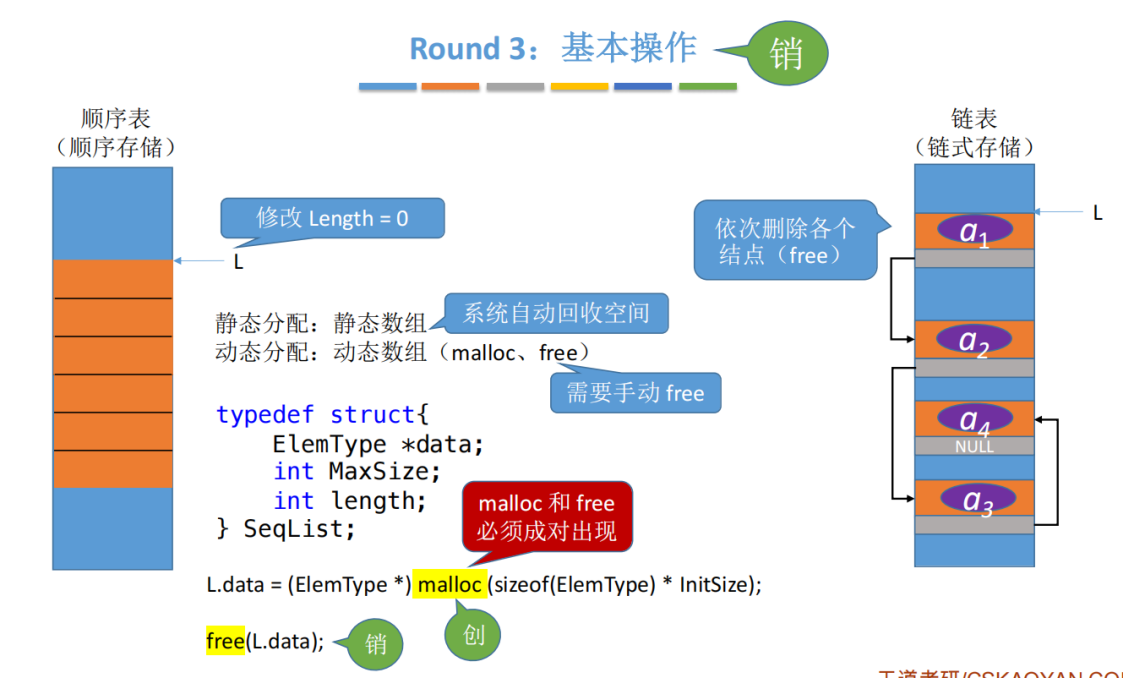
顺序存储在静态存储分配情形下,一旦存储空间装满就不能扩充,若再加入新元素,则会出现内存溢出,因此需要预先分配足够大的存储空间。预先分配过大,可能会导致顺序表后部大量闲置;预先分配过小,又会造成溢出。动态存储分配虽然存储空间可以扩充,但需要移动大量元素,导致操作效率降低,而且若内存中没有更大块的连续存储空间,则会导致分配失败。链式存储的结点空间只在需要时申请分配,只要内存有空间就可以分配,操作灵活、高效。此外,链表的每个结点都带有指针域,因此存储密度不够大。
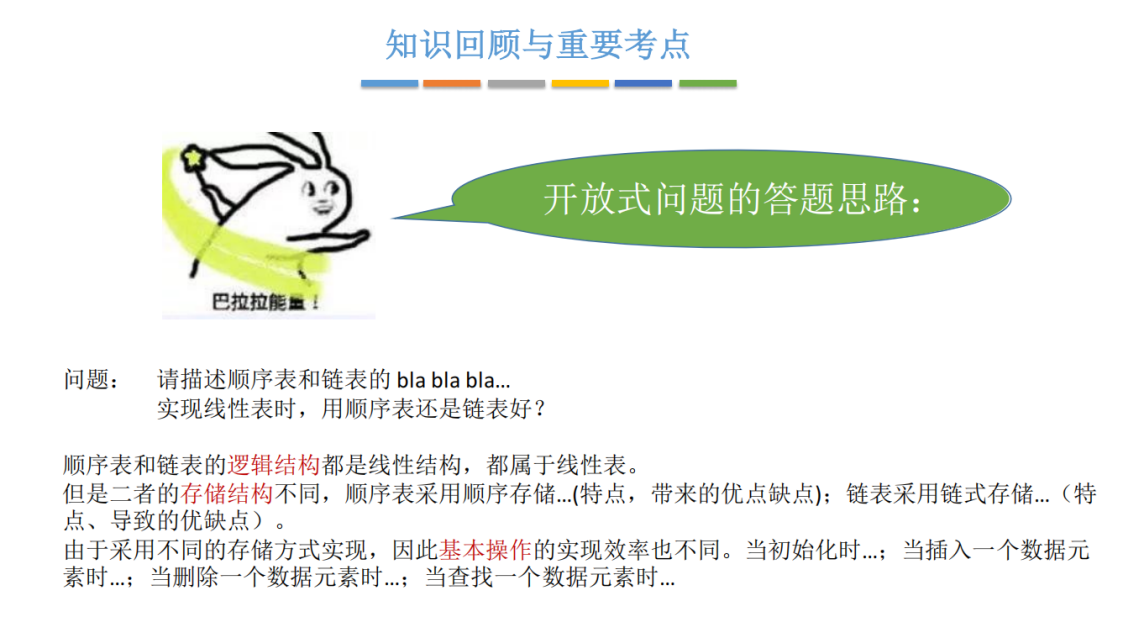
在实际中应该怎样选取存储结构呢?
1.基于存储的考虑
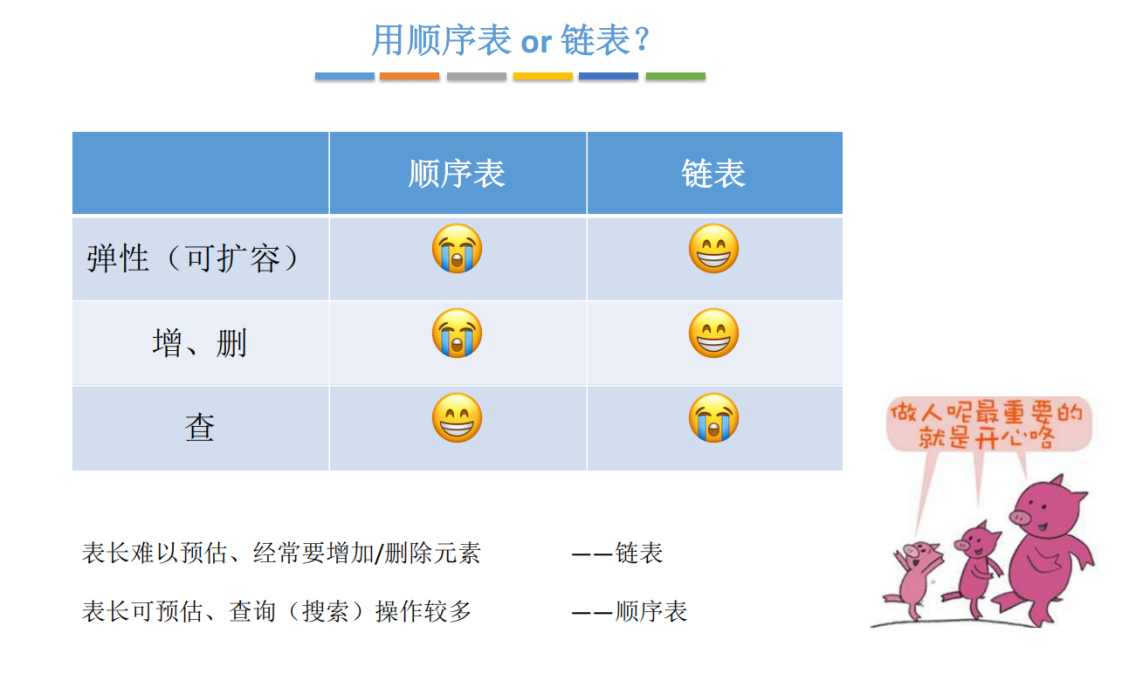
难以估计线性表的长度或存储规模时,不宜采用顺序表;链表不用事先估计存储规模,但链表的存储密度较低,显然链式存储结构的存储密度是小于1的。
2.基于运算的考虑
在顺序表中按序号访问a;的时间复杂度为0(1),而链表中按序号访问的时间复杂度为O(n),因此若经常做的运算是按序号访问数据元素,则显然顺序表优于链表。
在顺序表中进行插入、删除操作时,平均移动表中一半的元素,当数据元素的信息量较大且表较长时,这一点是不应忽视的;在链表中进行插入、删除操作时,虽然也要找插入位置,但操
作主要是比较操作,从这个角度考虑显然后者优于前者。
3.基于环境的考虑
顺序表容易实现,任何高级语言中都有数组类型;链表的操作是基于指针的,相对来讲,前者实现较为简单,这也是用户考虑的一个因素。
总之,两种存储结构各有长短,选择哪一种由实际问题的主要因素决定。通常较稳定的线性表选择顺序存储,而频繁进行插入、删除操作的线性表(动态性较强)宜选择链式存储。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献3条内容

所有评论(0)