Java数据结构完整学习指南

简介:《Java数据结构全套》是一个全面的学习资源集合,它为Java编程语言学习者提供了从基础知识到高级应用的数据结构学习路径。该资源包括叶核亚编著的《数据结构(Java版)(第3版)》电子教案、MyEclipse例题与习题、JDK数据结构示例以及丰富的配套学习资料。通过系统学习,学习者能够深入理解数据结构基础理论、Java实现、算法逻辑、物理存储及实际应用。此外,MyEclipse为实践提供平台,JDK示例帮助理解标准库中数据结构的使用,而配套资料则是巩固学习成果、深入理解数据结构优化策略的宝贵资源。
1. 数据结构基础理论
在计算机科学中,数据结构是存储、组织数据的方式,它旨在以一种高效且合理的方式对数据进行操作。本章将探索数据结构的理论基础,为后续章节深入Java语言实现打下坚实的基础。
1.1 数据结构的定义
数据结构是一门研究如何在计算机中组织和存储数据的学科。它涉及到数据类型的抽象,以及这些数据类型的操作和关系。数据结构通常包括以下基本概念:
- 数据元素:数据的基本单位,可以是最简单的数据项,也可以是复杂的结构。
- 数据关系:数据元素之间的相互关系,它决定了数据元素是如何组织的。
- 数据操作:数据结构支持的操作,如插入、删除、搜索等。
1.2 数据结构的分类
数据结构主要分为两大类:线性结构和非线性结构。
- 线性结构:元素之间为一对一的关系,典型的线性结构包括数组、链表、栈和队列。
- 非线性结构:元素之间存在多对多的关系,树形结构和图是其两个主要的分支。
掌握线性和非线性数据结构是成为数据结构大师的第一步。在接下来的章节中,我们将详细学习这些数据结构的特性和在Java中的实现。
2. Java实现详解
Java作为一种广泛使用的编程语言,在实现数据结构方面有着丰富的标准库支持和社区资源。接下来的章节将深入探讨Java中的基本数据结构和高级数据结构的实现方式,以及它们的应用场景。
2.1 Java中的基本数据结构
2.1.1 Java中的数据类型和对象
在Java中,数据类型分为基本数据类型和引用数据类型。基本数据类型包括 byte , short , int , long , float , double , char , boolean ,它们直接存储数据。引用数据类型则包括类、接口、数组等,它们存储的是对象的引用。
int a = 10; // 基本数据类型示例
Integer b = Integer.valueOf(10); // 引用数据类型示例,自动装箱
自动装箱和拆箱机制允许基本数据类型和其对应的包装类之间进行转换,极大地简化了数据操作。
2.1.2 Java集合框架概述
Java集合框架提供了一套性能优化的接口和类,用于存储和操作对象集合。主要分为两大类: Collection 接口及其子接口 List , Set , Queue ,以及 Map 接口。
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

public class CollectionDemo {
    public static void main(String[] args) {
        List<Integer> numbers = new ArrayList<>(); // List集合
        Map<String, Integer> map = new HashMap<>(); // Map集合
        // 添加元素
        numbers.add(1);
        map.put("one", 1);
    }
}
通过 Collection 接口我们可以进行添加、删除、遍历元素等操作。 Map 接口则用于存储键值对,它不遵循 Collection 接口的规则,提供了键值对的增删查操作。
2.2 Java中的高级数据结构
2.2.1 设计模式在数据结构中的应用
设计模式为数据结构和算法的设计与实现提供了最佳实践。例如,在Java集合框架中,迭代器模式允许顺序访问集合对象中的各个元素,而不暴露其底层表示。
import java.util.List;
import java.util.ListIterator;

public class IteratorPatternDemo {
    public static void main(String[] args) {
        List<Integer> list = new ArrayList<>();
        list.add(1);
        list.add(2);
        list.add(3);
        ListIterator<Integer> iterator = list.listIterator();
        while (iterator.hasNext()) {
            int number = iterator.next();
            System.out.println(number);
        }
    }
}
迭代器模式使用 ListIterator 接口实现了对集合的双向遍历,提高了代码的可重用性和灵活性。
2.2.2 Java内存模型和数据结构的关联
Java内存模型定义了共享变量的访问规则,它影响到数据结构中元素的存储和访问效率。例如, HashMap 的性能受到哈希表大小和负载因子的影响。
import java.util.HashMap;

public class MemoryModelDemo {
    public static void main(String[] args) {
        HashMap<Integer, String> map = new HashMap<>();
        map.put(1, "One");
        String value = map.get(1);
        System.out.println(value);
    }
}
在上述代码中, HashMap 内部通过数组加链表的方式管理键值对,Java内存模型确保了多线程环境下数据的一致性和访问的安全性。
通过深入理解Java中的基本和高级数据结构的实现与优化,开发者能够更好地利用Java标准库中提供的工具来解决问题,并在必要时实现自定义的数据结构以满足特定的需求。接下来的章节将详细探讨Java实现线性表、栈、队列、链表、数组、树、图等数据结构的细节,以及它们在实际中的应用。
3. 线性表、栈、队列、链表、数组、树、图
3.1 线性表、栈、队列、链表的实现与应用
3.1.1 各结构的特点与应用场景分析
线性表是一种基本的数据结构,它由一系列节点组成,每个节点除了存储数据外,还通过指针连接到下一个节点。在Java中,线性表可以通过数组或链表来实现。数组是一种静态的数据结构,适合于元素数量固定且已知的情况,因为它提供了快速的随机访问能力。而链表是一种动态的数据结构,它的长度可以动态改变,更适用于频繁的插入和删除操作。
栈是一种后进先出(LIFO)的数据结构,它只允许在表的一端进行插入和删除操作。栈的典型应用包括函数调用堆栈、表达式求值等。队列是一种先进先出(FIFO)的数据结构,与栈不同的是,它允许在表的一端插入元素,在另一端删除元素,这使得队列成为了处理排队操作的理想选择,如打印队列、任务调度等。
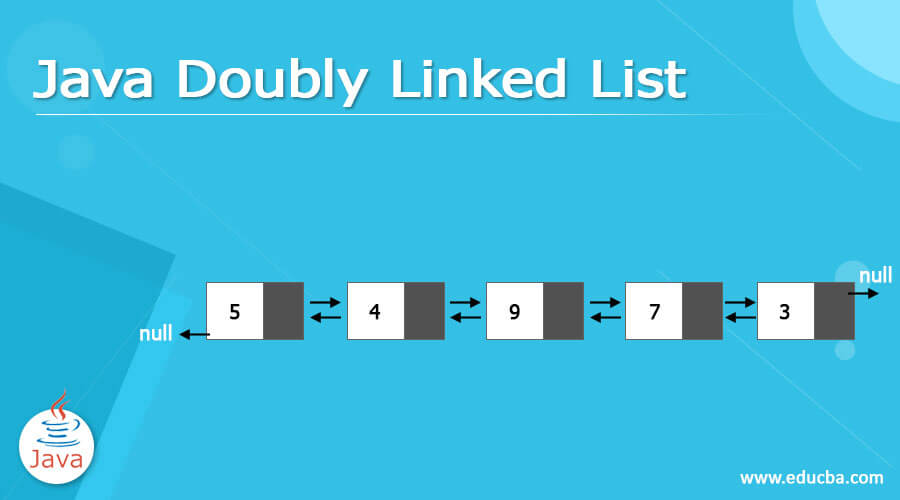
链表是由一系列节点构成的集合,每个节点包含数据域和指向下一个节点的指针。链表根据指针的不同分为单向链表、双向链表和循环链表。链表的灵活性使得其在实现动态内存管理方面有着广泛的应用,尤其是在插入和删除操作频繁的场合。
3.1.2 Java中线性结构的封装和使用
在Java中,线性表可以通过数组实现,也可以通过链表实现。Java提供了封装好的类来简化线性结构的使用。以ArrayList为例,它内部使用数组实现,但对外提供了动态数组的功能。
List<Integer> list = new ArrayList<>();
list.add(1);
list.add(2);
list.add(3);
// 动态扩展数组容量
list.add(100);
// 随机访问元素
int firstElement = list.get(0);
链表的实现则需要手动管理节点的创建和连接,如下所示,定义了一个简单的单向链表节点:
class ListNode {
    int val;
    ListNode next;
    ListNode(int x) {
        val = x;
        next = null;
    }
}

class LinkedList {
    ListNode head;
    public void add(int value) {
        ListNode newNode = new ListNode(value);
        if (head == null) {
            head = newNode;
        } else {
            ListNode current = head;
            while (current.next != null) {
                current = current.next;
            }
            current.next = newNode;
        }
    }
}
通过封装,我们无需关注链表节点的内存分配和释放,可以更加专注于业务逻辑的实现。这为我们处理复杂的数据结构提供了便利,同时也隐藏了底层的复杂性。
3.2 树、图的实现与应用
3.2.1 树和图的数据结构概念及分类
树是一种非线性的数据结构,它由节点和连接节点的边组成,具有层次结构的特点。树的根节点位于最顶端,其他节点可以有子节点,但子节点的个数有一个上限,称为分支因子。树结构的典型应用包括文件系统的目录结构、组织结构图等。
图是由顶点(节点)和边组成的复杂数据结构,表示元素之间的二元关系。图可以分为有向图和无向图,有向图表示的是节点之间的单向关系,而无向图则表示双向关系。图的广泛应用包括社交网络、路由算法、地图导航等。
3.2.2 Java中树和图的实现及其应用实例
在Java中,树的实现可以通过多种方式完成,例如二叉树、B树、红黑树等。二叉树是一种每个节点最多有两个子节点的树形数据结构,它是实现其他树结构的基础。下面是一个简单的二叉树节点的实现:
class TreeNode {
    int val;
    TreeNode left;
    TreeNode right;
    TreeNode(int x) {
        val = x;
        left = null;
        right = null;
    }
}

class BinaryTree {
    TreeNode root;
    // 插入节点的方法
    public void insert(int value) {
        root = insertRec(root, value);
    }
    private TreeNode insertRec(TreeNode root, int value) {
        if (root == null) {
            root = new TreeNode(value);
            return root;
        }
        if (value < root.val) {
            root.left = insertRec(root.left, value);
        } else if (value > root.val) {
            root.right = insertRec(root.right, value);
        }
        return root;
    }
}
图的实现需要考虑节点之间的连接关系。在Java中,图可以使用邻接矩阵或邻接列表来表示。以下是一个使用邻接列表实现的无向图的例子:
import java.util.*;

class Graph {
    private int V;   // 顶点的个数
    private LinkedList<Integer> adj[]; // 邻接表
    Graph(int v) {
        V = v;
        adj = new LinkedList[v];
        for (int i = 0; i < v; ++i)
            adj[i] = new LinkedList();
    }
    // 添加边到图中
    void addEdge(int v, int w) {
        adj[v].add(w);
        adj[w].add(v);
    }
}
在实际应用中,可以根据不同的需求选择合适的树和图的实现方式。例如,在实现搜索引擎的页面排名算法时,可以利用图的数据结构;而在处理XML文档的结构时,则更适合使用树形结构。
通过本章节的介绍,我们了解到线性表、栈、队列、链表、数组、树和图等数据结构的基本概念、特点以及在Java中的实现和应用。下一章我们将深入探讨排序和查找算法的理论与实践。
4. 排序和查找算法
4.1 排序算法理论与实践
4.1.1 排序算法的基本概念与分类
排序算法是将一组数据按照特定顺序进行排列的算法。在计算机科学中,排序算法是基本且重要的操作之一,广泛应用于数据处理、数据库查询优化、以及各种算法的预处理阶段。排序算法可以根据是否使用额外的存储空间以及数据的比较和交换方式来分类。按照空间复杂度划分,排序算法可以分为原地排序和非原地排序。根据比较和交换方式的不同,排序算法又可以分为比较排序和非比较排序。
原地排序算法不需要额外的存储空间或者只使用固定数量的变量,如插入排序和快速排序。非原地排序算法则需要额外的存储空间,如归并排序和堆排序。比较排序算法通过比较数据元素的大小来进行排序,例如冒泡排序、选择排序和希尔排序。非比较排序则不依赖元素间的比较,而是通过元素的其他属性来进行排序,比如计数排序、基数排序和桶排序。
4.1.2 排序算法的时间复杂度分析
时间复杂度是衡量排序算法效率的重要指标,它描述了执行算法所需的运算次数与输入数据规模之间的关系。时间复杂度通常用大O符号表示。在排序算法中,常见的时间复杂度有O(n^2)、O(nlogn)、O(n)等。
- O(n^2)的排序算法主要包括冒泡排序、选择排序、插入排序和希尔排序。这些算法比较适合数据规模较小的场景。
- O(nlogn)是许多高效排序算法的时间复杂度,包括归并排序、快速排序和堆排序。在数据规模较大时,O(nlogn)的算法通常有较好的性能表现。
- O(n)的排序算法非常稀有,通常只在特定条件下有效,如计数排序和基数排序,它们往往依赖于数据的特有属性。
排序算法的选择取决于数据的规模、数据的分布特性以及是否需要稳定的排序等因素。例如,如果数据量非常大且没有重复元素,快速排序可能是最优选择;如果数据量不大且大部分已经有序,插入排序可能会更快。
4.2 查找算法理论与实践
4.2.1 查找算法的基本概念与分类
查找算法用于从一组数据中找出满足特定条件的元素。根据查找过程是否需要数据事先被排序,查找算法可以分为两大类:顺序查找和二分查找。
顺序查找是最简单的查找算法之一,也称为线性查找,适用于无序数组和链表。它从头到尾依次检查每个元素,直到找到所需的目标元素或遍历完所有元素。顺序查找的时间复杂度为O(n),在最坏情况下,其性能与数据量成正比。
二分查找算法是高效的查找算法之一,需要数据先进行排序。它通过反复将数据集分为两部分,并确定目标值所在的半部分来减少搜索范围。二分查找的时间复杂度为O(logn),适用于大数据集的查找操作。
除了顺序查找和二分查找,还有诸如哈希查找、跳表查找、二叉搜索树查找等高级查找算法。这些算法各有优劣,适用于不同的应用场景。
4.2.2 查找算法的效率比较与选择
查找算法的效率取决于数据的组织结构和数据量的大小。对于无序数据集,顺序查找是最直接的方法,但其效率较低。当数据集较大且已排序时,二分查找或其他基于二叉搜索的查找算法会更加高效。
哈希查找通过哈希函数将键值映射到存储位置,使得查找操作的平均时间复杂度接近O(1)。但哈希查找的缺点是它不支持有序的遍历,并且在哈希冲突时效率可能会降低。
跳表是一种可以进行快速查找、插入和删除操作的有序链表,它在链表基础上增加了一些指向其他节点的指针,通过多层结构加快查找效率。跳表的时间复杂度为O(logn)。
二叉搜索树是一种有序树结构,其中每个节点的左子树只包含小于当前节点的数,右子树只包含大于当前节点的数。二叉搜索树的查找、插入和删除操作的时间复杂度均为O(logn),但最坏情况下(如输入数据已经有序),其性能会退化至O(n)。
选择合适的查找算法需要考虑数据的特性以及操作的类型。例如,在需要频繁插入和删除操作的环境中,跳表和哈希表可能更合适;而在查找密集型且数据稳定的环境中,有序数组配合二分查找可能是最佳选择。
// 示例代码:Java中二分查找算法的实现
public static int binarySearch(int[] sortedArray, int target) {
    int left = 0;
    int right = sortedArray.length - 1;
    while (left <= right) {
        int mid = left + (right - left) / 2;
        if (sortedArray[mid] == target) {
            return mid; // 查找成功,返回索引
        } else if (sortedArray[mid] < target) {
            left = mid + 1;
        } else {
            right = mid - 1;
        }
    }
    return -1; // 查找失败,返回-1
}
在上述代码中, binarySearch 函数接受一个已排序的数组 sortedArray 和一个目标值 target ,通过二分查找算法找到目标值并返回其在数组中的索引。如果目标值不存在于数组中,则返回-1。二分查找的时间复杂度为O(logn),确保了即使在大型数据集上查找操作也能高效执行。
通过本章节的介绍,我们可以看到排序和查找算法在计算机科学中的重要性。选择合适的算法不仅可以优化程序的性能,还可以大幅度提升软件系统的运行效率。接下来的章节,我们将深入探讨如何在实际Java开发中应用这些算法,并通过实际的案例来进一步理解这些理论知识。
5. Java数据结构高级应用与实践
5.1 Java标准库中数据结构使用
5.1.1 ArrayList、LinkedList等集合的深入分析
在Java的标准库中, ArrayList 和 LinkedList 是两种常见的集合类,用于存储线性数据结构中的元素。它们都实现了 List 接口,但内部实现和性能特点各不相同。
ArrayList 基于动态数组的数据结构,它在数组的基础上增加了动态扩容的功能,使得其大小可以动态改变。当数组容量不足时, ArrayList 会创建一个新的更大的数组,并将原有数据复制过去。这种基于索引的快速查找操作是 ArrayList 的强项,但其插入和删除操作可能需要移动大量元素,时间复杂度为O(n)。
ArrayList<String> arrayList = new ArrayList<>();
arrayList.add("Element1");
arrayList.add("Element2");
String firstElement = arrayList.get(0); // 快速访问
相反, LinkedList 是基于双向链表实现的,它不支持基于索引的快速访问,但插入和删除操作相对高效,时间复杂度为O(1)(如果已知插入位置的情况下)。链表通过指针连接各个元素,因此在内存中可能不连续存储。
LinkedList<String> linkedList = new LinkedList<>();
linkedList.add("Element1");
linkedList.add("Element2");
String firstElement = linkedList.getFirst(); // 需要遍历链表
5.1.2 HashMap、TreeMap等映射的深入分析
HashMap 和 TreeMap 是Java中两种常见的映射实现,用于存储键值对数据。
HashMap 基于哈希表实现,它根据键的 hashCode() 计算出桶(bucket)位置,然后将键值对存储在桶中。 HashMap 提供了快速的查找、插入和删除操作,其时间复杂度平均为O(1)。但请注意,这并不意味着每个操作都一定是O(1),特别是在哈希冲突严重的情况下,性能可能会下降。
HashMap<String, Integer> hashMap = new HashMap<>();
hashMap.put("Key1", 100);
int value = hashMap.get("Key1"); // 快速访问
TreeMap 则基于红黑树实现,它保证了键的有序性。这意味着它不仅能够快速检索键值对,还能维护键的顺序。然而,由于其内部结构的复杂性, TreeMap 在插入和删除操作上通常比 HashMap 慢,时间复杂度为O(log n)。
TreeMap<String, Integer> treeMap = new TreeMap<>();
treeMap.put("Key1", 100);
int value = treeMap.get("Key1"); // 有序访问
5.2 学习资料补充
5.2.1 算法复杂度分析的理论与实践
算法复杂度分析是评估算法性能的基础,主要分为时间复杂度和空间复杂度两部分。理解算法复杂度对于选择或设计高效算法至关重要。
时间复杂度是对算法执行时间随输入数据规模增长的变化趋势的描述。常见的有O(1)常数时间复杂度、O(log n)对数时间复杂度、O(n)线性时间复杂度、O(n log n)线性对数时间复杂度、O(n^2)平方时间复杂度等。
空间复杂度则是对算法执行过程中临时占用存储空间大小的描述,同样也使用大O符号表示。空间复杂度的分析不仅包括数据存储空间,还包括算法执行过程中递归调用栈的大小等。
在实践中,推荐使用Big O表示法来描述算法复杂度,这是因为Big O关注的是随着输入数据规模的增长,算法运行时间或占用空间的增长趋势。
5.3 MyEclipse实践平台
5.3.1 MyEclipse集成开发环境配置
MyEclipse是一个功能强大的IDE,支持多种开发环境。配置MyEclipse主要涉及工作空间的设置、插件安装以及JDK配置等。
- 工作空间设置:选择一个合适的目录作为MyEclipse的工作空间,该目录用于存储所有工程相关的文件。
// 工作空间配置示例
String workspacePath = "E:\\MyEclipseWorkspace";
IWorkspace workspace = ResourcesPlugin.getWorkspace();
workspaceRoot = workspace.getRoot();
workspaceRoot.setLocation(new Path(workspacePath));
-
插件安装:可以通过Help菜单下的Install New Software功能进行插件安装,以增强MyEclipse的功能。
-
JDK配置:在Preferences中设置Java的JDK路径,以确保MyEclipse可以正确地编译和运行Java代码。
// JDK配置示例
Preferences preferences = JavaCore.getPlugin().getPluginPreferences();
preferences.setValue(JavaCore.CORE_JAVA_BUILD议论_PATH, "C:\\Program Files\\Java\\jdk1.8.0_201");
5.3.2 实战项目:构建复杂的数据结构应用
构建一个复杂的数据结构应用需要选择合适的数据结构,并对其操作进行编码实现。以下是一个基于 HashMap 的简单用户管理系统示例:
// 用户管理系统示例
public class UserManager {
    private Map<String, User> userMap = new HashMap<>();

    public void addUser(String userId, User user) {
        userMap.put(userId, user);
    }

    public User getUser(String userId) {
        return userMap.get(userId);
    }

    public boolean deleteUser(String userId) {
        return userMap.remove(userId) != null;
    }
}
在这个例子中, HashMap 被用来快速检索用户数据。 User 类是一个简单的POJO类,包含用户的基本信息,如姓名和邮箱等。
实践项目不仅能够加深对Java数据结构使用的理解,还能提高解决实际问题的能力。在MyEclipse中,通过建立项目、编写代码、测试运行和调试,可以构建并完善这样的数据结构应用。
简介:《Java数据结构全套》是一个全面的学习资源集合,它为Java编程语言学习者提供了从基础知识到高级应用的数据结构学习路径。该资源包括叶核亚编著的《数据结构(Java版)(第3版)》电子教案、MyEclipse例题与习题、JDK数据结构示例以及丰富的配套学习资料。通过系统学习,学习者能够深入理解数据结构基础理论、Java实现、算法逻辑、物理存储及实际应用。此外,MyEclipse为实践提供平台,JDK示例帮助理解标准库中数据结构的使用,而配套资料则是巩固学习成果、深入理解数据结构优化策略的宝贵资源。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献16条内容

所有评论(0)