构建多功能计算器:数据结构课程设计

简介:数据结构课程设计要求学生综合运用数据管理原理与编程技能,完成一个具备图形用户界面的计算器应用。该设计可能会用到链表、栈、队列、树结构、哈希表等数据结构,涉及到图形用户界面设计、事件驱动编程、错误处理以及内存管理等编程概念。此外,该课程设计还会涵盖编译原理基础和文件操作技能,是对学生综合编程能力的一次全面考验。
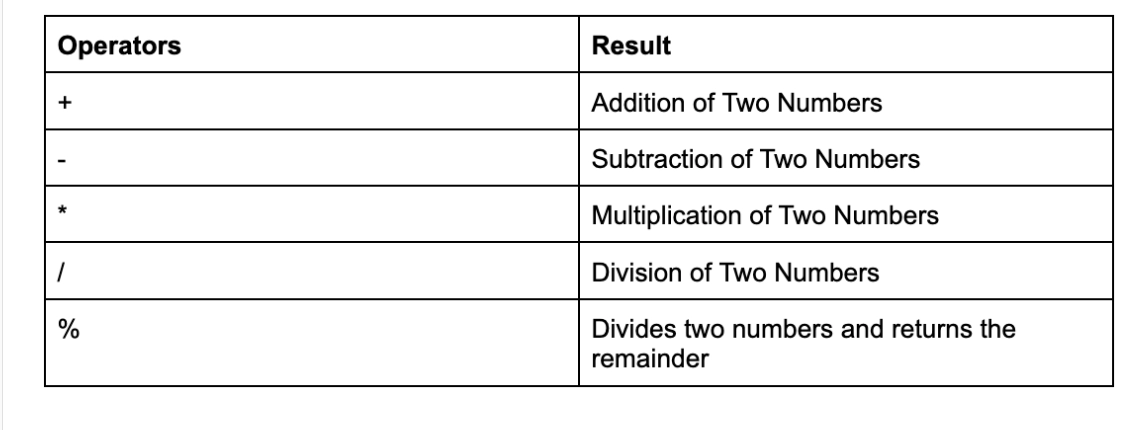
1. 链表的运用与历史记录管理
在本章节中,我们将深入探讨链表这种数据结构在历史记录管理方面的应用,以及它是如何适应不同的数据存储需求的。
1.1 链表的历史回顾与数据管理原理
链表作为一种基础的数据结构,其历史可以追溯到计算机科学的早期。与数组相比,链表允许更灵活地插入和删除元素,因为它不需要预先分配一块连续的内存空间。链表的每个节点包含数据和一个指向下一个节点的指针。这种结构使得链表在动态数据管理方面表现出色。
1.2 链表在历史记录管理中的作用
历史记录管理是链表在实际应用中的一个重要领域。在文本编辑器、图形界面应用程序以及许多其他需要记录和恢复历史状态的应用中,链表都能够提供一个高效的解决方案。链表中的每个节点可以代表一个历史状态,允许用户执行”撤销”和”重做”操作。
1.3 链表优化策略与性能分析
为了提高链表操作的效率,可以采取一些优化策略,如使用双向链表或循环链表。这些变体可以提高某些特定操作的速度,比如从链表的末尾开始访问节点。性能分析是评估和提升链表操作效率的关键,本章将讨论如何识别性能瓶颈并应用这些优化方法。
以上是对第一章内容的概述,接下来的章节中我们将更详细地探讨链表的各种操作、它的历史记录管理特性,以及一些具体的优化策略。
2. 栈在运算符优先级处理中的应用
2.1 栈的基本概念与数据结构
2.1.1 栈的定义和特性
栈是一种遵从后进先出(LIFO, Last In First Out)原则的抽象数据结构,它只允许在结构的一端进行插入和删除操作。这一端称为栈顶,另一端称为栈底。在栈的使用过程中,最后一个进入栈中的元素必须是第一个被删除的,这种操作模式类似于现实生活中的堆叠物品。
2.1.2 栈的操作:入栈和出栈
- 入栈(Push) :向栈中添加一个新的元素。这个元素会成为新的栈顶元素。
- 出栈(Pop) :从栈中移除最顶端的元素,并且返回被移除的元素。栈顶元素被移除之后,下一个元素将成为新的栈顶元素。
栈操作示意图:

栈顶
  |
  v
[3] <- [2] <- [1] <- 栈底
2.2 运算符优先级与栈的结合
2.2.1 运算符优先级解析原理
在表达式的求值过程中,运算符优先级的解析是关键步骤之一。根据运算符优先级表,不同优先级的运算符在表达式求值时的执行顺序有所不同。通常,优先级高的运算符会先进行计算。
2.2.2 栈在优先级判断中的实现
利用栈结构来处理运算符优先级,其核心思想是把运算符临时存储在栈中,并遵循优先级规则来决定何时将栈中的运算符与操作数结合。以下是使用栈处理表达式中运算符优先级的简单算法步骤:
- 初始化两个栈:一个用于存储操作数(数字栈),另一个用于存储运算符(操作符栈)。
- 从左到右扫描表达式。
- 遇到操作数时,直接将其推入数字栈。
- 遇到运算符时:
- 若操作符栈为空或栈顶运算符为左括号 ‘(‘,则直接将当前运算符入栈。
- 否则,将栈顶运算符与当前运算符比较,若当前运算符优先级高于栈顶运算符,或栈顶为左括号,则当前运算符入栈。
- 否则,弹出栈顶运算符,并将其与数字栈顶的两个操作数进行运算,然后将运算结果压入数字栈。重复此过程,直到当前运算符可以入栈。 - 遇到左括号 ‘(‘,直接入栈。
- 遇到右括号 ‘)’,依次弹出操作符栈顶的运算符,并进行运算,直到遇到左括号为止,然后弹出左括号。
- 表达式扫描完毕后,依次弹出操作符栈中的所有运算符并运算,直到操作符栈为空。
2.3 栈在计算器中的具体应用
2.3.1 表达式求值算法
在计算器程序中实现表达式求值时,可以使用栈来处理操作数和运算符。以下是一个简化的表达式求值算法的伪代码:
function evaluateExpression(expression):
    numberStack = new Stack()
    operatorStack = new Stack()
    for each token in expression.split():
        if token is a number:
            numberStack.push(token)
        else if token is an operator:
            while not operatorStack.isEmpty() and
                  hasLowerPrecedence(token, operatorStack.peek()):
                numberStack.push(applyOperator(operatorStack.pop(),
                                              numberStack.pop(),
                                              numberStack.pop()))
            operatorStack.push(token)
    while not operatorStack.isEmpty():
        numberStack.push(applyOperator(operatorStack.pop(),
                                      numberStack.pop(),
                                      numberStack.pop()))

    return numberStack.pop()
2.3.2 栈应用实例分析
假设有一个简单的后缀表达式求值问题,我们要计算表达式 “3 4 + 2 * 7 /” 的结果。使用栈结构进行如下处理:
- 初始化两个栈,操作数栈和运算符栈。
- 按顺序扫描表达式中的元素:
- “3” 和 “4” 是操作数,直接入操作数栈。
- “+” 是运算符,与栈顶的 “4” 和 “3” 结合,计算结果 “7” 入操作数栈。
- “2” 是操作数,入操作数栈。
- “*” 是运算符,与栈顶的 “7” 和 “2” 结合,计算结果 “14” 入操作数栈。
- “7” 是操作数,入操作数栈。
- “/” 是运算符,与栈顶的 “14” 和 “7” 结合,计算结果 “2” 入操作数栈。 - 最后,操作数栈顶的元素即为表达式的结果。
通过这个实例,我们可以看到栈在处理运算符优先级和表达式求值中的关键作用。它不仅简化了计算过程,而且确保了运算顺序的正确性。
3. 队列实现多步撤销功能
3.1 队列的基本原理和操作
3.1.1 队列的数据结构定义
队列是一种先进先出(FIFO, First In First Out)的数据结构,与栈(后进先出)相对。队列中的元素被添加在尾部,并从头部移除。在多步撤销功能中,队列用于追踪用户的每一步操作,确保可以准确地撤销到任意历史状态。
3.1.2 队列的基本操作:入队和出队
队列的两个基本操作是入队(enqueue)和出队(dequeue)。入队操作在队列尾部添加一个元素,而出队操作则从队列头部移除一个元素。队列的这一特性使得它非常适合用来实现撤销操作的历史记录功能。
// C语言实现队列的入队和出队操作
#include <stdio.h>
#include <stdlib.h>

typedef struct Node {
    int data;
    struct Node* next;
} Node;

typedef struct Queue {
    Node* front;
    Node* rear;
} Queue;

// 初始化队列
Queue* createQueue() {
    Queue* q = (Queue*)malloc(sizeof(Queue));
    q->front = q->rear = NULL;
    return q;
}

// 入队操作
void enqueue(Queue* q, int value) {
    Node* temp = (Node*)malloc(sizeof(Node));
    temp->data = value;
    temp->next = NULL;

    if (q->rear == NULL) {
        q->front = q->rear = temp;
        return;
    }

    q->rear->next = temp;
    q->rear = temp;
}

// 出队操作
int dequeue(Queue* q) {
    if (q->front == NULL) {
        return -1;
    }

    Node* temp = q->front;
    int data = temp->data;
    q->front = q->front->next;

    if (q->front == NULL) {
        q->rear = NULL;
    }

    free(temp);
    return data;
}

int main() {
    Queue* q = createQueue();
    enqueue(q, 1);
    enqueue(q, 2);
    enqueue(q, 3);

    printf("%d ", dequeue(q)); // 输出:1
    printf("%d ", dequeue(q)); // 输出:2
    printf("%d\n", dequeue(q)); // 输出:3

    return 0;
}
3.2 撤销功能的算法实现
3.2.1 撤销功能的逻辑设计
撤销功能的算法设计核心在于维护一个操作序列的队列。每当用户执行一个操作时,该操作被添加到队列中。用户进行撤销操作时,最新一次的操作被从队列中弹出并执行逆操作,恢复到前一个状态。若操作序列为空,则表示不能再进行撤销。
3.2.2 队列在撤销功能中的应用
在撤销功能中,队列的使用确保了操作的可逆性和历史状态的可追溯性。通过队列的先进先出特性,可以快速地访问和还原历史操作,实现多步撤销和重做功能。
3.3 队列在交互式应用中的优化
3.3.1 响应式撤销策略
在某些应用场景中,撤销操作需要更加智能和响应式。例如,当用户撤销至某个特定的历史点后,再次执行撤销操作应该能够直接跳过中间状态,直接回到上一个关键点,这需要队列中存储更多元的历史信息。
3.3.2 队列与用户界面的交互
撤销功能不仅需要在后端维护队列,还需要与用户界面进行良好的交互。撤销历史记录需要呈现给用户,让用户能够选择需要回退到的具体状态。这通常通过一个撤销菜单或历史列表来实现。
在使用队列实现撤销功能时,我们通常会遇到性能和内存管理上的挑战。随着操作的不断执行,队列可能会变得很大,因此需要考虑如何高效地管理内存,避免造成内存泄漏。此外,特定的应用场景下,可能需要对队列结构进行扩展,以支持更复杂的撤销逻辑和优化用户体验。
4. 树结构用于表达式解析
4.1 树结构的定义与特性
4.1.1 树的基本概念
在计算机科学中,树(Tree)是一种用于表示数据元素之间层次关系的非线性数据结构。它模拟了真实世界中的树状结构,具有一个根节点,其余的节点被划分为若干个互不相交的子集,这些子集本身又是一个树,并且称为根节点的子树。在树中,每个节点都有零个或多个子节点。树通常用于表达和实现具有层次或递归性质的数据结构。
4.1.2 二叉树及其特殊形态
二叉树是树结构的一种特殊形式,其中每个节点最多有两个子节点,通常被称为左子节点和右子节点。二叉树的特殊形态包括完全二叉树、满二叉树和平衡二叉树等。完全二叉树是指除最后一层外,其它层的节点数都达到最大个数,并且最后一层的节点都靠左排列。满二叉树是指每一层都有最大的节点数的二叉树。平衡二叉树(AVL树)是一种自平衡的二叉搜索树,任何节点的两个子树的高度差不超过1,这确保了树的平衡状态。
4.1.3 表达式树的基本概念
表达式树是用于表示算术表达式的二叉树。在这种树结构中,每个叶节点代表一个操作数(例如数字),每个内部节点代表一个运算符。表达式树允许我们以层次化的形式直观地表示表达式。例如,表达式 (3 + (4 * 5)) 可以表示为一棵树,其结构反映了操作符的优先级和括号指定的运算顺序。
4.2 表达式树构建过程
4.2.1 中缀表达式转后缀表达式
中缀表达式转为后缀表达式(也称为逆波兰表示法)是构建表达式树的前置步骤。中缀表达式是常见的算术表达式,例如 3 + 4 * 5 ,而后缀表达式则是 3 4 5 * + 。后缀表达式可以方便地通过栈操作转换成表达式树。
转换的算法过程通常使用一个栈来存储运算符,遵循运算符优先级规则,将遇到的运算符压入栈中,直到遇到优先级更低或同级的运算符。此时从栈中弹出运算符并将其作为右子节点,新遇到的运算符入栈作为左子节点。如此往复,直到整个表达式处理完毕。
4.2.2 表达式树的构建算法
构建表达式树的算法基于后缀表达式。从后缀表达式的第一个元素开始,创建一个新节点,如果该元素是操作数,则直接返回这个节点;如果该元素是运算符,则创建一个新节点作为这个运算符的根节点。递归地将后缀表达式的剩余部分作为左右子树,重复这一过程,直到所有元素处理完毕,最后一个运算符的节点即为表达式树的根节点。
def build_expression_tree(postfix_expr):
    stack = []
    # 一个辅助函数,用于将符号压入栈中,并创建表达式树节点
    def push_symbol(symbol):
        stack.append(Node(symbol))
    # 一个辅助函数,用于创建表达式树节点,并将两个栈顶节点作为左右子节点
    def make_node():
        right = stack.pop()
        left = stack.pop()
        node = Node(op symbol, left, right)
        return node
    for symbol in postfix_expr:
        if is_operator(symbol):
            push_symbol(make_node())
        else:
            push_symbol(Node(symbol))
    return stack.pop()

# 示例:构建表达式树
postfix = ['3', '4', '5', '*', '+']
expression_tree_root = build_expression_tree(postfix)
4.3 树结构在解析器中的应用
4.3.1 语法分析树的应用
语法分析树是编译器中用来表示源程序语法结构的树状图。在表达式解析中,语法分析树和表达式树非常相似,但语法分析树提供了更为丰富的结构信息,如操作符优先级和括号的使用,以表达更复杂的编程语言语法。语法分析器利用这种树结构来检测源代码中的语法错误,以及为后续的代码生成或代码优化阶段提供基础结构。
4.3.2 解析器设计与实现
解析器的设计与实现是一个将源代码转换为某种中间表示(例如语法分析树)的过程。解析器通常由两部分组成:词法分析器和语法分析器。词法分析器负责将字符流转换为标记(Token),而语法分析器则将这些标记转换成语法树。
编写解析器时,开发者需要定义语言的语法规则,这些规则通常使用上下文无关文法(Context-Free Grammar,CFG)描述。然后,使用一些工具如 Yacc 或 ANTLR,根据这些语法规则生成解析器代码。这些工具能够自动处理符号表的管理、语法树的构建等复杂任务。
在表达式解析中,解析器可以根据不同的需求,设计为不同的复杂程度。从简单的数学表达式解析器到完整的编程语言编译器前端,树结构在其中扮演了核心角色,帮助实现了数据结构与程序逻辑的高效映射。
5. 哈希表的快速查找和存储功能
5.1 哈希表的基本概念和原理
5.1.1 哈希表的数据结构定义
哈希表是一种通过哈希函数将键(key)映射到表中一个位置来访问数据的结构。这种方法允许快速插入、删除和查找操作,使得哈希表在需要快速查找的应用中非常有用。在理想情况下,哈希函数能够将每个唯一的键映射到一个独特的哈希值,即哈希表中的索引。然而,在实际情况中,由于键的数量通常大于哈希表的大小,哈希冲突是不可避免的。
哈希表通常由一系列“桶”(或“槽”)组成,每个桶可以存储一个或多个键值对。理想情况下,哈希表的大小应该是质数,这样可以更好地分散哈希值,减少冲突的概率。
5.1.2 哈希函数的构造与选择
哈希函数的设计对于哈希表的性能至关重要。一个好的哈希函数应该具有以下几个特点:
- 计算简单快速 :能够在较短的时间内计算出键的哈希值。
- 均匀分布 :能够尽可能均匀地将键映射到哈希表的各个位置上。
- 少有冲突 :减少不同键映射到同一个哈希值的次数。
选择合适的哈希函数是一个挑战,常见的哈希函数包括除法哈希、乘法哈希和组合哈希等。为了进一步提高性能,可以使用诸如MurmurHash或CityHash这样的加密散列函数。
5.2 哈希表的冲突解决策略
5.2.1 冲突的概念及产生原因
冲突是指两个不同的键通过哈希函数映射到了同一个哈希值。冲突的产生主要是因为哈希表的大小有限,而可能的键的数量是无限的。即使哈希函数能够均匀分布哈希值,由于哈希空间的限制,冲突仍然可能发生。
5.2.2 解决冲突的常用方法
解决哈希冲突的方法主要有以下几种:
- 开放寻址法 :当发生冲突时,按照某种规则在表中寻找下一个空位置。
- 链表法 :每个桶中存储一个链表,所有哈希到该桶的键值对都存储在链表中。
- 双散列法 :使用第二个哈希函数来解决冲突。
- 再哈希法 :在开放寻址法中,如果发现数据已经存在于目标位置,则使用另一个哈希函数。
链表法是最常用的一种方法,因为它简单且能够有效地处理冲突,同时保持相对较好的性能。
5.3 哈希表在计算器中的应用
5.3.1 快速查找功能的实现
在计算器应用中,哈希表可以用来实现快速的查找功能。例如,计算器可能会预存一些常用操作符或函数的定义,当用户输入这些符号时,计算器可以通过哈希表在常数时间内找到对应的操作。
class HashTable:
    def __init__(self, size=10):
        self.size = size
        self.table = [[] for _ in range(self.size)]

    def hash_function(self, key):
        return hash(key) % self.size

    def insert(self, key, value):
        index = self.hash_function(key)
        bucket = self.table[index]
        for item in bucket:
            k, v = item
            if k == key:
                item[1] = value
                return
        bucket.append([key, value])

    def search(self, key):
        index = self.hash_function(key)
        bucket = self.table[index]
        for item in bucket:
            k, v = item
            if k == key:
                return v
        return None

# 示例使用
calculator = HashTable()
calculator.insert("+", "Addition")
calculator.insert("-", "Subtraction")
print(calculator.search("+"))  # 输出: Addition
5.3.2 变量存储与管理
哈希表在计算器中也被广泛用于变量的存储和管理。每个变量名可以作为键,而其对应的值作为哈希表的值。当计算器需要存储或读取变量时,通过变量名快速定位到对应的值。
# 继续使用上面的HashTable类
calculator.insert("x", 10)
calculator.insert("y", 20)

print(calculator.search("x"))  # 输出: 10

# 更新变量值
calculator.insert("x", 30)
print(calculator.search("x"))  # 输出: 30
通过以上代码演示,哈希表的实现和其在计算器中存储变量的应用。哈希表保证了变量的快速读取和存储,而其冲突解决策略确保了即使有哈希冲突发生,系统依然能够有效地处理。
6. 图形用户界面(GUI)设计与实现
6.1 GUI的基本概念和组成
6.1.1 GUI的定义与重要性
图形用户界面(Graphical User Interface, GUI)是一种用户界面类型,通过图形和符号直观地呈现信息,使得用户通过屏幕上的视觉元素进行交互。GUI为计算机提供了与用户交互的新方式,与早期的命令行界面(CLI)相比,GUI通过鼠标点击、触摸和键盘输入等更加直观、更少记忆负担的方式操作计算机,极大提高了用户体验和操作效率。
GUI的重要性在于它降低了计算机使用的门槛,使非专业用户也能够轻松使用计算机。直观的图标、菜单和窗口等元素使得信息展示更加清晰,用户可以快速学习和使用软件。此外,GUI的美观和设计元素也反映了软件的品质,增强了用户的信任和满意度。
6.1.2 GUI的设计原则
良好的GUI设计需要遵循一些基本原则,以确保用户能够高效和愉快地使用软件。以下是几个核心的设计原则:
- 一致性(Consistency) :用户在使用软件时应该发现相似的操作和视觉元素在不同地方和不同上下文中的表现是一致的。
- 直接性(Direct manipulation) :用户应该能够直接与界面元素交互,而不是通过复杂或不直观的命令序列。
- 反馈(Feedback) :用户的每一个操作都应该得到及时且明确的反馈,以告知操作结果。
- 简洁性(Simplicity) :避免界面元素过载和不必要的复杂性,保持界面清晰和简洁。
- 容错性(Error prevention) :设计应该尽量避免错误的发生,并且在用户犯错时提供易于纠正的方法。
6.2 GUI开发工具与库的选择
6.2.1 常见GUI开发库比较
在现代软件开发中,有多种流行的GUI开发库可供选择。以下是一些广受欢迎的GUI开发库:
- Tkinter :Python的标准GUI库,提供了一套丰富的控件,易于学习和使用,适合初学者。
- Qt :一个功能强大的跨平台C++ GUI框架,它拥有大量的组件和工具,适用于复杂的桌面和嵌入式应用开发。
- Electron :使用JavaScript、HTML和CSS等Web技术开发跨平台的桌面应用。
- JavaFX :Java的现代化GUI开发库,提供清晰的API和丰富的组件,适用于构建富客户端应用。
选择合适的GUI开发库时,需要考虑项目需求、开发语言、团队技能和目标平台等因素。
6.2.2 开发环境的搭建
开发GUI应用前需要搭建相应的开发环境。这通常包括安装必要的软件开发工具、编译器、库和框架。对于某些开发环境,还需要配置特定的环境变量和依赖项。
以Python和Tkinter为例,搭建环境的步骤可能包括:
- 确保Python已安装。可通过运行
python --version或python3 --version来检查。 - 安装Tkinter库。大多数Python发行版默认包含Tkinter。可以使用
pip install tk确认是否已安装。 - 选择一个适合的IDE(如PyCharm、Visual Studio Code等)来编写代码并运行GUI应用。
确保开发环境搭建成功后,即可开始编写GUI应用。
6.3 GUI设计实例与交互逻辑
6.3.1 交互式界面设计原则
GUI设计的核心是确保用户与界面之间的交互流畅和自然。以下是一些交互式界面设计的原则:
- 使用标准控件 :遵循操作系统的标准控件设计,用户可以依靠已有的知识进行操作。
- 最小化步骤 :为了完成任务,用户应采取最少的步骤。
- 提供辅助信息 :在需要时提供提示信息,帮助用户理解界面功能。
- 视觉层次 :通过对比、大小和颜色等视觉元素突出显示重要信息和控件。
- 实时帮助 :提供实时帮助和状态信息,使用户能够理解应用的状态和下一步可能的动作。
6.3.2 事件处理与用户反馈
事件处理是GUI设计中的关键部分,它决定了用户与界面交互时的响应。事件处理机制包括事件生成、捕获和响应三个步骤:
- 事件生成 :用户与界面交互时(如点击按钮、输入文字等),操作系统会生成一个事件。
- 事件捕获 :GUI框架捕获这些事件,并根据事件类型调用相应的事件处理函数。
- 事件响应 :事件处理函数根据事件的具体内容,执行相应的逻辑处理。
例如,在Python和Tkinter中,可以使用 bind() 方法将事件处理函数绑定到特定的事件上:
import tkinter as tk

def on_button_click(event):
    print("Button was clicked!")

root = tk.Tk()
button = tk.Button(root, text="Click Me")
button.bind("<Button-1>", on_button_click)  # 绑定鼠标左键点击事件
button.pack()

root.mainloop()
在上述代码中,当用户点击按钮时, on_button_click 函数会被调用,打印出一条消息。
用户反馈则是指应用在接收到用户操作后给出的回应。反馈可以是视觉的(如按钮颜色变化)、听觉的(如声音提示)或触觉的(如振动反馈)。良好的用户反馈可以提升用户体验,让用户知道他们的操作已被识别和执行。
7. 计算器的综合应用与优化
在软件开发过程中,计算器应用是一个常见的项目,常被用来教学和演示算法与数据结构的应用。在本章中,我们将深入探讨计算器项目中常见的高级应用和优化技术,包括错误处理、编译原理的应用、算法优化、内存管理和文件操作等关键话题。
7.1 错误处理机制设计
为了提高用户体验,计算器应用中的错误处理机制必须既精确又人性化。这包括了:
7.1.1 错误类型与错误代码
各种错误类型需要明确定义,并且每种错误应当有一个对应的错误代码。例如:
-
E_INVALID_INPUT: 用户输入了无效的字符。 -
E_ARITHMETIC_ERROR: 发生了算术错误,比如除以零。 -
E_SYNTAX_ERROR: 表达式语法不正确。
7.1.2 异常处理与错误提示
在代码中,我们使用异常处理结构来捕获并处理这些错误。下面是一个伪代码的例子:
try {
    double result = evaluateExpression(expression);
    printResult(result);
} catch(E_INVALID_INPUT &error) {
    printError(E_INVALID_INPUT, error.getMessage());
} catch(E_ARITHMETIC_ERROR &error) {
    printError(E_ARITHMETIC_ERROR, error.getMessage());
} catch(E_SYNTAX_ERROR &error) {
    printError(E_SYNTAX_ERROR, error.getMessage());
}
7.2 编译原理在表达式解析中的应用
编译原理提供了强大的工具,用于将人类可读的表达式转换为机器可执行的指令。在计算器应用中,我们可以使用词法分析和语法分析来处理用户输入。
7.2.1 词法分析与语法分析
词法分析器将输入的字符串分解为一个个有意义的词素(tokens),比如数字、操作符和括号。语法分析器则根据预定义的语法规则,来组织这些词素,形成一个抽象语法树(AST)。
7.2.2 编译器前端技术的应用
通过应用编译器前端技术,我们可以将复杂的表达式转换为更简单的形式,这样后续处理如计算和优化会更加高效。这一过程通常涉及到了后缀表达式(逆波兰表示法)的生成。
7.3 算法优化与性能提升
为了提升计算器性能,对关键算法进行优化是必要的。我们需要对算法的时间复杂度和空间复杂度进行分析,找出瓶颈并进行优化。
7.3.1 算法复杂度分析
计算表达式的复杂度通常依赖于算法的类型。例如,递归算法可能会导致栈溢出,而迭代算法可能需要额外的内存空间。通过分析我们可以选择更为合理的算法,如使用栈实现的Shunting-yard算法来计算后缀表达式。
7.3.2 性能优化策略
优化策略可能包括:
- 尾递归优化 :将递归调用改写为循环,以减少栈空间的使用。
- 缓存中间结果 :存储已计算的中间结果,避免重复计算。
7.4 内存管理和C语言指针使用
C语言中,指针是管理内存的强大工具。在计算器项目中,合理管理内存与指针使用对于避免内存泄漏和提高程序稳定性至关重要。
7.4.1 内存分配与释放机制
正确地分配和释放内存是防止内存泄漏的关键。在C语言中,我们通常使用 malloc , calloc , realloc 和 free 来进行动态内存管理。
7.4.2 指针的高级用法与注意事项
指针可以用来实现复杂的数据结构如链表和树。但同时也需要小心处理指针,避免野指针和指针越界等错误。
int *ptr = malloc(sizeof(int)); // 分配内存
if (ptr != NULL) {
    *ptr = 42; // 使用指针
    free(ptr); // 释放内存
}
7.5 文件操作技能用于历史数据保存与加载
计算器通常需要具备保存用户操作历史的功能。这一功能的实现依赖于文件操作技术。
7.5.1 文件I/O操作流程
保存历史记录到文件通常包括打开文件、写入数据和关闭文件这几个步骤。
7.5.2 历史记录的序列化与反序列化
序列化是将历史数据结构转换为可以写入文件的格式,而反序列化则是读取文件并恢复数据结构。序列化可能使用文本或二进制格式,文本格式便于阅读和调试,二进制格式更加紧凑。
FILE *file = fopen("history.txt", "w");
if (file != NULL) {
    for (int i = 0; i < historySize; i++) {
        fprintf(file, "%s\n", history[i]);
    }
    fclose(file);
}
通过深入理解并应用上述技术,可以构建一个稳定且功能全面的计算器应用。这些技术涵盖了从处理错误到优化用户体验的各个重要方面。作为开发者,通过这样的实际应用案例,可以进一步提高你的专业技能和产品开发能力。
简介:数据结构课程设计要求学生综合运用数据管理原理与编程技能,完成一个具备图形用户界面的计算器应用。该设计可能会用到链表、栈、队列、树结构、哈希表等数据结构,涉及到图形用户界面设计、事件驱动编程、错误处理以及内存管理等编程概念。此外,该课程设计还会涵盖编译原理基础和文件操作技能,是对学生综合编程能力的一次全面考验。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献29条内容

所有评论(0)