MyCat/ShardingJDBC分库分表:一片搞定
目录
1、问题分析
单数据库进行数据存储具有以下性能瓶颈:
1、IO瓶颈:热点数据太多,数据库缓存不足,产生大量磁盘IO,效率低下。请求数据太多,带宽不够,网络IO瓶颈
2、CPU瓶颈:排序、分组连接查询、聚合统计等SQL会耗费大量CPU资源,请求太多,CPU出现瓶颈。
分库分表:将数据分散存储,使得单一数据库/表的数据量变小来缓解单一数据库的性能问题,从而达到提升数据库性能的目的。
2、拆分策略
拆分策略通常有如下两种方式
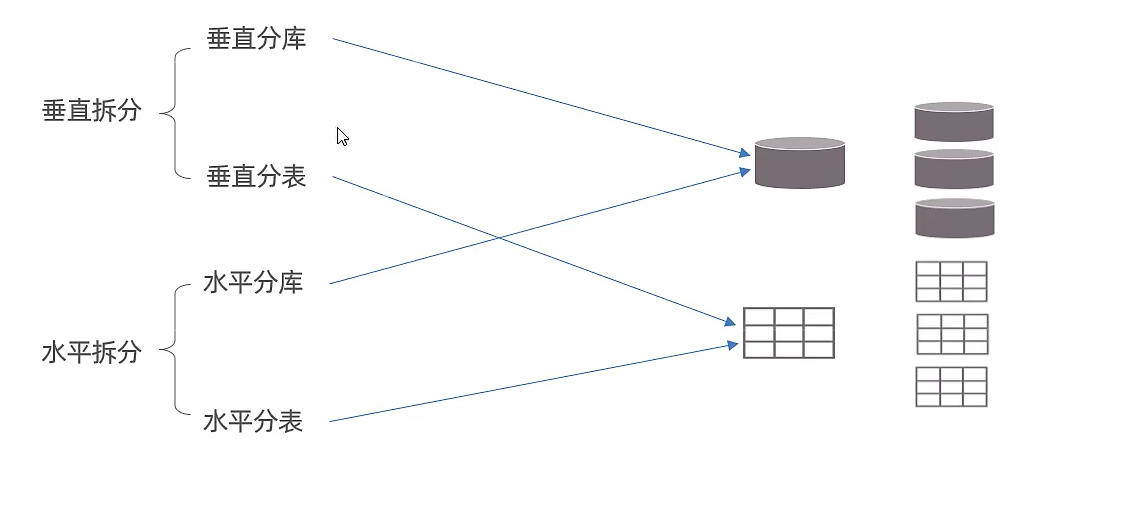
3、实现技术
shardingJDBC:基于AOP原理,在应用程序中对本地执行的SQL进行拦截,解析、改写、路由处理。需要自行编码配置实现,只支持Java语言,性能高
MyCat:数据库分库分表中间件,不用调整代码即可实现分库分表,支持多种语言,性能不及前者
4、MyCat
伪装协议:可以像使用mysql一样使用mycat
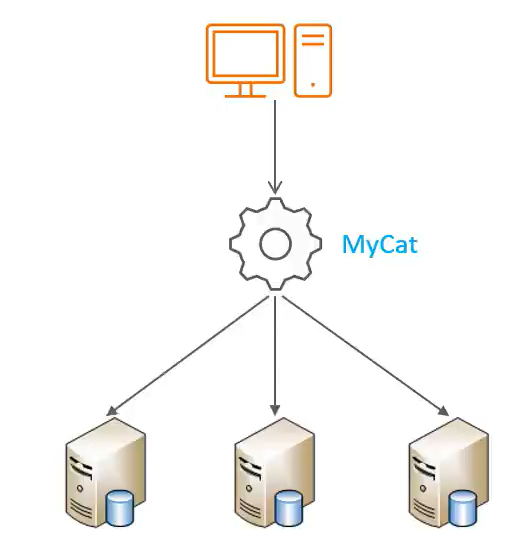
优势:性能稳定可靠,强大的技术团队,体系完善,社区活跃
5、实践
我们通过修改MyCat的配置文件,来实现MyCat对数据库分库分表的代理操作
5.1打开MyCat
从Github上将MyCat项目克隆下来
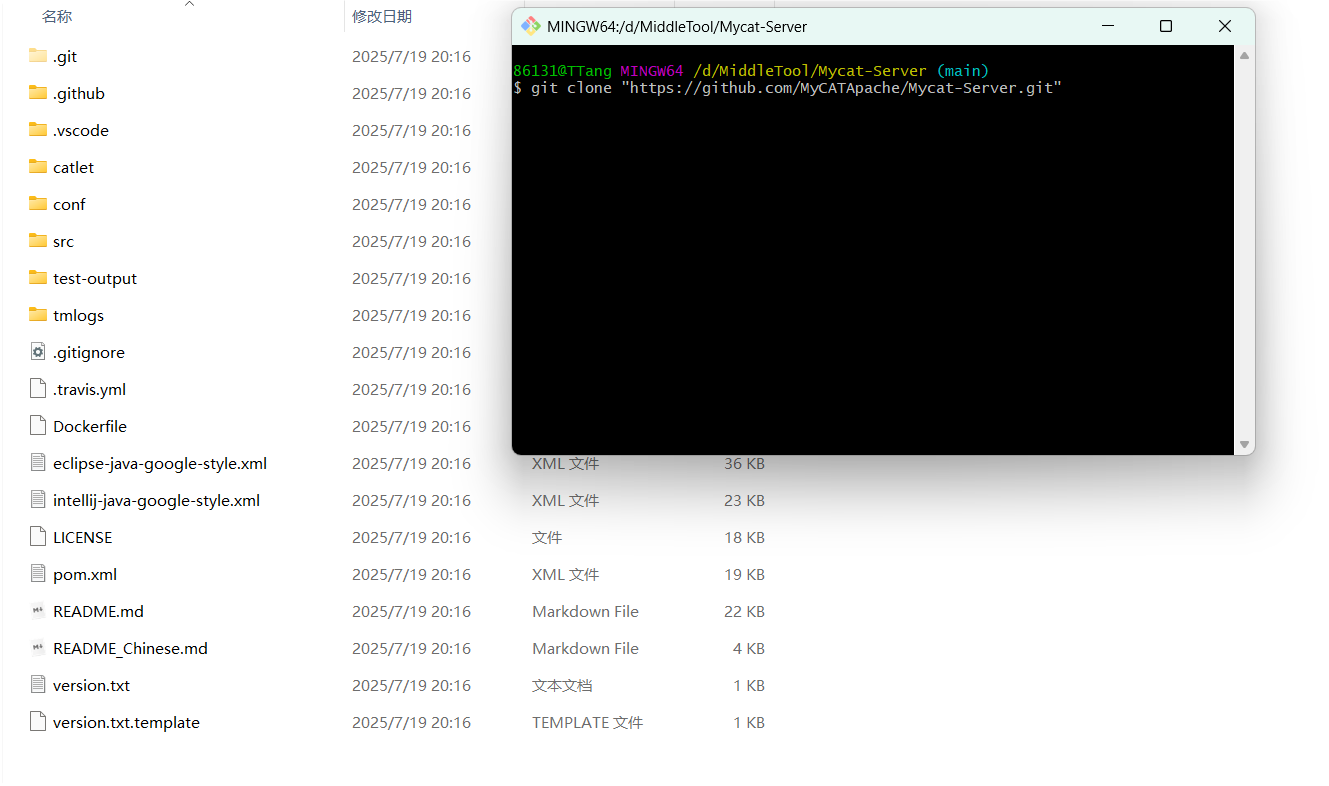
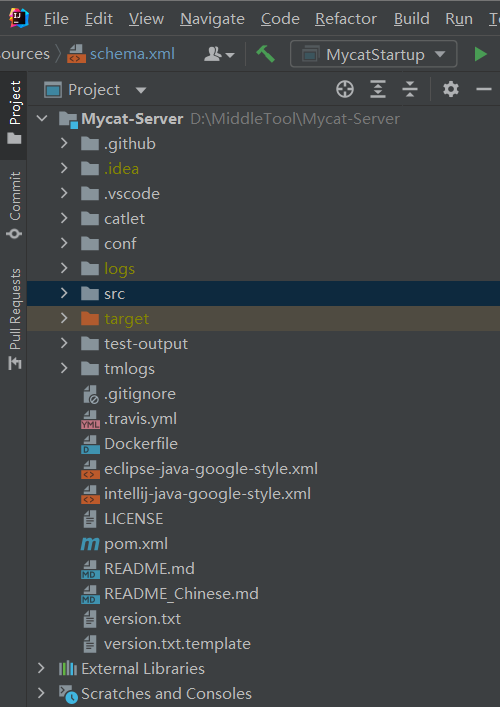
用idea打开,这里jdk版本使用1.8,版本过高过低可能会报错。
5.2修改配置文件
在MyCat中我们主要修改两个配置文件,分别对应数据节点配置和分片规则
5.2.1 schemal.xml
在这个配置文件里,要定义逻辑表以及数据节点。
<?xml version="1.0"?>
<!DOCTYPE mycat:schema SYSTEM "schema.dtd">
<mycat:schema xmlns:mycat="http://io.mycat/">
   <!-- 逻辑库,客户端连接时使用的库名 -->
   <schema name="TESTDB" checkSQLschema="false" sqlMaxLimit="100">
      <!-- 配置 tb_order 表,关联 mod - long 分片规则,对应 dn1、dn2、dn3 三个数据节点 -->
      <table name="tb_order" dataNode="dn1,dn2,dn3" rule="mod-long"/>
   </schema>

   <!-- 数据节点:关联具体物理库 -->
   <dataNode name="dn1" dataHost="localhost" database="db1"/>
   <dataNode name="dn2" dataHost="localhost" database="db2"/>
   <dataNode name="dn3" dataHost="localhost" database="db3"/>

   <!-- 配置物理数据库连接信息 -->
   <dataHost name="localhost" maxCon="200" minCon="10" balance="0"
           writeType="0" dbType="mysql" dbDriver="native" switchType="1"  slaveThreshold="100">
      <heartbeat>select user()</heartbeat>
      <!-- 本地 MySQL 实际的用户名和密码,需替换 -->
      <writeHost host="hostM1" url="localhost:3306" user="root" password="1111"/>
   </dataHost>
</mycat:schema>
5.2.2配置rule.xml
此文件用于定义分片规则。
<!DOCTYPE mycat:rule SYSTEM "rule.dtd">
<mycat:rule xmlns:mycat="http://io.mycat/">
   <!-- 表规则:指定对 tb_order 表的 id 字段,使用 mod - long 算法进行分片 -->
   <tableRule name="mod-long">
      <rule>
         <columns>id</columns>
         <algorithm>mod-long</algorithm>
      </rule>
   </tableRule>

   <!-- 分片算法:基于取模,count 为分片数量(对应 3 个数据节点) -->
   <function name="mod - long" class="io.mycat.route.function.PartitionByMod">
      <property name="count">3</property>
   </function>
</mycat:rule>
5.3数据库准备
我们在数据库中建立三个分库
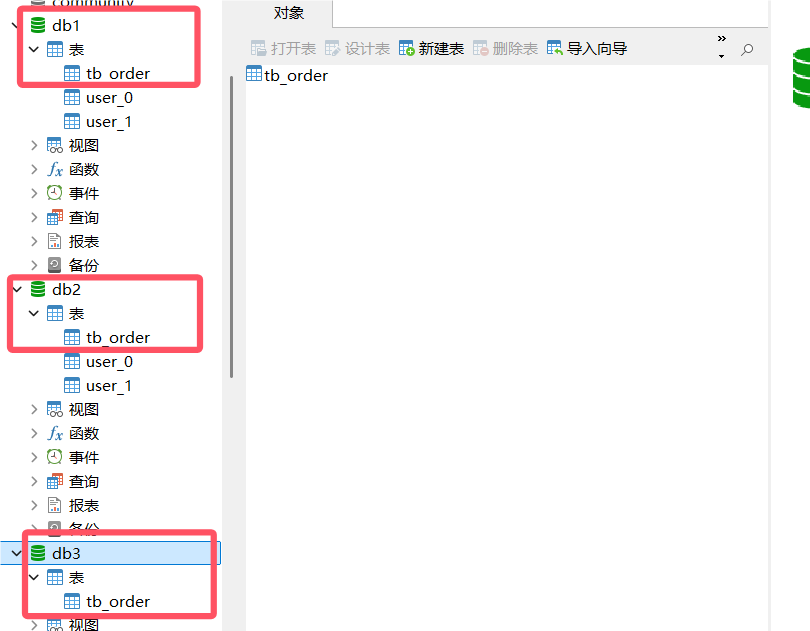
分别在三个数据库,创建三个相同的表
CREATE TABLE `tb_order`  (
  `id` int(0) NOT NULL COMMENT '只能是主键不能自增',
  `clientid` int(0) DEFAULT NULL COMMENT '客户id',
  `goods_id` int(0) DEFAULT NULL COMMENT '商品id',
  `shop_id` int(0) DEFAULT NULL COMMENT '商店Id',
  `create_time` datetime(0) DEFAULT NULL COMMENT '下单时间',
  `shard_date` date DEFAULT NULL COMMENT '分片时间',
  PRIMARY KEY (`id`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Dynamic;
5.4建立MyCat连接
MyCat默认端口为8066
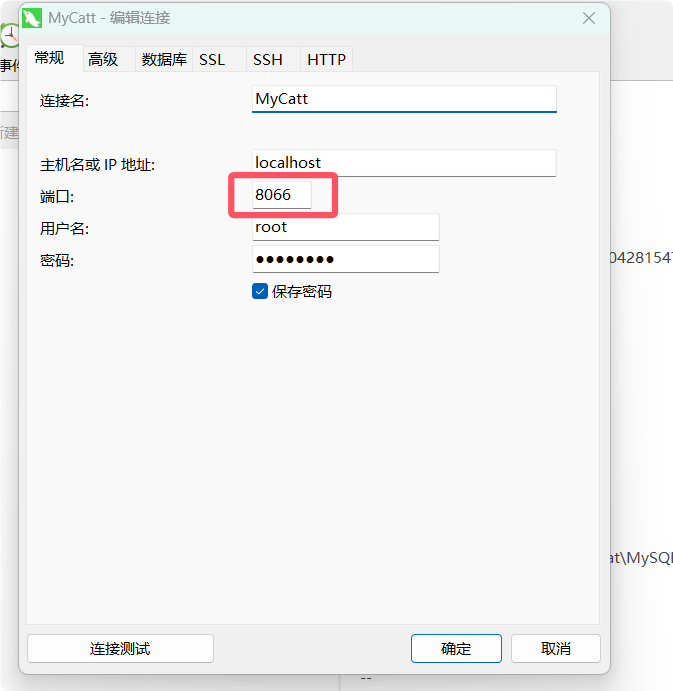
连接新建成功我们会发现该连接中有我们提前设定好的逻辑库,逻辑表
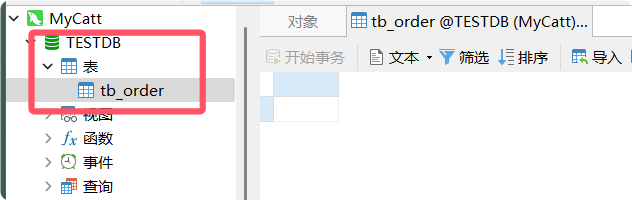
5.5插入数据测试
在TESTDB进行插入操作即可
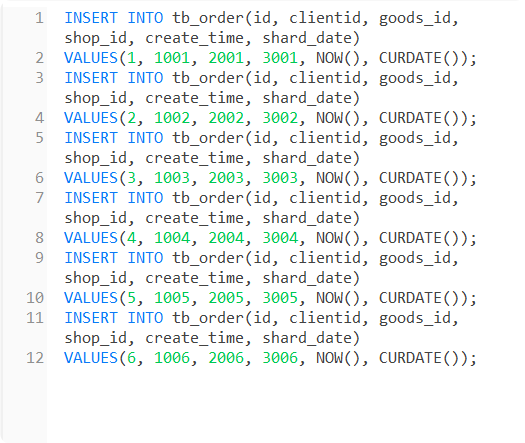
成功后,我们去查看其他库
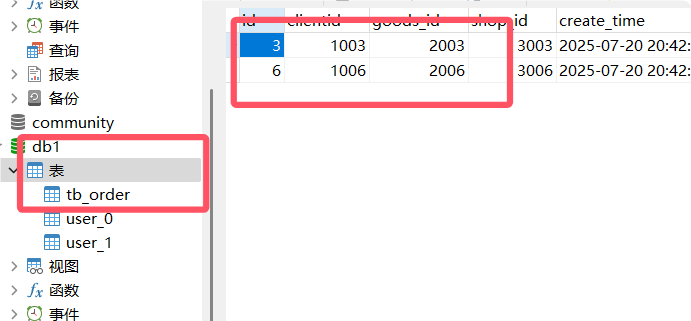
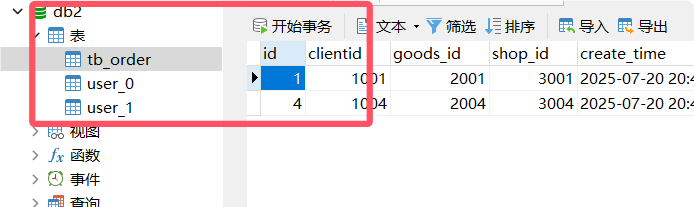
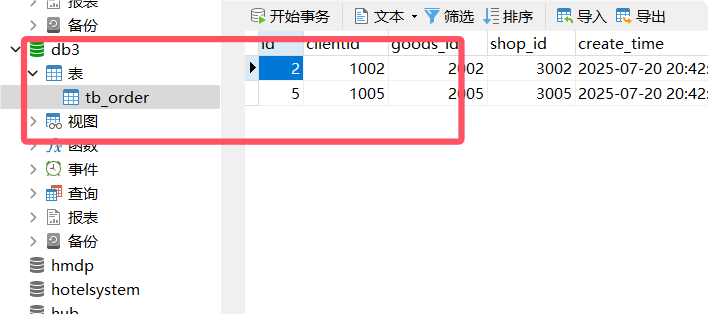
可以看到数据已经被正确的分库分表了
6、ShardingJDBC实现分库分表
ShardingJDBC相比于MyCat个人感觉要更简单一些,因为不需要下载,也不需要自己完全编写配置文件,只需要导包,配置相应参数即可
6.1 引入依赖(Maven)
<dependency>
    <groupId>org.apache.shardingsphere</groupId>
    <artifactId>shardingsphere-jdbc-core-spring-boot-starter</artifactId>
    <version>5.3.2</version> <!-- 使用最新稳定版 -->
</dependency>
6.2配置分表分库规则(.yml)
spring:
  shardingsphere:
    datasource:
      # 配置数据源(逻辑名称为 "order_db")
      names: order_db
      order_db:
        type: com.zaxxer.hikari.HikariDataSource
        driver-class-name: com.mysql.cj.jdbc.Driver
        url: jdbc:mysql://localhost:3306/order_db?useSSL=false
        username: root
        password: root
    rules:
      sharding:
        # 配置分表规则
        tables:
          t_order:  # 逻辑表名
            actual-data-nodes: order_db.t_order_${0..1}  # 实际表名(0和1两个表)
            table-strategy:  # 分表策略
              standard:
                sharding-column: order_id  # 分片键
                sharding-algorithm-name: order_inline  # 分片算法名称
        # 配置分片算法(INLINE表达式)
        sharding-algorithms:
          order_inline:
            type: INLINE
            props:
              algorithm-expression: t_order_${order_id % 2}  # 哈希取模:id%2=0→t_order_0,否则t_order_1
    # 打印SQL(调试用)
    props:
      sql-show: true
6.3.编写业务代码
使用方式与普通 JDBC 或 MyBatis 完全一致,ShardingJDBC 会自动拦截 SQL 并路由到正确的表。
我们对配置文件中的逻辑表进行 操作即可,ShardingJDBC会帮我们做进一步的处理

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献3条内容

所有评论(0)