JAVA面试宝典 -《分库分表实战:ShardingSphere 进阶》
分库分表实战:ShardingSphere 进阶
面向读者:中高级 Java 工程师
定位:实战 + 原理 + 性能优化
文章目录
开篇导语:为什么需要分库分表?
随着业务体量与访问量的 爆炸式增长,单库单表架构的瓶颈愈发凸显:
- 数据量过大:单表百万、千万、亿级行数,建索引、写删改、DDL 都变得异常缓慢。
- 并发压力:热点表行锁、页锁争夺、连接池耗尽,导致整体吞吐急剧下降。
- 维护成本高:备份、迁移、扩容都需停机,严重影响可用性。
为了解决这一系列问题,ShardingSphere 作为主流 分库分表中间件,在「分片路由」「分布式主键」「柔性事务」等方面提供了完善方案,成为电商、高并发场景下的必选组件。
ShardingSphere 核心能力回顾
在深入进阶之前,我们先快速回顾 ShardingSphere 的三大核心能力:
- 分库分表策略
- 取模(MOD):
user_id % N - 范围(RANGE):
2023-07-01 ~ 2023-07-31 - 哈希(HASH):一致性哈希环
- 取模(MOD):
- 分布式主键生成
- 雪花算法:Twitter、Leaf
- UUID:128 位全局唯一
- 自定义:Redis 自增、数据库号段
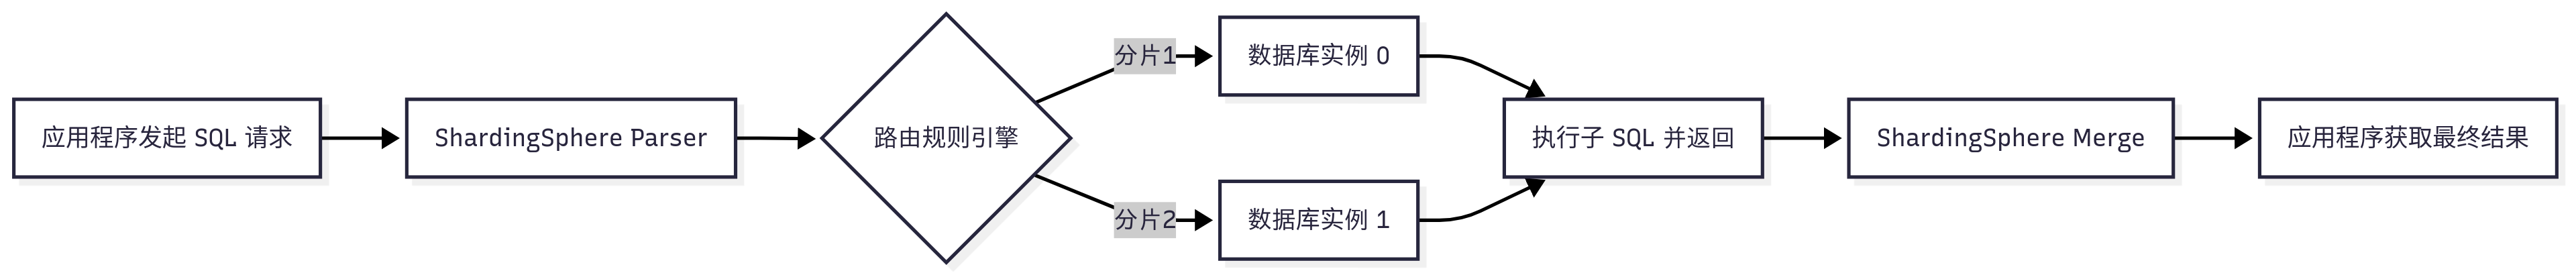
- SQL 路由与执行
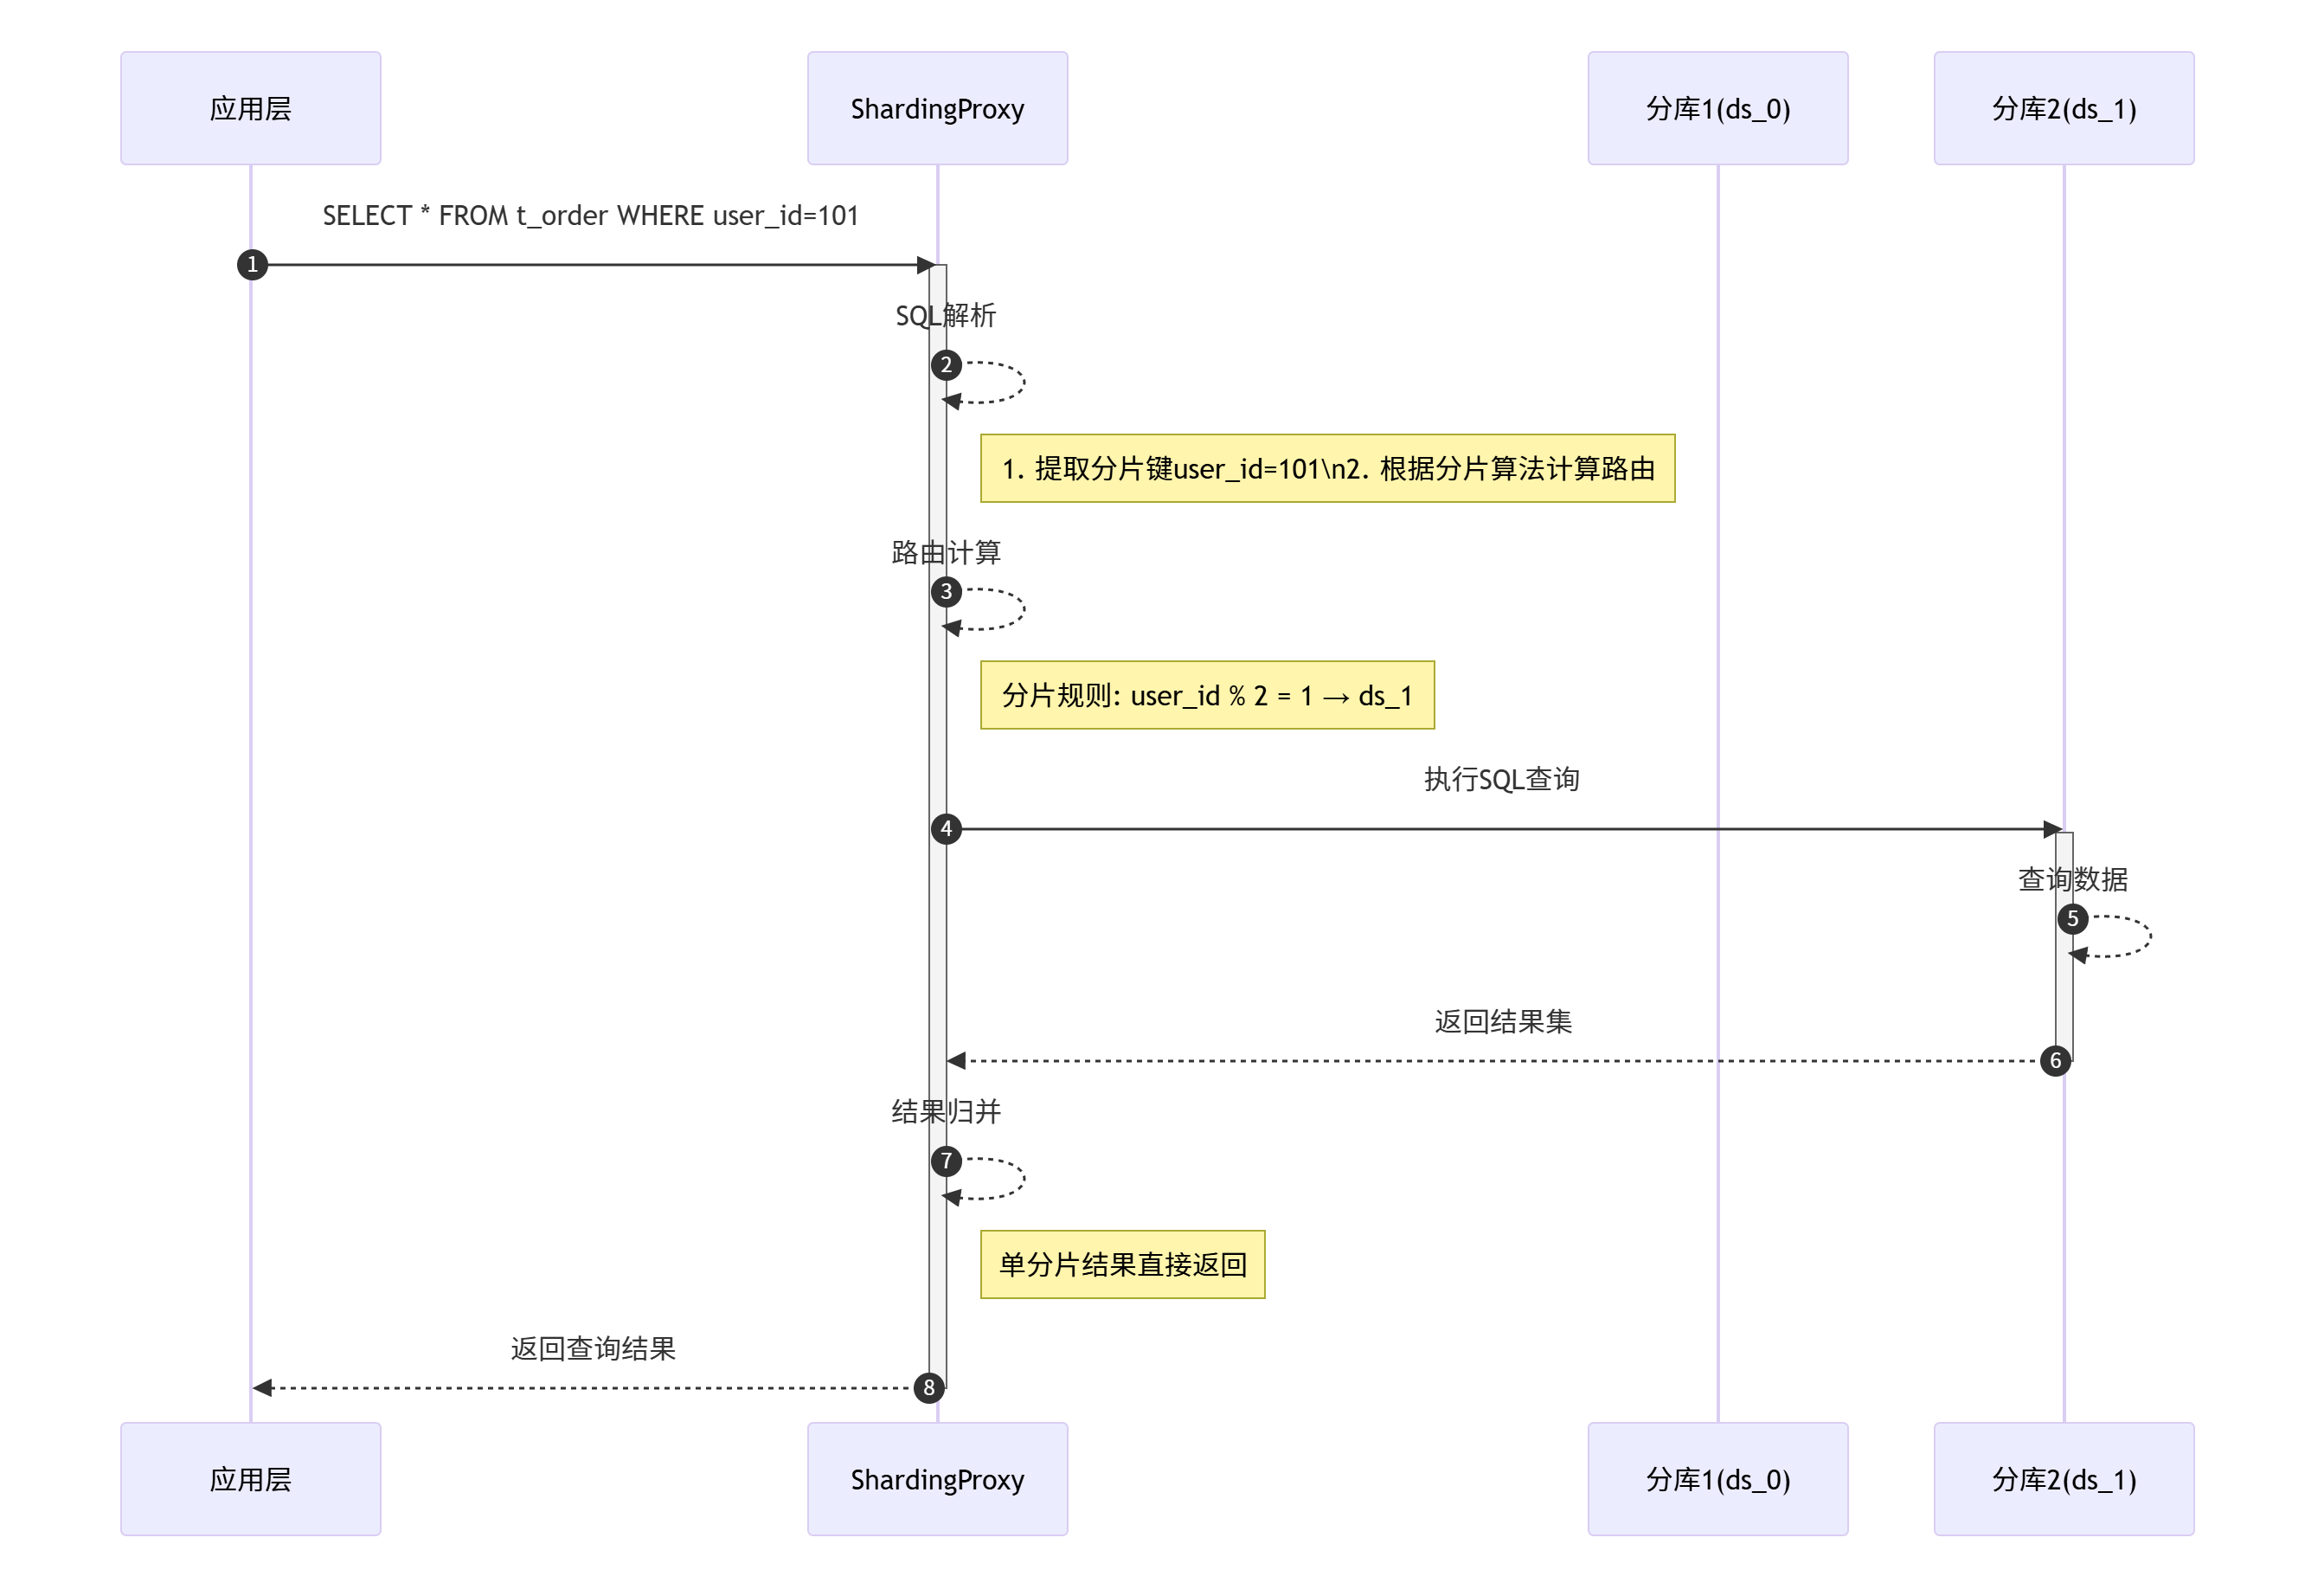
- SQL 解析:生成 AST
- 路由决策:基于分片键决定目标分片
- 改写执行:拆分为多条子 SQL
- 结果归并:分页、排序、聚合在内存中完成
下面用一段 Mermaid 流程图 展示 ShardingSphere 的 SQL 路由流程:
一、为什么需要分库分表?
1.1 数据量爆炸带来的挑战
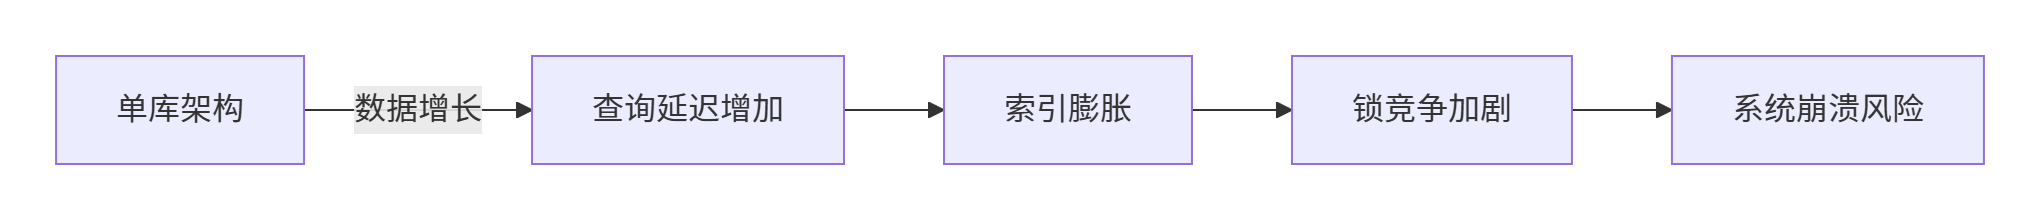
典型瓶颈表现:
- 单表超过5000万行:B+树深度达到4层,查询效率骤降30%
- QPS超过2000:连接池耗尽,大量请求被阻塞
- 存储空间不足:单机磁盘容量达到TB级别后扩容困难
1.2 ShardingSphere的优势
作为Apache顶级项目,ShardingSphere提供:
- 透明化分片:业务代码几乎零改造
- 生态完善:支持MySQL、PostgreSQL、Oracle等主流数据库
- 功能全面:从数据分片到分布式事务的全套解决方案
二、ShardingSphere核心机制剖析
2.1 分片策略配置示例(YAML)
sharding:
  tables:
    t_order:
      actualDataNodes: ds_${0..1}.t_order_${0..15}  # 2库16表
      databaseStrategy:
        standard:
          shardingColumn: user_id
          shardingAlgorithmName: database_inline
      tableStrategy:
        standard:
          shardingColumn: order_id
          shardingAlgorithmName: table_inline
  shardingAlgorithms:
    database_inline:
      type: INLINE
      props:
        algorithm-expression: ds_${user_id % 2}
    table_inline:
      type: INLINE
      props:
        algorithm-expression: t_order_${order_id % 16}
2.2 SQL执行流程解析
2.3 分布式主键生成对比
| 方案 | 性能 | 数据连续性 | 缺点 |
|---|---|---|---|
| 雪花算法 | 10w+/s | 趋势有序 | 时钟回拨问题 |
| UUID | 无限 | 无序 | 存储空间大 |
| Leaf | 5w+/s | 连续 | 依赖外部服务 |
| 数据库自增 | 受限于DB | 连续 | 扩容困难 |
三、实战进阶问题解决方案
3.1 一致性哈希算法优化扩容
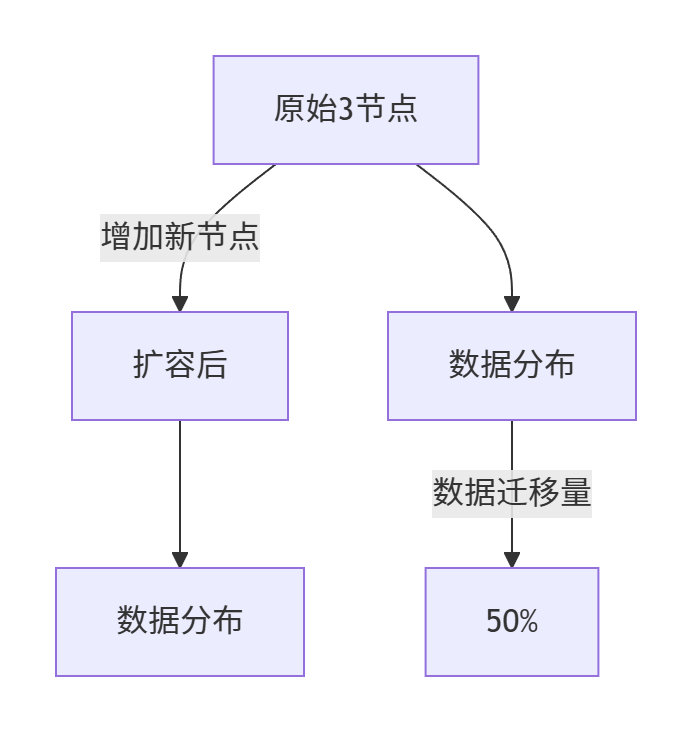
传统取模算法的问题:
虚拟节点一致性哈希实现:
public class ConsistentHashShardingAlgorithm implements StandardShardingAlgorithm<Long> {

    // 虚拟节点数=物理节点数*100
    private static final int VIRTUAL_NODE_MULTIPLIER = 100;

    @Override
    public String doSharding(Collection<String> availableTargetNames,
                            RangeShardingValue<Long> shardingValue) {
        // 1. 创建哈希环
        TreeMap<Long, String> hashRing = new TreeMap<>();

        // 2. 为每个物理节点创建虚拟节点
        for (String node : availableTargetNames) {
            for (int i = 0; i < VIRTUAL_NODE_MULTIPLIER; i++) {
                long hash = hash(node + "#V_" + i);
                hashRing.put(hash, node);
            }
        }

        // 3. 查找大于等于分片键的第一个节点
        Long key = shardingValue.getValue();
        Long hash = hash(key.toString());
        SortedMap<Long, String> tailMap = hashRing.tailMap(hash);
        return tailMap.isEmpty() ? hashRing.firstEntry().getValue() : tailMap.get(tailMap.firstKey());
    }
}
效果:扩容时数据迁移量仅需10%-20%
3.2 分布式主键冲突解决方案
解决雪花算法时钟回拨:
public class SnowflakeIdGenerator {
    private long lastTimestamp = -1L;
    private long sequence = 0L;

    public synchronized long nextId() {
        long currentTimestamp = timeGen();

        if (currentTimestamp < lastTimestamp) {
            long offset = lastTimestamp - currentTimestamp;
            if (offset <= 5) {
                // 等待时钟同步
                while (currentTimestamp < lastTimestamp) {
                    currentTimestamp = timeGen();
                }
            } else {
                throw new RuntimeException("Clock moved backwards!");
            }
        }

        if (lastTimestamp == currentTimestamp) {
            sequence = (sequence + 1) & SEQUENCE_MASK;
            if (sequence == 0) {
                currentTimestamp = tilNextMillis(lastTimestamp);
            }
        } else {
            sequence = 0L;
        }

        lastTimestamp = currentTimestamp;
        return ((currentTimestamp << 22)) | (nodeId << 12) | sequence;
    }
}
主键生成器配置:
spring.shardingsphere.rules.sharding.key-generators:
  snowflake:
    type: SNOWFLAKE
    props:
      worker-id: ${server-id} # 通过服务标识指定
3.3 跨库关联查询实战方案
禁止跨库JOIN的三种替代方案:
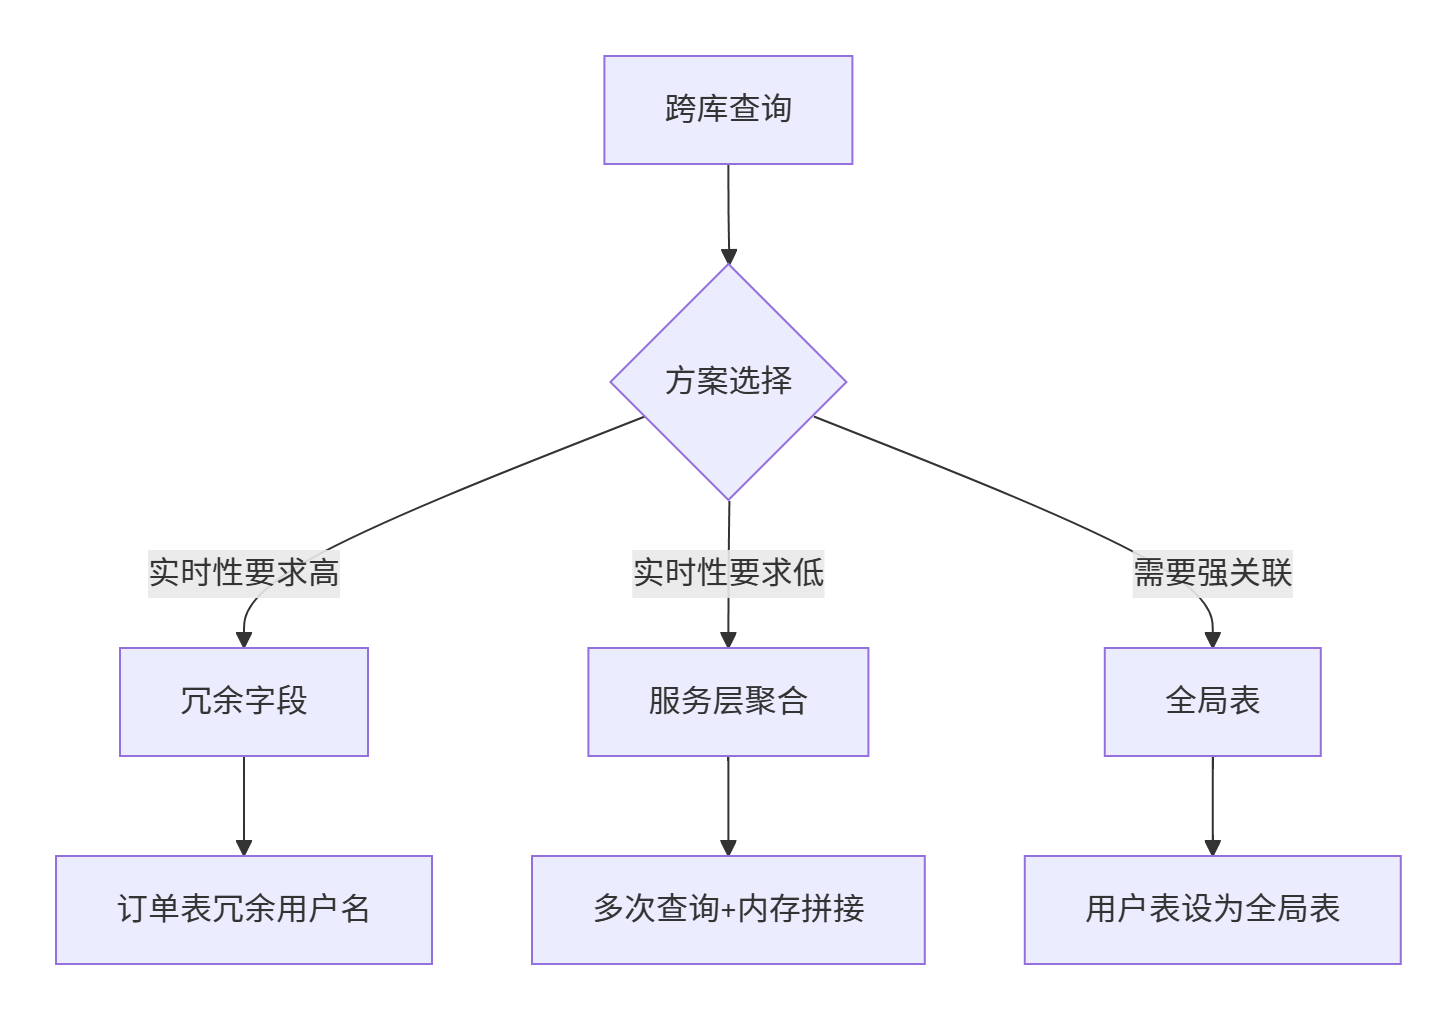
服务层聚合实现:
// 获取用户订单信息
public UserOrderDTO getUserOrderInfo(Long userId) {
    // 1. 查询用户信息(在用户库)
    User user = userService.getUserById(userId);

    // 2. 查询订单信息(在订单库)
    List<Order> orders = orderService.getUserOrders(userId);

    // 3. 服务层聚合结果
    return new UserOrderDTO(user, orders);
}
3.4 柔性事务实现原理
Seata与ShardingSphere集成:
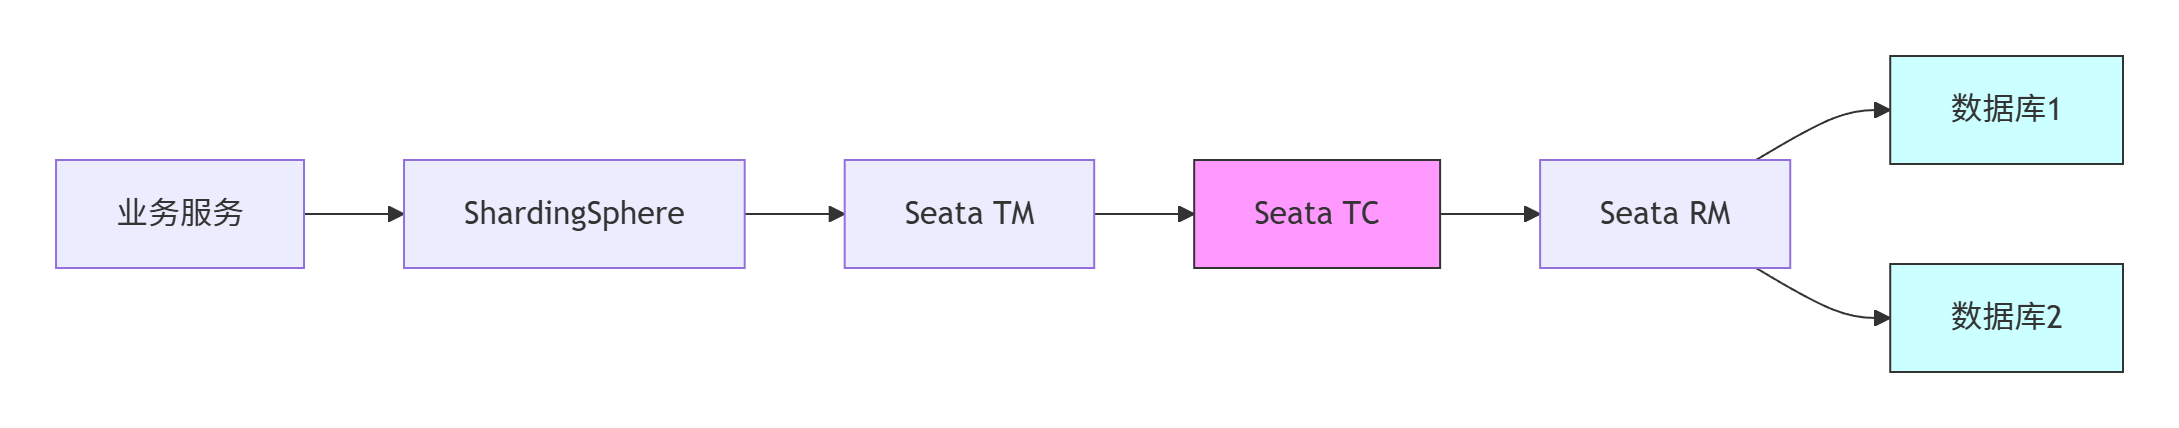
最大努力通知实现:
@Transactional
public void placeOrder(Order order) {
    // 1. 保存订单
    orderDao.insert(order);

    // 2. 发送MQ消息(独立事务)
    TransactionSynchronizationManager.registerSynchronization(
        new TransactionSynchronization() {
            @Override
            public void afterCommit() {
                mqSender.sendOrderEvent(order);
            }
        }
    );
}
3.5 数据迁移不停机方案
双写迁移架构:
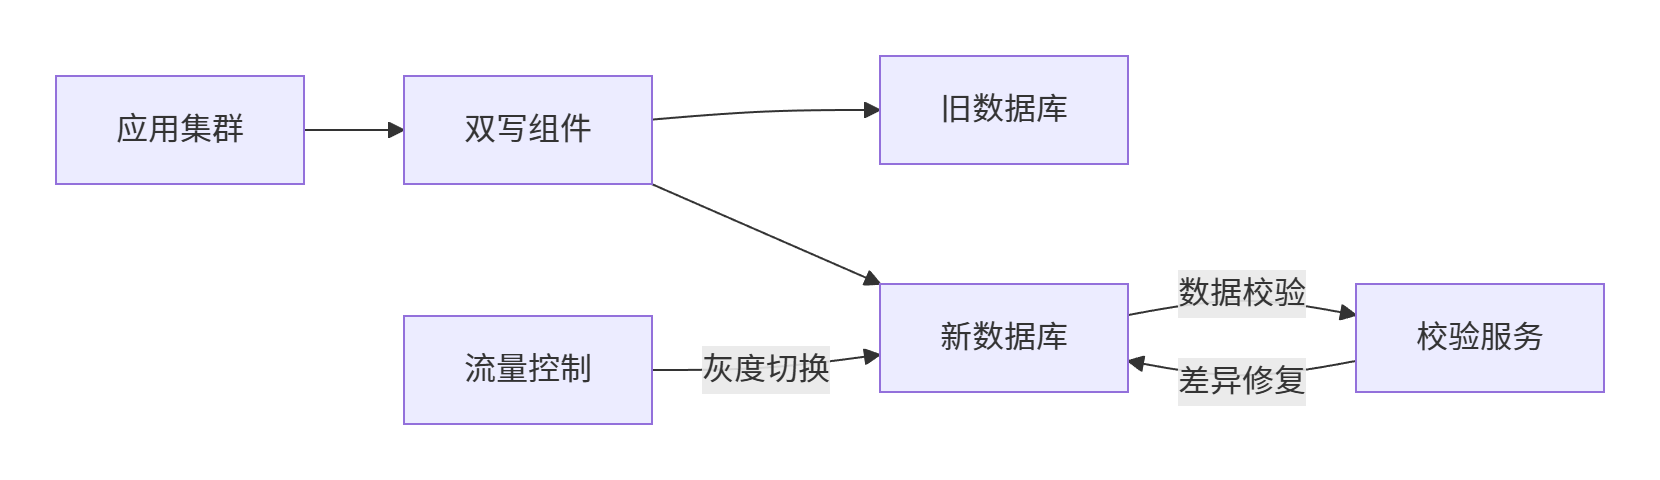
迁移阶段:
1.全量迁移:使用DataX导入历史数据
2.增量同步:Canal实时捕获binlog
3.灰度切流:按用户ID段逐步迁移10% → 30% → 100%
4.一致性校验:对比新旧库数据差异
5.旧库下线:完全切换后停用旧库
四、最佳实践与避坑指南
4.1 分库分表方案选型
| 业务类型 | 推荐策略 | 分区键选择 |
|---|---|---|
| 交易系统 | 取模分片 | user_id |
| 日志系统 | 时间范围分片 | create_time |
| 社交平台 | 一致性哈希 | post_id |
| 多租户系统 | 租户隔离 + 库内分表 | tenant_id |
4.2 十大避坑指南
- 广播表滥用:小于1w行的配置表才适合全局广播
- 热点数据倾斜:用户画像等热点数据应单独分片
- 深度分页优化:
-- 错误写法
SELECT * FROM order LIMIT 10000,20

-- 优化写法
SELECT * FROM order WHERE id > last_id LIMIT 20
- 分布式死锁:避免跨分片事务更新操作
- 未指定分片键:强制走全库路由导致性能雪崩
五、结语
分库分表是解决海量数据问题的良药,却是系统复杂性的毒药。
本文涉及方案均在生产环境验证,欢迎在评论区分享你的实战经验!
数据来源:
- ShardingSphere 5.3.0 官方文档
- 阿里巴巴双11分库分表白皮书
- 美团点评订单系统架构演进
互动话题:
在分库分表实践中,你踩过最深的坑是什么?
1)主键冲突
2)数据迁移问题
3)跨库查询性能
4)分布式事务一致性问题
👇 欢迎评论区讨论你的踩坑经历!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 28
 0
- 0


 已为社区贡献6条内容

所有评论(0)