基于Python+Django的电影推荐系统的设计与实现
设计思路
电影推荐系统通常采用协同过滤或内容推荐算法。Django作为后端框架,搭配Python的数据处理库(如Pandas、NumPy)和推荐算法库(如Surprise、scikit-learn),可以构建高效的系统。
数据库设计需包含用户表、电影表、评分表。用户行为数据(如评分、点击)是推荐算法的核心输入,需设计合理的数据结构存储这些信息。
核心功能模块
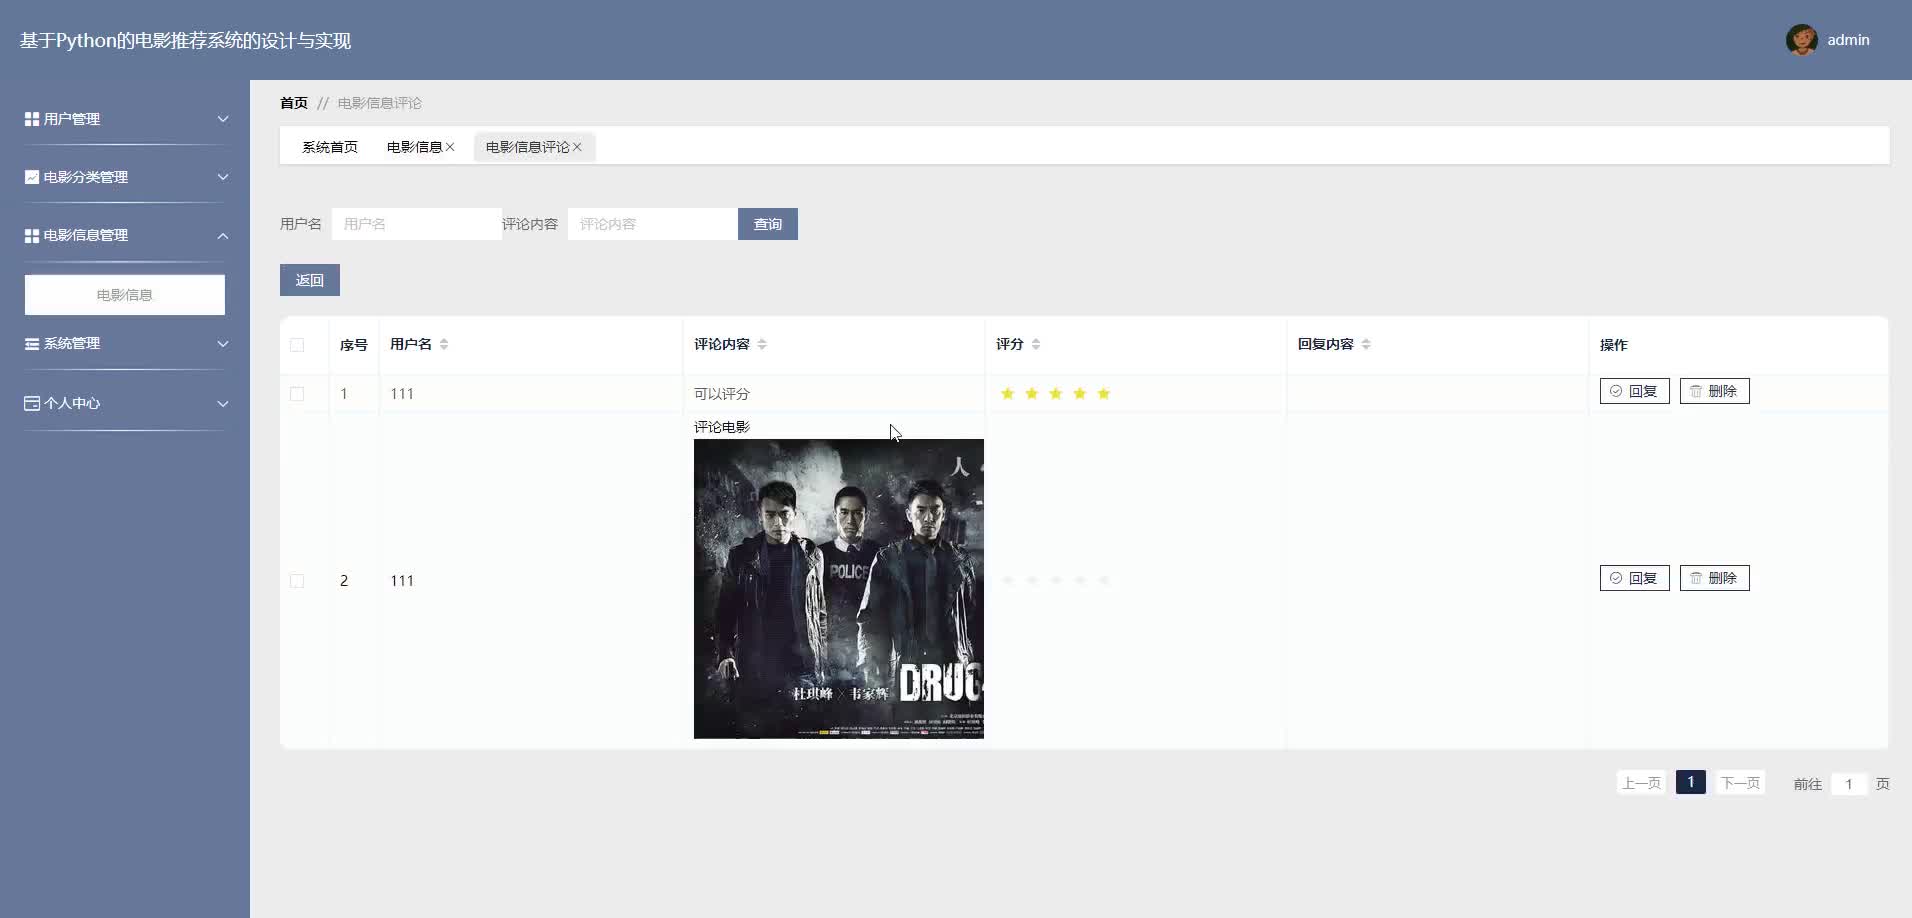
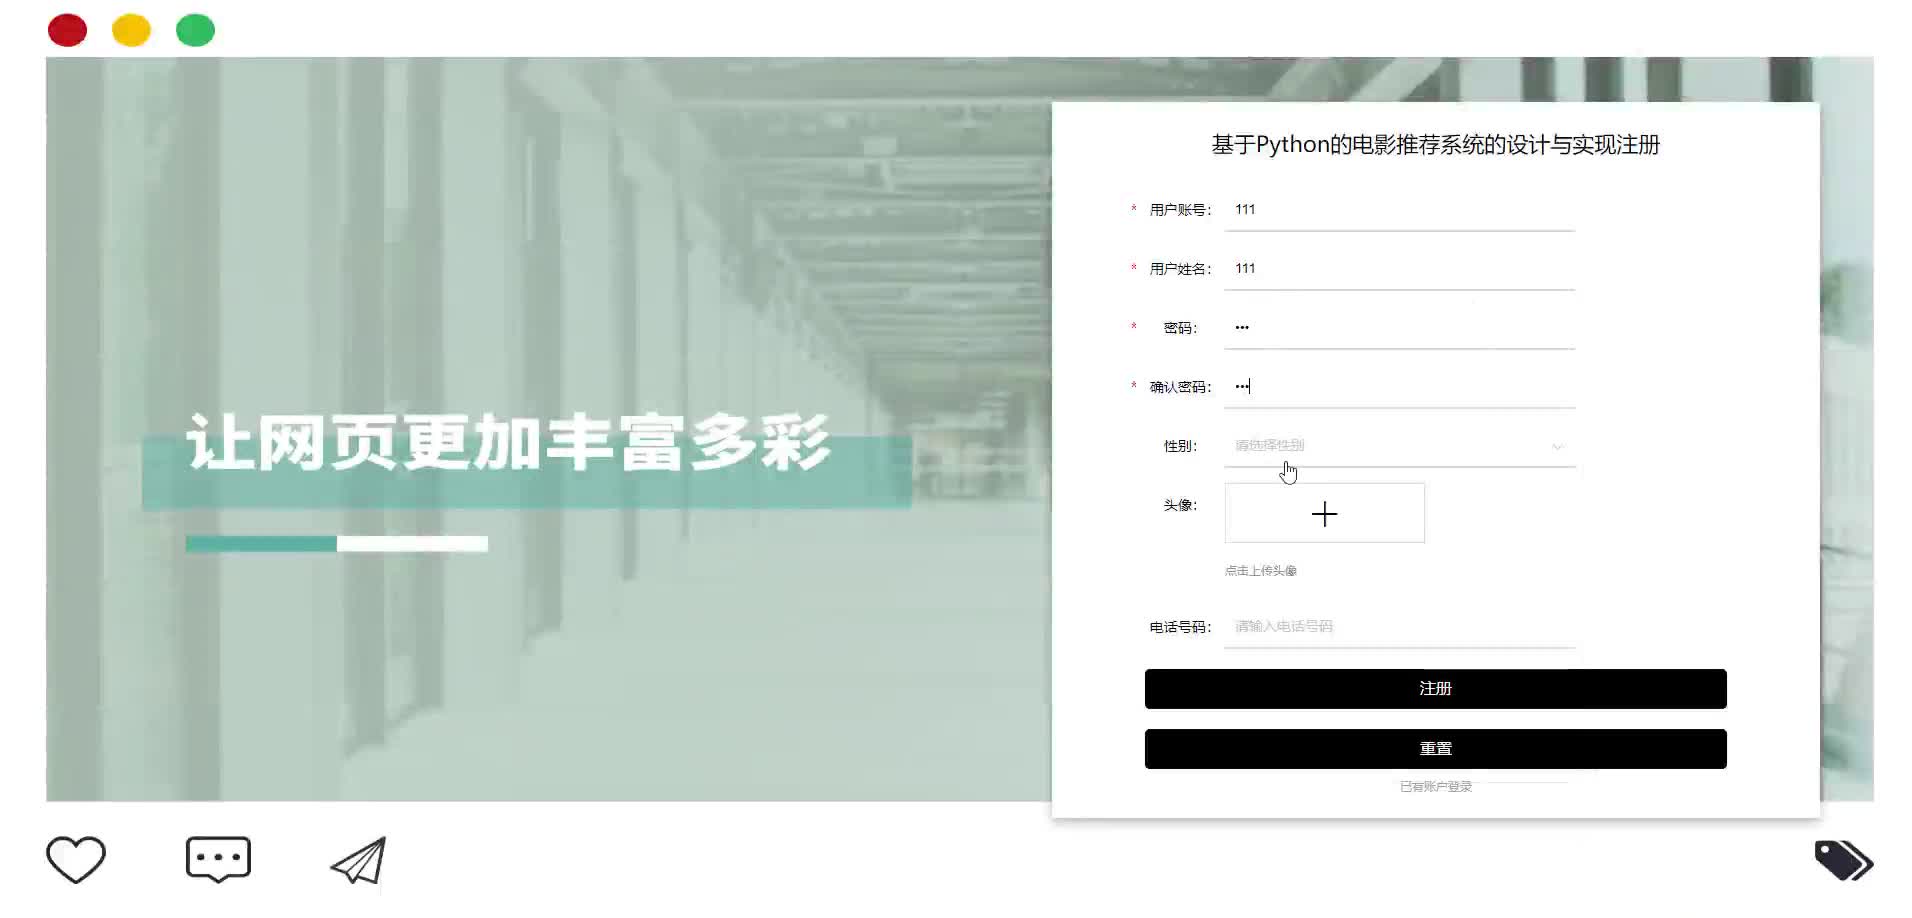
用户管理模块 注册、登录、个人资料管理功能,使用Django内置的auth模块快速实现。扩展用户模型添加偏好字段,如喜欢的电影类型。
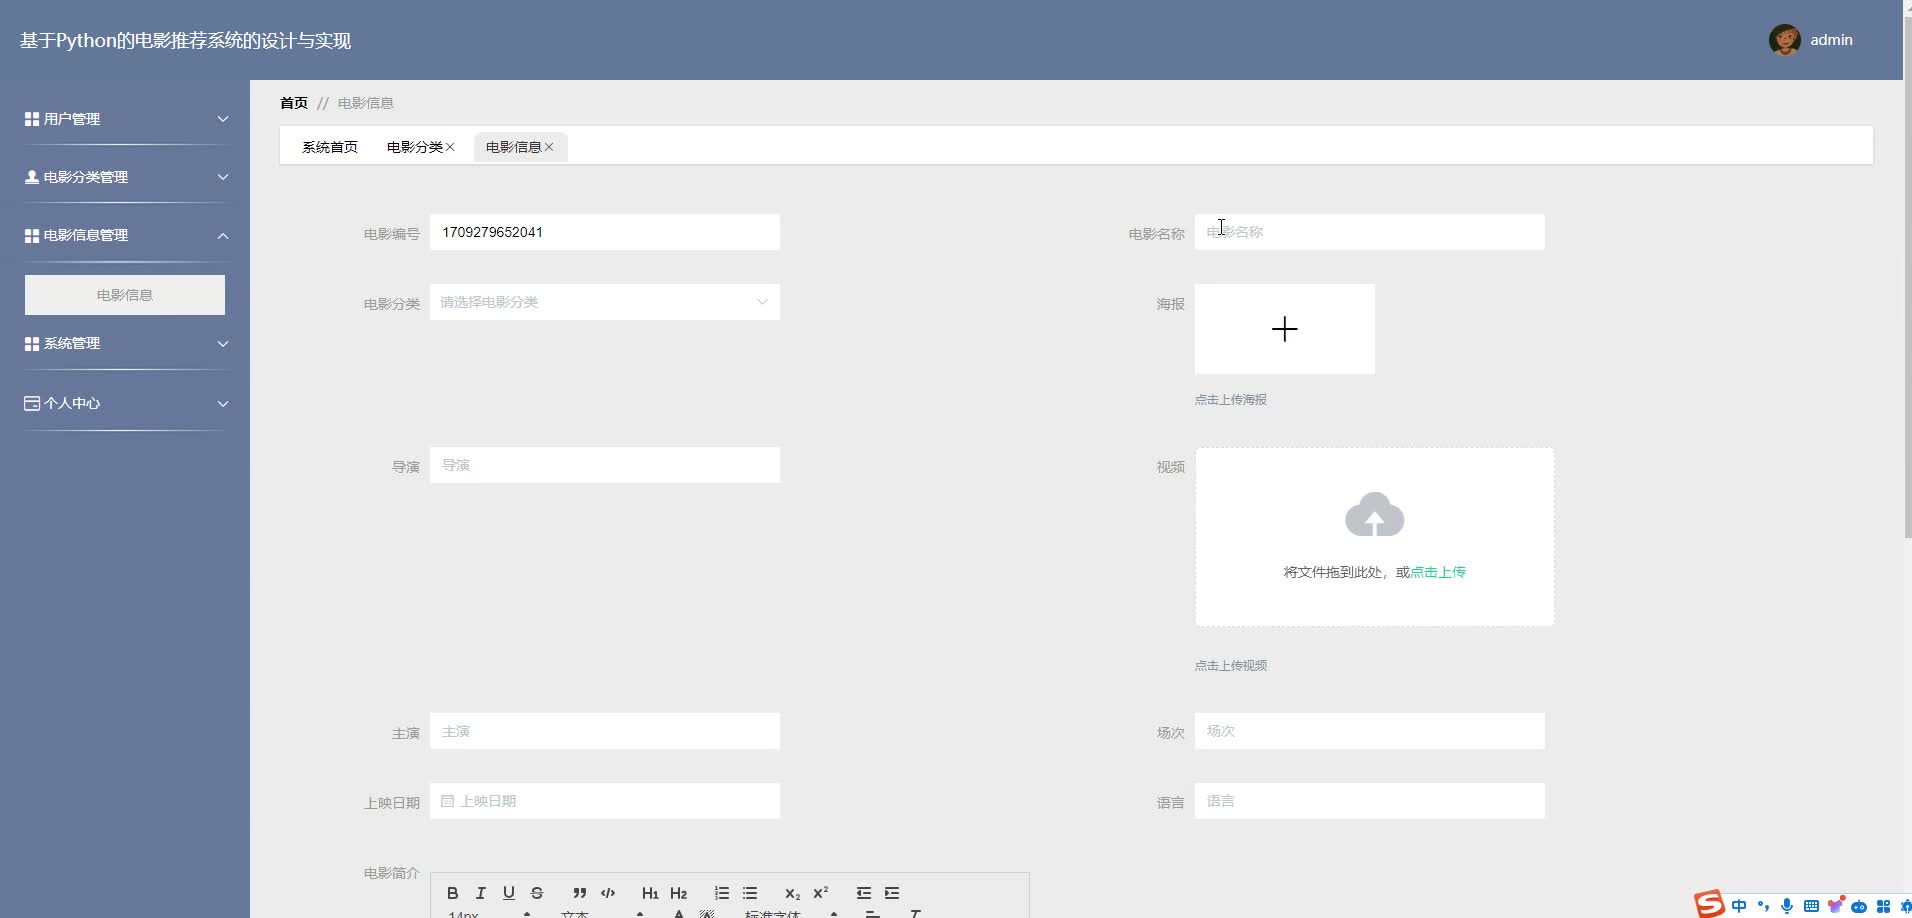
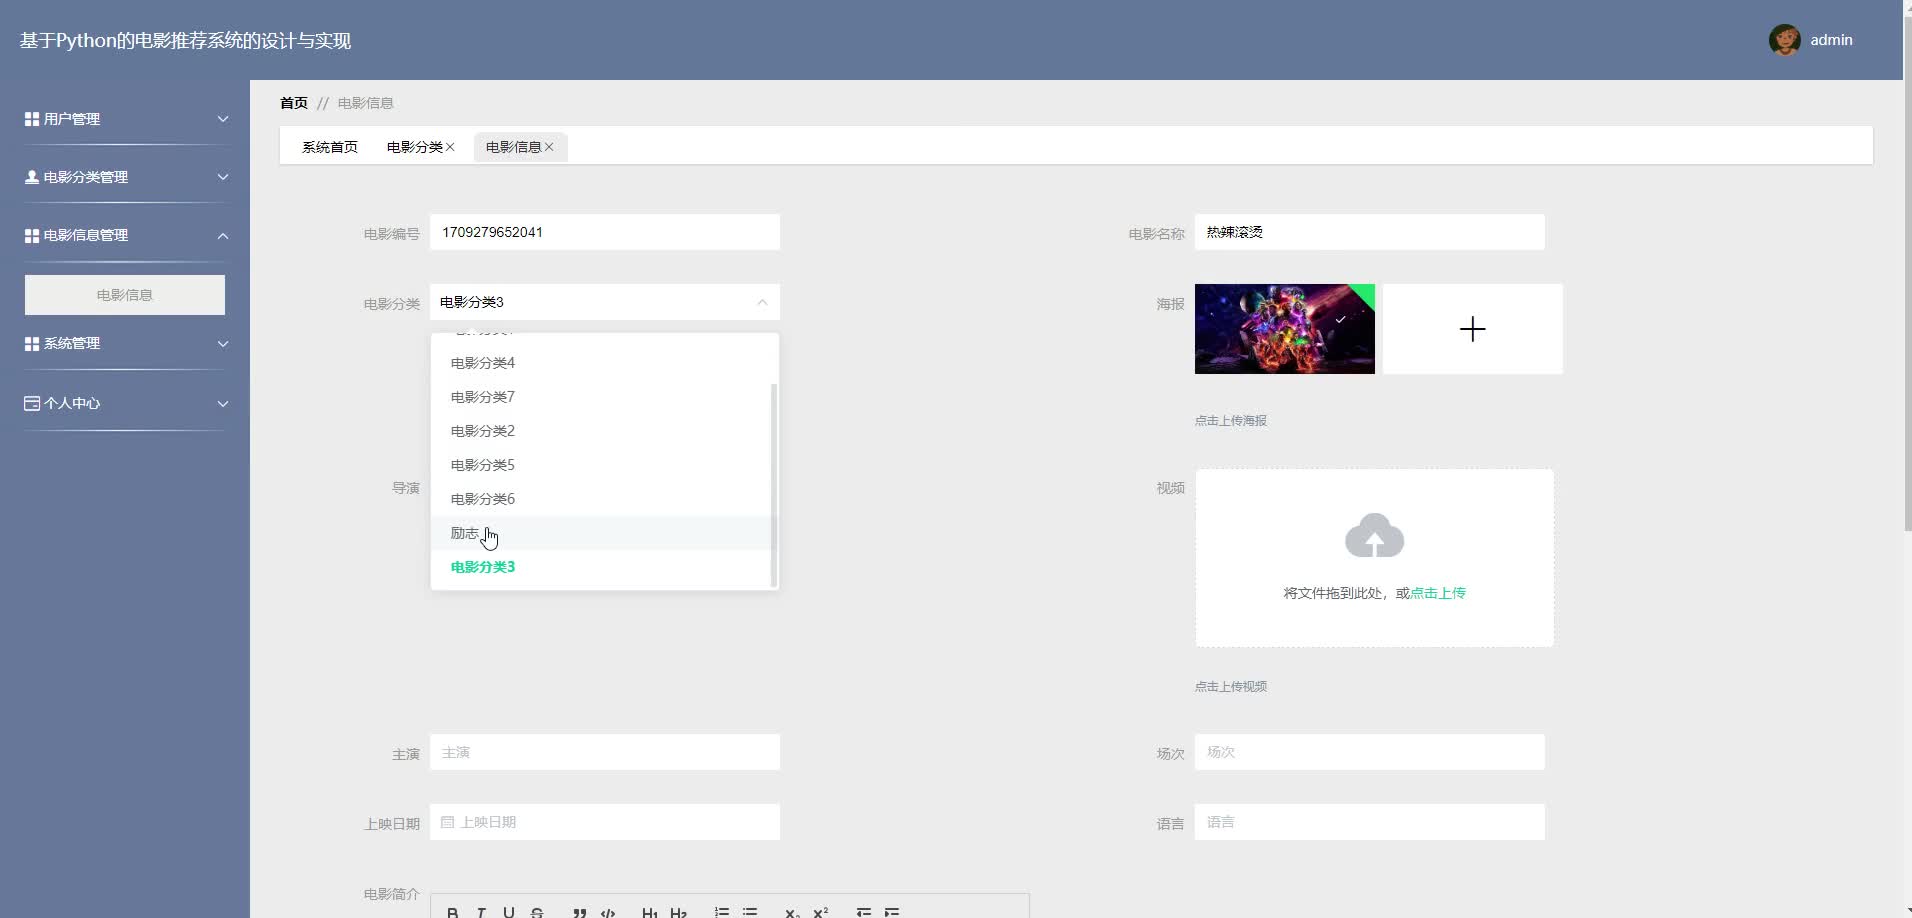
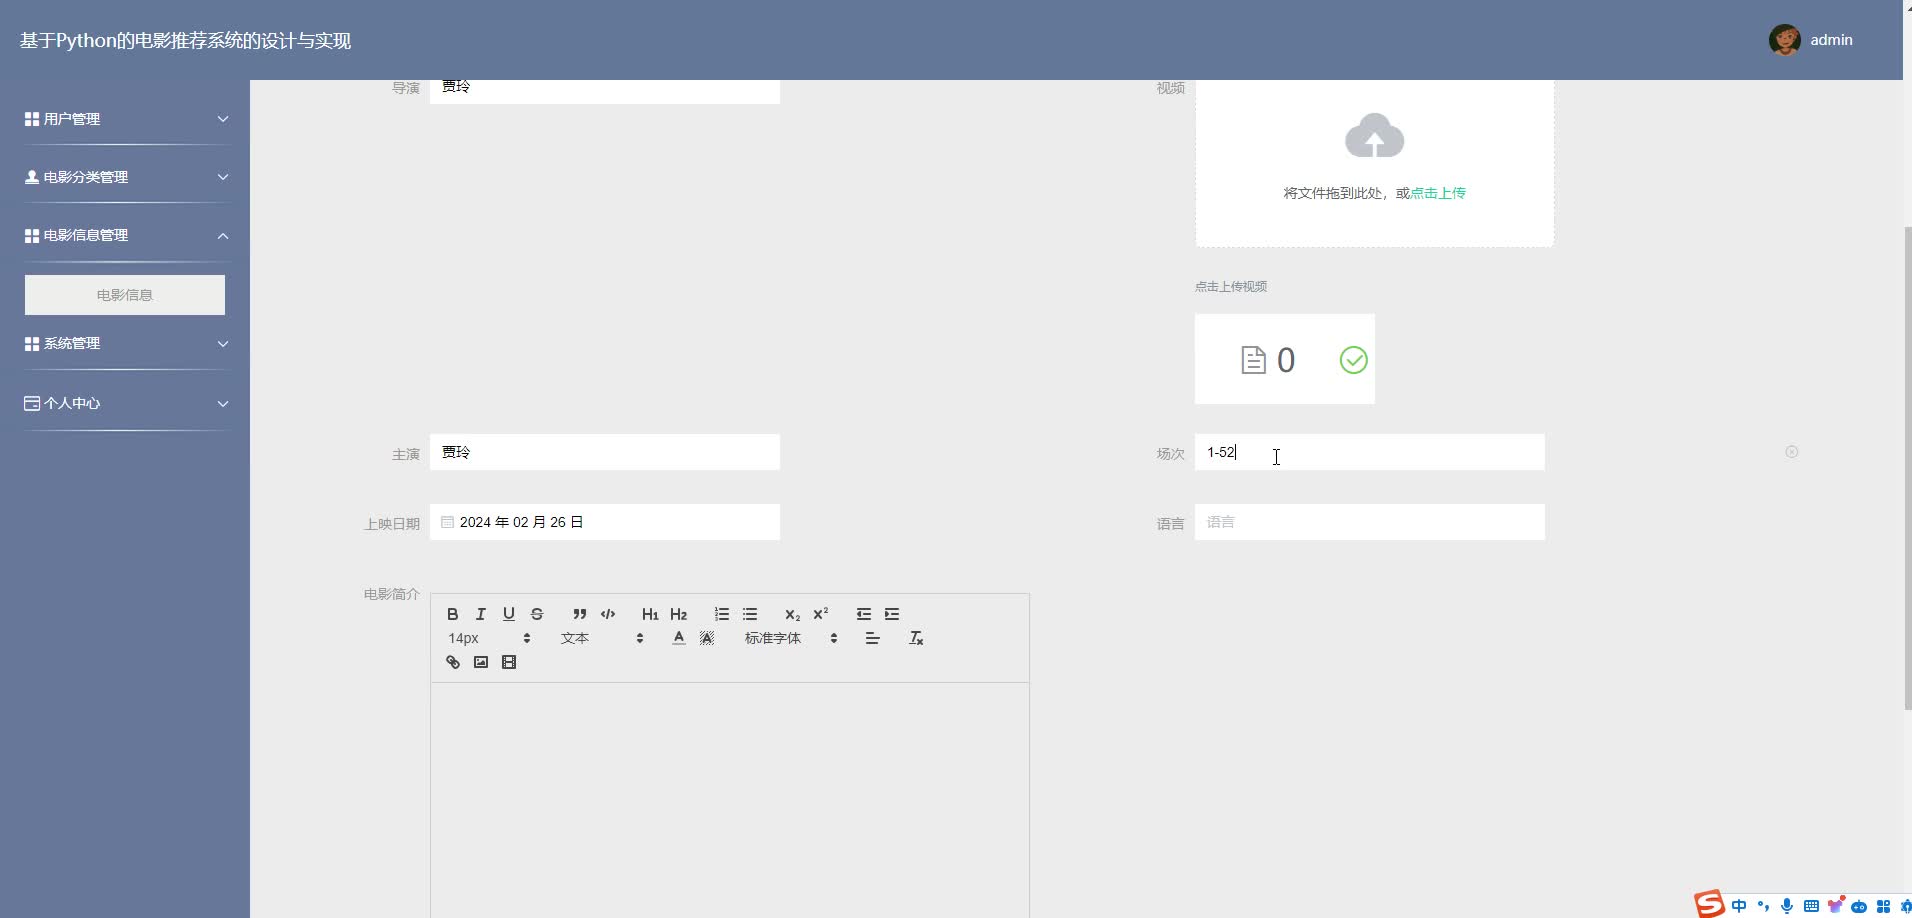
电影管理模块 电影信息的增删改查,包含标题、类型、导演、演员、简介等字段。Django的ORM简化数据库操作,Admin后台方便内容管理。
推荐算法模块 基于用户的协同过滤算法计算用户相似度,找出相似用户喜欢的电影推荐给目标用户。使用Surprise库实现算法,公式如下:
$$ \hat{r}{ui} = \frac{\sum{v \in N_i(u)} \text{sim}(u, v) \cdot r_{vi}}{\sum_{v \in N_i(u)} \text{sim}(u, v)} $$
其中$N_i(u)$表示对物品$i$评分的用户中与$u$最相似的$k$个用户,$\text{sim}(u, v)$表示用户$u$和$v$的相似度。
实现步骤
环境搭建 安装Python 3.8+、Django 3.2+、Surprise、Pandas等库。创建Django项目,配置数据库(如SQLite或MySQL)。
pip install django pandas numpy surprise
django-admin startproject movie_recommend
cd movie_recommend
python manage.py startapp recommender
模型定义 在recommender/models.py中定义用户、电影、评分模型。用户模型继承AbstractUser,电影模型包含各种元数据字段,评分模型记录用户对电影的评分。
from django.db import models
from django.contrib.auth.models import AbstractUser

class Movie(models.Model):
    title = models.CharField(max_length=200)
    genres = models.CharField(max_length=200)
    # 其他字段...

class Rating(models.Model):
    user = models.ForeignKey(User, on_delete=models.CASCADE)
    movie = models.ForeignKey(Movie, on_delete=models.CASCADE)
    rating = models.FloatField()
    timestamp = models.DateTimeField(auto_now_add=True)
视图与路由 编写视图处理用户请求,如电影列表、评分提交、推荐获取。配置URL路由映射视图。
# views.py
from django.shortcuts import render
from .models import Movie, Rating
from .recommend import get_recommendations

def recommend(request):
    if request.user.is_authenticated:
        movies = get_recommendations(request.user)
        return render(request, 'recommend.html', {'movies': movies})
    return redirect('login')

# urls.py
from django.urls import path
from . import views

urlpatterns = [
    path('recommend/', views.recommend, name='recommend'),
]
推荐算法实现 在recommend.py中实现协同过滤算法。加载评分数据,训练模型,生成推荐。
from surprise import Dataset, KNNBasic
from surprise.model_selection import train_test_split

def get_recommendations(user):
    data = Dataset.load_builtin('ml-100k')
    trainset, testset = train_test_split(data, test_size=0.25)
    algo = KNNBasic(sim_options={'user_based': True})
    algo.fit(trainset)

    user_inner_id = algo.trainset.to_inner_uid(user.id)
    user_neighbors = algo.get_neighbors(user_inner_id, k=10)

    recommendations = set()
    for neighbor in user_neighbors:
        neighbor_ratings = algo.trainset.ur[neighbor]
        for movie_inner_id, rating in neighbor_ratings:
            if rating >= 4.0:  # 只推荐高评分电影
                movie_id = algo.trainset.to_raw_iid(movie_inner_id)
                recommendations.add(movie_id)

    return Movie.objects.filter(id__in=list(recommendations)[:10])
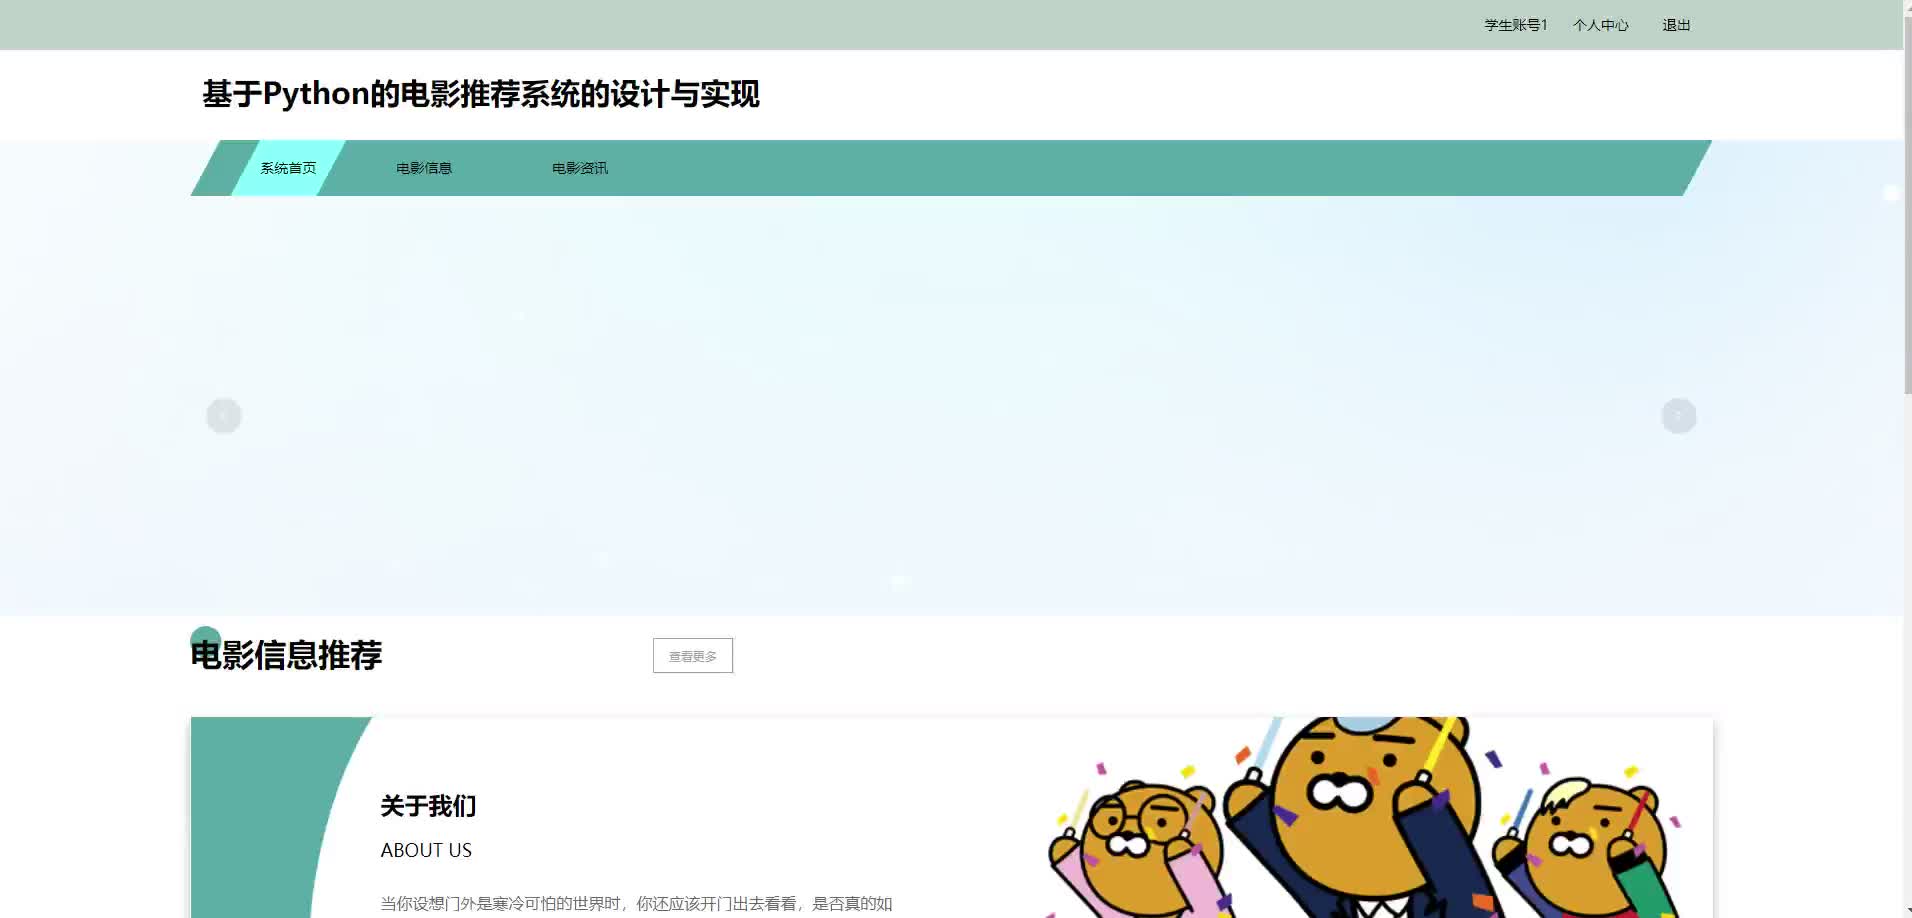
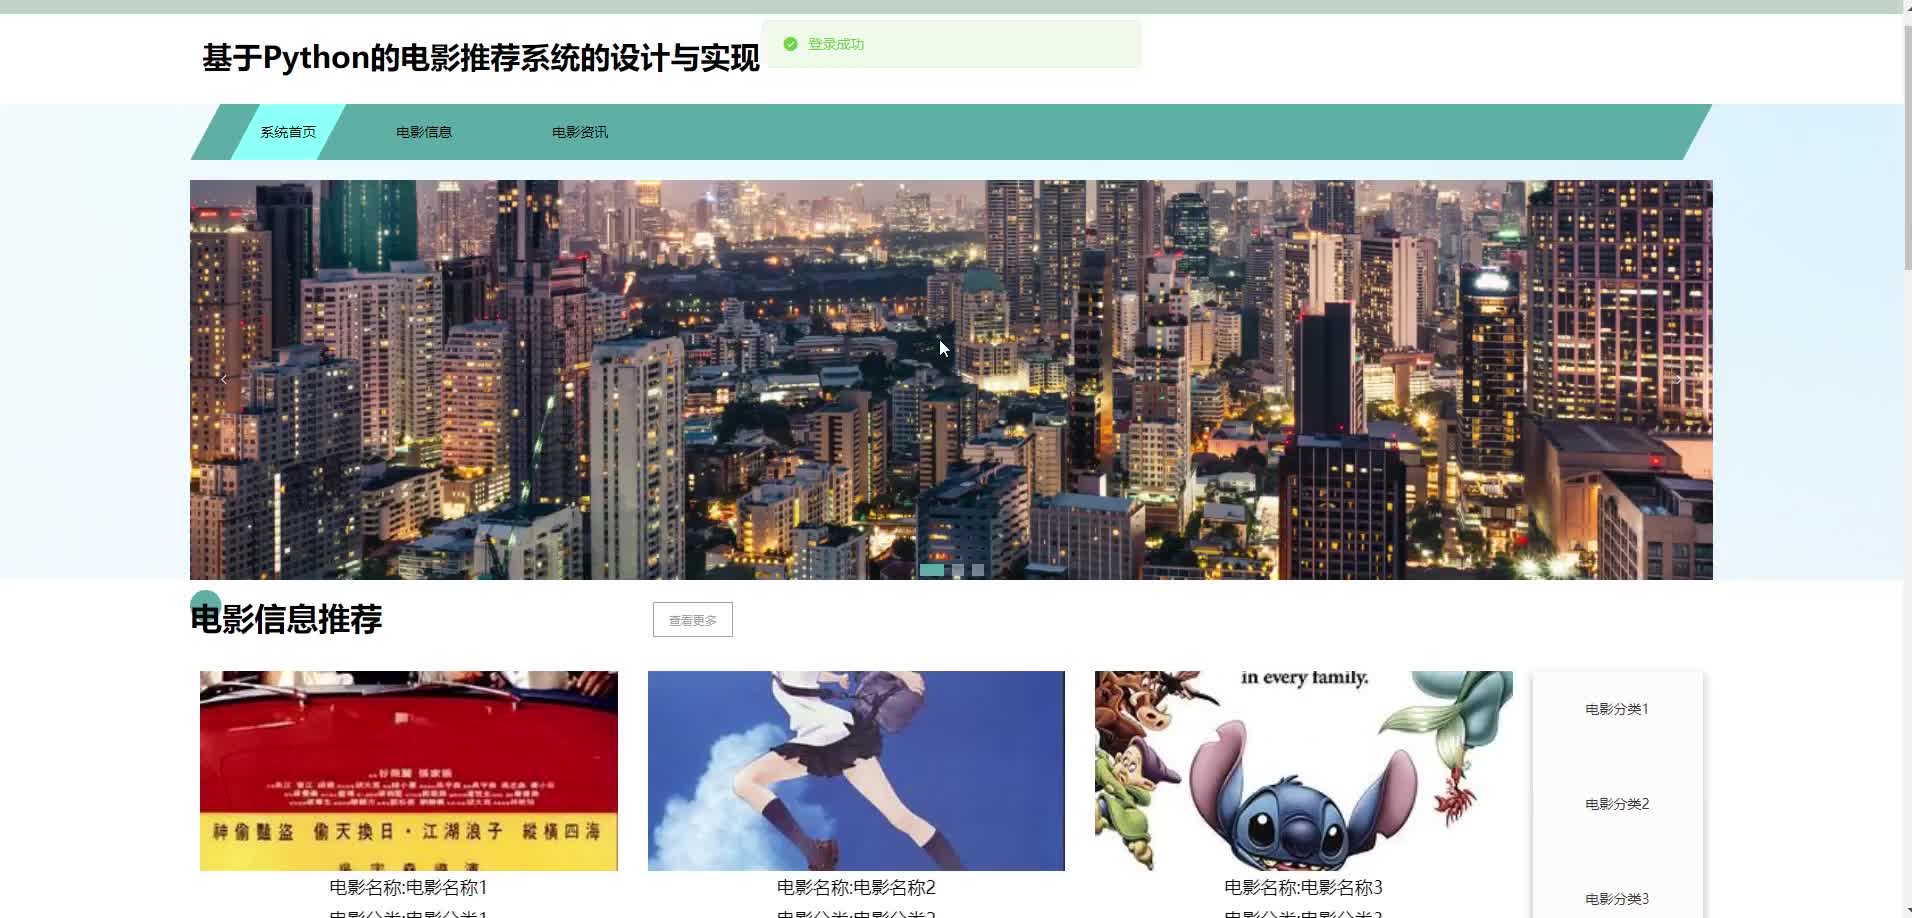
前端展示 使用Django模板或前后端分离架构(如Vue.js)展示推荐结果。模板中循环显示推荐电影及其信息。
<!-- recommend.html -->
{% for movie in movies %}
<div class="movie">
    <h3>{{ movie.title }}</h3>
    <p>类型: {{ movie.genres }}</p>
    <!-- 其他信息... -->
</div>
{% endfor %}
优化与扩展
冷启动问题 新用户没有评分数据时,采用热门电影或基于内容的推荐。电影内容使用TF-IDF向量化,计算相似度:
$$ \text{sim}(d_i, d_j) = \frac{\mathbf{d}_i \cdot \mathbf{d}_j}{|\mathbf{d}_i| \times |\mathbf{d}_j|} $$
其中$\mathbf{d}_i$和$\mathbf{d}_j$是电影的TF-IDF向量。
实时推荐 使用Django Channels实现WebSocket,当用户评分后实时更新推荐列表。建立长连接推送新推荐。
性能优化 对于大规模数据,将算法离线计算,结果缓存到Redis。定期更新推荐结果而非实时计算。
import redis
from django.conf import settings

r = redis.Redis(host=settings.REDIS_HOST, port=settings.REDIS_PORT)

def cache_recommendations(user_id, movies):
    r.set(f'recommendations:{user_id}', pickle.dumps(movies), ex=86400)  # 缓存1天
A/B测试 设计多种推荐策略(如基于用户、基于物品、混合),通过用户反馈数据选择最佳方案。记录点击率、观看时长等指标。
通过以上设计和实现,可以构建一个功能完善、性能良好的电影推荐系统。根据实际需求和数据规模,可进一步调整算法和架构。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献10条内容

所有评论(0)