数据结构与算法:AC自动机
前言
这玩意儿竞赛里真的会考嘛(捂脸)
一、AC自动机介绍
首先,自动机就是对信号序列进行判定的数学模型。那么在AC自动机里,这个信号序列就是字符串。常见的自动机有前缀树,KMP自动机,回文自动机,后缀自动机和AC自动机。
AC自动机的作用就是给定一篇文章,还有若干个目标字符串,然后返回每个目标字符串在这篇文章中出现了几次。
二、AC自动机详解
AC自动机其实就是加了fail指针的前缀树。
1.AC自动机的构建
首先就是根据所有的目标字符串建立前缀树。
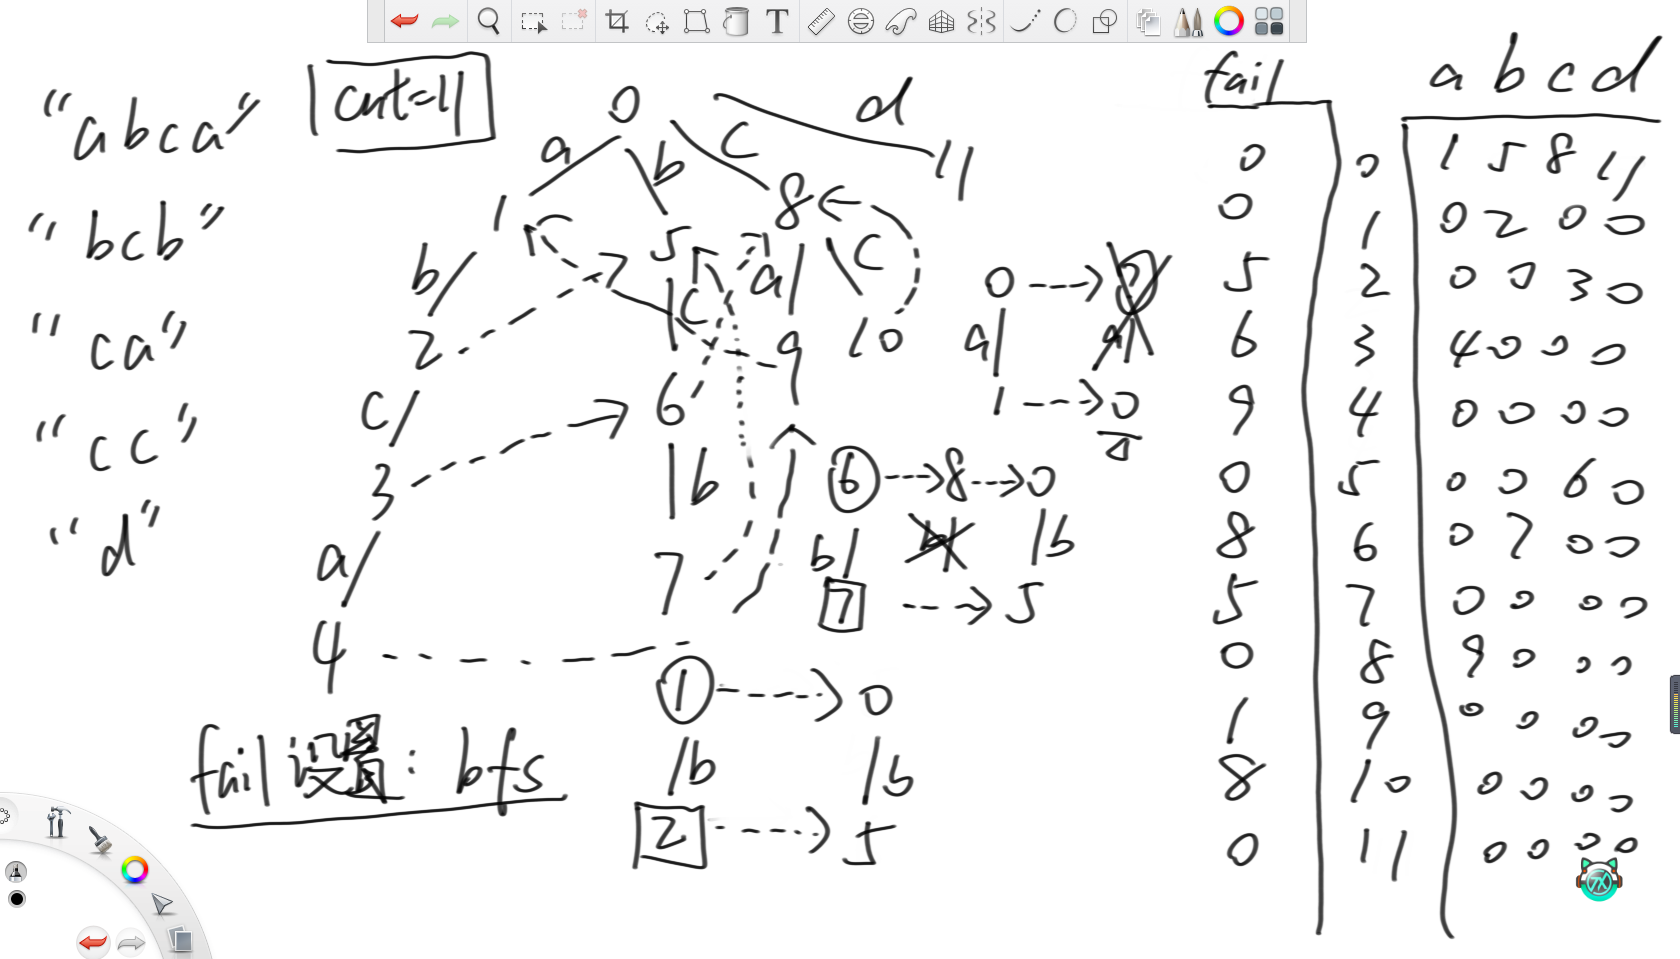
在建立好前缀树后,就要建立fail指针。fail指针的构建其实是一个bfs,首先定义0这个头节点的fail指针指向自己,然后进行宽度优先遍历。首先,同样定义第一层的所有节点的fail指针指向0号节点。
之后,当来到每个节点时,去设置其所有孩子节点的fail指针。设置方法就是,已知当前节点走向其孩子节点的路径,之后一直顺着当前节点的fail指针跳转,看哪个跳转到的节点有同样的路径,那么其孩子节点的fail指针就指向这个路径的终点。
在上述例子中,在1节点时,就去设置其孩子2节点的fail指针,那么就是顺着1节点的fail指针来到0节点。因为1到2的路径为b,且0节点有一条路径同样为b,终点为5节点,那么2节点的fail指针就指向5节点。同理可得6,9和10节点的fail指针。之后到达6节点时,其有一条到7节点的路径b。那么先根据6的fail指针跳到8节点,但由于8节点没有一条路径同样为b,那么就再根据8的fail指针跳到0节点。此时发现有一条到5的路径为b,那么7节点的fail指针就指向5节点。
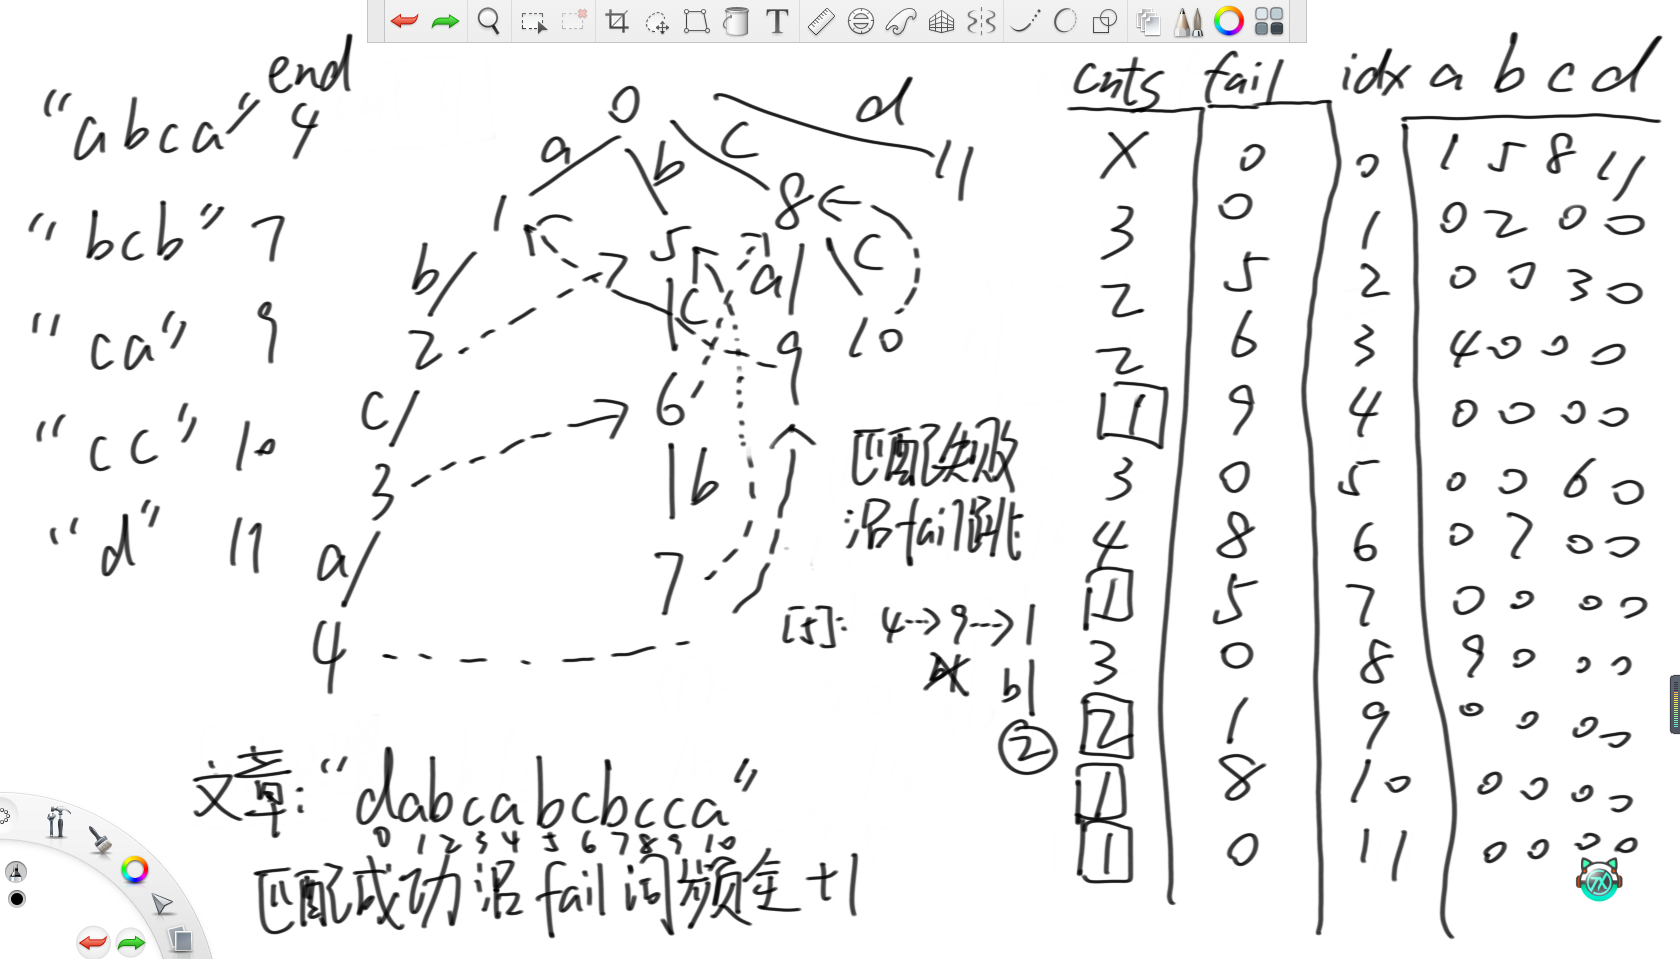
最后在求解答案时,首先,在建立前缀树时,要建立一个endIdx表,表示每个目标字符串结尾的节点。之后遍历文章,统计词频。方法就是如果能匹配成功,那就顺着前缀树往下扎,期间将经过节点的词频加一。同时来到每个节点时,还要顺着当前节点的fail指针把经过的节点词频全加一。如果发现匹配不上了,即下面没有对应的路了,那就一直顺着当前节点的fail指针跳转,直到跳转到有路的节点继续匹配。
在上述例子中,首先从0节点沿路径d来到11节点。那么11节点的词频加一,然后沿11的fail指针来到0节点,停止统计。之后发现匹配不上了,那就沿fail指针跳转到0节点,发现有一条路径为a,那就顺着来到1节点,然后沿fail指针到0节点,停止。再来到2节点,词频加一,沿fail指针来到5节点,词频同样加一。之后3和4节点的统计同理。在统计完4节点后,发现匹配不上了,那就沿fail指针跳到9节点,发现也匹配不上,那就再跳到1节点。此时能匹配上,那就来到2节点,然后统计词频即可。最后,每个目标字符串结尾节点的词频数即出现的次数。
2.fail指针的含义
AC自动机上的某个节点a,表示某个目标串的前缀串s的终止节点。所有目标串的前缀串,要求和s的某个后缀串完全一样且长度最大,不能为s整体。满足以上条件的前缀串t,则节点a的fail指针指向t的终止节点。
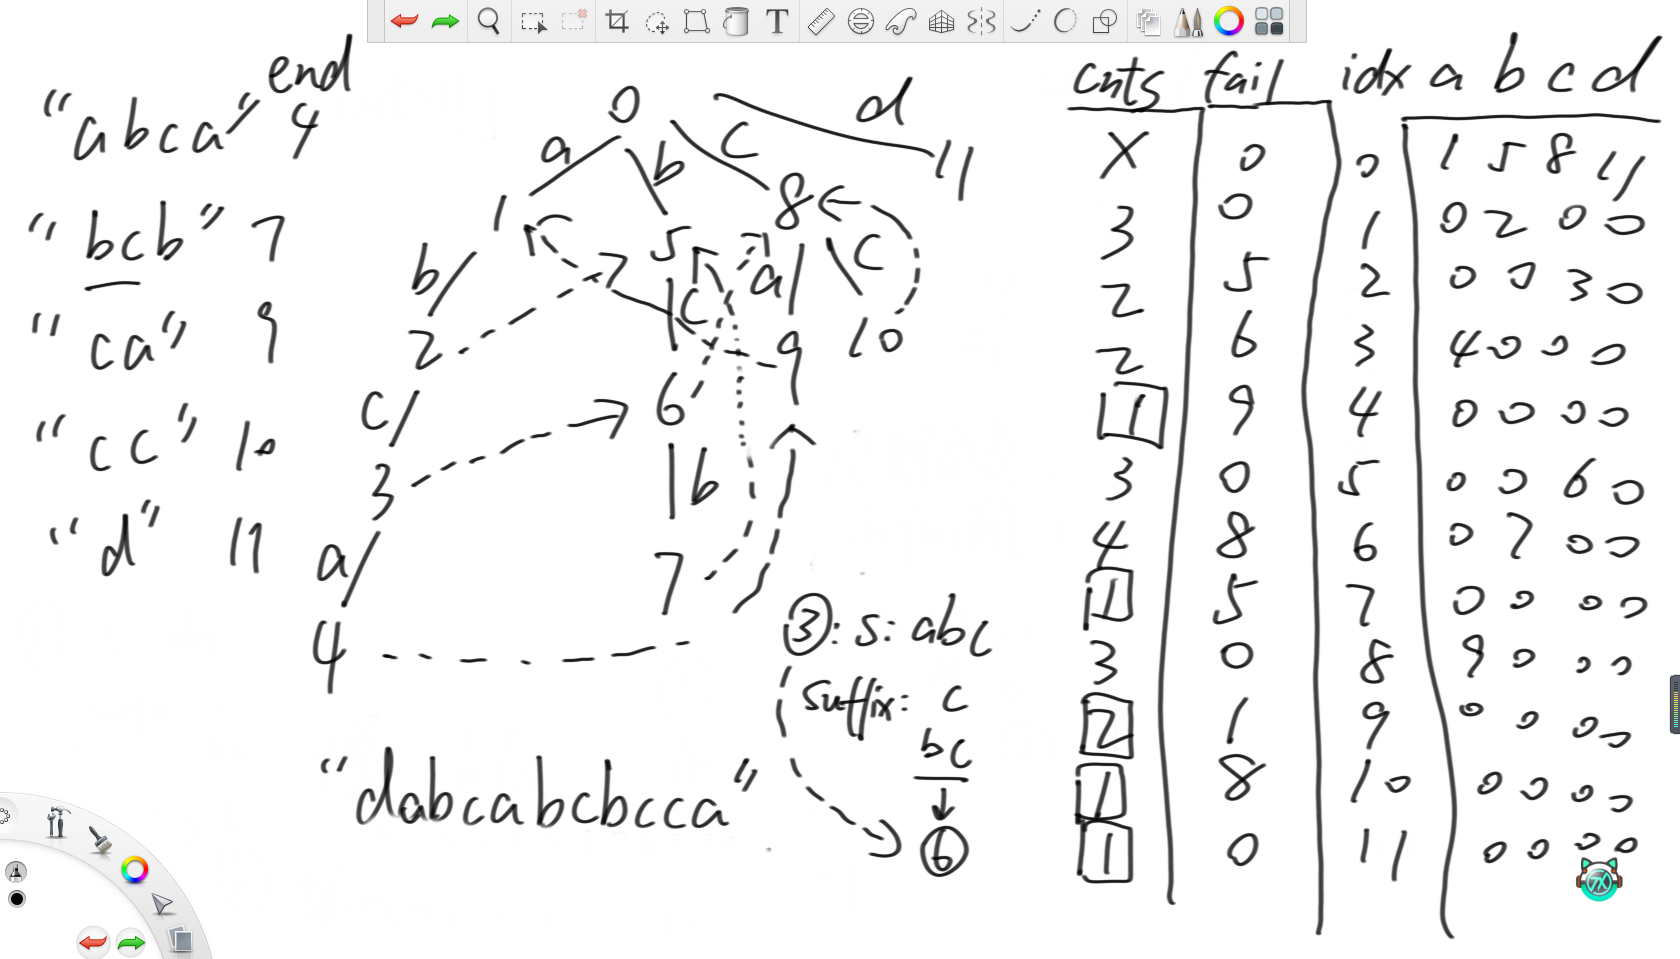
其实这个和kmp算法的next数组几乎一样,就是改成到前缀树上操作了。举个例子,对于3节点,其表示的是“abca”这个目标字符串的前缀串“abc”。那么除了自己,还有后缀串“c”和“bc”。而在所有目标字符串里,能匹配的长度最大的前缀串就是目标串“bcb”的“bc”。又因为表示这个“bc”前缀串的节点是6,所以3节点的fail指针就指向6节点。
3.答案的求解原理
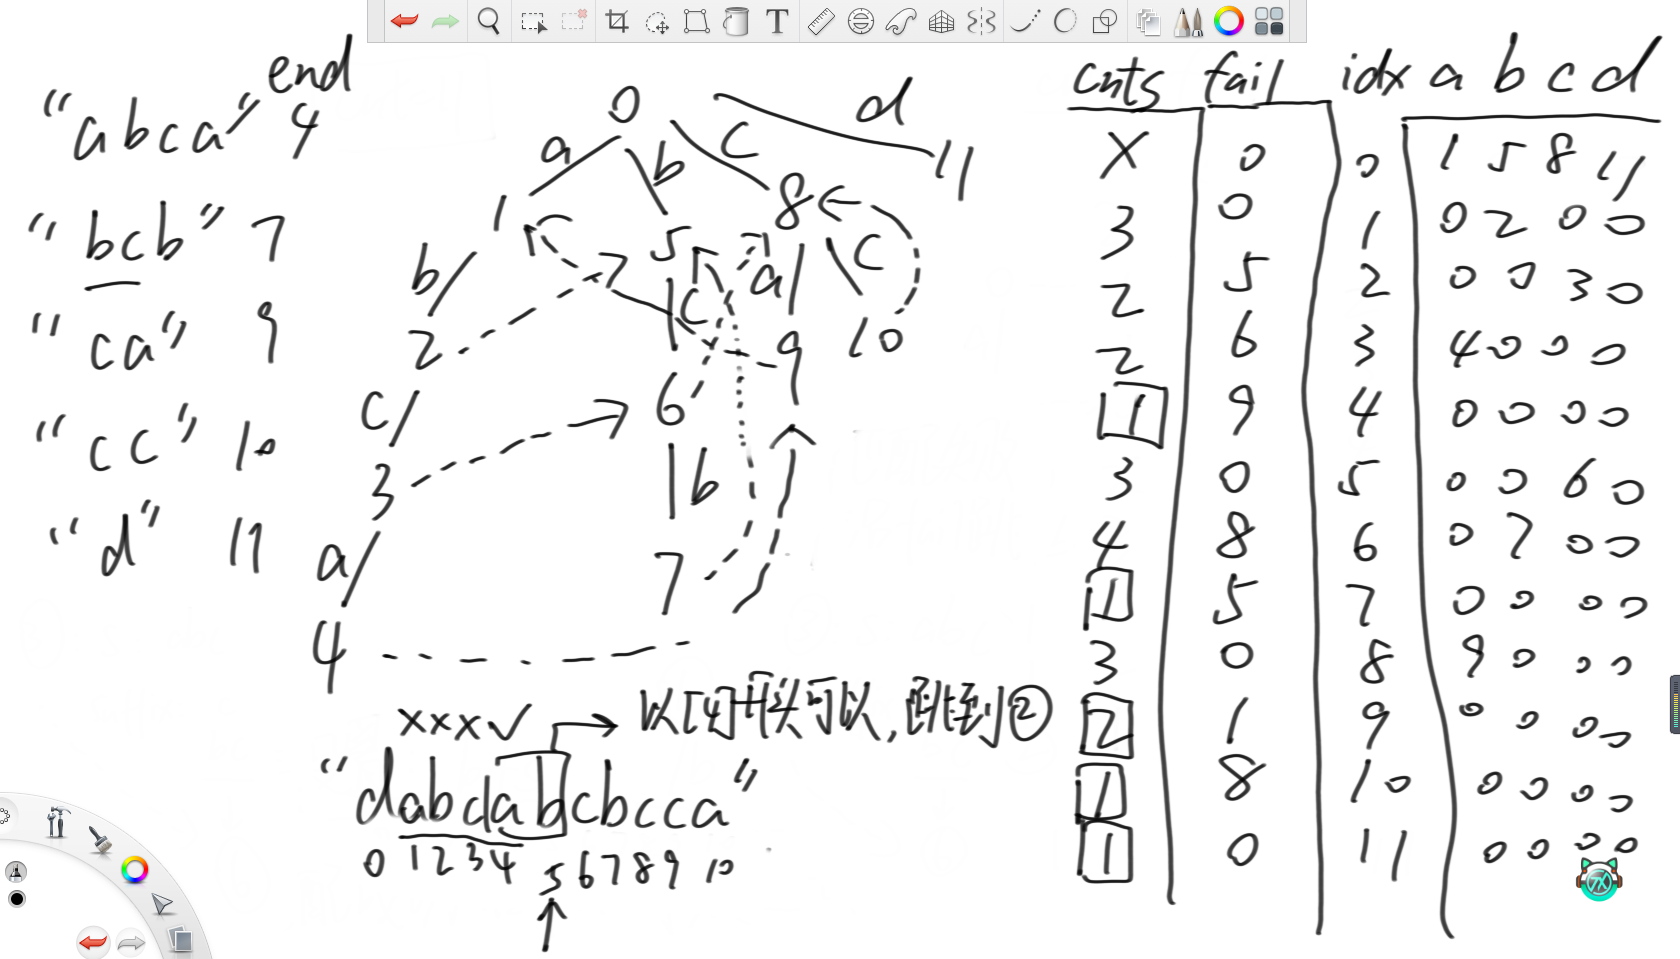
在答案的求解过程中,其实和kmp算法一样,就是不断淘汰没可能的开头位置,同时避免重复匹配。
在上述例子中,在匹配完字符d后,能一直匹配就一直匹配。在匹配完目标字符串“abca”后,因为没有能继续匹配的目标串了,那就开始淘汰没可能的开头位置。此时的开头位置是字符“a”,那么就去找有没有一个目标字符串的前缀串为“abca”,发现没有,那么就不可能以这个“a”开头,所以淘汰。再看有没有一个目标字符串的前缀串为“bca”或“ca”,发现都没有,那就都淘汰。之后,发现“abca”这个目标串有前缀串“a”对应当前的后缀串“a”。所以根据fail指针的定义,跳去1节点,然后继续匹配。和kmp算法一样,保证了在跳转后不用重复匹配。
至于为什么每来到一个匹配的节点就要沿着fail指针都统计一遍词频,这是因为要把可能的作为某个目标串的前缀串的节点都统计上。举个例子,当来到文章的6位置,此时来到4节点。此时不仅“abca”出现了一次,“ca”同样出现了一次,所以就要根据fail指针跳到9节点,把“ca”串的词频也加一。
4.fail指针的绕圈现象
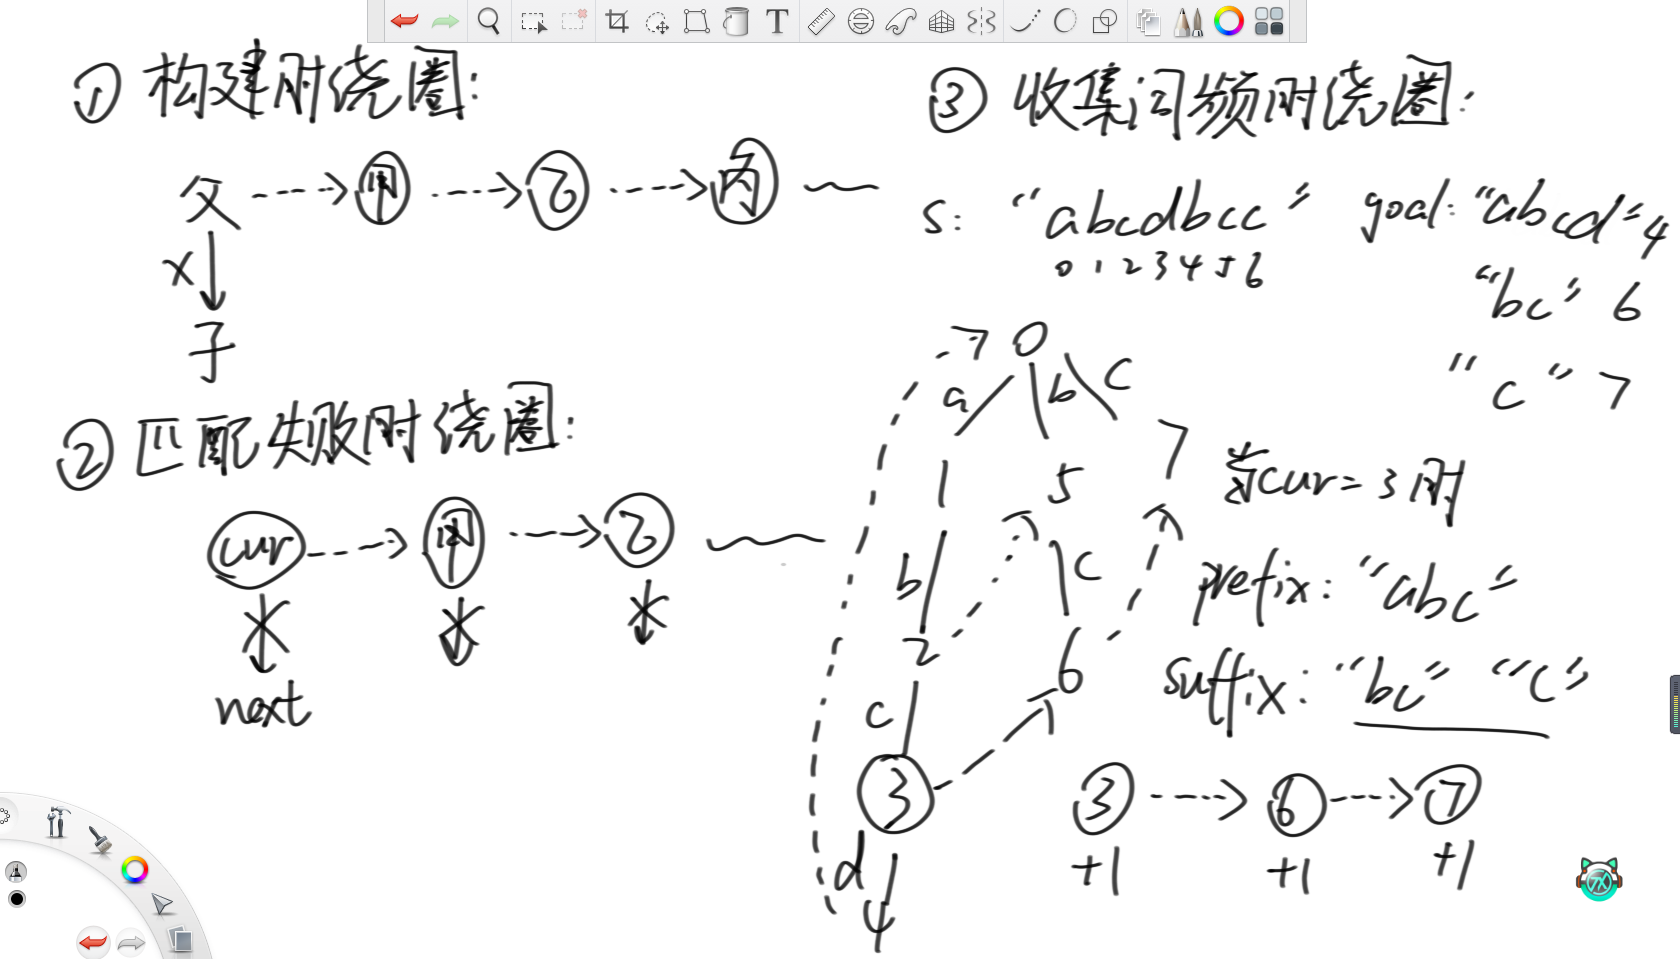
其实观察整个过程就能发现,在根据fail指针跳转时存在三个绕圈的情况。首先就是在构建fail指针时,若一直找不到相同的向下的路径,那就fail指针就会一直绕圈。其次,在匹配失败时,若一直找不到能匹配上的向下的路径,fail指针也会一直绕圈。最后,在收集词频时,因为要沿着fail指针收集,所以也存在绕圈行为。
三、对fail指针绕圈的优化
1.构建和失败寻路时不绕圈
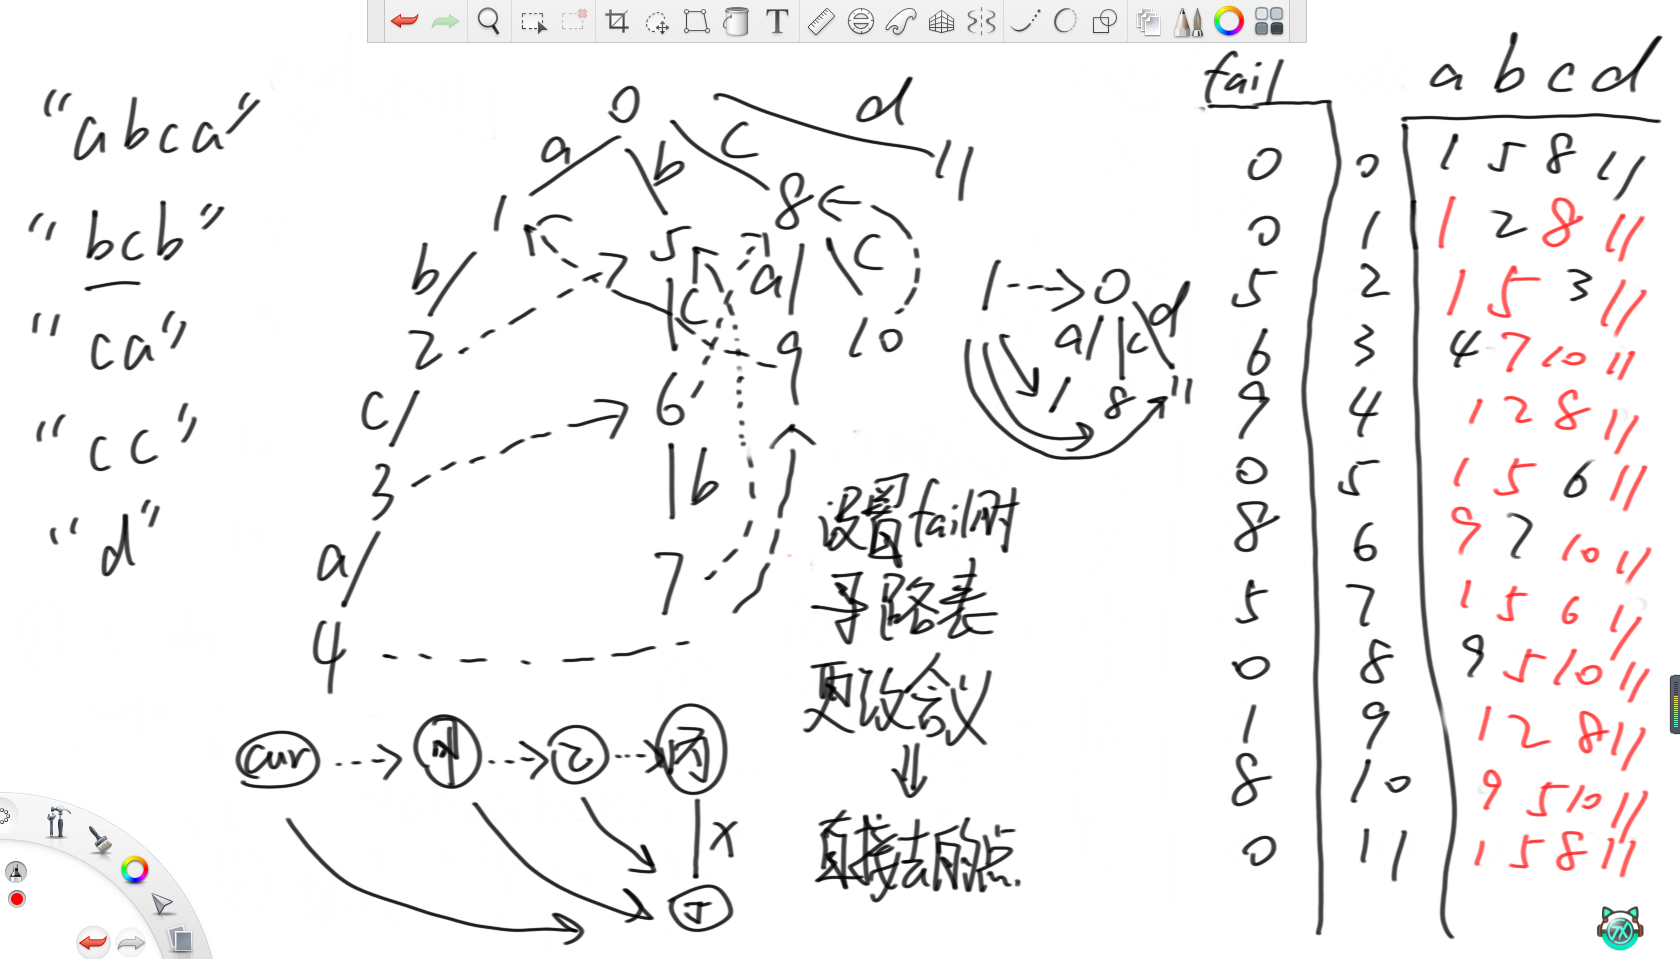
首先就要处理前两个绕圈行为。这里的方法是更改前缀树寻路表的定义,在其原来路径的基础上,增加类似“虚拟传送门”的结构,即当遇到不存在的路径时应该跳去的节点。具体方法就是,在构建fail指针时,需要遍历所有可能得路径。若路径存在,那就按原来的方法设置这个孩子的fail指针。如果不存在,就将路径表里这条路去往的节点设置为当前节点fail指针指向节点该路径去往的节点。
在上述例子里,当bfs到1节点时,首先考察路径a,发现没有。那么在匹配失败时,按理来说应该顺着fail指针来到0节点,发现有路径a到1节点,所以应该来到1节点。那么此时就直接在路径表里把1节点的路径a设置为去往1节点,这样在匹配失败时可以直接去,这样就能避免后续匹配失败时绕圈。之后因为路径b存在,所以就设置fail指针。之后路径c和d和路径a同理。而因为是bfs,所以若要绕圈,fail指针指向的节点肯定在前面都被设置为通往同一个节点,所以当前节点可以直接依赖其fail指针,这就避免了在构建fail指针时绕圈。
2.收集词频时不绕圈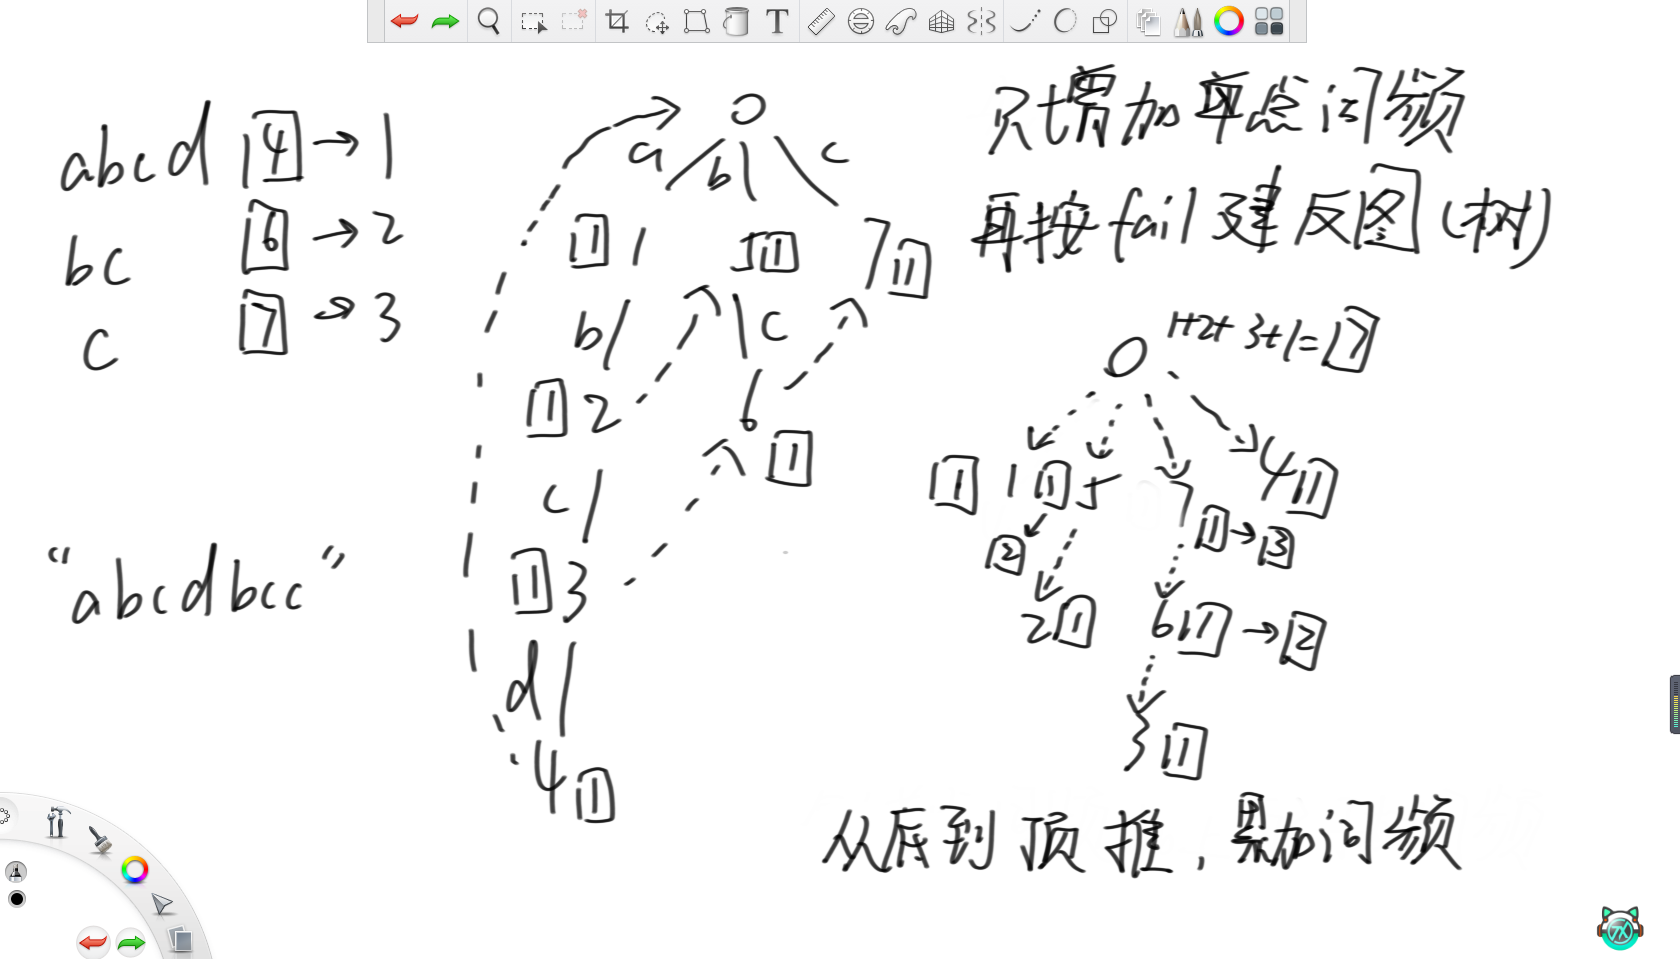
其次就是要解决收集词频时的绕圈问题。方法就是根本不去绕圈,匹配成功就只增加单点的词频。然后在全统计完以后,根据fail指针建反图,然后dfs从底到顶推送词频,每个节点的词频要加上其子树的词频累加和。最后查看目标串结尾节点的词频即可。
其实不难发现,建正图拓扑排序也行。
3.命中报警不绕圈
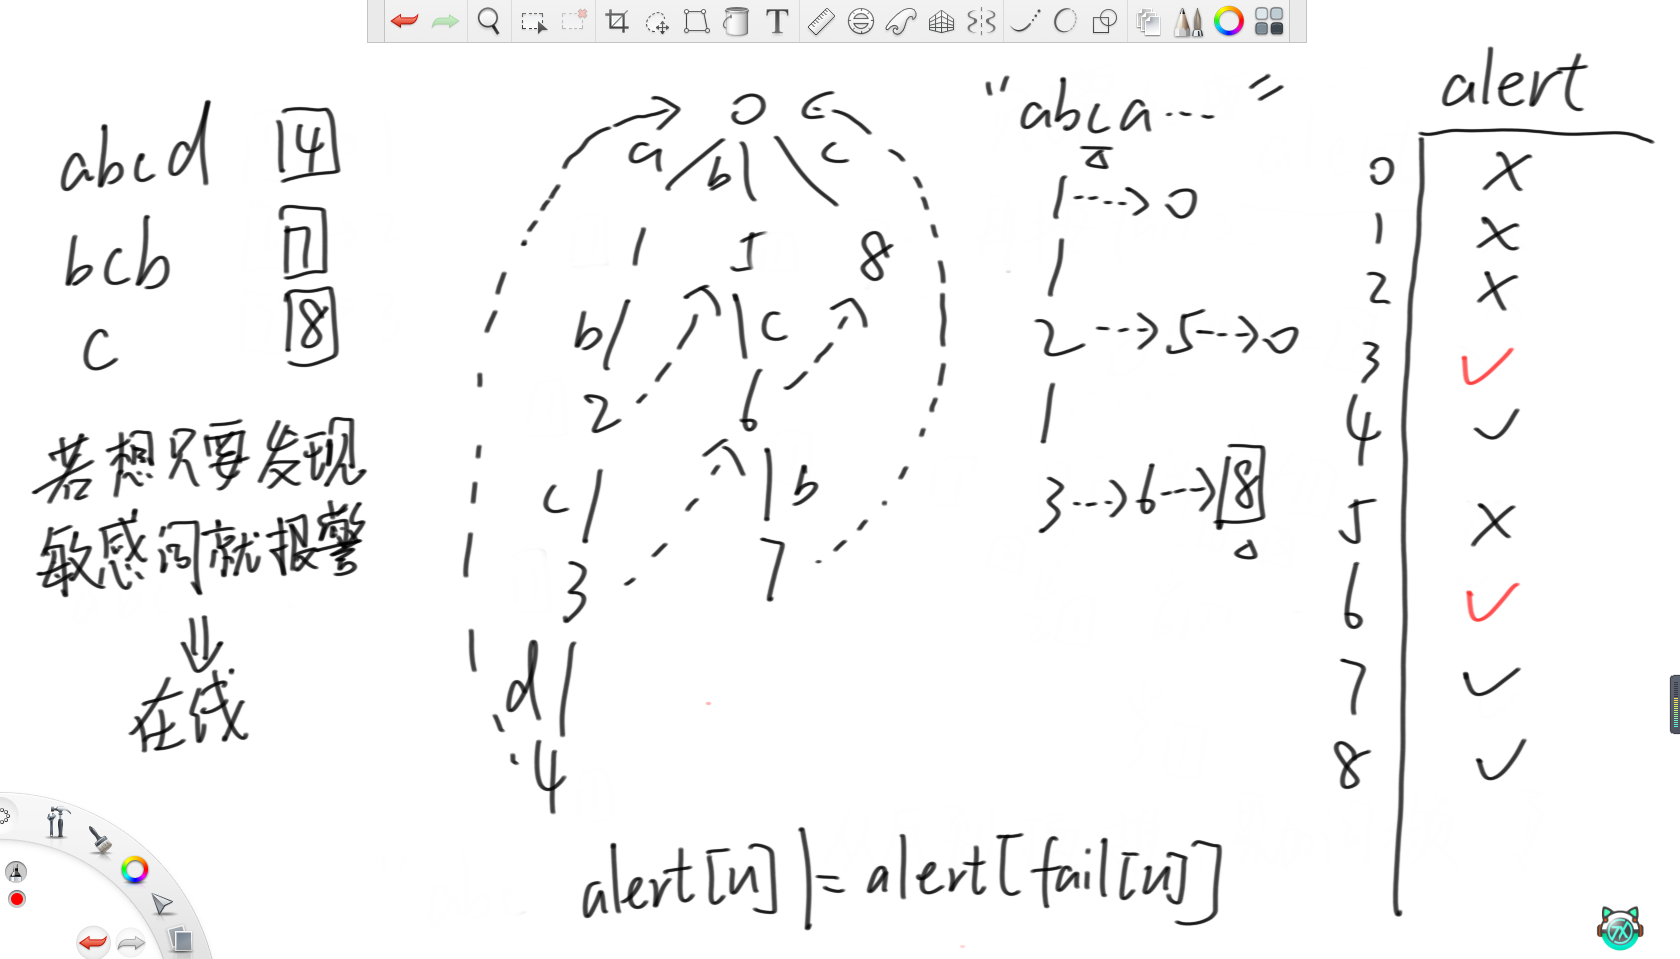
前面说的都是离线处理的情况,即把文章全过一遍之后再返回出现次数。但如果不是找目标字符串的出现次数,而是找文章中有没有敏感词的话,全遍历一遍再返回有没有的话效率会很低。此时就可以考虑在线处理,即在遍历过程中找到了就报警,然后停止后续查找。
首先看为什么存在绕圈行为,在上述例子中,首先在构建fail指针时要同步设置alert数组表示报不报警,所以最初每个敏感词结尾节点的alert都是true,其他都是false,跟endIdx数组一样设置即可。当来到3节点时,同样需要沿fail指针跳,跟统计词频一个原理。而因为跳到了8节点,那就报警然后停止。
防止绕圈的方法就是在设置fail指针时更改当前节点的alert,若其fail指针的alert是true,那么当前节点的alert也是true,原理和失败寻路时不绕圈的优化类似。
四、AC自动机相关题
1.AC 自动机
#include <bits/stdc++.h>
using namespace std;

typedef long long ll;
typedef pair<int,int> pii;

const int MAXN=2e5+5;//目标串数
const int MAXS=2e5+5;//总字符数

//每个目标串结尾节点编号
vector<int>endIdx(MAXN);

//AC自动机
vector<vector<int>>tree(MAXS,vector<int>(26));
vector<int>fail(MAXS);
int cnt=0;

//第i号目标串建前缀树
void insert(int i,string s)
{
    //当前所在的节点
    int u=0;

    for(int j=0;j<s.length();j++)
    {
        int c=s[j]-'a';

        //没路
        if(tree[u][c]==0)
        {
            tree[u][c]=++cnt;
        }

        u=tree[u][c];
    }

    endIdx[i]=u;
}

//设置fail和直通表 -> bfs
void setFail()
{
    queue<int>q;

    //0号节点下一层入队
    for(int i=0;i<=25;i++)
    {
        //有路
        if(tree[0][i]>0)
        {
            q.push(tree[0][i]);
        }
    }

    //bfs
    while(!q.empty())
    {
        int u=q.front();
        q.pop();

        for(int i=0;i<=25;i++)
        {
            if(tree[u][i]==0)//没路 -> 改直通表
            {
                tree[u][i]=tree[fail[u]][i];
            }
            else//有路 -> 设置fail
            {
                fail[tree[u][i]]=tree[fail[u]][i];
                q.push(tree[u][i]);
            }
        }
    }
}

//链式前向星
vector<int>head(MAXS);
vector<int>nxt(MAXS);
vector<int>to(MAXS);
int edge=1;

void addEdge(int u,int v)
{
    nxt[edge]=head[u];
    to[edge]=v;
    head[u]=edge++;
}

//词频表
vector<int>cnts(MAXS);

//汇总词频
void dfs(int u)
{
    for(int ei=head[u];ei>0;ei=nxt[ei])
    {
        int v=to[ei];

        dfs(v);
        cnts[u]+=cnts[v];
    }
}

void solve()
{
    int n;
    cin>>n;
    string tmp;
    for(int i=1;i<=n;i++)
    {
        cin>>tmp;

        //建树
        insert(i,tmp);
    }

    setFail();

    string s;
    cin>>s;

    //增加词频
    for(int i=0,u=0;i<s.length();i++)
    {
        //下一步的节点编号
        u=tree[u][s[i]-'a'];

        cnts[u]++;
    }

    //链式前向星建反图 -> 从1号节点开始
    for(int i=1;i<=cnt;i++)
    {
        addEdge(fail[i],i);
    }

    //汇总词频
    dfs(0);

    for(int i=1;i<=n;i++)
    {
        cout<<cnts[endIdx[i]]<<endl;
    }
}

int main()
{
    ios::sync_with_stdio(0);cin.tie(0);cout.tie(0);
    int t=1;
    //cin>>t;
    while(t--)
    {
        solve();
    }
    return 0;
}
这个就是模板题了,只有前两个优化,第三个优化在下一个题里。
首先就是读入每个目标串,然后insert建立前缀树,注意在最后要设置当前目标串的结尾节点。之后就是setFail设置fail指针和直通表,那就是一个标准的bfs。准备好一个队列后,每次考察所有可能的路径,存在就设置fail指针,不存在就改直通表。接着读入文章,遍历统计一遍词频。然后链式前向星建立反图,然后dfs统计词频,最后根据endIdx的节点输出即可。
2.数数
#include <bits/stdc++.h>
using namespace std;

typedef long long ll;
typedef pair<int,int> pii;

const int MOD=1e9+7;

const int MAXN=1201+5;//目标串数
const int MAXS=2000+5;//总字符数

//AC自动机
vector<vector<int>>tree(MAXS,vector<int>(10));
vector<int>fail(MAXS);
int cnt=0;

//报警表
vector<bool>alert(MAXS);

//第i号目标串建前缀树
void insert(string s)
{
    //当前所在的节点
    int u=0;

    for(int j=0;j<s.length();j++)
    {
        int c=s[j]-'0';

        //没路
        if(tree[u][c]==0)
        {
            tree[u][c]=++cnt;
        }

        u=tree[u][c];
    }

    alert[u]=true;
}

//设置fail和直通表 -> bfs
void setFail()
{
    queue<int>q;

    //0号节点下一层入队
    for(int i=0;i<=9;i++)
    {
        //有路
        if(tree[0][i]>0)
        {
            q.push(tree[0][i]);
        }
    }

    //bfs
    while(!q.empty())
    {
        int u=q.front();
        q.pop();

        for(int i=0;i<=9;i++)
        {
            if(tree[u][i]==0)//没路 -> 改直通表
            {
                tree[u][i]=tree[fail[u]][i];
            }
            else//有路 -> 设置fail
            {
                fail[tree[u][i]]=tree[fail[u]][i];
                q.push(tree[u][i]);
            }
        }

        //标记
        alert[u]=alert[u]||alert[fail[u]];
    }
}

//dp表
vector<vector<vector<vector<int>>>>dp
(MAXN,vector<vector<vector<int>>>(MAXS,vector<vector<int>>(2,vector<int>(2,-1))));

//数位dp -> 来到第i位,AC自动机的编号j,能否自由选free,之前是否要过数字has
int DP(int i,int j,int free,int has,int n,vector<int>&num)
{
    //是敏感词
    if(alert[j])
    {
        return 0;
    }
    if(i==n)
    {
        return has;
    }
    if(dp[i][j][free][has]!=-1)
    {
        return dp[i][j][free][has];
    }

    int ans=0;
    int cur=num[i];

    if(has==0)
    {
        if(free==0)//i在开头
        {
            //不要
            ans=(ans+DP(i+1,0,1,0,n,num))%MOD;

            //要
            for(int p=1;p<cur;p++)
            {
                ans=(ans+DP(i+1,tree[j][p],1,1,n,num))%MOD;
            }
            ans=(ans+DP(i+1,tree[j][cur],0,1,n,num))%MOD;
        }
        else
        {
            //不要
            ans=(ans+DP(i+1,0,1,0,n,num))%MOD;

            //要
            for(int p=1;p<=9;p++)
            {
                ans=(ans+DP(i+1,tree[j][p],1,1,n,num))%MOD;
            }
        }
    }
    else
    {
        if(free==0)
        {
            //可以选0
            for(int p=0;p<cur;p++)
            {
                ans=(ans+DP(i+1,tree[j][p],1,1,n,num))%MOD;
            }
            ans=(ans+DP(i+1,tree[j][cur],0,1,n,num))%MOD;
        }
        else
        {
            for(int p=0;p<=9;p++)
            {
                ans=(ans+DP(i+1,tree[j][p],1,1,n,num))%MOD;
            }
        }
    }

    dp[i][j][free][has]=ans;
    return ans;
}

void solve()
{
    string s;
    cin>>s;

    //转数组
    int n=s.length();
    vector<int>num(n);
    for(int i=0;i<n;i++)
    {
        num[i]=s[i]-'0';
    }

    int m;
    cin>>m;
    string tmp;
    for(int i=1;i<=m;i++)
    {
        cin>>tmp;

        insert(tmp);
    }

    setFail();

    cout<<DP(0,0,0,0,n,num);
}

int main()
{
    ios::sync_with_stdio(0);cin.tie(0);cout.tie(0);
    int t=1;
    //cin>>t;
    while(t--)
    {
        solve();
    }
    return 0;
}
这个题就要用到第三个优化了。
这题也是一眼数位dp,不同的就是要保证没有敏感词。所以在建立前缀树时最后把结尾节点的alert设置为true,然后setFail时同时更改每个节点的alert值。
然后定义dp[i][j][free][has]为当前来到i位置,在前缀树上的节点为j,能否自由选择free和之前是否选过has。之后的可能性展开就是数位dp的标准题了,只是加上了在前缀树里的跳转。期间一旦发现alert[j]是true,即配出了个敏感词,那就直接返回0终止。
总结
其实也就初见比较难懂,听完左老师的讲解再自己敲一遍代码,再写的时候就没啥难度了。
END

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 30
 0
- 0


 已为社区贡献6条内容

所有评论(0)