【王树森推荐系统】物品冷启02:简单的召回通道
·
召回的难点
召回的依据
- 有自带图片,文字,地点
- 有算法或人工标注的标签
- 缺少用户点击,点赞等信息,可以反映出笔记本身的质量和什么样的用户喜欢这样的笔记。并且如果一篇笔记还没有交互,那么就不能用 ItemCF 和 UserCF
- 缺少笔记ID embedding,这个是从用户和笔记的交互行为中学习出来的,冷启的时候这个向量刚刚初始化。但是这个特征是最重要的特征之一,缺少这个特征会让召回和排序变得很不准
冷启召回的困难
- 缺少用户交互,还没学好笔记ID embedding,导致双塔模型效果不好。双塔模型是推荐系统中最重要的召回通道,没有之一,离开双塔模型很难做好新笔记的推荐。缺少ID embedding 不止会影响召回还会影响排序,让排序模型的预估做不准
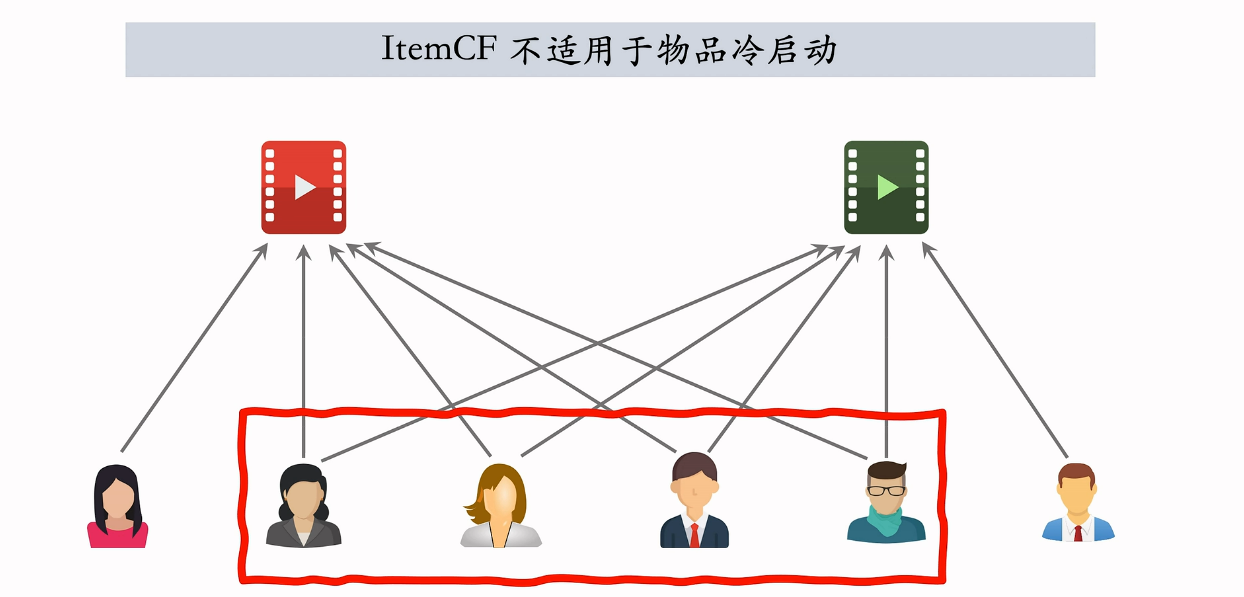
- 缺少用户交互,导致 ItemCF 也不适用,这个也是一个重要的召回通道
- ItemCF 的原理是判断两个物品的相似度有多高
- 而物品的相似度需要通过用户的交互来判断,重合的笔记越多,物品的相似度就越高
召回通道
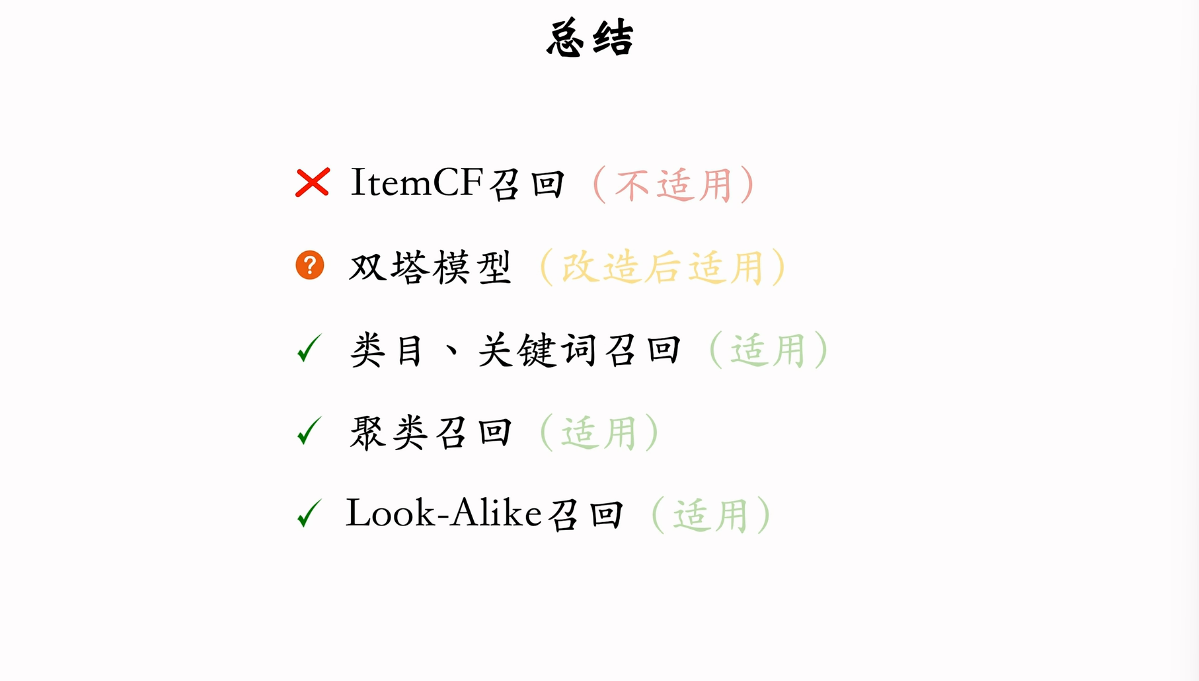
- ItemCF彻底不适用
- 双塔模型改造后适用
- 类目,关键词是弱个性化的召回通道,在笔记刚刚发布的时候,这两种召回通道是最有用的。但是在笔记发布一段时间后,这两个通道会失效
- 聚类召回
- Look-Alike 召回
改造双塔模型使其适用于冷启动
- 以下为常见的双塔模型:以下的ID embedding都是缺失的
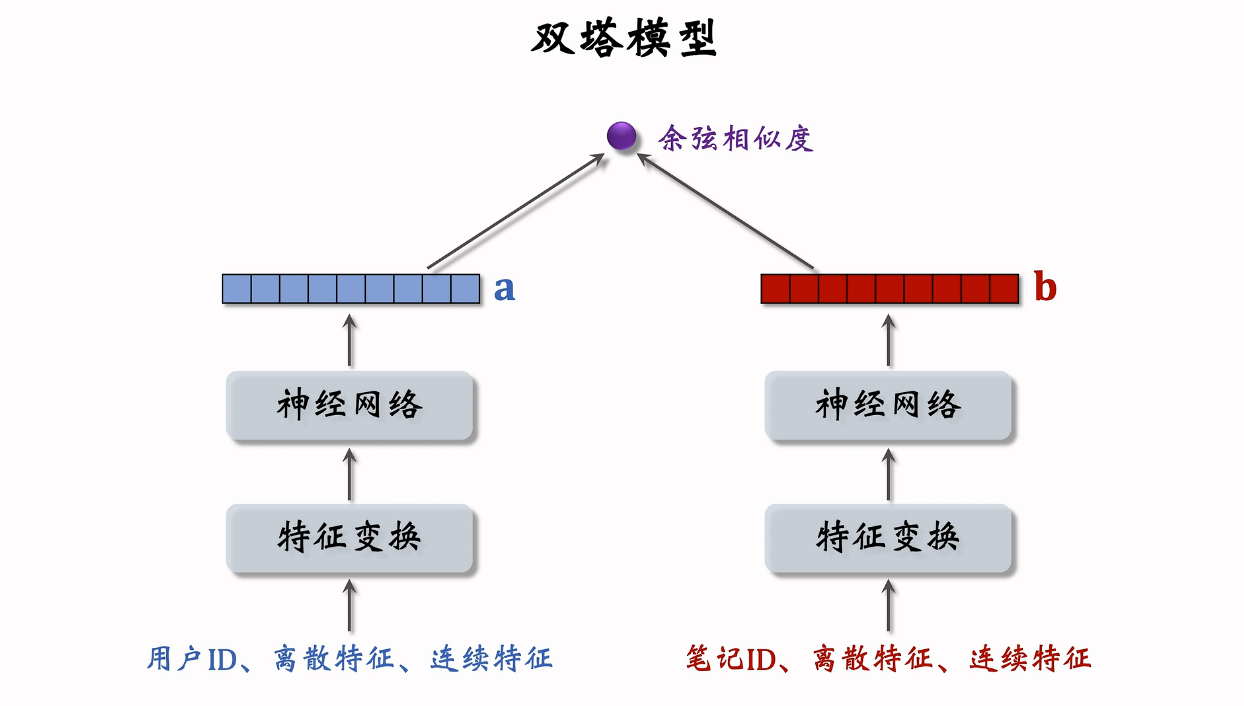
ID embedding改进方案1
- 新笔记使用 default embedding
- 物品塔做ID embedding 时,让所有新笔记共享一个ID,而不是用自己真正的ID
- Default embedding:共享的 ID 对应的 embedding 向量。在实践中是可以获得收益的,这个向量是学出来的,而不是随机初始化。学出来的共享ID embedding 比随机初始化和全零初始化要好
- 到下次模型训练的时候,新笔记有了一些曝光和点击,此时才有自己的 ID embedding 向量
ID embedding改进方案2
- 利用相似笔记的 embedding 向量
- 查找 top k 内容最相似的高曝笔记,相似可以用图片,文字,类目来定义
- 把 k 个高曝笔记的 embedding 取平均,作为新笔记的 embedding
- 用高曝光笔记是因为它们的 ID embedding 学的比较好
多个向量召回池
- 多个召回池,让新笔记有更多曝光机会:
- 1 小时新笔记
- 6 小时新笔记
- 24 小时新笔记
- 30 天笔记
- 假如只有一个 30 天的召回池,那么新笔记很难曝光
- 共享同一个双塔模型,那么多个召回池不增加训练的代价
类目召回
用户画像
- 感兴趣的类目:美食,科技数码,电影等等
- 感兴趣的关键词:纽约,职场,搞笑,程序员,大学等
基于类目的召回
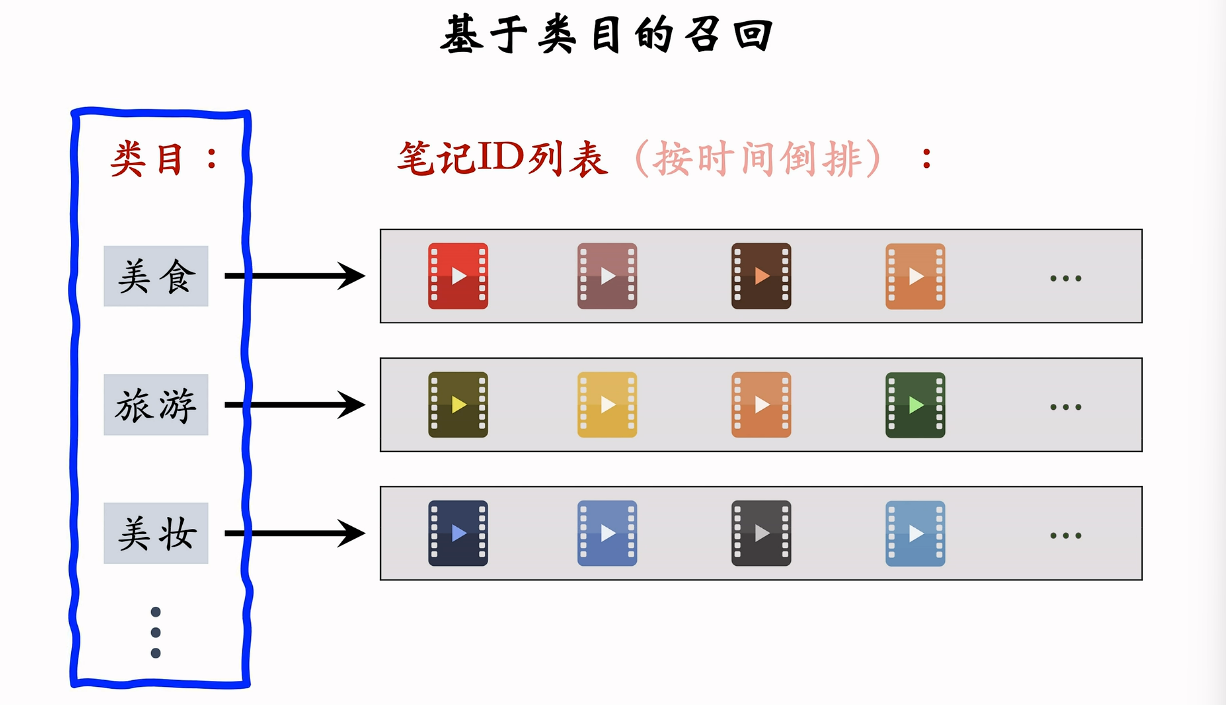
- 系统维护类目索引:类目 → 笔记列表(按时间倒排)
- 用类目索引做召回:用户画像 → 类目 → 笔记列表
- 取回笔记列表上前 k 篇笔记(即最新的 k 篇)
基于关键词的召回
- 系统维护关键词索引:关键词 → 笔记列表(按时间倒排)
- 根据用户画像上的关键词做召回
- 与基于类目的召回的唯一区别就是用关键词代替了类目
缺点
- 缺点 1:只对刚刚发布的新笔记有效。因为他们是按时间倒排的
- 取回某类目/关键词下最新的 k 篇笔记
- 发布几小时后,就再没有机会被召回(被排出去了)
- 缺点2:弱个性化,不够精准。比如我喜欢的是观赏鱼,但是被记录为宠物类目然后模型有根据宠物类目推荐猫猫狗狗
- 虽然缺点明显,但是它们对冷启动很重要,它们能让刚刚发布的新笔记立刻获得曝光,能够提升作者的发布积极性
总结

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 25
 0
- 0


 已为社区贡献17条内容

所有评论(0)