别人都在用的AI神器!魔搭社区+豆包刷题,LLM起飞!
在当今这个数据爆炸的时代,人工智能技术正以前所未有的速度改变着我们的生活和工作方式。其中,大型语言模型(LLM)因其强大的自然语言处理能力而备受关注。在中国,魔搭社区作为国内最大的AI模型开发平台,不仅提供了丰富的在线大模型开发环境,更是成为了连接开发者与先进AI技术的重要桥梁。本文将深入探讨魔搭社区如何通过其独特的资源和服务,助力大模型技术的发展与应用。
什么是大模型?
大型语言模型(LLM)是指那些拥有数十亿甚至上百亿参数的语言模型。这些模型通过深度学习算法,利用海量文本数据进行训练,能够理解和生成人类语言。LLM的核心优势在于其广泛的知识基础和强大的语言理解能力,使其在自然语言处理(NLP)、文本生成、机器翻译等多个领域展现出了卓越的表现。
魔搭社区:大模型的孵化器
modelscope.cn/ 在魔搭社区中,你在线可以选择自己想要使用的大模型并且立即使用,对于我们开发者来说非常方便,它为我们提供了我们电脑上不具备的环境,实现远程大模型的开发和体验,接下来让我们一起来试试看吧:
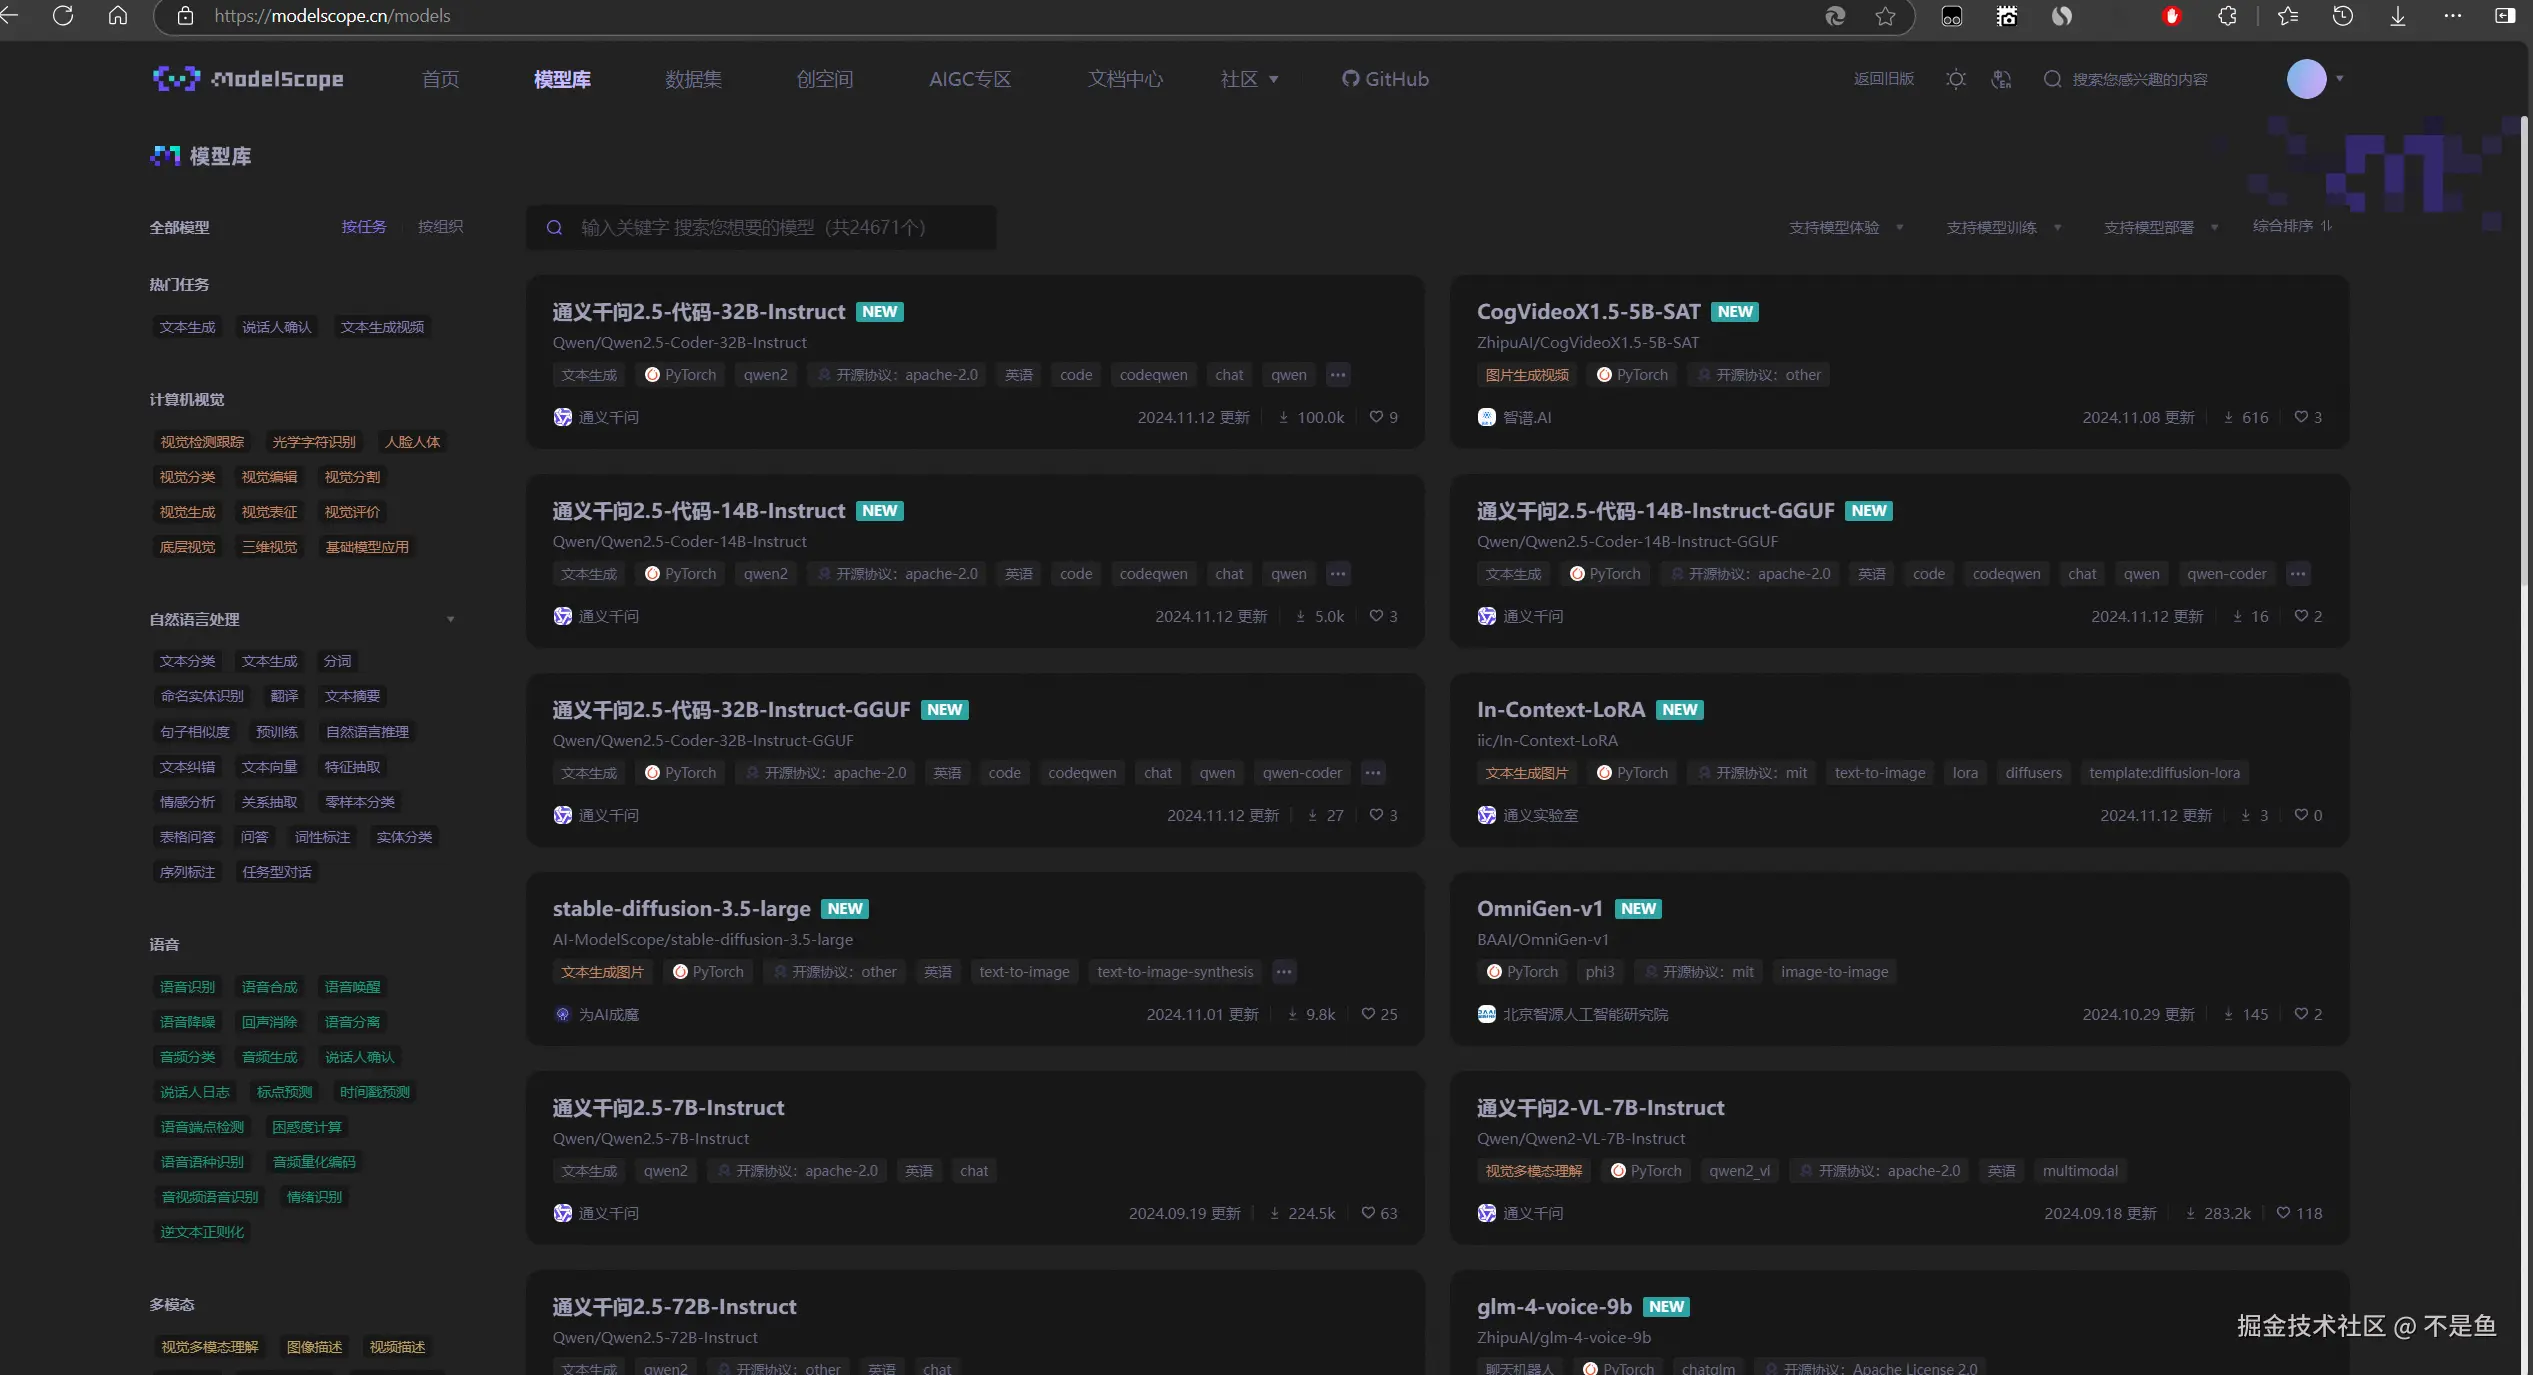
我们就点进页面上第一个通义千问的32B大模型,B是Bilion的缩写,所以我们选择的这个大模型,它的参数是由全球中的上百亿的知识所组成,可想而知它会的究竟有多少。
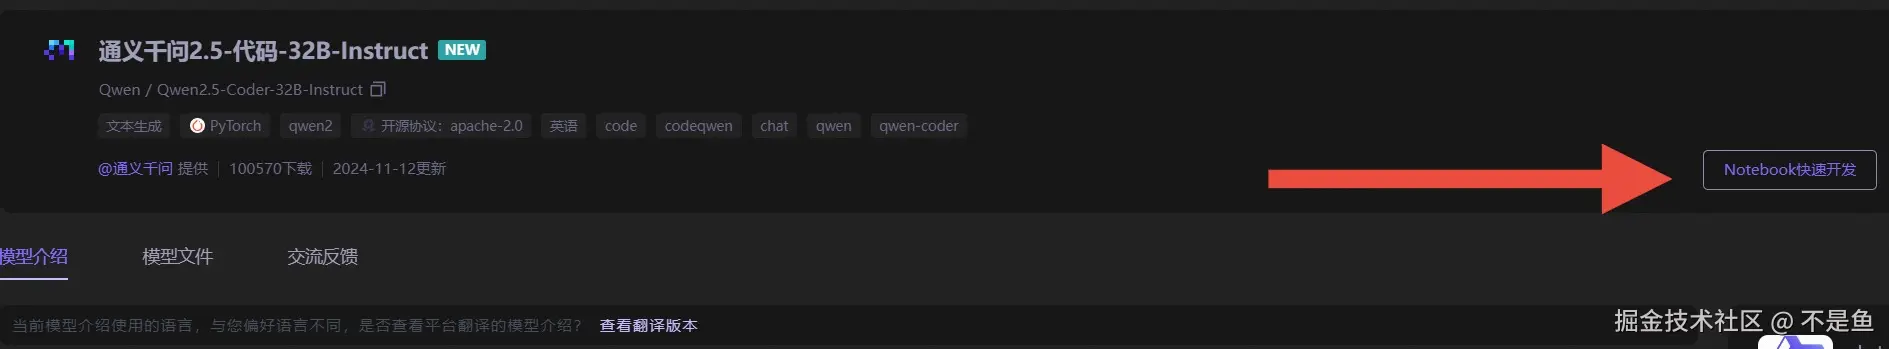
当我们点击这个NoteBook快速开发就可以开始进行我们这次的旅程啦。 在选择大模型使用中极为重要的一点就是我们需要为了业务选择合适的大模型,比如我们熟知的openai,coze,豆包,kimi等,他们有各自的区别,我们应该在当前需求下选择最佳的AI大模型进行使用,在这里,我们通过使用阿里达摩院所开发的用于情感分析的大模型来体验此次开发:
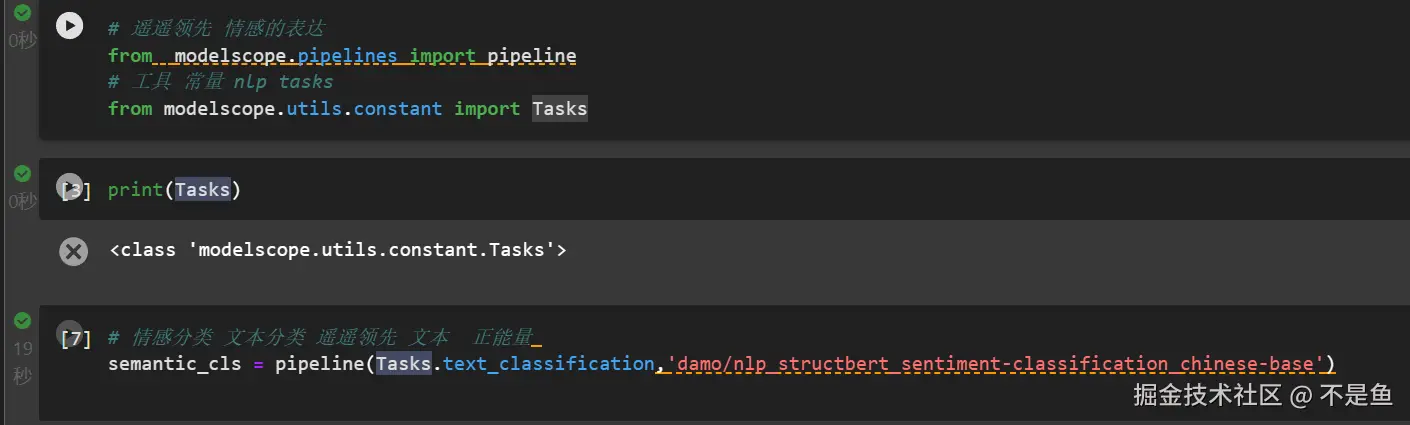
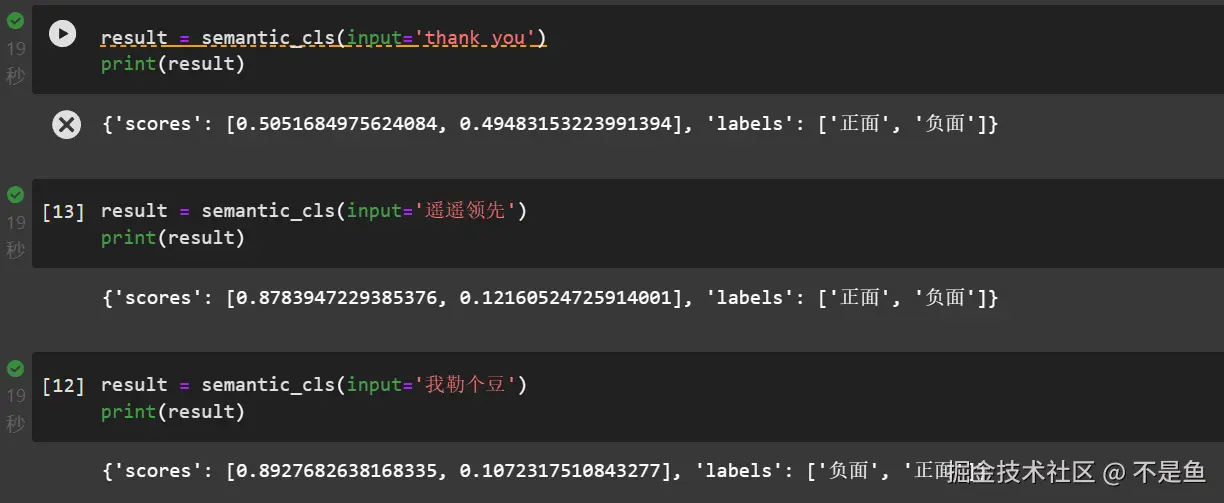
在这里我们进行了了一个导包的操作,通过pipeline函数打开管道,创建了一个用于文本分类的情感分析管道,选择任务后,选择达摩院开发的大模型,最后,通过向管道传递了一段文本,在启动之后,我们就可以输入我们想要向他询问的话,并分析其中的情感是正面多一些还是负面多一些了:
魔搭社区是国内最大的开源大模型社区,旨在为开发者提供一个开放、协作的平台,促进AI技术的创新与发展。以下是魔搭社区的主要特点和优势:
- 丰富的模型资源:
- 预训练模型:魔搭社区提供了多种预训练好的大模型,包括但不限于通义千问、豆包模型、Kimi等。这些模型覆盖了多个领域,如自然语言处理、计算机视觉等。
- 开源模型:除了预训练模型,魔搭社区还支持开源模型的发布和使用,鼓励开发者共享自己的研究成果,共同推动AI技术的发展。
- 便捷的开发环境:
- 云端AI环境:魔搭社区提供了一站式的云端开发环境,开发者可以在平台上直接编写和运行代码,无需担心本地环境的配置问题。
- Python支持:魔搭社区全面支持Python编程语言,提供了丰富的模块和库,方便开发者进行模型调用和数据处理。
- 灵活的任务管道:
- Pipeline机制:魔搭社区引入了Pipeline机制,允许开发者通过简单的API调用,快速构建和执行复杂的AI任务。例如,使用
pipeline函数可以轻松实现文本分类、情感分析等功能。 - 任务选择:魔搭社区提供了多种任务类型,如文本分类、命名实体识别、情感分析等。开发者可以根据具体需求选择合适的任务和模型组合。
大模型的弊端以及npl微调训练
尽管预训练的大模型已经具备了强大的语言理解能力,但它有一个很大的弊端就是它不会自己接受最新的知识,对于今天或者明天的讯息它不会主动去结束,这时候就需要你自己来手动训练它,给他灌输最新的知识,所以我们在网上看到的那些AI大模型app都会不断的更新版本。微调是一种有效的手段,通过在特定任务上对模型进行再训练,可以显著提高模型的准确性和鲁棒性。
微调的过程通常包括以下几个步骤:
- 准备数据:收集并标注特定任务的数据集。
- 加载预训练模型:从魔搭社区下载预训练好的大模型。
- 微调模型:使用标注好的数据对模型进行再训练。
- 评估和部署:评估微调后的模型性能,并将其部署到生产环境中。
LLM的重要性及其未来趋势
随着计算能力的不断提升,特别是GPU等高性能硬件的普及,使得训练更大规模的语言模型成为可能。这意味着未来的LLM将具备更强的理解能力和创造力,能够在更多复杂的场景下发挥作用。同时,随着技术的进步,模型的训练成本也在逐渐降低,这将进一步促进大模型的广泛应用。
此外,端侧模型的发展也不容忽视。随着物联网技术的发展,越来越多的设备开始集成小型化的人工智能功能。这些“小而美”的模型虽然参数量不如云端大模型庞大,但在特定场景下的表现却十分出色,如智能家居、智能汽车等。这种趋势不仅丰富了我们的日常生活,也为AI技术的普及开辟了新的道路。
前后端开发者为什么需要学习LLM?
- 输入 -> code(编程) -> 输出 传统开发方式
- 输入(prompt) -> LLM(大模型) -> 输出 最新最酷的开发方式
- 端模型时代到来:随着AI技术的不断发展,端侧模型的应用越来越广泛。无论是AI手机、AI汽车还是其他智能设备,都需要高效的端侧模型来提供实时的智能服务。
- 提高开发效率:通过学习和使用大模型,前后端开发者可以大幅提高开发效率。许多重复性和繁琐的工作可以交给大模型来完成,使开发者能够专注于更有创造性的任务。
- 拓展职业发展空间:掌握大模型技术不仅可以提升个人技能水平,还能为职业生涯带来更多的机会和发展空间。在未来,具备AI技术背景的开发者将更加受到市场的青睐。
小结
总之,魔搭社区作为一个集成了丰富资源和技术支持的平台,且是我们国内最大的,国内最大的开源大模型社区,正在为中国乃至全球的AI开发者提供强有力的支持。随着大模型技术的不断进步,我们有理由相信,一个更加智能化、个性化的未来正向我们走来。无论是对于专业开发者还是普通用户而言,拥抱新技术、探索新可能,都是通往美好未来的必由之路。通过魔搭社区这样的平台,我们不仅可以接触到最前沿的AI技术,还可以与全球的开发者一起合作,所以现在点进魔搭社区,注册一个账号,开始你的AI探索之路吧。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

一、大模型风口已至:月薪30K+的AI岗正在批量诞生
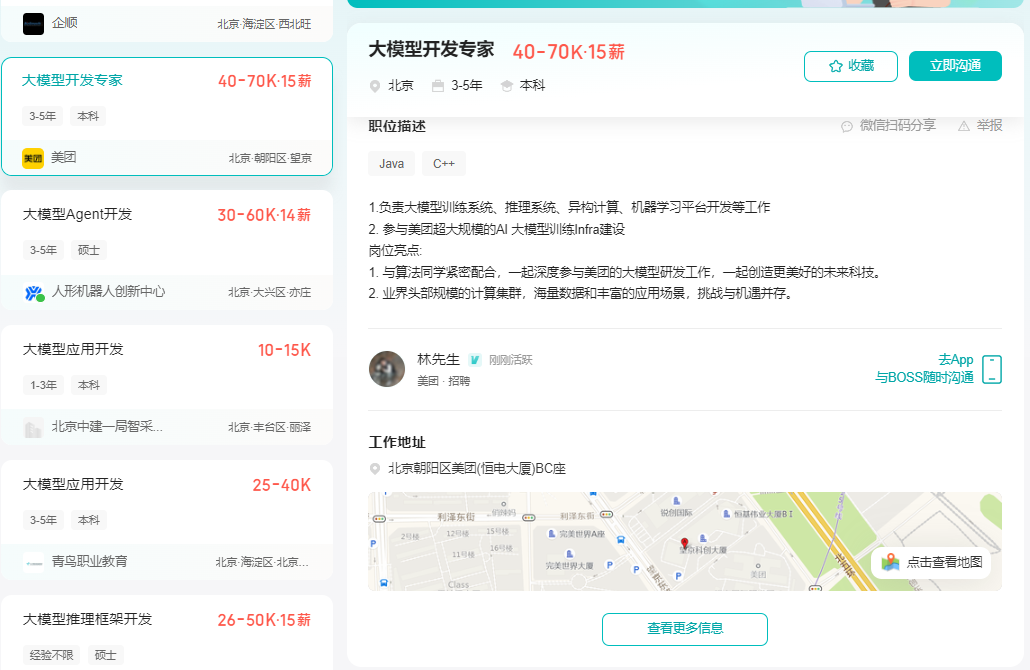
2025年大模型应用呈现爆发式增长,根据工信部最新数据:
国内大模型相关岗位缺口达47万
初级工程师平均薪资28K
70%企业存在"能用模型不会调优"的痛点
真实案例:某二本机械专业学员,通过4个月系统学习,成功拿到某AI医疗公司大模型优化岗offer,薪资直接翻3倍!
二、如何学习大模型 AI ?
🔥AI取代的不是人类,而是不会用AI的人!麦肯锡最新报告显示:掌握AI工具的从业者生产效率提升47%,薪资溢价达34%!🚀
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
1️⃣ 提示词工程:把ChatGPT从玩具变成生产工具
2️⃣ RAG系统:让大模型精准输出行业知识
3️⃣ 智能体开发:用AutoGPT打造24小时数字员工
📦熬了三个大夜整理的《AI进化工具包》送你:
✔️ 大厂内部LLM落地手册(含58个真实案例)
✔️ 提示词设计模板库(覆盖12大应用场景)
✔️ 私藏学习路径图(0基础到项目实战仅需90天)

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
* 大模型 AI 能干什么?
* 大模型是怎样获得「智能」的?
* 用好 AI 的核心心法
* 大模型应用业务架构
* 大模型应用技术架构
* 代码示例:向 GPT-3.5 灌入新知识
* 提示工程的意义和核心思想
* Prompt 典型构成
* 指令调优方法论
* 思维链和思维树
* Prompt 攻击和防范
* …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
* 为什么要做 RAG
* 搭建一个简单的 ChatPDF
* 检索的基础概念
* 什么是向量表示(Embeddings)
* 向量数据库与向量检索
* 基于向量检索的 RAG
* 搭建 RAG 系统的扩展知识
* 混合检索与 RAG-Fusion 简介
* 向量模型本地部署
* …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
* 为什么要做 RAG
* 什么是模型
* 什么是模型训练
* 求解器 & 损失函数简介
* 小实验2:手写一个简单的神经网络并训练它
* 什么是训练/预训练/微调/轻量化微调
* Transformer结构简介
* 轻量化微调
* 实验数据集的构建
* …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
* 硬件选型
* 带你了解全球大模型
* 使用国产大模型服务
* 搭建 OpenAI 代理
* 热身:基于阿里云 PAI 部署 Stable Diffusion
* 在本地计算机运行大模型
* 大模型的私有化部署
* 基于 vLLM 部署大模型
* 案例:如何优雅地在阿里云私有部署开源大模型
* 部署一套开源 LLM 项目
* 内容安全
* 互联网信息服务算法备案
* …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献37条内容

所有评论(0)