深入理解MPEG-4视频编码解码的C语言实现

简介:MPEG-4是一种先进的视频压缩技术,用于视频压缩、流媒体传输和数字视频存储等。在C语言中实现MPEG-4编解码功能要求深入掌握图像处理、算法应用以及相关模块的实现。本文将探讨MPEG-4的编码过程,包括帧间预测、运动补偿、熵编码和量化等步骤,以及解码过程的逆向操作。文章还涉及了在C语言中实现MPEG-4的关键模块,例如图像处理、宏块处理、熵编解码、量化操作和内存管理,并强调了这些模块在实际源代码中的实现细节。整体架构的理解与具体算法的分析将帮助开发者提升编程技能,并加深对视频编码标准的了解。
1. MPEG-4 视频编码标准概述
在当今数字化时代,视频内容的存储和传输要求高效且经济,这催生了各种视频编码标准。MPEG-4,作为ISO组织制定的国际标准,因其高效率和适用性被广泛应用于多种场景中。
1.1 MPEG-4的发展历程与优势
MPEG-4于1998年正式成为标准,与之前的MPEG-1和MPEG-2相比,MPEG-4不仅支持更高的压缩比,还引入了对象基的编码和交互性特征,使它能够适应不同的网络环境和设备。
1.2 MPEG-4的技术特点
MPEG-4技术的核心特点在于其采用的面向对象编码和高效的压缩算法。面向对象的编码方法意味着视频内容被分割成独立的对象,并对每个对象进行编码,这样的处理方式大大提高了压缩效率。
1.3 MPEG-4的应用领域
由于其高度的灵活性和压缩效率,MPEG-4编码标准广泛应用于互联网流媒体、移动视频通信以及交互式多媒体应用等领域,成为现今许多主流视频技术的基石。
随着技术的不断演进,MPEG-4将继续在视频编码领域扮演关键角色,为未来的数字娱乐和信息交换提供支持。下一章,我们将深入探讨MPEG-4编码过程中的关键技术。
2. 编码过程的关键技术解析
2.1 帧间预测机制
2.1.1 预测模型和算法
帧间预测是利用视频帧之间的相关性,通过参考帧来预测当前帧,从而减少编码信息量的一种技术。在MPEG-4编码中,常用的预测模型包括前向预测、后向预测、双向预测等。前向预测使用一个或多个过去的帧作为参考,后向预测使用未来的帧作为参考,而双向预测则结合了前向和后向信息。
算法方面,MPEG-4通常采用块匹配算法(Block Matching Algorithm, BMA),它通过在参考帧中搜索与当前帧块最匹配的块来实现。匹配度通常使用均方误差(MSE)或绝对差和(SAD)来计算。
// 伪代码表示块匹配算法搜索过程
for each block in current_frame {
    min_cost = INFINITY
    best_match_block = NULL
    for each block in reference_frame {
        cost = calculate_cost(current_block, reference_block)
        if cost < min_cost {
            min_cost = cost
            best_match_block = reference_block
        }
    }
    motion_vector = calculate_motion_vector(current_block, best_match_block)
    encode_with_motion_vector(motion_vector)
}
2.1.2 预测误差计算与处理
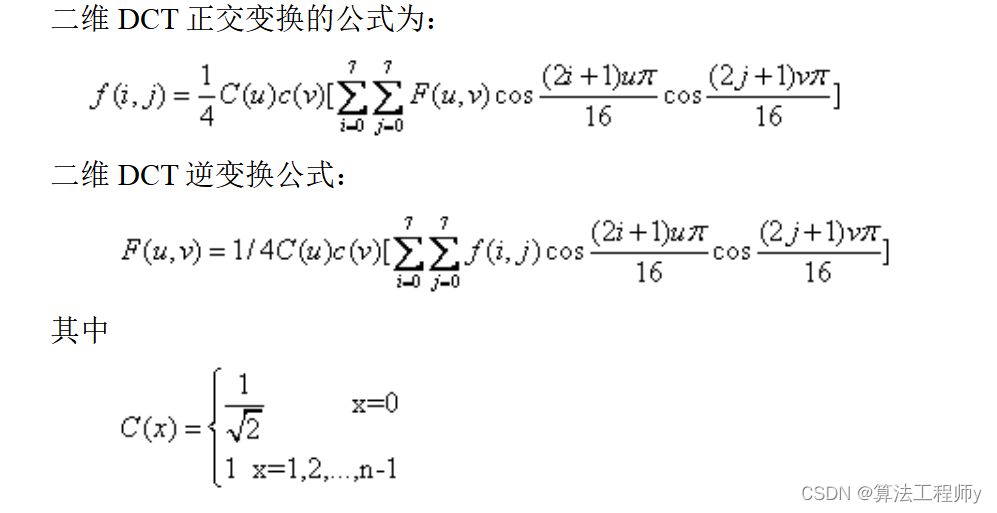
预测误差是指当前帧与预测帧之间的差异。在MPEG-4中,预测误差的处理通常包括变换、量化和熵编码。变换步骤使用例如离散余弦变换(DCT)将空间域的数据转换到频域,量化步骤则根据人类视觉系统的特性减少数据量,最后通过熵编码压缩数据。
// 伪代码表示DCT变换后的量化过程
quantized_coefficients = quantize(dct_transformed_block, quantization_table)

// 伪代码表示量化后的熵编码过程
entropy_encoded_block = entropy_encode(quantized_coefficients)
2.2 运动补偿技术
2.2.1 运动矢量的计算
运动补偿技术的目的是通过计算运动矢量来补偿图像块在连续帧之间的移动。运动矢量通常通过块匹配算法计算得到,它指明了图像块在参考帧中的位置。
// 伪代码表示运动矢量的计算
motion_vector = calculate_motion_vector(block, best_match_block, block_size)
2.2.2 补偿精度和效率优化
为了提高补偿精度,MPEG-4支持不同大小的块进行匹配,如16x16、8x8或4x4像素块。为了提高效率,可以使用半像素或四分之一像素精度的插值算法。优化通常涉及在计算量和预测精度之间的权衡。
// 伪代码表示不同大小块的运动补偿
block_size = determine_block_size(frame, block)
motion_vector = calculate_motion_vector(block, best_match_block, block_size)

// 半像素精度插值
motion_vector_halfPel = interpolate_halfPel(motion_vector)
补偿块 = get_compensated_block(reference_frame, motion_vector_halfPel)
2.3 熵编码与量化过程
2.3.1 熵编码的原理与实现
熵编码是一种无损数据压缩技术,用于进一步减少编码数据的大小。MPEG-4编码中常用的熵编码方法包括可变长编码(VLC)和算术编码。VLC是基于概率分布为不同符号分配不同长度的码字,而算术编码则是利用连续的数值来表示整个数据序列。
// 伪代码表示熵编码过程
coded_symbols = entropy_encode(predicted_block)

// 码字的分配通常基于统计数据,例如Huffman编码树
huffman_tree = build_huffman_tree(symbol_frequencies)
for each symbol in symbols {
    coded_symbols += lookup_huffman_code(symbol, huffman_tree)
}
2.3.2 量化过程及其对图像质量的影响
量化是编码过程中的关键步骤,它将变换后的系数转换为整数,但同时也引入了失真。量化步长的选择对压缩率和图像质量有直接影响。较小的步长可以减少量化噪声,但会增加码流大小。
// 伪代码表示量化过程
quantized_coefficients = round_to_nearest_integer(unquantized_coefficients / quantization_step)

// 影响量化过程的关键参数
quantization_table = create_quantization_table(bit_depth, quality_factor)
下表总结了熵编码和量化过程中的关键参数及其作用:
| 参数名称 | 作用 |
|---|---|
| 概率分布 | 码字分配的依据,影响编码效率 |
| Huffman树 | 变长编码的查找结构,影响编码速度 |
| 量化步长 | 决定量化噪声和压缩率的关键因素 |
| 位深度 | 影响量化精度和动态范围的关键因素 |
| 质量因子 | 影响码流大小和图像质量的平衡参数 |
接下来,我们将深入探讨MPEG-4解码过程的逆向工程。
3. 解码过程的逆向工程
3.1 熵解码技术
熵解码技术是MPEG-4解码过程中非常关键的一个环节,它主要负责将经过压缩的数据还原回原始的视频信号。熵解码的效率直接影响到整个解码器的性能,因此深入理解其原理和实现方式对于提高解码速度和图像质量至关重要。
3.1.1 解码算法的实现细节
熵解码算法的核心是基于霍夫曼编码(Huffman Coding),它是一种广泛使用的熵编码方法,能有效减少数据冗余度。MPEG-4使用变长编码表来将二进制序列转化为原始数据值。解码算法需要精确地反向执行编码时的映射过程。具体来说,解码算法首先从编码流中读取一段特定长度的二进制数据,然后使用解码表将其转换成对应的符号值。
// 简单的霍夫曼解码函数示例
int huffman_decode(const unsigned char *encoded_data, unsigned char *decoded_data, int encoded_size, int *table, int table_size) {
    int index = 0;
    while (index < encoded_size) {
        // 查找解码表,获取霍夫曼码对应的值
        int symbol = lookup_huffman_table(encoded_data + index, table, table_size);
        decoded_data[index++] = symbol;
        // 更新索引位置
        while (symbol) {
            index += symbol;
            symbol = lookup_huffman_table(encoded_data + index, table, table_size);
        }
    }
    return index;
}
3.1.2 解码过程中的数据流分析
在解码过程中,数据流的分析是一个细致的活。每个码字的长度和值都是不同的,因此解码器需要能够适应各种长度的码字。通常情况下,码字的长度与它出现的概率成反比,频繁出现的值通常用较短的码字表示。在解码时,需要逐步构建出正确的码字长度,然后根据这个长度和解码表来还原原始值。
为了更好地理解数据流分析的过程,这里给出一个简化的示例代码,展示了如何根据输入的编码数据和已知的霍夫曼表来还原原始数据:
// 简化的数据流分析示例
void analyze_data_stream(const unsigned char *encoded_data, int encoded_size, int *table, int table_size) {
int current_index = 0;
while (current_index < encoded_size) {
// 解析下一个码字
unsigned int code = next_code(encoded_data, ¤t_index);
// 使用码字值和霍夫曼表获取对应的解码值
int value = lookup_value(code, table, table_size);
if (value == END_OF_STREAM) {
break;
}
// 将解码值输出到decoded_data中
decoded_data[current_index++] = value;
}
}
3.2 反量化和反运动补偿
反量化和反运动补偿是解码过程中将压缩视频还原回可播放格式的重要步骤。反量化涉及将量化后的系数恢复到其原始的幅度值,而反运动补偿则涉及到利用运动矢量信息恢复出帧间预测的差异部分。
3.2.1 反量化方法与步骤
反量化通常包括对量化步长的逆运算,其目的是将整数形式的量化系数转换为接近原始的浮点系数。这个过程需要根据量化表和量化参数来进行。量化表提供了编码过程中使用的量化步长,而量化参数则决定了量化过程的精细程度。
// 反量化过程的简化代码
void inverse_quantize(const int *quantized_coefficients, float *original_coefficients, int size, const int *quant_table, int quant_param) {
    for (int i = 0; i < size; ++i) {
        // 逆量化计算,根据量化步长和参数
        original_coefficients[i] = quantized_coefficients[i] * (quant_table[i] * quant_param);
    }
}
3.2.2 运动估计与补偿的逆过程
运动补偿是基于先前帧的信息来预测当前帧的过程,而反运动补偿则是恢复这些被预测数据的过程。它需要结合运动矢量信息和已经解码的参考帧来精确地计算出当前帧的像素值。
// 反运动补偿的简化代码
void inverse_motion_compensation(int *current_frame, int *reference_frame, int *motion_vectors, int frame_size) {
    for (int y = 0; y < frame_size; ++y) {
        for (int x = 0; x < frame_size; ++x) {
            // 计算参考帧中的预测位置
            int pred_x = x + motion_vectors[x];
            int pred_y = y + motion_vectors[y];
            // 从参考帧获取预测值并应用到当前帧
            current_frame[x + y * frame_size] = reference_frame[pred_x + pred_y * frame_size];
        }
    }
}
以上代码块展示了如何将经过运动补偿的像素值还原到原帧位置,但实际情况会更复杂,需要处理边界条件和插值等更细致的问题。
4. C语言实现MPEG-4编解码的模块化设计
4.1 图像处理模块
4.1.1 模块架构与功能
在MPEG-4编解码器的实现中,图像处理模块是编解码流程的基础。C语言实现该模块时,需要考虑模块的架构设计,以支持高效的图像数据处理。
图像处理模块通常包括以下几个功能:
- 图像读取和存储: 能够加载原始图像数据,支持不同格式的图像文件,例如BMP、JPEG等,并将处理后的图像数据保存到内存或磁盘上。
- 图像格式转换: 由于MPEG-4标准对图像格式有特殊要求,图像处理模块需要提供转换功能,将原始图像格式转换为MPEG-4所需的格式。
- 图像缩放: 编解码过程中可能需要对图像进行缩放,以适应不同的编码参数或传输带宽限制。
- 色彩空间转换: 在RGB和YUV色彩空间之间转换,以满足编解码算法对色彩格式的要求。
4.1.2 图像数据的预处理和后处理
为了准备编码过程,图像数据需要进行预处理,而编码后的图像数据在输出之前还需要进行后处理。
在 预处理 阶段,会执行以下步骤:
- 降噪: 减少图像中由于拍摄或传输造成的噪声,提高编码效率。
- 颜色校正: 调整图像的色彩平衡,确保颜色的准确性。
- 帧间预测准备: 生成预测帧,为帧间预测算法提供必要的历史帧信息。
在 后处理 阶段,编解码器执行:
- 逆变换: 对量化和变换后的数据进行逆变换,恢复图像数据。
- 重建误差调整: 结合重建误差对最终输出的图像进行微调,以提高视觉质量。
4.2 宏块处理技术
4.2.1 宏块的定义与操作
宏块(Macroblock)是MPEG-4视频编码中的基本处理单元。一个宏块通常由16x16个像素构成,是进行帧内预测、帧间预测及运动补偿的基本单位。
在C语言实现中,需要定义宏块的数据结构,包括:
- 像素数据: 存储宏块内每个像素的颜色分量数据。
- 运动向量: 对于帧间编码的宏块,记录其运动向量。
- 参考帧索引: 对于运动补偿,存储参考帧的索引。
- 编码模式: 记录当前宏块的编码模式,如帧内编码、帧间编码等。
宏块的 操作 通常包括:
- 读取与写入: 从输入视频帧读取宏块数据,编码后再写入到压缩数据流。
- 预测计算: 基于不同模式计算宏块的预测值。
- 差分计算: 计算当前宏块与预测宏块之间的差异值。
4.2.2 宏块级别的数据压缩与重构
数据压缩和重构是实现高效视频编码的关键步骤。
数据压缩过程涉及:
- 变换编码: 将空间域的图像数据转换到频率域,常用的变换方法包括DCT(离散余弦变换)。
- 量化: 根据量化参数对变换系数进行量化,减少数据量。
- 编码: 使用熵编码技术对量化后的数据进行编码,以进一步压缩数据。
数据重构过程涉及:
- 熵解码: 将压缩后的数据解码,恢复出量化前的变换系数。
- 反量化: 应用相同的量化表对系数进行反量化,还原系数值。
- 逆变换: 将频率域的系数转换回空间域,得到重构后的图像数据。
// C语言伪代码示例:量化过程
void quantize_block(block_t* block, const int* quant_matrix, int quant_scale) {
    for (int y = 0; y < BLOCK_HEIGHT; ++y) {
        for (int x = 0; x < BLOCK_WIDTH; ++x) {
            int value = block->data[y][x];
            block->data[y][x] = (value / quant_scale) * quant_matrix[y][x];
        }
    }
}
在上述代码块中,我们展示了对一个图像块(block_t类型)进行量化的函数。每个块中的像素值根据量化矩阵(quant_matrix)和量化尺度(quant_scale)被量化。量化过程中要确保数据的准确性和可逆性。
4.3 熵编码/解码的C语言实现
4.3.1 熵编码的C语言算法优化
熵编码是一种变长编码技术,可以无损地压缩数据。在MPEG-4编解码器中,常用的熵编码方法有Huffman编码和算术编码。
C语言实现熵编码时需要关注以下优化策略:
- 字典优化: 在Huffman编码中,预先构建或动态更新字典可以提高编码效率。
- 位操作: 利用位操作对数据进行高效读取和写入,减少计算开销。
- 并行处理: 通过多线程等并行技术提高熵编码的速度。
// C语言伪代码示例:Huffman编码优化
void huffman_encode(const uint8_t* input_data, size_t data_size, uint8_t* output_buffer) {
    // 假设huffman_tree为已构建的霍夫曼树
    for (size_t i = 0; i < data_size; ++i) {
        Node* node = huffman_tree;
        while (node->left || node->right) {
            if (input_data[i] & 0x80) {
                node = node->right;
            } else {
                node = node->left;
            }
            input_data[i] <<= 1;
        }
        output_buffer[node->value] = 1; // 使用节点值作为编码结果
    }
}
此段代码说明了一个简单的Huffman编码过程,通过遍历构建好的霍夫曼树来生成编码结果。优化的关键在于减少在树节点间的遍历次数和高效的位操作。
4.3.2 熵解码的准确性和效率
熵解码是熵编码的逆过程,其准确性和效率同样重要。解码过程需要精确地还原编码数据,同时保证速度。
在实现熵解码时,需要注意以下几点:
- 准确的位流解析: 解码过程应能够准确识别和处理输入的位流,避免误读。
- 高效的位流操作: 利用位操作对数据进行高效读取,减少不必要的数据转换。
- 缓存管理: 优化缓冲区的使用和管理,减少内存分配和释放的开销。
// C语言伪代码示例:Huffman解码优化
void huffman_decode(const uint8_t* input_buffer, size_t buffer_size, uint8_t* output_data) {
    Node* root = huffman_tree;
    Node* current = root;

    for (size_t i = 0; i < buffer_size; ++i) {
        if (input_buffer[i] == 1) {
            current = current->right;
        } else {
            current = current->left;
        }

        if (current->is_leaf) {
            output_data[current->value] = 1; // 使用节点值作为解码结果
            current = root;
        }
    }
}
这段代码演示了一个基本的Huffman解码流程,该流程遍历位流,通过霍夫曼树来还原编码前的数据。
4.4 量化与反量化操作
4.4.1 量化的数学模型
量化过程可以认为是信号强度的有损压缩。通过使用数学模型,量化可以减少数据量,同时尽量保留图像信息。
量化操作通常用到的数学模型是:
- 量化步长(Q Step): 量化步长控制数据压缩的程度,较大的步长意味着更大的数据压缩,但图像质量损失也会更大。
- 量化表(Q Table): 不同频率的系数可能有不同的重要性,量化表可以根据系数的重要性进行加权,以获得更好的编码效果。
量化过程可以用以下公式表示:
Q_{out} = round\left(\frac{Q_{in}}{Q_{step}}\right) \cdot Q_{step}
其中 Q_in 是变换前的数据, Q_out 是量化的结果, round 表示四舍五入操作。
4.4.2 反量化过程的准确性保证
反量化是为了在解码过程中恢复量化前的数据,保证准确的图像质量。反量化操作是量化的逆过程,通常用以下公式表示:
Q_{out} = Q_{in} \cdot Q_{step}
其中 Q_in 是量化后的数据, Q_step 是对应的量化步长, Q_out 是反量化结果。
为了保证反量化的准确性,需要确保:
- 量化步长的准确记录: 在编码过程中记录量化步长,并在解码过程中使用相同的步长进行反量化。
- 位宽的匹配: 确保在量化和反量化过程中数据类型的位宽匹配,避免因为数据截断导致的精度损失。
4.5 头信息处理
4.5.1 头信息结构和功能
头信息是视频帧数据的起始部分,包含了视频帧的元数据信息,例如编解码参数、时间戳、关键帧标记等。头信息的处理对于视频编解码器来说至关重要。
头信息通常包含:
- 序列头信息(Sequence Header): 包含整个视频序列的基本参数,例如分辨率、帧率、比特率等。
- 图像头信息(Picture Header): 包含单个图像帧的参数,例如是否为关键帧、帧内编码的宏块数量等。
- 扩展头信息(Extension Headers): 包含更多的控制信息,如编码模式、运动向量等。
处理头信息需要确保:
- 信息的完整性: 在编码时要确保头信息的完整性,避免解码时信息丢失。
- 解析的准确性: 在解码时,要能准确解析头信息,以便正确解码后续的视频帧数据。
4.5.2 头信息的解析与应用
在C语言实现头信息处理时,要特别注意头信息的解析和应用:
- 解析头信息: 读取头信息并根据解析结果进行相应的处理,比如调整编解码参数。
- 参数更新: 将解码的头信息用于调整后续图像帧的处理,如动态调整编码参数。
- 错误检测: 在解析头信息时进行错误检测,确保编码数据的完整性和可用性。
// C语言伪代码示例:头信息解析
void parse_sequence_header(sequence_header_t* header, uint8_t* buffer, size_t buffer_size) {
    size_t pos = 0;
    // 假设已知头信息长度为header_len
    if (buffer_size < header_len) {
        throw_error("Invalid buffer size");
    }

    header->resolution = read_uint16(buffer + pos); // 读取分辨率信息
    pos += 2;
    header->frame_rate = read_uint16(buffer + pos); // 读取帧率信息
    pos += 2;
    // 解析其他头信息字段...

    // 应用解析出的头信息参数
    configure_encoder(header->resolution, header->frame_rate);
}
在此代码段中,我们展示了解析序列头信息的函数,读取并设置了解码器的分辨率和帧率参数。这保证了头信息被正确解析并应用于视频解码。
4.6 内存管理策略
4.6.1 动态内存分配与回收
在视频编解码过程中,为了处理不同大小的图像数据,动态内存分配是一个必不可少的环节。
C语言实现内存管理时需要考虑:
- 内存分配策略: 根据编解码需求灵活分配内存空间,同时避免内存泄漏。
- 内存碎片管理: 合理管理内存碎片,防止内存碎片过多影响系统性能。
// C语言伪代码示例:动态内存分配与回收
void* allocate_memory(size_t size) {
    void* memory = malloc(size);
    if (!memory) {
        throw_error("Memory allocation failed");
    }
    return memory;
}

void free_memory(void* memory) {
    if (memory) {
        free(memory);
    }
}
上述代码段展示了动态内存分配和回收的基本操作,通过 malloc 函数进行内存分配, free 函数进行内存释放。
4.6.2 内存优化与错误处理
内存优化不仅涉及内存的使用,还包括对内存进行优化以提高性能和减少资源消耗。
对于内存优化,需要考虑:
- 优化内存访问模式: 减少不必要的内存读写操作,提高内存访问效率。
- 内存对齐: 确保数据在内存中按照处理器对齐方式存储,以提高内存访问速度。
错误处理是内存管理中的重要部分,应当:
- 进行运行时检查: 在分配和释放内存时,检查是否有错误发生,如内存分配失败。
- 捕获并处理异常: 适当处理内存相关异常,如捕获段错误并给出提示信息。
通过合理管理内存和正确处理错误,可以提高MPEG-4编解码器的稳定性和性能。
5. MPEG-4编解码器的性能优化
在这一章节中,我们将深入探讨如何对MPEG-4编解码器进行性能优化。性能优化是让编解码器在不同应用场景下都能达到最佳运行效率的关键。我们不仅要关注编解码速度和资源消耗,还要了解如何借助现代技术,如并行处理和硬件加速来提升性能。
5.1 系统级性能分析
在优化MPEG-4编解码器之前,首先需要对其性能有一个系统级的分析,包括编码时间和资源消耗以及性能瓶颈的识别与解决。
5.1.1 编解码时间与资源消耗
编解码的时间效率是衡量编解码器性能的重要指标之一。高效编解码器应当在保证质量的前提下尽可能减少所需时间。资源消耗,包括CPU、内存以及存储空间等,也是评价编解码器性能的重要方面。我们通常使用时间复杂度和空间复杂度来量化编解码过程的资源消耗。
// 示例代码:C语言中计算编解码时间
#include <stdio.h>
#include <time.h>

int main() {
    clock_t start, end;
    double cpu_time_used;

    start = clock();
    // 执行编解码操作
    // 例如:encode_or_decode_video();
    end = clock();

    cpu_time_used = ((double) (end - start)) / CLOCKS_PER_SEC;
    printf("编解码操作耗时: %f 秒\n", cpu_time_used);
    return 0;
}
在上面的示例代码中,我们使用了 clock() 函数来计算编解码操作前后的时间差,从而得到整个操作所耗费的时间。此外,我们还可以监控内存使用情况,例如通过 mallinfo() 函数在Linux下获取。
5.1.2 性能瓶颈识别与优化
性能瓶颈往往是由于算法效率低下或者资源管理不当造成的。因此,识别性能瓶颈是进行优化的第一步。我们可以使用性能分析工具,如gprof或者Valgrind来监测编解码器中哪个函数或模块消耗的资源最多。
一旦识别了瓶颈,我们可以通过算法优化,例如调整数据结构和循环展开,以及优化代码实现,例如减少不必要的内存分配来减少性能损耗。有时,对编译器的优化选项进行调整也能显著提高性能。
5.2 并行处理与多线程
随着多核处理器的普及,利用并行处理和多线程技术成为提升编解码性能的有力手段。
5.2.1 多线程编程模型在MPEG-4中的应用
多线程编程允许我们在程序的不同部分同时执行任务。在MPEG-4编解码器中,比如可以将视频帧分配给不同的线程进行并行处理。OpenMP是一个常用的库,可以轻松实现多线程。
// 示例代码:使用OpenMP进行并行处理
#include <omp.h>
#include <stdio.h>

int main() {
    #pragma omp parallel for
    for (int i = 0; i < 10; i++) {
        printf("线程 %d 处理数据\n", omp_get_thread_num());
    }
    return 0;
}
在上述代码中,我们使用 #pragma omp parallel for 指令告诉编译器并行执行循环体内的代码。 omp_get_thread_num() 函数返回当前线程的ID,可以用来观察多线程执行情况。
5.2.2 并行处理的优势与挑战
并行处理的优势在于它可以显著减少处理时间,特别是在处理大规模数据或者复杂任务时。然而,并行处理也带来了挑战,如线程安全、同步问题以及资源竞争等。需要仔细设计算法,合理划分任务,以避免这些问题。
5.3 硬件加速与专用编解码器
硬件加速是提升编解码性能的另一有效手段,特别是对实时视频应用来说至关重要。
5.3.1 硬件加速技术简介
硬件加速是利用专门设计的硬件资源,如GPU、专用视频处理芯片等来执行特定任务,从而达到加速目的。MPEG-4编解码器可利用这些硬件资源进行高效的视频处理。
5.3.2 专用编解码器的优势与选择
专用编解码器专为视频编解码设计,相比通用处理器,它们可以提供更高的效率和更低的功耗。选择合适的专用编解码器需考虑编码质量和能耗等因素。
通过本章的讨论,我们已经对MPEG-4编解码器的性能优化有了一个全面的认识,这将为实战应用打下坚实的基础。在下一章中,我们将深入探索MPEG-4编解码器的实战应用案例。
6. MPEG-4编解码器的实战应用案例
6.1 媒体播放器集成MPEG-4编解码器
MPEG-4编解码器在媒体播放器中的集成是其实际应用中最为常见的一个场景。为了将MPEG-4编解码器成功集成到媒体播放器中,开发者需要遵循一系列标准步骤并解决特定的技术挑战。
6.1.1 集成方法与步骤
-
确定编解码器API: 首先需要确认MPEG-4编解码器提供的API接口,这些API将被用来在媒体播放器中调用编解码功能。例如,FFmpeg就是一个开源项目,提供了丰富的编解码器接口,可以用来集成到播放器中。
-
媒体播放器的扩展: 需要修改媒体播放器的代码,为MPEG-4格式添加支持。这通常涉及到对播放器源代码的深入分析以及对编解码器架构的理解。
-
流媒体协议适配: 根据实际需求,可能还需要集成支持MPEG-4格式的流媒体协议,如RTSP或HLS。这需要在播放器中添加对这些协议的处理逻辑。
-
测试和调试: 集成完成后,进行广泛测试以确保编解码器和播放器的兼容性以及性能。测试中需要考虑不同网络环境、不同硬件配置下视频的播放效果和编解码效率。
6.1.2 播放器性能与用户体验分析
集成MPEG-4编解码器后,对播放器性能的测试和用户体验的分析是至关重要的。性能方面,需要关注视频播放的流畅性、启动时间、缓冲频率等指标。而用户体验方面,则需要关注播放器的界面友好度、响应速度和操作便捷性。
在测试过程中,可以记录播放器在处理MPEG-4视频时的CPU和内存使用情况。通过对比分析集成编解码器前后的性能数据,可以评估MPEG-4编解码器的集成效果。
graph LR
A[开始集成MPEG-4编解码器] --> B[确定编解码器API]
B --> C[媒体播放器代码修改]
C --> D[流媒体协议适配]
D --> E[测试和调试]
E --> F[性能与用户体验分析]
6.2 实时视频传输与压缩
MPEG-4编解码技术在实时视频传输和压缩领域也得到了广泛的应用。视频压缩的质量直接影响到网络带宽的使用效率和实时视频通信的体验。
6.2.1 实时压缩的技术要求
在实时压缩技术中,MPEG-4编解码器需要满足如下要求:
-
低延迟: 实时视频通信要求编解码过程尽可能缩短时间,以减少视频信号的传输延迟。
-
低带宽使用: 针对带宽限制的情况,编解码器需要优化压缩率,以减少传输过程中的数据量。
-
容错能力: 网络传输不稳定可能造成数据丢失,MPEG-4编解码器应具备一定的错误恢复机制。
6.2.2 实时流媒体传输优化策略
为了优化实时视频流的传输,可以采取以下策略:
-
采用差错控制机制: 如前向纠错(FEC)和重传机制,可以在一定程度上恢复丢失的数据。
-
适应性比特率调整: 根据当前网络状况动态调整视频的比特率,以此来适应带宽的变化。
-
多播和分层编码: 多播可以减轻服务器压力,而分层编码则为不同质量的视频流提供了灵活性。
6.3 移动端视频应用与优化
随着智能手机和其他移动设备的普及,MPEG-4编解码器在移动端的应用变得尤为重要。移动平台上的视频应用需要注重能耗管理和电池寿命优化。
6.3.1 移动平台的编解码器适配
-
硬件加速: 利用移动设备的GPU和专用硬件加速视频编解码过程,可以提高处理速度并降低能耗。
-
软件优化: 编解码器的软件实现需要针对移动设备的CPU架构进行优化,如使用ARM特定的优化指令。
6.3.2 能耗管理与电池寿命优化
-
动态电源管理: 在编解码过程中,根据负载动态调节设备的能耗模式,以降低功耗。
-
减少CPU唤醒次数: 减少不必要的CPU唤醒可以有效延长电池使用时间,因此编解码器应优化任务调度,以减少唤醒次数。
6.4 未来发展趋势与研究方向
6.4.1 高效编解码技术的最新进展
随着技术的不断发展,高效编解码技术也在不断进步。比如,HEVC(High Efficiency Video Coding)是MPEG-4的后续标准,旨在提供更好的压缩效率。在编码算法方面,采用机器学习技术来预测帧间运动,进一步提高压缩率和视频质量。
6.4.2 人工智能在视频编解码中的应用前景
人工智能(AI)与视频编解码技术的结合是未来研究的热点。AI可以用于提升视频内容分析、优化比特率控制和增强视频恢复等方面。例如,深度学习模型可以用来自适应地调整量化参数,从而在保证视频质量的同时达到更高的压缩比。
在实际应用中,开发者应紧密关注这些前沿技术的发展动态,并适时地将新技术集成到产品中,以提高产品的竞争力。
简介:MPEG-4是一种先进的视频压缩技术,用于视频压缩、流媒体传输和数字视频存储等。在C语言中实现MPEG-4编解码功能要求深入掌握图像处理、算法应用以及相关模块的实现。本文将探讨MPEG-4的编码过程,包括帧间预测、运动补偿、熵编码和量化等步骤,以及解码过程的逆向操作。文章还涉及了在C语言中实现MPEG-4的关键模块,例如图像处理、宏块处理、熵编解码、量化操作和内存管理,并强调了这些模块在实际源代码中的实现细节。整体架构的理解与具体算法的分析将帮助开发者提升编程技能,并加深对视频编码标准的了解。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献20条内容

所有评论(0)