经典排序算法(五万字详解,全网最细)
经典排序算法
🌟🌟hello,各位读者大大们你们好呀🌟🌟
🚀🚀系列专栏:【数据结构的学习】
📝📝本篇内容:排序概念;直接插入排序;希尔排序;选择排序;堆排序;冒泡排序;快速排序;hoare版本;三数取中;小区间优化;挖坑法;前后指针版本;非递归版本;三路划分版本;归并排序递归版本;归并排序非递归版本;计数排序;排序总结;完整代码
⬆⬆⬆⬆上一篇:链式二叉树(万字总结)(详细解析,建议收藏!!!)
💖💖作者简介:轩情吖,请多多指教(> •̀֊•́ ) ̖́-
1.排序概念
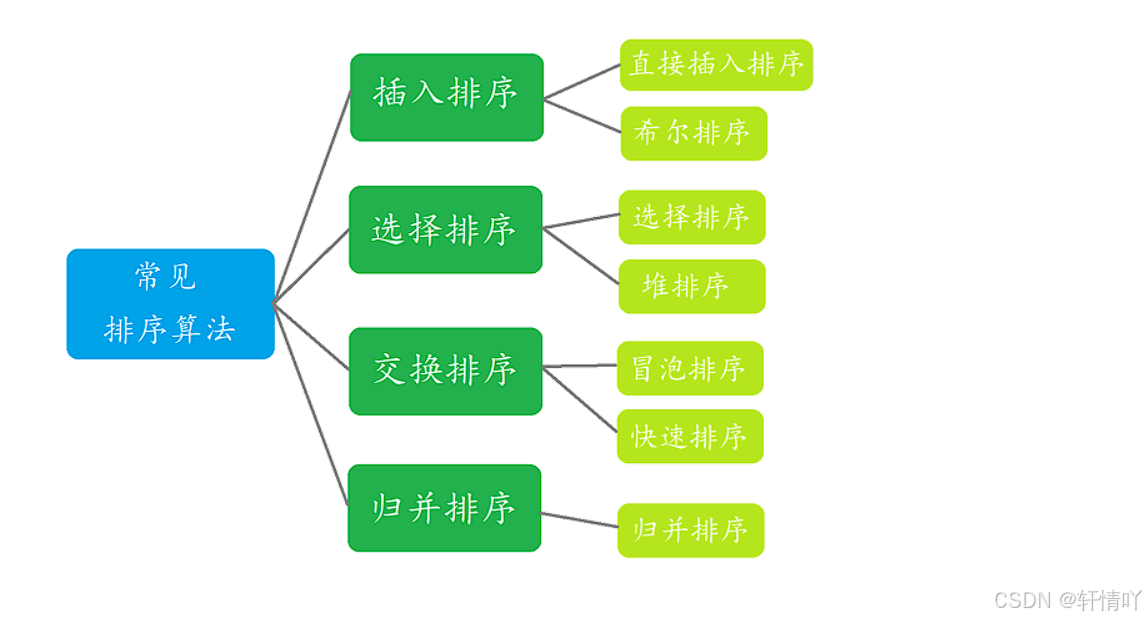
在本小节中,我们主要是围绕着上面的的几种排序来展开讲解。
排序就是按照从大到小降序或者从小到大升序操作,我们以下的讲解都是以升序为例
//Sort.h
#pragma once
#include <stdio.h>
#include <stdbool.h>
#include "stack.h"
#include <stdlib.h>
#include <string.h>
#include <errno.h>
#include <time.h>
void InsertSort(int* arr, int n);//直接插入排序
void ShellSort(int* arr, int n);//希尔排序
void SelectSort(int* arr, int n);//选择排序
void HeapSort(int* arr, int n);//堆排序
void BubbleSort(int* arr, int n);//冒泡排序
void QuickSort(int* arr, int begin, int end);//快速排序
void QuickSortNonR(int* arr, int begin,int end);//快速排序的非递归写法
void MergeSort(int* arr, int n);//归并排序,递归版本
void MergeSortNonR(int* arr, int n);//归并排序,非递归版本,处理越界方法1
void MergeSortNonR2(int* arr, int n);//归并排序,非递归版本,处理越界方法2
void CountSort(int* arr, int n);//计数排序
1.直接插入排序
首先我们先来谈谈直接插入排序,什么是直接插入排序呢?
不知道各位有没有打过牌,在我们整理牌时就是直接插入排序
它的具体算法思想如下:
①从数组的第一个元素开始,该元素可以认为已经被排序。
②取出下一个元素,在已经排序的元素序列中从后向前扫描。
③如果该元素(已排序)大于新元素,则将该元素移到下一位置。
④重复步骤3,直到找到已排序的元素小于或者等于新元素的位置。
⑤将新元素插入到该位置后。
⑥重复步骤2~5,直到所有元素均已排序。
void InsertSort(int* arr, int n)//直接插入排序
{
	//从1号下标开始调整,默认0号下标一个元素有序的
	for (int i = 0; i < n - 1; i++)//end==i,i==n-1时,end+1就会越界变成n
	{
		//单趟插入排序
		int end = i;//进行调整的开始位置
		int x = arr[end + 1];//插入值进行保存,防止覆盖
		while (end >= 0)
		{
			if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
			{
				arr[end + 1] = arr[end];
				end--;
			}
			else
			{
				break;//找到合适的插入位置,跳出
			}
		}
		//在找到的位置放入值
		//两种极端情况:不需要移动;全部元素进行移动
		//不需要移动:end+1就是原来的插入值位置
		//全部元素进行移动:end变成-1,-1+1->0,在0号位置插入
		//正常情况:经过上一趟的排序end--后,插入位置已经是end+1了
		arr[end + 1] = x;
	}
}
下面是图片解析:
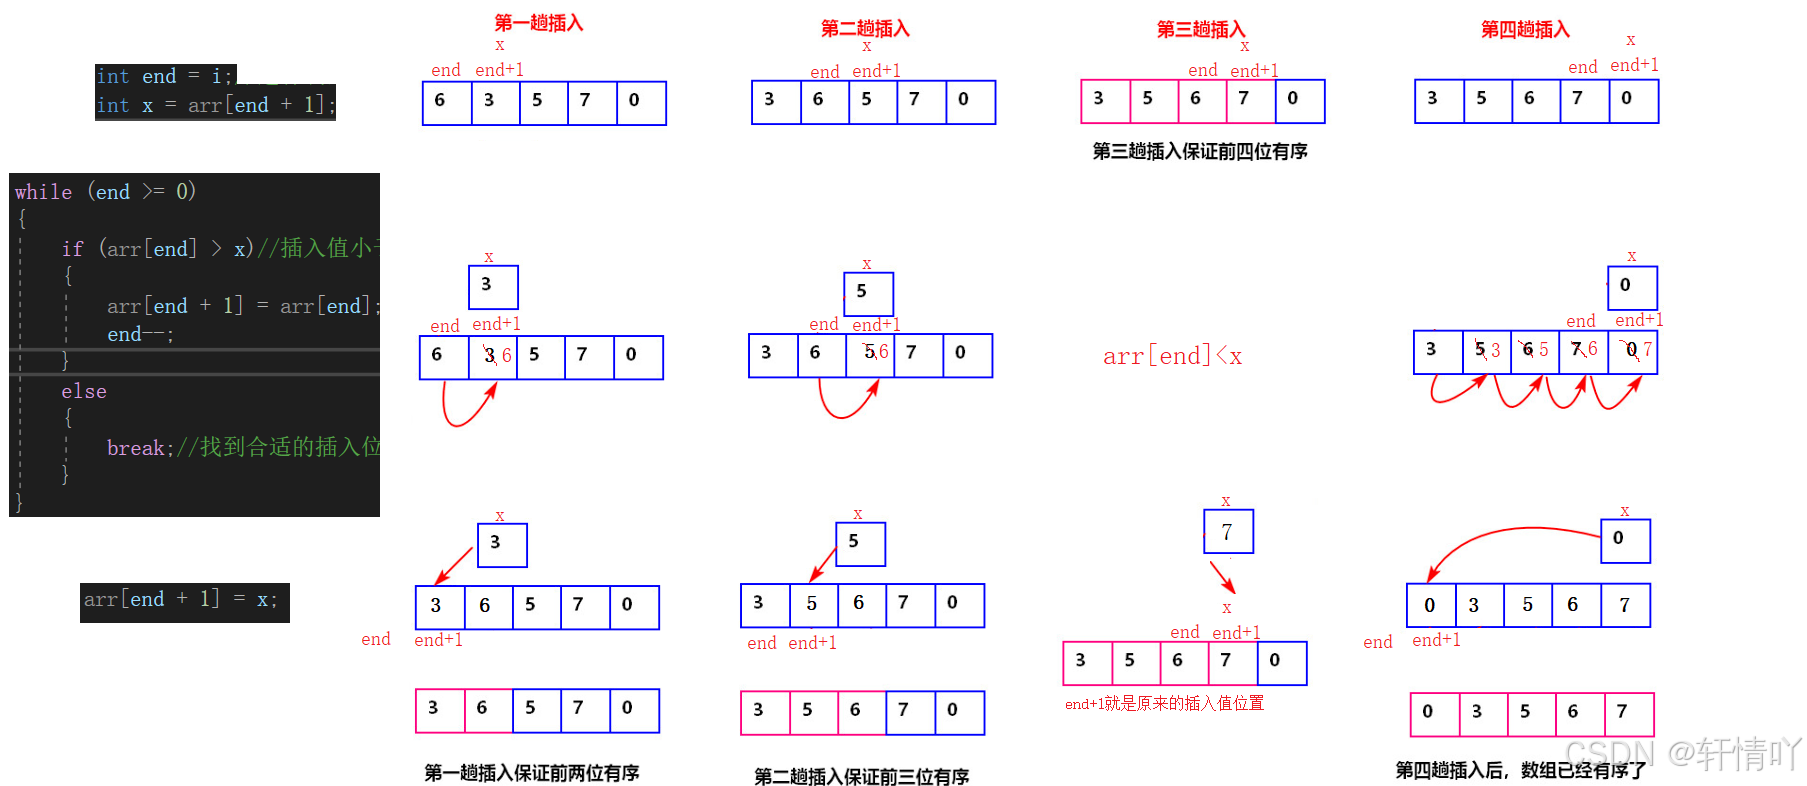
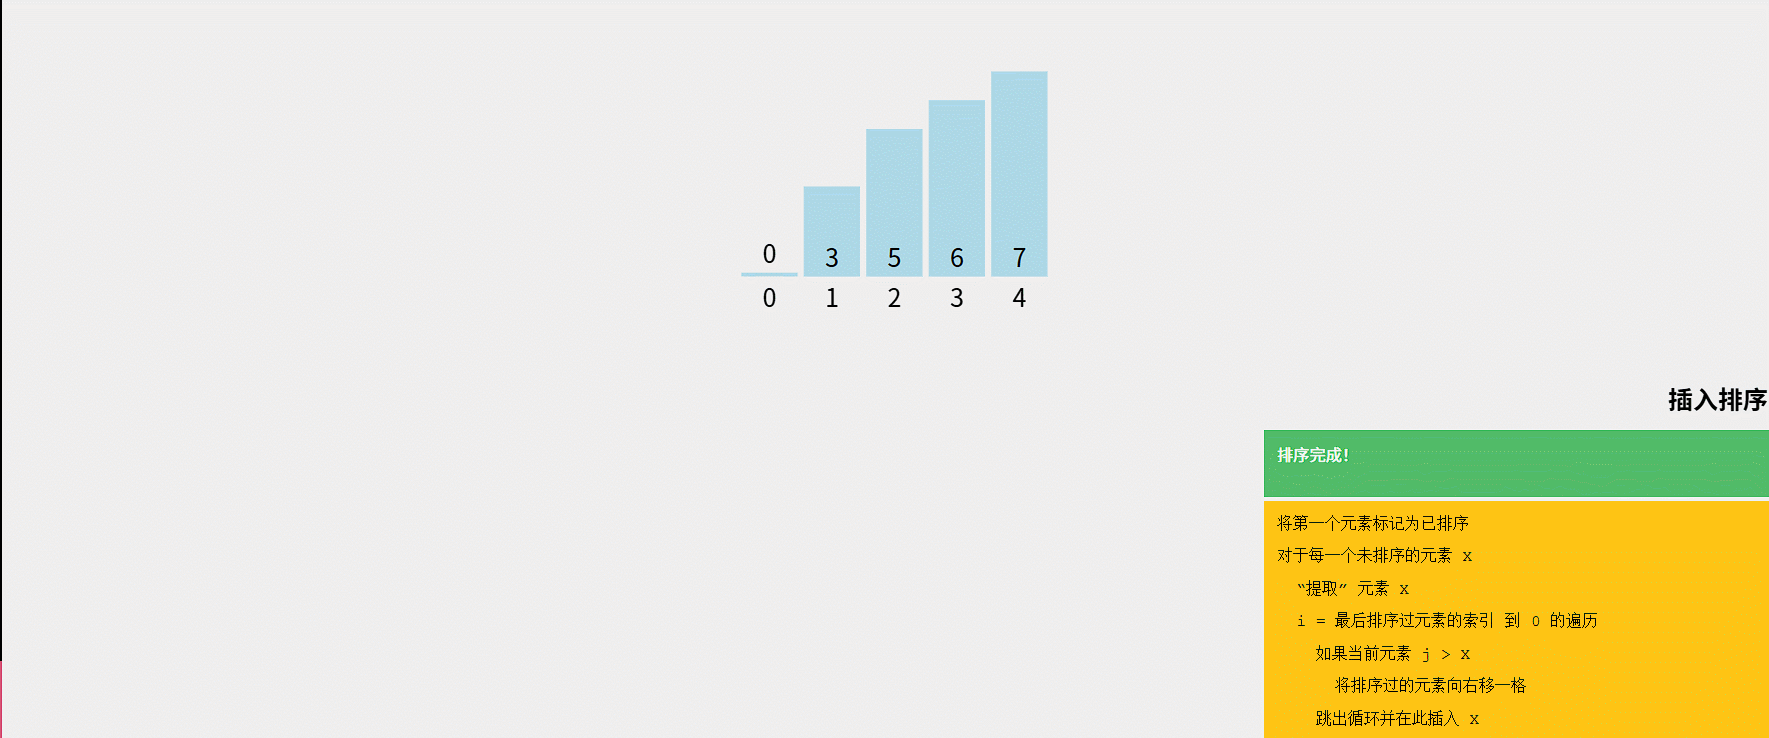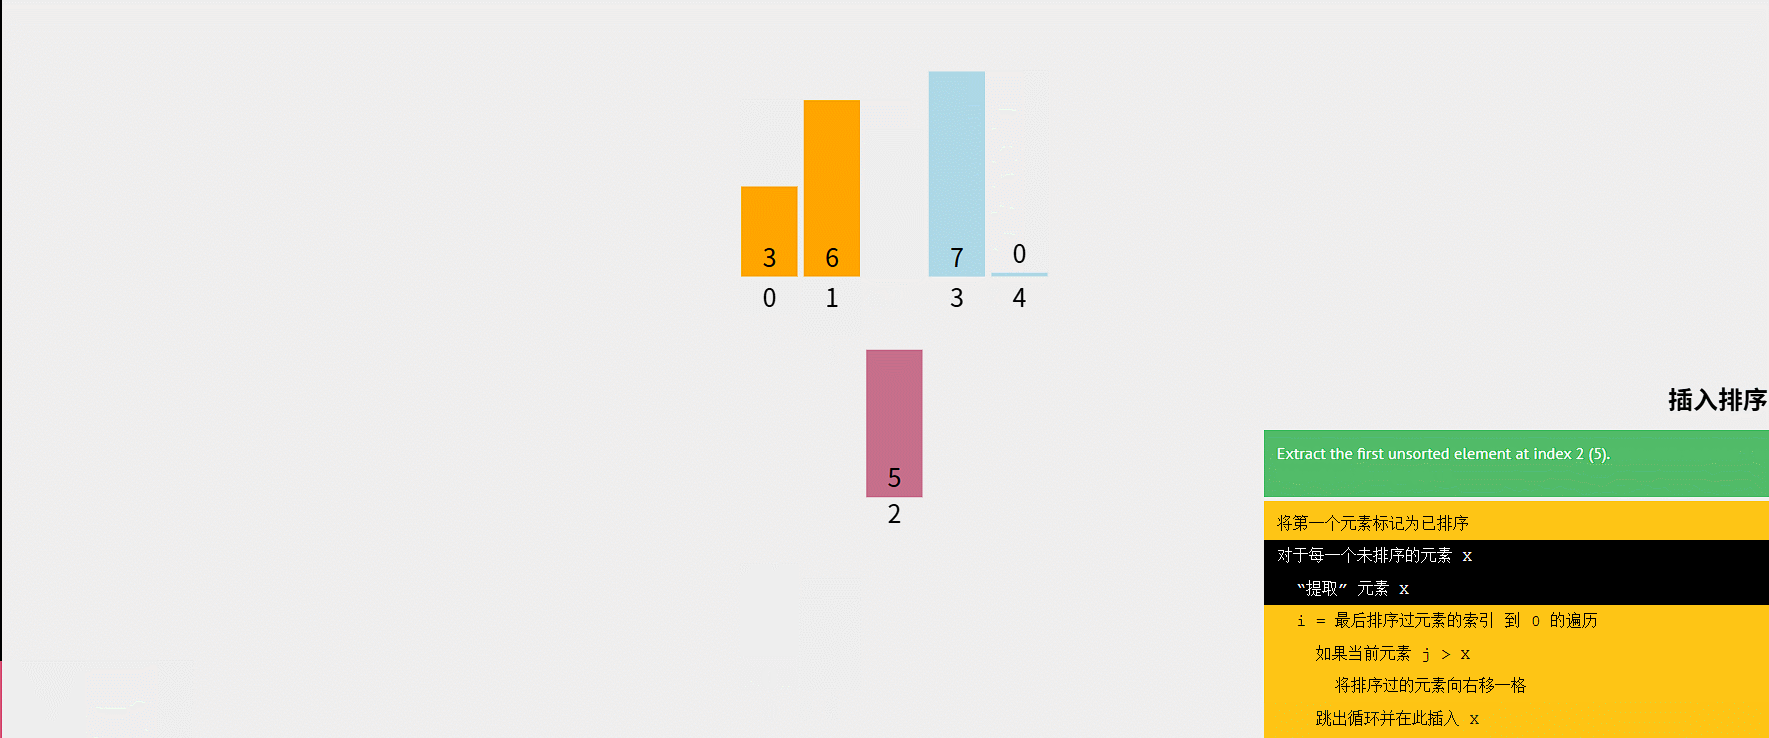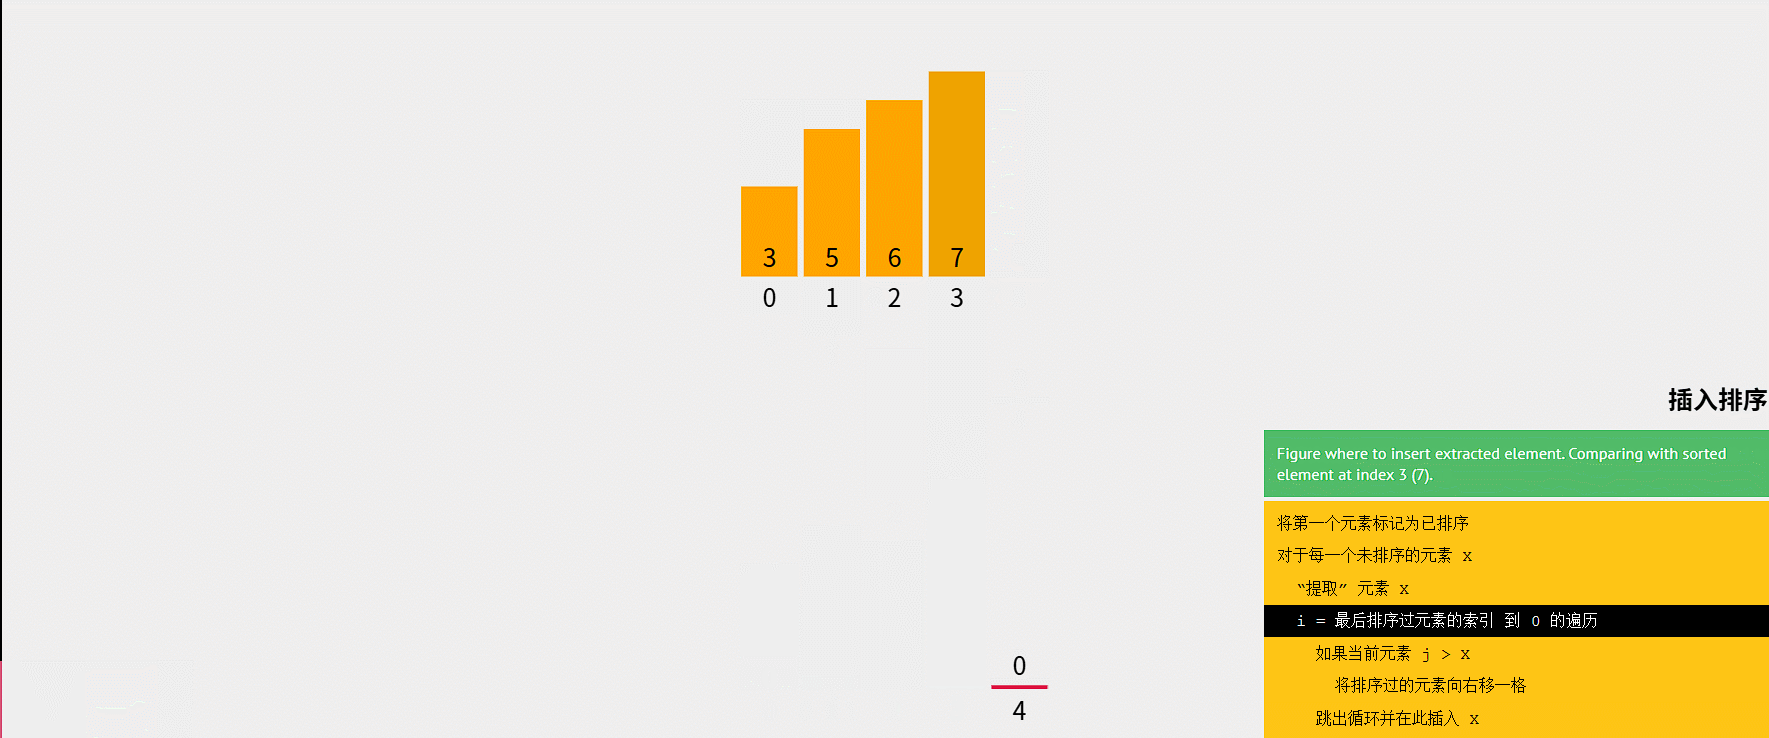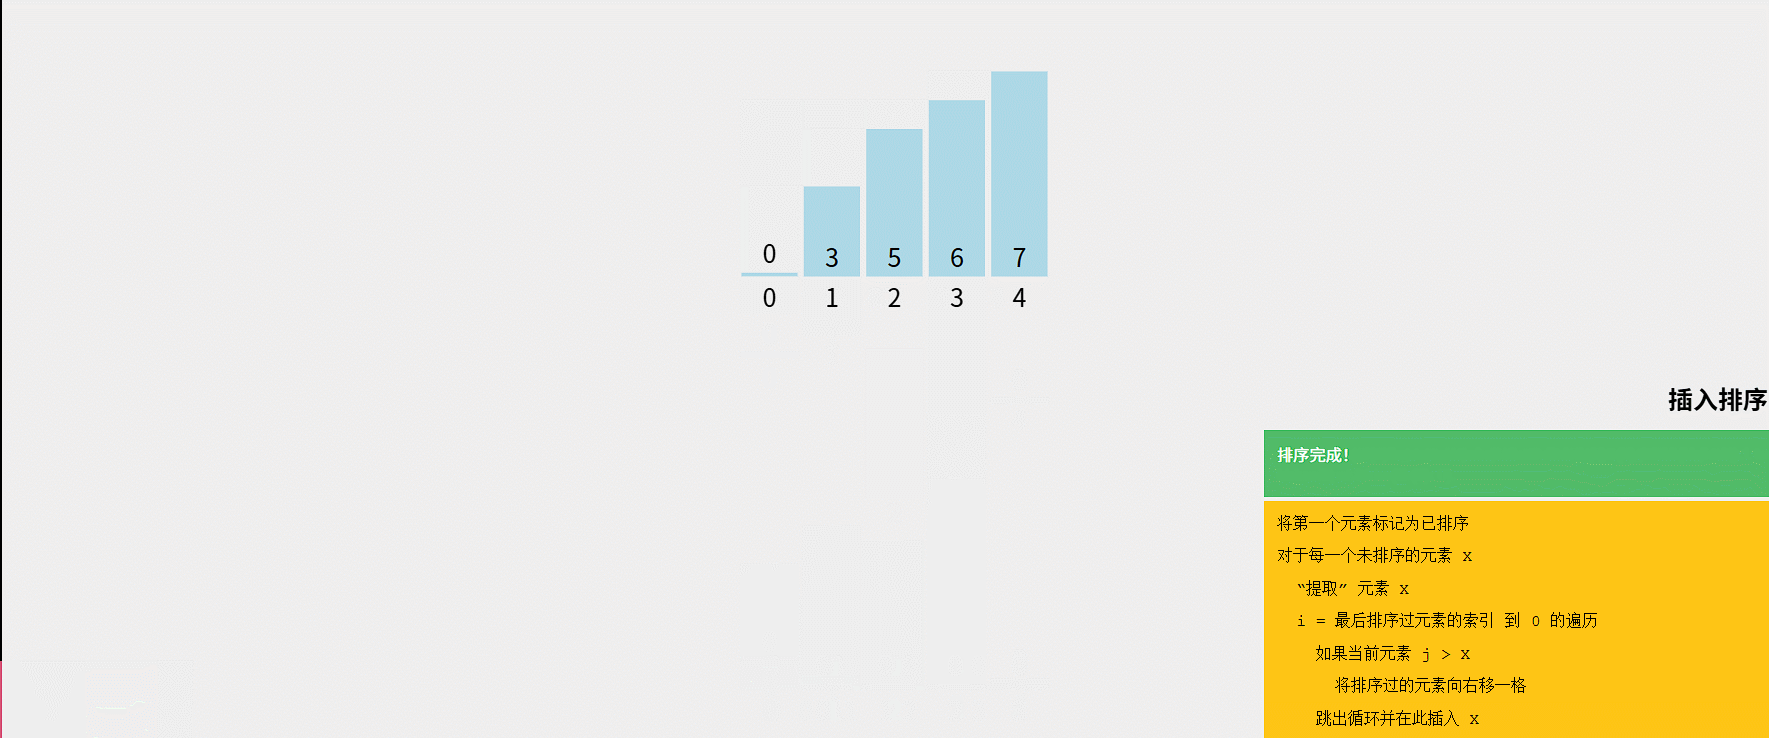
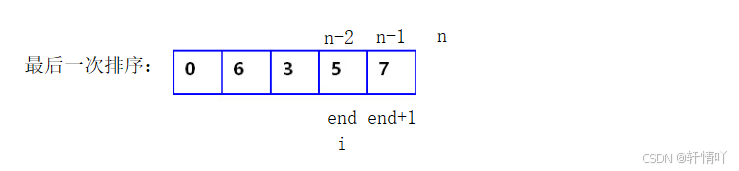
要关注一下循环的结束条件,i<n就会导致i最大可以是n-1,那么在进行排序的时候end+1就变成了n,下标是n就越界了,因此循环条件只能是i<n-1,如下图
直接插入排序的特性总结:
①元素集合越接近有序,直接插入排序算法的时间效率越高
② 时间复杂度:最差的情况是逆序–等差数列–O(N^2),最好的情况是(接近)顺序–共需比较n-1次,没有移动数据–O(N)
③ 空间复杂度:O(1)
④ 稳定性:稳定
2.希尔排序
希尔排序是直接插入排序的优化,因此它是建立在直接插入排序基础上的,但是它也是比较复杂的,我们先简单了解一下它的思想
希尔排序:希尔排序是把记录按下标的一定增量分组,对每组使用直接插入排序算法排序;随着增量逐渐减少,每组包含的关键词越来越多,当增量减至1时,所有数据恰被分成一组,算法便终止。通俗的说法就是先对分组数据使用直接插入排序进行预排序,最后一次再对所有数据进行一次直接插入排序
我们先简单来看看对一组数据预排序的写法,我们使用gap为3(即间距是3)
void ShellSortV1(int* arr, int n)//希尔排序
{
	//希尔排序简单来说就是进行多次的直接插入排序,优化直接插入排序
	//一组元素的预排序
	int gap = 3;

	for (int i = 0; i < n - gap; i += gap)//以gap为间距,下一个需要调整的值就是i+=gap
	{
		int end = i;
		int x = arr[end + gap];//调整的值和插入值相差gap
		//完成一个元素的插入
		while (end >= 0)
		{
			if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
			{
				arr[end + gap] = arr[end];//直接插入排序是end+1,就是gap等于1;这边gap为3
				end -= gap;//下一个end位置间距为gap
			}
			else
			{
				break;//找到合适的插入位置了
			}
		}

		arr[end + gap] = x;//放入元素
	}
}
看下面的图来理解,我们假设有一组数据(逆序,直接插入排序的痛点),设置的gap是3,从0号下标数据开始,每间距是3就是同一组的数据,我们需要对它们进行直接插入排序(预排序)
我们的代码其实和直接插入排序唯一的区别就是gap是3,而直接插入排序是1,因此我们代码中需要找对应数据就需要以gap来加减
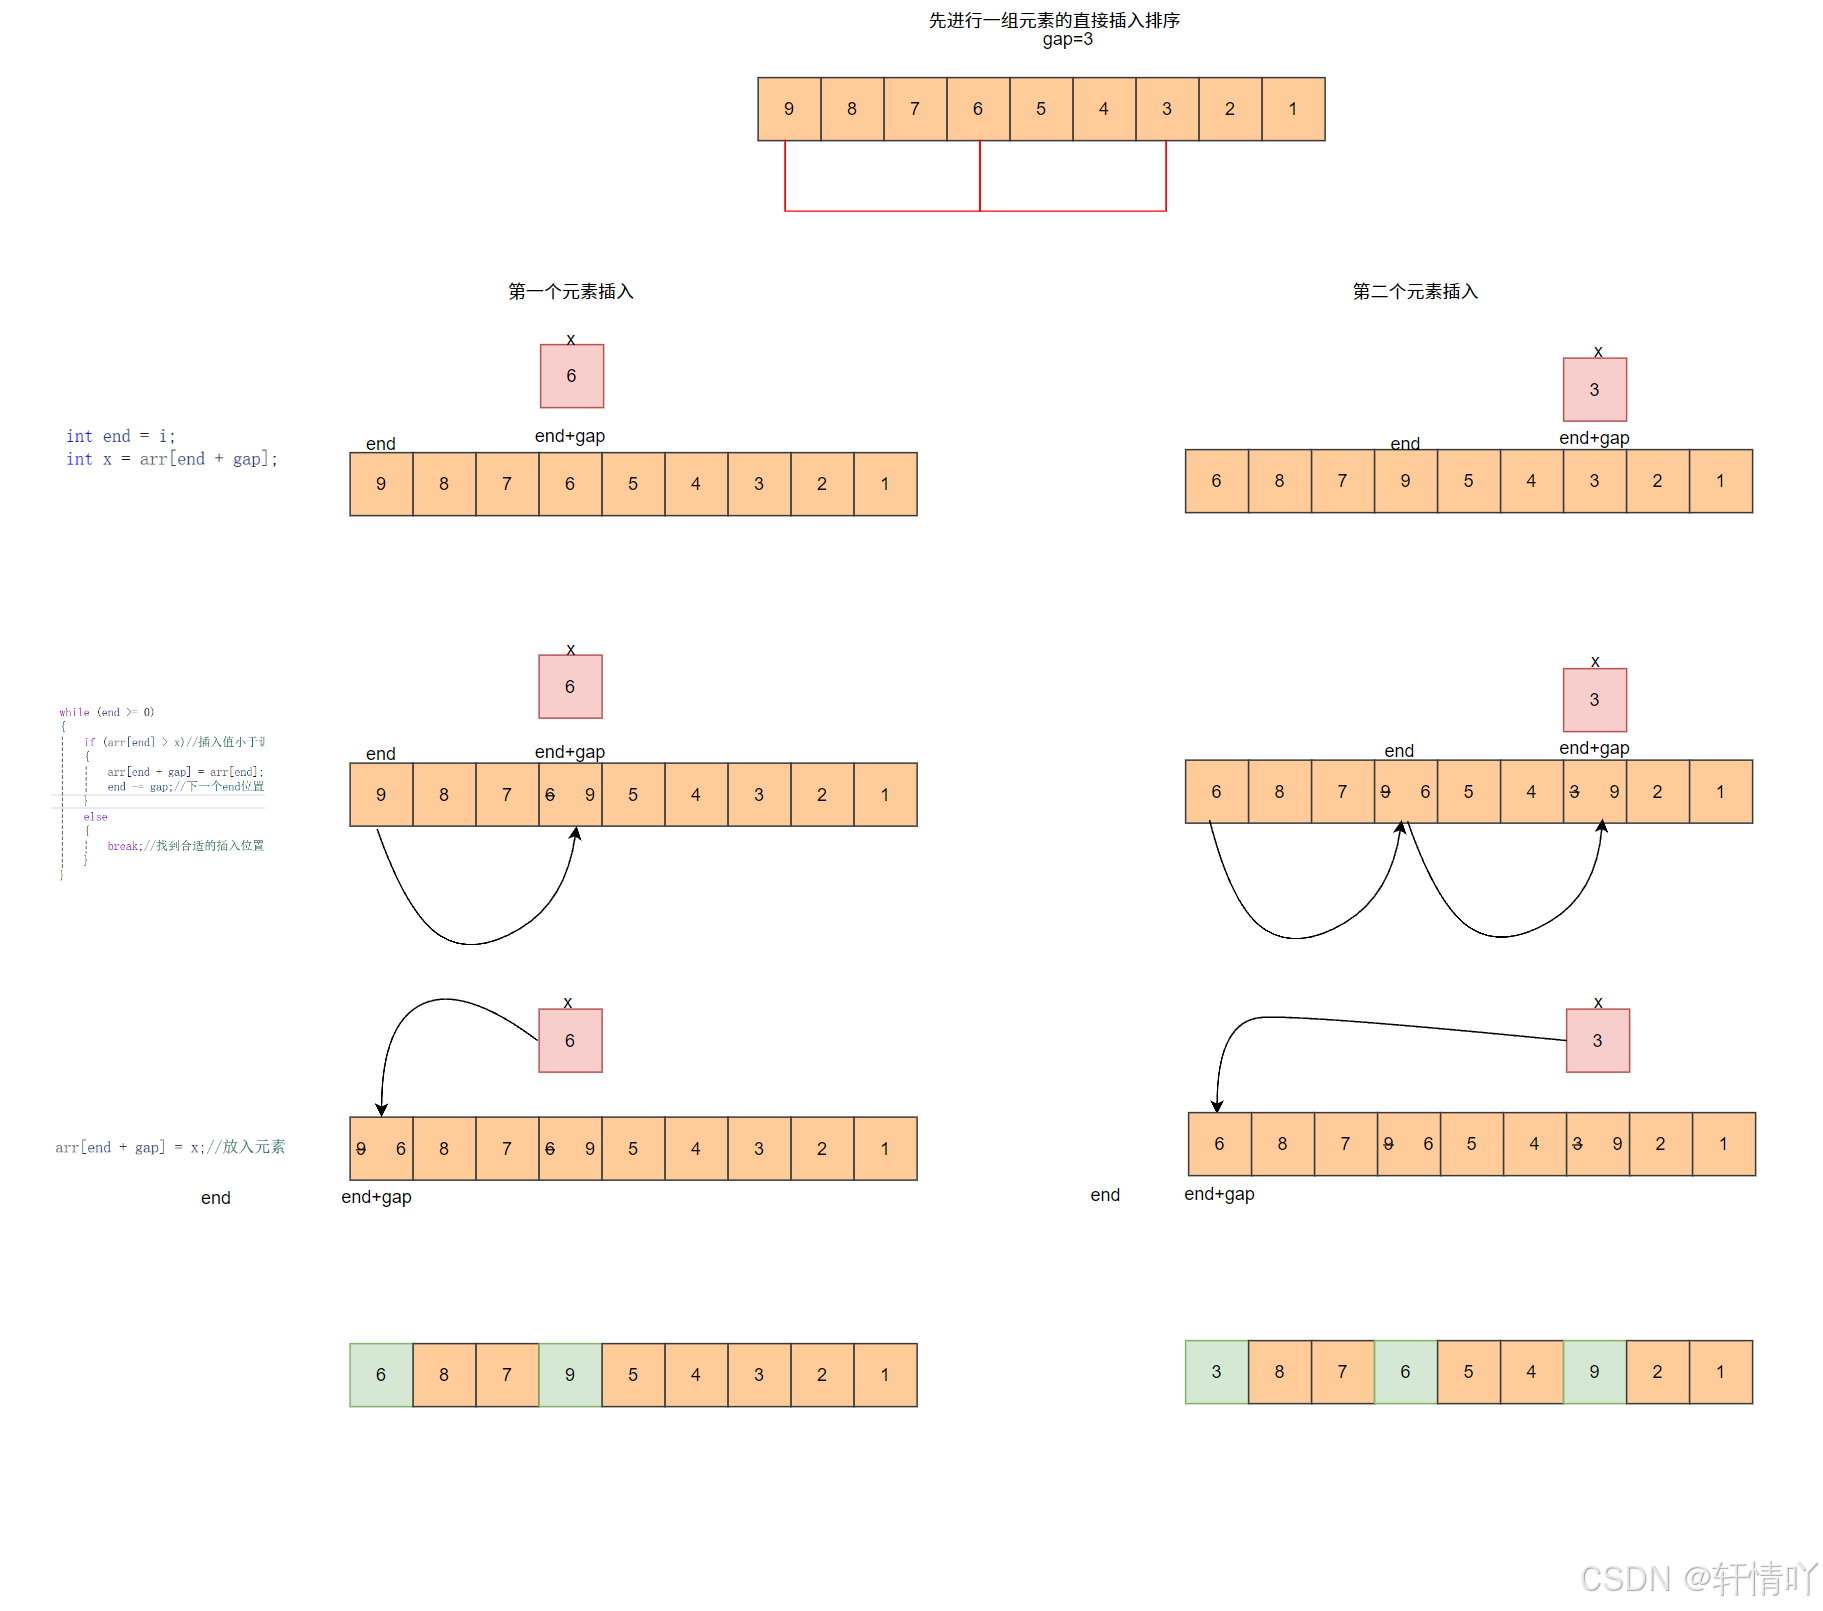
并且和直接插入排序一样,这边i的循环结束条件也是需要注意,看下面图演示
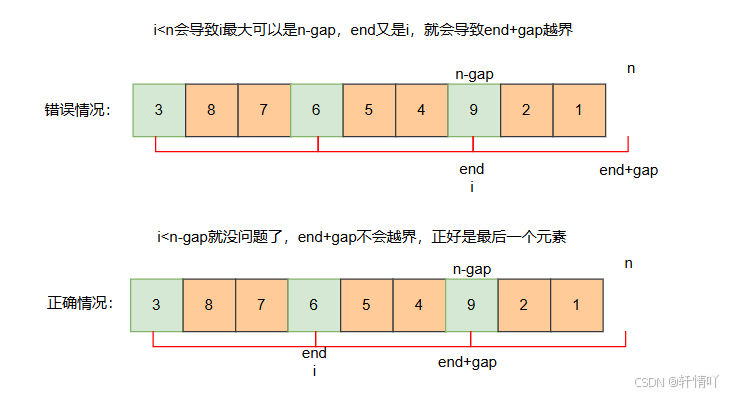
接下来我们就要考虑将每组数据进行直接插入排序(预排序)了,还是老样子,得看图
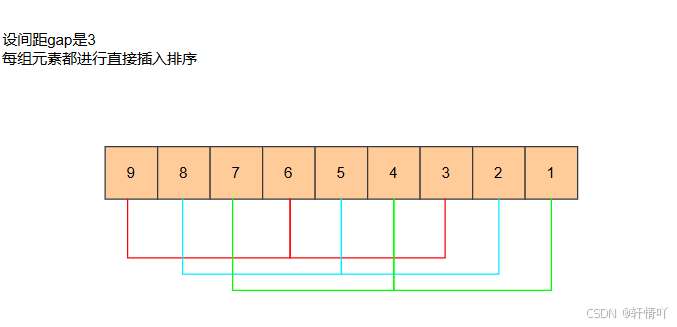
从上图中看,一共是三组,每组三个元素,刚才讲了第一组的直接插入排序(预排序),那么剩下的也就好理解了
//每组元素都进行预排序
void ShellSortV2(int* arr, int n)//希尔排序
{
	//简单来说就是进行多次的直接插入排序,优化直接插入排序
	int gap = 3;
	//gap组元素的预排序;每组n/gap个元素
	for (int j = 0; j < 3; j++)
	{
		for (int i = j; i < n - gap; i += gap)//以gap为间距,下一个需要调整的值就是i+=gap
		{
			int end = i;
			int x = arr[end + gap];//调整的值和插入值相差gap
			//完成一个元素的插入
			while (end >= 0)
			{
				if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
				{
					arr[end + gap] = arr[end];//直接插入排序是end+1,就是gap等于1;这边gap为3
					end -= gap;//下一个end位置间距为gap
				}
				else
				{
					break;//找到合适的插入位置了
				}
			}

			arr[end + gap] = x;//放入元素
		}
	}
}
只需要外套一层循环就好,循环结束条件就考虑一共有多少组,只要gap不是超过n这种不正常写法,一般就是gap组。
但是这种写法太臃肿了,我们可以改进一下
//优化每组元素的预排序
void ShellSortV3(int* arr, int n)//希尔排序
{
	//简单来说就是进行多次的直接插入排序,优化直接插入排序
	int gap = 3;
	//gap组元素的预排序;每组n/gap个元素

	for (int i = 0; i < n - gap; i++)//和V2一样,只不过每循环一次是对不同的组的元素预排序
	{
		int end = i;
		int x = arr[end + gap];//调整的值和插入值相差gap
		//完成一个元素的插入
		while (end >= 0)
		{
			if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
			{
				arr[end + gap] = arr[end];//直接插入排序是end+1,就是gap等于1;这边gap为3
				end -= gap;//下一个end位置间距为gap
			}
			else
			{
				break;//找到合适的插入位置了
			}
		}

		arr[end + gap] = x;//放入元素
	}
}
就是简单的使每组直接插入排序的元素排序是依次进行的,而不是像原来一样,一组接一组,我们来看图
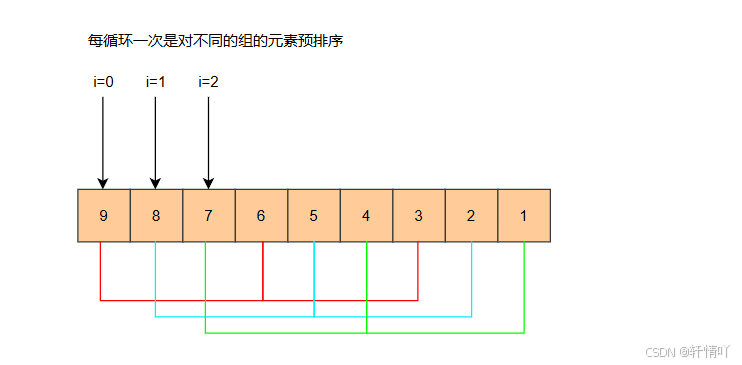
接下来要看一下我们的最终版希尔排序了,前面讲了那么多,其实我们的元素比原来有序很多了,将小的数都往左边靠,大的数都往右边靠,使得序列接近有序。
//最终版
void ShellSort(int* arr, int n)//希尔排序
{
	//简单来说就是进行多次的直接插入排序,优化直接插入排序
	int gap = n;
	while (gap > 1)//gap==0就没意义了,原地赋值x罢了
	{
		//gap /= 2;
		gap = gap / 3 + 1;// /3必须要+1,保证最后一次gap为1

		//gap组元素的预排序;每组n/gap个元素
		for (int i = 0; i < n - gap; i++)//和V2一样,只不过每循环一次是对不同的组的元素预排序
		{
			int end = i;
			int x = arr[end + gap];//调整的值和插入值相差gap
			//完成一个元素的插入
			while (end >= 0)
			{
				if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
				{
					arr[end + gap] = arr[end];//直接插入排序是end+1,就是gap等于1;这边gap为3
					end -= gap;//下一个end位置间距为gap
				}
				else
				{
					break;//找到合适的插入位置了
				}
			}

			arr[end + gap] = x;//放入元素
		}
	}
}
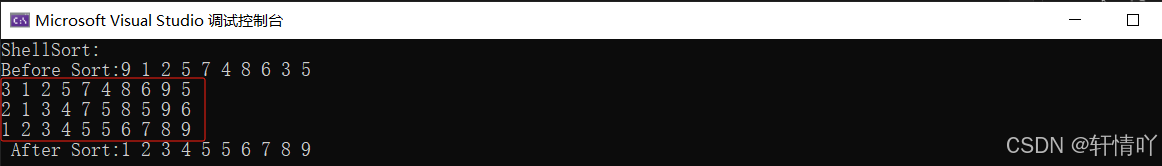
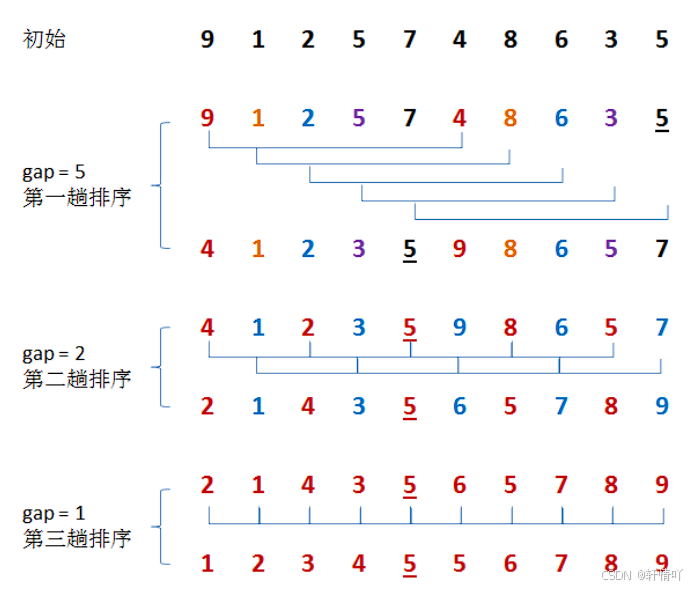
我们这里将gap变成可变的,使所有的数据随着gap的变化分配到不同组里进行预排序,让数据逐渐接近有序,保证最后一次是完整数据的直接插入排序即可
因此为了保证最后一次完整数据的直接插入排序,我们就需要保证最后一次gap是1,我们既可以对gap/2也可以是/3+1,/2的话就是预排序的次数会比较多,/3+1的次数就会少一点。不过/3必须要+1,不然不能保证最后一次gap是1
总结来说:
①gap越大,大的数据可以更快的到达后面,小的数据能够更快的到达前面,但是越不接近有序
②gap越小,数据跳动的越慢,但是越接近有序
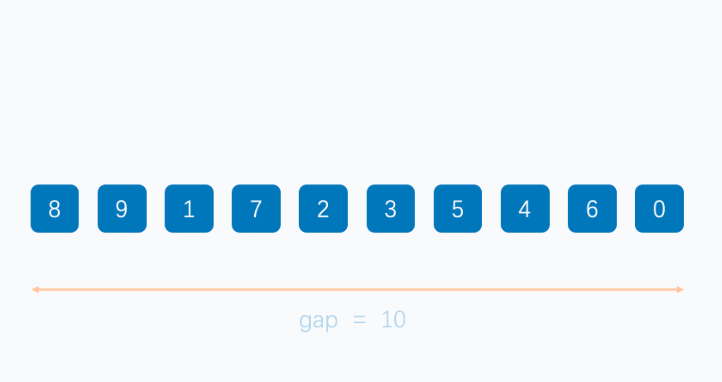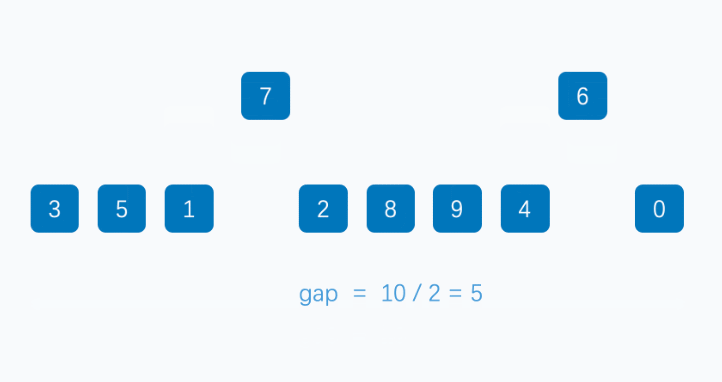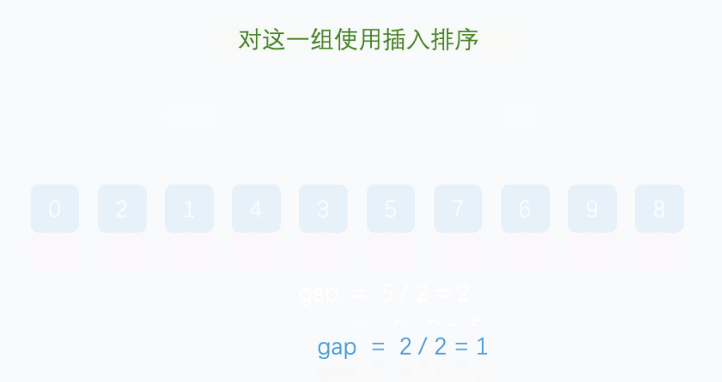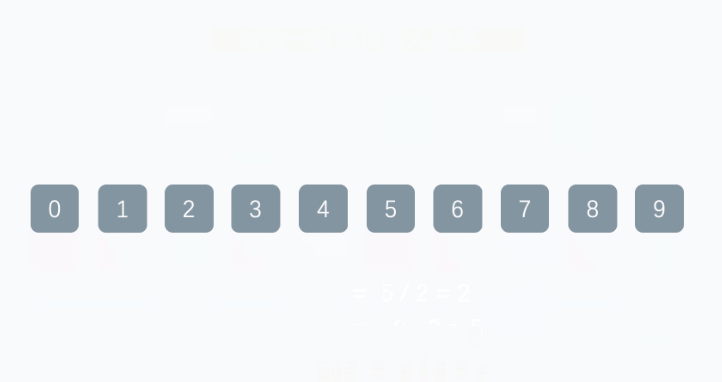
上图为每次gap变化后预排序的结果,可以看出,通过预排序后,数据在逐渐接近有序
我们通过动图和静态图来感受一下
希尔排序的特性总结:
①希尔排序是对直接插入排序的优化。
②当gap > 1时都是预排序,目的是让数组更接近于有序。当gap == 1时,数组已经接近有序的了,这样就会很快。这样整体而言,可以达到优化的效果。
③时间复杂度由于gap取值很多,非常难算,直接给出结论:教材上是O(n^1.25)到O(1.6*n ^1.25),约等于可以理解为是O(N^1.3)
④ 空间复杂度:O(1)
⑤ 稳定性:不稳定
3.选择排序
选择排序的思想:每一次从待排序的数据元素中选出最小(或最大)的一个元素,存放在序列的起始位置,直到全部待排序的数据元素排完 。
这个排序的写法很简单,但是为了提升它的效率,我们给它做了升级,每次从待排序的数据元素中同时选出最大和最小的,这样能最大的提高它的排序效率。
void SelectSort(int* arr, int n)//选择排序
{
	//找出最小值和最大值,和起始位置和结束位置交换
	//初始版可以只找最小值或最大值,这个是提高效率

	int begin = 0;
	int end = n - 1;
	while (begin < end)//当两者相互碰头或者错过时就排序完成了
	{
		int maxi = begin;
		int	mini = begin;
		//进行一次选择排序
		for (int i = begin; i <= end; i++)
		{
			//选最大值
			if (arr[maxi] < arr[i])
			{
				maxi = i;
			}
			//选最小值
			if (arr[mini] > arr[i])
			{
				mini = i;
			}
		}

		//将最小值和起始值交换
		Swap(&arr[mini], &arr[begin]);

		//!!!有概率最大值是起始值,这会导致最大值已经被交换到mini位置
		if (begin == maxi)
		{
			maxi = mini;//调整最大值的位置
		}

		//将最大值和结尾值交换
		Swap(&arr[maxi], &arr[end]);

		//头和尾已经有正确的值,进行调整,继续完成下次的排序
		begin++;
		end--;
	}
}
排序结束的条件当数据量无论是奇数或者偶数都可以满足,当数据量是奇数时begin会和end碰头,只剩下一个数据,不需要再调整了;偶数时会正好错过,所有数据都完成了调整,因此只要begin>=end就说明排序完成
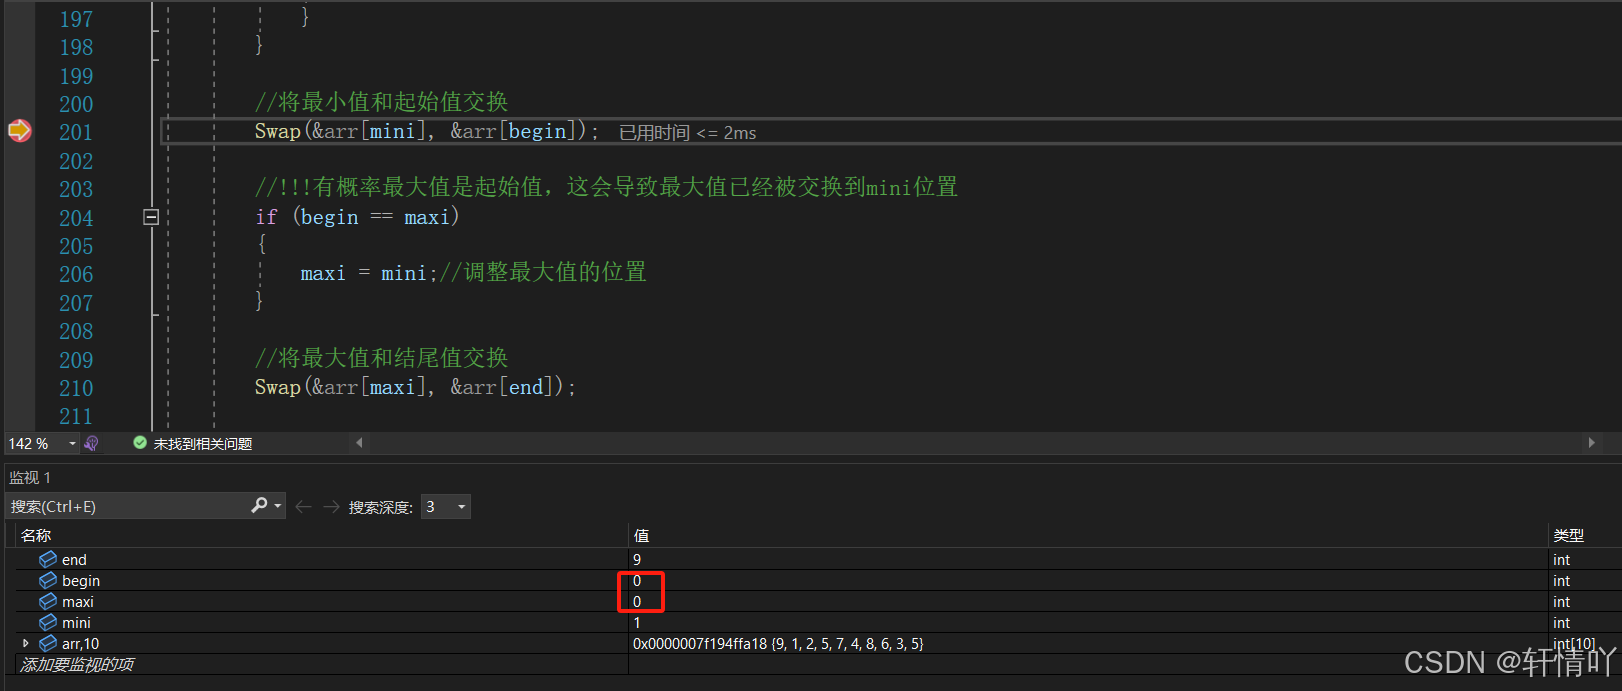
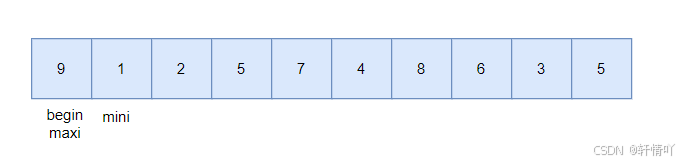
要注意其中的交换时会有一个隐藏的bug, 就是mini想要交换的位置begin可能是maxi,这就会导致begin和maxi重叠了,经过一系列的交换后,最小值跑到了end位置,最大值的位置也错了,因此我们要加上条件进行判断,如果是begin==maxi,就调整maxi
如下图
我们来看一下选择排序的动态图(只选出最小值)
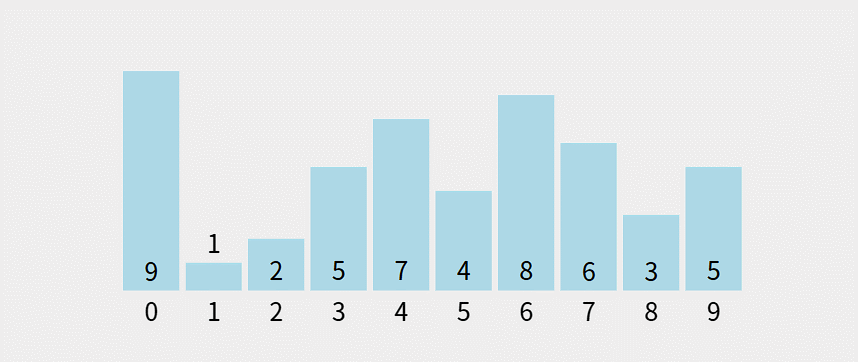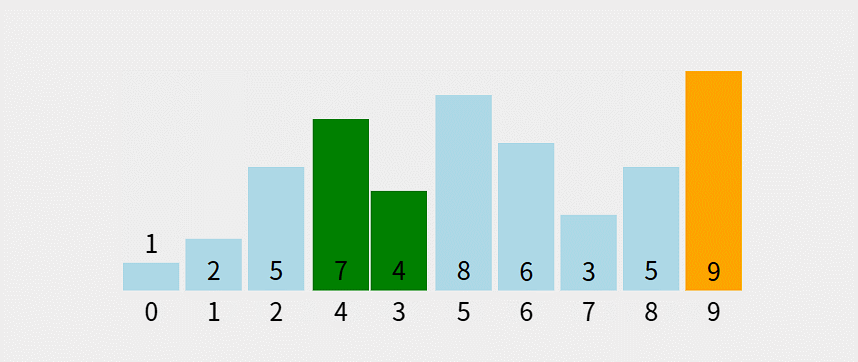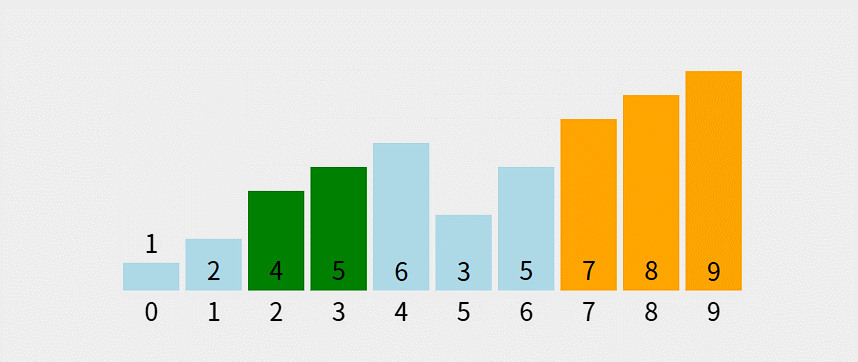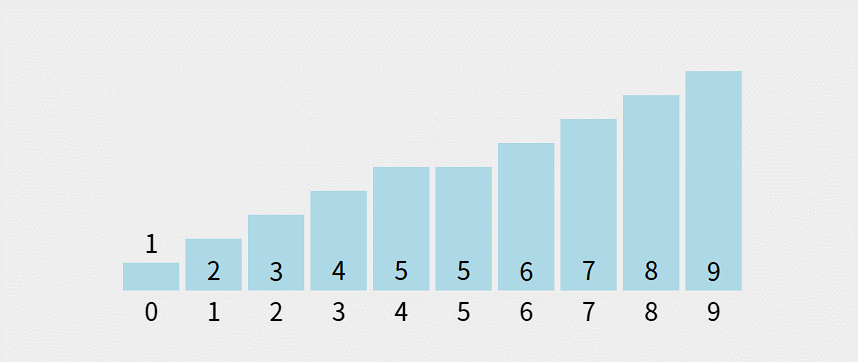
选择排序的特性总结:
①直接选择排序思考非常好理解,但是效率不是很好。实际中很少使用
②时间复杂度:O(N^2),排序的次数是等差数列,(N-2)+(N-4)+(N-6)…
③ 空间复杂度:O(1)
④ 稳定性:不稳定
void TestEfficiency()
{
	srand(time(0));
	const int N = 30000;//排序数据数量
	int* a1 = (int*)malloc(sizeof(int) * N);
	int* a2 = (int*)malloc(sizeof(int) * N);
	int* a3 = (int*)malloc(sizeof(int) * N);
	int* a4 = (int*)malloc(sizeof(int) * N);
	int* a5 = (int*)malloc(sizeof(int) * N);
	int* a6 = (int*)malloc(sizeof(int) * N);
	int* a7 = (int*)malloc(sizeof(int) * N);
	int* a8 = (int*)malloc(sizeof(int) * N);
	int* a9 = (int*)malloc(sizeof(int) * N);
	for (int i = 0; i < N; ++i)
	{
		a1[i] = rand() % 1000;
		a2[i] = a1[i];
		a3[i] = a1[i];
		a4[i] = a1[i];
		a5[i] = a1[i];
		a6[i] = a1[i];
		a7[i] = a1[i];
		a8[i] = a1[i];
		a9[i] = a1[i];
	}

	int begin1 = clock();
	InsertSort(a1, N);
	int end1 = clock();

	int begin2 = clock();
	ShellSort(a2, N);
	int end2 = clock();

	int begin3 = clock();
	SelectSort(a3, N);
	int end3 = clock();

	int begin4 = clock();
	HeapSort(a4, N);
	int end4 = clock();

	int begin5 = clock();
	BubbleSort(a5, N);
	int end5 = clock();


	//int begin6 = clock();
	//QuickSort(a5, N);
	//int end6 = clock();

	//int begin7 = clock();
	//MergeSort(a6, N);
	//int end7= clock();

	//

	//int begin8 = clock();
	////BucketSort(a8, N);
	//int end8 = clock();

	//int begin9 = clock();
	//RadixSort(a9, N);
	//int end9 = clock();

	printf("InsertSort:%d\n", end1 - begin1);
	printf("ShellSort:%d\n", end2 - begin2);
	printf("SelectSort:%d\n", end3 - begin3);
	printf("HeapSort:%d\n", end4 - begin4);
	printf("BubbleSort:%d\n", end5 - begin5);
	//printf("QuickSort:%d\n", end6 - begin6);
	//printf("MergeSort:%d\n", end6 - begin6);
	////printf("bucketSort:%d\n", end8 - begin8);
	//printf("RadixSort:%d\n", end9 - begin9);
	free(a1);
	free(a2);
	free(a3);
	free(a4);
	free(a5);
	free(a6);
	free(a7);
	free(a8);
	free(a9);

}
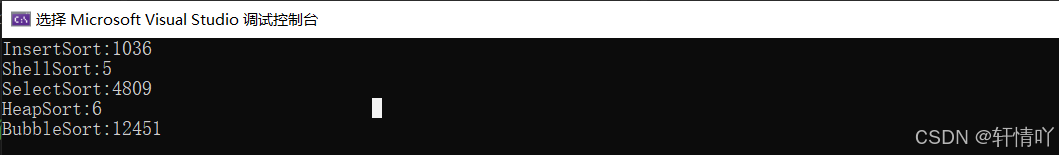
上面的代码主要是用来看效率的,单位是毫秒,使数据量不断增大,可以发现,我们的选择排序不如直接插入排序
这是因为直接插入排序适应性很强,对于有序,局部有序,都能效率提升,减少排序的次数,但是选择排序无论怎么样,它都会进行比较选择,导致时间复杂度永远是O(N²)
同时我们也能看出堆排序和希尔排序的效率差不多,毕竟一个是O(N*log₂N),一个是O(N^1.3)
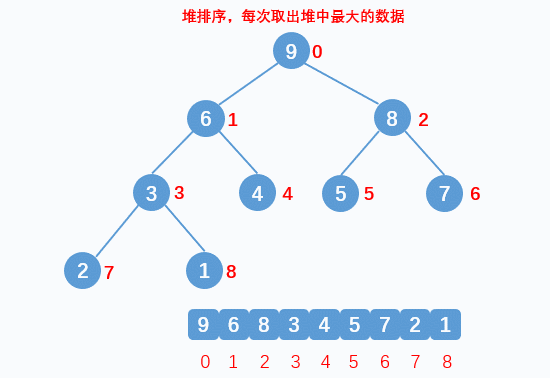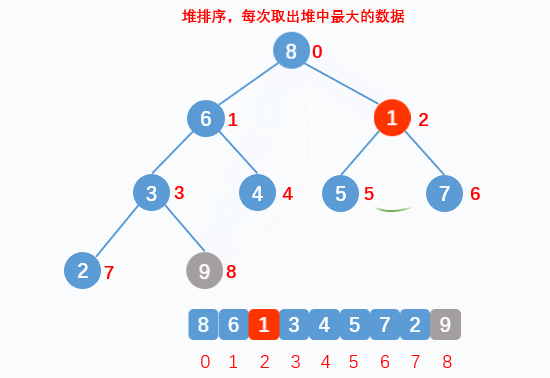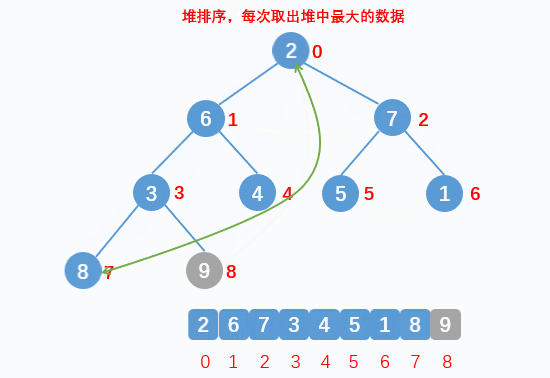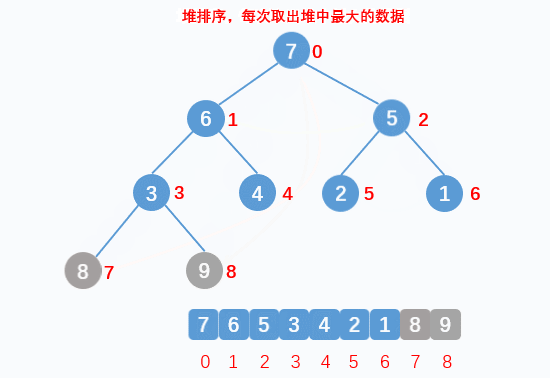
4.堆排序
这个排序和二叉树有点联系,建议去看看我的这篇文章☞二叉树_堆并且其中也把堆排序详细的讲了一遍(图文结合),这边就简要讲述和给出代码
void AdjustDown(int* arr, int parent, int n)
{
	//假设较大的孩子是左孩子
	int child = parent * 2 + 1;
	while (child < n)//不能越界
	{
		//确保child+1存在,需要判断
		//右孩子=左孩子+1,右孩子大于左孩子就修改child
		if (child + 1 < n && arr[child + 1] > arr[child])
		{
			child++;
		}

		//孩子结点大于父结点就交换
		if (arr[child] > arr[parent])
		{
			Swap(&arr[child], &arr[parent]);
		}
		else
		{
			break;
		}

		//孩子结点变成父结点,再找孩子结点,继续向下调整
		parent = child;
		child = parent * 2 + 1;
	}

}

void HeapSort(int* arr, int n)//堆排序
{
	//建大堆->向下调整
	//从最后一个结点的父结点开始调整
	int parent = (n - 1) / 2;
	while (parent >= 0)
	{
		AdjustDown(arr, parent, n);
		parent--;
	}

	//头和尾端的值进行交换,顺序值依次在最后出现
	int end = n - 1;
	while (end > 0)//只剩下一个值就结束
	{
		Swap(&arr[end], &arr[0]);//交换
		AdjustDown(arr, 0, end);//进行向下调整
		end--;
	}

}
这张动图将建堆和排序的过程全部演示出来了
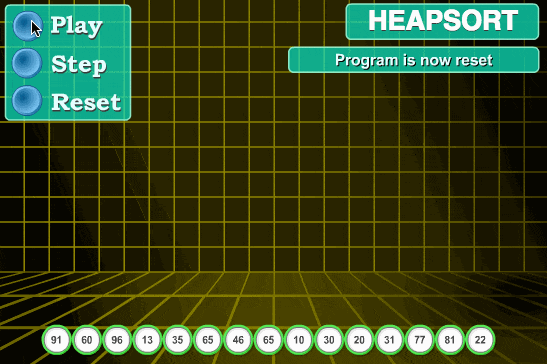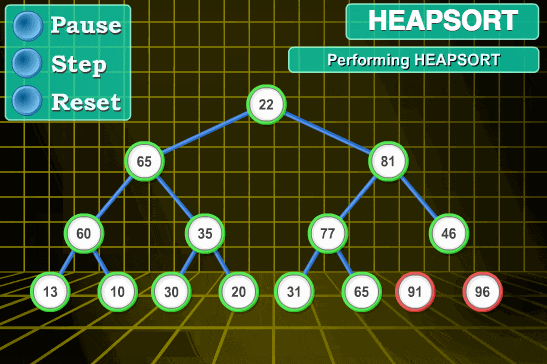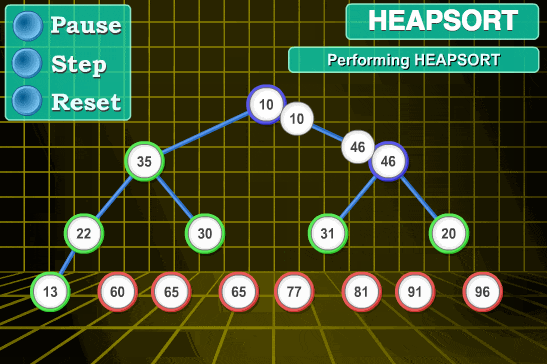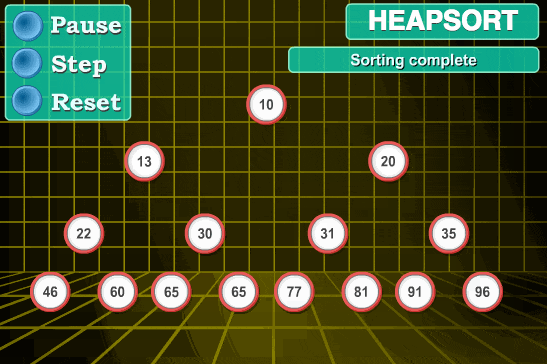
这张动图主要是排序的过程,更为清楚详细
堆排序的特性总结:
①堆排序使用堆来选数,效率就高了很多。
② 时间复杂度:O(N*log₂N)
③ 空间复杂度:O(1)
④ 稳定性:不稳定
5.冒泡排序
这个排序真的就是老生常谈了,我们就直接给出代码了
void BubbleSort(int* arr, int n)//冒泡排序
{
	//两两元素相比,前一个比后一个大就交换,直到将最大的元素交换到末尾位置

	//进行n-1次的冒泡排序
	//两两比较只需要n-1次;最后一次两个元素比较,只需要1次
	for (int j = 0; j < n - 1; j++)
	{
		bool flag = 1;
		//单次冒泡排序
		//i代表前一个,i最大只能是n-2;i+1代表后一个,最大只能是n-1;不会越界
		//以i代表前一个为基准,i就得<n-1
		for (int i = 0; i < n - 1 - j; i++)
			//一次冒泡排序后选出的最大值会在末尾,下一次就无需比较它了,因此需要不断的减小i,i就需要-j
		{
			//前一个比后一个大就交换
			if (arr[i] > arr[i + 1])
			{
				Swap(&arr[i], &arr[i + 1]);
				flag = 0;
			}
		}

		//优化冒泡排序,当完成单趟冒泡排序后,如果数据之间没有交换过,说明整体已经有序
		if (flag)
		{
			break;
		}
	}
}
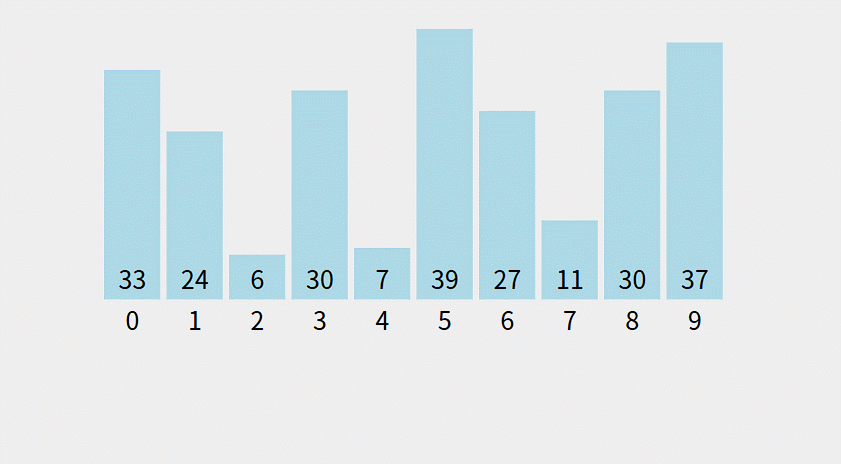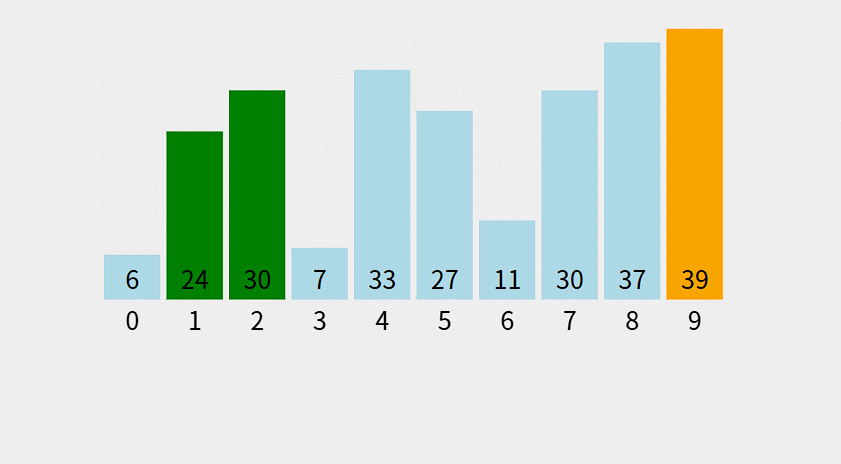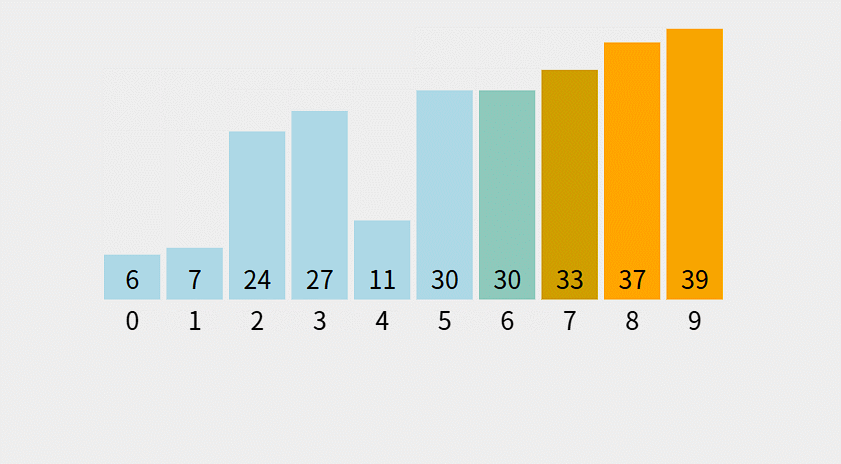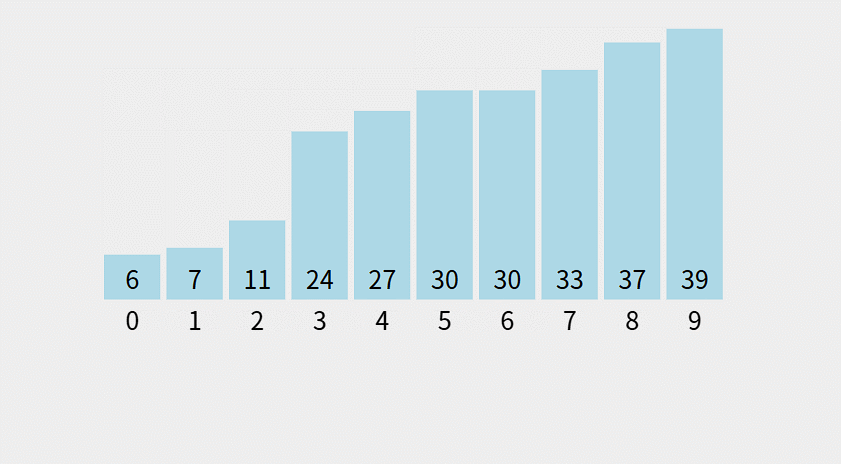
我们代码中也对冒泡排序进行了优化,但是它的效率依旧不是很理想
选择排序也是经过优化的,效果还是比冒泡排序好,这主要是因为我们的冒泡排序的优化太局限了,它只能是在有序的情况下(接近有序也不行,无法确保具体情况, 例如最小的在最后)或者前面部分有序的情况下才能起到作用,否则无济于事。虽然选择排序不管有序还是无序,它都必须要经历O(N^2)的排序,但是一次选出最大最小的优化,还是展现出来了。另外我们的直接插入排序很能打,无论是接近有序还是局部有序,它都能减少排序次数。
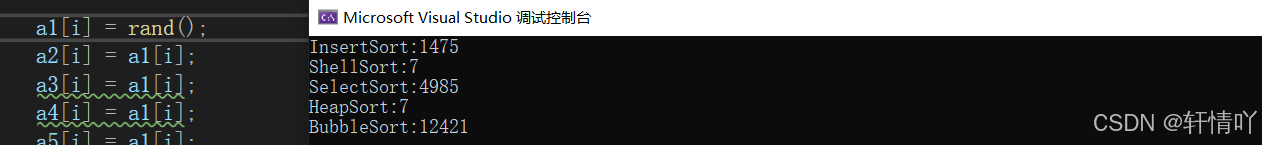
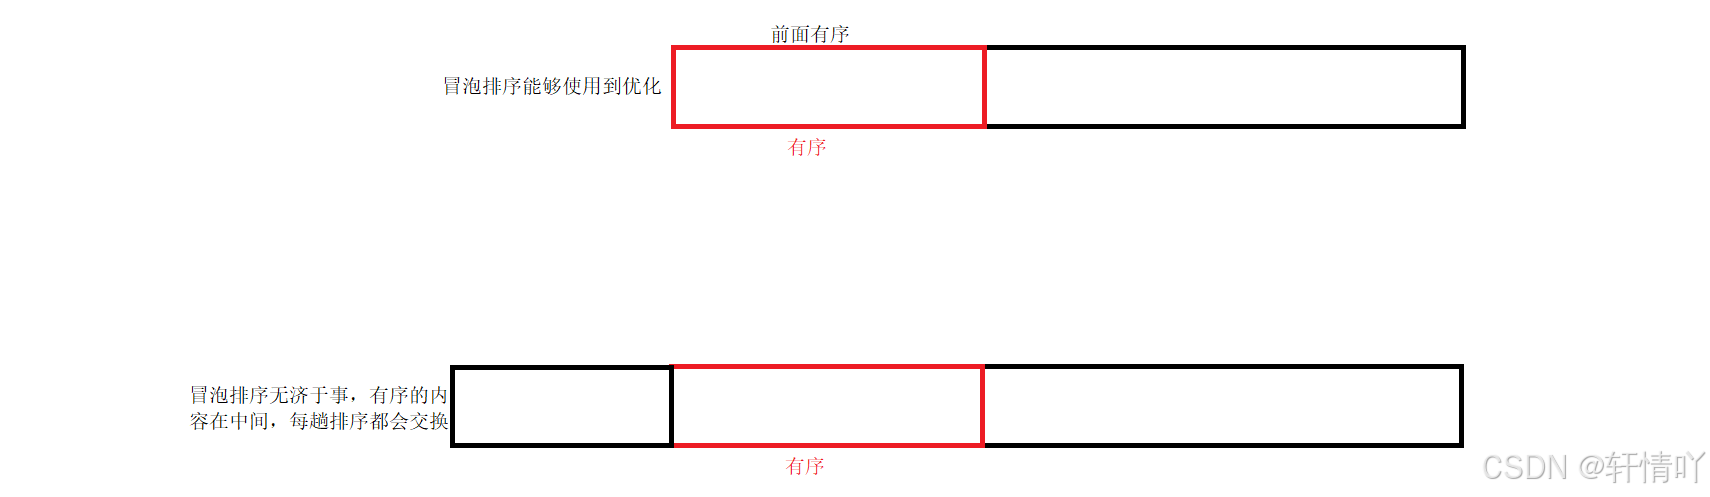
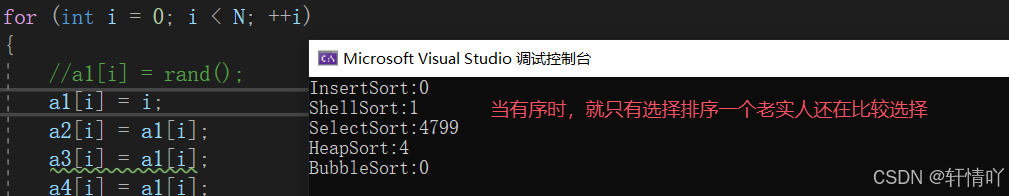
注意:上述测试都是在release版本下,这样才能发挥最大性能
冒泡排序的特性总结:
① 时间复杂度:O(N^2)
② 空间复杂度:O(1)
③ 稳定性:稳定
6.快速排序
6.1.hoare版本
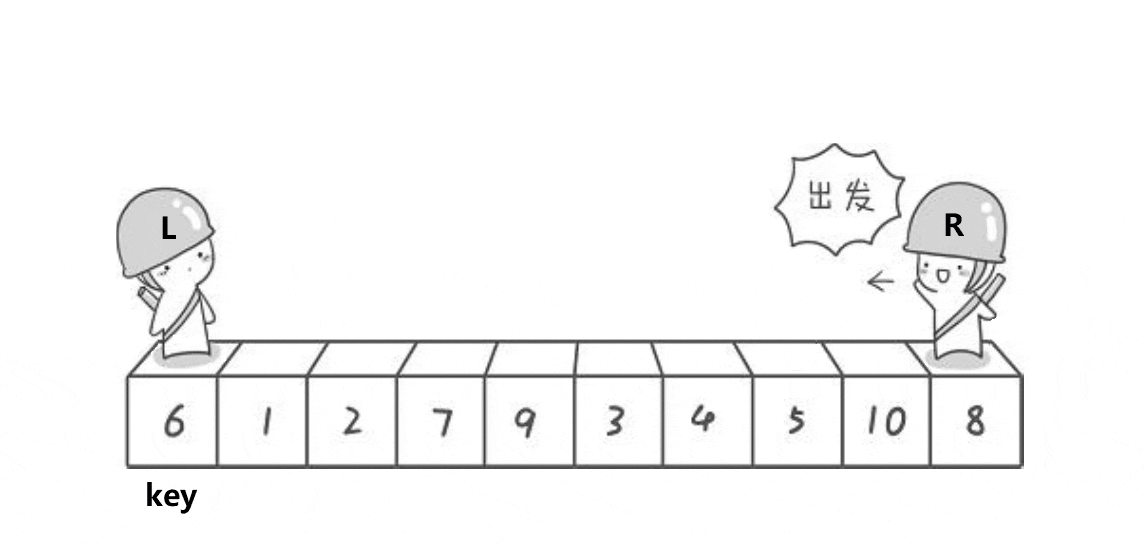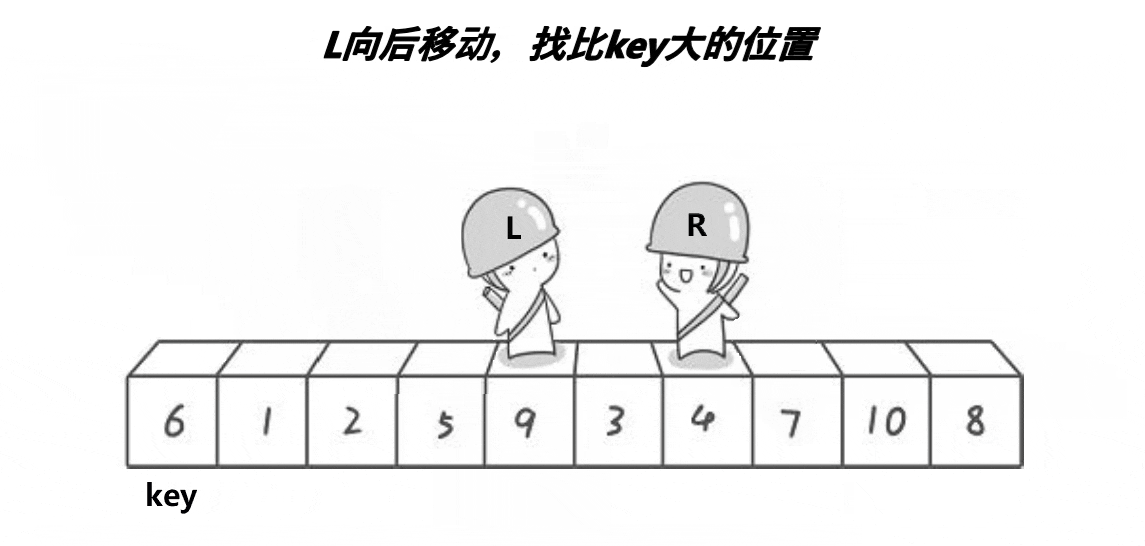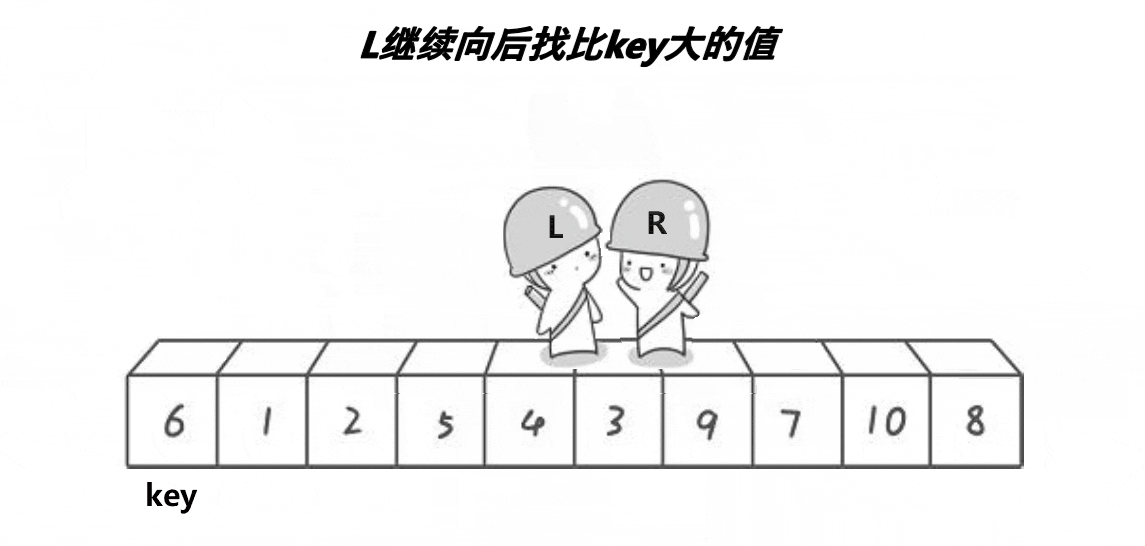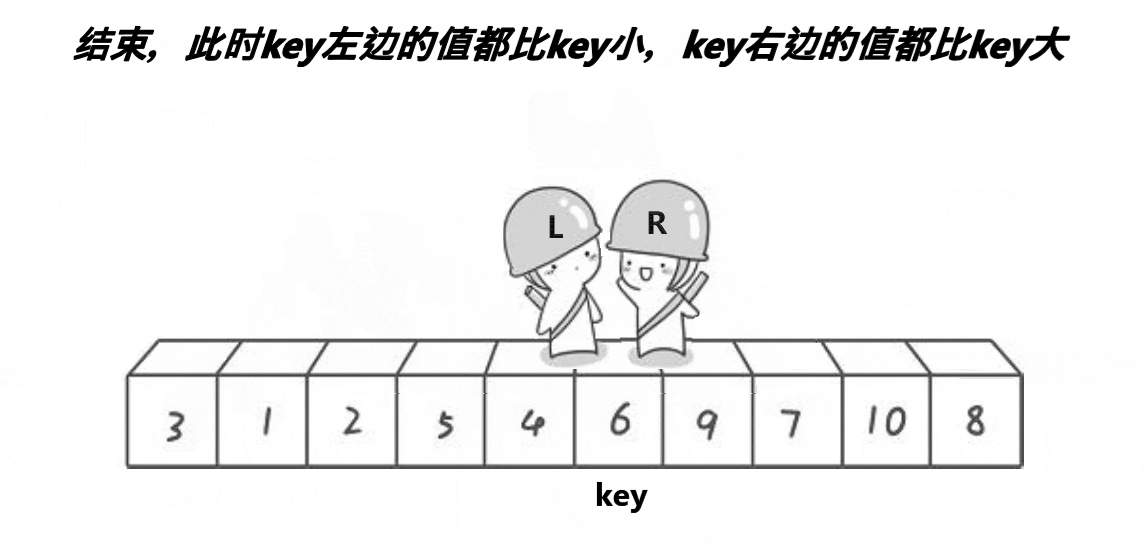
大家根据上面的动图,能不能看出它的思想?
接下来讲解一下
我们取一个关键值key(基准值),那么我们一般取的是最左边或者最右边的数据,然后设置两个下标:left和right,进行一趟排序:左下标从左向右开始找比key大的,右下标从右向左找比key小的,然后左右下标的值交换,然后再重复此过程,记住,右下标要先走。要当左右下标重叠时,将key与重叠位置的数据进行交换。一趟排序之后得到的结果就是分割出左右区间,key左边的都比key小,右边的都比key大,并且key已经到了它应该到的位置,但是并不一定是有序,然后使用左右下标重合的位置将数据分为两个区间,然后再重复上述步骤,将这两个区间变为有序,那么左右区间都有序,数据的整体就有序了。如下图所演示的一趟排序
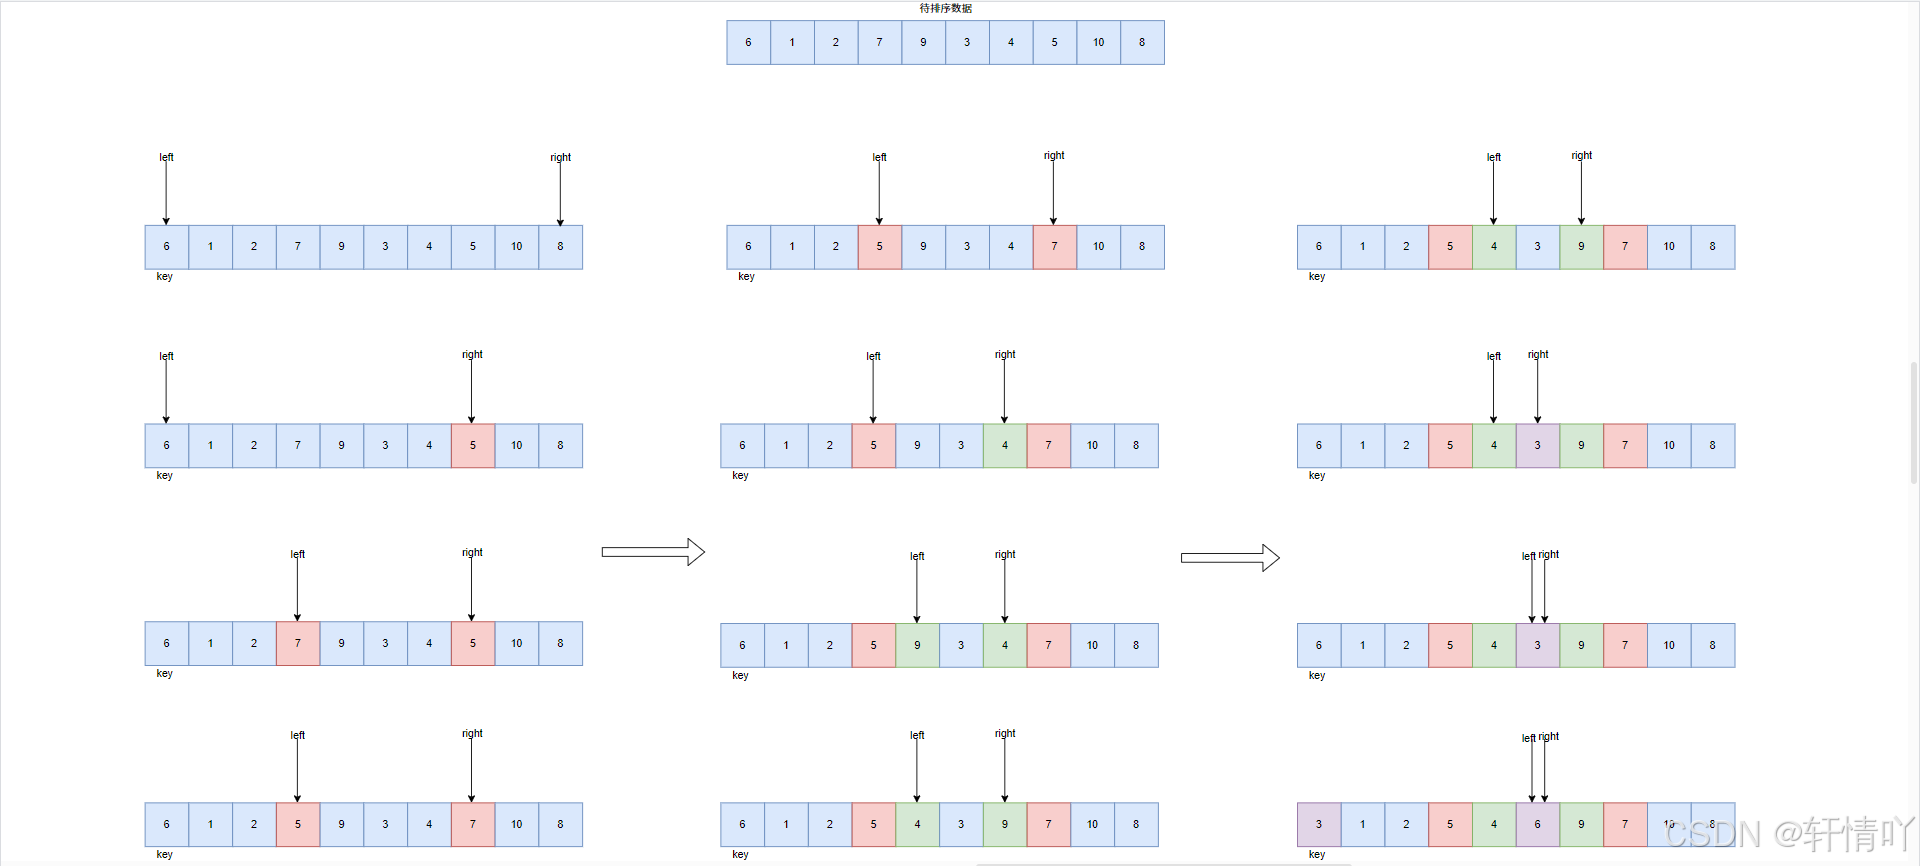
仔细想想,这种让左右区间再变得有序需要用什么方法?
当然是递归啦,既然有一个数据已经排序好了,那么其余的数据就是化为子问题来处理,就是递归。
现在还有一个问题就是为什么我们的右边下标要先走呢?接下来我们来看看
左边做key,右边就先走的原因是保证相遇的位置,比key要小,这样就能将相遇的位置和key交换后,key的左边都是小于key的,如下图解析
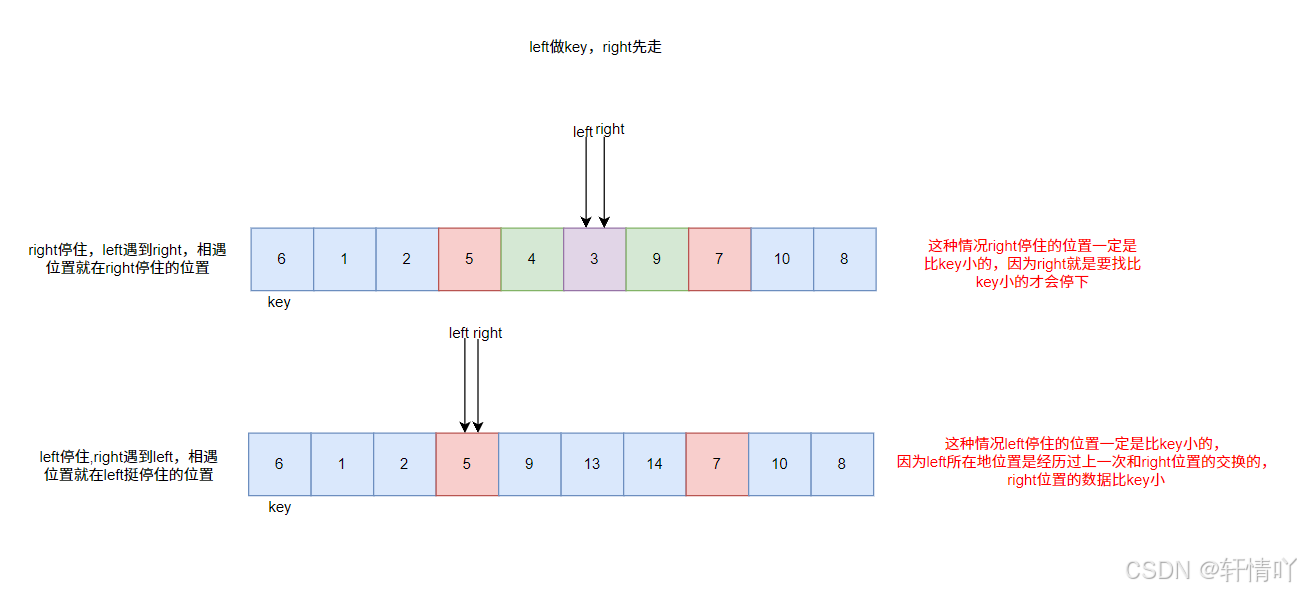
接下来就要写代码啦,用递归,代码如下:
void QuickSort(int* arr, int begin, int end)//快速排序
{
	//begin<end时可以不断的分割左右区间,直到只剩下一个元素或者无元素
	if (begin >= end)
	{
		return;
	}


	int left = begin;
	int right = end;
	int keyi = left;//选定左边key的位置


	while (left < right)//等于时就要和key交换
	{
		//右边先走,找小
		//注意不能少了left<right,否则会越界
		//>加上=,否则会造成死循环
		while (left<right&&arr[right]>=arr[keyi])
		{
			right--;
		}

		//左边后走,找大
		//这个一样需要left<right
		//=最好加上,保证足够的严谨
		while (left<right&&arr[left] <=arr[keyi])
		{
			left++;
		}

		//交换各自找到的值
		Swap(&arr[left], &arr[right]);
	}

	//left==right
	//交换keyi位置的值和相遇位置的值
	Swap(&arr[keyi],&arr[left]);


	keyi = left;

	//递归调用左区间和右区间
	QuickSort(arr, begin, keyi - 1);
	QuickSort(arr, keyi + 1,end);
}
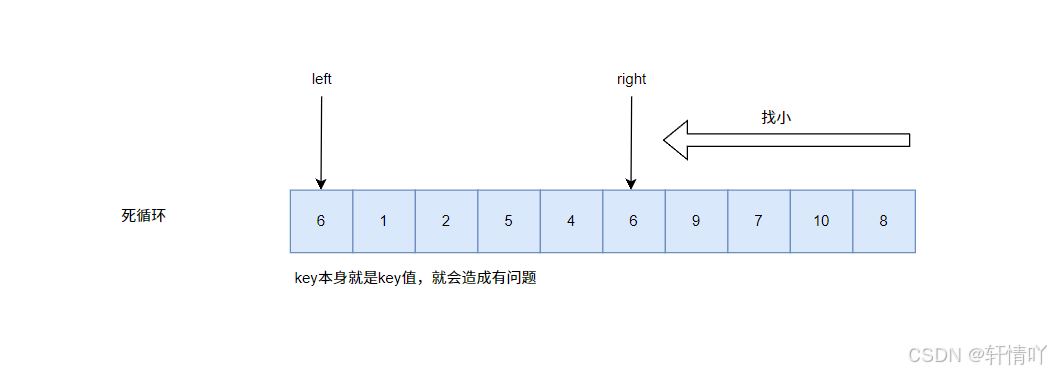
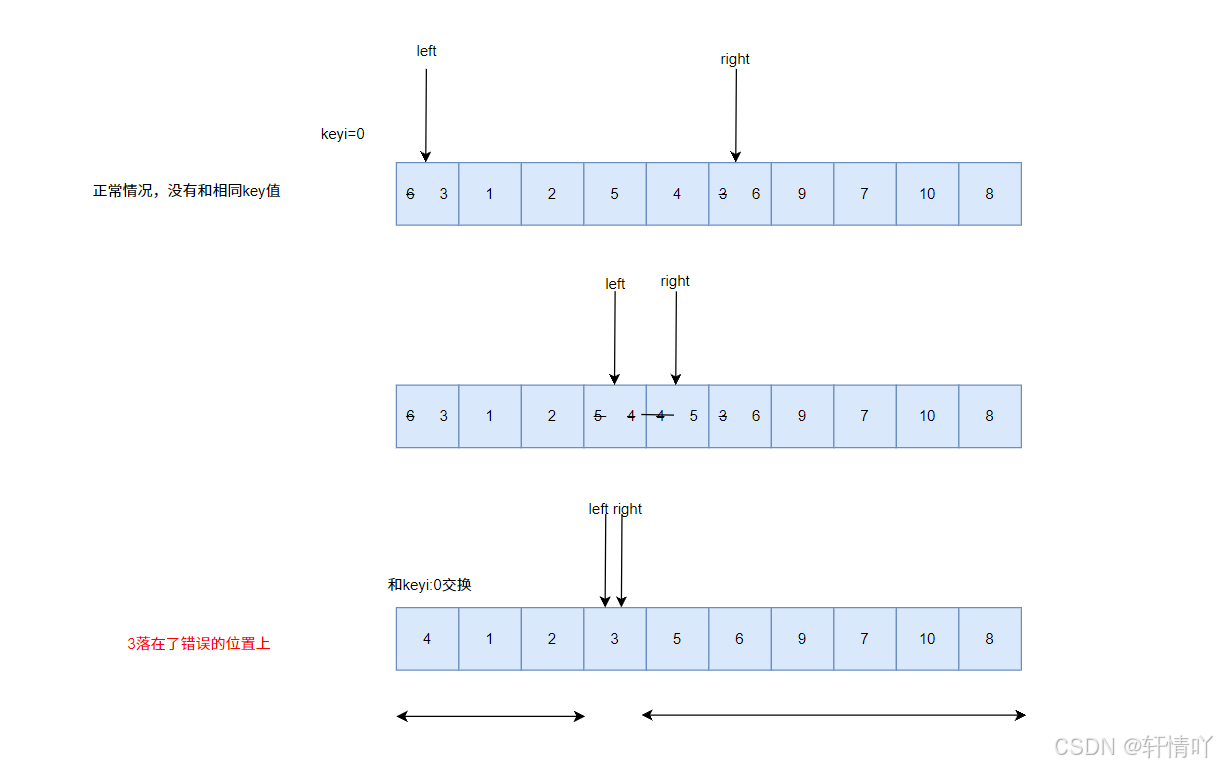
代码中要注意内部的两个循环必须要都要加上left<right,否则一旦数据是逆序left会直接越界或者key右边的值都比key大就会导致right越界。并且我们的两个循环判断必须带上=(第二个可以不带,但是保险起见还是带上),否则左右两边都有跟key相等的值时就会造成死循环,但是即使是没有和key相等的值也会出问题,看下面两幅图
递归过程看下图来理解一下
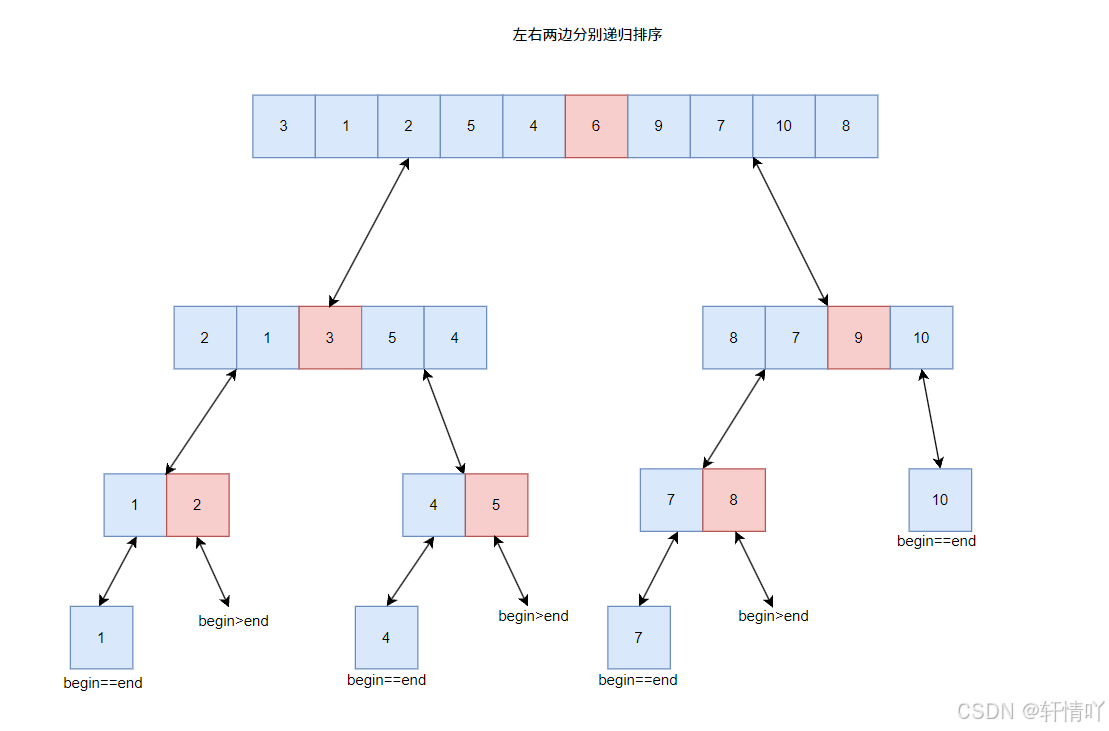
6.1.1.三数取中
接下来我们思考一下它的时间复杂度,我们单看代码的循环无法判断出,只能靠画图来分析一下,还是这张图,大家想一想,它长的像什么?
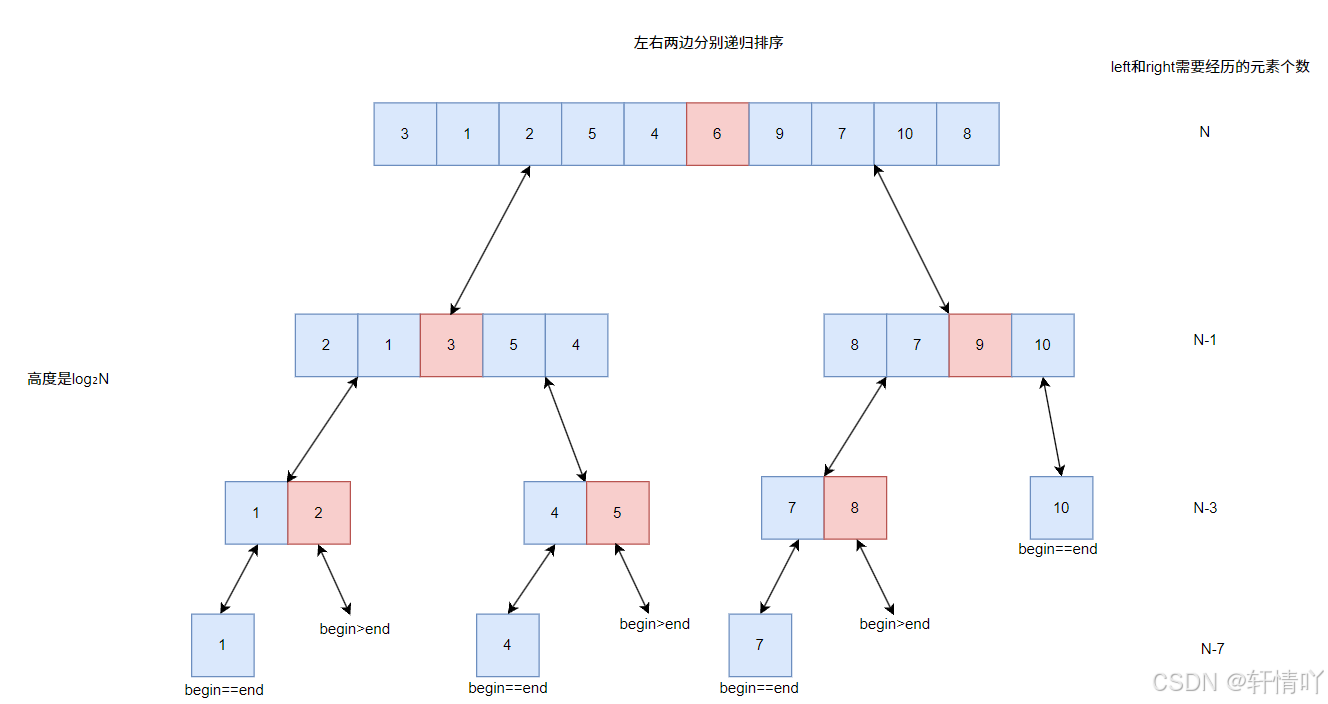
是不是像一棵二叉树,它的高度是log₂N,我们每一层递归都需要经过的元素可以都看成是N,因此时间复杂度是O(N*log₂N)。但是这仅仅是最好的情况,最坏的情况是什么样的呢?
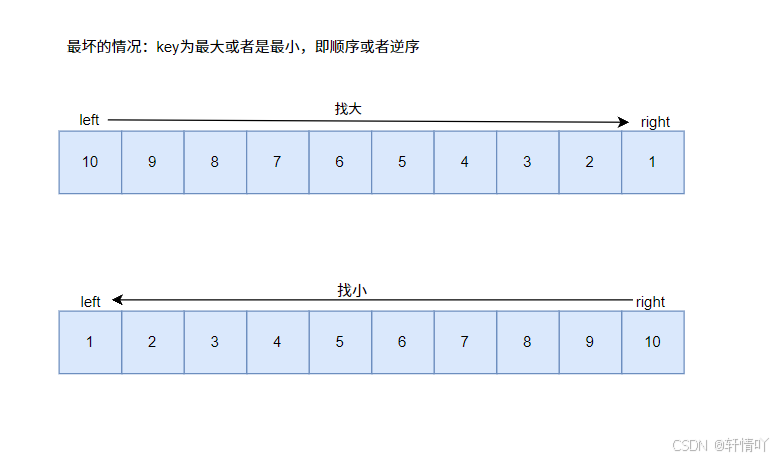
那么它的递归情况是这样的
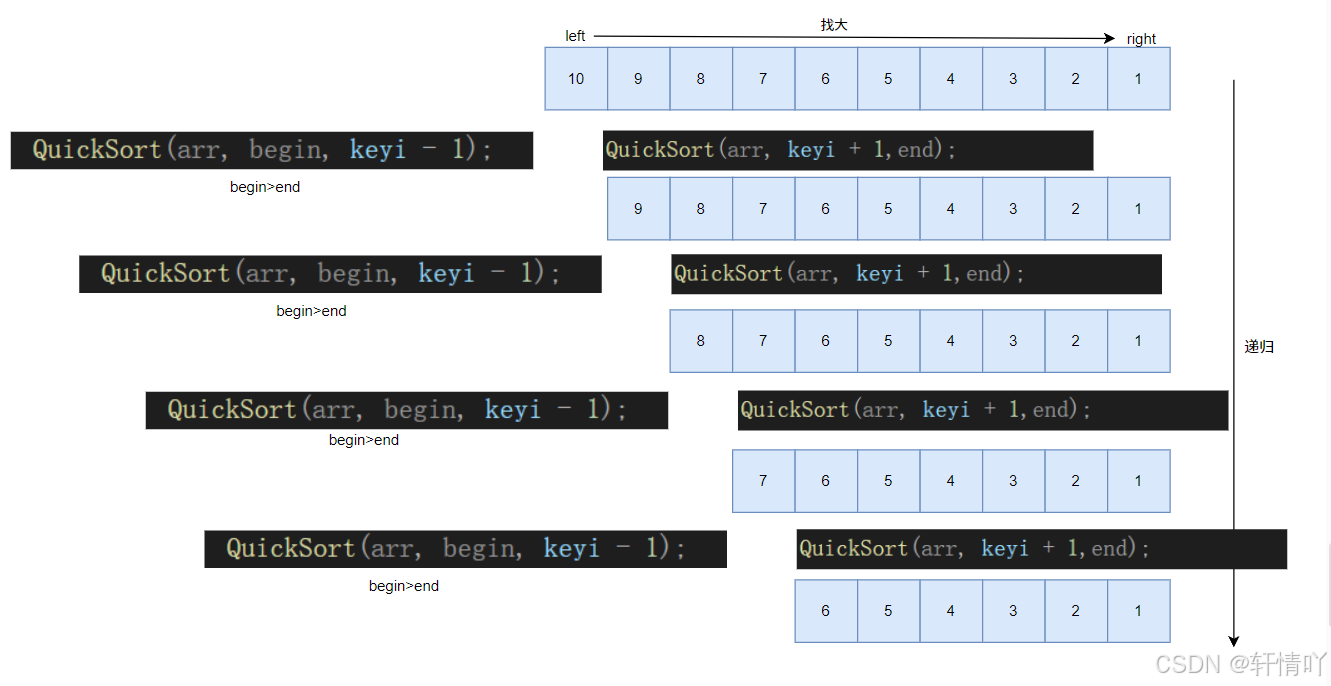
这就相等于每一层递归只能处理一个数,一共要进行N次完整的递归,一共有N个数,那么时间复杂度就是O(N^2)
因此我们得出结论:
现在的写法快速排序最好的情况下时间复杂度是O(N*log₂N)
现在的写法快速排序最坏的情况下时间复杂度是O(N²)
我们要想办法将最坏的情况优化掉,所以我们要使用三数取中法
//三数取中
int GetMidIndex(int* arr, int begin, int end)
{
	//找到中间位置
	int mid = (begin + end) / 2;
	if (arr[begin] > arr[mid])
	{
		if (arr[mid] > arr[end])
		{
			return mid;
		}
		else if (arr[begin] < arr[end])
		{
			return begin;
		}
		else//arr[begin]>arr[end]
		{
			return end;
		}
	}
	else//arr[begin]<=arr[mid]
	{
		if (arr[mid] < arr[end])
		{
			return mid;
		}
		else if (arr[begin] > arr[end])
		{
			return begin;
		}
		else//arr[begin]<arr[end]
		{
			return end;
		}
	}
}


void QuickSort(int* arr, int begin, int end)//快速排序
{
	//begin<end时可以不断的分割左右区间,直到只剩下一个元素或者无元素
	if (begin >= end)
	{
		return;
	}

	//找到不是最大也不是最小的值,提高递归效率
	int mid=GetMidIndex(arr, begin, end);
	Swap(&arr[begin], &arr[mid]);

	int left = begin;
	int right = end;
	int keyi = left;//选定左边key的位置


	while (left < right)//等于时就要和key交换
	{
		//右边先走,找小
		//注意不能少了left<right,否则会越界
		//>加上=,否则会造成死循环
		while (left<right&&arr[right]>=arr[keyi])
		{
			right--;
		}

		//左边后走,找大
		//这个一样需要left<right
		//=最好加上,保证足够的严谨
		while (left<right&&arr[left] <=arr[keyi])
		{
			left++;
		}

		//交换各自找到的值
		Swap(&arr[left], &arr[right]);
	}

	//left==right
	//交换keyi位置的值和相遇位置的值
	Swap(&arr[keyi],&arr[left]);


	keyi = left;

	//递归调用左区间和右区间
	QuickSort(arr, begin, keyi - 1);
	QuickSort(arr, keyi + 1,end);
}
6.1.2.小区间优化
虽然使用三数取中后能够有效的提高效率,但是快速排序还有能提高效率的地方,我们来看看
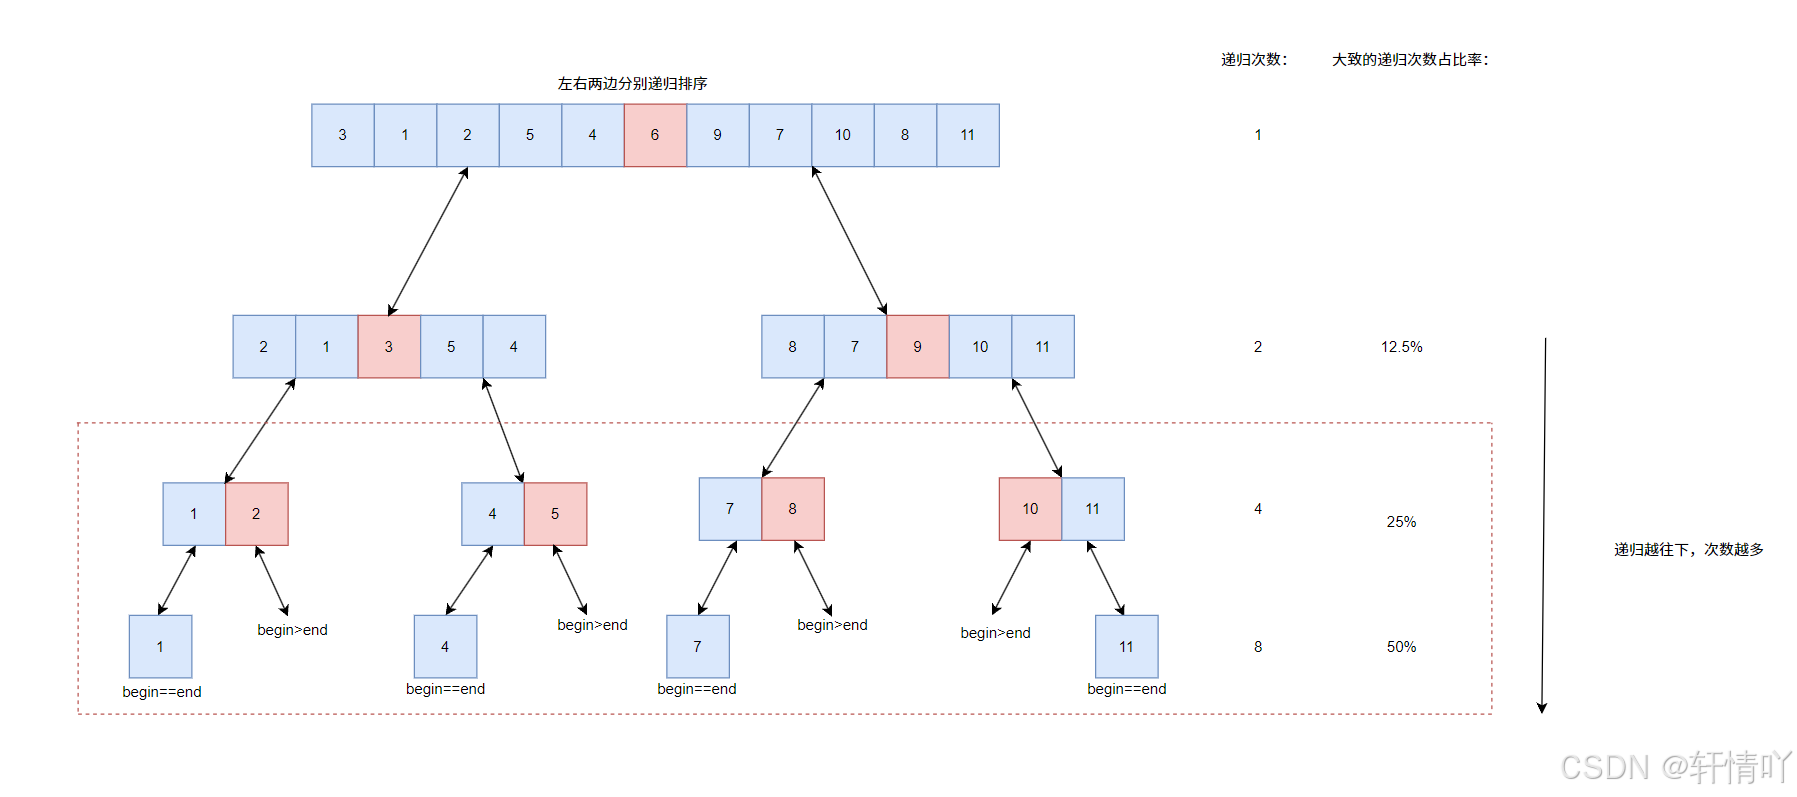
根据我们之前学习二叉树的经验,层数越深,结点数就会比上层多二倍,这里递归也是一样的,
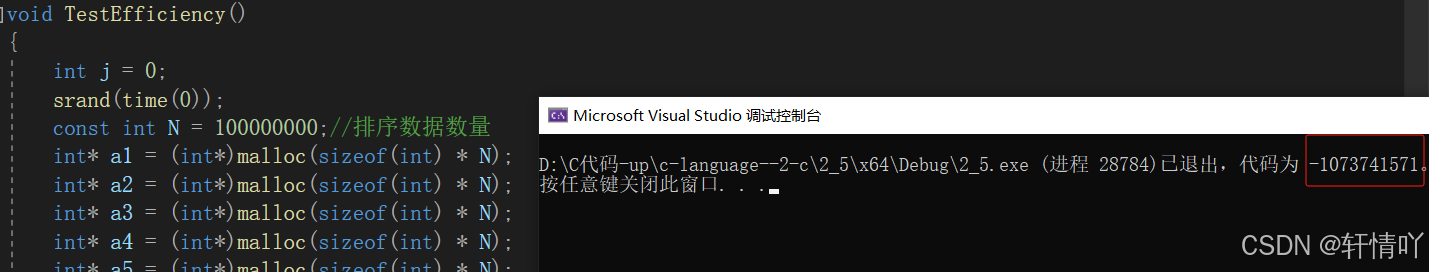
如图中圈出的一部分,递归消耗会非常的大,但是那一部分也就只是一两个数据,一共2^h-1次递归,但是仅仅最后一层占了2 ^(h-1)对于数据量过小用快速排序/希尔排序/堆排,效率反而没有直接插入排序高。(杀鸡用牛刀)直接插入排序对局部有序序列很友好。因此我们在小数据量的情况下使用直接插入排序
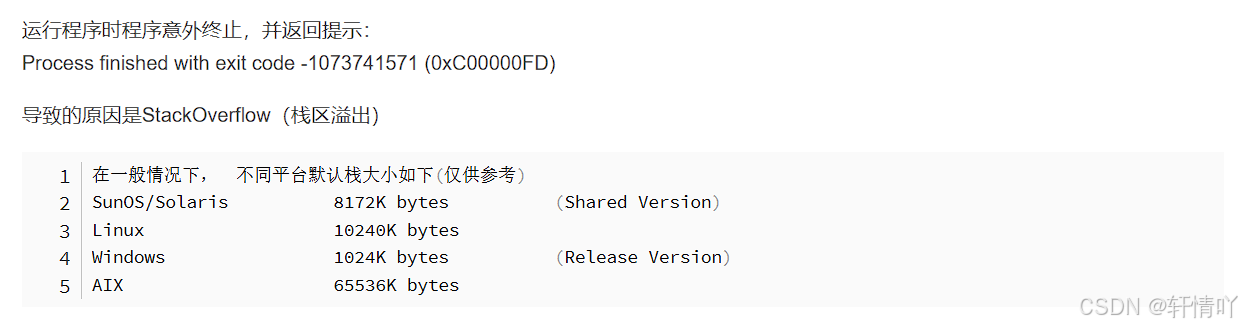
并且过多的递归还会造成栈溢出
void InsertSort(int* arr, int n)//直接插入排序
{
	//从1号下标开始调整,默认0号下标一个元素有序的
	for (int i = 0; i < n - 1; i++)//end==i,i==n-1时,end+1就会越界变成n
	{
		//单趟插入排序
		int end = i;//进行调整的开始位置
		int x = arr[end + 1];//插入值进行保存,防止覆盖
		while (end >= 0)
		{
			if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
			{
				arr[end + 1] = arr[end];
				end--;
			}
			else
			{
				break;//找到合适的插入位置,跳出
			}
		}
		//在找到的位置放入值
		//两种极端情况:不需要移动;全部元素进行移动
		//不需要移动:end+1就是原来的插入值位置
		//全部元素进行移动:end变成-1,-1+1->0,在0号位置插入
		//正常情况:经过上一趟的排序end--后,插入位置已经是end+1了
		arr[end + 1] = x;
	}
}

//三数取中
int GetMidIndex(int* arr, int begin, int end)
{
	//找到中间位置
	int mid = (begin + end) / 2;
	if (arr[begin] > arr[mid])
	{
		if (arr[mid] > arr[end])
		{
			return mid;
		}
		else if (arr[begin] < arr[end])
		{
			return begin;
		}
		else//arr[begin]>arr[end]
		{
			return end;
		}
	}
	else//arr[begin]<=arr[mid]
	{
		if (arr[mid] < arr[end])
		{
			return mid;
		}
		else if (arr[begin] > arr[end])
		{
			return begin;
		}
		else//arr[begin]<arr[end]
		{
			return end;
		}
	}
}

void QuickSort(int* arr, int begin, int end)//快速排序
{
	//begin<end时可以不断的分割左右区间,直到只剩下一个元素或者无元素
	if (begin >= end)
	{
		return;
	}

	//小区间用直接插入替代,减少递归调用次数
	if (end - begin+1<15)
	{
		//arr+begin找到递归区间的起始位置
		InsertSort(arr + begin, end - begin + 1);
	}
	else
	{

		//找到不是最大也不是最小的值,提高递归效率
		int mid = GetMidIndex(arr, begin, end);
		Swap(&arr[begin], &arr[mid]);


		int left = begin;
		int right = end;
		int keyi = left;//选定左边key的位置


		while (left < right)//等于时就要和key交换
		{
			//右边先走,找小
			//注意不能少了left<right,否则会越界
			//>加上=,否则会造成死循环
			while (left < right && arr[right] >= arr[keyi])
			{
				right--;
			}

			//左边后走,找大
			//这个一样需要left<right
			//=最好加上,保证足够的严谨
			while (left < right && arr[left] <= arr[keyi])
			{
				left++;
			}

			//交换各自找到的值
			Swap(&arr[left], &arr[right]);
		}

		//left==right
		//交换keyi位置的值和相遇位置的值
		Swap(&arr[keyi], &arr[left]);


		keyi = left;

		//递归调用左区间和右区间
		QuickSort(arr, begin, keyi - 1);
		QuickSort(arr, keyi + 1, end);
	}
}
6.2.挖坑法
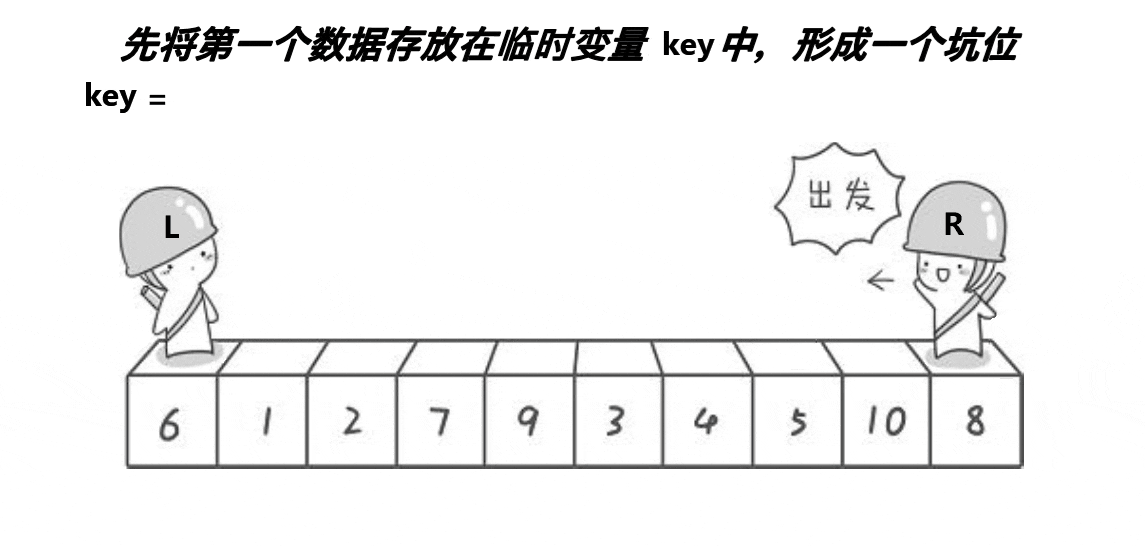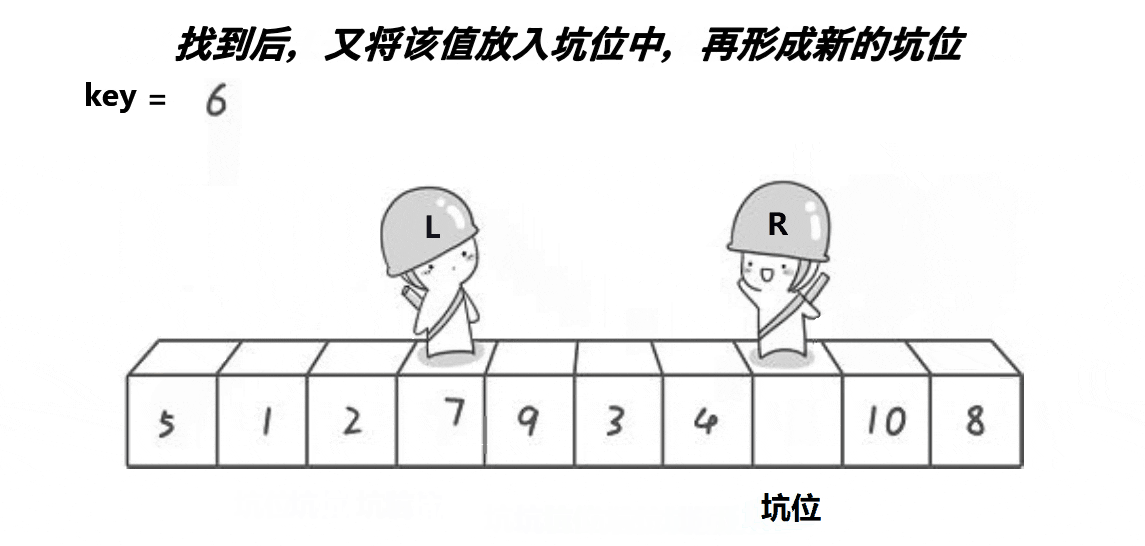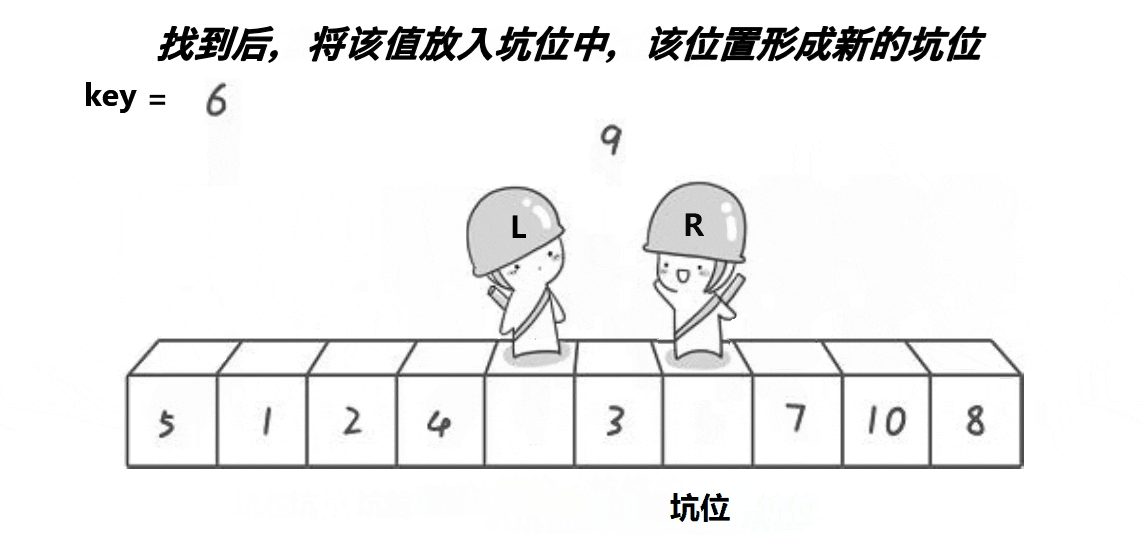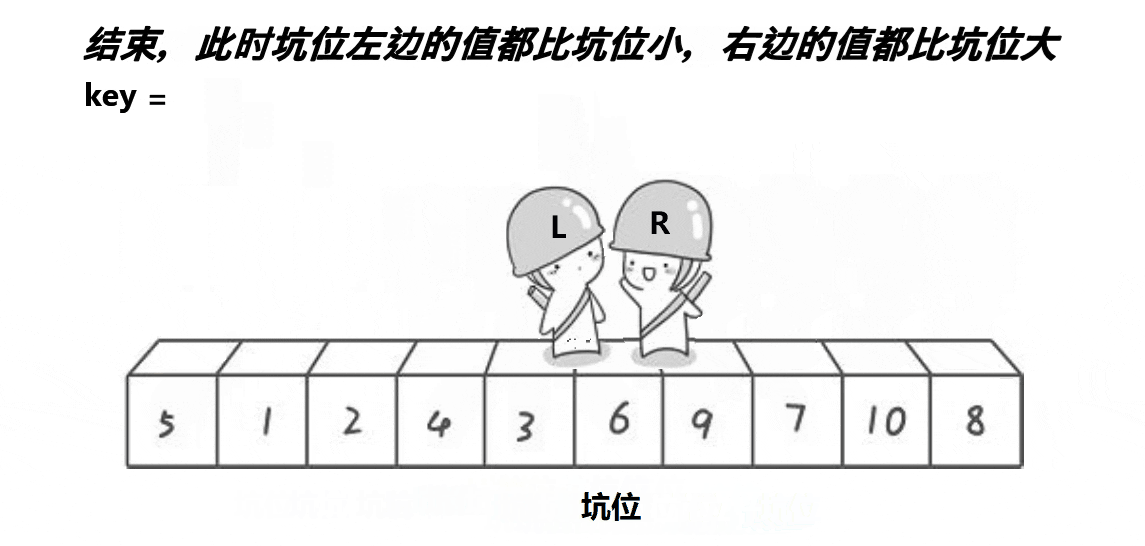
挖坑法的主要思想:
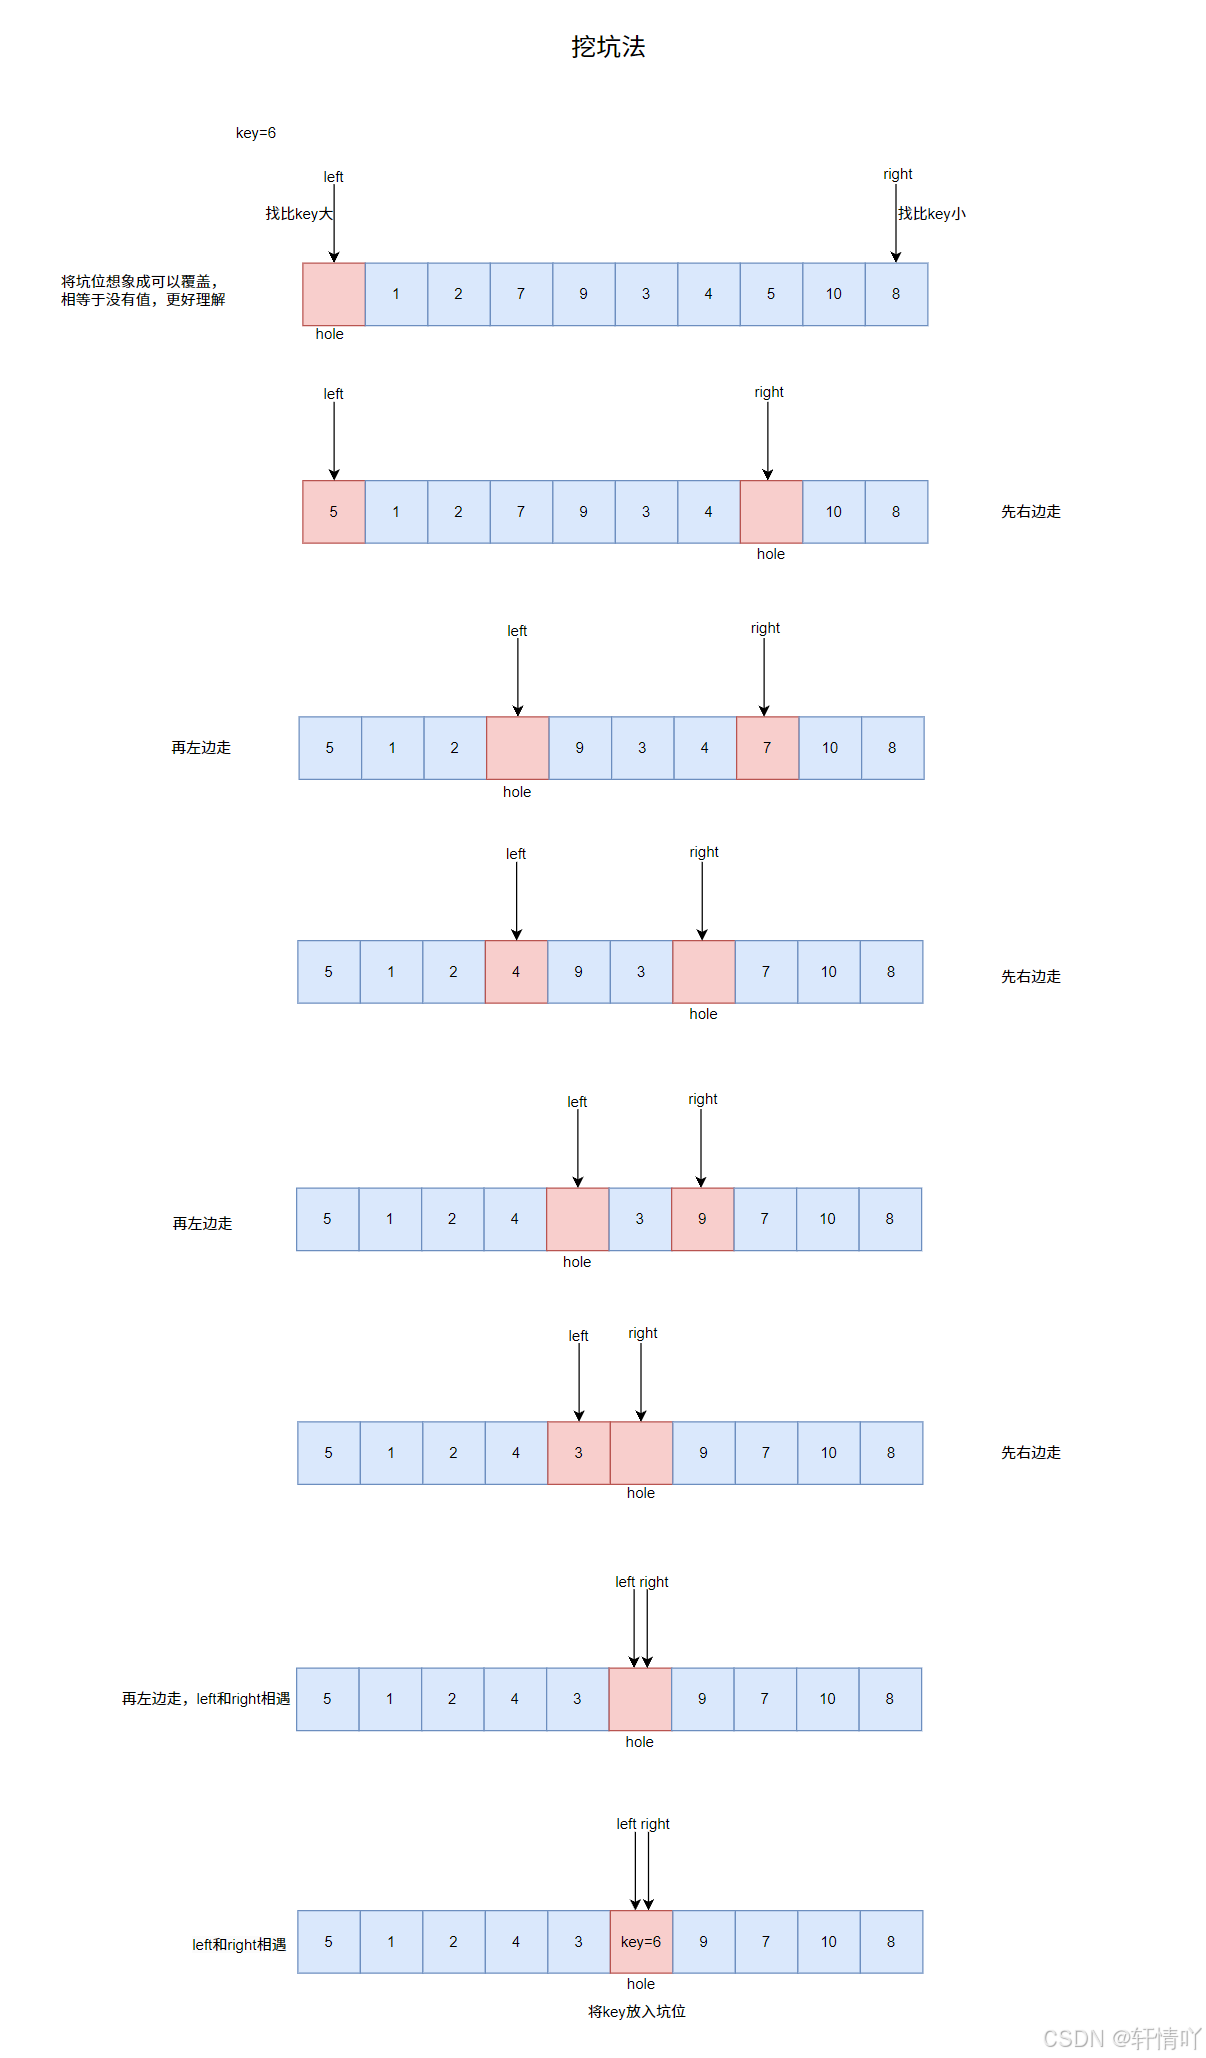
头为初始坑,就从右往左找第一个小于基准值的数来填初始坑,就产生了第二个坑,在从左往右找第一个大于基准值的数来填第二个坑,一次反复进行填坑,直到begin=end时,说明坑左边的数不大于key,坑右边的不小于key,就直接将key填入坑中,得到两个子区间,在用递归的方式对子区间进行上述操作。
并且相遇的位置一定是坑位,因为每次填坑后会有新的坑位,新的坑位一定是停住的没有移动的一方,那么移动的一方没有找到合适的值就会和停住的一方相遇
//三数取中
int GetMidIndex(int* arr, int begin, int end)
{
	//找到中间位置
	int mid = (begin + end) / 2;
	if (arr[begin] > arr[mid])
	{
		if (arr[mid] > arr[end])
		{
			return mid;
		}
		else if (arr[begin] < arr[end])
		{
			return begin;
		}
		else//arr[begin]>arr[end]
		{
			return end;
		}
	}
	else//arr[begin]<=arr[mid]
	{
		if (arr[mid] < arr[end])
		{
			return mid;
		}
		else if (arr[begin] > arr[end])
		{
			return begin;
		}
		else//arr[begin]<arr[end]
		{
			return end;
		}
	}
}

//挖坑法
int PartSort2(int* arr, int begin, int end)
{
	//三数取中
	int mid = GetMidIndex(arr, begin, end);
	Swap(&arr[begin], &arr[mid]);

	int left = begin;
	int right = end;

	//选key值
	int key = arr[left];
	//选取首个坑位
	int hole = left;

	while (left < right)
	{
		//先从右边找比key小的
		while (left < right && arr[right] >= key)
		{
			right--;
		}
		//将找到的值放入坑位
		arr[hole] = arr[right];
		//重新选坑
		hole = right;

		//再从左边找比key大的
		while (left < right && arr[left] <= key)
		{
			left++;
		}
		arr[hole] = arr[left];
		hole = left;
	}

	//在left和right相遇位置(坑位)放入key
	arr[hole] = key;

	return hole;
}

void QuickSort(int* arr, int begin, int end)//快速排序
{
	//begin<end时可以不断的分割左右区间,直到只剩下一个元素或者无元素
	if (begin >= end)
	{
		return;
	}

	//小区间用直接插入替代,减少递归调用次数
	if (end - begin+1 >15)
	{
		//arr+begin找到递归区间的起始位置
		InsertSort(arr + begin, end - begin + 1);
	}
	else
	{
		int keyi = PartSort2(arr, begin, end);
		//递归调用左区间和右区间
		QuickSort(arr, begin, keyi - 1);
		QuickSort(arr, keyi + 1, end);
	}
}
这个比较简单,但还是画了图,可以看一下:
6.3.前后指针版本
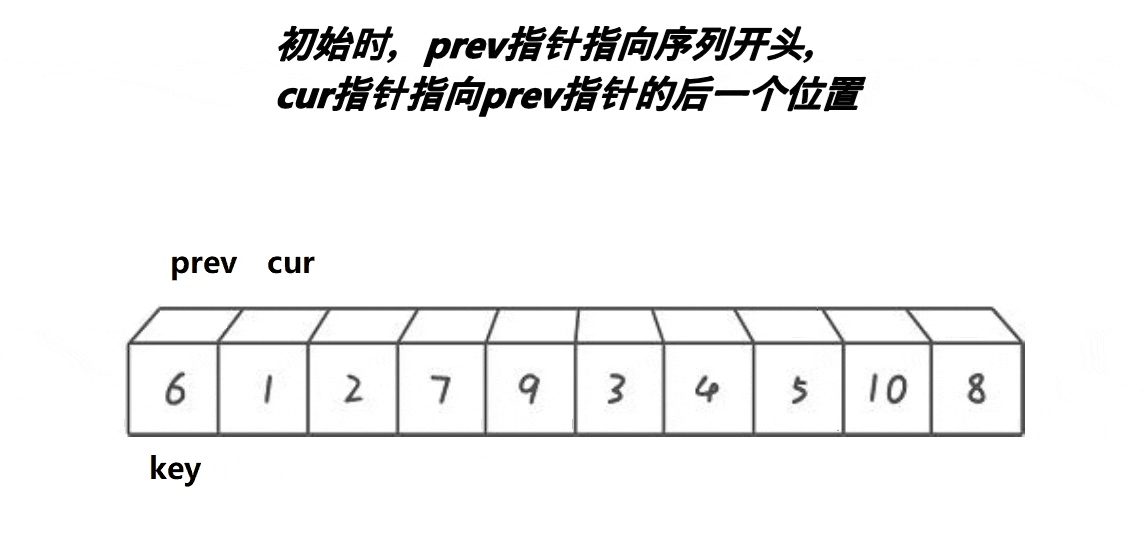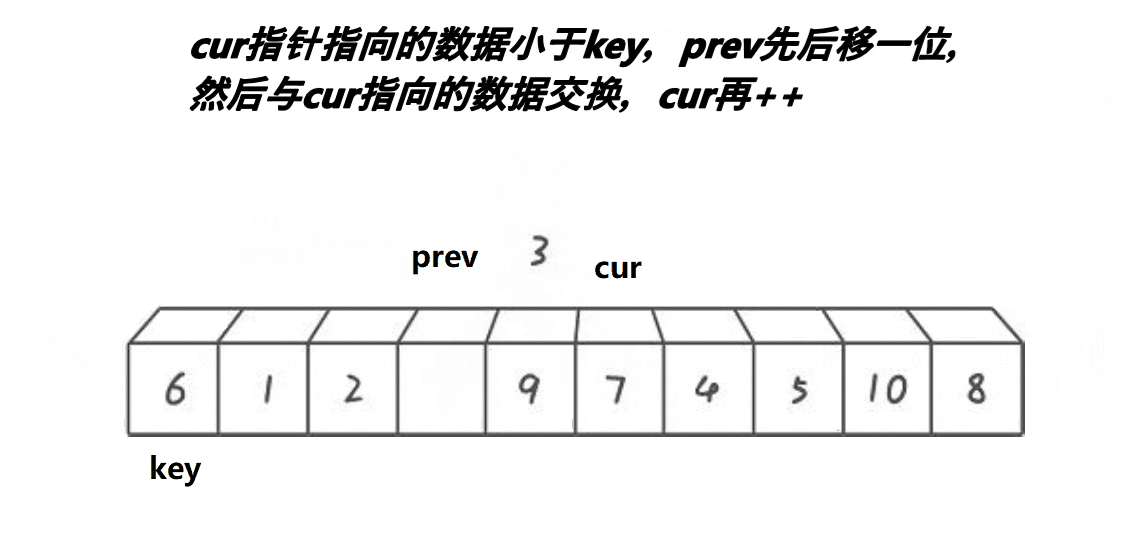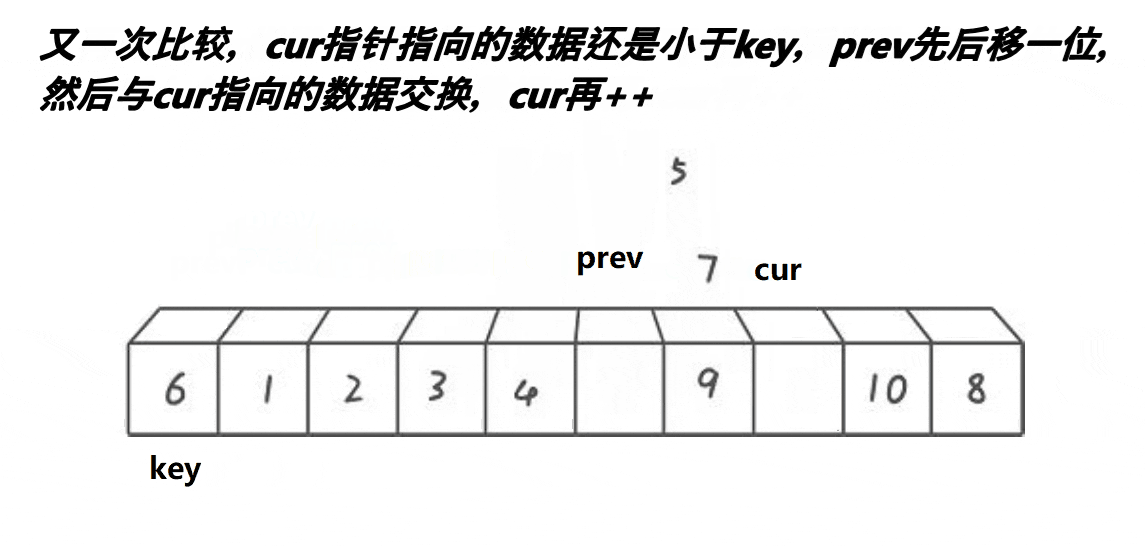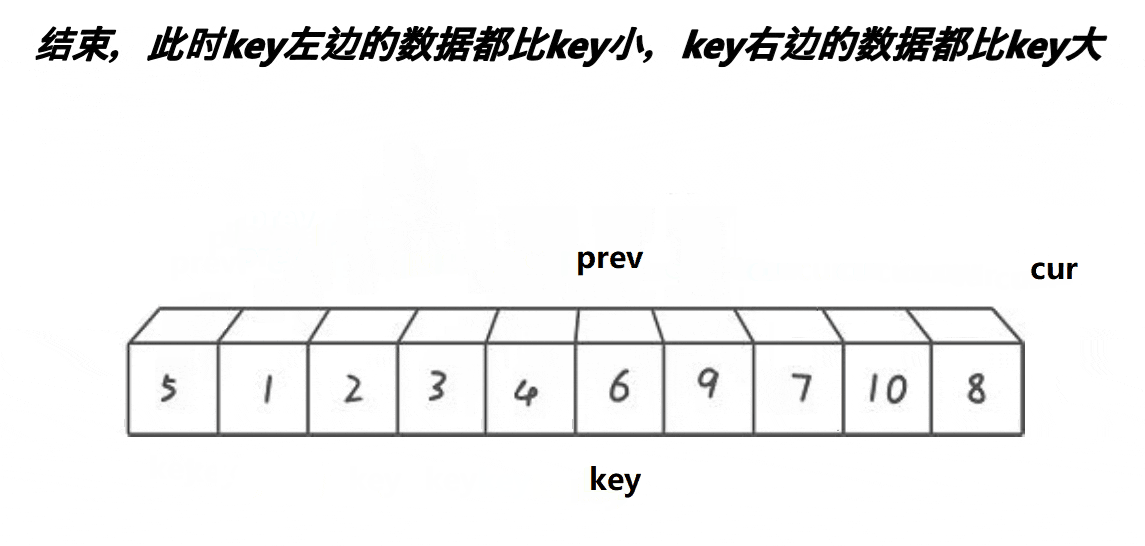
前后指针的大致思想:cur找比key小的,找到后停下来,++prev,交换prev位置和cur位置的值;当cur越界后,将prev位置的值和key进行交换。这样就能保证key的左边全是小于它的,右边全是大于它的,并且这个思想可以理解为是prev一直在“推着”比key大的值往后移动
//三数取中
int GetMidIndex(int* arr, int begin, int end)
{
	//找到中间位置
	int mid = (begin + end) / 2;
	if (arr[begin] > arr[mid])
	{
		if (arr[mid] > arr[end])
		{
			return mid;
		}
		else if (arr[begin] < arr[end])
		{
			return begin;
		}
		else//arr[begin]>arr[end]
		{
			return end;
		}
	}
	else//arr[begin]<=arr[mid]
	{
		if (arr[mid] < arr[end])
		{
			return mid;
		}
		else if (arr[begin] > arr[end])
		{
			return begin;
		}
		else//arr[begin]<arr[end]
		{
			return end;
		}
	}
}

//双指针法(前后指针法)
int PartSort3(int* arr, int begin, int end)
{
	//三数取中
	int mid = GetMidIndex(arr, begin, end);
	Swap(&arr[begin], &arr[mid]);

	//选prev和cur
	int prev = begin;
	int cur = begin + 1;
	//选keyi
	int keyi = begin;

	while (cur <=end)
	{
		//cur找比key小的
		//prev在判断时进行++,并且只在前置表达式成立时才会执行
		//判断主要是减少同一位置的交换
		if (arr[cur] < arr[keyi] && (++prev) != cur)
		{
			//交换prev位置和cur位置的值
			Swap(&arr[prev], &arr[cur]);
		}
		//cur不停地++直到越界
		cur++;
	}

	//交换keyi位置和prev位置的值,keyi来到了正确的位置
	//keyi左边都是小于它的,右边都是大于它的
	//prev指向的必定是小于key的
	Swap(&arr[keyi],&arr[prev]);

	keyi = prev;
	return keyi;
}

void QuickSort(int* arr, int begin, int end)//快速排序
{
	//begin<end时可以不断的分割左右区间,直到只剩下一个元素或者无元素
	if (begin >= end)
	{
		return;
	}

	//小区间用直接插入替代,减少递归调用次数
	if (end - begin+1 >15)
	{
		//arr+begin找到递归区间的起始位置
		InsertSort(arr + begin, end - begin + 1);
	}
	else
	{
		int keyi = PartSort3(arr, begin, end);
		//递归调用左区间和右区间
		QuickSort(arr, begin, keyi - 1);
		QuickSort(arr, keyi + 1, end);
	}
}
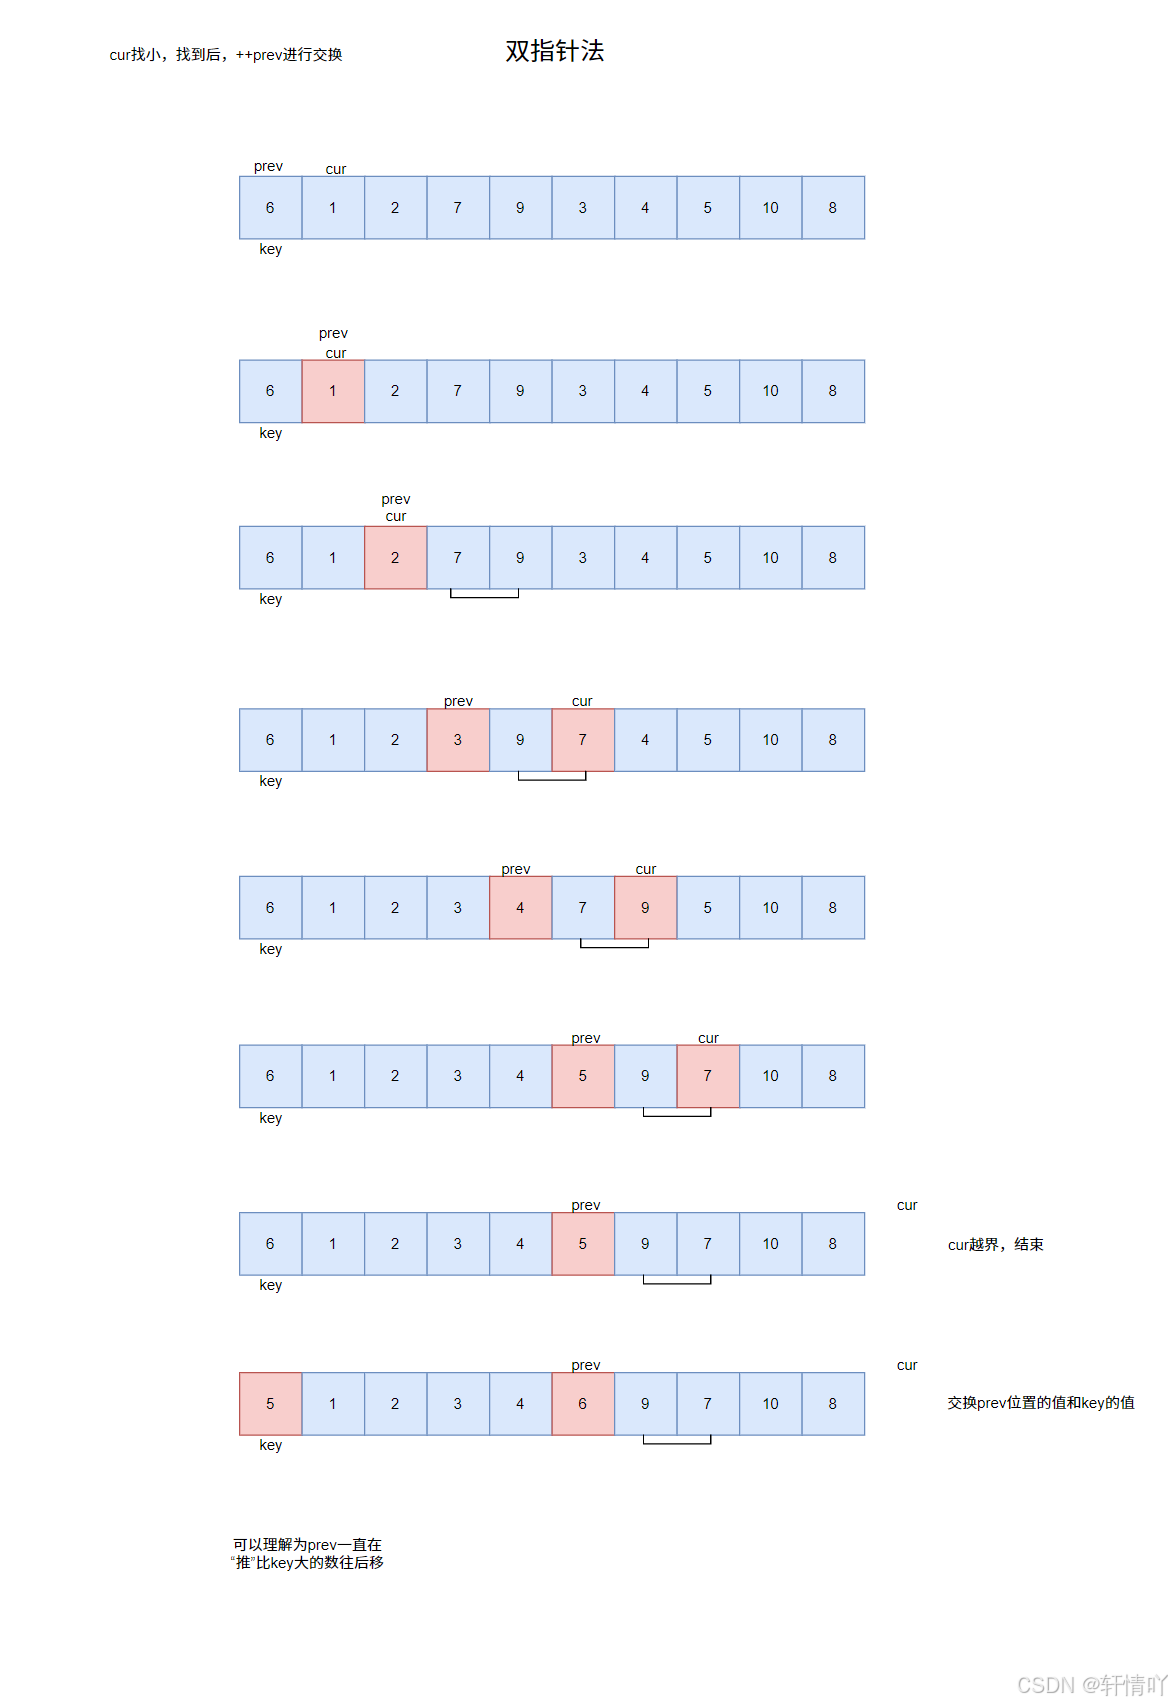
图中的9和7就像是在一直在被“推着”往后走
6.4.非递归版本
前面的三个版本使用的都是递归方法,虽然进行优化后会好很多,但是已久无法避免递归太多导致栈爆掉,因此我们需要学习一下非递归方法
我们实现非递归就得使用栈来辅助,基本思想如下:
①设begin= 0,end = 9,left先入栈,right再入栈。
②判断栈是否为空,如果不为空从栈中两次提取数据,先取right为栈顶元素,然后删除栈顶元素,再取left为栈顶元素,再删除栈顶元素。对下标位于[left, right]之间的数据进行单趟快排,获取key在单趟快排之后的下标keyi。
③进行完②的单趟快排后,左子序列的下标范围是[begin, keyi - 1],右子序列的下标范围是[keyi+1, end],先判断keyi + 1 < right是否成立,如果成立,keyi+1和right先后入栈,再判断left < keyi - 1是否成立,如果成立,begin和keyi - 1先后入栈。
重复步骤2和步骤3,直到栈为空。
上述的方法其实是参照递归的路线来的,使用栈可以使左区间全部排序完成再完成右区间(类似于二叉树先完成左子树再完成右子树),这样的我们称之为深度优先遍遍历;但是我们也可以使用队列来实现非递归版本,只不过是排序的顺序不一样罢了(类似于二叉树的层序遍历),对于排序上来说就是左区间排一次,右区间排一次,直到一层排完再排下一层。
下面是实现代码:
//hoare法
int PartSort1(int* arr, int begin, int end)
{
	//找到不是最大也不是最小的值,提高递归效率
	int mid = GetMidIndex(arr, begin, end);
	Swap(&arr[begin], &arr[mid]);


	int left = begin;
	int right = end;
	int keyi = left;//选定左边key的位置


	while (left < right)//等于时就要和key交换
	{
		//右边先走,找小
		//注意不能少了left<right,否则会越界
		//>加上=,否则会造成死循环
		while (left < right && arr[right] >= arr[keyi])
		{
			right--;
		}

		//左边后走,找大
		//这个一样需要left<right
		//=最好加上,保证足够的严谨
		while (left < right && arr[left] <= arr[keyi])
		{
			left++;
		}

		//交换各自找到的值
		Swap(&arr[left], &arr[right]);
	}

	//left==right
	//交换keyi位置的值和相遇位置的值
	Swap(&arr[keyi], &arr[left]);


	keyi = left;
	return keyi;
}

//快速排序的非递归
void QuickSortNonR(int* arr, int begin,int end)
{
	//需要使用栈来辅助
	ST st;
	StackInit(&st);
	//首次先将begin和end入栈
	StackPush(&st, begin);
	StackPush(&st, end);
	while (!StackEmpty(&st))//直到栈为空,所有区间的排序完成
	{
		//由于栈的先进先出的特性,第一次拿到的是右标识
		int right=StackTop(&st);
		StackPop(&st);
		int left = StackTop(&st);
		StackPop(&st);


			//进行一次快排
			int keyi = PartSort1(arr, left, right);

			//分割左右区间放入栈中,模拟递归的行为
			//模拟递归行为的话就需要先放右区间
			//这样才能保证先左区间后右区间
			if (keyi + 1 < right)
			{
				StackPush(&st, keyi + 1);
				StackPush(&st, right);
			}
			if (left < keyi - 1)//元素有两个及以上时才放入栈中,同时防止越界情况
			{
				StackPush(&st, left);
				StackPush(&st, keyi - 1);
			}
	}


	StackDestory(&st);

}
//stack.h
#pragma once
#define _CRT_SECURE_NO_WARNINGS 1
#include <stdio.h>
#include <assert.h>
#include <stdlib.h>
#include <stdbool.h>
typedef int Type;//把int重命名为Type,因此以后如果需要新的类型数据,直接改int就可以了
typedef struct Stack
{
	Type* arr;//动态开辟数组
	int capacity;//容量
	int top;//栈顶的下一个位置的下标
}ST;
void StackInit(ST* p);//初始化栈
void StackDestory(ST* p);//销毁栈
void StackPush(ST* p, Type x);//压栈
void StackPop(ST* p);//出栈
Type StackTop(ST* p);//找出栈顶的值
bool StackEmpty(ST* p);//判断栈是否为空
int StackSize(ST* p);//栈里有多少数据
//stack.c
#define _CRT_SECURE_NO_WARNINGS 1
#include "stack.h"
void StackInit(ST* p)//初始化栈
{
	assert(p);//断言一下,防止传过来的是NULL
	p->arr = malloc(sizeof(Type) * 4);//给arr开辟空间
	if (p->arr == NULL)//判断一下是否开辟空间失败
	{
		perror("malloc fail");
		exit(-1);
	}
	p->top = 0;//top是栈顶的下一个位置的下标
	p->capacity = 4;
}


void StackDestory(ST* p)//销毁栈
{
	assert(p);
	free(p->arr);//释放给arr开辟的空间
	p->capacity = 0;//容量也变为0
	p->top = 0;
}


void StackPush(ST* p, Type x)//压栈
{
	assert(p);
	if (p->top == p->capacity)//判断空间是否满了,可以看出top正好是数据的数量
	{
		Type* tmp = realloc(p->arr, p->capacity * 2 * sizeof(Type));//空间不够开辟原来空间的两倍
		if (tmp != NULL)
		{
			p->arr = tmp;
			p->capacity *= 2;
		}
		else
		{
			perror("realloc fails");
			exit(-1);
		}
	}
	p->arr[p->top] = x;
	p->top++;//使top指向栈顶的下一个位置的下标
}


void StackPop(ST* p)//出栈
{
	assert(p);
	assert(p->top > 0);//如果已经没有数据了就不能再删了
	p->top--;//栈是通过top来判断元素数量的
}


Type StackTop(ST* p)//找出栈顶的值
{
	assert(p);
	assert(p->top > 0);//没有数据了就不会有栈顶的值
	return p->arr[p->top - 1];//top是栈顶的下一个值的下标,那么top-1就是栈顶的下标
}


bool StackEmpty(ST* p)//判断栈是否为空
{
	assert(p);
	return p->top == 0;//前面也说了top也正好是数据的数量,当top是0时,那么栈就为空
}


int StackSize(ST* p)//栈里有多少数据
{
	assert(p);
	return p->top;
}
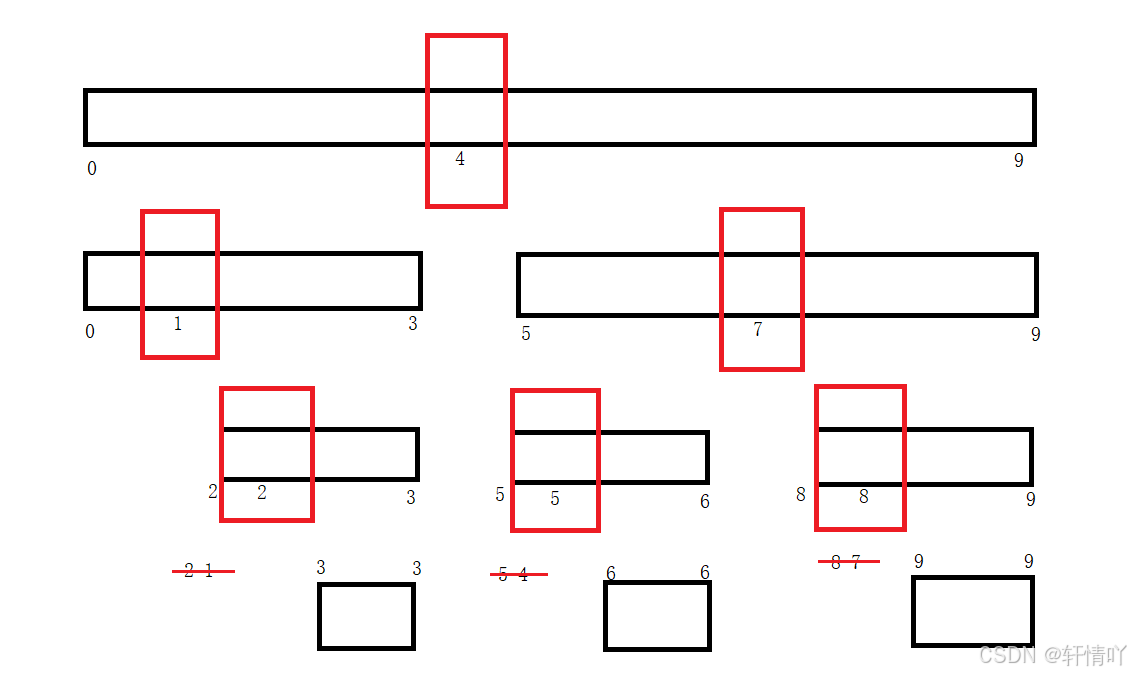
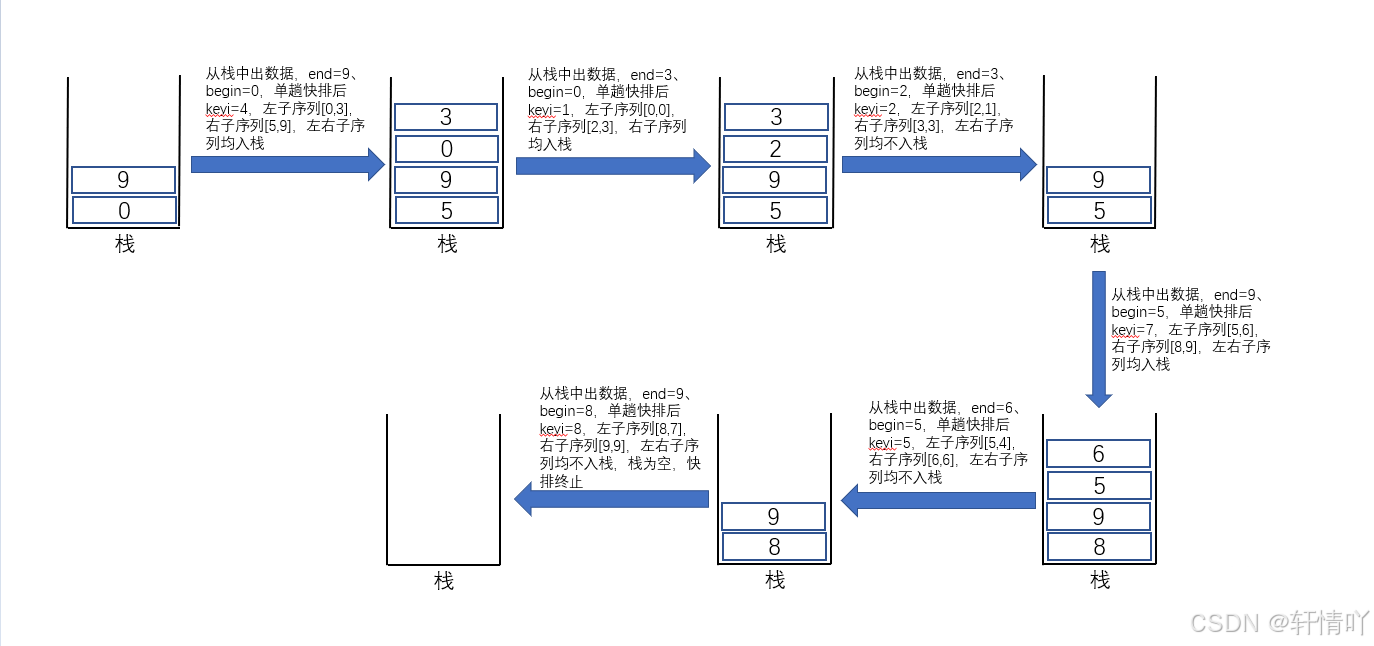
上面展示了两幅画,分别是递归展开的情况和栈的情况,两幅图是相对应的,可以看出我们使用栈是和递归的排序步骤是一样的
快速排序的特性总结:
①时间复杂度:O(N*log₂N)
②空间复杂度:O(log₂N)
③稳定性:不稳定
它的时间复杂度前面说过了,它的空间复杂度是O(log₂N)是因为快速排序需要用到递归,而递归的样子就是类似于二叉树一样,如上面给出的递归图,需要开辟的栈帧个数是高度个,因为栈帧会销毁,销毁后又可以重复利用。
6.5三路划分版本
在我们前面的写的版本中,已经解决了大部分问题,例如序列是一个顺序或者逆序会造成效率低下O(N^2),我们使用了三数取中的方法将其解决。但是还有一个极端的问题,如果元素都是相同的怎么办?即使是三数取中也没办法来处理,因为选来选去的值始终一样,那么在进行查找大的值或者小的值来进行交换或者填坑时,会一直走到底,这样在进行递归时就会效率极其低下,就和顺序或者逆序一样的问题,因此就有了
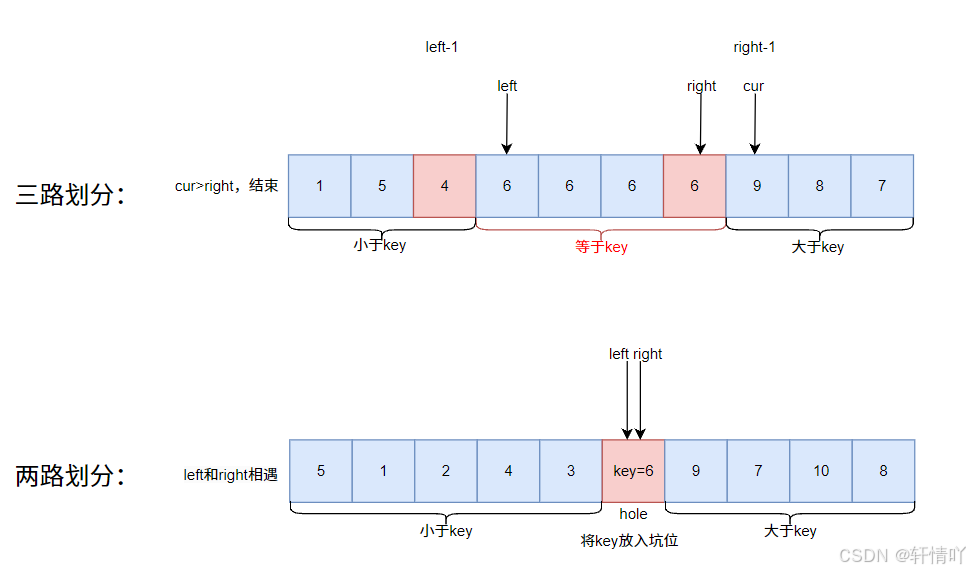
三路划分,我们前面学习的都是两路划分
在leetcode也有道题,如果使用两路划分,就无法通过,先给出代码,再来分析:
 int GetMidIndex(int* arr, int begin, int end)
{
	//找到中间位置
	//int mid = (begin + end) / 2;

	//用于三路划分-随机数取中--对于大量区间选key可能选到比较小(大),效率下降,这里使用随机选key来优化,leetcode必须要
	int mid = begin+rand() % (end - begin + 1);

	if (arr[begin] > arr[mid])
	{
		if (arr[mid] > arr[end])
		{
			return mid;
		}
		else if (arr[begin] < arr[end])
		{
			return begin;
		}
		else//arr[begin]>arr[end]
		{
			return end;
		}
	}
	else//arr[begin]<=arr[mid]
	{
		if (arr[mid] < arr[end])
		{
			return mid;
		}
		else if (arr[begin] > arr[end])
		{
			return begin;
		}
		else//arr[begin]<arr[end]
		{
			return end;
		}
	}
}

void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}

void InsertSort(int* arr, int n)//直接插入排序
{
	//从1号下标开始调整,默认0号下标一个元素有序的
	for (int i = 0; i < n - 1; i++)//end==i,i==n-1时,end+1就会越界变成n
	{
		//单趟插入排序
		int end = i;//进行调整的开始位置
		int x = arr[end + 1];//插入值进行保存,防止覆盖
		while (end >= 0)
		{
			if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
			{
				arr[end + 1] = arr[end];
				end--;
			}
			else
			{
				break;//找到合适的插入位置,跳出
			}
		}
		//在找到的位置放入值
		//两种极端情况:不需要移动;全部元素进行移动
		//不需要移动:end+1就是原来的插入值位置
		//全部元素进行移动:end变成-1,-1+1->0,在0号位置插入
		//正常情况:经过上一趟的排序end--后,插入位置已经是end+1了
		arr[end + 1] = x;
	}
}

 //快速排序-三路划分
void QuickSort(int* arr, int begin, int end)
{
	if (begin >= end)
	{
		return;
	}

	//当数据少时,减少递归,使用直接插入排序
	if (end - begin + 1 < 15)
	{
		InsertSort(arr + begin, end - begin + 1);
	}
	else
	{
		//三数取中
		int mid=GetMidIndex(arr, begin,end);
		Swap(&arr[begin], &arr[mid]);
		//标识设置
		int left = begin;
		int cur = begin + 1;
		int right = end;
		int key = arr[begin];
		//当cur>right时,一次快排结束
		while (cur <= right)
		{
			//当arr[cur]<key时,交换arr[left]和arr[cur],left++,cur++
			//当arr[cur] == key时,cur++
			if (arr[cur] < key)
			{
				Swap(&arr[cur],&arr[left]);
				left++;
				cur++;
			}
			//当arr[cur] > key时,交换arr[right]和arr[cur], right--
			else if (arr[cur] > key)
			{
				Swap(&arr[cur], &arr[right]);
				right--;
			}
			//当arr[cur] == key时,cur++
			else
			{
				cur++;
			}
		}
		//[begin,left-1][left,right][right+1,end]
		//左边都是小于key的
		QuickSort(arr, begin, left - 1);
		//右边都是大于key的
		QuickSort(arr, right + 1, end);
		//中间的是等于key的,已经到达正确的位置了
	}

}
三路划分的主要思想是通过left推着和key相等的值往后走,和key相等的在中间,比key小的在左边,比key大的在右边,那么是如何做到的呢?如下图,展示的具体过程
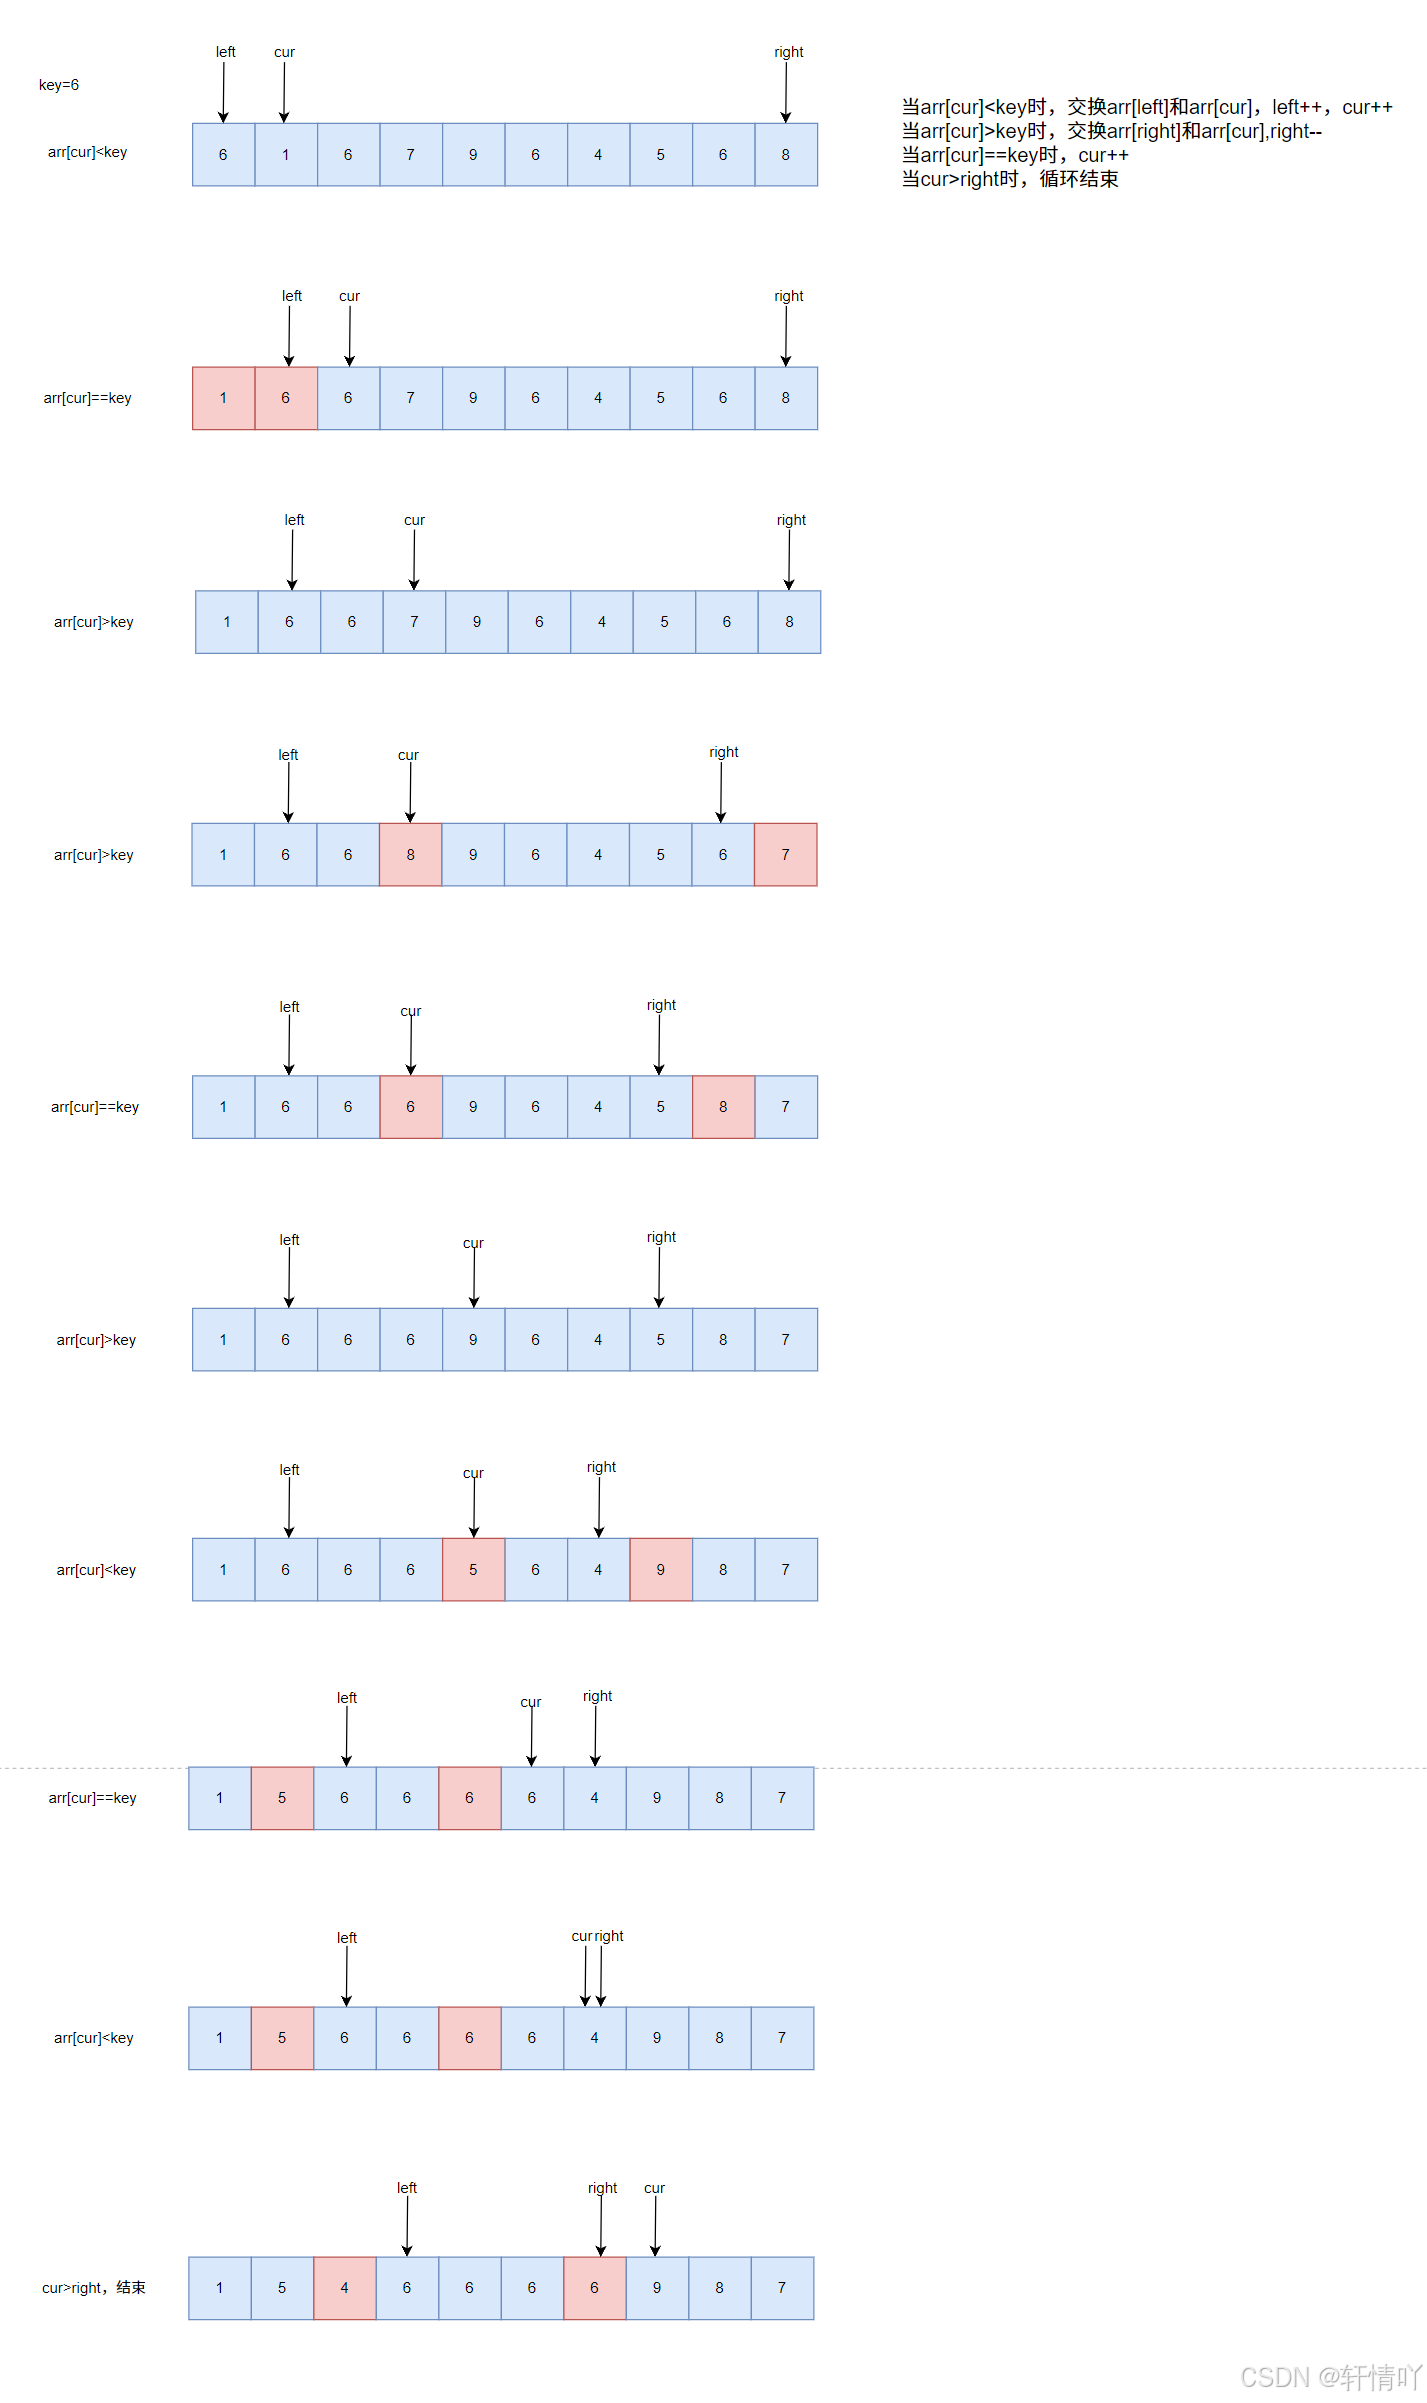
以前讲的两路划分只有小于和大于key这两路,现在的三路划分多了个等于key,并且我们的三路划分后等于key的值已经到了正确的位置,只需要对左右两边进行递归即可,这样就能解决全部是相等值的序列了,并且这种写法对于普通的数据也能达到排序的效果
7.归并排序
7.1.递归版本
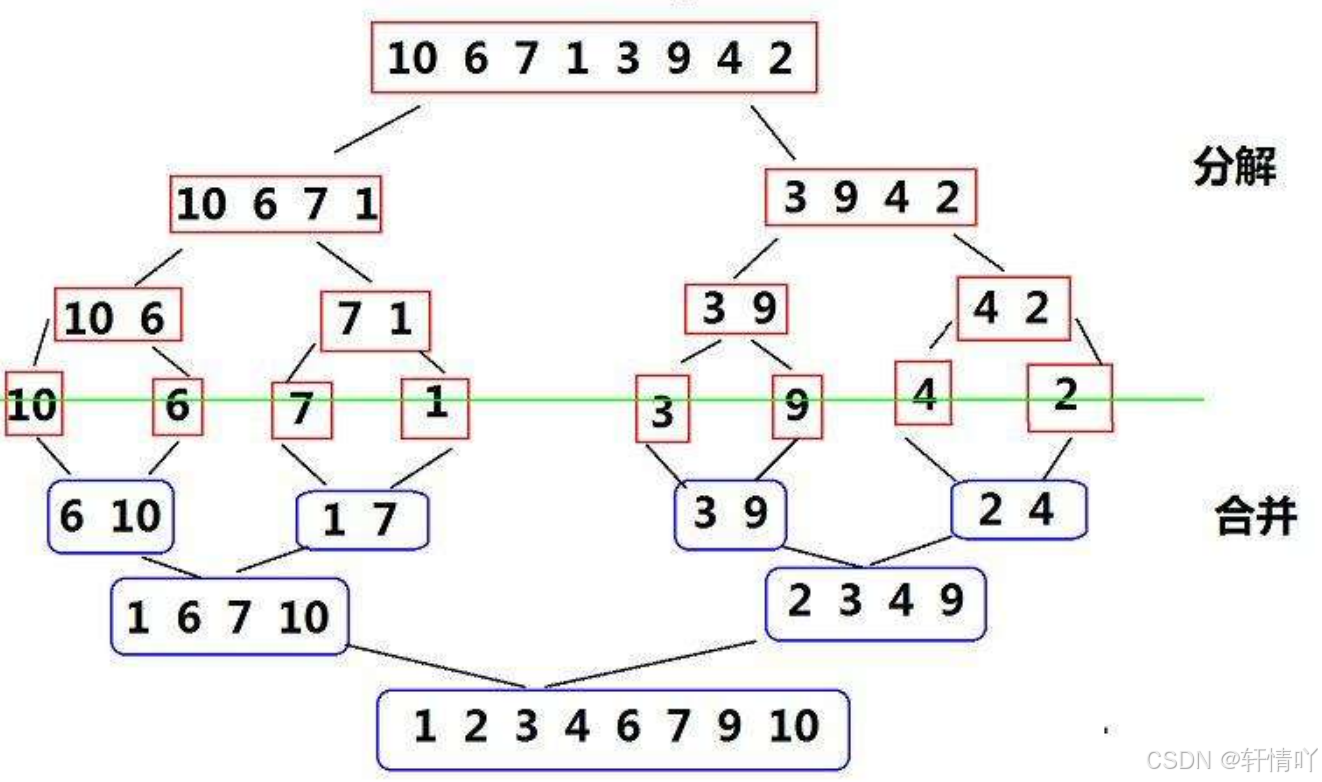
归并排序思想:
将一个数组分成两半,递归地对这两半进行排序,然后将排序好的两半合并成一个有序的数组
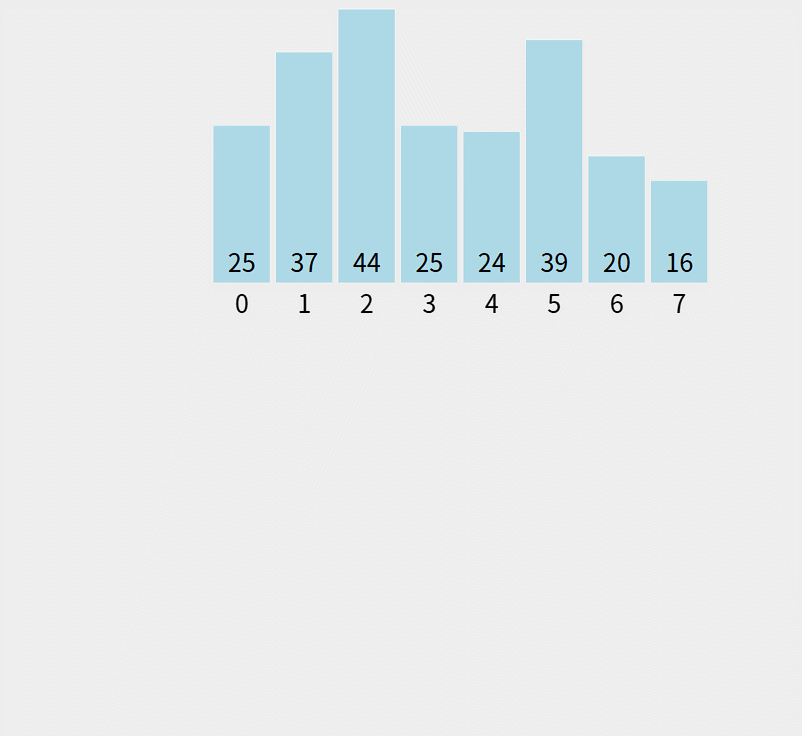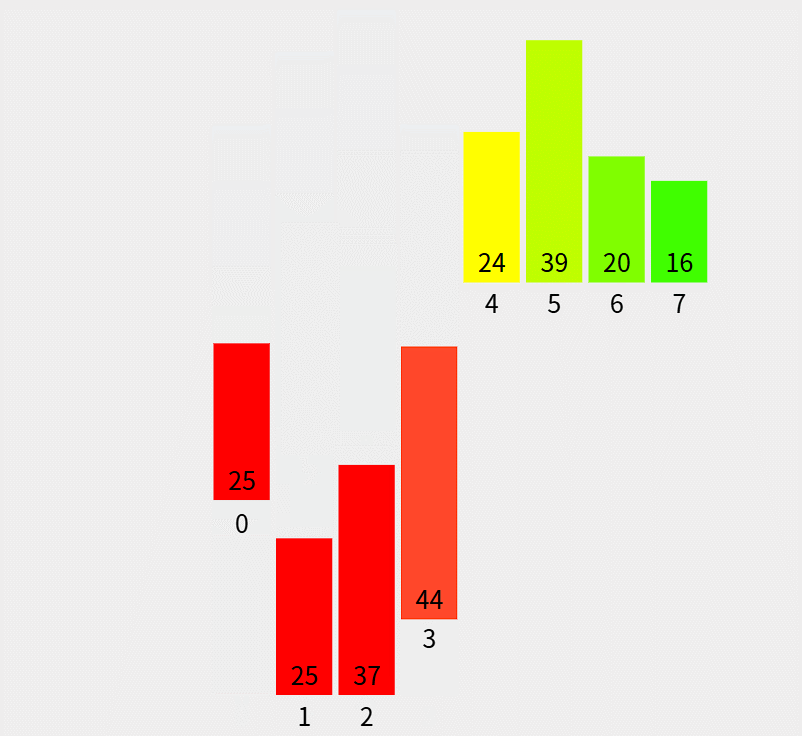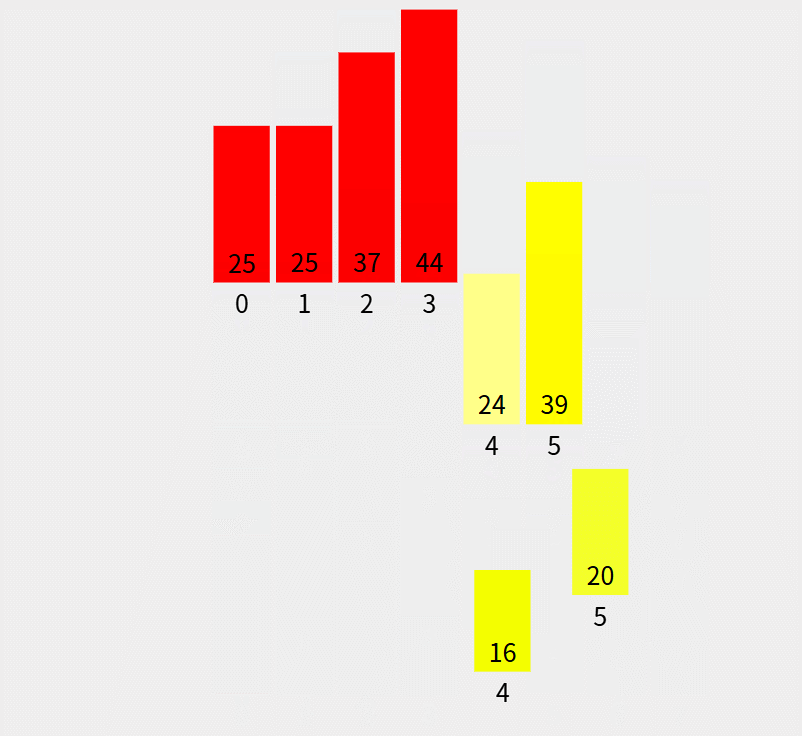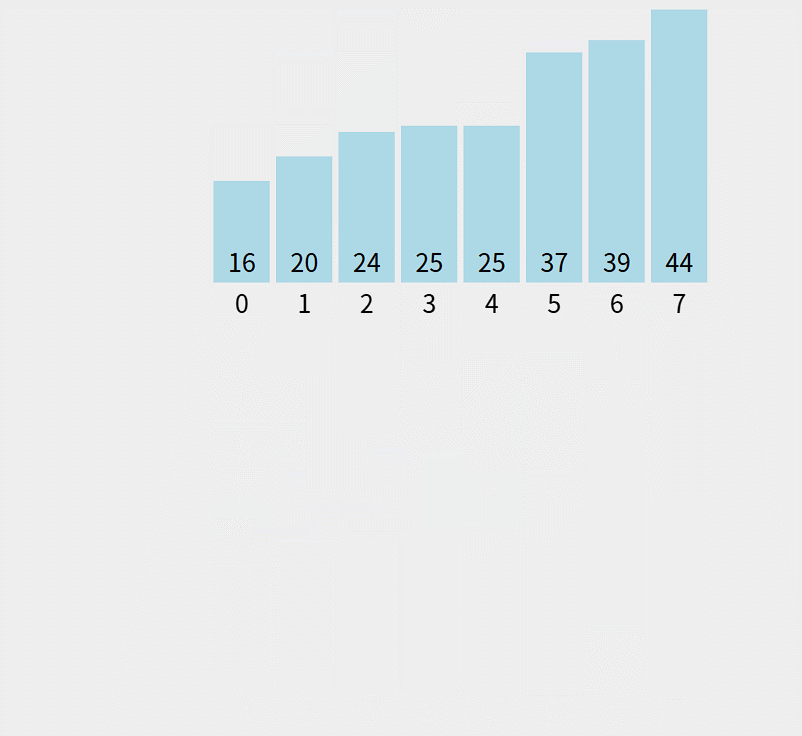
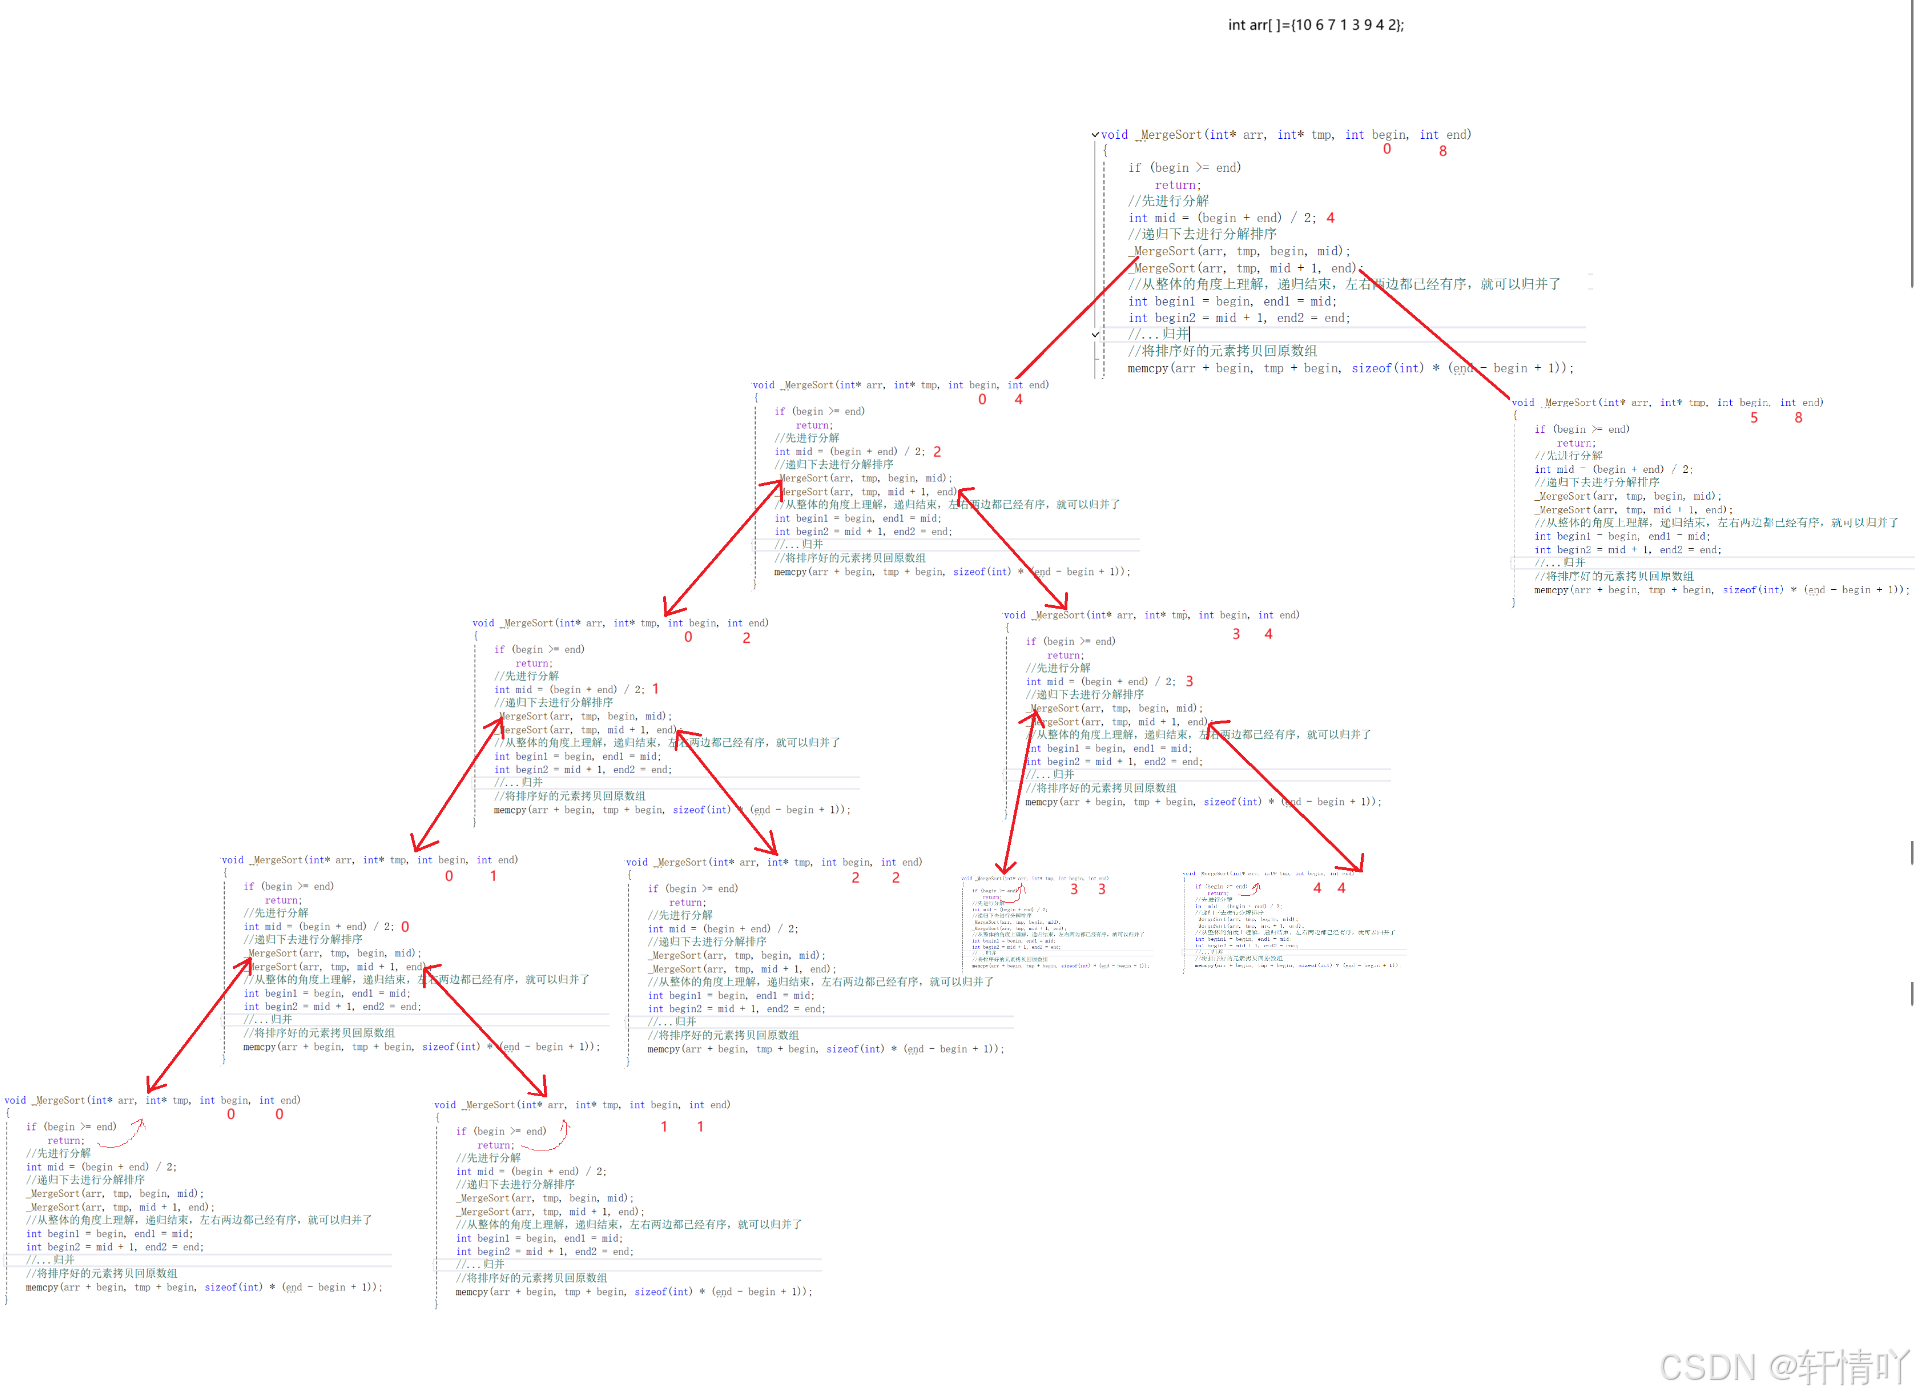
归并排序不停地递归分解,直到元素只剩下1个,这个时候1个元素就肯定是有序了,然后依次一层一层回到调用的地方进行比较合并,直到有序,比较合并也需要空间,因此我们还需要进行开辟空间,合并完成后再拷贝回原数组
看动图来理解一下:
void _MergeSort(int* arr, int* tmp, int begin, int end)
{
	if (begin >= end)
	{
		return;
	}

	//先进行分解
	int mid = (begin+end) / 2;

	//递归下去进行分解排序
	_MergeSort(arr, tmp, begin, mid);
	_MergeSort(arr, tmp, mid+1, end);

	//从整体的角度上理解,递归结束,左右两边都已经有序,就可以归并了
	int begin1 = begin, end1 = mid;
	int begin2 = mid + 1, end2 = end;

	int i = begin;

	//两个有序的序列,放到一起,只要有一个结束了,循环结束
	while (begin1 <= end1 && begin2 <= end2)
	{
		if (arr[begin1]<=arr[begin2])
		{
			tmp[i++] = arr[begin1++];
		}
		else
		{
			tmp[i++] = arr[begin2++];
		}
	}

	while (begin1 <= end1)//如果左序列还有剩余就继续拼接
	{
		tmp[i++] = arr[begin1++];
	}

	while (begin2 <= end2)
	{
		tmp[i++] = arr[begin2++];
	}

	//将排序好的元素拷贝回原数组
	memcpy(arr+begin, tmp+begin, sizeof(int) * (end - begin + 1));
}

void MergeSort(int* arr, int n)//归并排序,非递归
{
	//开辟空间
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc error");
	}

	//需要递归,但是不需要每次都开辟空间,因此需要另一个函数
	_MergeSort(arr,tmp,0,n-1);

	free(tmp);
	tmp = NULL;
}
左半部分的递归展开图:
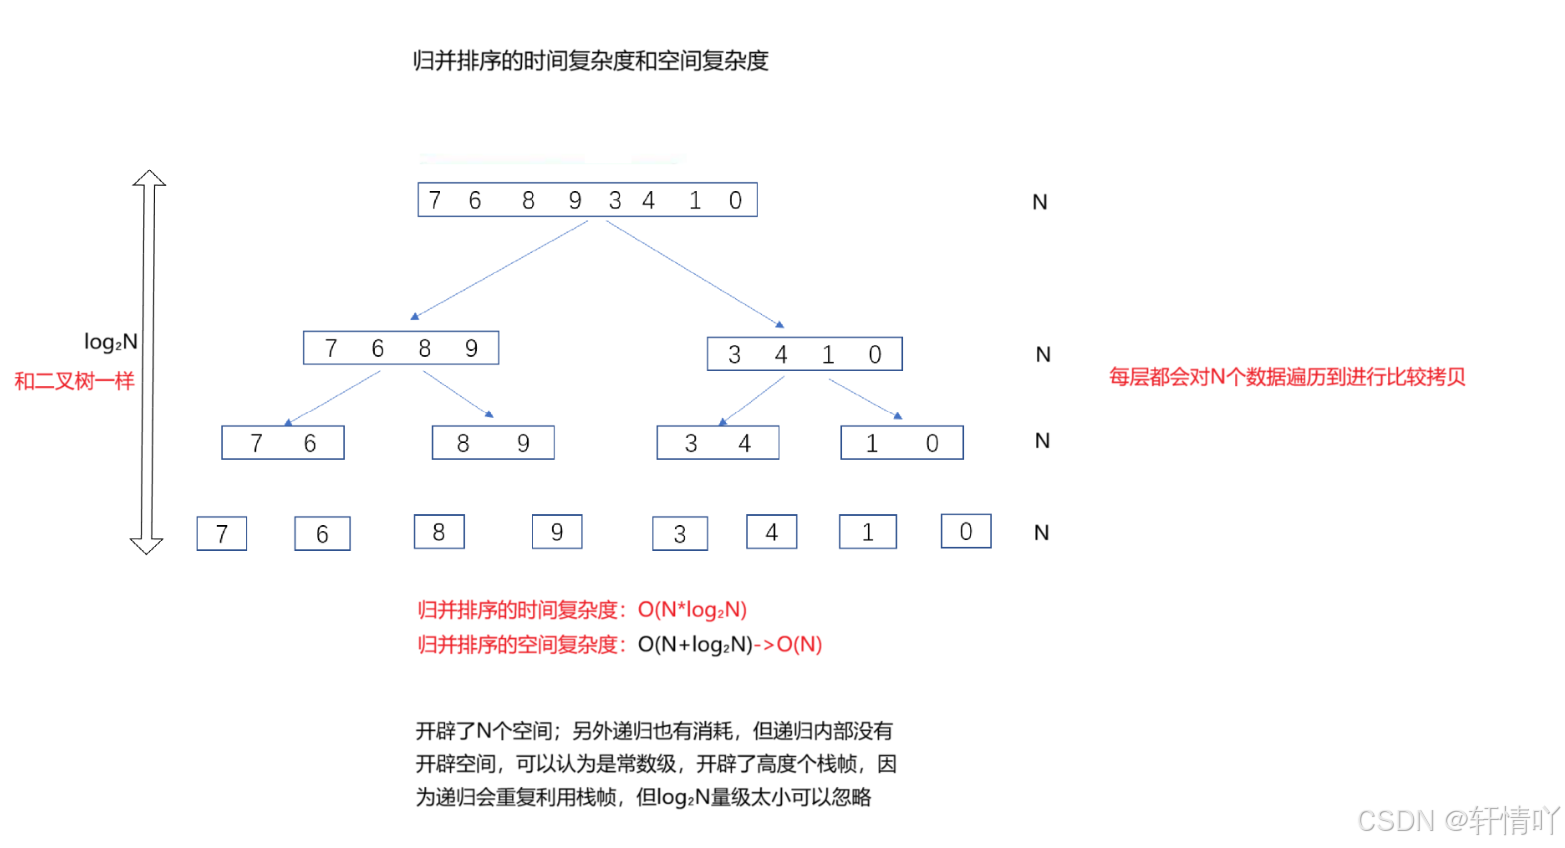
接下来就是它的时间复杂度和空间复杂度
归并排序的特性总结:
①归并的缺点在于需要O(N)的空间复杂度,归并排序的思考更多的是解决在磁盘中的外排序问题。
②时间复杂度:O(N*logN)
③空间复杂度:O(N)
④稳定性:稳定
7.2.非递归版本
非递归实现的思想与递归实现的思想是类似的。
不同的是,这里的序列划分过程和递归是相反的,不是一次一分为二,而是先1个元素一组进行合并,再2个元素一组进行合并,4个元素一组进行合并…直到将所有的元素归并完。
//非递归版归并排序
void MergeSortNonR(int* arr, int n)
{
	//先开辟空间
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc error");
		exit(-1);
	}


	int rangeN = 1;//rangeN是左右子序列的间距,同时也是子序列的元素个数
	while (rangeN < n)//一般rangeN是n的一半就能完成排序,>=n就越界了
	{
		for (int i = 0; i < n; i += 2 * rangeN)//i每次变化代表到下一个分解的数组
		{
			//左边的一组区间
			//end1是左序列的结尾,i位置+rangeN元素个数-越界到右序列的1个
			int begin1 = i, end1 = i + rangeN - 1;
			//右边的一组区间
			//begin2是+rangeN个元素找到右序列的头
			//end2通过+左右序列的元素个数(2*rangeN)-越界后面的1个
			int begin2 = i + rangeN, end2 = i+2 * rangeN - 1;
			int j = i;//单词循环i不会变化,不能使用begin1...

			//todo

			//两个有序的序列,放到一起,只要有一个结束了,循环结束
			while (begin1 <= end1 && begin2 <= end2)
			{
				if (arr[begin1] <= arr[begin2])
				{
					tmp[j++] = arr[begin1++];
				}
				else
				{
					tmp[j++] = arr[begin2++];
				}
			}

			while (begin1 <= end1)//如果左序列还有剩余就继续拼接
			{
				tmp[j++] = arr[begin1++];
			}

			while (begin2 <= end2)
			{
				tmp[j++] = arr[begin2++];
			}

			//将排序好的元素拷贝回原数组
			//不能写2*rangeN,会有越界问题
			//也不能使用begin1和begin2,已经变化过了
			memcpy(arr + i, tmp + i, sizeof(int) * (end2 -i+1));
		}
		rangeN *= 2;//模仿递归的返回过程
	}
	free(tmp);
}
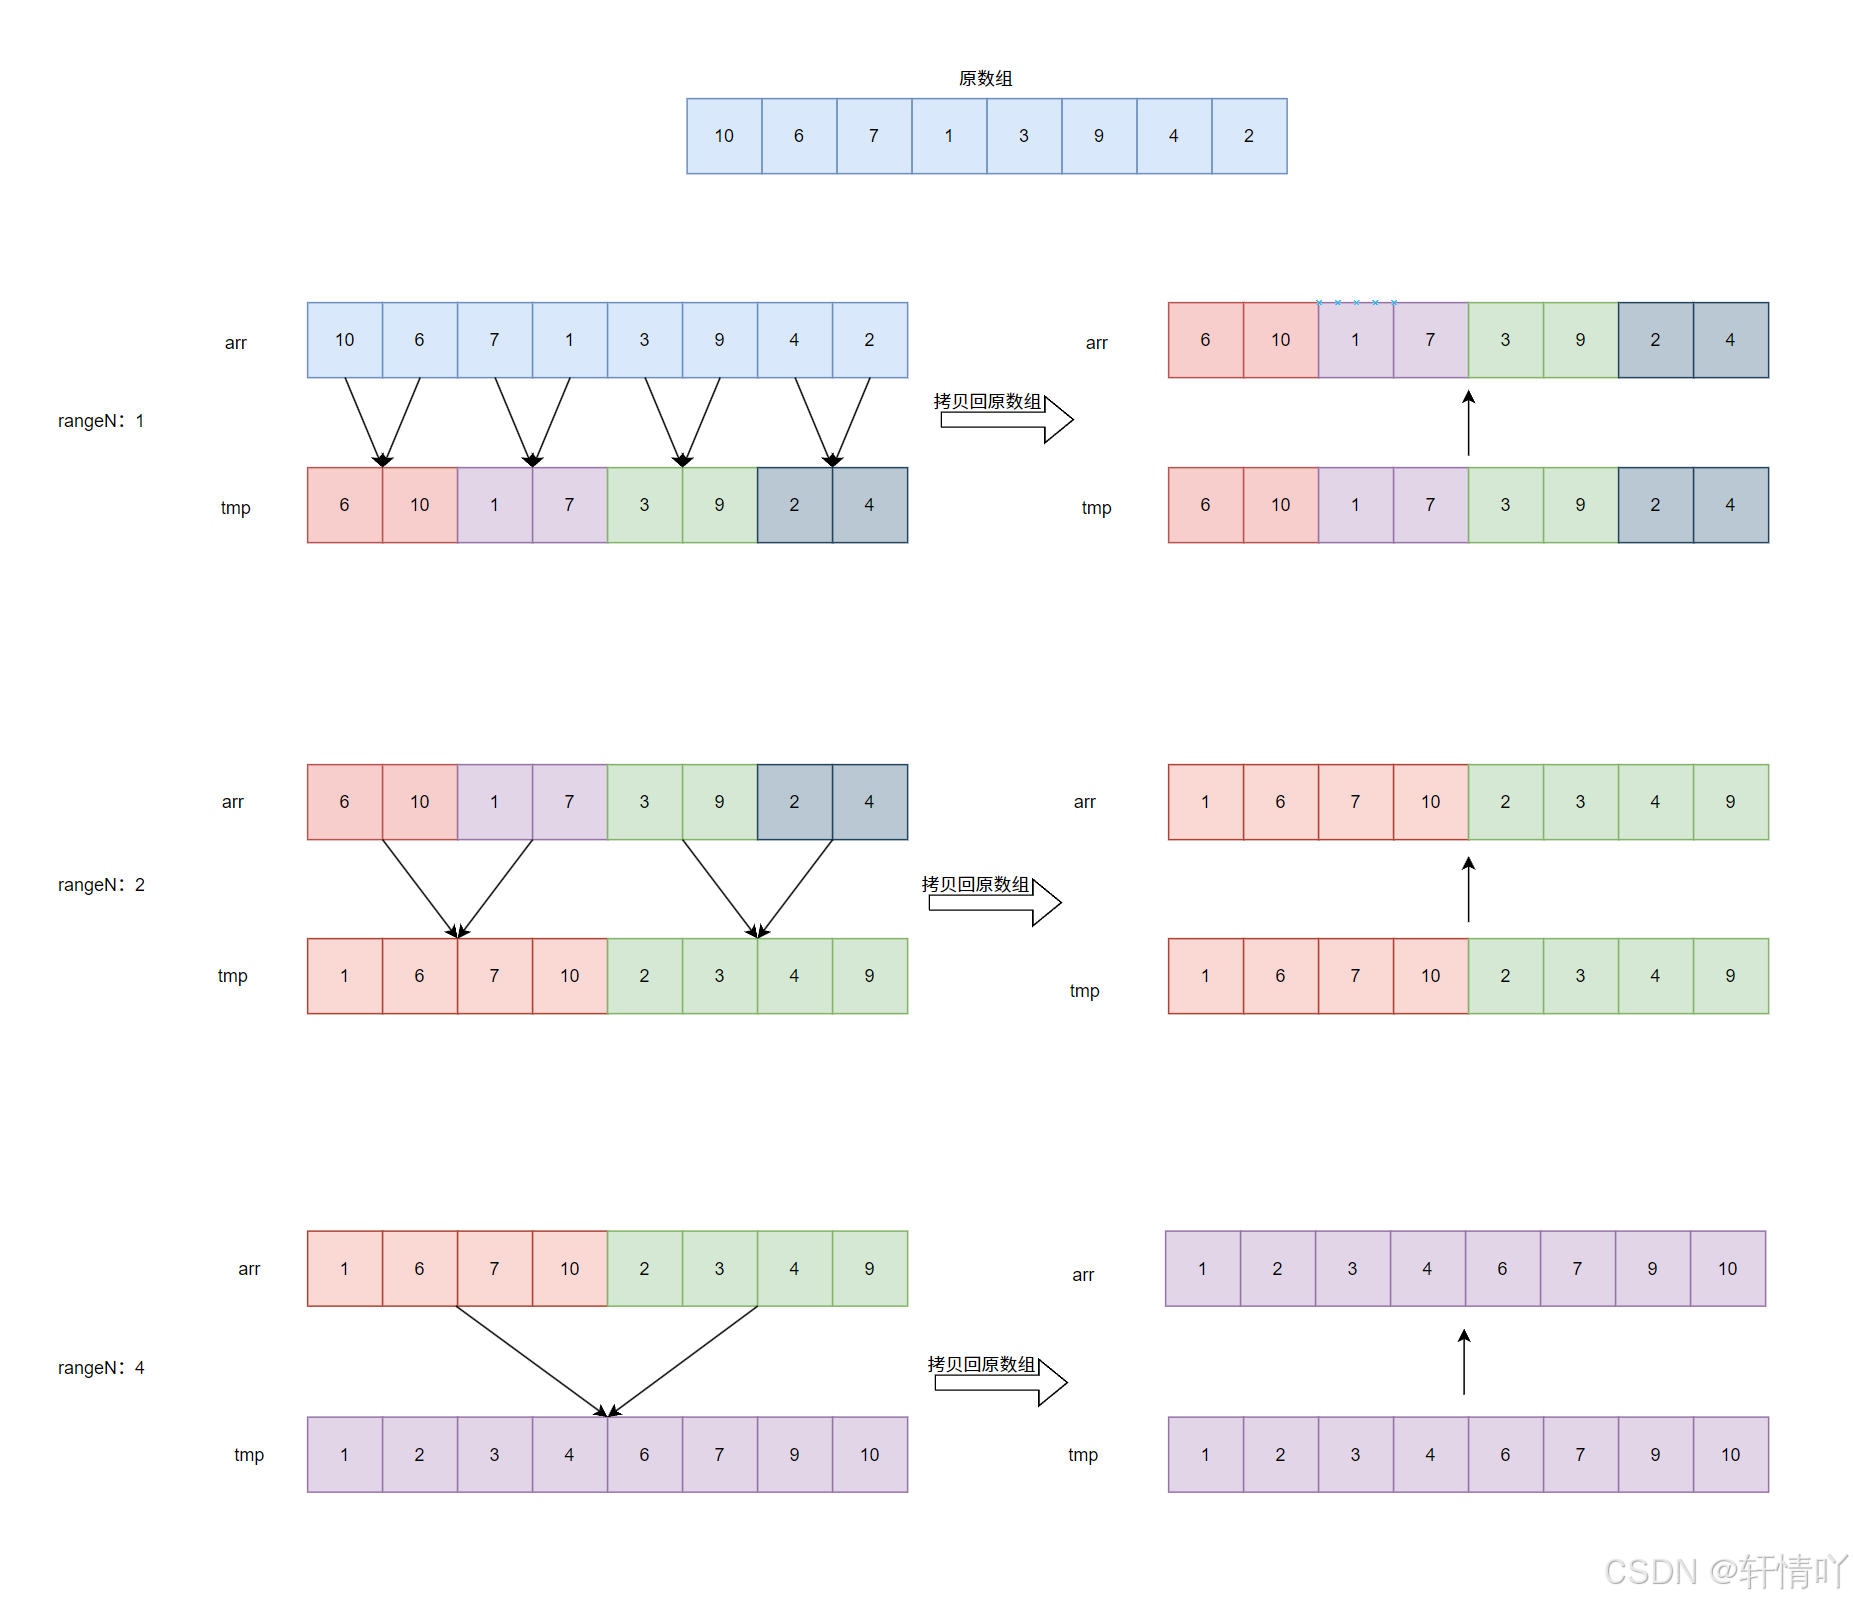
上面给出了代码和图解,但是这种写法还是有点问题,它会有越界的可能性,我们往下来看
我们将排序的数组变一下
int arr[10] = { 6, 1, 2, 7, 9, 3, 4, 5, 6, 8 };
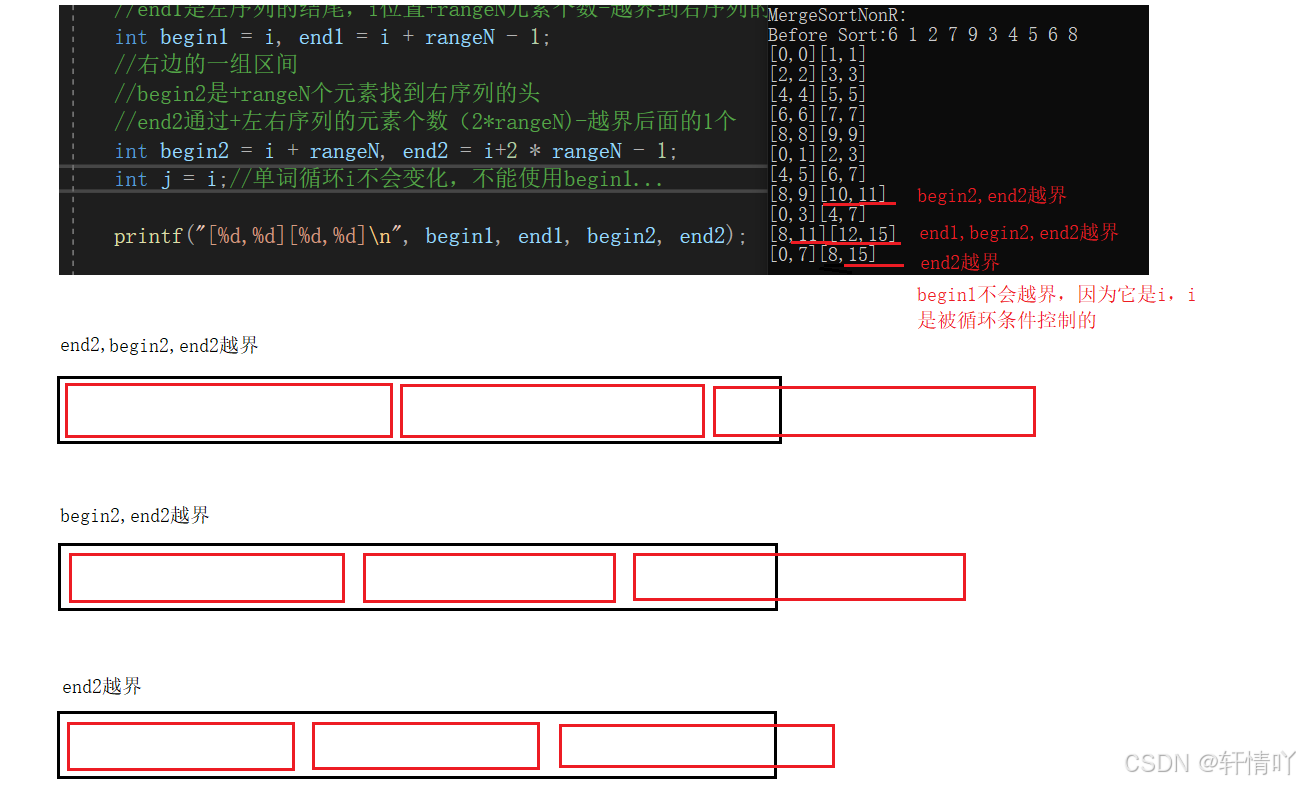
我们在代码中将下标指向打印出来,可以发现成除了begin1,其他的都会越界,begin1能够保证不越界是因为它是受循环条件控制的,并且只要前者越界了,后面的也都跟着越界了,如end1越界了,那么begin2和end2必定越界
基于上述的问题,我们会给出两种写法
//非递归版归并排序
//使用跳出循环的方式来避免越界--必须是归并一部分,拷贝一部分
void MergeSortNonR(int* arr, int n)
{
	//先开辟空间
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc error");
		exit(-1);
	}


	int rangeN = 1;//rangeN是左右子序列的间距,同时也是子序列的元素个数
	while (rangeN < n)//一般rangeN是n的一半就能完成排序,>=n就越界了
	{
		for (int i = 0; i < n; i += 2 * rangeN)//i每次变化代表到下一个分解的数组
		{
			//左边的一组区间
			//end1是左序列的结尾,i位置+rangeN元素个数-越界到右序列的1个
			int begin1 = i, end1 = i + rangeN - 1;
			//右边的一组区间
			//begin2是+rangeN个元素找到右序列的头
			//end2通过+左右序列的元素个数(2*rangeN)-越界后面的1个
			int begin2 = i + rangeN, end2 = i+2 * rangeN - 1;
			int j = i;//单词循环i不会变化,不能使用begin1...


			//先处理end1,end1越界,那么begin2和end2也会越界
			if (end1 >= n)
			{
				break;
			}
			else if (begin2 >= n)//begin2越界,end2也会越界
			{
				break;
			}
			else//end2越界
			{
				end2 = n - 1;//end2必须要进行修改,因为begin1和end1需要和begin2进行归并
			}


			//printf("[%d,%d][%d,%d]\n", begin1, end1, begin2, end2);


			//两个有序的序列,放到一起,只要有一个结束了,循环结束
			while (begin1 <= end1 && begin2 <= end2)
			{
				if (arr[begin1] <= arr[begin2])
				{
					tmp[j++] = arr[begin1++];
				}
				else
				{
					tmp[j++] = arr[begin2++];
				}
			}

			while (begin1 <= end1)//如果左序列还有剩余就继续拼接
			{
				tmp[j++] = arr[begin1++];
			}

			while (begin2 <= end2)
			{
				tmp[j++] = arr[begin2++];
			}

			//将排序好的元素拷贝回原数组
			//不能写2*rangeN,会有越界问题
			//也不能使用begin1和begin2,已经变化过了
			memcpy(arr + i, tmp + i, sizeof(int) * (end2 -i+1)); //必须这样写,不能全部归并完再拷贝
		}
		rangeN *= 2;//模仿递归的返回过程
	}
	free(tmp);
}

//非递归版归并排序
//遇到越界就进行修改标识的位置--即可以整体归并完拷贝也可以归并一部分拷贝一部分
void MergeSortNonR2(int* arr, int n)
{
	//先开辟空间
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc error");
		exit(-1);
	}


	int rangeN = 1;//rangeN是左右子序列的间距,同时也是子序列的元素个数
	while (rangeN < n)//一般rangeN是n的一半就能完成排序,>=n就越界了
	{
		for (int i = 0; i < n; i += 2 * rangeN)//i每次变化代表到下一个分解的数组
		{
			//左边的一组区间
			//end1是左序列的结尾,i位置+rangeN元素个数-越界到右序列的1个
			int begin1 = i, end1 = i + rangeN - 1;
			//右边的一组区间
			//begin2是+rangeN个元素找到右序列的头
			//end2通过+左右序列的元素个数(2*rangeN)-越界后面的1个
			int begin2 = i + rangeN, end2 = i + 2 * rangeN - 1;
			int j = i;//单词循环i不会变化,不能使用begin1...


			if (end1 >= n)
			{
				end1 = n - 1;//和begin1一样,后序归并还需要用到
				//begin2和end2需要表示为不存在的区间
				begin2 = n;
				end2 = n - 1;
			}
			else if (begin2 >= n)
			{
				begin2= n;
				end2 = n - 1;
			}
			else//end2不存在
			{
				end2 = n - 1;//和begin2一样,归并需要使用
			}

			//两个有序的序列,放到一起,只要有一个结束了,循环结束
			while (begin1 <= end1 && begin2 <= end2)
			{
				if (arr[begin1] <= arr[begin2])
				{
					tmp[j++] = arr[begin1++];
				}
				else
				{
					tmp[j++] = arr[begin2++];
				}
			}

			while (begin1 <= end1)//如果左序列还有剩余就继续拼接
			{
				tmp[j++] = arr[begin1++];
			}

			while (begin2 <= end2)
			{
				tmp[j++] = arr[begin2++];
			}

			//方式一:
			//将排序好的元素拷贝回原数组
			//不能写2*rangeN,会有越界问题
			//也不能使用begin1和begin2,已经变化过了
			//memcpy(arr + i, tmp + i, sizeof(int) * (end2 - i + 1));
		}

		//方式二:
		//整体归并完成进行整体拷贝
		memcpy(arr, tmp, sizeof(int) *n);
		rangeN *= 2;//模仿递归的返回过程
	}
	free(tmp);
}
一共给出了两种写法,第一种是直接跳出循环,第二种处理越界的方式是通过修改标识的值。前者对于每次归并好的一部分数据必须拷贝回去一部分,而后者既可以归并一部分拷贝一部分又可以整体归并整体拷贝。这主要是因为第一种方式如果是整体拷贝的话,由于直接跳出循环,越界的左右序列没有经历归并的循环代码,所以没有将数据放入tmp中,拷贝回去的内容后半部分是随机值,如下图
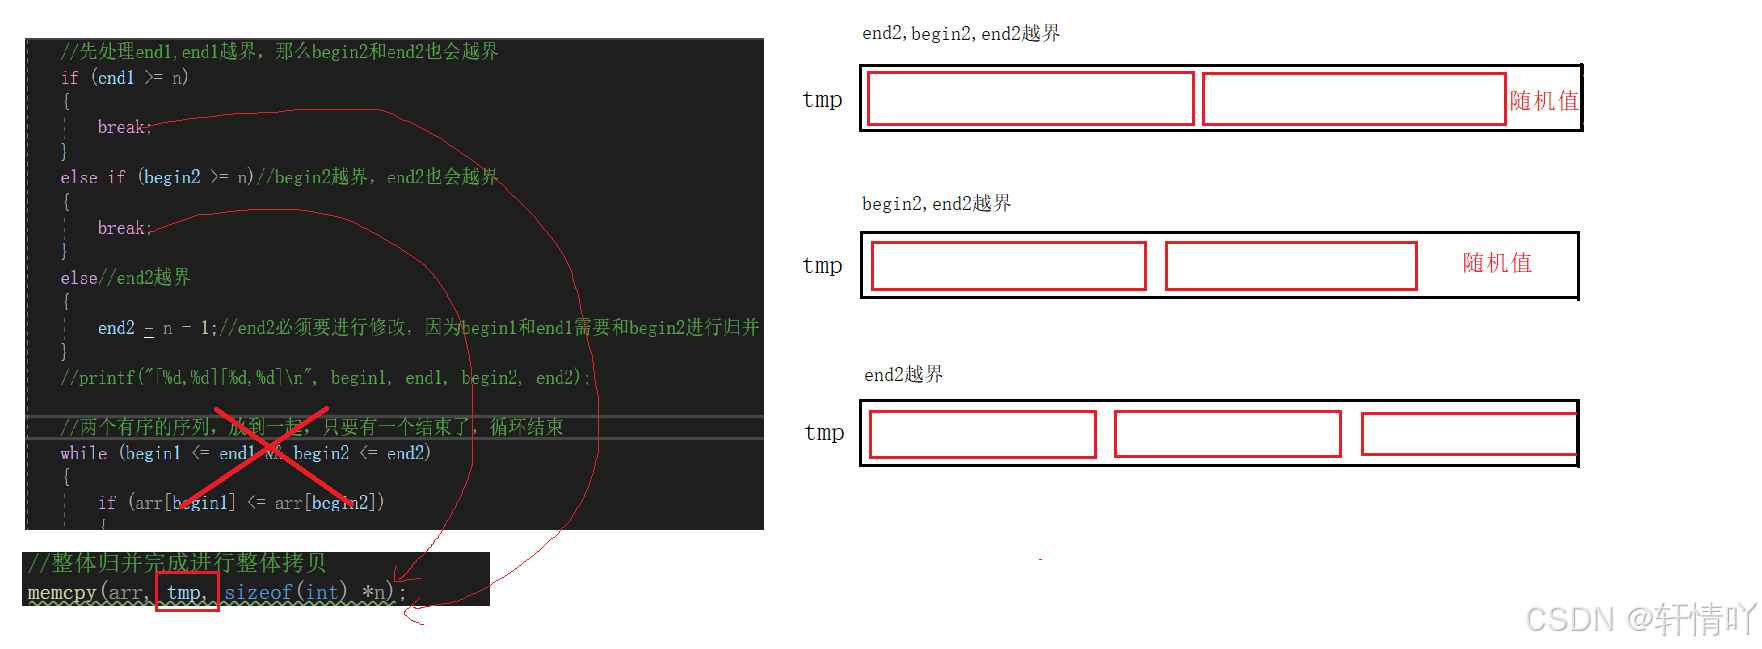
而我们的第二种方法会修改标识的值,并不会跳过归并的循环,也就每次都会将值拷贝到tmp中,这个时候无论是归并一部分拷贝一部分或者整体归并整体拷贝都不会有问题
8.计数排序
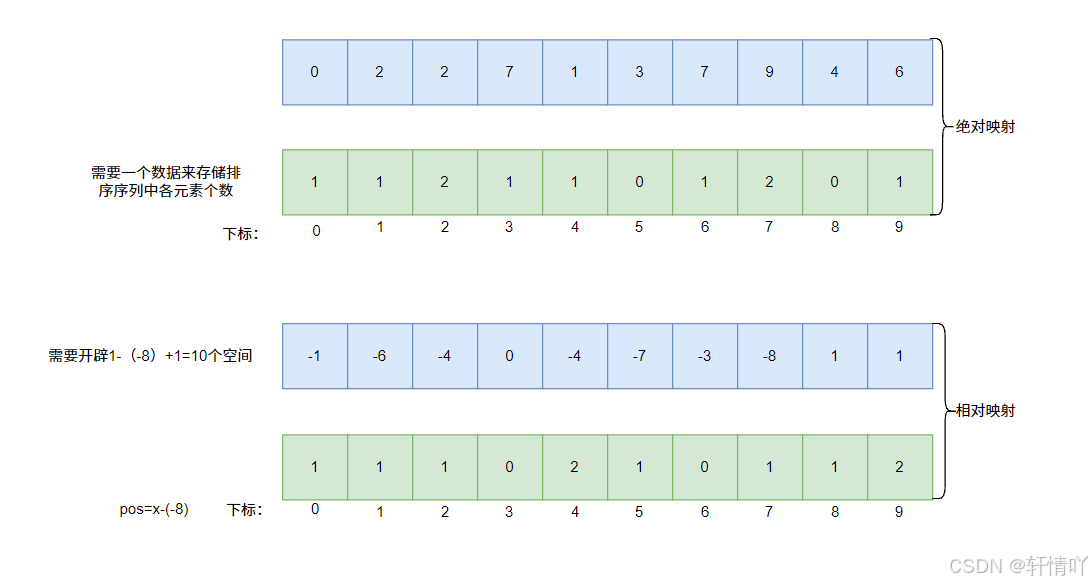
计数排序计数排序,简单来讲就是依靠技术来排序,而不是像前面的排序使用比较来排序,首先我们先来谈谈一个简单的例子
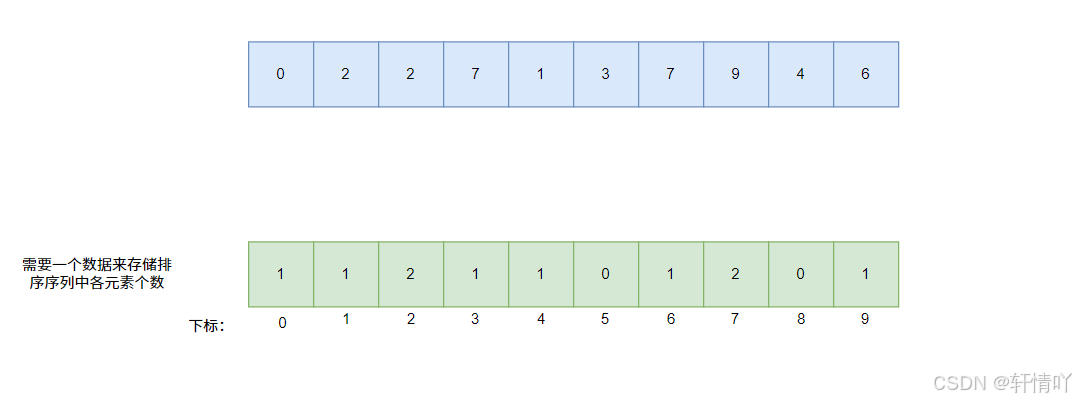
具体的计数就如同上图所示,我们将要排序的序列中各个元素的个数记录下来放入到一个数组中,我们的下标正好对应元素的值,对于没有的元素,在数组中就设为0,最后将数据按照映射的元素个数依次拷贝到序列中
但是还有其他的情况
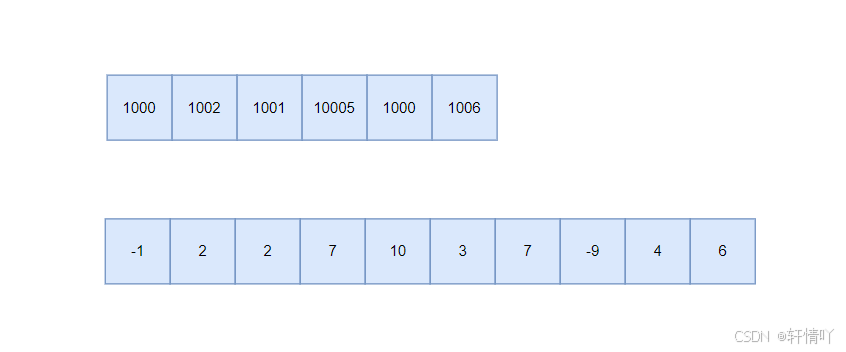
像这种情况该怎么办呢?我们应该给数组开多大的空间呢?像第一个总不能开1007个空间吧,这样就把前面的1001个空间给浪费了,像第二个还有负数。
因此为了节省空间,我们可以通过元素的最大值-元素最小值+1来计算出需要的空间(+1是因为两个元素相减是闭区间,例如0~9的元素需要10个空间,因此9-0后还需要+1)
但是还有一个问题,那就是如何每个值怎么找到对应映射的位置呢?我们可以通过x-min即可,例如我们前面一开始讲的那个例子,0-9个数,空间大小为10个,设x是5,min是0,即5-0得出位置
//计数排序
void CountSort(int* arr, int n)
{
	//选出最大值和最小值
	int max =arr[0], min =arr[0];
	for (int i = 0; i < n; i++)
	{
		if (max < arr[i])
		{
			max = arr[i];
		}
		if (min > arr[i])
		{
			min = arr[i];
		}
	}

	//计算需要开辟的空间
	int range = max - min + 1;
	//开辟一个数组
	//使用calloc会对空间进行初始化为0
	int* CountA = (int*)calloc(range, sizeof(int));

	//统计次数
	for (int i = 0; i < n; i++)
	{
		//arr[i]-min为对应位置
		CountA[arr[i] - min]++;
	}

	//排序
	int j = 0;
	for (int i = 0; i < range; i++)
	{
		//CountA[i]是元素存在的个数,如果不存在就不会循环
		while (CountA[i]--)
		{
			//拷贝到数组时需要将元素复原到原来,因此需要+min,因为存的时候是-min的
			arr[j++] = i+ min;
		}
	}

	free(CountA);
}
计数排序的特性总结:
①计数排序在数据范围集中时,效率很高,只能用于整型。
②时间复杂度:O(MAX(N,Range))或O(N+Range)
③空间复杂度:O(Range)
④稳定性:稳定
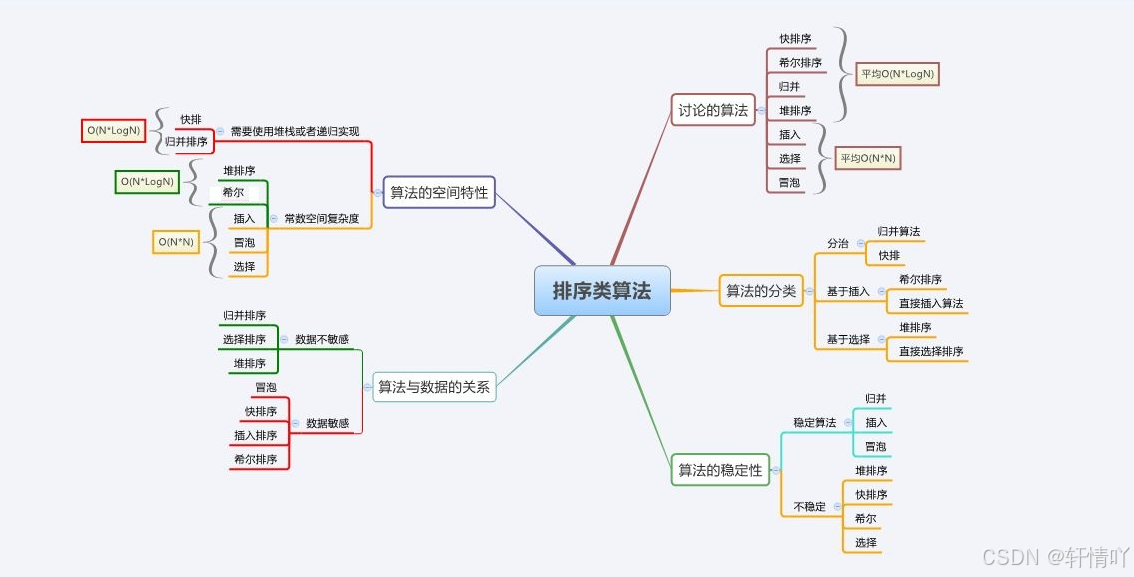
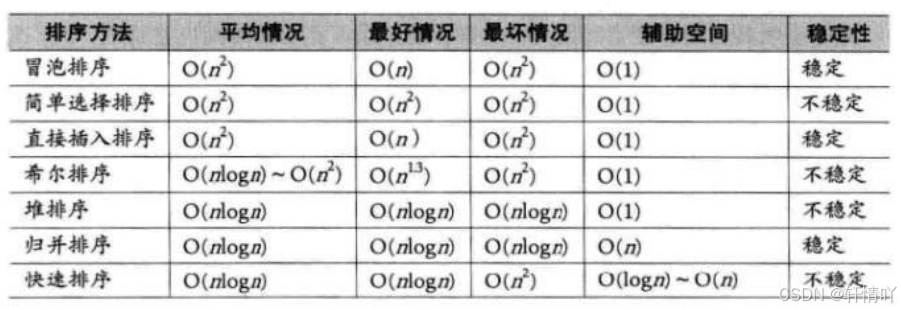
9.排序总结
10.完整代码
//Sort.h
#pragma once
#include <stdio.h>
#include <stdbool.h>
#include "stack.h"
#include <stdlib.h>
#include <string.h>
#include <errno.h>
#include <time.h>
void InsertSort(int* arr, int n);//直接插入排序
void ShellSort(int* arr, int n);//希尔排序
void SelectSort(int* arr, int n);//选择排序
void HeapSort(int* arr, int n);//堆排序
void BubbleSort(int* arr, int n);//冒泡排序
void QuickSort(int* arr, int begin, int end);//快速排序
void QuickSortNonR(int* arr, int begin,int end);//快速排序的非递归写法
void MergeSort(int* arr, int n);//归并排序,递归版本
void MergeSortNonR(int* arr, int n);//归并排序,非递归版本,处理越界方法1
void MergeSortNonR2(int* arr, int n);//归并排序,非递归版本,处理越界方法2
void CountSort(int* arr, int n);//计数排序
//stack.h
#pragma once
#define _CRT_SECURE_NO_WARNINGS 1
#include <stdio.h>
#include <assert.h>
#include <stdlib.h>
#include <stdbool.h>
typedef int Type;//把int重命名为Type,因此以后如果需要新的类型数据,直接改int就可以了
typedef struct Stack
{
	Type* arr;//动态开辟数组
	int capacity;//容量
	int top;//栈顶的下一个位置的下标
}ST;
void StackInit(ST* p);//初始化栈
void StackDestory(ST* p);//销毁栈
void StackPush(ST* p, Type x);//压栈
void StackPop(ST* p);//出栈
Type StackTop(ST* p);//找出栈顶的值
bool StackEmpty(ST* p);//判断栈是否为空
int StackSize(ST* p);//栈里有多少数据
//stack.c
#define _CRT_SECURE_NO_WARNINGS 1
#include "stack.h"
void StackInit(ST* p)//初始化栈
{
	assert(p);//断言一下,防止传过来的是NULL
	p->arr = malloc(sizeof(Type) * 4);//给arr开辟空间
	if (p->arr == NULL)//判断一下是否开辟空间失败
	{
		perror("malloc fail");
		exit(-1);
	}
	p->top = 0;//top是栈顶的下一个位置的下标
	p->capacity = 4;
}


void StackDestory(ST* p)//销毁栈
{
	assert(p);
	free(p->arr);//释放给arr开辟的空间
	p->capacity = 0;//容量也变为0
	p->top = 0;
}


void StackPush(ST* p, Type x)//压栈
{
	assert(p);
	if (p->top == p->capacity)//判断空间是否满了,可以看出top正好是数据的数量
	{
		Type* tmp = realloc(p->arr, p->capacity * 2 * sizeof(Type));//空间不够开辟原来空间的两倍
		if (tmp != NULL)
		{
			p->arr = tmp;
			p->capacity *= 2;
		}
		else
		{
			perror("realloc fails");
			exit(-1);
		}
	}
	p->arr[p->top] = x;
	p->top++;//使top指向栈顶的下一个位置的下标
}


void StackPop(ST* p)//出栈
{
	assert(p);
	assert(p->top > 0);//如果已经没有数据了就不能再删了
	p->top--;//栈是通过top来判断元素数量的
}


Type StackTop(ST* p)//找出栈顶的值
{
	assert(p);
	assert(p->top > 0);//没有数据了就不会有栈顶的值
	return p->arr[p->top - 1];//top是栈顶的下一个值的下标,那么top-1就是栈顶的下标
}


bool StackEmpty(ST* p)//判断栈是否为空
{
	assert(p);
	return p->top == 0;//前面也说了top也正好是数据的数量,当top是0时,那么栈就为空
}


int StackSize(ST* p)//栈里有多少数据
{
	assert(p);
	return p->top;
}
//Sort.c
#include "Sort.h"
//统一升序

void PrintArray(int* arr, int n)
{
	for (int i = 0; i < n; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void InsertSort(int* arr, int n)//直接插入排序
{
	//从1号下标开始调整,默认0号下标一个元素有序的
	for (int i = 0; i < n - 1; i++)//end==i,i==n-1时,end+1就会越界变成n
	{
		//单趟插入排序
		int end = i;//进行调整的开始位置
		int x = arr[end + 1];//插入值进行保存,防止覆盖
		while (end >= 0)
		{
			if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
			{
				arr[end + 1] = arr[end];
				end--;
			}
			else
			{
				break;//找到合适的插入位置,跳出
			}
		}
		//在找到的位置放入值
		//两种极端情况:不需要移动;全部元素进行移动
		//不需要移动:end+1就是原来的插入值位置
		//全部元素进行移动:end变成-1,-1+1->0,在0号位置插入
		//正常情况:经过上一趟的排序end--后,插入位置已经是end+1了
		arr[end + 1] = x;
	}
}

void ShellSortV1(int* arr, int n)//希尔排序
{
	//希尔排序简单来说就是进行多次的直接插入排序,优化直接插入排序
	//一组元素的预排序
	int gap = 3;

	for (int i = 0; i < n - gap; i += gap)//以gap为间距,下一个需要调整的值就是i+=gap
	{
		int end = i;
		int x = arr[end + gap];//调整的值和插入值相差gap
		//完成一个元素的插入
		while (end >= 0)
		{
			if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
			{
				arr[end + gap] = arr[end];//直接插入排序是end+1,就是gap等于1;这边gap为3
				end -= gap;//下一个end位置间距为gap
			}
			else
			{
				break;//找到合适的插入位置了
			}
		}

		arr[end + gap] = x;//放入元素
	}
}

//每组元素都进行预排序
void ShellSortV2(int* arr, int n)//希尔排序
{
	//简单来说就是进行多次的直接插入排序,优化直接插入排序
	int gap = 3;
	//gap组元素的预排序;每组n/gap个元素
	for (int j = 0; j < 3; j++)
	{
		for (int i = j; i < n - gap; i += gap)//以gap为间距,下一个需要调整的值就是i+=gap
		{
			int end = i;
			int x = arr[end + gap];//调整的值和插入值相差gap
			//完成一个元素的插入
			while (end >= 0)
			{
				if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
				{
					arr[end + gap] = arr[end];//直接插入排序是end+1,就是gap等于1;这边gap为3
					end -= gap;//下一个end位置间距为gap
				}
				else
				{
					break;//找到合适的插入位置了
				}
			}

			arr[end + gap] = x;//放入元素
		}
	}
}

//优化每组元素的预排序
void ShellSortV3(int* arr, int n)//希尔排序
{
	//简单来说就是进行多次的直接插入排序,优化直接插入排序
	int gap = 3;
	//gap组元素的预排序;每组n/gap个元素

	for (int i = 0; i < n - gap; i++)//和V2一样,只不过每循环一次是对不同的组的元素预排序
	{
		int end = i;
		int x = arr[end + gap];//调整的值和插入值相差gap
		//完成一个元素的插入
		while (end >= 0)
		{
			if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
			{
				arr[end + gap] = arr[end];//直接插入排序是end+1,就是gap等于1;这边gap为3
				end -= gap;//下一个end位置间距为gap
			}
			else
			{
				break;//找到合适的插入位置了
			}
		}

		arr[end + gap] = x;//放入元素
	}
}

//最终版
void ShellSort(int* arr, int n)//希尔排序
{
	//简单来说就是进行多次的直接插入排序,优化直接插入排序
	int gap = n;
	while (gap > 1)//gap==0就没意义了,原地赋值x罢了
	{
		//gap /= 2;
		gap = gap / 3 + 1;// /3必须要+1,保证最后一次gap为1

		//gap组元素的预排序;每组n/gap个元素
		for (int i = 0; i < n - gap; i++)//和V2一样,只不过每循环一次是对不同的组的元素预排序
		{
			int end = i;
			int x = arr[end + gap];//调整的值和插入值相差gap
			//完成一个元素的插入
			while (end >= 0)
			{
				if (arr[end] > x)//插入值小于调整位置的值就需要向后移动
				{
					arr[end + gap] = arr[end];//直接插入排序是end+1,就是gap等于1;这边gap为3
					end -= gap;//下一个end位置间距为gap
				}
				else
				{
					break;//找到合适的插入位置了
				}
			}

			arr[end + gap] = x;//放入元素
		}
		//PrintArray(arr, n);
	}
}


void Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}


void SelectSort(int* arr, int n)//选择排序
{
	//找出最小值和最大值,和起始位置和结束位置交换
	//初始版可以只找最小值或最大值,这个是提高效率

	int begin = 0;
	int end = n - 1;
	while (begin < end)//当两者相互碰头或者错过时就排序完成了
	{
		int maxi = begin;
		int	mini = begin;
		//进行一次选择排序
		for (int i = begin; i <= end; i++)
		{
			//选最大值
			if (arr[maxi] < arr[i])
			{
				maxi = i;
			}
			//选最小值
			if (arr[mini] > arr[i])
			{
				mini = i;
			}
		}

		//将最小值和起始值交换
		Swap(&arr[mini], &arr[begin]);

		//!!!有概率最大值是起始值,这会导致最大值已经被交换到mini位置
		if (begin == maxi)
		{
			maxi = mini;//调整最大值的位置
		}

		//将最大值和结尾值交换
		Swap(&arr[maxi], &arr[end]);

		//头和尾已经有正确的值,进行调整,继续完成下次的排序
		begin++;
		end--;
	}
}


void AdjustDown(int* arr, int parent, int n)
{
	//假设较大的孩子是左孩子
	int child = parent * 2 + 1;
	while (child < n)//不能越界
	{
		//确保child+1存在,需要判断
		//右孩子=左孩子+1,右孩子大于左孩子就修改child
		if (child + 1 < n && arr[child + 1] > arr[child])
		{
			child++;
		}

		//孩子结点大于父结点就交换
		if (arr[child] > arr[parent])
		{
			Swap(&arr[child], &arr[parent]);
		}
		else
		{
			break;
		}

		//孩子结点变成父结点,再找孩子结点,继续向下调整
		parent = child;
		child = parent * 2 + 1;
	}

}

void HeapSort(int* arr, int n)//堆排序
{
	//建大堆->向下调整
	//从最后一个结点的父结点开始调整
	int parent = (n - 1) / 2;
	while (parent >= 0)
	{
		AdjustDown(arr, parent, n);
		parent--;
	}

	//头和尾端的值进行交换,顺序值依次在最后出现
	int end = n - 1;
	while (end > 0)//只剩下一个值就结束
	{
		Swap(&arr[end], &arr[0]);//交换
		AdjustDown(arr, 0, end);//进行向下调整
		end--;
	}

}

void BubbleSort(int* arr, int n)//冒泡排序
{
	//两两元素相比,前一个比后一个大就交换,直到将最大的元素交换到末尾位置

	//进行n-1次的冒泡排序
	//两两比较只需要n-1次;最后一次两个元素比较,只需要1次
	for (int j = 0; j < n - 1; j++)
	{
		bool flag = 1;
		//单次冒泡排序
		//i代表前一个,i最大只能是n-2;i+1代表后一个,最大只能是n-1;不会越界
		//以i代表前一个为基准,i就得<n-1
		for (int i = 0; i < n - 1 - j; i++)
			//一次冒泡排序后选出的最大值会在末尾,下一次就无需比较它了,因此需要不断的减小i,i就需要-j
		{
			//前一个比后一个大就交换
			if (arr[i] > arr[i + 1])
			{
				Swap(&arr[i], &arr[i + 1]);
				flag = 0;
			}
		}

		//优化冒泡排序,当完成单趟冒泡排序后,如果数据之间没有交换过,说明整体已经有序
		if (flag)
		{
			break;
		}
	}
}


//三数取中
int GetMidIndex(int* arr, int begin, int end)
{
	//找到中间位置
	//int mid = (begin + end) / 2;

	//用于三路划分-随机数取中--对于大量区间选key可能选到比较小(大),效率下降,这里使用随机选key来优化,leetcode必须要
	int mid = begin+rand() % (end - begin + 1);

	if (arr[begin] > arr[mid])
	{
		if (arr[mid] > arr[end])
		{
			return mid;
		}
		else if (arr[begin] < arr[end])
		{
			return begin;
		}
		else//arr[begin]>arr[end]
		{
			return end;
		}
	}
	else//arr[begin]<=arr[mid]
	{
		if (arr[mid] < arr[end])
		{
			return mid;
		}
		else if (arr[begin] > arr[end])
		{
			return begin;
		}
		else//arr[begin]<arr[end]
		{
			return end;
		}
	}
}


//双指针法(前后指针法)
int PartSort3(int* arr, int begin, int end)
{
	//三数取中
	int mid = GetMidIndex(arr, begin, end);
	Swap(&arr[begin], &arr[mid]);

	//选prev和cur
	int prev = begin;
	int cur = begin + 1;
	//选keyi
	int keyi = begin;

	while (cur <=end)
	{
		//cur找比key小的
		//prev在判断时进行++,并且只在前置表达式成立时才会执行
		//判断主要是减少同一位置的交换
		if (arr[cur] < arr[keyi] && (++prev) != cur)
		{
			//交换prev位置和cur位置的值
			Swap(&arr[prev], &arr[cur]);
		}
		//cur不停地++直到越界
		cur++;
	}

	//交换keyi位置和prev位置的值,keyi来到了正确的位置
	//keyi左边都是小于它的,右边都是大于它的
	//prev指向的必定是小于key的
	Swap(&arr[keyi],&arr[prev]);

	keyi = prev;
	return keyi;
}

//挖坑法
int PartSort2(int* arr, int begin, int end)
{
	//三数取中
	int mid = GetMidIndex(arr, begin, end);
	Swap(&arr[begin], &arr[mid]);

	int left = begin;
	int right = end;

	//选key值
	int key = arr[left];
	//选取首个坑位
	int hole = left;

	while (left < right)
	{
		//先从右边找比key小的
		while (left < right && arr[right] >= key)
		{
			right--;
		}
		//将找到的值放入坑位
		arr[hole] = arr[right];
		//重新选坑
		hole = right;

		//再从左边找比key大的
		while (left < right && arr[left] <= key)
		{
			left++;
		}
		arr[hole] = arr[left];
		hole = left;
	}

	//在left和right相遇位置(坑位)放入key
	arr[hole] = key;

	return hole;
}

//hoare法
int PartSort1(int* arr, int begin, int end)
{
	//找到不是最大也不是最小的值,提高递归效率
	int mid = GetMidIndex(arr, begin, end);
	Swap(&arr[begin], &arr[mid]);


	int left = begin;
	int right = end;
	int keyi = left;//选定左边key的位置


	while (left < right)//等于时就要和key交换
	{
		//右边先走,找小
		//注意不能少了left<right,否则会越界
		//>加上=,否则会造成死循环
		while (left < right && arr[right] >= arr[keyi])
		{
			right--;
		}

		//左边后走,找大
		//这个一样需要left<right
		//=最好加上,保证足够的严谨
		while (left < right && arr[left] <= arr[keyi])
		{
			left++;
		}

		//交换各自找到的值
		Swap(&arr[left], &arr[right]);
	}

	//left==right
	//交换keyi位置的值和相遇位置的值
	Swap(&arr[keyi], &arr[left]);


	keyi = left;
	return keyi;
}


void QuickSort(int* arr, int begin, int end)//快速排序
{
	//begin<end时可以不断的分割左右区间,直到只剩下一个元素或者无元素
	if (begin >= end)
	{
		return;
	}

	//小区间用直接插入替代,减少递归调用次数
	if (end - begin+1 >15)
	{
		//arr+begin找到递归区间的起始位置
		InsertSort(arr + begin, end - begin + 1);
	}
	else
	{
		int keyi = PartSort3(arr, begin, end);
		//递归调用左区间和右区间
		QuickSort(arr, begin, keyi - 1);
		QuickSort(arr, keyi + 1, end);
	}
}

////快速排序-三路划分
//void QuickSort(int* arr, int begin, int end)
//{
//	if (begin >= end)
//	{
//		return;
//	}
//
//	//当数据少时,减少递归,使用直接插入排序
//	if (end - begin + 1 < 15)
//	{
//		InsertSort(arr + begin, end - begin + 1);
//	}
//	else
//	{
//		//三数取中
//		int mid=GetMidIndex(arr, begin,end);
//		Swap(&arr[begin], &arr[mid]);
//		//标识设置
//		int left = begin;
//		int cur = begin + 1;
//		int right = end;
//		int key = arr[begin];
//		//当cur>right时,一次快排结束
//		while (cur <= right)
//		{
//			//当arr[cur]<key时,交换arr[left]和arr[cur],left++,cur++
//			//当arr[cur] == key时,cur++
//			if (arr[cur] < key)
//			{
//				Swap(&arr[cur],&arr[left]);
//				left++;
//				cur++;
//			}
//			//当arr[cur] > key时,交换arr[right]和arr[cur], right--
//			else if (arr[cur] > key)
//			{
//				Swap(&arr[cur], &arr[right]);
//				right--;
//			}
//			//当arr[cur] == key时,cur++
//			else
//			{
//				cur++;
//			}
//		}
//		//[begin,left-1][left,right][right+1,end]
//		//左边都是小于key的
//		QuickSort(arr, begin, left - 1);
//		//右边都是大于key的
//		QuickSort(arr, right + 1, end);
//		//中间的是等于key的,已经到达正确的位置了
//	}
//
//}


//快速排序的非递归
void QuickSortNonR(int* arr, int begin,int end)
{
	//需要使用栈来辅助
	ST st;
	StackInit(&st);
	//首次先将begin和end入栈
	StackPush(&st, begin);
	StackPush(&st, end);
	while (!StackEmpty(&st))//直到栈为空,所有区间的排序完成
	{
		//由于栈的先进先出的特性,第一次拿到的是右标识
		int right=StackTop(&st);
		StackPop(&st);
		int left = StackTop(&st);
		StackPop(&st);


			//进行一次快排
			int keyi = PartSort1(arr, left, right);

			//分割左右区间放入栈中,模拟递归的行为
			//模拟递归行为的话就需要先放右区间
			//这样才能保证先左区间后右区间
			if (keyi + 1 < right)
			{
				StackPush(&st, keyi + 1);
				StackPush(&st, right);
			}
			if (left < keyi - 1)//元素有两个及以上时才放入栈中,同时防止越界情况
			{
				StackPush(&st, left);
				StackPush(&st, keyi - 1);
			}
	}


	StackDestory(&st);

}

void _MergeSort(int* arr, int* tmp, int begin, int end)
{
	if (begin >= end)
	{
		return;
	}

	//先进行分解
	int mid = (begin+end) / 2;

	//递归下去进行分解排序
	_MergeSort(arr, tmp, begin, mid);
	_MergeSort(arr, tmp, mid+1, end);

	//从整体的角度上理解,递归结束,左右两边都已经有序,就可以归并了
	int begin1 = begin, end1 = mid;
	int begin2 = mid + 1, end2 = end;

	int i = begin;

	//两个有序的序列,放到一起,只要有一个结束了,循环结束
	while (begin1 <= end1 && begin2 <= end2)
	{
		if (arr[begin1]<=arr[begin2])
		{
			tmp[i++] = arr[begin1++];
		}
		else
		{
			tmp[i++] = arr[begin2++];
		}
	}

	while (begin1 <= end1)//如果左序列还有剩余就继续拼接
	{
		tmp[i++] = arr[begin1++];
	}

	while (begin2 <= end2)
	{
		tmp[i++] = arr[begin2++];
	}

	//将排序好的元素拷贝回原数组
	memcpy(arr+begin, tmp+begin, sizeof(int) * (end - begin + 1));
}

void MergeSort(int* arr, int n)//归并排序,非递归
{
	//开辟空间
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc error");
	}

	//需要递归,但是不需要每次都开辟空间,因此需要另一个函数
	_MergeSort(arr,tmp,0,n-1);

	free(tmp);
	tmp = NULL;
}


//非递归版归并排序
//使用跳出循环的方式来避免越界--必须是归并一部分,拷贝一部分
void MergeSortNonR(int* arr, int n)
{
	//先开辟空间
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc error");
		exit(-1);
	}


	int rangeN = 1;//rangeN是左右子序列的间距,同时也是子序列的元素个数
	while (rangeN < n)//一般rangeN是n的一半就能完成排序,>=n就越界了
	{
		for (int i = 0; i < n; i += 2 * rangeN)//i每次变化代表到下一个分解的数组
		{
			//左边的一组区间
			//end1是左序列的结尾,i位置+rangeN元素个数-越界到右序列的1个
			int begin1 = i, end1 = i + rangeN - 1;
			//右边的一组区间
			//begin2是+rangeN个元素找到右序列的头
			//end2通过+左右序列的元素个数(2*rangeN)-越界后面的1个
			int begin2 = i + rangeN, end2 = i+2 * rangeN - 1;
			int j = i;//单词循环i不会变化,不能使用begin1...


			//先处理end1,end1越界,那么begin2和end2也会越界
			if (end1 >= n)
			{
				break;
			}
			else if (begin2 >= n)//begin2越界,end2也会越界
			{
				break;
			}
			else//end2越界
			{
				end2 = n - 1;//end2必须要进行修改,因为begin1和end1需要和begin2进行归并
			}
			//printf("[%d,%d][%d,%d]\n", begin1, end1, begin2, end2);

			//两个有序的序列,放到一起,只要有一个结束了,循环结束
			while (begin1 <= end1 && begin2 <= end2)
			{
				if (arr[begin1] <= arr[begin2])
				{
					tmp[j++] = arr[begin1++];
				}
				else
				{
					tmp[j++] = arr[begin2++];
				}
			}

			while (begin1 <= end1)//如果左序列还有剩余就继续拼接
			{
				tmp[j++] = arr[begin1++];
			}

			while (begin2 <= end2)
			{
				tmp[j++] = arr[begin2++];
			}

			//将排序好的元素拷贝回原数组
			//不能写2*rangeN,会有越界问题
			//也不能使用begin1和begin2,已经变化过了
			memcpy(arr + i, tmp + i, sizeof(int) * (end2 -i+1)); //必须这样写,不能全部归并完再拷贝
		}
		rangeN *= 2;//模仿递归的返回过程
	}
	free(tmp);
}

//非递归版归并排序
//遇到越界就进行修改标识的位置--即可以整体归并完拷贝也可以归并一部分拷贝一部分
void MergeSortNonR2(int* arr, int n)
{
	//先开辟空间
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc error");
		exit(-1);
	}


	int rangeN = 1;//rangeN是左右子序列的间距,同时也是子序列的元素个数
	while (rangeN < n)//一般rangeN是n的一半就能完成排序,>=n就越界了
	{
		for (int i = 0; i < n; i += 2 * rangeN)//i每次变化代表到下一个分解的数组
		{
			//左边的一组区间
			//end1是左序列的结尾,i位置+rangeN元素个数-越界到右序列的1个
			int begin1 = i, end1 = i + rangeN - 1;
			//右边的一组区间
			//begin2是+rangeN个元素找到右序列的头
			//end2通过+左右序列的元素个数(2*rangeN)-越界后面的1个
			int begin2 = i + rangeN, end2 = i + 2 * rangeN - 1;
			int j = i;//单词循环i不会变化,不能使用begin1...


			if (end1 >= n)
			{
				end1 = n - 1;//和begin1一样,后序归并还需要用到
				//begin2和end2需要表示为不存在的区间
				begin2 = n;
				end2 = n - 1;
			}
			else if (begin2 >= n)
			{
				begin2= n;
				end2 = n - 1;
			}
			else//end2不存在
			{
				end2 = n - 1;//和begin2一样,归并需要使用
			}

			//两个有序的序列,放到一起,只要有一个结束了,循环结束
			while (begin1 <= end1 && begin2 <= end2)
			{
				if (arr[begin1] <= arr[begin2])
				{
					tmp[j++] = arr[begin1++];
				}
				else
				{
					tmp[j++] = arr[begin2++];
				}
			}

			while (begin1 <= end1)//如果左序列还有剩余就继续拼接
			{
				tmp[j++] = arr[begin1++];
			}

			while (begin2 <= end2)
			{
				tmp[j++] = arr[begin2++];
			}

			//方式一:
			//将排序好的元素拷贝回原数组
			//不能写2*rangeN,会有越界问题
			//也不能使用begin1和begin2,已经变化过了
			//memcpy(arr + i, tmp + i, sizeof(int) * (end2 - i + 1));
		}

		//方式二:
		//整体归并完成进行整体拷贝
		memcpy(arr, tmp, sizeof(int) *n);
		rangeN *= 2;//模仿递归的返回过程
	}
	free(tmp);
}

//计数排序
void CountSort(int* arr, int n)
{
	//选出最大值和最小值
	int max =arr[0], min =arr[0];
	for (int i = 0; i < n; i++)
	{
		if (max < arr[i])
		{
			max = arr[i];
		}
		if (min > arr[i])
		{
			min = arr[i];
		}
	}

	//计算需要开辟的空间
	int range = max - min + 1;
	//开辟一个数组
	//使用calloc会对空间进行初始化为0
	int* CountA = (int*)calloc(range, sizeof(int));

	//统计次数
	for (int i = 0; i < n; i++)
	{
		//arr[i]-min为对应位置
		CountA[arr[i] - min]++;
	}

	//排序
	int j = 0;
	for (int i = 0; i < range; i++)
	{
		//CountA[i]是元素存在的个数,如果不存在就不会循环
		while (CountA[i]--)
		{
			//拷贝到数组时需要将元素复原到原来,因此需要+min,因为存的时候是-min的
			arr[j++] = i+ min;
		}
	}

	free(CountA);
}
//main.c
#include "Sort.h"
#include <stdlib.h>
#include <time.h>
void TestInsertSort()
{
	int arr[10] = { 9,1,2,5,7,4,8,6,3,5 };
	int arrlen = sizeof(arr) / sizeof(int);
	printf("InsertSort:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	InsertSort(arr, arrlen);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestShellSort()
{
	int arr[10] = { 9,1,2,5,7,4,8,6,3,5 };
	int arrlen = sizeof(arr) / sizeof(int);
	printf("ShellSort:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	ShellSort(arr, arrlen);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestSelectSort()
{
	int arr[10] = { 9,1,2,5,7,4,8,6,3,5 };
	int arrlen = sizeof(arr) / sizeof(int);
	printf("SelectSort:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	SelectSort(arr, arrlen);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestHeapSort()
{
	int arr[10] = { 9,1,2,5,7,4,8,6,3,5 };
	int arrlen = sizeof(arr) / sizeof(int);
	printf("HeapSort:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	HeapSort(arr, arrlen);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestBubbleSort()
{
	int arr[10] = { 9,1,2,5,7,4,8,6,3,5 };
	int arrlen = sizeof(arr) / sizeof(int);
	printf("BubbleSort:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	BubbleSort(arr, arrlen);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestQuickSort()
{
	int arr[] = { 9,1,2,5,7,4,8,6,3,5,11,2,4,6,10,2,4};
	int arrlen = sizeof(arr) / sizeof(int);
	printf("QuickSort:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	QuickSort(arr, 0,arrlen-1);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestQuickSortNonR()
{
	int arr[10] = { 9,1,2,5,7,4,8,6,3,5 };
	int arrlen = sizeof(arr) / sizeof(int);
	printf("QuickSortNonR:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	QuickSortNonR(arr,0,arrlen-1);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestMergeSort()
{
	int arr[10] = { 9,1,2,5,7,4,8,6,3,5 };
	int arrlen = sizeof(arr) / sizeof(int);
	printf("MergeSort:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	MergeSort(arr, arrlen);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestMergeSortNonR()
{
	//int arr[] = { 7,6,8,9,3,4,1,0 };
	int arr[] = { 6, 1, 2, 7, 9, 3, 4, 5, 6, 8 };
	int arrlen = sizeof(arr) / sizeof(int);
	printf("MergeSortNonR:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	MergeSortNonR2(arr, arrlen);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestCountSort()
{
	//int arr[] = { 7,6,8,9,3,4,1,0 };
	//int arr[] = { 6, 1, 2, 7, 9, 3, 4, 5, 6, 8 };
	//int arr[] = { -1,-6,-4,0,-4,-7,-3,-8,1,1 };
	int arr[] = { 1,1,1,1,1 };
	int arrlen = sizeof(arr) / sizeof(int);
	printf("CountSort:\n");
	printf("Before Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	CountSort(arr, arrlen);
	printf(" After Sort:");
	for (int i = 0; i < arrlen; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

void TestSort()
{
	TestInsertSort();
	TestShellSort();
	TestSelectSort();
	TestHeapSort();
	TestBubbleSort();
	TestQuickSort();
	TestQuickSortNonR();
	TestMergeSort();
	TestMergeSortNonR();
	TestCountSort();
}


void TestEfficiency()
{
	int j = 0;
	srand(time(0));
	const int N = 100000000;//排序数据数量
	int* a1 = (int*)malloc(sizeof(int) * N);
	int* a2 = (int*)malloc(sizeof(int) * N);
	int* a3 = (int*)malloc(sizeof(int) * N);
	int* a4 = (int*)malloc(sizeof(int) * N);
	int* a5 = (int*)malloc(sizeof(int) * N);
	int* a6 = (int*)malloc(sizeof(int) * N);
	int* a7 = (int*)malloc(sizeof(int) * N);
	int* a8 = (int*)malloc(sizeof(int) * N);
	int* a9 = (int*)malloc(sizeof(int) * N);
	for (int i = 0; i < N; ++i)
	{
		/*int x = rand();
		if (x % 7 == 0 && x%3==0&&x%2==0)
		{
			a1[i] = x;
			j++;
		}
		else if (i == N - 1)
		{
			a1[i] = -1;
		}
		else
		{
			a1[i] = i;
		}*/

		//a1[i] = rand();
		//a1[i] = i;

		a1[i] = rand() + 1;//rand()产生的随机数有限(3w左右),通过+1来提高随机率
		a2[i] = a1[i];
		a3[i] = a1[i];
		a4[i] = a1[i];
		a5[i] = a1[i];
		a6[i] = a1[i];
		a7[i] = a1[i];
		a8[i] = a1[i];
		a9[i] = a1[i];
	}
	//printf("j=%d\n", j);

	/*int begin1 = clock();
	InsertSort(a1, N);
	int end1 = clock();*/

	/*int begin2 = clock();
	ShellSort(a2, N);
	int end2 = clock();*/

	/*int begin3 = clock();
	SelectSort(a3, N);
	int end3 = clock();*/

	/*int begin4 = clock();
	HeapSort(a4, N);
	int end4 = clock();*/

	/*int begin5 = clock();
	BubbleSort(a5, N);
	int end5 = clock();*/


	int begin6 = clock();
	QuickSort(a5, 0,N-1);
	int end6 = clock();

	//int begin7 = clock();
	//MergeSort(a6, N);
	//int end7= clock();


	/*int begin8 = clock();
	BucketSort(a8, N);
	int end8 = clock();

	int begin9 = clock();
	RadixSort(a9, N);
	int end9 = clock();*/

	/*printf("InsertSort:%d\n", end1 - begin1);*/
	//printf("ShellSort:%d\n", end2 - begin2);
	//printf("SelectSort:%d\n", end3 - begin3);
	//printf("HeapSort:%d\n", end4 - begin4);
	//printf("BubbleSort:%d\n", end5 - begin5);
	printf("QuickSort:%d\n", end6 - begin6);
	//printf("MergeSort:%d\n", end6 - begin6);
	//printf("bucketSort:%d\n", end8 - begin8);
	/*printf("RadixSort:%d\n", end9 - begin9);*/
	free(a1);
	free(a2);
	free(a3);
	free(a4);
	free(a5);
	free(a6);
	free(a7);
	free(a8);
	free(a9);

}

int main()
{
	TestSort();
	//TestEfficiency();
	return 0;
}
🌸🌸经典排序算法的知识大概就讲到这里啦,博主后续会继续更新更多数据结构的相关知识,干货满满,如果觉得博主写的还不错的话,希望各位小伙伴不要吝啬手中的三连哦!你们的支持是博主坚持创作的动力!💪💪

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献2条内容

所有评论(0)