PyMovieAdvisor-电影推荐系统
目录
前言
为了宇宙的爱与和平,人类的和谐稳定,本团队开发了PyMovieAdvisor-电影推荐系统~~~~~~~~~~~~(以上为作者臆想,不用理会嘿嘿)。
在当今信息爆炸的时代,海量的电影资源让观众在挑选时常常陷入选择困难。如何高效地从庞大的影视库中找到符合个人兴趣的作品,已成为一个值得探索的问题。PyMovieAdvisor-电影推荐系统应运而生,旨在通过智能算法为用户提供个性化的观影建议。
该系统结合了协同过滤、内容分析等先进技术,能够分析用户的观影历史和偏好,挖掘潜在的观影兴趣。无论是基于相似用户的推荐,还是基于电影内容的匹配,PyMovieAdvisor都致力于帮助用户发现更多值得欣赏的影片。
数据集介绍
本项目中主要用到了两个数据集
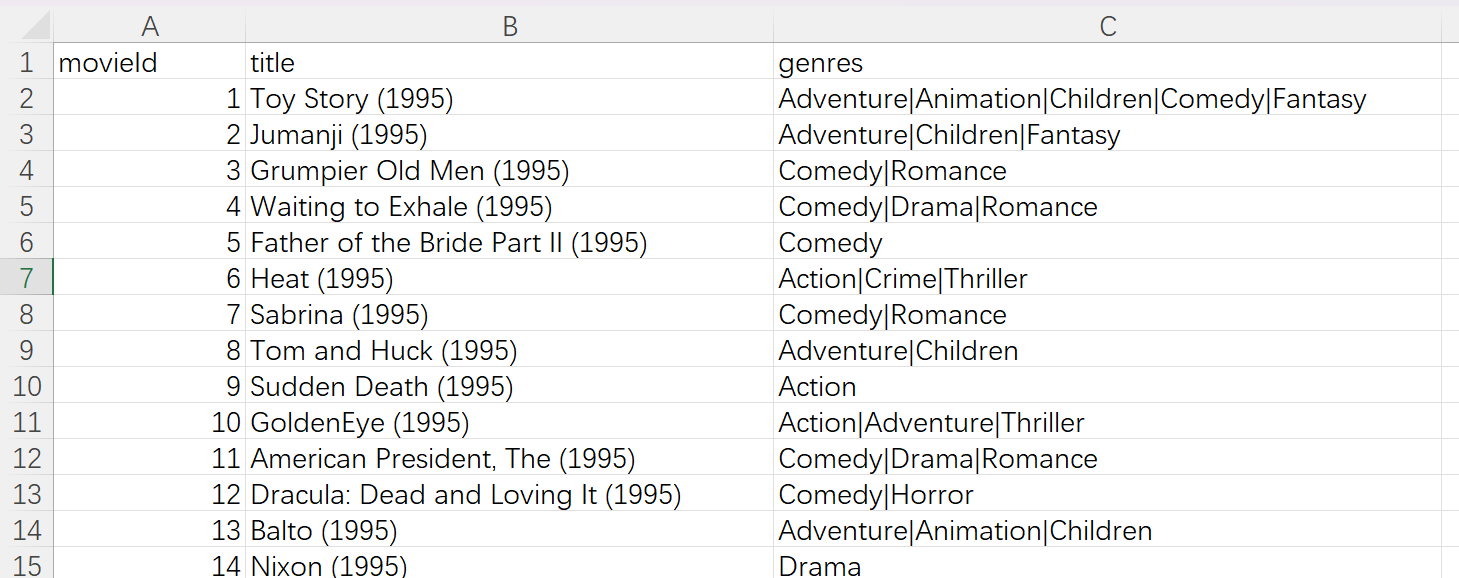
第一个数据集为movies.csv,这个数据集包含了 9742 条电影相关的数据,数据集包含 3 个字段,每个字段的含义如下:
- movieId:电影的唯一标识ID,数据类型为int64
- title:电影的名称,数据类型为object
- genres:电影的类型,不同类型之间用“|”分隔,数据类型为object
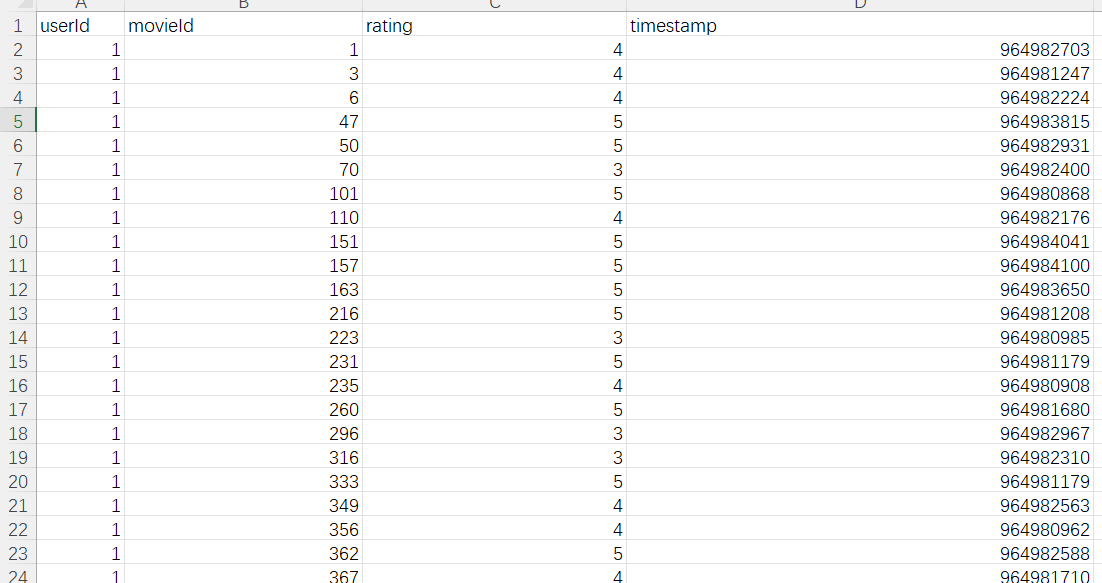
第二个数据集为ratings.csv,这个数据集包含了100836 行用户评分信息,包含 4 个字段,每个字段的含义如下:
- userId:用户的唯一标识ID,数据类型为int64
- movieId:电影的唯一标识ID,数据类型为int64
- rating:用户评分,数据类型为float64
- timestamp:用户评分时间戳,数据类型为int64
项目开发
基于用户协同过滤
import pandas as pd
import numpy as np
from scipy.sparse.linalg import svds

# 读取数据
ratings_df = pd.read_csv('ratings.csv')
movies_df = pd.read_csv('movies.csv')

# 合并数据集,将电影信息与评分信息关联
ratings_df = pd.merge(ratings_df, movies_df, on='movieId')

# 创建用户-电影评分矩阵,行为用户,列为电影,值为评分
user_ratings = ratings_df.pivot_table(index='userId', columns='title', values='rating')

# 处理缺失值,将未评分的电影用0填充
user_ratings = user_ratings.fillna(0)

# 计算每个用户的平均评分
mean_ratings = np.mean(user_ratings, axis=1).values

# 中心化评分矩阵:减去用户的平均评分,消除用户评分习惯差异
centered_ratings = user_ratings.sub(mean_ratings, axis=0).values

# 使用SVD进行降维,提取50个潜在特征
U, sigma, Vt = svds(centered_ratings, k=50)

# 将奇异值转换为对角矩阵
sigma_diag = np.diag(sigma)

# 重构评分矩阵,得到预测评分
predicted_ratings = np.dot(np.dot(U, sigma_diag), Vt) + mean_ratings.reshape((-1, 1))

# 将预测评分转换为DataFrame格式
predicted_ratings_df = pd.DataFrame(predicted_ratings, columns=user_ratings.columns, index=user_ratings.index)

def recommend_movies(user_id, num_recs=10):
    """
    为指定用户推荐电影

    参数:
    user_id: 用户ID
    num_recs: 推荐电影数量

    返回:
    推荐的电影标题列表
    """
    # 获取用户对所有电影的预测评分并排序
    sorted_ratings = predicted_ratings_df.loc[user_id].sort_values(ascending=False)
    # 获取评分最高的前N部电影
    top_movie_titles = sorted_ratings.index[:num_recs]
    return top_movie_titles

# 为用户1推荐10部电影并打印
rec1=recommend_movies(1, num_recs=10)
for title in rec1:
  print(title)
代码详解
-
数据准备:读取评分数据和电影数据,并将它们合并为一个完整的数据集。
-
构建用户 - 电影评分矩阵:使用 pivot_table 创建一个二维矩阵,其中行代表用户,列代表电影,值代表用户对电影的评分。缺失值(用户未评分的电影)用 0 填充。
-
数据预处理:
-
计算每个用户的平均评分
-
对评分矩阵进行中心化处理,即每个用户的评分减去该用户的平均评分
-
中心化处理可以消除不同用户的评分习惯差异(有些用户倾向于给高分,有些用户倾向于给低分)
-
-
SVD 降维:
-
使用奇异值分解 (SVD) 将高维的评分矩阵分解为三个矩阵:U (用户 - 特征矩阵)、sigma (奇异值矩阵) 和 Vt (特征 - 电影矩阵)
-
k=50 表示提取 50 个潜在特征,这是一个降维操作,可以捕捉数据中的主要模式
-
-
重构评分矩阵:
-
将分解后的矩阵重新组合,得到预测的评分矩阵
-
加上之前减去的用户平均评分,恢复原始评分尺度
-
-
推荐生成:
-
对特定用户,按照预测评分从高到低排序
-
选取评分最高的 N 部电影作为推荐结果
-
基于内容推荐
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity

# 读取电影数据
movies_df = pd.read_csv('movies.csv')

# 初始化TF-IDF向量化器,去除英文停用词
tfidf_vectorizer = TfidfVectorizer(stop_words='english')

# 将电影类型文本转换为TF-IDF特征矩阵
tfidf_matrix = tfidf_vectorizer.fit_transform(movies_df['genres'])

# 计算电影之间的余弦相似度
cosine_sim = cosine_similarity(tfidf_matrix)

def get_similar_movie_titles(movie_title, num_recs=10):
    """
    获取与指定电影相似的其他电影

    参数:
    movie_title: 参考电影的标题
    num_recs: 推荐电影数量

    返回:
    相似电影的标题列表
    """
    # 获取参考电影在DataFrame中的索引
    movie_index = movies_df.index[movies_df['title'] == movie_title][0]

    # 获取该电影与所有其他电影的相似度得分
    sim_scores = list(enumerate(cosine_sim[movie_index]))

    # 按相似度得分降序排序
    sim_scores = sorted(sim_scores, key=lambda x: x[1], reverse=True)

    # 获取相似度最高的前N部电影的标题
    top_movie_titles = [movies_df.iloc[i[0]]['title'] for i in sim_scores[1:num_recs+1]]

    return top_movie_titles

# 以《夺宝奇兵3》为例,获取相似电影并打印
movie_title = 'Indiana Jones and the Last Crusade (1989)'
rec_movie_titles = get_similar_movie_titles(movie_title)
for recs in rec_movie_titles:
  print(recs)
代码详解
-
数据准备:读取包含电影信息的 CSV 文件,特别关注电影的类型 (genres) 字段。
-
特征提取:
-
使用 TF-IDF 向量化器将电影类型文本转换为数值特征向量
-
TF-IDF(词频 - 逆文档频率)是一种常用的文本特征表示方法,它能够衡量一个词在文档中的重要性
-
停用词过滤可以去除如 "the"、"and" 等无实际意义的词汇
-
-
相似度计算:
-
使用余弦相似度计算电影之间的相似性
-
余弦相似度衡量两个向量之间的夹角余弦值,值越接近 1 表示越相似
-
-
推荐生成:
-
找到用户喜欢的参考电影在数据集中的索引
-
获取该电影与所有其他电影的相似度得分
-
按照相似度得分排序,选择得分最高的 N 部电影作为推荐结果
-
两种推荐算法的对比
-
用户协同过滤:
-
基于用户的历史行为和偏好
-
可以发现用户可能喜欢但尚未发现的新类型电影
-
需要足够的用户评分数据才能准确推荐
-
对新用户或评分数据稀少的用户效果较差
-
-
基于内容的推荐:
-
基于电影的内在特征
-
推荐结果通常比较保守,倾向于推荐与用户已喜欢电影相似的内容
-
不需要用户评分数据,对新用户友好
-
难以发现用户可能喜欢的跨类型电影
-
PyMovieAdvisor(完整版)
数据探索与统计分析
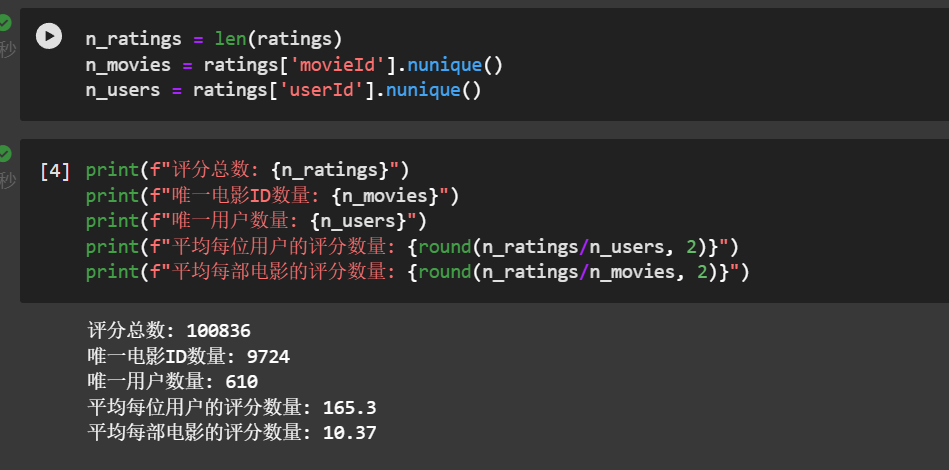
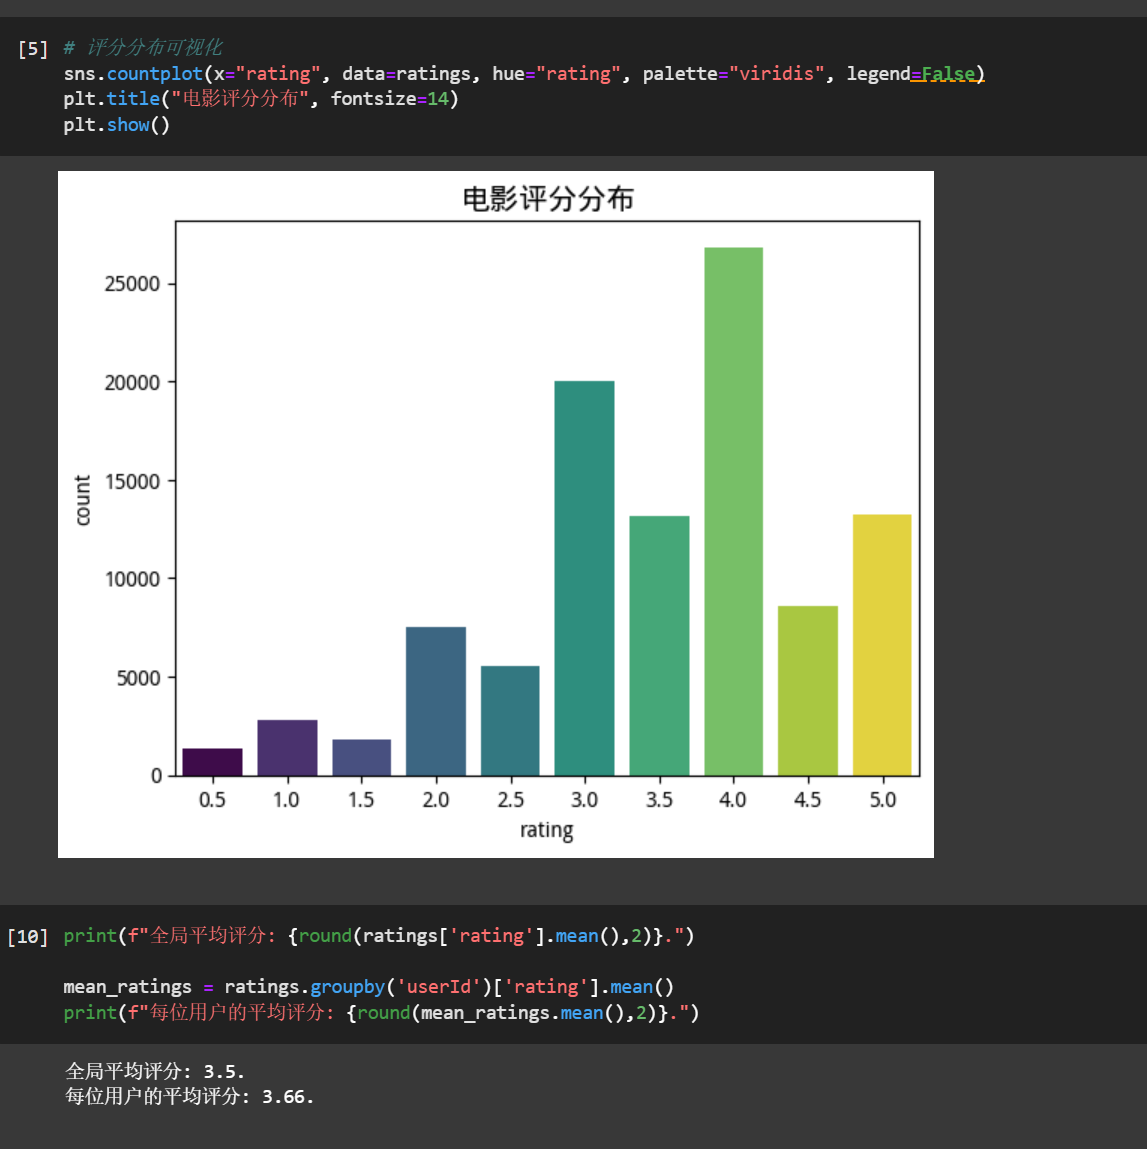
在这里我们使用柱状图展示各评分的分布频率,发现用户评分集中在较高区间(如 4.0 和 3.0)。接下来,我们进行分组聚合,计算出全局平均评分来观察整体的评分趋势,再计算了每位用户平均评分的均值评估了用户评分的倾向。
电影评分优化:贝叶斯平均
直接取平均评分我们会导致冷门电影的评分波动变大,而热门电影会稳定,所以我们采取了贝叶斯平均原理,平衡评分次数和评分值,使得冷门电影评分更加可靠。
movie_stats = ratings.groupby('movieId')[['rating']].agg(['count', 'mean'])
movie_stats.columns = movie_stats.columns.droplevel()

C = movie_stats['count'].mean()  # 全局平均评分次数
m = movie_stats['mean'].mean()  # 全局平均评分

def bayesian_avg(ratings):
    bayesian_avg = (C*m + ratings.sum()) / (C + ratings.count())
    return bayesian_avg

bayesian_avg_ratings = ratings.groupby('movieId')['rating'].agg(bayesian_avg).reset_index()
movie_stats = movie_stats.merge(bayesian_avg_ratings, on='movieId')
movie_stats.sort_values('bayesian_avg', ascending=True).head()
用户-电影评分矩阵构建
# 创建用户-电影评分矩阵
from scipy.sparse import csr_matrix

def create_X(df):
    M = df['userId'].nunique()
    N = df['movieId'].nunique()
    user_mapper = dict(zip(np.unique(df["userId"]), list(range(M))))
    movie_mapper = dict(zip(np.unique(df["movieId"]), list(range(N))))
    user_inv_mapper = dict(zip(list(range(M)), np.unique(df["userId"])))
    movie_inv_mapper = dict(zip(list(range(N)), np.unique(df["movieId"])))
    user_index = [user_mapper[i] for i in df['userId']]
    item_index = [movie_mapper[i] for i in df['movieId']]
    X = csr_matrix((df["rating"], (user_index,item_index)), shape=(M,N))
    return X, user_mapper, movie_mapper, user_inv_mapper, movie_inv_mapper

X, user_mapper, movie_mapper, user_inv_mapper, movie_inv_mapper = create_X(ratings)

# 分析矩阵稀疏性
n_total = X.shape[0]*X.shape[1]
n_ratings = X.nnz
sparsity = n_ratings/n_total
print(f"矩阵稀疏度: {round(sparsity*100,2)}%")
我们将用户/电影ID转换为连续整数索引,便于矩阵的操作,为了数据稀疏性挑战的问题,我们还进行了稀疏度计算,计算出非零评分占总可能评分的比例。
评分分布可视化
# 分析用户和电影评分分布
n_ratings_per_user = X.getnnz(axis=1)
print(f"最活跃用户评分的电影数量: {n_ratings_per_user.max()}")
print(f"最不活跃用户评分的电影数量: {n_ratings_per_user.min()}")

n_ratings_per_movie = X.getnnz(axis=0)
print(f"评分最多的电影获得的评分数量: {n_ratings_per_movie.max()}")
print(f"评分最少的电影获得的评分数量: {n_ratings_per_movie.min()}")

# 可视化评分分布
plt.figure(figsize=(16,4))
plt.subplot(1,2,1)
sns.kdeplot(n_ratings_per_user, shade=True)
plt.xlim(0)
plt.title("每位用户的评分数量分布", fontsize=14)
plt.xlabel("每位用户的评分数量")
plt.ylabel("密度")

plt.subplot(1,2,2)
sns.kdeplot(n_ratings_per_movie, shade=True)
plt.xlim(0)
plt.title("每部电影的评分数量分布", fontsize=14)
plt.xlabel("每部电影的评分数量")
plt.ylabel("密度")
plt.show()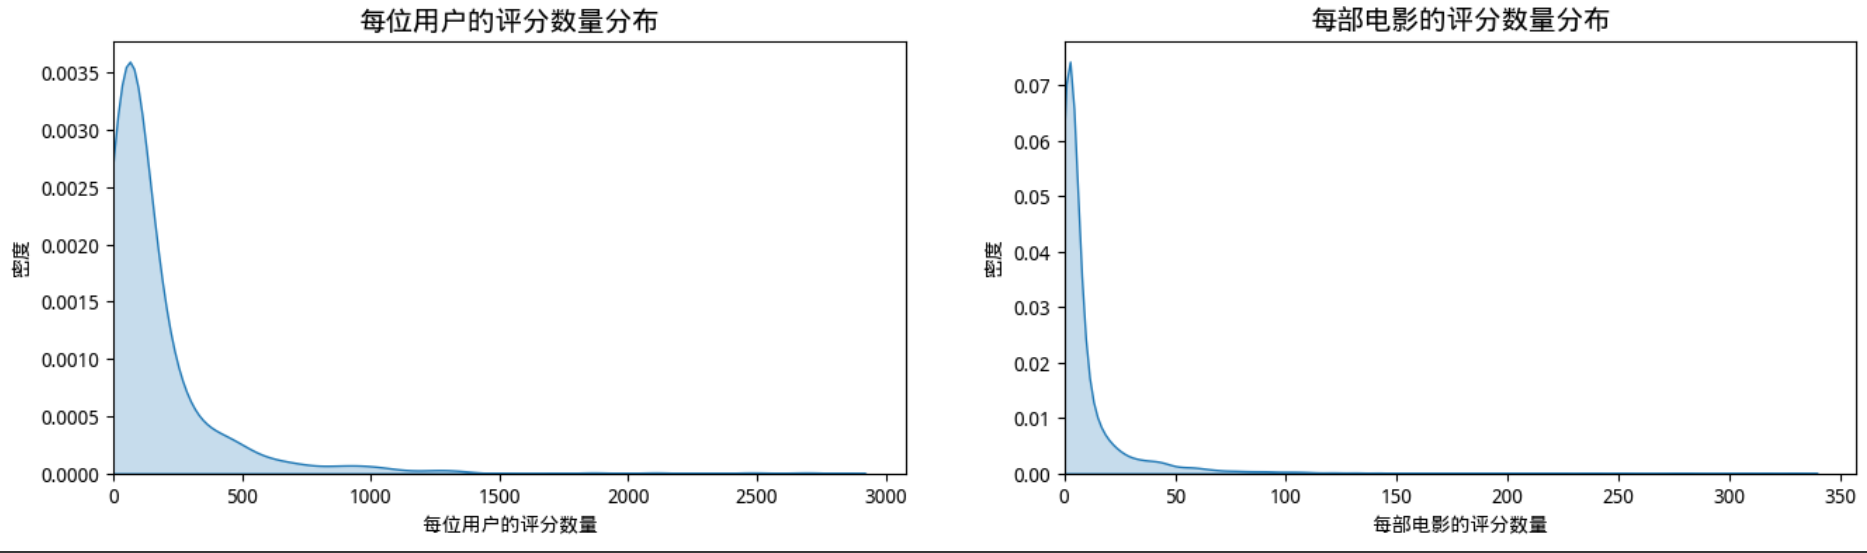
通过可视化分析,我们得出:
- 用户评分数量:呈长尾分布,少数活跃用户评分很多,而多数用户评分很少
- 电影评分数量:类似长尾分布,少数热门电影评分很多,而多数电影评分少
矩阵标准化
# 计算每部电影的平均评分
sum_ratings_per_movie = X.sum(axis=0)
mean_rating_per_movie = sum_ratings_per_movie/n_ratings_per_movie

# 创建平均评分矩阵并标准化
X_mean_movie = np.tile(mean_rating_per_movie, (X.shape[0],1))
X_norm = X - csr_matrix(X_mean_movie)
为了消除某些电影天然高分/低分的情况,使评分更具可比性,我们对每部电影,用用户评分减去该电影的全局平均分,得到了标准化评分矩阵,为后续做了一个预处理工作。
基于内容推荐
# 计算电影之间的余弦相似度
from sklearn.metrics.pairwise import cosine_similarity
cosine_sim = cosine_similarity(movie_genres, movie_genres)
print(f"电影类型余弦相似度矩阵维度: {cosine_sim.shape}")

# 电影查找函数
def movie_finder(title):
    return movies[movies['title'].str.contains(title)]['title'].tolist()

# 示例:查找包含"Toy Story"的电影
movie_finder('Toy Story')

# 基于内容的推荐
movie_idx = dict(zip(movies['title'], list(movies.index)))
title = movie_finder('Toy Story')[0]
n_recommendations = 10
idx = movie_idx[title]
sim_scores = list(enumerate(cosine_sim[idx]))
sim_scores = sorted(sim_scores, key=lambda x: x[1], reverse=True)
sim_scores = sim_scores[1:(n_recommendations+1)]
similar_movies = [i[0] for i in sim_scores]

print(f"根据喜欢 {title} 推荐的电影:")
movies['title'].iloc[similar_movies]
基于协同过滤推荐
# 定义查找相似电影的函数
from sklearn.neighbors import NearestNeighbors

def find_similar_movies(movie_id, X, movie_mapper, movie_inv_mapper, k, metric='cosine'):
    X = X.T
    neighbour_ids = []
    movie_ind = movie_mapper[movie_id]
    movie_vec = X[movie_ind]
    if isinstance(movie_vec, (np.ndarray)):
        movie_vec = movie_vec.reshape(1,-1)
    kNN = NearestNeighbors(n_neighbors=k+1, algorithm="brute", metric=metric)
    kNN.fit(X)
    neighbour = kNN.kneighbors(movie_vec, return_distance=False)
    for i in range(0,k):
        n = neighbour.item(i)
        neighbour_ids.append(movie_inv_mapper[n])
    neighbour_ids.pop(0)
    return neighbour_ids

# 查找与电影ID 1相似的电影
print("余弦相似度下相似的电影有:")
movie_titles = dict(zip(movies['movieId'], movies['title']))
movie_id = 1
similar_movies = find_similar_movies(movie_id, X_norm, movie_mapper, movie_inv_mapper, metric='cosine', k=10)
movie_title = movie_titles[movie_id]
for i in similar_movies:
    print(movie_titles[i])

print("")

print("欧几里得距离下相似的电影有:")
movie_id = 1
similar_movies = find_similar_movies(movie_id, X_norm, movie_mapper, movie_inv_mapper, metric='euclidean', k=10)
movie_title = movie_titles[movie_id]
for i in similar_movies:
    print(movie_titles[i])
矩阵分解与降维推荐
# 使用SVD进行降维
from sklearn.decomposition import TruncatedSVD

svd = TruncatedSVD(n_components=20, n_iter=10)
Z = svd.fit_transform(X.T)
为了缓解稀疏性问题,并且降低我们计算的复杂度,我们采用了矩阵分解,将高维评分矩阵分解为用户隐因子矩阵和电影隐因子矩阵,其中隐因子用于捕捉用户和电影的潜在特性。降维后再进行协同过滤也使得结果更具鲁棒性。
用户个性化推荐
# 重建用户-电影评分矩阵
new_X = svd.inverse_transform(Z).T

# 为特定用户生成推荐
userId = 99
user_preferences = ratings[(ratings['userId']==userId)&(ratings['rating']>=4)]
user_preferences = user_preferences.merge(movies[['movieId', 'title']])
user_preferences.sort_values('rating', ascending=False).head(10)

# 生成推荐结果
top_N = 10
movie_titles = dict(zip(movies['movieId'], movies['title']))
top_N_indices = new_X[user_mapper[userId]].argsort()[-top_N:][::-1]
print(f"为用户ID {userId} 推荐的前 {top_N} 部电影:")
for i in top_N_indices:
    movie_id = movie_inv_mapper[i]
    print(movie_titles[movie_id])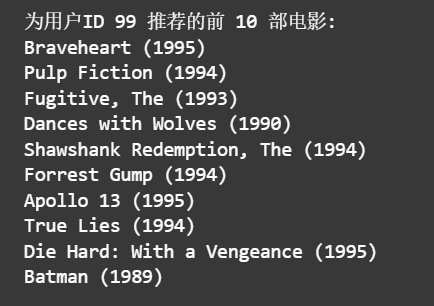
总结
最初接触推荐算法时,被“协同过滤”和“内容推荐”这两个概念吸引了。这听起来像是机器在模仿人的社交行为探索人的喜好。
后来深入学习并了解后,我发现它的潜力远超想象。利用推荐算法快速整合海量信息,输出的内容甚至可以贴近个性化的风格。我也对此更加有了兴趣。
学习推荐算法的过程,对我而言,既是技术的积累,也是思维的锻炼。从理论到代码,从单一方法到混合策略,每一步都让我更接近“让机器理解人”的目标。
未来的路还很长,或许有一天,人与机器的协作将不再是单向指令,而是双向启发;或许有一天,它会成为每个人身边无声的“灵感伙伴”,帮助突破认知边界,让创作变得更自由、更有温度。
谢谢~

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 40
 0
- 0


 已为社区贡献1条内容

所有评论(0)