数据结构1800题精练与详解

简介:数据结构是计算机科学的核心,涉及高效数据管理与操作。本资源为2020年考研数据结构考生提供的1800题练习集和答案,覆盖了线性结构、树形结构、图结构、散列与查找、排序与搜索、递归与分治、动态规划和贪心算法等关键知识点。通过这些练习题,学生能加深对数据结构概念的理解,并提高问题解决能力。详细答案帮助自我检查和学习,为考研复习打下坚实基础。 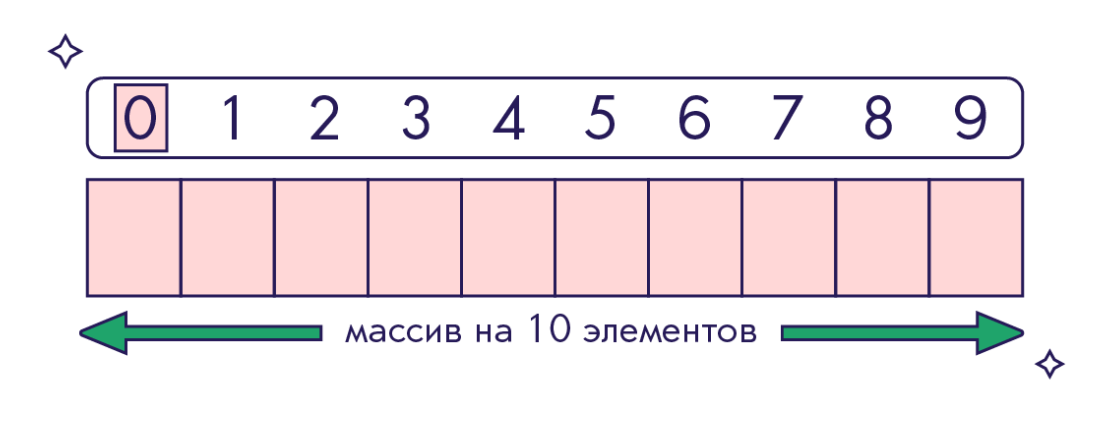
1. 数据结构基础理论与题目解析
数据结构是计算机存储、组织数据的方式,是学习算法与编程的核心。本章我们将从基础理论开始,逐步深入,掌握数据结构的奥秘,为解决实际问题打下坚实基础。
1.1 数据结构的重要性与应用领域
数据结构不仅关系到程序的运行效率,还直接影响代码的可读性和可维护性。广泛应用于数据库系统、网络数据传输、搜索引擎、图形处理等多个领域。
1.2 基本数据类型与抽象数据类型
基本数据类型是编程语言中内置的类型,如整型、浮点型等。而抽象数据类型(ADT)则是一种对数据操作的封装,如栈(Stack)、队列(Queue)、集合(Set)等。
1.3 数据结构的复杂度分析
理解数据结构的性能至关重要。我们会学习时间复杂度和空间复杂度的概念,并通过分析各种操作来评估不同数据结构的效率。
本章,我们将结合实例题,逐一解析数据结构的基础知识点,并提供一些经典问题的解法,让读者能够从理论到实践,逐步掌握数据结构的精髓。
2. 线性结构的深入探讨与实践
2.1 线性结构的基本概念
线性结构是数据结构领域中最基础且应用最为广泛的结构之一。其特点是由一系列节点组成,每个节点之间有且仅有一个前驱和一个后继。线性结构可以直观地想象为一条直线,数据元素在这条线上按线性排列。在计算机科学中,常见的线性结构包括数组、链表、栈、队列等。
2.1.1 数组与链表的区别与联系
数组和链表是线性结构中最常见的两种数据结构,它们在存储数据的方式、效率等方面都有明显的不同。
数组(Array)
数组是一种线性数据结构,它使用一段连续的内存空间来存储相同类型的一系列元素。数组中的元素通过索引直接访问,具有随机访问的特点。
优点 :
- 随机访问 :可以快速地通过索引访问数组中的任何元素。
- 存储紧凑 :数组中的元素在内存中是连续存储的,这可以提高缓存的效率。
缺点 :
- 固定大小 :数组一旦创建,大小就固定了,增加或删除元素需要创建新数组。
- 空间浪费 :如果数组初始化大小大于实际存储需求,将会导致空间浪费。
int arr[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
printf("%d", arr[5]); // 输出第6个元素,即数字6
链表(Linked List)
链表是一种动态的数据结构,由一系列节点组成,每个节点包含数据部分和指向下一个节点的指针。
优点 :
- 动态调整 :链表的大小可以动态调整,添加或删除元素时不需要创建新数组。
- 高效插入和删除 :在链表中间插入和删除节点时,只需要改变几个指针,不需要移动大量数据。
缺点 :
- 访问效率低 :访问链表中的元素需要从头开始遍历,直到找到目标节点。
- 空间开销大 :每个节点除了存储数据外,还需要额外的空间存储指针。
typedef struct Node {
    int data;
    struct Node *next;
} Node;

Node *head = NULL;
// 创建新节点并插入链表头部
Node *newNode = (Node *)malloc(sizeof(Node));
newNode->data = 1;
newNode->next = head;
head = newNode;
2.1.2 栈与队列的原理及应用场景
栈(Stack)和队列(Queue)都是特殊的线性结构,它们的存取操作有特定的规则。
栈(Stack)
栈是一种后进先出(LIFO, Last In First Out)的数据结构,操作只发生在一端。元素的添加(压栈)和删除(弹栈)操作都发生在栈顶。
应用场景 :
- 函数调用的维护,如递归函数中的调用栈。
- 撤销操作,如文本编辑器中的撤销栈。
- 表达式求值,如后缀表达式的计算。
// 栈的基本操作实现
typedef struct Stack {
    int top;
    unsigned capacity;
    int *array;
} Stack;

// 创建栈
Stack* createStack(unsigned capacity) {
    Stack* stack = (Stack*) malloc(sizeof(Stack));
    stack->capacity = capacity;
    stack->top = -1;
    stack->array = (int*) malloc(stack->capacity * sizeof(int));
    return stack;
}

// 压栈操作
void push(Stack* stack, int item) {
    if (stack->top == stack->capacity - 1) {
        return;
    }
    stack->array[++stack->top] = item;
}

// 弹栈操作
int pop(Stack* stack) {
    if (stack->top == -1) {
        return INT_MIN;
    }
    return stack->array[stack->top--];
}
队列(Queue)
队列是一种先进先出(FIFO, First In First Out)的数据结构,操作发生在两端。数据的添加(入队)发生在队尾,而删除(出队)发生在队头。
应用场景 :
- 缓冲处理,如打印队列的管理。
- 任务调度,如操作系统的进程调度。
- 深度优先搜索(DFS)算法中的路径追踪。
// 队列的基本操作实现
typedef struct Queue {
    int front, rear, size;
    int capacity;
    int* array;
} Queue;

// 创建队列
Queue* createQueue(int capacity) {
    Queue* queue = (Queue*) malloc(sizeof(Queue));
    queue->capacity = capacity;
    queue->front = queue->size = 0;
    queue->rear = capacity - 1;
    queue->array = (int*) malloc(queue->capacity * sizeof(int));
    return queue;
}

// 入队操作
void enqueue(Queue* queue, int item) {
    if ((queue->size + 1) > queue->capacity)
        return;
    queue->array[++queue->rear] = item;
    queue->size = queue->size + 1;
}

// 出队操作
int dequeue(Queue* queue) {
    if (queue->size == 0)
        return INT_MIN;
    int item = queue->array[queue->front];
    queue->front = (queue->front + 1) % queue->capacity;
    queue->size = queue->size - 1;
    return item;
}
2.2 线性结构题目实践
2.2.1 线性结构题目精讲
线性结构的题目精讲是帮助加深理解和巩固基本概念的有效方式。通过实际问题的分析,可以更好地理解数组和链表在实际应用中的不同。
线性查找(Linear Search)
线性查找是一种简单的查找方法,它遍历数组或链表,逐个比较数据元素直到找到所需的值或到达末尾。
题目描述 :给定一个整数数组和一个目标值,返回该目标值在数组中的位置;如果不存在,则返回-1。
解题思路 :
- 遍历数组中的每个元素。
- 将当前元素与目标值进行比较。
- 如果匹配成功,则返回当前索引。
- 如果遍历完成都没有找到,则返回-1。
代码实现 :
int linearSearch(int arr[], int size, int target) {
    for (int i = 0; i < size; i++) {
        if (arr[i] == target) {
            return i;
        }
    }
    return -1; // 未找到目标值
}

// 测试函数
int main() {
    int array[] = {1, 3, 5, 7, 9};
    int target = 7;
    int index = linearSearch(array, 5, target);
    if (index != -1) {
        printf("Element found at index: %d\n", index);
    } else {
        printf("Element not found in array\n");
    }
    return 0;
}
2.2.2 编程解决线性结构问题的方法与技巧
在编程解决线性结构问题时,熟悉数据结构的特点和性能参数至关重要。以下是一些常用的技巧和方法:
- 数组优化 :在需要频繁随机访问的场景下,使用数组可以提高效率。
- 链表动态扩展 :当元素数量动态变化时,使用链表可以有效地管理内存。
- 栈与递归 :递归问题通常可以用栈来模拟,理解这一点有助于理解递归调用的工作机制。
- 队列的广度优先搜索 :在图的遍历算法中,队列用于实现广度优先搜索,有助于理解图的层次结构。
通过这些方法和技巧的应用,我们可以更有效地解决线性结构相关的问题,并且在实际编码中更加得心应手。
3. 树形结构的算法分析与应用
3.1 树形结构的理论基础
3.1.1 二叉树的特性与遍历算法
二叉树作为树形结构中最基本的形式,具有节点最多有两个子树的特性,即左子树和右子树。在计算机科学中,二叉树被广泛应用于搜索算法和排序算法,例如二叉搜索树(BST)。
二叉树的遍历算法主要有三种:前序遍历(Pre-order)、中序遍历(In-order)、后序遍历(Post-order)。每种遍历方式均以递归的方式进行。
class TreeNode:
    def __init__(self, value):
        self.val = value
        self.left = None
        self.right = None

def preorder_traversal(root):
    if root:
        print(root.val, end=' ')
        preorder_traversal(root.left)
        preorder_traversal(root.right)

def inorder_traversal(root):
    if root:
        inorder_traversal(root.left)
        print(root.val, end=' ')
        inorder_traversal(root.right)

def postorder_traversal(root):
    if root:
        postorder_traversal(root.left)
        postorder_traversal(root.right)
        print(root.val, end=' ')
前序遍历首先访问根节点,然后遍历左子树,最后遍历右子树;中序遍历先遍历左子树,访问根节点,再遍历右子树;后序遍历则首先遍历左子树和右子树,最后访问根节点。中序遍历二叉搜索树可以得到有序的序列。
3.1.2 平衡树的原理及其优化
平衡树是一种特殊的二叉树,它满足任何节点的两个子树的高度差不超过1。平衡树的代表有AVL树和红黑树等,它们通过旋转操作来保持平衡,从而保证树的操作如查找、插入和删除在最坏情况下都能保持对数时间复杂度。
平衡树的关键在于其平衡因子(Balance Factor),通常定义为一个节点左子树的高度减去右子树的高度。比如,AVL树要求所有节点的平衡因子只可能是{-1, 0, 1}。
class AVLNode:
    def __init__(self, key, left=None, right=None):
        self.key = key
        self.left = left
        self.right = right
        self.height = 1

def get_height(node):
    if not node:
        return 0
    return node.height

def update_height(node):
    node.height = max(get_height(node.left), get_height(node.right)) + 1
当插入或删除节点导致某个节点平衡因子的绝对值超过1时,平衡树会进行旋转操作来调整。旋转操作有四种:LL旋转、RR旋转、LR旋转和RL旋转。每种旋转操作都涉及到改变节点的父节点和子节点的关系,以保持树的平衡。
3.2 树形结构编程应用
3.2.1 AVL树与红黑树的实现与比较
AVL树和红黑树都是自平衡的二叉搜索树,它们在插入、删除和查找操作时都能保持较好的性能。在实际应用中,它们的选择往往取决于特定场景的需求。
AVL树是高度平衡的,因此它在进行查找操作时具有很好的性能,但是在插入和删除时可能需要进行多次旋转来保持平衡,特别是在树的深度较大时,旋转成本较高。
class AVLTree:
    def __init__(self):
        self.root = None

    def insert(self, key):
        # 插入操作后保持树的平衡
        pass

    def delete(self, key):
        # 删除操作后保持树的平衡
        pass
红黑树相比AVL树,在插入和删除操作时旋转的次数较少,因此在频繁修改数据的应用中表现更佳。但红黑树在最坏情况下仍然能够保证对数时间复杂度的性能。
3.2.2 堆结构的构建与应用
堆是一种特殊的完全二叉树,满足任何一个父节点的值都必须大于或等于其子节点的值(最大堆),或者小于或等于其子节点的值(最小堆)。堆通常用于实现优先队列,并在排序算法(如堆排序)中作为数据结构的核心。
堆可以通过数组实现,父节点和子节点之间的关系如下:
- 对于数组中的任意元素
i,其左子节点的索引为2*i + 1,右子节点的索引为2*i + 2。 - 对于任意非根节点
i,其父节点的索引为(i - 1) // 2。
def heapify(arr, n, i):
    largest = i
    left = 2 * i + 1
    right = 2 * i + 2

    if left < n and arr[i] < arr[left]:
        largest = left

    if right < n and arr[largest] < arr[right]:
        largest = right

    if largest != i:
        arr[i], arr[largest] = arr[largest], arr[i]
        heapify(arr, n, largest)
通过 heapify 函数,可以构建最大堆或最小堆,并且可以实现堆的插入和删除操作,从而应用堆结构解决实际问题,如优先级调度、任务分配等。
4. 图结构的探索与实现
4.1 图的基本概念与算法
4.1.1 图的表示方法及存储结构
图是由一组顶点和连接这些顶点的边组成的数学结构。在计算机科学中,图的表示方法和存储结构直接影响到算法的效率和实用性。最常见的表示方法有邻接矩阵和邻接表。
邻接矩阵 表示图的方法使用二维数组,其中的元素表示顶点之间的连接关系。对于无向图,如果顶点i和顶点j之间有边,则 matrix[i][j] 和 matrix[j][i] 都被设置为1(或者其他标记为存在的值),否则为0。对于有向图,如果存在从顶点i到顶点j的边,则 matrix[i][j] 为1,否则为0。邻接矩阵的优点是直观且易于检查任意两个顶点之间是否存在边,但其空间复杂度较高,特别是在稀疏图中。
# 示例代码:构建无向图的邻接矩阵表示
def create_adjacency_matrix(graph):
    # 初始化矩阵大小为顶点数*顶点数,全部为0
    matrix = [[0 for _ in range(len(graph))] for _ in range(len(graph))]
    # 遍历图中的所有边,设置连接关系
    for i, edges in enumerate(graph):
        for j, weight in edges:
            matrix[i][j] = weight  # 这里的weight可以是1或者其他标记值
    return matrix
邻接表 则是一种更为节省空间的表示方法,它使用链表或者字典来存储每个顶点的邻接顶点列表。邻接表特别适合表示稀疏图,因为它只存储存在边的顶点信息。
# 示例代码:构建无向图的邻接表表示
def create_adjacency_list(graph):
    adj_list = {i: [] for i in range(len(graph))}
    for i, edges in enumerate(graph):
        for j, weight in edges:
            adj_list[i].append((j, weight))
            adj_list[j].append((i, weight))  # 对于无向图需要添加两个方向
    return adj_list
在实际应用中,选择哪一种表示方法取决于图的类型(有向或无向)以及图的稠密程度。对于有大量顶点和边的图,邻接表通常会更加高效。
4.1.2 深度优先搜索(DFS)与广度优先搜索(BFS)的原理
深度优先搜索(DFS)和广度优先搜索(BFS)是两种基本的图遍历算法,它们在很多图论问题中都有广泛的应用。
深度优先搜索(DFS) 从一个顶点开始,访问所有可能的路径直到走到终点,然后回溯继续寻找新的路径。DFS可以使用递归或栈实现。在搜索的过程中,DFS会尽可能深地探索图的分支。
# 示例代码:深度优先搜索(递归实现)
def dfs_recursive(graph, start, visited=None):
    if visited is None:
        visited = set()
    visited.add(start)
    print(start, end=' ')
    for next_node in graph[start]:
        if next_node not in visited:
            dfs_recursive(graph, next_node, visited)
    return visited
广度优先搜索(BFS) 从一个顶点开始,先访问其邻接顶点,然后再对这些邻接顶点的邻接顶点进行访问。BFS通常使用队列来实现。在搜索的过程中,BFS会按照距离起始点的距离逐层向外扩展。
# 示例代码:广度优先搜索(队列实现)
from collections import deque

def bfs_queue(graph, start):
    visited = set()
    queue = deque([start])
    while queue:
        vertex = queue.popleft()
        if vertex not in visited:
            print(vertex, end=' ')
            visited.add(vertex)
            queue.extend(set(graph[vertex]) - visited)
    return visited
DFS和BFS都可以用来解决路径问题、连通性检测和拓扑排序等图论问题。DFS特别适合解决需要访问所有顶点的问题,而BFS在最短路径问题中特别有用,因为BFS保证了最先找到的是最短路径。
4.2 图结构编程实现
4.2.1 实现图的遍历算法
图的遍历是图论问题的基础,而DFS和BFS是实现图遍历的关键算法。以下是如何用Python代码实现这两种图遍历算法:
# DFS和BFS的完整实现代码
# ...(前面的函数定义)

def main():
    # 假设有一个无向图的邻接列表表示
    graph = {
        'A': [('B', 1), ('C', 1)],
        'B': [('A', 1), ('D', 1), ('E', 1)],
        'C': [('A', 1), ('F', 1)],
        'D': [('B', 1)],
        'E': [('B', 1), ('F', 1)],
        'F': [('C', 1), ('E', 1)]
    }

    # 执行DFS遍历
    print("DFS traversal starting at 'A':")
    dfs_recursive(graph, 'A')
    print()

    # 执行BFS遍历
    print("BFS traversal starting at 'A':")
    bfs_queue(graph, 'A')
    print()

if __name__ == '__main__':
    main()
通过这段代码,我们可以看到图的两种基本遍历方法,以及如何使用Python来实现它们。图的遍历算法是很多其他图论算法的基础,例如拓扑排序、寻找连通分量和生成树等。
4.2.2 图的连通性分析与路径问题
图的连通性分析旨在确定图中的顶点之间是否互相可达。一个图可以是有向的也可以是无向的,而连通图则是图中任意两个顶点都相互可达的特殊图。在有向图中,如果每个顶点至少有一条边进入和一条边离开,则称该图是强连通的。对应的,无向图中任意两个顶点都相互连通,则该图是连通的。
连通分量是图中最大的一组连通顶点。无向图可以包含多个连通分量,而有向图的强连通分量分析则更为复杂。Tarjan算法和Kosaraju算法是解决有向图强连通分量问题的两种常用算法。
路径问题在图中也非常重要,例如寻找两个顶点之间的最短路径问题可以通过Dijkstra算法或Floyd-Warshall算法解决。对于无权图或特殊图(如二叉树),可以使用更简单的BFS来寻找最短路径。
在实际应用中,图的连通性分析和路径问题非常重要,例如在社交网络分析、网络路由优化和物流配送路径规划等领域。
graph LR
A[开始] --> B[创建图的表示]
B --> C{检查连通性}
C -->|是| D[图是连通的]
C -->|否| E[图是不连通的]
E --> F[识别连通分量]
F --> G[分析路径问题]
G --> H[结束]
以上mermaid流程图展示了图连通性分析与路径问题的一般处理流程。
图结构作为复杂网络模型的基础,广泛应用于各种领域。掌握图的基本概念、表示方法、遍历算法以及连通性和路径问题的解决方法,对于处理现实世界中各种网络问题至关重要。
5. 散列与查找技术的实战应用
5.1 散列技术的理论与方法
5.1.1 散列表(哈希表)的设计与应用
散列表(哈希表)是一种特殊的数据结构,它通过哈希函数将关键码映射到表中的一个位置来加速数据的查找。散列表的性能优异,平均查找时间复杂度为O(1),它广泛应用于各类数据管理系统中。设计一个好的哈希表需要考虑的关键因素包括哈希函数的设计、冲突解决策略以及负载因子的控制。
哈希函数的设计
一个好的哈希函数应当尽可能地减少冲突并均匀地分布数据,以保证哈希表的高效性能。设计哈希函数时通常会考虑以下几个方面:
- 计算效率 :哈希函数需要快速计算,以便在数据查找时能迅速确定位置。
- 均匀分布 :对于不同的关键码,哈希函数应能尽可能地均匀分布到哈希表的槽位中。
- 最小化冲突 :理想的哈希函数应该尽量避免两个不同关键码产生相同的哈希值。
常见哈希函数的设计方法包括:
- 除留余数法 :对于关键码K,选择一个大于哈希表大小m的数p,然后计算
K mod p得到哈希值。 - 平方取中法 :对于关键码K,将其平方,然后从中间取几个数字作为哈希值。
- 数字分析法 :适用于关键码具有特定模式的情况,通过分析关键码的数字特征来构造哈希函数。
冲突解决策略
冲突是指两个关键码通过哈希函数计算后得到相同的哈希地址。常用的冲突解决策略有:
- 开放寻址法 :如果计算得到的哈希地址已被占用,则线性或二次地探测下一个地址,直到找到空闲位置。
- 链地址法 :在每个哈希桶中存储一个链表,所有具有相同哈希地址的关键码都存储在该链表中。
负载因子与扩容
负载因子是哈希表当前元素数量与表大小的比值。随着负载因子的增加,冲突的概率也随之增加,哈希表的性能下降。当负载因子超过某个阈值时,通常需要对哈希表进行扩容操作,即创建一个新的更大的哈希表,并将所有元素重新插入到新表中以减少冲突。
实际应用案例
在实际应用中,散列表常常用于存储和快速检索大量数据。例如,在数据库的索引系统中,利用散列表能够快速地根据主键访问记录;在实现缓存系统时,散列表提供了快速的数据存取;以及在各种字典和映射的应用场景中,散列表都发挥着重要的作用。
5.1.2 各类查找算法的效率分析
查找算法用于在数据集合中搜索特定数据项。在散列与查找技术中,除了散列表(哈希表),还有其他几种常见的查找算法,它们各自有着不同的效率和适用场景。
线性查找
线性查找是最简单的查找算法,它按顺序检查每个元素,直到找到目标数据或遍历完数组。线性查找的时间复杂度为O(n),适用于数据量小或无序的数据集合。
线性查找算法伪代码:
for i = 0 to length(array) - 1:
    if array[i] == target:
        return i  # 找到目标,返回索引
return -1  # 未找到目标,返回-1
二分查找
二分查找算法适用于有序数组,其时间复杂度为O(log n)。算法通过比较中间元素与目标值,缩小查找范围,效率远高于线性查找。
二分查找算法伪代码:
left = 0
right = length(array) - 1
while left <= right:
    mid = left + (right - left) // 2
    if array[mid] == target:
        return mid  # 找到目标,返回索引
    elif array[mid] < target:
        left = mid + 1
    else:
        right = mid - 1
return -1  # 未找到目标,返回-1
二叉搜索树查找
二叉搜索树(BST)是一种有序树结构,具有以下性质:左子树上所有节点的值均小于其根节点的值;右子树上所有节点的值均大于其根节点的值;左右子树也分别为二叉搜索树。对于BST的查找操作,平均时间复杂度为O(log n),但在最坏情况下(如二叉树退化为链表),时间复杂度会退化为O(n)。
BST查找算法伪代码:
function searchBST(root, target):
    if root is None or root.value == target:
        return root
    if target < root.value:
        return searchBST(root.left, target)
    else:
        return searchBST(root.right, target)
散列查找
散列查找是基于哈希表的查找方法。通过哈希函数计算出的关键码对应的哈希地址,直接访问数据项。散列查找的平均时间复杂度接近O(1),但实际性能依赖于哈希函数的设计和冲突处理策略。
散列查找算法伪代码:
index = hashFunction(key)
if hashTable[index] is not empty and hashTable[index].key == key:
    return hashTable[index].value  # 找到目标,返回值
else:
    return null  # 未找到目标,返回null
效率比较
在选择查找算法时,需要根据数据的特点和查找频率来决定。对于无序且数据量不大的集合,线性查找是简单的选择;对于有序数据集合,尤其是静态数据集合,二分查找是更高效的选择;对于需要快速插入和删除操作的动态数据集合,散列查找可能是最佳选择。
5.2 散列技术在数据存储中的应用案例
5.2.1 散列技术在数据存储中的应用案例
散列技术在数据存储中的应用极为广泛,特别是在需要高效数据检索和快速插入删除的场景。下面通过一个具体的案例,来详细说明散列技术在数据存储中的应用。
案例背景:缓存系统设计
假设我们要设计一个简单的缓存系统,用于存储Web服务器的静态资源。由于静态资源通常由键(如文件名)唯一标识,并且访问频率高,因此缓存系统需要能够快速定位和存储这些资源。
散列表设计
首先,我们使用散列表作为缓存系统的存储结构。键(文件名)经过哈希函数处理后得到哈希值,该哈希值直接映射到散列表的槽位中。
def hash_function(key):
    # 一个简单的哈希函数实现
    return hash(key) % table_size
冲突解决与扩容机制
由于散列冲突的不可避免性,我们选择链地址法作为冲突解决策略。当多个文件名通过哈希函数映射到同一个槽位时,我们将在该槽位维护一个链表来存储这些文件的条目。
class HashTable:
    def __init__(self, size):
        self.table = [[] for _ in range(size)]

    def insert(self, key, value):
        index = hash_function(key)
        # 遍历链表,检查键是否已存在
        for item in self.table[index]:
            if item['key'] == key:
                item['value'] = value
                break
        else:
            # 如果键不存在,添加新的键值对到链表
            self.table[index].append({'key': key, 'value': value})

    def search(self, key):
        index = hash_function(key)
        for item in self.table[index]:
            if item['key'] == key:
                return item['value']
        return None
扩容策略
为了保证散列表的高效性,需要定期检测负载因子并进行扩容。当负载因子超过某一阈值时,创建一个新的更大的散列表,并将所有现有数据重新哈希到新表中。
def resize_hash_table(hash_table, new_size):
    new_table = [[] for _ in range(new_size)]
    for bucket in hash_table.table:
        for item in bucket:
            new_index = hash_function(item['key'], new_size)
            new_table[new_index].append(item)
    hash_table.table = new_table
案例总结
通过上述案例,我们可以看到散列技术在数据存储中的具体应用。散列表以其优秀的平均查找时间,非常适合实现缓存系统、数据库索引、键值存储等需要快速访问的数据存储服务。通过合理设计哈希函数、选择冲突解决策略以及定期扩容,可以保证散列表在各种应用场景下的性能和稳定性。
5.2.2 查找算法在实际问题中的应用
在实际问题解决过程中,查找算法的选择和应用至关重要。本节将通过具体案例,探讨如何在不同的应用场景中选择和实现最合适的查找算法。
案例分析:用户登录验证系统
假设我们正在开发一个用户登录验证系统,系统需要根据用户输入的用户名快速查找到对应用户的信息以进行验证。
需求分析
- 数据量大 :可能有数百万用户信息存储在数据库中。
- 实时查找 :用户登录时需要快速反馈验证结果。
- 动态更新 :用户信息(如密码)可能会被更新。
算法选择与实现
在本案例中,我们面临着数据量大且需要快速查找的需求。若采用线性查找,性能将远远不能满足需求。二分查找在有序数组中表现优异,但用户数据可能频繁更新,维护有序数组的成本较高。对于动态数据集合,散列查找提供了更好的解决方案。
散列表实现
我们可以构建一个散列表,将用户名作为键,用户信息(如密码、邮箱等)作为值。当用户尝试登录时,系统通过散列函数计算用户名的哈希值,并直接在散列表中查找对应的用户信息。
class UserHashTable:
    def __init__(self):
        self.table = [[] for _ in range(table_size)]

    def insert(self, username, user_info):
        index = hash_function(username)
        # 检查用户名是否已存在
        for item in self.table[index]:
            if item['username'] == username:
                item['user_info'] = user_info
                break
        else:
            # 如果用户名不存在,添加新的键值对
            self.table[index].append({'username': username, 'user_info': user_info})

    def search(self, username):
        index = hash_function(username)
        for item in self.table[index]:
            if item['username'] == username:
                return item['user_info']
        return None
系统测试与优化
在系统部署之前,我们对散列表进行测试,确保查找、插入和更新操作都能在预期的时间内完成。此外,我们还对散列表进行实时监控,以便在负载因子超过预设阈值时及时进行扩容操作。
结论与反思
通过上述案例,我们可以看到查找算法在解决实际问题中的作用。散列查找由于其优秀的平均查找时间,在处理大量动态数据时具有明显优势。此外,我们还应当注意到,在选择查找算法时,除了考虑其时间复杂度外,还应当考虑数据的特性(如数据量大小、是否有序、数据更新频率等),以及算法的空间复杂度和实现复杂性等因素。实际应用中,往往需要综合考虑,选择或设计最适合特定问题场景的查找算法。
5.2.1 散列技术在数据存储中的应用案例
在数据存储解决方案中,散列技术由于其快速的查找和插入性能,是解决大规模数据管理问题的常用手段。下面是一个详细的案例,展示了散列技术如何应用于一个具有大量数据访问需求的场景。
案例描述:分布式键值存储服务
在云计算和大数据时代,分布式系统因其可扩展性和容错性而越来越受到青睐。例如,一个用于存储用户会话信息的分布式键值存储服务,它需要快速响应用户的读写请求,并在多台服务器之间保持数据的同步。这种服务对数据访问速度有极高的要求,同时也要处理大量的并发读写操作。
散列表的角色
在这样的分布式键值存储服务中,散列表被用作数据存储的底层结构,允许快速定位数据项。每个服务器维护一个散列表,利用散列函数快速定位数据项在散列表中的位置。为了保持数据的一致性,通常会采用一致性哈希等技术,确保当服务器数量变动时,只有极小部分数据项需要迁移。
分布式散列表(DHT)设计
分布式散列表(Distributed Hash Table,DHT)通过结合散列技术和分布式系统的设计原则,提供了一种在多台机器间分布式存储和检索键值对的解决方案。常见的DHT算法有Chord、Pastry、Kademlia等,每种算法都旨在解决分布式环境下的查找效率和负载均衡问题。
以Chord算法为例,它通过散列函数计算每个键的哈希值,并将这个哈希值映射到一个虚拟的环状空间上。每个节点负责处理该环上的一部分哈希值区间,通过维护路由信息,高效地定位键所对应的节点。
class ChordDHTNode:
    def __init__(self, identifier):
        self.identifier = identifier  # 节点标识符
        self.successor = None          # 后继节点
        self.fingers = [None] * m      # 路由表

    def stabilize(self):
        # 稳定化操作,确保后继节点是最接近的节点
        pass

    def fix_fingers(self):
        # 维护路由表
        pass

    def lookup(self, key):
        # 查找操作,定位键所在的节点
        pass

# 初始化节点
node = ChordDHTNode(hash_function(key))
DHT的优化与应用
在实际应用中,DHT系统的设计需要考虑许多实际问题,比如网络延迟、节点失效和动态加入等。DHT实现需要精心设计路由表的大小和更新策略,以最小化查找延迟和提高系统容错性。此外,为了进一步优化性能,DHT系统往往还会引入缓存机制,以减少对后端存储的直接访问次数。
5.2.2 查找算法在实际问题中的应用
查找算法在计算机科学中具有广泛的应用。本节将通过一个具体的实例,探讨查找算法在处理实际问题中的应用,特别是如何根据问题的特点选择合适的查找算法。
实际问题:图书馆图书管理系统
假设我们需要设计一个图书馆的图书管理系统,用户可以使用书名或作者名来查找图书。系统中存储了成千上万本书籍的信息,包括书名、作者、出版社等。设计者必须考虑如何高效地实现图书的查找功能。
系统需求分析
- 快速检索 :用户希望在输入查询后立即得到搜索结果。
- 用户友好 :系统应该能够提供准确的查询建议,并能处理拼写错误等情况。
- 可扩展性 :随着图书数量的增长,系统应能够保持良好的性能。
算法选择与实现
在本例中,我们可以选择二分查找、散列查找和二叉搜索树查找这几种算法。由于图书馆的书籍通常需要按特定顺序排列,比如按书名的字典顺序,因此二分查找是合适的选择。但由于二分查找需要数据预先排序,而且对动态数据集合的支持不佳,实际应用中我们可能会采用二叉搜索树(BST)或散列表。
基于BST的实现
对于书名查找,可以构建一本包含所有书名的二叉搜索树。每个节点包含一个图书对象,其子树按书名的字典顺序组织。
class BookNode:
    def __init__(self, book):
        self.book = book
        self.left = None
        self.right = None

class BookBST:
    def __init__(self):
        self.root = None

    def insert(self, book):
        if not self.root:
            self.root = BookNode(book)
        else:
            self._insert(self.root, book)

    def _insert(self, node, book):
        if book.name < node.book.name:
            if node.left is None:
                node.left = BookNode(book)
            else:
                self._insert(node.left, book)
        else:
            if node.right is None:
                node.right = BookNode(book)
            else:
                self._insert(node.right, book)

    def search(self, book_name):
        return self._search(self.root, book_name)

    def _search(self, node, book_name):
        if node is None:
            return None
        if book_name < node.book.name:
            return self._search(node.left, book_name)
        elif book_name > node.book.name:
            return self._search(node.right, book_name)
        else:
            return node.book
基于散列表的实现
对于作者查找,我们可以选择使用散列表。每个作者名作为键,对应的值是一个包含该作者所有书籍的列表。
class AuthorHashTable:
    def __init__(self):
        self.table = [[] for _ in range(table_size)]

    def insert(self, author_name, book):
        index = hash_function(author_name)
        self.table[index].append(book)

    def search(self, author_name):
        index = hash_function(author_name)
        for book in self.table[index]:
            if book.author == author_name:
                return book
        return None
系统测试与优化
在系统开发过程中,我们需要对这两种实现进行测试,以验证它们是否满足系统的需求。比如,可以测试不同数量级的图书数据下,查找算法的性能表现。同时,我们还需要考虑到可能的异常情况,例如用户输入的查询关键词不存在于系统中,或者查询关键词拼写错误。针对这些情况,我们需要实现一些附加的功能,如提示用户可能的查询错误信息和查询建议。
结论
在实际问题的解决中,查找算法的选择至关重要。二叉搜索树适用于有序集合的快速查找,而散列表适用于快速定位无序数据集合中的元素。在选择查找算法时,应当综合考虑问题的特点、数据的特性以及系统的需求。对于动态数据集合,选择合适的查找算法和数据结构,能够显著提高系统的响应速度和用户体验。
6. 排序与搜索算法的优化
6.1 排序算法的理论框架
6.1.1 各类排序算法的特点与适用场景
在IT行业,排序算法是日常开发任务中的基础工具,它们在处理大量数据时展现出的效率直接影响到程序的性能。不同的排序算法具有各自的优点和局限性,选择合适的排序算法能大幅提升数据处理的效率。
-
冒泡排序(Bubble Sort) :这是一种简单直观的排序算法,其基本思想是通过重复遍历要排序的数列,比较相邻元素的值,若发现顺序错误就交换它们。冒泡排序适用于小规模数据集,因为其时间复杂度为O(n^2),在数据量大时效率较低。
-
快速排序(Quick Sort) :快速排序通过选择一个“基准”元素,然后将数组分为两部分,一部分比基准小,另一部分比基准大。这个过程递归地进行。快速排序平均情况下有很好的性能,时间复杂度为O(nlogn),但在最坏情况下会退化到O(n^2)。由于其分治策略,快速排序在大多数情况下都是排序大量数据的首选。
-
归并排序(Merge Sort) :归并排序也是分治策略的代表之一。它将数组分成两半,分别对它们进行排序,然后将结果归并起来。归并排序在所有情况下都有稳定的时间复杂度O(nlogn),但它需要额外的空间来存储临时数组。适用于需要稳定排序且不介意使用额外空间的场景。
-
堆排序(Heap Sort) :堆排序利用堆这种数据结构所设计的一种排序算法。它利用大顶堆或小顶堆对数据进行排序,先构建一个最大堆,然后将堆顶元素与堆的最后一个元素交换,之后重新调整堆结构,如此往复直到堆变为空堆。堆排序的时间复杂度为O(nlogn),由于它不需要额外的空间,因此在空间受限的情况下特别有用。
-
计数排序(Counting Sort)、桶排序(Bucket Sort)和基数排序(Radix Sort) :这些排序算法不基于比较,适用于特定类型的数据。计数排序适用于一定范围内整数的排序;桶排序适合用在平均分布的数据上;基数排序适用于处理整数或字符串,通过固定次数的非比较排序,按位数处理数据。这些排序方法通常用于优化特定情况下的性能,但它们的空间复杂度较高,且不适用于大规模随机数据。
6.1.2 排序算法的时间复杂度分析
理解每种排序算法的时间复杂度是选择排序方法的关键。时间复杂度描述了算法执行时间与输入数据规模之间的关系。在不同的排序算法中,我们可以将复杂度大致分类为最好、平均和最坏情况:
- 最好情况时间复杂度 :在最好的情况下,冒泡排序的时间复杂度为O(n),这是因为若数组已经有序,冒泡排序仅需一趟就可以完成排序。
- 平均情况时间复杂度 :对于大多数排序算法,平均情况下的时间复杂度通常是它们的典型代表,例如快速排序的O(nlogn)。
- 最坏情况时间复杂度 :在最坏的情况下,快速排序的时间复杂度会退化到O(n^2),这通常发生在数据已经有序或者选择的基准元素恰好是最大或最小元素时。
在实际应用中,我们通常会基于数据的规模、分布情况和稳定性要求,选择最合适的排序算法。
6.2 排序与搜索算法编程实践
6.2.1 编程实现排序算法
在本节中,我们将通过Python语言实现快速排序算法,这是编程中经常使用的高效排序方法。快速排序的核心在于分治思想,以下是实现快速排序的代码示例:
def quick_sort(arr):
    if len(arr) <= 1:
        return arr
    pivot = arr[len(arr) // 2]
    left = [x for x in arr if x < pivot]
    middle = [x for x in arr if x == pivot]
    right = [x for x in arr if x > pivot]
    return quick_sort(left) + middle + quick_sort(right)

# 示例数组
example_array = [3, 6, 8, 10, 1, 2, 1]
# 调用快速排序
sorted_array = quick_sort(example_array)
print(sorted_array)
代码逻辑逐行解读 :
- 第1行:定义
quick_sort函数,接受一个数组arr作为参数。 - 第2行:检查数组长度,如果小于或等于1,直接返回数组,因为长度为1的数组自然是有序的。
- 第3行:选择基准元素
pivot,通常是数组的中间元素。 - 第4-6行:根据基准元素将数组分为三部分:小于基准的
left、等于基准的middle、大于基准的right。 - 第7行:递归地对
left和right子数组应用快速排序,并与middle数组连接起来返回。
参数说明 :
-
arr:待排序的数组。 -
pivot:基准元素,用于分割数组。
6.2.2 搜索算法在数据处理中的应用
搜索是排序之后的常见数据处理操作,它涉及在有序或无序的数据集中查找特定元素。在这个部分,我们重点探讨二分搜索算法,它是一种高效的搜索算法,适用于已排序的数据集。
二分搜索算法的基本思想是将要查找的目标值与数组中间的值进行比较,根据比较结果决定是搜索左半部分还是右半部分,然后递归地重复这个过程,直到找到目标值或者搜索范围为空。
以下是二分搜索算法的Python代码实现:
def binary_search(arr, target):
    left, right = 0, len(arr) - 1
    while left <= right:
        mid = (left + right) // 2
        guess = arr[mid]
        if guess == target:
            return mid
        if guess > target:
            right = mid - 1
        else:
            left = mid + 1
    return -1

# 示例数组
example_array = [1, 3, 5, 7, 9]
# 目标值
target_value = 7
# 调用二分搜索
result_index = binary_search(example_array, target_value)
if result_index != -1:
    print(f"元素 {target_value} 在数组中的索引为 {result_index}")
else:
    print(f"数组中不包含元素 {target_value}")
代码逻辑逐行解读 :
- 第1行:定义
binary_search函数,接收已排序的数组arr和要搜索的目标值target作为参数。 - 第2行:初始化左边界
left为0,右边界right为数组长度减1。 - 第3行:开始一个循环,直到
left超过right。 - 第4行:计算中间位置
mid。 - 第5行:获取
mid位置的值guess。 - 第6行:判断
guess是否等于target,如果是,则返回mid。 - 第7行:如果
guess大于target,将right设置为mid - 1,搜索左半部分。 - 第8行:如果
guess小于target,将left设置为mid + 1,搜索右半部分。 - 第10行:如果循环结束都没有找到目标值,则返回-1表示搜索失败。
参数说明 :
-
arr:已排序的数组。 -
target:要搜索的目标值。 -
left和right:搜索过程中的边界值。
二分搜索相比于线性搜索(顺序遍历数组),其优势在于大幅减少了搜索的次数,将时间复杂度从O(n)降低到了O(logn),极大地提高了搜索效率,特别适用于大数据集的搜索任务。
7. 高级算法策略与题目应用
随着计算机科学的发展,高级算法策略越来越受到重视。它们在解决特定问题时表现出的高效性及优雅性,使得它们成为IT行业和相关领域技术人员所必备的技能之一。
7.1 高级算法理论与策略
7.1.1 递归与分治的算法原理
递归是一种常见的编程技术,它允许函数调用自身来解决问题。分治策略是递归的一种应用,其核心思想是将复杂的问题分解成多个简单的子问题,分别解决这些子问题后,再将它们的结果合并以解决原来的问题。
递归函数通常包含两个基本要素:基本情况(或终止条件)和递归步骤。基本情况是递归的结束条件,防止无限递归;而递归步骤则是函数自身调用的过程,每一次调用都会使问题规模减小。
例如,在快速排序算法中,分治策略被应用得淋漓尽致。快速排序将数组分成较小和较大的两个子数组,然后递归地排序两个子数组。
7.1.2 动态规划与贪心算法的解决问题思路
动态规划(Dynamic Programming,DP)是一种算法设计技巧,用于解决具有重叠子问题和最优子结构特性的问题。它通过将复杂问题分解为简单子问题,并存储这些子问题的解,避免了重复计算,从而提高了效率。
贪心算法(Greedy Algorithm)则是一种在每一步选择中都采取在当前状态下最好或最优(即最有利)的选择,从而希望导致结果是全局最好或最优的算法。
动态规划与贪心算法的区别在于,动态规划需要考虑全局最优解,而贪心算法只关注当前最优解。例如,在解决找零钱问题时,动态规划会考虑所有可能的组合来找到最优解,而贪心算法可能会直接从最大面额的硬币开始,尽可能多地使用,这种方法可能并不总是得到最优解。
7.2 高级算法编程与实践
7.2.1 动态规划在复杂问题中的应用
动态规划的应用非常广泛,解决的问题类型包括:最短路径问题、最小成本问题、最大利润问题等。动态规划的关键在于状态的定义和状态转移方程的建立。
以背包问题为例,我们可以定义状态 dp[i][w] 表示前 i 件物品,当前背包容量为 w 时的最大价值。状态转移方程为:
dp[i][w] = max(dp[i-1][w], dp[i-1][w-weight[i]] + value[i]) if w >= weight[i]
其中 weight[i] 和 value[i] 分别表示第 i 件物品的重量和价值。
7.2.2 贪心算法在优化问题中的应用实例
贪心算法在许多优化问题中可以快速得到解决方案,特别是在图论中。举个典型的例子,假设我们想从一个网络中找一条最短路径,可以使用Dijkstra算法,这是一种贪心算法。
Dijkstra算法的基本思想是:假设已经找到了最短路径上最后的节点,那么这条路径就是当前的最短路径。它每次选择当前可达的、距离最小的节点,并更新其他节点的最短路径估计值。
import heapq

def dijkstra(graph, start):
    distances = {vertex: float('infinity') for vertex in graph}
    distances[start] = 0
    priority_queue = [(0, start)]
    while priority_queue:
        current_distance, current_vertex = heapq.heappop(priority_queue)
        if current_distance > distances[current_vertex]:
            continue
        for neighbor, weight in graph[current_vertex].items():
            distance = current_distance + weight
            if distance < distances[neighbor]:
                distances[neighbor] = distance
                heapq.heappush(priority_queue, (distance, neighbor))
    return distances

graph = {
    'A': {'B': 1, 'C': 4},
    'B': {'A': 1, 'C': 2, 'D': 5},
    'C': {'A': 4, 'B': 2, 'D': 1},
    'D': {'B': 5, 'C': 1}
}

print(dijkstra(graph, 'A'))
此代码展示了Dijkstra算法在图的最短路径问题中的应用。代码中定义了 dijkstra 函数,通过优先队列(最小堆)维护当前待处理的节点以及对应的最短路径估计值,并不断地更新其它节点的最短路径估计值,直到所有节点都被处理。
贪心算法在实际应用中的局限性在于它并不总是能得到全局最优解。因此,使用贪心算法时需要仔细分析问题的特性,确认贪心选择能够保证全局最优解。
在编程实践中,高级算法策略的运用往往需要对问题的深入理解及丰富的经验积累。开发者需要在众多算法中选择或设计最合适的算法来解决问题。而这也是IT专业人员日常工作中最有挑战性和成就感的部分之一。
简介:数据结构是计算机科学的核心,涉及高效数据管理与操作。本资源为2020年考研数据结构考生提供的1800题练习集和答案,覆盖了线性结构、树形结构、图结构、散列与查找、排序与搜索、递归与分治、动态规划和贪心算法等关键知识点。通过这些练习题,学生能加深对数据结构概念的理解,并提高问题解决能力。详细答案帮助自我检查和学习,为考研复习打下坚实基础。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 19
 0
- 0


 已为社区贡献17条内容

所有评论(0)