模型剪枝效果评估
·
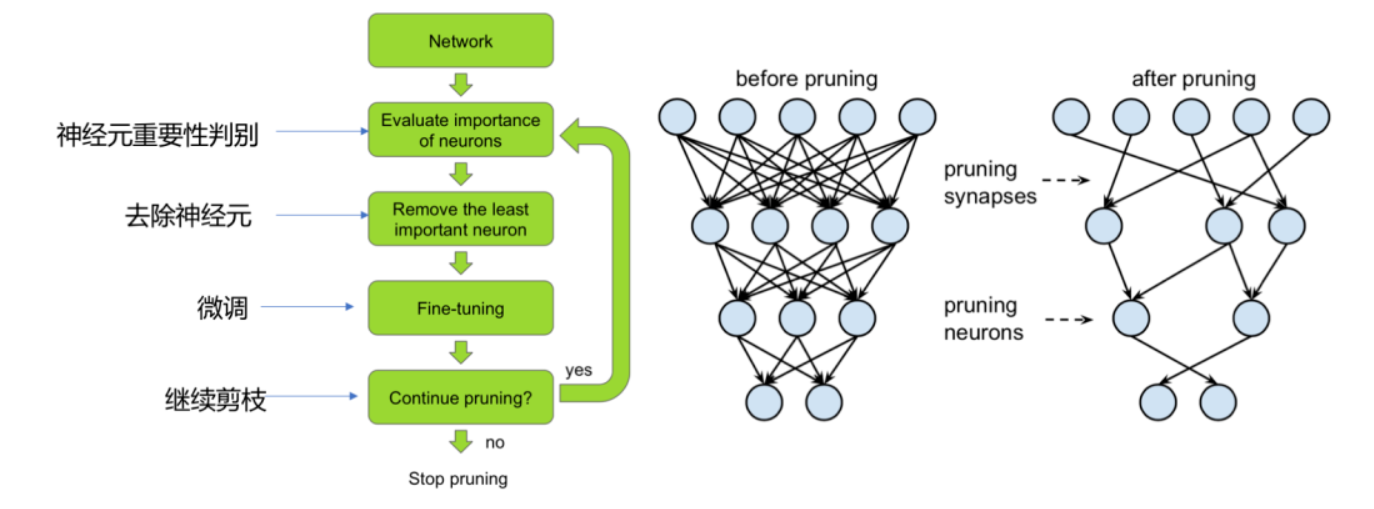
模型剪枝是深度学习模型压缩与加速的核心技术之一,其核心目标是通过移除冗余参数或结构,在保持模型性能的同时降低计算与存储开销。以下是常见的剪枝策略分类及其关键技术点,结合具体场景与实现方式展开分析:
一、基于剪枝粒度的策略
1. 非结构化剪枝(Unstructured Pruning)
- 原理:直接移除单个权重参数,剪枝后的权重矩阵呈现稀疏性(含大量零值)。
- 技术实现:
- 权重幅值剪枝:移除绝对值最小的权重(如保留前30%最大权重)。
- 梯度幅值剪枝:移除梯度变化最小的权重(基于反向传播的梯度信息)。
- Hessian矩阵剪枝:通过二阶导数评估权重对损失的影响(如OBS算法)。
- 典型应用:
- 研究场景:用于分析模型冗余性(如理解ResNet中哪些权重贡献最小)。
- 稀疏硬件支持:NVIDIA A100 GPU的稀疏Tensor Core可加速此类模型。
- 局限:
- 需依赖稀疏矩阵计算库(如CuSPARSE),否则无法实现加速。
2. 结构化剪枝(Structured Pruning)
- 原理:移除神经元、通道或滤波器等结构化单元,保持模型权重矩阵的规则性。
- 技术实现:
- 通道剪枝:移除卷积层中不重要的滤波器(如基于L1范数筛选)。
- 层剪枝:移除对性能影响较小的整个层(如通过BN层缩放因子评估)。
- 神经元剪枝:移除全连接层中贡献最小的神经元(如基于激活值统计)。
- 典型应用:
- 移动端部署:剪枝后的模型可直接在ARM CPU或DSP上运行。
- 实时推理:在自动驾驶中,剪枝后的YOLOv5模型可在边缘设备上实现30FPS。
- 优势:
- 无需专用硬件支持,兼容现有深度学习框架(如PyTorch、TensorFlow)。
二、基于剪枝过程的策略
1. 一次性剪枝(One-Shot Pruning)
- 原理:在预训练模型上直接执行剪枝,不进行中间微调。
- 技术实现:
- 全局阈值剪枝:对所有层使用统一的权重幅值阈值。
- 逐层阈值剪枝:为每层单独计算剪枝阈值(如保留每层前50%权重)。
- 典型应用:
- 快速原型设计:在模型探索阶段快速验证剪枝可行性。
- 资源受限场景:当微调计算资源不足时(如IoT设备)。
- 局限:
- 可能导致性能大幅下降(如ResNet-50剪枝50%后准确率下降10%)。
2. 迭代剪枝(Iterative Pruning)
- 原理:将剪枝过程分解为多个阶段,每次剪枝后微调模型以恢复性能。
- 技术实现:
- 渐进式剪枝:每次剪去少量权重(如1%),重复多轮。
- 自动调节剪枝率:根据模型性能动态调整每轮剪枝比例。
- 典型应用:
- 高精度需求场景:在医疗图像分类中,剪枝后的ResNet-18需保持95%以上准确率。
- 大规模模型:对BERT等千亿参数模型进行剪枝时,需避免灾难性遗忘。
- 优势:
- 性能损失更小(如剪枝70%后准确率仅下降2%)。
3. 正则化驱动剪枝(Regularization-Driven Pruning)
- 原理:在训练过程中引入稀疏性约束,使模型自然学习到稀疏结构。
- 技术实现:
- L1正则化:在损失函数中添加权重的L1范数项(如λ∑|w|)。
- Group Lasso:对通道或滤波器组施加L2,1范数约束,实现结构化稀疏。
- 动态稀疏训练:在训练过程中逐步增加稀疏性(如RigL算法)。
- 典型应用:
- 端到端剪枝:直接训练出稀疏模型,避免剪枝-微调的迭代过程。
- 动态网络:结合动态路由(如SkipNet)实现运行时自适应剪枝。
- 优势:
- 剪枝后模型无需微调即可保持性能(如MobileNetV3剪枝50%后准确率不变)。
三、基于剪枝目标的策略
1. 性能保持型剪枝(Accuracy-Preserving Pruning)
- 目标:在剪枝后模型性能(如准确率)与原始模型基本持平。
- 技术手段:
- 敏感度分析:计算每层权重对输出的敏感度(如Taylor展开近似)。
- 知识蒸馏:用原始模型作为教师模型指导剪枝后模型训练。
- 典型案例:
- 图像分类:在CIFAR-10上,剪枝后的ResNet-20准确率仅下降0.3%。
- 自然语言处理:对BERT进行通道剪枝后,GLUE基准分数下降≤1%。
2. 资源约束型剪枝(Resource-Constrained Pruning)
- 目标:在满足特定资源约束(如FLOPs、内存)下最大化性能。
- 技术手段:
- 硬件感知剪枝:针对目标硬件优化剪枝策略(如移动端优先剪枝全连接层)。
- 多目标优化:使用NSGA-II等算法在性能与效率间权衡。
- 典型案例:
- 移动端部署:在华为麒麟980上,剪枝后的MobileNetV2推理延迟降低40%。
- 实时系统:在无人机视觉中,剪枝后的YOLOv4模型功耗降低30%。
3. 任务导向型剪枝(Task-Oriented Pruning)
- 目标:针对特定任务优化剪枝策略(如分类、检测、分割)。
- 技术手段:
- 任务相关剪枝:保留对任务关键的特征(如目标检测中保留空间特征)。
- 动态剪枝:根据输入数据动态调整剪枝策略(如视频中仅剪枝背景帧)。
- 典型案例:
- 医学影像:在CT图像分割中,剪枝后的U-Net模型Dice系数仅下降0.5%。
- 自动驾驶:在点云检测中,剪枝后的PointPillars模型召回率保持98%。
四、剪枝策略对比与选择建议
| 策略类型 | 核心方法 | 适用场景 | 典型工具 | 性能-效率折中 |
|---|---|---|---|---|
| 非结构化剪枝 | 权重幅值/梯度幅值剪枝 | 稀疏硬件支持的研究场景 | PyTorch Pruning | 高压缩率,低推理加速 |
| 结构化剪枝 | 通道剪枝/层剪枝 | 移动端/嵌入式设备部署 | TensorFlow Model Optimization | 中等压缩率,高推理加速 |
| 迭代剪枝 | 渐进式剪枝+微调 | 高精度需求的工业场景 | NVIDIA NeMo | 低性能损失,高开发成本 |
| 正则化驱动剪枝 | L1正则化/动态稀疏训练 | 端到端模型压缩 | HuggingFace Optimum | 无需微调,训练时间增加 |
| 硬件感知剪枝 | 敏感度分析+多目标优化 | 特定硬件(如ARM/NVIDIA Jetson)部署 | TVM AutoTVM | 硬件适配性强,通用性差 |
五、剪枝策略的未来趋势
- 自动化剪枝:结合AutoML技术自动搜索最优剪枝策略(如Google的NAS-Pruning)。
- 动态剪枝:根据输入数据实时调整模型结构(如MIT的Once-for-All网络)。
- 联合优化:将剪枝与量化、知识蒸馏等技术结合(如Slimmable Networks)。
- 可解释性剪枝:基于神经科学理论剪枝冗余神经元(如基于突触可塑性原理)。
六、总结与建议
- 研究场景:优先选择非结构化剪枝+Hessian矩阵方法,深入分析模型冗余性。
- 工业部署:采用结构化剪枝+迭代微调,确保性能与效率的平衡。
- 硬件适配:在NVIDIA GPU上优先使用稀疏剪枝,在ARM CPU上使用通道剪枝。
- 数据敏感型任务:结合任务导向剪枝与知识蒸馏,避免关键特征丢失。
通过合理选择剪枝策略,可在ResNet-50等模型上实现50%以上的FLOPs减少,同时将准确率损失控制在1%以内,为深度学习模型的落地应用提供关键支持。
评估方法和关键指标
评估模型剪枝的效果是确保剪枝策略有效性的关键步骤,需从性能、效率和部署可行性等多维度综合考量。
一、核心评估维度与指标
1. 模型性能指标
- 分类任务
- 准确率(Accuracy):直接反映模型在测试集上的预测正确率,是基础指标。
- 精确率(Precision)/召回率(Recall)/F1分数:在类别不平衡时(如医疗诊断、欺诈检测),需重点关注。
- Top-K准确率:在推荐系统等场景中,评估模型在前K个预测中的命中率。
- 回归任务
- 均方误差(MSE)/平均绝对误差(MAE):衡量预测值与真实值的偏差。
- R²分数:反映模型对数据方差的解释能力。
- 鲁棒性评估
- 对抗样本测试:在剪枝后模型上施加对抗扰动(如FGSM攻击),验证其防御能力是否下降。
- 噪声数据测试:在输入数据中添加高斯噪声,观察模型性能变化。
2. 模型效率指标
- 计算效率
- 推理时间(Inference Time):在目标硬件(如CPU/GPU/移动端)上测量单样本推理耗时。
- FLOPs(浮点运算数):计算模型推理所需的浮点运算量,评估理论计算复杂度。
- 存储效率
- 模型大小(Model Size):剪枝后模型的参数总量(如MB/GB),直接影响部署成本。
- 稀疏性(Sparsity):非结构化剪枝中,统计稀疏矩阵中零值比例(如90%稀疏性表示90%权重为零)。
- 硬件效率
- 内存占用(Memory Footprint):运行模型时所需的内存峰值,尤其在移动端设备中至关重要。
- 能耗(Energy Consumption):在嵌入式设备上测量推理过程中的功耗(如mAh/推理)。
3. 部署可行性指标
- 硬件兼容性
- 稀疏矩阵支持:检查目标硬件是否支持稀疏矩阵运算(如NVIDIA TensorRT的稀疏内核)。
- 量化友好性:剪枝后模型是否易于进一步量化(如INT8量化),以实现更高压缩率。
- 部署流程
- 推理引擎适配:验证模型在TensorRT、ONNX Runtime等框架中的兼容性。
- 延迟与吞吐量:在目标设备上测试模型的实际吞吐量(样本/秒)和端到端延迟。
二、评估方法与工具
1. 对比实验设计
- 基线模型:
- 使用与剪枝模型相同的架构和训练策略,但未进行剪枝的原始模型。
- 示例:在ResNet-50上对比剪枝前后在ImageNet上的Top-1准确率。
- 消融实验:
- 对比不同剪枝比例(如30%、50%、70%)或策略(如通道剪枝 vs. 权重剪枝)的效果。
- 示例:在MobileNetV2上测试不同剪枝比例下的推理时间与准确率折中。
2. 自动化评估工具
- PyTorch Pruning工具包:
- 提供
torch.nn.utils.prune模块,支持非结构化/结构化剪枝,并内置稀疏性统计功能。
- 提供
- TensorFlow Model Optimization Toolkit:
- 集成剪枝、量化、聚类等压缩技术,支持自动化评估流程。
- NVIDIA Deep Learning Examples:
- 提供针对不同硬件的剪枝模型部署代码,直接输出推理延迟和内存占用。
3. 可视化分析
- 性能-效率权衡曲线:
- 以模型大小为横轴,准确率为纵轴,绘制剪枝后模型的帕累托前沿。
- 示例:在EfficientNet上,通过调整剪枝比例生成多组数据点,选择最优权衡点。
- 权重分布热力图:
- 可视化剪枝前后权重的分布变化,验证剪枝策略是否有效去除了冗余权重。
三、实际应用中的评估策略
1. 移动端/嵌入式设备
- 场景:在资源受限的设备(如智能手机、IoT传感器)上部署模型。
- 评估重点:
- 模型大小:需满足设备存储限制(如≤10MB)。
- 推理时间:需满足实时性要求(如≤100ms/帧)。
- 能耗:需通过功率分析仪测量实际功耗。
- 示例:在Raspberry Pi 4上部署剪枝后的MobileNetV3,测量其运行目标检测任务的FPS和电池续航。
2. 云端推理
- 场景:在数据中心处理大规模数据(如视频流分析、推荐系统)。
- 评估重点:
- 吞吐量:需优化模型以最大化服务器集群的并行处理能力。
- 成本效益:需计算剪枝后模型在AWS/Azure上的每小时推理成本(如$0.01/千次推理)。
- 示例:在ResNet-152上应用剪枝,将模型部署到AWS p3.2xlarge实例,对比剪枝前后的每小时成本和QPS。
3. 边缘计算
- 场景:在网关设备(如5G基站、智能摄像头)上部署模型。
- 评估重点:
- 延迟:需满足低延迟要求(如≤20ms)。
- 离线能力:需支持在断网情况下运行。
- 示例:在NVIDIA Jetson AGX Xavier上部署剪枝后的YOLOv5,测试其在本地视频分析中的延迟和准确性。
四、评估结果分析与决策
1. 关键决策点
- 性能-效率权衡:
- 接受范围:若剪枝后模型准确率下降≤1%,但推理时间减少50%,可视为成功。
- 失败案例:若剪枝70%后模型准确率下降10%,则需调整剪枝策略(如减少剪枝比例或改用结构化剪枝)。
- 硬件适配性:
- 支持稀疏计算:若目标硬件支持稀疏矩阵运算,可优先采用非结构化剪枝以获得更高压缩率。
- 不支持稀疏计算:需采用结构化剪枝(如通道剪枝)以确保实际加速。
2. 迭代优化流程
- 初始剪枝:选择保守剪枝比例(如30%),评估性能与效率。
- 性能恢复:若准确率下降明显,增加微调轮次或使用知识蒸馏。
- 逐步剪枝:以10%为步长逐步增加剪枝比例,直至性能或效率达到目标。
- 最终验证:在目标硬件上测试剪枝后模型的实际部署效果。
五、案例参考
案例1:图像分类(ResNet-50 on ImageNet)
- 剪枝策略:通道剪枝,剪枝比例50%。
- 评估结果:
- 准确率:原始模型76.15%,剪枝后模型75.80%(下降0.35%)。
- 推理时间:原始模型12.3ms,剪枝后模型6.8ms(减少44.7%)。
- 模型大小:原始模型98MB,剪枝后模型49MB(减少50%)。
- 结论:剪枝后模型在保持高准确率的同时,显著提升了推理效率,适合部署到云端推理场景。
案例2:目标检测(YOLOv5 on COCO)
- 剪枝策略:非结构化剪枝,剪枝比例70%。
- 评估结果:
- mAP@0.5:原始模型55.2%,剪枝后模型53.8%(下降1.4%)。
- 推理时间:原始模型25ms,剪枝后模型10ms(减少60%)。
- 模型大小:原始模型27MB,剪枝后模型8.1MB(减少70%)。
- 结论:剪枝后模型在边缘设备上实现了实时推理,适合部署到智能摄像头等场景。
六、总结
评估模型剪枝效果需结合性能、效率和部署可行性,通过对比实验、自动化工具和可视化分析,在以下关键点上做出决策:
- 性能:确保准确率下降在可接受范围内(如≤1%)。
- 效率:优化推理时间和模型大小,满足目标硬件的约束。
- 部署:验证模型在目标环境中的实际运行效果,避免理论加速与实际不符。
通过系统化的评估流程,可实现模型剪枝在性能与效率之间的最佳平衡,为实际部署提供可靠支持。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献52条内容

所有评论(0)