模型剪枝-Network Slimming
模型剪枝的定义
模型剪枝是一种通过移除神经网络中不重要的权重或神经元来减少模型复杂度的技术。其目的是在保持模型性能的同时,降低计算资源和存储需求。
本文以经典论文:Learning Efficient Convolutional Networks through Network Slimming 来实现模型的剪枝操作。
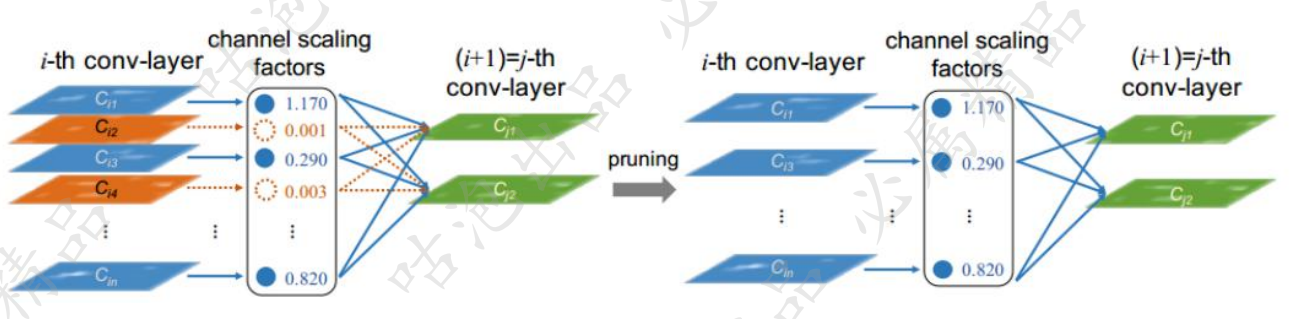
模型剪枝,就是在每个特征图中进行瘦身,筛选掉一些不必要的特征图,在原有框架内的基础上来减少特征图的数量,主要包括训练模型--模型剪枝-再次训练模型。
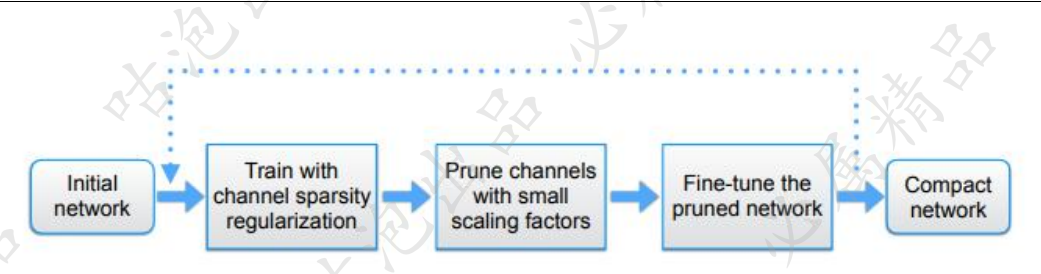
模型剪枝的过程
在论文中所提到了两个十分重要的知识点,一个是BatchNorm,一个是L1正则化,这里将分开讲解。
BatchNorm:
是一种对特征图进行标准化的操作,其目的是缓解“内部协变量偏移”(Internal Covariate Shift,加快收敛,提高训练稳定性和准确率。
主要是对一个通道上的所有特征先做归一化,再加上可以学习的γ缩放因子和β偏移参数。γ 代表一个通道的“重要性”;γ→0,表示这个通道几乎被抹去,其影响可以忽略;剪枝方法就可以利用这一点来“砍掉不重要的通道”。
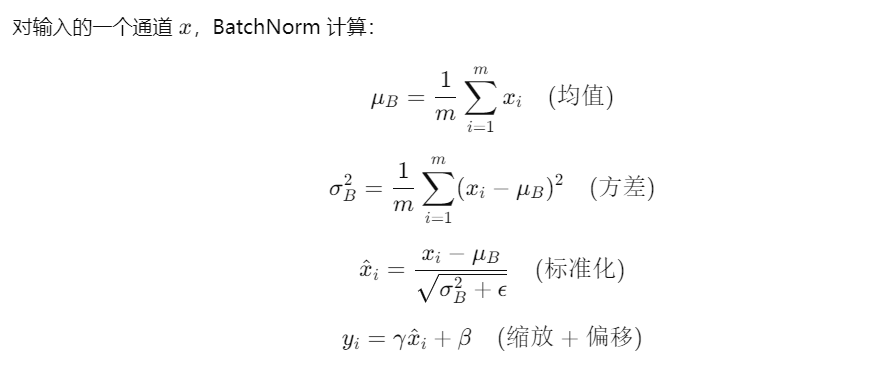
BatchNorm就相当于对每层的学习结果加上限制,BatchNorm要做的就是把越来越偏离的分布拉回来,再重新规范化到均值为0方差为1的标准正态分布,这样能够使得激活函数在数值层面更敏感,训练更快,但是经过BatchNorm后会将数值分布强制在非限制性函数的线性区域中,例如,ReLU 只有在输入 > 0 时才“工作”,标准化可能把输入压到负数区域,使 ReLU 死掉。这就需要γ 和 β 来恢复线性变换;它们本身可以学习出和没用 BN 时一样的分布,这保证了 BN 不限制模型表达能力
L1正则化:
L1 正则让模型中 BatchNorm 层的 **γ(通道缩放参数)**变稀疏(趋近于 0)

在训练损失中添加对 BN γ 的 L1,在训练中让 γ 更稀疏(很多 γ 接近 0),之后通过剪枝比率来减去γ中的最小通道,之后得到一个小的模型。
流程:
原始网络 + BN---->γ 上加 L1 正则训练(γ 稀疏)---->统计 γ → 设定剪枝比例 ----> 删除小 γ 的通道---->微调(Fine-tune)得到紧凑模型

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)