ThinkPHP框架封装Redis读写分离类完整指南

简介:ThinkPHP框架广泛用于高效Web应用开发。该压缩包提供了一套在ThinkPHP框架下实现Redis读写分离的类文件,对于应对大型和高并发Web应用至关重要。Redis作为高性能键值存储系统,配合读写分离策略,可以显著提升读写性能。本指南将详细介绍如何在ThinkPHP中封装实现Redis读写分离,包含配置管理、读写路由、事务处理、异常处理和性能优化等关键部分,并解释了读写分离的基本概念和实施步骤。通过本指南,开发者能够透明地利用封装好的类实现Redis的读写分离功能,简化代码并提升维护和扩展性。 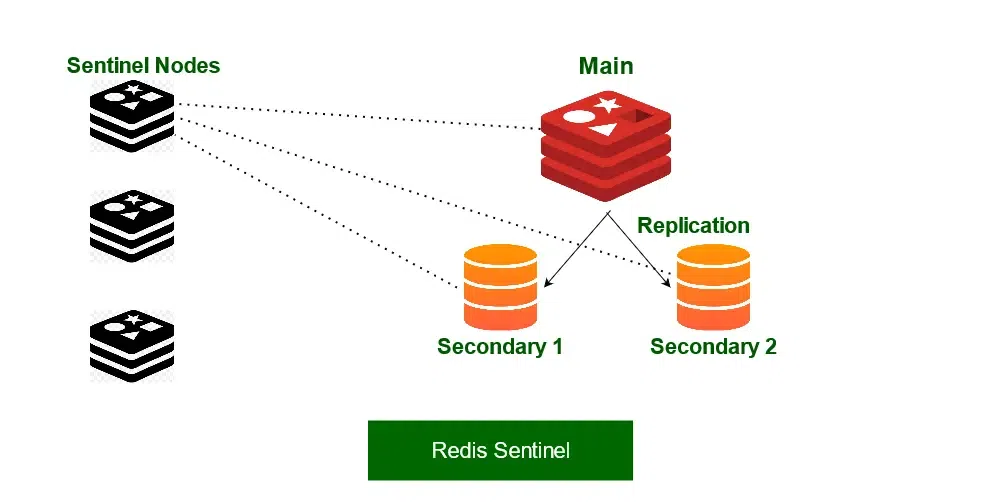
1. ThinkPHP框架简介
ThinkPHP是一个高级的、轻量级的PHP开发框架,它旨在提供快速、简洁且安全的Web开发体验。自2006年发布以来,ThinkPHP已成为中国广泛使用的PHP框架之一,具有活跃的社区支持和丰富的文档资料。
简要历史回顾
ThinkPHP的开发始于2006年,由中国的开发者团队LeadThink发起。经过多年的迭代和优化,已经发展到5.x版本,这个版本重构了框架的核心,并引入了更多现代化的设计理念和最佳实践。
核心特性概览
- MVC架构 :ThinkPHP遵循MVC(模型-视图-控制器)设计模式,将业务逻辑、数据和用户界面分离,促进代码的模块化和复用性。
- ORM集成 :它内置了对象关系映射(ORM)组件,允许开发者使用面向对象的方式进行数据库操作,简化数据访问层的编码。
- 模板引擎 :支持多种模板引擎,如ThinkTemplate和Smarty,提供灵活的模板设计与渲染能力。
- 扩展性与插件系统 :提供钩子、行为以及插件系统,方便开发者根据需要扩展框架功能或实现模块化开发。
开发者视角
对于开发者来说,ThinkPHP的易用性和灵活性是其最大的吸引力。通过配置文件和约定优于配置的原则,新手可以快速上手。同时,丰富的文档和社区资源为开发者在遇到问题时提供了有效的支持。
在本文接下来的章节中,我们将进一步深入了解如何使用ThinkPHP框架搭建高效、稳定的Web应用,并探讨如何通过各种优化策略提高应用程序的性能。
2. Redis读写分离概念
2.1 Redis读写分离的基本原理
2.1.1 读写分离的定义
Redis读写分离是一种数据库架构模式,通过将读和写操作分离到不同的服务器上,来提高系统的性能和可用性。在Redis的上下文中,这种模式通常涉及到一个主服务器(master)处理写请求,而多个从服务器(slave)处理读请求。读写分离能有效分散压力,允许主服务器专注于数据修改操作,同时从服务器可以分布地满足读取数据的需求。
2.1.2 读写分离的优势分析
读写分离的优势主要体现在以下几个方面:
- 提高性能 :读操作往往比写操作更为频繁,通过分发到多个从服务器上,可以大幅提升系统处理读请求的能力,特别是当数据被频繁读取时。
- 提高可用性 :如果主服务器出现故障,从服务器可以继续提供读服务,这样整体的系统可用性得到提升。
- 扩展性强 :读写分离架构支持水平扩展,可以增加更多的从服务器来应对不断增长的读请求负载。
2.2 Redis读写分离的常见模式
2.2.1 基于中间件的读写分离
基于中间件的读写分离是指通过中间件来管理主从服务器之间的数据复制和请求转发。常见的中间件有Twemproxy、Codis、Redis Sentinel等。这类中间件通常具备以下特点:
- 自动故障转移 :能够在主服务器出现故障时自动将从服务器升级为主服务器,保证服务的连续性。
- 负载均衡 :合理分发读写请求到不同的服务器上,减轻单一服务器的压力。
- 配置管理 :简化Redis主从架构的配置和管理,对应用透明。
示例代码:
-- 示例Lua脚本:使用Codis进行读写分离
if is_write_request() then
  codis:send_to_write_group()
else
  codis:send_to_read_group()
end
2.2.2 基于客户端的读写分离
客户端读写分离是在应用层实现的。在应用代码中,根据操作的类型,决定请求发送到主服务器还是从服务器。与中间件方案相比,客户端方案的优点是容易实现,缺点是每处代码修改都需要考虑读写分离的逻辑,且扩展性较差。
示例代码:
# 示例Python代码:基于客户端的读写分离逻辑
def get_client(is_read_only):
    if is_read_only:
        return connect_to_slave()  # 连接到从服务器
    else:
        return connect_to_master()  # 连接到主服务器
通过以上两种模式的实现,可以见到Redis读写分离的有效性,以及如何在不同的场景下选择合适的读写分离策略。无论选择哪种策略,实现读写分离的最终目的是为了提高系统的整体性能和稳定度。
3. 主从库配置管理
3.1 主从复制的配置与部署
3.1.1 主库的配置步骤
Redis主库配置是实施主从复制的关键步骤。主库的作用是负责写入操作并复制数据到从库。以下是主库配置步骤的详细说明:
首先,需要在Redis的配置文件 redis.conf 中找到与复制相关的配置项,并做适当修改。通常情况下,将主库配置为无密码可读或设置特定密码。
# 指定端口
port 6379

# 设置保护模式,关闭保护模式可以让远程客户端连接
protected-mode no

# 设置密码,若要设置密码则去掉注释,并替换YOUR_PASSWORD为真实密码
requirepass YOUR_PASSWORD
接下来,需要确保主库的配置中开启了持久化。例如,使用RDB快照进行数据持久化:
# 快照持久化配置
save 900 1
save 300 10
save 60 10000
这表示在900秒内至少有1个key发生变化、300秒内至少有10个key发生变化、60秒内至少有10000个key发生变化时,会触发RDB快照。需要根据实际业务调整这些配置。
3.1.2 从库的配置与同步
从库的配置相对简单,主要目的是连接到主库并同步数据。以下是在 redis.conf 中从库的配置方法:
# 指定端口
port 6380

# 设置从库模式并指定主库的地址和端口
slaveof <master-ip> <master-port>

# 设置连接主库的密码
masterauth <password>
这里 <master-ip> 和 <master-port> 是主库的IP地址和端口号, <password> 是主库的密码。如果主库没有设置密码,则不用指定 masterauth 。
完成配置后,需要重启从库Redis服务以应用配置更改。当从库重启后,它将尝试连接主库并开始数据同步。
redis-cli shutdown
redis-server redis.conf
从库启动后,可以通过执行 INFO replication 命令来检查从库的同步状态,确保配置正确。
3.2 主从库的状态监控与管理
3.2.1 监控主从同步状态
监控主从同步状态对于维护数据一致性非常重要。Redis提供了 INFO replication 命令来获取复制相关的统计信息。以下是一个监控命令的示例:
redis-cli INFO replication
该命令将返回主从库的复制状态信息,包括:
- 当前连接的从库数量。
- 从库的IP地址和端口号。
- 复制偏移量,即从库已经同步的数据量。
- 主从复制流中最后接收到的命令和字节。
这些信息帮助我们了解从库是否已经完全同步数据,以及是否需要进行故障转移。
3.2.2 主从切换策略与实践
在某些情况下,可能需要将从库提升为新的主库,这通常被称为故障转移。以下是一些常见的主从切换策略:
-
自动故障转移 :在高可用架构中,可以使用哨兵(Sentinel)系统来自动检测主库的故障,并自动进行故障转移。
-
手动故障转移 :管理员也可以在主库发生故障时手动执行故障转移。这通常通过修改从库的配置并将其设置为新的主库来实现。
# 在从库执行以下命令将当前的从库提升为新的主库
redis-cli config set slaveof <old-master-ip> <old-master-port>
确保替换 <old-master-ip> 和 <old-master-port> 为原主库的IP和端口。这个命令会立即生效,原从库会切断与原主库的连接,并开始接受写操作,同时将其标记为新的主库。
3.2.3 主从切换的最佳实践
在执行主从切换时,以下最佳实践可以帮助减少数据丢失和避免服务中断:
- 确保完全同步 :在主库正常运行时,确保所有从库都已完全同步主库数据。
- 维护连接池 :确保应用程序连接池中的连接在故障转移后可以正常工作。
- 更新配置 :故障转移后,更新应用程序的配置文件,指向新的主库地址。
- 重启服务 :如果需要,重启相关服务以应用新的配置。
通过遵循上述步骤,管理员可以确保Redis集群在出现主库故障时仍能平稳过渡到新的主库,同时保持数据的一致性和服务的可用性。
4. Redis连接对象创建
在这一章节中,我们将深入探讨Redis连接对象创建的细节。这个主题是任何希望高效使用Redis的开发者都必须理解的核心概念。我们将从连接池的实现与管理开始,然后深入到连接对象的生命周期管理。
4.1 连接池的实现与管理
4.1.1 连接池的基本概念
连接池是一种资源池,用于存储由多个客户端共享的数据库连接。它允许多个进程或线程重用一组有限数量的物理连接,从而避免了为每个连接请求建立新连接的开销。在处理大量短时间的数据库操作时,连接池能显著提高系统的性能。
在Redis的上下文中,连接池是管理Redis连接的重要组成部分。它负责跟踪可用的连接,管理连接的创建和回收,并提供给需要与Redis服务器通信的客户端使用。使用连接池可以减少因频繁创建和销毁连接带来的性能损耗。
4.1.2 连接池的创建和维护
在许多编程语言中,连接池通常是通过库或框架提供的抽象来实现的。在实际的使用中,开发者会调用特定的API来获取或释放连接。以下是一个使用伪代码来创建和维护连接池的简单示例:
class RedisConnectionPool {
    private List<RedisConnection> connections;
    private int maxConnections;

    function __construct(int maxConn) {
        connections = new List<RedisConnection>();
        maxConnections = maxConn;
    }

    function getConnection() {
        if (connections.isEmpty()) {
            if (connections.length < maxConnections) {
                connections.add(createNewConnection());
            } else {
                throw new Exception("Connection pool is full");
            }
        }
        return connections.remove(0);
    }

    function releaseConnection(RedisConnection conn) {
        connections.add(conn);
    }

    private RedisConnection createNewConnection() {
        // 实现创建新Redis连接的逻辑
    }
}
在这个示例中,我们定义了一个简单的连接池类 RedisConnectionPool 。它有两个主要的组成部分:
-
connections:一个列表,用于存储当前可用的Redis连接。 -
maxConnections:连接池中允许的最大连接数。
getConnection() 方法负责从连接池中获取一个可用的连接。如果连接池中没有可用连接,它将尝试创建一个新的连接,前提是当前连接数未达到 maxConnections 限制。
releaseConnection() 方法用于释放一个连接,将其重新放入连接池中供后续使用。
实际代码实现中,还需要考虑线程安全、连接的健康检查、超时管理等重要方面。
4.2 连接对象的生命周期管理
4.2.1 创建连接对象的时机
连接对象的创建时机是影响Redis性能的关键因素。在许多场景下,开发者可能会根据应用的实际需求来动态创建和销毁连接。然而,在高并发的环境下,频繁地创建和销毁连接会导致额外的性能开销。
为了优化性能,通常的做法是预先创建一定数量的连接对象,并在应用启动时将它们加入到连接池中。这样,连接对象就可以被重用,从而避免了频繁的创建和销毁操作。
4.2.2 连接对象的回收机制
连接对象的回收机制是保证连接池健康运作的重要组成部分。当客户端完成对Redis的操作后,它应该将连接对象归还给连接池,而不是销毁连接对象。这样,连接对象可以被其他客户端重用,而不是被无谓地丢弃。
在回收连接对象时,应该先检查该连接对象是否仍然有效。例如,检查连接是否还处于活跃状态,或者是否有执行命令时产生的错误。只有确认连接对象处于健康状态后,才能将其归还到连接池中。
在某些情况下,如果检测到连接对象存在问题,例如连接超时或响应错误,则应该销毁该连接对象,避免将其回收到连接池中导致其他客户端使用失败。
function returnConnectionToPool(RedisConnection conn) {
    if (conn.isValid()) {
        pool.releaseConnection(conn);
    } else {
        destroyConnection(conn);
    }
}

function destroyConnection(RedisConnection conn) {
    // 实现销毁已损坏连接的逻辑
}
在这个示例中, returnConnectionToPool 函数用于归还连接到连接池。它首先检查连接对象是否有效,如果有效,则调用 releaseConnection 方法将其归还;如果无效,则调用 destroyConnection 方法销毁连接对象。
这个过程确保了连接池中始终保持着健康的连接对象,从而维持了应用的稳定性和性能。
通过本章节的介绍,我们了解了连接池的基本概念以及创建和维护连接池的策略。此外,还探讨了连接对象的生命周期管理,包括创建连接对象的时机和连接对象的回收机制。在下一章中,我们将讨论如何实现读写操作的路由逻辑,以进一步优化Redis的性能。
5. 读写操作路由逻辑
读写操作路由逻辑是实现Redis读写分离的核心。我们需要理解路由策略的设计原则,并通过具体代码实现读写操作的路由。
5.1 路由策略的设计原则
路由策略的设计需要满足两个基本目标:保证读写操作的高可用性和优化性能。
5.1.1 路由逻辑的优化目标
路由逻辑的优化目标主要集中在两个方面:一是减少延迟,提高系统响应速度;二是提升系统的吞吐量,以应对高并发的场景。为了实现这些目标,我们通常需要考虑以下几点:
- 负载均衡 :在多个读服务器间合理分配读请求,以实现负载均衡。
- 故障转移 :当写服务器出现故障时,能够迅速切换到新的写服务器,保证数据的一致性和可用性。
5.1.2 高可用读写路由策略
高可用的读写路由策略需要综合考虑读写分离的性能优化与系统稳定性的双重需求。以下是一些常用的策略:
- 读写分离 :在读操作和写操作之间进行分离,使用专门的从库处理读请求,而主库则主要用于写操作和部分关键的读操作。
- 故障检测与自动切换 :通过监控系统检测主库的健康状况,一旦主库出现问题,立即进行故障转移,切换到备用的主库。
5.2 实现读写分离的代码实践
读写分离的实现,需要在应用层面上进行读写路由的逻辑控制。我们可以使用编程语言中的特定库或框架来实现这些路由逻辑。
5.2.1 读操作的路由实现
在读操作中,为了实现负载均衡和高可用,我们可以使用连接池来管理数据库连接,根据负载和响应时间动态选择从库。下面是一个简单的读操作路由示例:
import redis

# 创建一个连接池实例
pool = redis.ConnectionPool(host='read_host', port=6379, db=0)

# 创建连接对象
conn = redis.StrictRedis(connection_pool=pool)

# 执行读操作
data = conn.get('some_key')
在这个示例中,我们创建了一个连接池对象,指定了从库的地址和端口。之后,我们通过连接池实例化一个Redis连接对象,并通过该对象来执行读操作。连接池会根据预设的路由逻辑自动选择一个健康的从库进行连接。
5.2.2 写操作的路由实现
写操作通常要确保数据的一致性和可靠性,因此需要写入到主库。在实现上,可以对写操作的路由逻辑进行特殊处理,确保所有的写请求都发送到主库。以下是一个简单的写操作路由示例:
import redis

# 创建连接池,指定主库地址和端口
pool = redis.ConnectionPool(host='write_host', port=6379, db=0)

# 创建连接对象
conn = redis.StrictRedis(connection_pool=pool)

# 执行写操作
conn.set('some_key', 'some_value')
在这个示例中,我们与读操作类似,使用连接池创建了连接对象。不同的是,我们指定了主库的地址,确保所有的写操作都会路由到主库。
为了实现更高级的读写分离策略,可以使用中间件或客户端库来进一步抽象路由逻辑,使得系统可以根据实际的读写需求自动选择最合适的库。这种策略的实现,既保证了系统的可扩展性,也保证了系统的维护性。
6. 事务处理与原子性保证
在数据库管理系统中,事务是执行一系列操作的机制,这些操作要么完全执行,要么完全不执行,保证了数据的一致性和可靠性。Redis作为一款内存键值存储数据库,虽然其事务功能与传统的关系型数据库相比有所不同,但同样提供了保证多个操作原子性的机制。本章节将深入探讨Redis事务处理和原子性保证的技术细节。
6.1 Redis事务的基本操作
Redis通过MULTI, EXEC, WATCH等命令实现了事务功能。事务允许将多个命令打包,然后一次性、按顺序地执行。这一机制确保了多个命令的执行过程中不会被其他客户端命令插入。
6.1.1 MULTI, EXEC, WATCH命令解析
-
MULTI命令用于开启一个事务块,它会将客户端之后发送的命令入队。 -
EXEC命令用于执行事务块内的所有命令,如果某个命令执行失败,后续命令不会执行。 -
WATCH命令用于监视一个或多个键,如果在事务执行前这些键被其他客户端修改,那么事务将被取消。
6.1.2 Redis事务的使用场景
Redis事务主要适用于需要多个命令按顺序执行的场景,以保证操作的原子性。例如,银行转账操作,需要确保从一个账户扣除金额和向另一个账户增加金额这两个操作要么同时成功,要么同时失败,避免数据不一致。
6.2 原子性保证的高级技巧
在某些复杂的场景中,Redis原生的事务功能可能不足以应对需求,此时可采用一些高级技巧来保证操作的原子性,如分布式锁和Lua脚本。
6.2.1 分布式锁的实现
分布式锁是一种同步机制,用于在分布式系统中控制多个进程或线程访问共享资源。在Redis中,可以使用 SETNX (SET if Not eXists)命令来实现分布式锁:
# 尝试获取锁
SETNX lock_key unique_lock_value
# 设置锁的过期时间
EXPIRE lock_key lock_timeout
如果 SETNX 命令返回1,说明客户端成功获取到锁,可以执行需要的操作。如果返回0,则表示锁已被其他客户端持有。操作完成后,客户端应删除锁:
DEL lock_key
6.2.2 基于Lua脚本的原子操作
Lua脚本提供了一种在Redis内部执行多条命令的方法,而无需担心中间会有其他客户端命令介入。Redis保证脚本是原子执行的,即要么全部执行,要么全部不执行。以下是一个Lua脚本示例,实现了一个简单的计数器增加操作:
redis.call('incr',KEYS[1])
redis.call('expire',KEYS[1],60)
这个脚本将某个键的值增加1,并设置键的过期时间为60秒。使用Lua脚本不仅保证了操作的原子性,还能减少客户端与服务器之间的通信次数,提高性能。
小结
Redis提供了基本的事务机制和一些高级的原子操作工具,如分布式锁和Lua脚本,以满足不同场景下的原子性保证需求。理解和掌握这些机制,对于开发高性能和高可靠性的应用至关重要。
在下一章节,我们将探索Redis的异常处理机制,包括错误捕获、异常分类以及异常处理的最佳实践。
简介:ThinkPHP框架广泛用于高效Web应用开发。该压缩包提供了一套在ThinkPHP框架下实现Redis读写分离的类文件,对于应对大型和高并发Web应用至关重要。Redis作为高性能键值存储系统,配合读写分离策略,可以显著提升读写性能。本指南将详细介绍如何在ThinkPHP中封装实现Redis读写分离,包含配置管理、读写路由、事务处理、异常处理和性能优化等关键部分,并解释了读写分离的基本概念和实施步骤。通过本指南,开发者能够透明地利用封装好的类实现Redis的读写分离功能,简化代码并提升维护和扩展性。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献23条内容

所有评论(0)