【读点论文】OPEN-SET RECOGNITION: A GOOD CLOSED-SET CLASSIFIER IS ALL YOU NEED?找个更好的闭集分类器,使用logits进行分类,有用?
OPEN-SET RECOGNITION: A GOOD CLOSED-SET CLASSIFIER IS ALL YOU NEED?
ABSTRACT
- 识别测试样本是否属于分类器训练集中的某个语义类的能力对于模型的实际部署至关重要。这项任务被称为开集识别(OSR),近年来受到了极大的关注。在本文中,我们首先证明了分类器做出“none-of-above”决策的能力与其在闭集类上的准确性高度相关。我们发现这种关系适用于损失目标和架构,并进一步证明了标准OSR基准测试和大规模ImageNet评估的趋势。其次,我们使用这种相关性,通过提高其闭集精度来提高最大logit得分OSR“基线”的性能,并利用这种强大的基线在许多OSR基准上实现最先进的水平。类似地,我们通过提高其闭集精度来提升现有最先进方法的性能,但由此产生的与强基线的差异是微不足道的。我们的第三个贡献是提出了“语义转移基准”(SSB),与相关子领域中也考虑的其他形式的分布转移(如分布外检测)相比,它更好地考虑了检测语义新颖性的任务。在这项新的评估中,我们再次证明了强基线和现有的最先进的项目之间的差异可以忽略不计。项目页面:Open-Set Recognition: a Good Closed-Set Classifier is All You Need?。
- 通过提升闭集分类器的性能来增强开放集识别能力,特别是使用最大对数几率分数(MLS)作为开放集检测的指标,而不是传统的软 max 概率。闭集分类器的准确性与开放集性能高度相关。这可能是因为更好的闭集分类器具有更好的校准能力,能够更可靠地区分已知和未知类别。底层逻辑可能涉及模型校准(model calibration),即良好的校准模型能够正确估计不确定性,从而在遇到未知类别时给出低置信度。此外,使用对数几率(logits)而非归一化的软 max 概率,保留了特征范数的信息,这有助于检测未知样本,因为未知样本的特征范数通常较低。
- 作者通过改进闭集训练策略,如更长的训练时间、更好的数据增强(如 RandAugment)、标签平滑和余弦学习率调度,提升闭集分类器的准确性。同时,将开放集检测的评分规则从最大软 max 概率改为最大对数几率,以利用未归一化的原始输出信息。论文表示提升闭集分类器的性能是增强 OSR 的有效途径,而复杂的 OSR 方法可能并未显著超越简单的基线,除非在特定设置下。
- 良好的闭集分类器更 “自信”,对已知类别预测概率高,对未知类别预测概率低(即低置信度对应未知样本)。未知样本的特征范数通常低于已知样本,对数几率(logits)保留了这一信息,而软 max 归一化会消除该差异。软 max 将输出归一化为概率分布,掩盖了特征向量的绝对 magnitude(如已知样本特征范数更大)。直接使用最大对数几率(MLS)作为评分,可利用特征范数差异,未知样本的对数几率普遍较低,从而更易与已知样本区分。 S ( x ) = max y ∈ C logit y ( x ) S(x) = \max_{y \in C} \text{logit}_y(x) S(x)=maxy∈Clogity(x)其中, logit y ( x ) \text{logit}_y(x) logity(x) 为类别 y 的原始输出对数几率。
- 闭集训练策略改进:使用 RandAugment(自动数据增强)提升模型泛化能力。标签平滑(Label Smoothing)缓解过拟合,提升模型校准能力。余弦退火学习率(Cosine Annealing)结合重启(Warm Restarts),避免过早收敛。训练至 600 epochs(传统基线仅 30-100 epochs),充分优化闭集性能。
INTRODUCTION
-
鉴于现代深度学习系统在闭集视觉识别任务上的成功,自然的下一个挑战是开集识别(OSR) 。在封闭设置中,模型的任务是识别在训练和测试阶段保持不变的一组类别。在更现实的开放集设置中,模型不仅必须能够区分训练类,还必须指示图像是否来自它尚未遇到的类。OSR问题最初是在(Towards open set recognition)正式提出的,此后激发了大量的研究。OSR的标准基线是用已知类别的交叉熵损失训练的模型。在测试时,softmax概率向量的最大值用于决定输入是否属于已知类。我们此后将这种方法称为“基线”或“最大软最大概率(MSP)基线”。大多数现有的文献报道在重新设计的图像识别数据集的标准基准上显著优于该OSR基线。
-
在本文中,我们通过询问训练有素的闭集分类器是否可以像最近的算法一样执行,并通过分析基准数据集,重新评估这些方法。为了做到这一点,我们首先研究分类器的闭集和开集性能之间的关系。3).尽管人们可能期望更强的闭集分类器过度适应训练类,所以表现不佳的,我们反而表明,闭集和开集的表现高度相关。我们表明这种趋势适用于数据集、目标和模型架构,并在ImageNet规模的评估中进一步展示了这种趋势。
-
其次,根据这一观察,我们表明可以通过提高分类器的闭集精度来提高分类器的开集性能,利用图像分类中的众多最新进展。具体来说,我们引入了一些策略,如更多的扩充、更好的学习率计划和标签平滑,这些策略显著提高了MSP基线(sec 4)的封闭集性能。我们还建议使用最大logit得分(MLS),而不是标准化的softmax概率,作为开放集指标。通过这些调整,我们推动基线变得与最先进的OSR方法具有竞争力或优于该方法,大大优于当前报告的基线数字。值得注意的是,在六个OSR基准数据集的四个上,我们超过了最先进的数字。
-
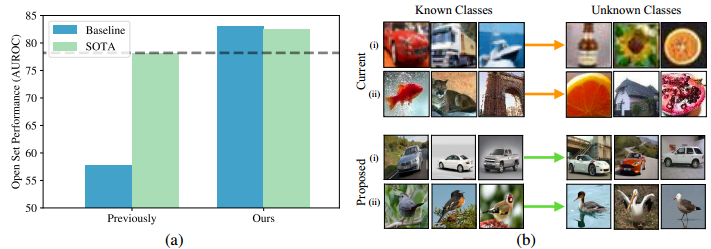
此外,我们将这些改进转移到以前的两个OSR方法,包括当前最先进的(Adversarial reciprocal points learning for open set recognition)。虽然这确实提高了其性能,但我们观察到与改进的“MLS”基线相比,差异可以忽略不计(见图1a)。这一发现很重要,因为它使我们能够更好地评估该领域最近报道的进展。
-
-
图1: (a)我们表明,我们可以推动基线绩效与最先进的方法竞争或超过最先进的方法(如图所示,ARPL + CS)。(b)我们提出了OSR的“语义转移基准”数据集,这是一个更大规模的数据集,并给出了构成“新类别”的精确定义。
-
-
最后,我们转向OSR的实验设置。目前的OSR基准都是小规模的,缺乏一个“视觉类”的具体定义。作为替代,我们提出了“语义转换基准”套件(SSB)。我们建议使用细粒度数据集,包括CUB 、Stanford Cars 和 FGVC-Aircraft ,它们都有语义类的明确定义(见图1b),以及基于完整 ImageNet 数据库的ImageNet规模的评估 。此外,我们构建了明确关注语义新颖性的开集分裂,我们希望它能更好地将这一研究途径与相关的机器学习子领域分开,如 分布外 和 异常检测 。我们提出的分割也提供了一个量化开放集难度的更好的方法;我们发现,不同的拆分导致开集表现的差异比当前的开集难度衡量标准“开放度” 大得多,后者只关注开集类别的数量。
RELATED WORK
-
开集识别。Scheirer等人的开创性工作正式确定了开集识别的任务,并启发了该领域的许多后续工作。基于极值理论(EVT)为OSR引入了第一个深度学习方法OpenMax。gan也被用于解决这一任务。OSRCI 生成与训练集中的图像相似但不属于任何已知类的图像,并使用生成的图像训练开集分类器。这项工作还建立了现有的OSR基准套件。 通过使用经过对抗性训练的鉴别器从开集图像中描绘封闭图像,利用真实的开集图像进行模型选择,从而实现强大的OSR性能。其他方法包括基于重建的方法 使用差的测试时间重构作为开集指标,以及基于原型的方法(P-odn: Prototype-based open deep network for open set recognition;Learning open set network with discriminative reciprocal points; Adversarial reciprocal points learning for open set recognition),其表示具有学习原型的已知类,并基于到原型的距离识别开集图像。
-
State-of-the-art. 在这项工作中,我们比较了在受控OSR环境中达到最先进水平的方法(没有用于训练或模型选择的额外数据)。据我们所知,这些方法是(对抗性互易点学习)和OpenHybrid,我们将在第二节中详细介绍。在本文中,我们展示了基线可以与上面列出的更复杂的方法相竞争或优于它们。最后,我们注意到最近的工作,我们不与他们进行比较,因为他们报告的性能低于 ARPL 和OpenHybrid。
-
Related subfields. OSR还与分布外(OOD)检测密切相关 ,新颖性检测 ,异常检测 和 新颖度类别发现 .在这些方法中,OOD可能是研究得最广泛的,并且在性质上与OSR相似。 OSR类似于 OOD 问题,在已知类别之间增加了一个多向分类组件。事实上,目前在这些设置之间的评估数据集中有明显的重叠,尽管由于不同的评估协议,交叉设置比较是困难的。具体来说,OOD设置允许在训练期间使用附加数据作为“OOD”数据的示例。在OOD基准上评估了他们的方法,尽管在训练期间无法获得额外的数据,但两者都显示出有竞争力的结果。
-
在本文中,我们通过提出一套新的基准来区分OSR问题和面向对象的设计以及其他相关领域。虽然面向对象设计涵盖了所有形式的分布变化,包括那些基于底层特征的变化,但OSR特指语义新奇。我们提出尊重这一区别的新基准。
CORRELATION BETWEEN CLOSED-SET AND OPEN-SET PERFORMANCE
-
人们可能会认为,更强的闭集分类器已经将其学习到的表示过度拟合到闭集类别,因此在OSR方面表现不佳。此外,现有文献在很大程度上分别考虑了闭集和开集任务,尽管闭集精度没有降低,但工作通常强调良好的开集性能。相反,在本节中,我们证明了分类器的闭集和开集性能是强相关的。我们首先在标准OSR基准(第3.1节)上对基线和最先进的方法进行了演示,然后在多个模型架构的大规模评估中进行了演示(第3.2节)。
-
开放式集合识别。我们将OSR问题形式化,并强调了它与闭集识别的区别。首先,考虑分类器 D t r a i n ={( x i , y i ) } i = 1 N ⊂ X × C D_{train}={(x_i,y_i)}^N _{i=1}⊂X×C Dtrain={(xi,yi)}i=1N⊂X×C 的标记训练集。这里,X是输入空间(例如图像),C 是“已知”类的集合。在闭集场景中,模型是在测试集上评估的,其中标签也是从同一组类中提取的,即 D t e s t − c l o s e d = { ( x i , y i ) } i = 1 M ⊂ X × C D_{test-closed}=\{(x_i,y_i)\}^M_{i=1}⊂X×C Dtest−closed={(xi,yi)}i=1M⊂X×C 。在闭集设置中,模型返回已知类上的分布,称为 p(y|X)。相反,在OSR中,测试图像也可能来自看不见的类 U,给出 D t e s t − o p e n = { ( x i , y i ) } i = 1 M ′ ⊂ X × ( C ∪ U ) D_{test-open}=\{(x_i,y_i)\}^{M′}_{i=1}⊂X×(C∪U) Dtest−open={(xi,yi)}i=1M′⊂X×(C∪U)。在开集设置中,除了返回已知类上的分布 p ( y ∣ x , y ∈ C ) p(y|x,y∈C) p(y∣x,y∈C) 外,该模型还返回一个分数 S ( y ∈ C ∣ x ) S(y∈C|x) S(y∈C∣x),以指示测试样本是否属于任何已知类。
-
闭集样本的 MLS(模型输出的各分类器对数似然的最大值)显著高于 OOD 样本。因此,直接用 MLS 作为判别指标,无需额外网络。在推理阶段,对输入样本计算模型输出的对数似然(Logits),取最大值作为 MLS。闭集样本的 MLS 通常较高,OOD 样本的 MLS 较低。通过验证集(闭集样本)确定 MLS 的阈值(如 95% TPR 对应的 FPR),低于阈值的样本判定为 OOD。
-
def detect_ood(model, image, threshold):
    with torch.no_grad():
        logits = model(image)  # 模型输出的对数似然(未归一化)
        mls = logits.max(dim=1).values  # 最大对数似然分数
        is_ood = (mls < threshold).item()  # 低于阈值则为OOD
    return is_ood
-
-
AUROC:接收者操作特征曲线下面积,衡量 OOD 检测整体性能。OSCR:开集分类率,衡量正确分类闭集样本且拒绝 OOD 样本的能力。Acc@95TPR:当闭集样本召回率(TPR)为 95% 时,OOD 样本的准确率(即正确拒绝率)。AUPR:精确率 - 召回率曲线下面积,关注正样本(OOD)的检测性能。
-
from sklearn.metrics import roc_curve, roc_auc_score, accuracy_score, average_precision_score
import numpy as np
def compute_auroc(open_set_preds, open_set_labels):
    auroc = roc_auc_score(open_set_labels, open_set_preds)
    print(f'AUROC: {auroc}')
    return auroc

def find_nearest(array, value):
    array = np.asarray(array)
    length = len(array)
    abs_diff = np.abs(array - value)
    t_star = abs_diff.min()
    equal_arr = (abs_diff == t_star).astype('float32') + np.linspace(start=0, stop=0.1, num=length)
    idx = equal_arr.argmax()
    return array[idx], idx
def acc_at_t(preds, labels, t):
    pred_t = np.copy(preds)
    pred_t[pred_t > t] = 1
    pred_t[pred_t <= t] = 0
    acc = accuracy_score(labels, pred_t.astype('int32'))
    return acc
def acc_at_95_tpr(open_set_preds, open_set_labels, thresholds, tpr):
    # Error rate at 95% TAR
    _, idx = find_nearest(tpr, 0.95)
    t = thresholds[idx]
    acc_at_95 = acc_at_t(open_set_preds, open_set_labels, t)
    print(f'Error Rate at TPR 95%: {1 - acc_at_95}')
    return acc_at_95

def compute_oscr(x1, x2, pred, labels):
    """
    :param x1: open set score for each known class sample (B_k,)
    :param x2: open set score for each unknown class sample (B_u,)
    :param pred: predicted class for each known class sample (B_k,)
    :param labels: correct class for each known class sample (B_k,)
    :return: Open Set Classification Rate
    """
    x1, x2 = -x1, -x2
    # x1, x2 = np.max(pred_k, axis=1), np.max(pred_u, axis=1)
    # pred = np.argmax(pred_k, axis=1)
    correct = (pred == labels)
    m_x1 = np.zeros(len(x1))
    m_x1[pred == labels] = 1
    k_target = np.concatenate((m_x1, np.zeros(len(x2))), axis=0)
    u_target = np.concatenate((np.zeros(len(x1)), np.ones(len(x2))), axis=0)
    predict = np.concatenate((x1, x2), axis=0)
    n = len(predict)
    # Cutoffs are of prediction values
    CCR = [0 for x in range(n + 2)]
    FPR = [0 for x in range(n + 2)]
    idx = predict.argsort()
    s_k_target = k_target[idx]
    s_u_target = u_target[idx]
    for k in range(n - 1):
        CC = s_k_target[k + 1:].sum()
        FP = s_u_target[k:].sum()
        # True	Positive Rate
        CCR[k] = float(CC) / float(len(x1))
        # False Positive Rate
        FPR[k] = float(FP) / float(len(x2))
    CCR[n] = 0.0
    FPR[n] = 0.0
    CCR[n + 1] = 1.0
    FPR[n + 1] = 1.0
    # Positions of ROC curve (FPR, TPR)
    ROC = sorted(zip(FPR, CCR), reverse=True)
    OSCR = 0
    # Compute AUROC Using Trapezoidal Rule
    for j in range(n + 1):
        h = ROC[j][0] - ROC[j + 1][0]
        w = (ROC[j][1] + ROC[j + 1][1]) / 2.0
        OSCR = OSCR + h * w
    print(f'OSCR: {OSCR}')
    return OSCR

def normalised_average_precision(y_true, y_pred):
    from sklearn.metrics.ranking import _binary_clf_curve
    fps, tps, thresholds = _binary_clf_curve(y_true, y_pred, pos_label=None, sample_weight=None)
    n_pos = np.array(y_true).sum()
    n_neg = (1 - np.array(y_true)).sum()
    precision = tps * n_pos / (tps * n_pos + fps * n_neg)
    precision[np.isnan(precision)] = 0
    recall = tps / tps[-1]
    # stop when full recall attained
    # and reverse the outputs so recall is decreasing
    last_ind = tps.searchsorted(tps[-1])
    sl = slice(last_ind, None, -1)
    precision, recall, thresholds = np.r_[precision[sl], 1], np.r_[recall[sl], 0], thresholds[sl]
    return -np.sum(np.diff(recall) * np.array(precision)[:-1])
def compute_aupr(open_set_preds, open_set_labels, normalised_ap=False):
    if normalised_ap:
        aupr = normalised_average_precision(open_set_labels, open_set_preds)
    else:
        aupr = average_precision_score(open_set_labels, open_set_preds)
    print(f'AUPR: {aupr}')
    return aupr
-
-
要加入温度缩放,可能需要在生成闭集预测后,应用温度缩放来校准置信度。温度缩放的基本思想是在 softmax 之前将 logits 除以一个温度参数 T,T>1 时会使 softmax 输出更平滑(降低置信度),T<1 时更尖锐(提高置信度)。通常 T 通过验证集上的交叉熵损失或 ECE(预期校准误差)来调整。因此,需要修改模型的前向过程,加入温度参数,并在验证阶段优化 T。除了温度缩放,还可以考虑其他校准方法,如 Platt Scaling(对每个类别单独校准)、Isotonic Regression(非参数校准),或者更复杂的方法如 Bayesian 校准。此外,OOD 检测的其他方法如基于似然的方法(如使用生成模型估计数据似然)、基于特征的方法(如使用预训练模型的特征分布)、或者基于对抗训练的方法 也可以结合使用。
BASELINE AND STATE-OF-THE-ART ON STANDARD BENCHMARKS
-
我们首先在文献中的标准基准数据集中对三种具有代表性的开放集识别方法进行了实验。这些方法包括标准MSP基线以及ARPL的两种变体 。我们使用开放集文献中的标准网络 ,这是一种类似于VGG架构的轻量级模型 ,我们此后称之为“VGG32”(详见附录D)。下面总结了这三种方法,然后描述了最常用的基准。
-
import torch
from torch import nn
class classifier32(nn.Module):
    def __init__(self, num_classes=10, feat_dim=128):
        super(self.__class__, self).__init__()
        if feat_dim is None:
            feat_dim = 128
        self.num_classes = num_classes
        self.conv1 = nn.Conv2d(3,       64,     3, 1, 1, bias=False)
        self.conv2 = nn.Conv2d(64,      64,     3, 1, 1, bias=False)
        self.conv3 = nn.Conv2d(64,     128,     3, 2, 1, bias=False)
        self.conv4 = nn.Conv2d(128,    128,     3, 1, 1, bias=False)
        self.conv5 = nn.Conv2d(128,    128,     3, 1, 1, bias=False)
        self.conv6 = nn.Conv2d(128,    128,     3, 2, 1, bias=False)
        self.conv7 = nn.Conv2d(128,    128,     3, 1, 1, bias=False)
        self.conv8 = nn.Conv2d(128,    128,     3, 1, 1, bias=False)
        self.conv9 = nn.Conv2d(128,    feat_dim,     3, 2, 1, bias=False)
        self.bn1 = nn.BatchNorm2d(64)
        self.bn2 = nn.BatchNorm2d(64)
        self.bn3 = nn.BatchNorm2d(128)
        self.bn4 = nn.BatchNorm2d(128)
        self.bn5 = nn.BatchNorm2d(128)
        self.bn6 = nn.BatchNorm2d(128)
        self.bn7 = nn.BatchNorm2d(128)
        self.bn8 = nn.BatchNorm2d(128)
        self.bn9 = nn.BatchNorm2d(feat_dim)
        self.bn10 = nn.BatchNorm2d(128)
        self.avgpool = nn.AdaptiveAvgPool2d((1, 1))
        self.fc = nn.Linear(feat_dim, num_classes, bias=False)
        self.dr1 = nn.Dropout2d(0.2)
        self.dr2 = nn.Dropout2d(0.2)
        self.dr3 = nn.Dropout2d(0.2)
        self.apply(weights_init)
        self.cuda()
    def forward(self, x, return_feature=False):
        x = self.dr1(x)
        x = self.conv1(x)
        x = self.bn1(x)
        x = nn.LeakyReLU(0.2)(x)
        x = self.conv2(x)
        x = self.bn2(x)
        x = nn.LeakyReLU(0.2)(x)
        x = self.conv3(x)
        x = self.bn3(x)
        x = nn.LeakyReLU(0.2)(x)
        x = self.dr2(x)
        x = self.conv4(x)
        x = self.bn4(x)
        x = nn.LeakyReLU(0.2)(x)
        x = self.conv5(x)
        x = self.bn5(x)
        x = nn.LeakyReLU(0.2)(x)
        x = self.conv6(x)
        x = self.bn6(x)
        x = nn.LeakyReLU(0.2)(x)
        x = self.dr3(x)
        x = self.conv7(x)
        x = self.bn7(x)
        x = nn.LeakyReLU(0.2)(x)
        x = self.conv8(x)
        x = self.bn8(x)
        x = nn.LeakyReLU(0.2)(x)
        x = self.conv9(x)
        x = self.bn9(x)
        x = nn.LeakyReLU(0.2)(x)
        x = self.avgpool(x)
        x = torch.flatten(x, 1)
        y = self.fc(x)
        if return_feature:
            return x, y
        else:
            return y
def weights_init(m):
    classname = m.__class__.__name__
    # TODO: what about fully-connected layers?
    if classname.find('Conv') != -1:
        m.weight.data.normal_(0.0, 0.05)
    elif classname.find('BatchNorm') != -1:
        m.weight.data.normal_(1.0, 0.02)
        m.bias.data.fill_(0)
if __name__ == '__main__':
    import numpy as np
    model = classifier32(num_classes=4)
    model_parameters = filter(lambda p: p.requires_grad, model.parameters())
    params = sum([np.prod(p.size()) for p in model_parameters])
    print(params)
-
-
方法。最大Softmax概率(MSP,基线):该模型使用一个热目标向量和分类器的Softmax输出 p ( y ∣ x ) p(y|x) p(y∣x) 之间的交叉熵损失进行闭集分类训练。这种训练策略,以及使用最大softmax概率 S ( y ∈ C ∣ x ) = m a x y ∈ C p ( y ∣ x ) S(y∈C|x)=max_{y∈C} p(y|x) S(y∈C∣x)=maxy∈Cp(y∣x),在OSR和OOD文献中被广泛用作基线 。ARPL :该方法是最近RPL(交互点学习)优化策略的扩展 。
-
在这里,样本属于某个类别的概率与其与特征空间中学习到的 ‘reciprocal point’ 的距离成正比。reciprocal point 旨在表示相对于一个类的“差异性”,直觉是开放集示例与所有已知类都不同。ARPL通过将特征距离计算为欧几里德距离和余弦距离之和来扩展RPL。在这种情况下, S ( y ∈ C ∣ x ) S(y∈C|x) S(y∈C∣x) 等于图像和任何倒易点之间在特征空间中的最大距离。ARPL+CS 用“混淆样本”来增强ARPL:对抗性生成的潜在点来代替“看不见的类”样本。鼓励混淆样本与所有倒数点等距,使用与ARPL中相同的开集评分规则。我们根据官方公开实施来训练ARPL和ARPL+CS 。
-
数据集。我们在开放集识别的标准基准数据集上训练上述方法。在所有情况下,模型都是在类的子集上训练的,而其他类则被保留为“看不见的”以供评估。MNIST 、SVHN 、CIFAR10 :这些是十类数据集,MNIST和SVHN分别包含手写数字和街景门牌号的图像。同时,CIFAR10是一个通用的对象识别数据集,包含来自包括动物和车辆在内的十个不同类别的自然图像。在这些情况下,开集方法通过在六个类上进行训练来评估,同时使用其他四个类进行测试(|C|=6;|U|=4)。CIFAR+N :在CIFAR10评估协议的扩展中,开放集算法通过对CIFAR10的四个类进行训练来进行基准测试,同时使用CIFAR100的N个类进行评估,其中N表示10个或50个类(|C|=4;|U|∈{10,50})。TinyImageNet :在最后一个也是最具挑战性的案例中,现有的开集算法是在 TinyImageNet 数据集上进行评估的。该数据集包含从ImageNet中抽取的200个类 ,其中20个类用于训练,180个类为未知(|C|=20;|U|=180)。
-
实验设置。在测试时,该模型接收来自已知和新类的测试图像,并负责在每张图像的基础上做出二元“已知/未知”决策。根据OSR文献中的标准做法,接收器操作员曲线(AUROC)下的无阈值面积被用作评估指标。我们使用与(Adversarial reciprocal points learning for open set recognition)中相同的超参数进行训练,并按照标准做法,为每个数据集和方法组合训练五个不同的闭集和开集类。在本文中评估现有基准时,我们使用了与(Adversarial reciprocal points learning for open set recognition)相同的数据分割。
-
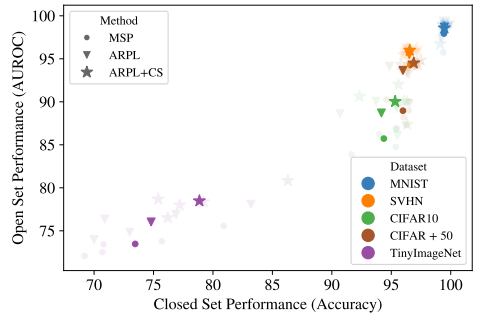
结果。图2给出了AUROC(开集性能)与Top-1多路分类精度(闭集性能)的对比。我们显示了平均结果和单个分割结果,为了清楚起见省略了CIFAR+10设置(因为散点几乎与CIFAR+50设置重合)。很明显,闭集精度和开集性能之间存在正相关关系:我们发现精度和AUROC之间的皮尔逊积矩相关ρ=0.95,表明这两个指标之间大致呈线性关系。
-
-
图2:闭集性能(准确度)和开集性能(AUROC)之间的相关性。我们在标准开放集基准数据集上训练了三种方法,包括MSP基线、ARPL和ARPL+CS 。粗体的前景点显示了每个方法数据集对的五个“已知/未知”类分割的平均结果(遵循OSR文献中的标准做法),而背景点(显示为假像)则表示来自潜在个体分割的结果。
-
-
讨论。为了从理论上证明我们的发现,我们查阅了模型校准文献(On calibration of modern neural networks)。直观地说,模型校准旨在量化模型是否“知道什么时候不知道”,因为低置信度预测与高错误率相关。具体来说,假设一个分类器 f(x)返回每个类的概率,预测为 y ^ = arg max f ( x ) \hat y=\arg \max f(x) y^=argmaxf(x)。进一步假设带标签的输入-输出对, ( x , y ) ⊂ X × C (x,y)⊂X×C (x,y)⊂X×C ,其中C是标签空间。然后,如果满足以下条件,则称分类器已完全校准:
- P ( y ^ = y ∣ f ( x ) = p ) = p , ∀ p ∈ [ 0 , 1 ] ( 1 ) P(\hat y = y|f(x) = p) = p, ∀p ∈ [0, 1] (1) P(y^=y∣f(x)=p)=p,∀p∈[0,1](1)
-
此外,如果分类器在无限数据上用适当的评分规则进行训练 ,那么分类器将在损失函数的最小值处进行完美校准 。用于训练深度网络的许多损失都是适当的评分规则(例如,交叉熵损失)。因此,假设测试集上的泛化误差与无限数据丢失值相关,我们会怀疑泛化(测试)误差较低的模型会得到更好的校准。如果我们使用低置信度闭集预测作为测试样本属于新语义类的指标,我们会期望更强的模型成为更好的开集检测器。
LARGE-SCALE EXPERIMENTS AND ARCHITECTURE ABLATION
-
到目前为止,我们已经证明了在单个轻量级架构和小规模数据集上闭集和开放集性能之间的相关性——尽管我们强调它们是OSR文献中现有的标准基准。在这里,我们在大规模数据集(ImageNet)上尝试了一系列架构。
-
方法。我们尝试了在标准ImageNet-1K数据集上训练的架构,这些数据集来自许多流行的模型家族,包括:VGG 、ResNet 和EfficientNet 。我们还包括非卷积模型 ViT 和 MLP Mixer 的结果,这些模型在Imagenet-21K上预先训练,然后在Imagenet-1K上进行微调。我们对所有模型权重都使用timm库。
-
数据集。为了进行大规模评估,我们利用了最近发布的ImageNet-21K-P 。该数据集包含完整ImageNet数据库的一个子集,经过处理和标准化,删除了小类,留下了大约11K个对象类别。请注意,ImageNet-21K-P是ImageNet-1K(ILSVRC12)的严格超集。因此,对于在ImageNet-1K的标准1000个类上训练的模型,我们从ImageNet-21K-P中不相交的类别中选择两个1000个类别子集作为开放集。与标准数据集上的现有实践不同,我们为ImageNet设计的两个开集分割不是随机抽样的,而是根据开集类别与训练类的语义相似性设计为“简单”和“困难”。通过这种方式,我们可以更好地捕捉模型识别语义新颖性的能力,而不是低级分布转换。第5节详细阐述了这一想法和拆分结构细节。对于“简单”和“困难”拆分,我们有|C|=1000和|U|=1000。
-
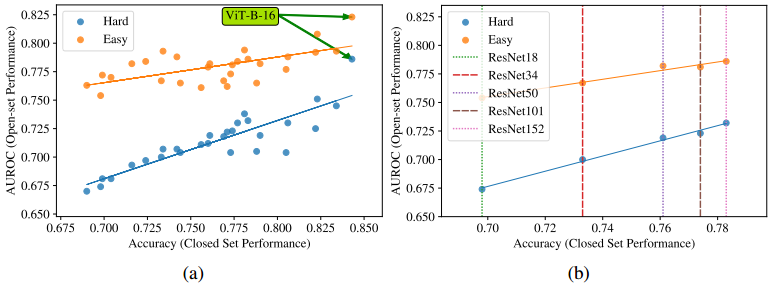
结果。图3a显示了我们在ImageNet上的开集结果。我们再次发现闭集和开集性能之间存在正相关关系。在这种情况下,我们发现线性关系较弱,“困难”评估的 ρ=0.88,“简单”评估的 ρ=0.63。考虑到建筑风格的巨大差异,这并不奇怪。总的来说,我们没有发现任何特定的型号系列在OSR方面明显优于其他型号。当观察单个模型族时,我们发现线性关系得到了极大的加强。图3b显示了ResNet家族内部的趋势,“简单”和“困难”OSR分裂的 ρ 分别为1.00和0.99。
-
讨论。我们注意到,ViT模型似乎在“易”和“难”分裂方面都与OSR趋势相反,在OOD检测方面显示出与 类似的发现。然而,在这两种情况下,ViT 模型都受益于对“看不见的”分裂中的类别进行预训练(尽管是在对闭集类进行微调之前)。最后,我们注意到第3节中我们的发现的实用性。也就是说,开放集和闭集性能相关的事实使得OSR能够随着标准图像识别的广泛研究而迅速改进。
-
-
图3:(a)ImageNet数据集上一系列架构的开放集结果。根据ImageNet-21K-P数据集构建“简单”和“困难”OSR分割。(b)单个模型族内的ImageNet开放集结果(ResNet)。
-
A GOOD CLOSED-SET CLASSIFIER IS ALL YOU NEED?
-
在本节中,我们将证明我们可以利用第3节中建立的相关性来提高基线OSR方法的性能。具体来说,我们提高了最大软最大概率(MSP)基线的闭集精度,并使其与最先进的开集模型竞争或更强。具体而言,我们在六个OSR基准中的四个上实现了最新的最先进数据。
-
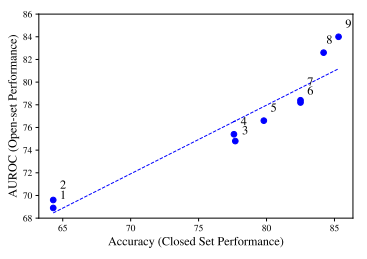
我们发现,通过利用图像识别文献中的技术,如更长的训练、更好的增强 和标签平滑 ,我们可以显著提高MSP基线性能。图4显示了当我们在TinyImageNet基准上引入这些变化时,基线模型的开集性能是如何提高的。例如:更长的训练(散点7-散点8);更好的增强(3-5);以及集合(8-9)。附录C中提供了用于提高闭集性能的方法的完整细节和表格细分。
-
-
图4:TinyImageNet上随着闭集性能的提高,开放集性能的提升。
-
-
我们采用这些改进的训练策略,在标准基准数据集上训练VGG32骨干。我们在单个NVIDIA Titan X GPU上以128的批处理大小训练600个迭代周期的所有模型。我们不包括集成结果,以便与以前的方法进行公平比较。完整的训练策略和实施细节见附录C和D。我们在表1中将结果报告为“基线(MSP+)”。
-
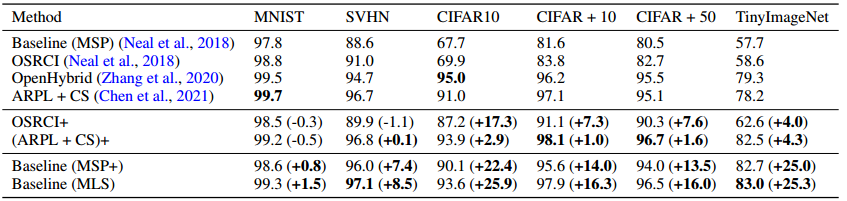
-
表1:我们改进的基线(MSP+,MLS)与标准OSR基准数据集上最先进方法的比较。所有结果表明,在五个“已知/未知”类别分割上,接收器操作员曲线(AUROC)下的面积平均值。“+”表示用改进的闭集优化策略增强的先前方法,包括:MSP+ 、OSRCI+ 和(ARPL+CS)+ 。
-
-
Logit评分规则。接下来,我们还更改了 open-set 评分规则。先前的研究已经指出,开集示例的特征范数往往低于闭集示例 。因此,我们建议在开集评分规则中使用最大logit分数(MLS)。Logits是深度分类器中最后一个线性层的原始输出,在softmax操作对其进行归一化之前,这些输出可以被解释为概率向量加1。由于softmax操作标准化了logits中存在的大部分特征量信息,我们发现logits可以获得更好的开集检测结果。我们在附录B中对此效应进行了详细的分析和讨论。我们还对使用交叉熵模型学习的表示进行了更全面的研究,包括学习特征空间的可视化。我们在表1中以“基线(MLS)”的形式呈现了最大logit评分基线的结果。
-
我们与OpenHybrid 和 ARPL+CS 进行了比较,后者在受控设置中的标准数据集上具有最先进的性能(没有用于训练或模型选择的额外数据)。我们还与 OSRCI 进行了比较,后者建立了当前的OSR基准套件。虽然 OSRCI 和 ARPL+CS 分别在第2节和第3.1节中进行了描述,但 OpenHybrid 通过在分类器的特征表示上训练基于流的密度估计器,联合训练编码器和密度模型来解决开放集任务。通过这种方式,学习了训练数据log p(x)上的分布,该分布用于直接提供S(y∈C|x)。与更多方法的比较见附录E。
-
我们发现,我们的MLS基线大大改善了之前报告的基线数据,整个数据集的AUROC平均绝对增加了15.6%。事实上,MLS在SVHN、CIFAR+10、CIFAR+50 和 TinyImageNet 基准测试中超过了现有的最先进水平,在整个套件中平均提高了0.7%。
-
我们还采用了 OSRCI 和 ARPL+CS 算法 ,并用我们提出的训练策略对其进行了补充,以进行公平的比较,并在OSRCI+和(ARPL+CS)+下报告了结果。具体来说,我们训练它们的时间更长,包括标签平滑和使用更好的数据增强(详见附录D)。我们还在这种受控环境中训练了OpenHybrid,但表现明显不如报告的性能。这可能是因为该方法训练了10k个迭代周期,批量大小为1024,都比这些实验中使用的大10倍。请注意,尽管如此,在许多情况下,更强的基线仍然优于 OpenHybrid。
-
在几乎所有情况下,我们都能提高OSRCI和ARPL+CS的开集性能,尤其是前者。在(ARPL+CS)+的情况下,我们在CIFAR+10和CIFAR+50基准测试中取得了最新的最先进成果,并报告TinyImageNet增长了4.3%。然而,我们注意到,平均而言,(ARPL+CS)+与改进的MLS基线几乎没有区别(平均开放集性能差异为0.03%)。
-
讨论。近年来,已经提出了许多越来越复杂的OSR方法。通常,所提出的方法已经仔细调整了训练策略和超参数,例如自定义学习速率表 、非标准骨干 和新的数据增强 。同时,这些方法的闭集精度往往未被报道。因此,很难描述开集性能增益中有多大比例来自闭集精度的提高。本节的研究结果表明,许多收益同样可以通过标准基线实现。事实上,在第5节中,我们提出了新的评估方案,发现一旦ARPL的闭集精度和基线具有可比性,开集性能的差异可以忽略不计。我们在附录F中进一步对OOD基准进行了实验,并报告了类似的基线性能改进。
SEMANTIC SHIFT BENCHMARK
-
目前的OSR基准有两个缺点:(1)它们都涉及小规模数据集;(2)它们对“语义类”的构成缺乏明确的定义。后者对于将开放集领域与其他研究问题(如分布外检测 和异常检测 )区分开来非常重要。具体来说,OSR旨在确定测试图像在语义上是否与训练类不同,而不是例如模型是否对其预测不确定,或者是否存在低级分布偏移。
-
为了解决这些问题,我们提出了一套新的评估基准。在本节中,我们首先详细介绍了大规模ImageNet评估(在第3.2节中介绍),然后对具有明确语义类定义的细粒度数据集提出了三个评估。与之前的工作不同,我们的评估设置都旨在明确地捕捉语义新颖性的概念。最后,我们在新的基准套件上对MLS和ARPL进行基准测试,以激励未来的研究。
PROPOSED BENCHMARK DATATSETS
-
ImageNet。我们引入了一种大规模的类别转换评估方法,该方法基于与训练集的语义距离进行开集分割。具体来说,我们为闭集指定原始的ImageNet-1K类,并从ImageNet-21K-P的不相交集中选择开集类。我们利用了ImageNet数据库的分层树状语义结构。例如,“大象”类可以在多个语义抽象层次上进行标记(‘elephant’, ‘placental’, ‘mammal’, ‘vertebrate’, ‘animal’)。因此,对于ImageNet-1K和ImageNet-21K-P之间的每对类,我们将两个类之间的语义距离定义为语义树中节点之间的总路径距离。然后,我们通过将所有ImageNet-1K类的距离相加,来近似ImageNet-21K-P类到闭集的总语义距离。
-
最后,我们通过对到闭集的总距离进行排序,并选择两组1000个类别,来选择“简单”和“困难”的开集分割。我们注意到,较大的ImageNet数据库以前曾用于OSR研究。然而,我们明确地构建了与ImageNet-1K的语义相似性,类似于(Concept generalization in visual representation learning)中的并发工作。
-
细粒度分类数据集。考虑细粒度视觉分类(FGVC)数据集的属性。这些数据集由“入门级”类别定义,如花朵 或鸟类 。在数据集中,所有类别都是该单一类别的变体,定义了一个语义变化轴,例如,在鸟类的情况下是“鸟类”。由于变异轴定义良好,因此可以合理地期望分类器在给定多个示例类的情况下学习它,即学习鸟类是什么以及如何区分它们。
-
将FGVC数据集与当前的OSR基准(如CIFAR+10评估)进行对比。在这种情况下,模型在四个CIFAR10类上进行训练,如{飞机、汽车、轮船、卡车},所有这些都可以被视为“入门级”,然后必须将来自CIFAR100类的图像(如{bicycle, bee, porcupine, baby})识别为属于新类。在这种情况下,变异轴的具体性要低得多,并且不确定OSR模型是对真实的语义信号做出响应,还是仅仅对“看不见”数据中的低级分布变化做出响应。此外,由于当前基准设置中的训练类数量较少,分类器学习如此高级的类定义是不现实的。我们在附录G中给出了一个说明性的例子。
-
因此,我们提出了三个用于OSR评估的FGVC数据集:加州理工学院UCSD鸟类(CUB) ,斯坦福汽车 ,FGVC飞机 。这些数据集带有标记的属性(例如,CUB中的has_bill_shape::hook),可用于表征类之间的差异,从而表征语义转换的程度。我们使用属性构建开集FGVC类分割,将其分为“简单”、“中等”和“困难”类,难度取决于标记的视觉属性与任何训练类的相似性。我们在这里简要介绍了CUB的分体建造过程,有关斯坦福汽车和FGVC飞机的更多详细信息,请参阅附录H。
-
CUB中的每个图像都标记了312个视觉属性,如 has_bill_shape::hook 和 has_breast_color::yellow。这些信息针对每个类进行聚合,得到一个矩阵 M ∈ [ 0 , 1 ] C × A M∈[0,1]^{C×A} M∈[0,1]C×A,描述了每个属性在每个类中出现的频率。将M中的每一行视为语义类描述符,这使我们能够计算每对类的语义相似性,并在给定一组闭集类的情况下,识别出相对于闭集而言哪些剩余的类是“简单”、“中等”和“困难”(从最不相似到最相似)。CUB 的 “Easy”、“Medium”和“Hard”开集类及其闭集中最接近的类的示例如图5所示。
-
我们注意到,细粒度OSR已在300种飞机类别的数据集上得到验证。然而,这个数据集没有带标签的属性,这使得构建与训练集具有不同语义相似性的开放集分割变得更加困难,这也是我们在这里的重点。最后,虽然之前的工作已经认识到对更细粒度的数据进行OOD检测的困难 ,但我们建议将它们用于OSR,因为它们对语义类的定义很明确,而不是难度增加。附录G进一步讨论了这些想法。我们在表2中提供了所有拟议数据集的分割统计数据,并在补充材料中提供了分割本身。
-
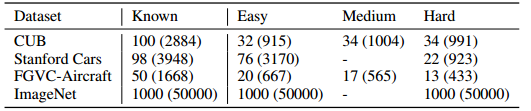
-
表2:语义转换基准的统计数据。我们显示了已知类的“#Classes(#Test Images)”,以及“Easy”、“Medium”和“Hard”开集类的“#Classes(#测试图像)”。
-
BENCHMARKING FOR OPEN-SET RECOGNITION
-
评估协议。对于“已知/未知”的类决策,我们将AUROC报告为标准做法,以及允许在模型的闭集精度中情境化开放集性能潜在收益的准确性。我们还报告了开放集分类率(OSCR) ,它衡量了准确性和开放集检测率之间的权衡,因为预测类的置信度阈值是不同的。我们报告了所有数据集的“简单”和“困难”分割结果,在适用的情况下将“中等”和“艰难”示例组合到一个容器中。
-
在细粒度分类中,在ImageNet上预训练模型是标准的。这不适合所提出的细粒度OSR设置,因为ImageNet包含与所提出的数据集重叠的类。相反,我们使用MoCoV2自监督权重对地点网络进行预训练 。对于ImageNet基准测试,我们可以使用ImageNet-1K数据集上的标签进行训练,并对看不见的类进行评估。我们从预训练的ImageNet检查点微调ARPL模型。
-
结果。在表3中,我们使用ResNet50骨干网在拟议的基准上测试了MLS和ARPL+ (我们发现在这种情况下训练ARPL+CS的成本过高,详见附录D)。结果证实了第4节中发现的趋势:强闭集分类器产生具有良好AUROC性能的开集结果,MLS基线的性能与最先进的方法相当。
-
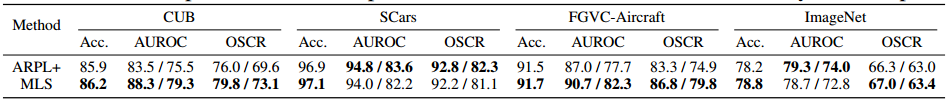
-
表3:Semantic Shift Benchmark上的OSR结果。我们测量了二元开集决策的闭集分类准确率和AUROC。我们还报告了OSCR,它衡量了开放和封闭集性能之间的权衡。OSR结果显示在“简单/困难”分割上。
-
-
最后,更仔细地考虑开放集类的语义会导致更难的拆分,从而显著降低OSR性能。这与“开放性” 形成鲜明对比,后者是目前用于评估OSR问题难度的指标,仅取决于封闭类与开放类的数量之比。例如,在ImageNet的情况下,我们发现更难的分割会导致两种方法的AUROC降低5-6%。我们还对1K和10K的开集类进行了随机子采样实验,发现在评估过程中引入更多的类只会使开集性能降低约0.6%(比我们提出的拆分低≈10倍)。
CONCLUSION
- 在这项工作中,我们证明了开放集识别任务中模型的闭集和开放集性能之间存在很强的相关性。利用这一发现,我们证明了一个训练有素的闭集分类器,在测试时使用最大logit分数(MLS),可以与现有的最先进方法竞争或超越现有的最新方法。尽管我们认为OSR是一个需要进一步调查的关键问题,但我们的发现为我们提供了不充分的证据来拒绝我们的名义问题“你只需要一个好的闭集分类器吗?’.我们还提出了“语义转换基准”套件,该套件将语义转换与其他低级分布转换隔离开来。我们提出的基准套件允许对语义新颖性进行受控研究,包括语义转换程度的分层。
- Close Set Recognition,闭集识别:指 训练集中的类别和测试集中的类别是一致的,例如最常用最经典的ImageNet-1k。所有在测试集中的图像的类别都在训练集中出现过,没有未知种类的图像。从AlexNet到VGG,再到ResNet,以及最近大火的Visual Transformer,都能够比较好的处理这一类别的任务。
EXPANSION OF FIG. 2 OF THE MAIN PAPER WITH STANDARD DEVIATIONS
-
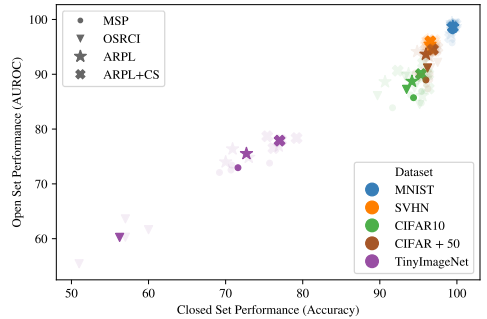
为了完整起见,我们在图 6 中包括了图 2 的另一个版本,其中包括OSRCI模型 。我们发现,通过引入这种额外的方法,闭集和开集性能之间的相关性仍然成立。我们在表 4 中进一步报告了该图的标准偏差。可以看出,对于同一数据集,所有四种方法的标准差似乎都相似。最具挑战性的TinyImageNet基准测试的标准差大于其他数据集。
-
-
图6:标准OSR基准上开集和闭集性能之间的相关性。该图类似于图2,但包括OSRCI的散点 。
-
-
最后,我们在图6中注意到,在非常高的精度下,趋势似乎不太明显。这可能是因为AUROC也变得非常高,难以识别清晰的模式。然而,这也可能表明,随着闭集性能的饱和,指标之间的关系变得越来越弱。
ANALYSING THE CLOSED-SET AND OPEN-SET CORRELATION
-
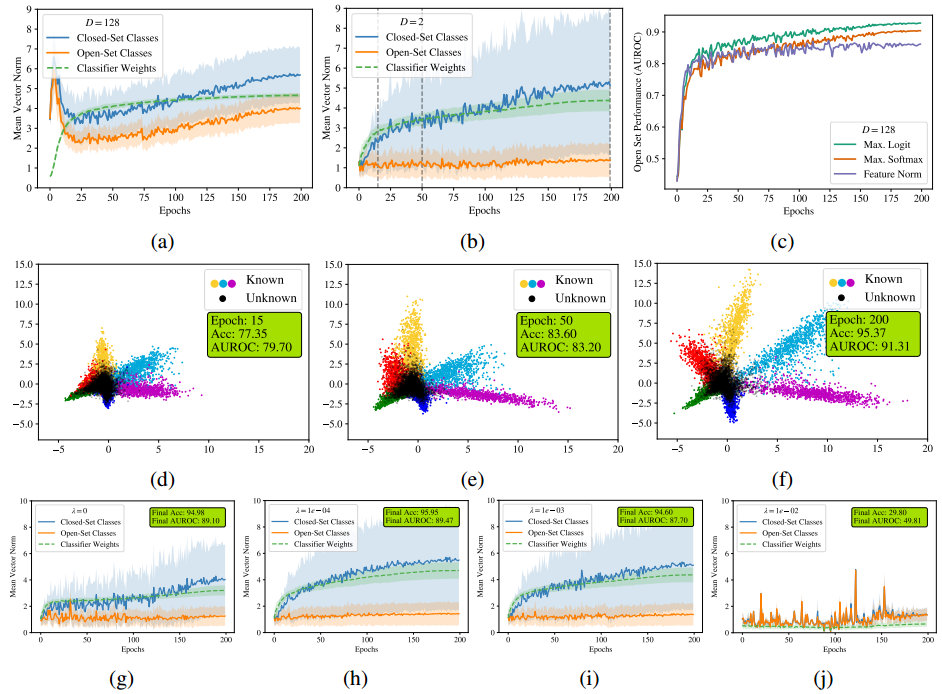
在这里,我们的目的是了解为什么提高闭集精度可能会通过MSL基线提高开集性能。为此,我们在具有交叉熵损失的CIFAR10基准设置上训练VGG32模型。我们使用D=128的特征维度(这是该模型的标准)以及D=2的特征空间可视化来训练模型。我们还在线性分类器中无偏见地训练,以获得更可解释的特征和分类边界(因此类边界从特征空间的原点辐射)。具体地说,我们训练一个模型来进行预测,使其为 y ^ i = s o f t m a x ( W Φ θ ( x i )) \hat y_i=softmax(WΦ_θ(x_i)) y^i=softmax(WΦθ(xi)),其中 Φ θ ( ⋅ ) Φθ(·) Φθ(⋅) 是CNN嵌入函数( Φ θ ( x ) ∈ R D Φ_θ(x)∈R^D Φθ(x)∈RD), W ∈ R C × D W∈\R^{C×D} W∈RC×D是线性分类矩阵。这里C=|C|=6,D∈{2,128},我们使用 one-hat 目标向量 yi 和批大小B优化损失,如 − 1 B ∑ i = 1 B y i ⋅ l o g ( y ^ i ) −\frac 1 B\sum^B_{i=1} y_i·log(\hat y_i) −B1∑i=1Byi⋅log(y^i)。
-
接下来,随着训练的进行,我们通过绘制所有测试图像中已知和未知类别的特征的均值向量范数来询问学习到的嵌入。图7a和图7b分别显示了D=128和D=2的模型。我们还将线性分类器中每类权重的平均向量范数显示为虚线。此外,图7d至7f显示了在代表性时期如何为D=2的模型嵌入这些图像的快照。平均特征范数的图显示,在训练开始时,所有图像都以相似的幅度嵌入。然而,随着训练的进行,已知类的特征量比未知类增加得更多。
-
-
图7:显示深度分类器的特征表示和线性分类权重如何随着训练的进行而演变的图(CIFAR10 OSR设置)。(a)、(b)分别显示了D=128和D=2的模型的可见和不可见类的平均特征范数,以及线性分类头中权重的每类向量范数。(c)显示了使用三种不同的OSR评分规则,D=128的分类器的开集性能如何随着训练的进行而发展。(d)、(e)、(f)显示了d=2的模型在不同时期(由(b)中的垂直虚线表示)来自可见和不可见类别的图像的特征投影。我们用彩色显示已知类别的测试图像,用黑色显示未知类别的测试图片。(g)(h)(i)显示分类器权重和特征范数如何随权重衰减强度(λ)而变化
-
-
为了理解这一点,考虑批次中单个样品的交叉熵损失,如方程式(2)所示:
-
L i ( θ , W ) = − y ^ i , c + log ( ∑ j = 1 C exp ( y ^ i , j ) ) = − w c ⋅ Φ θ ( x i ) + log ( ∑ j = 1 C exp ( w j ⋅ Φ θ ( x i ) ) ) (2) {\mathcal L}_{i} ( \theta, \mathbf{W} )=-{\hat{y}}_{i, c}+\operatorname{l o g} ( \sum_{j=1}^{C} \operatorname{e x p} ( {\hat{y}}_{i, j} ) )=-\mathbf{w}_{c} \cdot\Phi_{\theta} ( \mathbf{x}_{i} )+\operatorname{l o g} ( \sum_{j=1}^{C} \operatorname{e x p} ( \mathbf{w}_{j} \cdot\Phi_{\theta} ( \mathbf{x}_{i} ) ) ) \tag{2} Li(θ,W)=−y^i,c+log(j=1∑Cexp(y^i,j))=−wc⋅Φθ(xi)+log(j=1∑Cexp(wj⋅Φθ(xi)))(2)
-
其中c表示正确的类索引,wj 表示与第 j 个类对应的分类向量。经验上,我们发现线性分类器的权重和已知类的特征范数在训练过程中增加,这是合理的,因为增加 |wc| 和 |Φθ(xi)| 都会降低损失值。请注意,尽管进行了重量衰减训练,我们还是观察到了这一点,为了清楚起见,我们在方程式(2)中省略了这一部分。然而,对于“困难”或“不确定”的训练示例(分类器的预测可能不正确),鼓励模型通过等式(2)的第二项减少 w j ⋅ Φ θ ( x i ) ∀ j ≠ c w_j·Φ_θ(x_i)∀j \neq c wj⋅Φθ(xi)∀j=c。虽然对于D=2的情况,唯一的方法是降低特征范数(图7b和图7d至7f),但我们在图7a中表明,对于D>C的D=128的情况也是如此。深度网络将“困难”样本映射到更接近原点的趋势在 中有所指出。
-
-
这表明,更强的交叉熵模型将特征投影到离原点更远的地方,同时仍然确保任何“不确定”的样本具有较低的特征范数。这反过来又表明,更强的交叉熵分类器在OSR中表现更好,来自新类别的图像在评估过程中可能会被解释为“不确定”。我们的分析还表明,交叉熵训练已经提供了一个很强的信号,从而为开放集识别提供了很强的基线。
-
最后,这促使我们提出最大logit分数(MLS)来提供我们的开集分数,即 S ( y ∈ C ∣ x ) = m a x j ∈ C w j ⋅ Φ θ ( x ) S(y∈C|x)=max_{j∈C}w_j·Φ_θ(x) S(y∈C∣x)=maxj∈Cwj⋅Φθ(x),而不是标准MSP基线中的 softmax 输出。通过 softmax 算子对 logits 进行归一化可以抵消特征表示的幅度信息,我们已经证明这对 OSR 决策很有用。图7c显示了当最大logit和最大softmax值都用于OSR评分时,AUROC如何随着训练的进行而演变。该图表明,softmax归一化显著降低了模型做出开集决策的能力。我们还展示了如果我们使用特征范数作为我们的开集得分( S ( y ∈ C ∣ x ) = ∣ Φ θ ( x ) ∣ S(y∈C|x)=|Φ_θ(x)| S(y∈C∣x)=∣Φθ(x)∣),OSR的性能,表明这个简单的指标可以表现得非常好。
IMPROVING OPEN-SET PERFORMANCE WITH STRONGER CLOSED-SET CLASSIFIERS
-
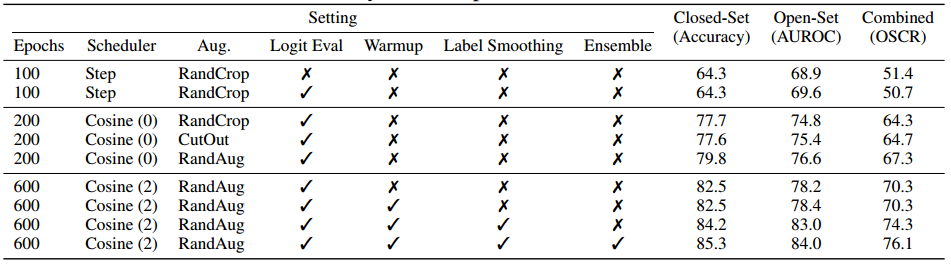
在这里,我们描述了如何在主论文第4节中提高基线方法的开集性能,并提供了图4的完整分解。这些方法包括更好的学习率计划和数据增强,以及使用 logits 而不是 softmax 输出进行OSR评分。我们在表5中记录了TinyImageNet数据集(最具挑战性的OSR基准)的闭集和开集性能。我们还包括“开放集分类率”(OSCR ),它总结了随着开放集得分阈值的变化,封闭集准确性和开放集性能(此处为假阳性率)之间的权衡。如主论文第4节所示,本研究的结果很好地推广到其他数据集。
-
-
表5:用于提高基线方法闭集分类准确性的方法细分。所有实验都是在TinyImageNet数据集的五个“已知/未知”分割上使用VGG32骨干进行的。带余弦调度器的括号内的数字表示训练期间使用的学习率重启次数。我们发现闭集精度和开集AUROC之间的皮尔逊积矩相关系数为0.93。
-
-
我们首先使用与(Adversarial reciprocal points learning for open set recognition)中相同的超参数训练基线,训练100个迭代周期,并使用步进学习率计划,使用基本的随机作物增强策略。我们使用softmax和logit评分策略进行评估。可以看出,使用最大logit评分可以获得更好的开放集性能(AUROC),而softmax评分在OSCR方面似乎更好。这可能是由于softmax归一化消除了特征范数的影响,从而产生了更多有利于OSCR计算的可分离分数。
-
在这里,我们有兴趣通过提高闭集精度来提高开集性能(AUROC)。因此,我们使用附录B中讨论的开放集评分的最大logit。这已经给出了69.6%AUROC的开放集性能,明显高于文献中几乎所有比较中报告的softmax阈值基线,该基线报告的AUROC为57.7%。报告的基线与我们最简单的设置之间的差异是源于 的报告数据的结果,其中所有模型仅训练了30个迭代周期(根据公开共享的代码),而我们最简单模型训练了100个迭代周期。
-
遵循这一趋势,我们发现训练时间更长(200个epoch)和使用更好的学习率计划(余弦退火计划 )显著提高了闭集和开集的性能。我们进一步发现,更强的增强可以提高准确性,我们利用 RandAugment 来找到最佳策略。最后,我们发现学习率预热和标签平滑 可以共同显著提高准确性。我们通过在验证集上最大化闭集精度(随机采样训练集的20%)来选择RandAugment和标签平滑超参数。
-
""" https://github.com/ildoonet/pytorch-randaugment/blob/master/RandAugment/augmentations.py """ import random import PIL, PIL.ImageOps, PIL.ImageEnhance, PIL.ImageDraw import numpy as np import torch from PIL import Image def ShearX(img, v): # [-0.3, 0.3] assert -0.3 <= v <= 0.3 if random.random() > 0.5: v = -v return img.transform(img.size, PIL.Image.AFFINE, (1, v, 0, 0, 1, 0)) def ShearY(img, v): # [-0.3, 0.3] assert -0.3 <= v <= 0.3 if random.random() > 0.5: v = -v return img.transform(img.size, PIL.Image.AFFINE, (1, 0, 0, v, 1, 0)) def TranslateX(img, v): # [-150, 150] => percentage: [-0.45, 0.45] assert -0.45 <= v <= 0.45 if random.random() > 0.5: v = -v v = v * img.size[0] return img.transform(img.size, PIL.Image.AFFINE, (1, 0, v, 0, 1, 0)) def TranslateXabs(img, v): # [-150, 150] => percentage: [-0.45, 0.45] assert 0 <= v if random.random() > 0.5: v = -v return img.transform(img.size, PIL.Image.AFFINE, (1, 0, v, 0, 1, 0)) def TranslateY(img, v): # [-150, 150] => percentage: [-0.45, 0.45] assert -0.45 <= v <= 0.45 if random.random() > 0.5: v = -v v = v * img.size[1] return img.transform(img.size, PIL.Image.AFFINE, (1, 0, 0, 0, 1, v)) def TranslateYabs(img, v): # [-150, 150] => percentage: [-0.45, 0.45] assert 0 <= v if random.random() > 0.5: v = -v return img.transform(img.size, PIL.Image.AFFINE, (1, 0, 0, 0, 1, v)) def Rotate(img, v): # [-30, 30] assert -30 <= v <= 30 if random.random() > 0.5: v = -v return img.rotate(v) def AutoContrast(img, _): return PIL.ImageOps.autocontrast(img) def Invert(img, _): return PIL.ImageOps.invert(img) def Equalize(img, _): return PIL.ImageOps.equalize(img) def Flip(img, _): # not from the paper return PIL.ImageOps.mirror(img) def Solarize(img, v): # [0, 256] assert 0 <= v <= 256 return PIL.ImageOps.solarize(img, v) def SolarizeAdd(img, addition=0, threshold=128): img_np = np.array(img).astype(np.int) img_np = img_np + addition img_np = np.clip(img_np, 0, 255) img_np = img_np.astype(np.uint8) img = Image.fromarray(img_np) return PIL.ImageOps.solarize(img, threshold) def Posterize(img, v): # [4, 8] v = int(v) v = max(1, v) return PIL.ImageOps.posterize(img, v) def Contrast(img, v): # [0.1,1.9] assert 0.1 <= v <= 1.9 return PIL.ImageEnhance.Contrast(img).enhance(v) def Color(img, v): # [0.1,1.9] assert 0.1 <= v <= 1.9 return PIL.ImageEnhance.Color(img).enhance(v) def Brightness(img, v): # [0.1,1.9] assert 0.1 <= v <= 1.9 return PIL.ImageEnhance.Brightness(img).enhance(v) def Sharpness(img, v): # [0.1,1.9] assert 0.1 <= v <= 1.9 return PIL.ImageEnhance.Sharpness(img).enhance(v) def Cutout(img, v): # [0, 60] => percentage: [0, 0.2] assert 0.0 <= v <= 0.2 if v <= 0.: return img v = v * img.size[0] return CutoutAbs(img, v) def CutoutAbs(img, v): # [0, 60] => percentage: [0, 0.2] # assert 0 <= v <= 20 if v < 0: return img w, h = img.size x0 = np.random.uniform(w) y0 = np.random.uniform(h) x0 = int(max(0, x0 - v / 2.)) y0 = int(max(0, y0 - v / 2.)) x1 = min(w, x0 + v) y1 = min(h, y0 + v) xy = (x0, y0, x1, y1) color = (125, 123, 114) # color = (0, 0, 0) img = img.copy() PIL.ImageDraw.Draw(img).rectangle(xy, color) return img def SamplePairing(imgs): # [0, 0.4] def f(img1, v): i = np.random.choice(len(imgs)) img2 = PIL.Image.fromarray(imgs[i]) return PIL.Image.blend(img1, img2, v) return f def Identity(img, v): return img def augment_list(): # 16 oeprations and their ranges # https://github.com/google-research/uda/blob/master/image/randaugment/policies.py#L57 # l = [ # (Identity, 0., 1.0), # (ShearX, 0., 0.3), # 0 # (ShearY, 0., 0.3), # 1 # (TranslateX, 0., 0.33), # 2 # (TranslateY, 0., 0.33), # 3 # (Rotate, 0, 30), # 4 # (AutoContrast, 0, 1), # 5 # (Invert, 0, 1), # 6 # (Equalize, 0, 1), # 7 # (Solarize, 0, 110), # 8 # (Posterize, 4, 8), # 9 # # (Contrast, 0.1, 1.9), # 10 # (Color, 0.1, 1.9), # 11 # (Brightness, 0.1, 1.9), # 12 # (Sharpness, 0.1, 1.9), # 13 # # (Cutout, 0, 0.2), # 14 # # (SamplePairing(imgs), 0, 0.4), # 15 # ] # https://github.com/tensorflow/tpu/blob/8462d083dd89489a79e3200bcc8d4063bf362186/models/official/efficientnet/autoaugment.py#L505 l = [ (AutoContrast, 0, 1), (Equalize, 0, 1), (Invert, 0, 1), (Rotate, 0, 30), (Posterize, 0, 4), (Solarize, 0, 256), (SolarizeAdd, 0, 110), (Color, 0.1, 1.9), (Contrast, 0.1, 1.9), (Brightness, 0.1, 1.9), (Sharpness, 0.1, 1.9), (ShearX, 0., 0.3), (ShearY, 0., 0.3), (CutoutAbs, 0, 40), (TranslateXabs, 0., 100), (TranslateYabs, 0., 100), ] return l def augment_list_svhn(): # 16 oeprations and their ranges # https://github.com/tensorflow/tpu/blob/8462d083dd89489a79e3200bcc8d4063bf362186/models/official/efficientnet/autoaugment.py#L505 l = [ (AutoContrast, 0, 1), (Equalize, 0, 1), (Invert, 0, 1), (Posterize, 0, 4), (Solarize, 0, 256), (SolarizeAdd, 0, 110), (Color, 0.1, 1.9), (Contrast, 0.1, 1.9), (Brightness, 0.1, 1.9), (Sharpness, 0.1, 1.9), (ShearX, 0., 0.3), (ShearY, 0., 0.3), (CutoutAbs, 0, 40), ] return l class Lighting(object): """Lighting noise(AlexNet - style PCA - based noise)""" def __init__(self, alphastd, eigval, eigvec): self.alphastd = alphastd self.eigval = torch.Tensor(eigval) self.eigvec = torch.Tensor(eigvec) def __call__(self, img): if self.alphastd == 0: return img alpha = img.new().resize_(3).normal_(0, self.alphastd) rgb = self.eigvec.type_as(img).clone() \ .mul(alpha.view(1, 3).expand(3, 3)) \ .mul(self.eigval.view(1, 3).expand(3, 3)) \ .sum(1).squeeze() return img.add(rgb.view(3, 1, 1).expand_as(img)) class CutoutDefault(object): """ Reference : https://github.com/quark0/darts/blob/master/cnn/utils.py """ def __init__(self, length): self.length = length def __call__(self, img): h, w = img.size(1), img.size(2) mask = np.ones((h, w), np.float32) y = np.random.randint(h) x = np.random.randint(w) y1 = np.clip(y - self.length // 2, 0, h) y2 = np.clip(y + self.length // 2, 0, h) x1 = np.clip(x - self.length // 2, 0, w) x2 = np.clip(x + self.length // 2, 0, w) mask[y1: y2, x1: x2] = 0. mask = torch.from_numpy(mask) mask = mask.expand_as(img) img *= mask return img class RandAugment: def __init__(self, n, m, args=None): self.n = n # [1, 2] self.m = m # [0...30] if args is None: self.augment_list = augment_list() elif args.dataset == 'svhn' or args.dataset == 'mnist': self.augment_list = augment_list_svhn() else: self.augment_list = augment_list() def __call__(self, img): ops = random.choices(self.augment_list, k=self.n) for op, minval, maxval in ops: val = (float(self.m) / 30) * float(maxval - minval) + minval img = op(img, val) return img -
总之,我们发现,简单地利用图像识别模型的标准训练策略可以显著提高开放集性能。具体来说,我们发现上述方法的结合,包括更长的训练和更好的增强,将AUROC提高到83.0%。最后,我们发现通过引导训练数据和训练K=5集合,开放集性能可以提高到84.0%的AUROC。开集性能的提高与闭集精度的提高密切相关,精度和AUROC之间的ρ=0.93。
-
在PyTorch中,“projection layer”(投影层)并不是一个特定的层类型,而是一种概念,通常用于指代那些将高维输入映射到低维空间的层。这种层可以通过线性变换(即全连接层)或卷积操作实现,具体取决于应用场景。一个典型的投影层可以使用
torch.nn.Linear来实现。假设输入是一个形状为[batch_size, input_dim]的张量,我们希望将其映射到一个形状为[batch_size, output_dim]的张量,其中output_dim通常小于input_dim,从而实现降维的目的。- 输入:形状为
[batch_size, input_dim] - 权重矩阵:形状为
[input_dim, output_dim] - 偏置向量:形状为
[output_dim](可选) - 输出计算公式:
output = input @ weight.t() + bias,其中@表示矩阵乘法,.t()表示转置。
- 输入:形状为
-
对于使用
torch.nn.Linear实现的投影层,主要涉及以下几个参数:in_features (int): 输入特征的数量。out_features (int): 输出特征的数量。bias (bool): 是否包含偏置项,默认为True。在训练过程中,投影层中的权重和偏置(如果有的话)是模型的一部分,会随着整个网络一起通过梯度下降等优化算法进行更新。PyTorch自动处理反向传播过程。当你调用损失函数的.backward()方法时,PyTorch会根据链式法则自动计算每个参数的梯度,并且这些梯度会被用来更新参数值。-
import torch.nn as nn
# 定义一个简单的线性投影层
projection_layer = nn.Linear(in_features=1024, out_features=128)
############
import torch
import torch.nn as nn
import torch.optim as optim
class SimpleModel(nn.Module):
    def __init__(self, input_dim=1024, output_dim=128):
        super(SimpleModel, self).__init__()
        self.projection = nn.Linear(in_features=input_dim, out_features=output_dim)
    def forward(self, x):
        return self.projection(x)
# 创建模型实例
model = SimpleModel()
# 定义损失函数和优化器
criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.01)
# 生成一些假数据用于演示
inputs = torch.randn(32, 1024)  # 32个样本,每个样本有1024个特征
targets = torch.randn(32, 128)  # 目标输出
# 前向传播
outputs = model(inputs)
loss = criterion(outputs, targets)
# 反向传播和优化步骤
optimizer.zero_grad()  # 清空之前的梯度
loss.backward()         # 反向传播计算梯度
optimizer.step()       # 更新参数
print("Loss:", loss.item())
-

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献16条内容

所有评论(0)