一文全面精通贪心算法
一文全面精通贪心算法
前言
贪心算法(Greedy Algorithm)是一种在每一步选择中都采取当前状态下最优(局部最优)选择,从而希望最终导致全局最优解的算法策略。贪心算法虽然不能保证在所有问题中都能得到全局最优解,但在许多实际问题中,它能够高效地找到近似最优解或精确最优解。本文我将深入探讨贪心算法的原理、适用场景、设计策略以及经典应用案例,帮助你掌握这一重要的算法思想。
一、算法基本原理
1.1 核心思想
贪心算法的核心思想是局部最优选择导向全局最优。在每一步决策时,算法会选择当前看起来最优的选项,而不考虑该选择对后续步骤的影响。这种策略使得算法在每一步都能快速做出决策,从而降低了问题的复杂度。
1.2 适用条件
贪心算法适用于满足以下两个条件的问题:
-
贪心选择性质:问题的全局最优解可以通过一系列局部最优选择得到。即每一步的局部最优选择最终会导致全局最优解。
-
最优子结构:问题的最优解包含其子问题的最优解。也就是说,问题可以分解为多个子问题,每个子问题的最优解组合起来就是原问题的最优解。
1.3 与动态规划的对比
贪心算法与动态规划(Dynamic Programming)都是解决优化问题的常用方法,但它们的适用场景和解决思路有所不同:
贪心算法:每一步只做当前最优选择,不考虑子问题的解,决策过程是单向的,时间复杂度通常较低。
动态规划:会存储子问题的解,通过综合考虑所有可能的选择来得到全局最优解,决策过程是多向的,时间复杂度通常较高。
二、贪心算法的设计策略
2.1 问题分析
在应用贪心算法之前,需要对问题进行深入分析,判断问题是否满足贪心选择性质和最优子结构。这通常需要对问题的数学性质进行研究,或者通过实例验证。
2.2 选择贪心策略
根据问题的特点,选择合适的贪心策略。常见的贪心策略包括:
-
最大/最小优先:每次选择当前最大或最小的元素。
-
最早/最晚优先:每次选择最早或最晚发生的事件。
-
最高效率优先:每次选择单位代价收益最高的选项。
2.3 验证正确性
选择贪心策略后,需要验证其正确性。这可以通过数学归纳法、反证法或构造具体实例来证明。如果无法证明贪心策略的正确性,则需要考虑使用其他算法(如动态规划)。
三、经典应用案例
3.1 活动选择问题(Activity Selection Problem)
问题描述:给定一组活动,每个活动有开始时间和结束时间,要求选择最多的互不冲突的活动。
贪心策略:每次选择结束时间最早且不与已选活动冲突的活动。
代码实现(Python):
def activity_selection(start, end):
    n = len(end)
    activities = sorted(zip(end, start))  # 按结束时间排序
    result = []
    last_end = -1

    for e, s in activities:
        if s >= last_end:
            result.append((s, e))
            last_end = e

    return result
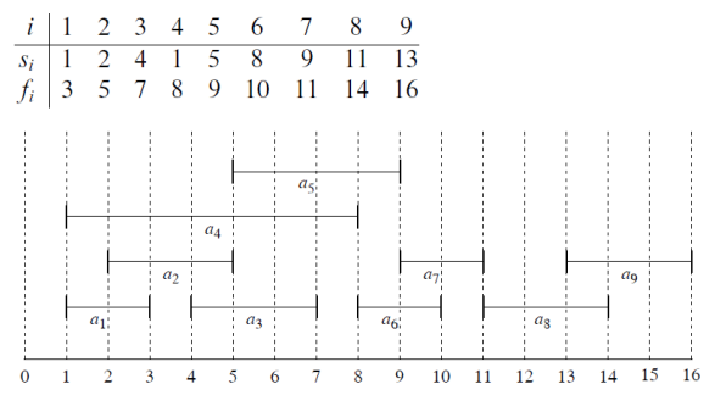
分析:该算法的时间复杂度为 O ( n log n ) O(n \log n) O(nlogn)(排序时间),空间复杂度为 O ( n ) O(n) O(n)。贪心策略的正确性可以通过反证法证明。
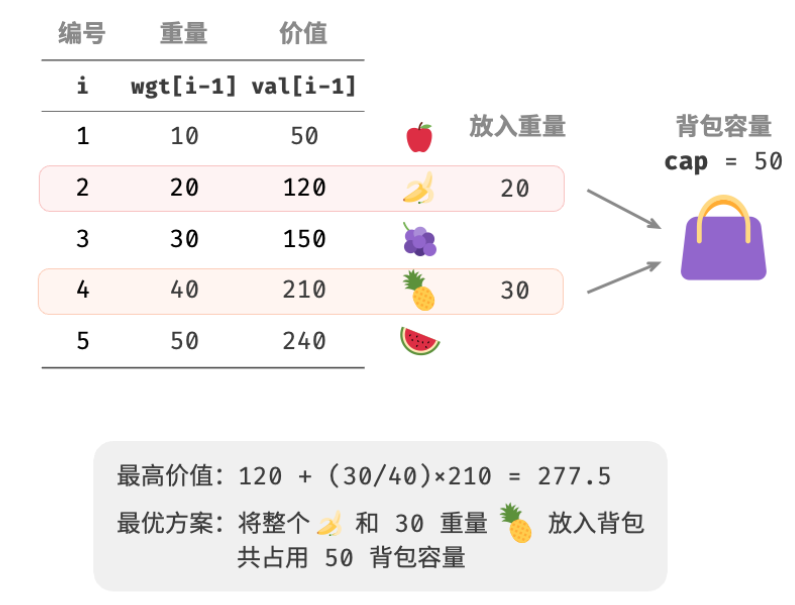
3.2 分数背包问题(Fractional Knapsack Problem)
问题描述:给定一组物品,每个物品有重量和价值,以及一个容量为 C 的背包。可以取物品的一部分,要求背包中物品的总价值最大。
贪心策略:每次选择单位重量价值最高的物品,尽可能多地装入背包。
代码实现(Java):
import java.util.Arrays;
import java.util.Comparator;

class Item {
    int weight;
    int value;

    public Item(int weight, int value) {
        this.weight = weight;
        this.value = value;
    }
}

public class FractionalKnapsack {
    public static double fractionalKnapsack(int capacity, Item[] items) {
        Arrays.sort(items, Comparator.comparingDouble(item -> (double) item.value / item.weight).reversed());

        double totalValue = 0;
        for (Item item : items) {
            if (capacity == 0) break;

            if (item.weight <= capacity) {
                totalValue += item.value;
                capacity -= item.weight;
            } else {
                totalValue += (double) item.value * capacity / item.weight;
                capacity = 0;
            }
        }

        return totalValue;
    }
}
分析:该算法的时间复杂度为
O
(
n
log
n
)
O(n \log n)
O(nlogn)(排序时间),空间复杂度为
O
(
1
)
O(1)
O(1)。贪心策略的正确性可以通过数学归纳法证明。
3.3 哈夫曼编码(Huffman Coding)
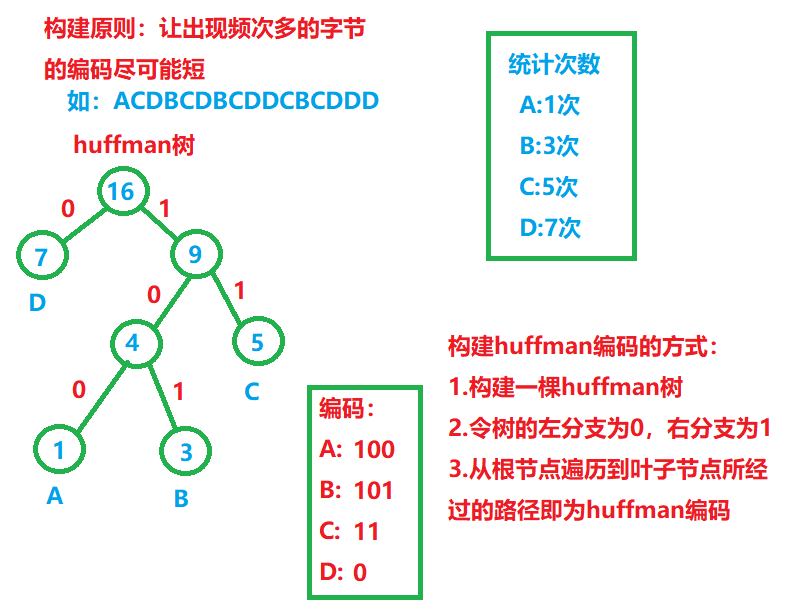
问题描述:给定一组字符及其频率,构造一种二进制编码,使得总编码长度最短。
贪心策略:每次选择频率最小的两个字符合并,生成一个新的父节点,父节点的频率为这两个字符的频率之和,重复此过程直到所有字符合并为一个根节点。
代码实现(C++):
#include <iostream>
#include <queue>
#include <vector>
using namespace std;

struct HuffmanNode {
    char data;
    int freq;
    HuffmanNode *left, *right;

    HuffmanNode(char data, int freq) : data(data), freq(freq), left(nullptr), right(nullptr) {}
};

struct compare {
    bool operator()(HuffmanNode* l, HuffmanNode* r) {
        return l->freq > r->freq;
    }
};

HuffmanNode* buildHuffmanTree(vector<char> data, vector<int> freq) {
    int n = data.size();
    priority_queue<HuffmanNode*, vector<HuffmanNode*>, compare> minHeap;

    for (int i = 0; i < n; ++i) {
        minHeap.push(new HuffmanNode(data[i], freq[i]));
    }

    while (minHeap.size() != 1) {
        HuffmanNode* left = minHeap.top();
        minHeap.pop();
        HuffmanNode* right = minHeap.top();
        minHeap.pop();

        HuffmanNode* top = new HuffmanNode('$', left->freq + right->freq);
        top->left = left;
        top->right = right;

        minHeap.push(top);
    }

    return minHeap.top();
}
分析:该算法的时间复杂度为
O
(
n
log
n
)
O(n \log n)
O(nlogn)(每次从优先队列中取出最小元素的时间为
O
(
log
n
)
O(\log n)
O(logn),共进行
n
−
1
n-1
n−1次合并),空间复杂度为
O
(
n
)
O(n)
O(n)。贪心策略的正确性可以通过证明哈夫曼树的最优性来验证。
四、贪心算法的局限性
尽管贪心算法在许多问题中表现出色,但它也有一定的局限性:
-
无法保证全局最优:在某些问题中,局部最优选择可能导致次优解或错误解。例如,在 0-1 背包问题中,贪心策略无法得到最优解,必须使用动态规划。
-
适用范围有限:只有满足贪心选择性质和最优子结构的问题才能使用贪心算法。许多实际问题并不满足这些条件。
-
策略选择困难:在某些问题中,可能存在多种贪心策略,但只有一种或几种能够得到最优解,需要仔细分析和验证。
总结
贪心算法是一种简单而高效的算法策略,适用于满足贪心选择性质和最优子结构的问题。通过每一步的局部最优选择,贪心算法能够快速找到问题的解,时间复杂度通常较低。然而贪心算法并不适用于所有问题,在应用前需要仔细分析问题的特性,并验证贪心策略的正确性。
贪心算法在实际应用中常被用于解决资源分配、调度、编码等问题,如活动选择、分数背包、哈夫曼编码等。希望本文能够帮助读者掌握贪心算法的设计思想和应用技巧,深入理解贪心算法。
That’s all, thanks for reading!
创作不易,点赞鼓励;
知识无价,收藏备用;
持续精彩,关注不错过!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 30
 0
- 0


 已为社区贡献5条内容

所有评论(0)