【滑动窗口】找到字符串中所有字母异位词
438. 找到字符串中所有字母异位词
给定两个字符串 s 和 p,找到 s 中所有 p 的 异位词 的子串,返回这些子串的起始索引。不考虑答案输出的顺序。
异位词 指由相同字母重排列形成的字符串(包括相同的字符串)。
示例 1:
输入: s = "cbaebabacd", p = "abc"
输出: [0,6]
解释:
起始索引等于 0 的子串是 "cba", 它是 "abc" 的异位词。
起始索引等于 6 的子串是 "bac", 它是 "abc" 的异位词。
示例 2:
输入: s = "abab", p = "ab"
输出: [0,1,2]
解释:
起始索引等于 0 的子串是 "ab", 它是 "ab" 的异位词。
起始索引等于 1 的子串是 "ba", 它是 "ab" 的异位词。
起始索引等于 2 的子串是 "ab", 它是 "ab" 的异位词。
提示:
1 <= s.length, p.length <= 3 * 104s和p仅包含小写字母
解题思路一:哈希表 + 暴力破解
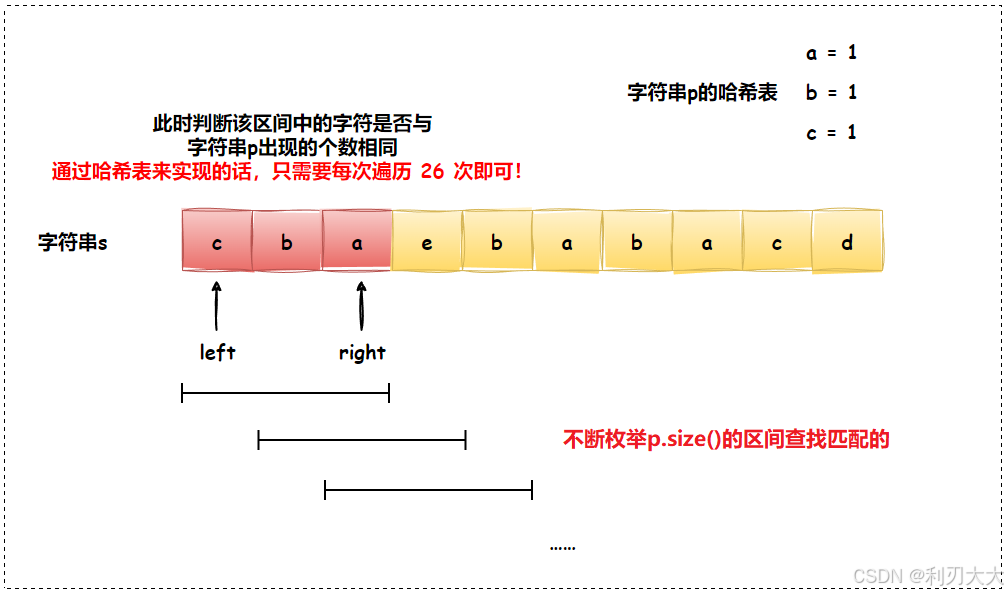
对于字符串的求异位词问题,其实很容易想到的就是用哈希表来解决,但是不同的是,这道题是需要找出匹配的子串的起始索引,那么这里我们先讲如何使用暴力破解,因为后面的滑动窗口就是根据暴力破解得来的!
首先我们可以将字符串 p 的字符映射到哈希表中,因为这道题仅包含小写字母,所以我们可以用一个 int hash[26] 大小的数组来充当哈希表即可!
接着我们再定义一个哈希表 comparehash,用于指针在遍历的时候映射遍历的字符!
然后定义两个指针 left 和 right,让 right 往后走,直到 [left, right] 区间的元素满足 p.size() 的时候也就是 right - left + 1 == p.size() 的时候,就要判断 [left, right] 区间上映射的字符 comparehash,是否等于 hash 中映射的字符:
- 如果说字符都是相等的话,就将此时的
left尾插到返回数组中。 - 如果字符不是全相等的话,则继续往后遍历。
遍历的方式就是让 left 和 right 此时一起走,因为满足长度要求之后,left 走一格的时候 right 肯定要走一格才满足要求,直到 right 走出界了为止!
💥解题思路二:哈希表 + 滑动窗口
进行滑动窗口的优化,其实对于这道题很明显,因为这道题的窗口的长度实际上是不会变的,一直都是 p.size(),不像我们以前遇到的滑动窗口的题,要么是可能 right 一直走而 left 不动,或者 left 一直走而 right 不动的情况,这里就不一样了,因为我们只有在满足 p.size() 的时候判断才有意义,所以我们要一直保持窗口大小不变,也就是 right 走一步,left 就走一步!
至于为什么可以用滑动窗口来解决,相信做过前面的题就知道,因为我们其实 不用每次都让 right 往回退,因为在 [left, right] 区间内,此时哈希表 comparehash 已经记录了该区间的字符出现次数了,如果说 left++ 之后又要让 right 重新从 left 开始走,其实就白白浪费了刚才记录下来的字符出现次数了,因为 right 肯定还是要走到满足字符串长度的为止也就是之前的 right 处,所以这是一直在重复的工作,而因为我们是遍历整个字符串,这样子算下来时间复杂度就很高了,所以我们要 优化一下,从 right 指针不回退入手,也就是一直往后走!
剩下的任务就是关系出入窗口的时机,以及更新结果的时机了!
算法流程如下(与暴力破解大体相似):
- 定义一个哈希表
hash,将字符串p中的字符都映射到哈希表中;定义另一个哈希表comparehash,用于记录滑动窗口中字符的映射 - 定义
left和right指针,分别是滑动窗口的左右边界 - 首先让
right往后走,相当于进窗口,则让comparehash[s[right] - ‘a’]++- 如果滑动窗口大小
right - left + 1 > p.size()的话,则要让左边界也开始移动,即comparehash[s[left] - ‘a’]--,别忘了还有left++,这两步是出窗口操作 - 出窗口之后此时窗口大小就等于
p的长度了,则要看看comparehash中的字符是否和hash中的字符完全相等- 完全相等的话则直接向返回数组中尾插
left也就是起始索引 - 反之则不成立,则继续往后遍历
- 完全相等的话则直接向返回数组中尾插
- 如果滑动窗口大小
- 重复上述操作直到
right出界!
class Solution {
public:
    vector<int> findAnagrams(string s, string p) {
        int hash[26] = { 0 };
        for(auto e : p)
            hash[e - 'a']++;

        vector<int> ret;
        int left = 0;
        int comparehash[26] = { 0 };
        for(int right = 0; right < s.size(); ++right)
        {
            comparehash[s[right] - 'a']++; // 进窗口

            if(right - left + 1 > p.size())
            {
                // 出窗口
                comparehash[s[left] - 'a']--;
                left++;
            }

            // 判断是否更新结果
            if(right - left + 1 == p.size())
            {
                int flag = true;
                for(int i = 0; i < 26; ++i)
                {
                    if(comparehash[i] != hash[i])
                    {
                        flag = false;
                        break;
                    }
                }
                if(flag)
                    ret.push_back(left);
            }
        }
        return ret;
    }
};
💥优化
上面这种解法虽然在这道题能跑过去,但是在后面一些题按照同样的思路就会超时了,所以我们现在要再次优化一下,优化的主要切入点,起始就是这个比较两个哈希表的过程,其实我们可以做做优化!
要优化,我们得多定义一个变量 count,让它来记录当前滑动窗口中 “有效字符” 的个数!
下面主要讲一下出入窗口的时机以及更新结果的时机,这是和上面的不同之处:
- 在遍历
right的时候,此时s[right]入窗口之后,判断一下是否comparehash[s[right] - 'a'] ≤ hash[s[right] - 'a']- 如果是的话,说明此时
s[right]进入这个窗口,对字符串p来说是有贡献的,则让count++ - 反之说明对you’xiao没有影响,则不用管!
- 如果是的话,说明此时
- 在判断是否出窗口的时候,当
s[left]出窗口后,判断一下是否comparehash[s[left] - 'a'] < hash[s[left] - 'a']- 如果是的话说明此时
s[left]离开窗口,对字符串p来说是有影响的,所以要让count-- - 反之说明
s[left]是多余的或者不属于字符串p的,则不用管
- 如果是的话说明此时
- 然后只要
count == p.size(),说明有效个数和字符串p的字符是完全一样了,此时就更新left到结果数组中
class Solution {
public:
    vector<int> findAnagrams(string s, string p) {
        int hash[26] = { 0 };
        for(auto e : p)
            hash[e - 'a']++;

        vector<int> ret;
        int left = 0;
        int count = 0;
        int comparehash[26] = { 0 };
        for(int right = 0; right < s.size(); ++right)
        {
            // 进窗口
            comparehash[s[right] - 'a']++;
            if(comparehash[s[right] - 'a'] <= hash[s[right] - 'a']) // “有效”才能进窗口
                count++;

            if(right - left + 1 > p.size())
            {
                // 出窗口
                comparehash[s[left] - 'a']--;
                if(comparehash[s[left] - 'a'] < hash[s[left] - 'a']) // “有效”才能出窗口
                    count--;
                left++; // 别忘了移动窗口
            }

            if(count == p.size())
                ret.push_back(left);
        }
        return ret;
    }
};

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献7条内容

所有评论(0)