仅需10G显存,使用 Unsloth 微调 Qwen2 并使用 Ollama 推理
最近这一两周不少大厂都已经开始秋招面试了。
不同以往的是,当前职场环境已不再是那个双向奔赴时代了。求职者在变多,HC 在变少,岗位要求还更高了。
本文主要使用Unsloth基于Qwen2基础模型微调对话机器人以及在Ollama上运行。
仅需要10G显存,使用Unsloth来微调Qwen2创建自定义聊天机器人,并创建GGUF文件,可以在PC端本地运行。
1 Unsloth是什么?
Unsloth是一个预训练模型微调框架,专注于提高训练速度和减少显存占用。针对现在主流模型,如Llama-3,Qwen2,Mistral等LLM的微调速度可提升2倍,内存使用量减少70%,而且准确度并不会降低!
- 所有内核均用OpenAI 的 Triton语言编写
- 准确度损失为 0%
- 通过bitsandbytes支持 4 位和 16 位 QLoRA / LoRA 微调。
- 开源训练速度提高 5 倍
- 拥有一张很酷的贴纸!所有基于Unsloth的模型都可以用这张贴纸
图片
2 Ollama是什么?
Ollama 是一款极其简单的基于命令行的工具,用于运行 LLM,极易上手,可用于构建 AI 应用程序。本文使用Ollama作为我们的推理引擎。
图片
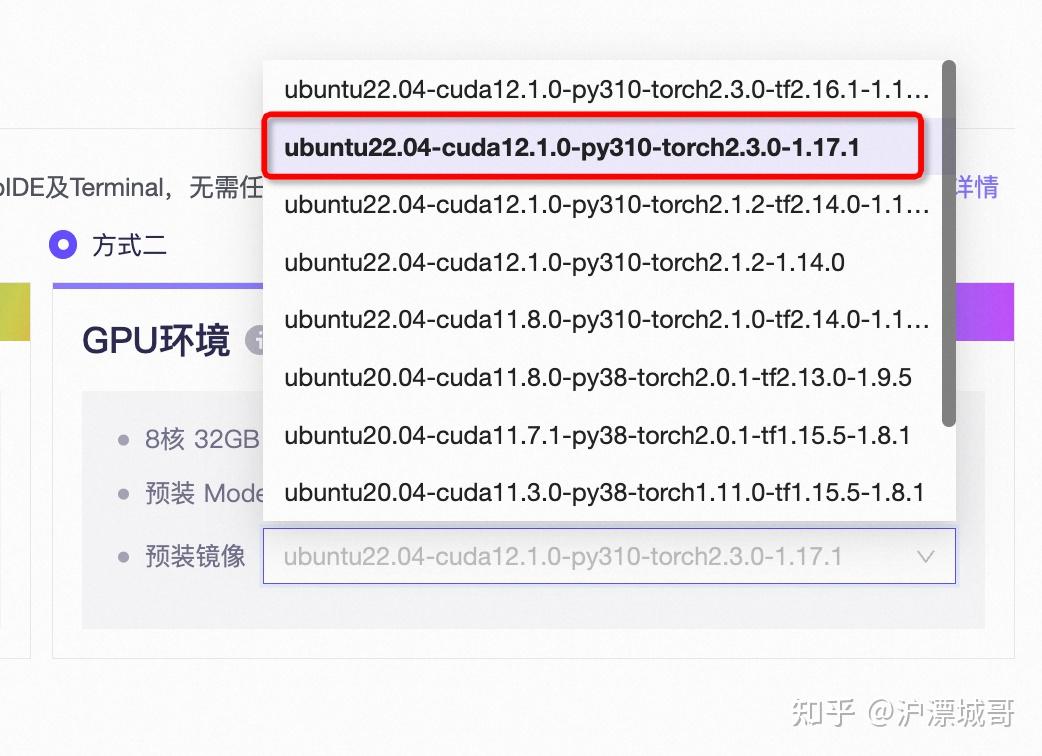
3 环境安装
图片
安装Unsloth:
!pip install "unsloth[cu121-torch230] @ git+https://github.com/unslothai/unsloth.git"4 选择需要微调的模型
本文选择Qwen2-7B,Qwen2 是 Qwen 大型语言模型的新系列。与最先进的开源语言模型(包括之前发布的 Qwen1.5)相比,Qwen2 总体上超越了大多数开源模型,并在一系列针对语言理解、语言生成、多语言能力、编码、数学、推理等的基准测试中展现出与专有模型的竞争力。
from unsloth import FastLanguageModel
import torch
from modelscope import snapshot_download
max_seq_length = 2048
dtype = torch.bfloat16
load_in_4bit = True


model_dir=snapshot_download("qwen/Qwen2-7B")
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = model_dir,
    max_seq_length = max_seq_length,
    dtype = dtype,
    load_in_4bit = load_in_4bit,
)
其中三个参数的设置:
max_seq_length = 2048这决定了模型的上下文窗口长度,比如Qwen2-7B的上下文长度为32K,并可以通过yarn拓展到128K。本文从测试的角度,设置上下文长度为2048。
dtype = torch.bfloat16根据A10的GPU选择torch.bfloat16
load_in_4bit = True本文采用 4 位量化进行微调。这样可将内存使用量减少 4 倍。4 位量化本质上将权重转换为一组有限的数字以减少内存使用量。这样做的缺点是准确度会下降 1-2%。
5 微调参数
model = FastLanguageModel.get_peft_model(
    model,
    r = 16, # Choose any number > 0 ! Suggested 8, 16, 32, 64, 128
    target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
                      "gate_proj", "up_proj", "down_proj",],
    lora_alpha = 16,
    lora_dropout = 0, # Supports any, but = 0 is optimized
    bias = "none",    # Supports any, but = "none" is optimized
    # [NEW] "unsloth" uses 30% less VRAM, fits 2x larger batch sizes!
    use_gradient_checkpointing = "unsloth", # True or "unsloth" for very long context
    random_state = 3407,
    use_rslora = False,  # We support rank stabilized LoRA
    loftq_config = None, # And LoftQ
)
微调参数的设置目标是改变这些微调参数以提高微调的准确性,同时也不希望发生过拟合。过度拟合是指让语言模型记住数据集,而无法回答新颖的新问题。本文希望最终模型能够回答从未见过的问题,而不是进行记忆。
r = 16, # Choose any number > 0 ! Suggested 8, 16, 32, 64, 128微调过程的rank。数值越大,占用的内存越多,速度越慢,但可以提高复杂任务的准确性。通常建议数值为 8(用于快速微调),最高可达 128。数值过大可能会导致过度拟合,从而损害模型的质量。
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
                  "gate_proj", "up_proj", "down_proj",],
本文选择所有模块进行微调。您可以删除一些模块以减少内存使用量并加快训练速度,但强烈不建议这样做。
lora_alpha = 16,微调的缩放因子。较大的数字将使微调更多地了解您的数据集,但可能会导致过度拟合。建议将其等于等级r,或将其加倍。
lora_dropout = 0, # Supports any, but = 0 is optimized将其保留为 0 以加快训练速度!可以减少过度拟合,但效果不大。
bias = "none", # Supports any, but = "none" is optimized将其保留为 none,以实现更快、更少的过度拟合训练!
use_gradient_checkpointing = "unsloth", # True or "unsloth" for very long context选项包括True、False 和"unsloth"。本文建议这样做"unsloth",因为unsloth将内存使用量减少了 30%,并支持极长的上下文微调。
random_state = 3407,确定确定性运行的次数。训练和微调需要随机数,因此设置此数字可使实验可重复。
use_rslora = False, # We support rank stabilized LoRA高级功能可自动设置lora_alpha = 16。
loftq_config = None, # And LoftQ高级功能可将 LoRA 矩阵初始化为权重的前 r 个奇异向量。可以在一定程度上提高准确度,但一开始会使内存使用量激增。
6 Prompt模板和数据集
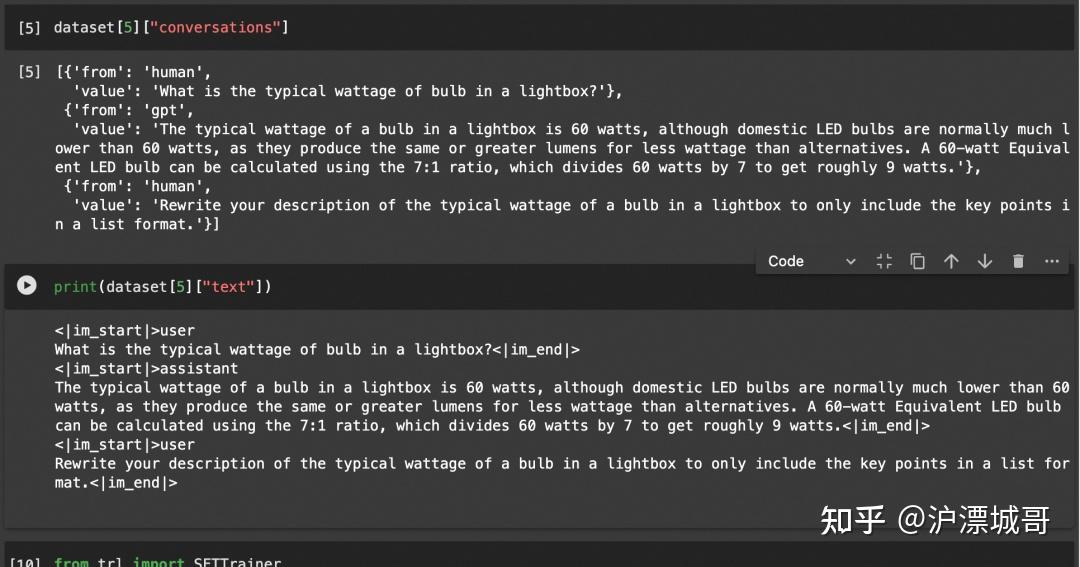
现在使用 Qwen-2 的chatml格式进行对话风格微调。数据集使用 ShareGPT 风格的 Open Assistant 对话数据集。
使用 get_chat_template 函数来获取正确的聊天模板。get_chat_template 函数目前支持 zephyr、chatml、mistral、llama、alpaca、vicuna、vicuna_old 等模板。
注意 ShareGPT 使用 {"from": "human", "value" : "Hi"} 而不是 {"role": "user", "content" : "Hi"},因此使用mapping做一轮映射。
from unsloth.chat_templates import get_chat_template

tokenizer = get_chat_template(
    tokenizer,
    chat_template = "chatml", # Supports zephyr, chatml, mistral, llama, alpaca, vicuna, vicuna_old, unsloth
    mapping = {"role" : "from", "content" : "value", "user" : "human", "assistant" : "gpt"}, # ShareGPT style
)

def formatting_prompts_func(examples):
    convos = examples["conversations"]
    texts = [tokenizer.apply_chat_template(convo, tokenize = False, add_generation_prompt = False) for convo in convos]
    return { "text" : texts, }
pass

from modelscope.msdatasets import MsDataset
dataset =  MsDataset.load('OmniData/guanaco-sharegpt-style', split = "train")
dataset = dataset.map(formatting_prompts_func, batched = True,)
可以看到mapping前后的数据集的具体样式:
图片
7 训练模型
下面开始训练模型,使用huggingface的trl库
from trl import SFTTrainer
from transformers import TrainingArguments
from unsloth import is_bfloat16_supported

trainer = SFTTrainer(
    model = model,
    tokenizer = tokenizer,
    train_dataset = dataset,
    dataset_text_field = "text",
    max_seq_length = max_seq_length,
    dataset_num_proc = 2,
    packing = False, # Can make training 5x faster for short sequences.
    args = TrainingArguments(
        per_device_train_batch_size = 2,
        gradient_accumulation_steps = 4,
        warmup_steps = 5,
        max_steps = 60,
        learning_rate = 2e-4,
        fp16 = not is_bfloat16_supported(),
        bf16 = is_bfloat16_supported(),
        logging_steps = 1,
        optim = "adamw_8bit",
        weight_decay = 0.01,
        lr_scheduler_type = "linear",
        seed = 3407,
        output_dir = "outputs",
    ),
)
通常不建议更改上述参数,但需要详细说明其中一些参数:
per_device_train_batch_size = 2,如果想更多地利用 GPU 的内存,请增加批处理大小。同时增加批处理大小可以使训练更加流畅,并使过程不会过度拟合。
gradient_accumulation_steps = 4,相当于将批量大小增加到自身之上,但不会影响内存消耗!如果您想要更平滑的训练损失曲线,通常建议增加这个值。
max_steps = 60, # num_train_epochs = 1,我们将步骤设置为 60 以加快训练速度。对于可能需要数小时的完整训练运行,请注释掉max_steps,并将其替换为num_train_epochs = 1。将其设置为 1 表示对数据集进行 1 次完整传递。通常建议传递 1 到 3 次,不要更多,否则您的微调会过度拟合。
learning_rate = 2e-4,如果您想让微调过程变慢,但同时又最有可能收敛到更高精度的结果,请降低学习率。我们通常建议尝试 2e-4、1e-4、5e-5、2e-5 作为数字。
trainer_stats = trainer.train()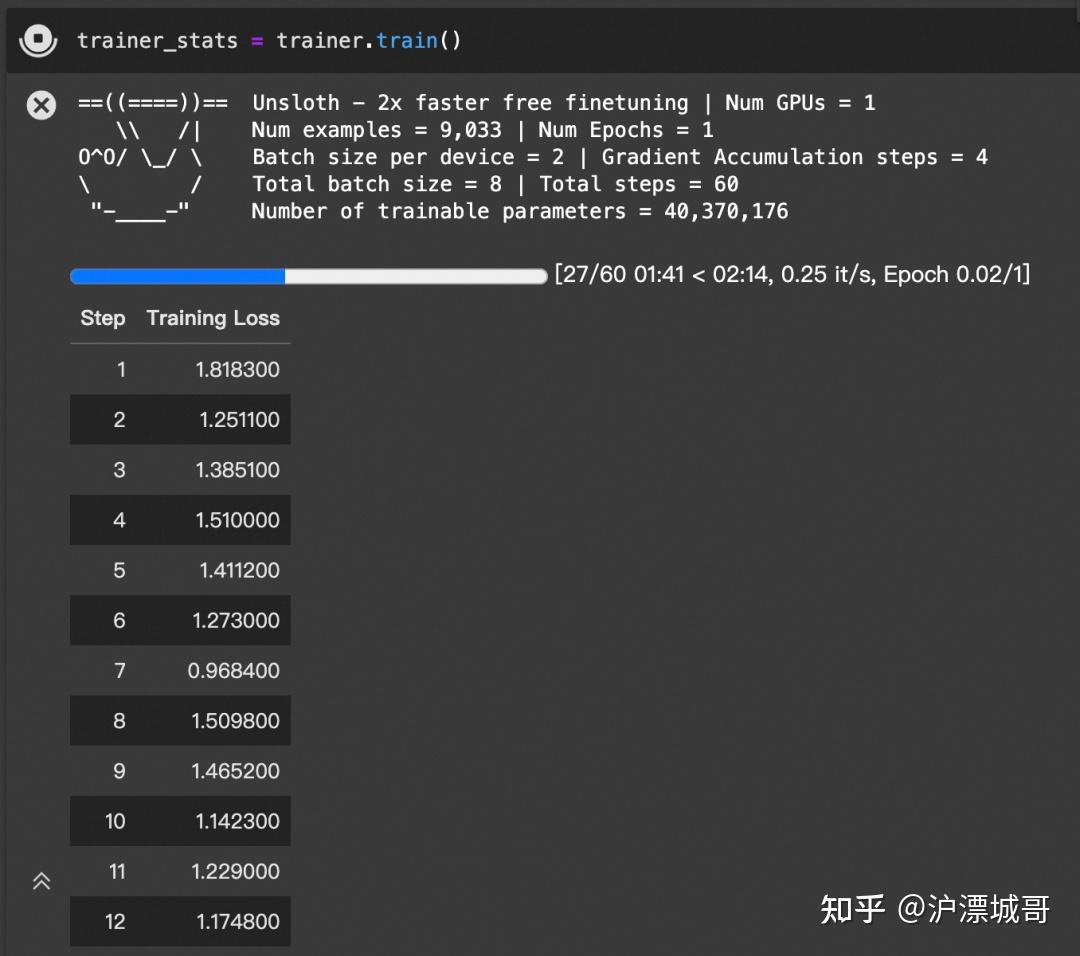
图片
显存占用(使用Unsloth):
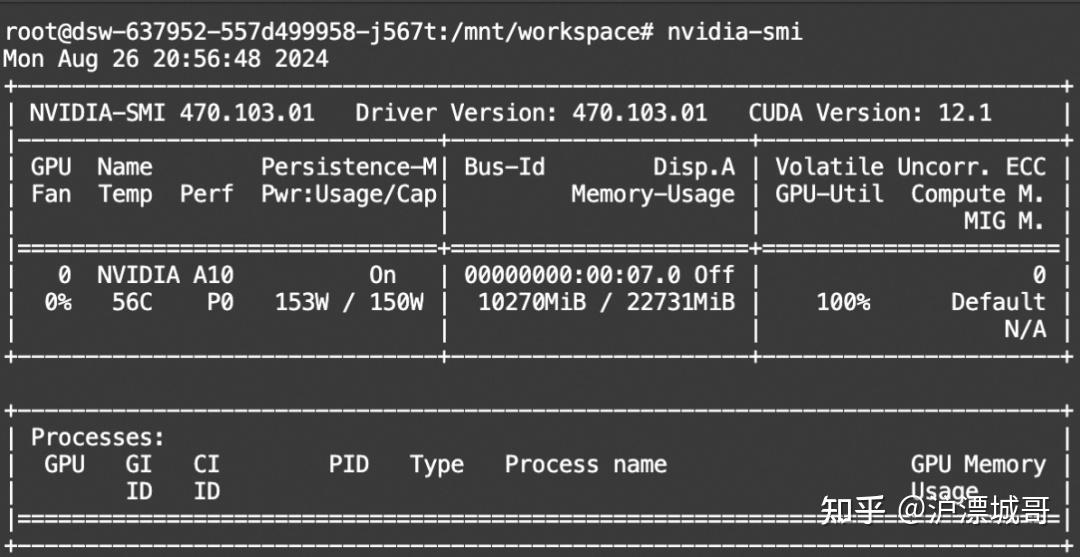
图片
8. 推理/运行模型
完成训练过程后运行模型!
from unsloth.chat_templates import get_chat_template

tokenizer = get_chat_template(
    tokenizer,
    chat_template = "chatml", # Supports zephyr, chatml, mistral, llama, alpaca, vicuna, vicuna_old, unsloth
    mapping = {"role" : "from", "content" : "value", "user" : "human", "assistant" : "gpt"}, # ShareGPT style
)

FastLanguageModel.for_inference(model) # Enable native 2x faster inference

messages = [
    {"from": "human", "value": "杭州的省会在哪里?"},
]
inputs = tokenizer.apply_chat_template(
    messages,
    tokenize = True,
    add_generation_prompt = True, # Must add for generation
    return_tensors = "pt",
).to("cuda")

outputs = model.generate(input_ids = inputs, max_new_tokens = 64, use_cache = True)
tokenizer.batch_decode(outputs)
也支持流式输出:
FastLanguageModel.for_inference(model) # Enable native 2x faster inference

messages = [
    {"from": "human", "value": "杭州的省会在哪里?"},
]
inputs = tokenizer.apply_chat_template(
    messages,
    tokenize = True,
    add_generation_prompt = True, # Must add for generation
    return_tensors = "pt",
).to("cuda")

from transformers import TextStreamer
text_streamer = TextStreamer(tokenizer, skip_prompt = True)
_ = model.generate(input_ids = inputs, streamer = text_streamer, max_new_tokens = 128, use_cache = True)
9.保存模型
我们将微调后的模型保存到一个名叫LoRA的100MB小文件。
model.save_pretrained("lora_model") # Local saving
tokenizer.save_pretrained("lora_model")
10.导出至Ollama
最后,可以将经过微调的模型导出为GGUF格式!本文选择的量化方法是q4_k_m格式。可以前往https://github.com/ggerganov/llama.cpp了解有关 GGUF 的更多信息。
if True: model.save_pretrained_gguf("model", tokenizer, quantization_method = "q4_k_m")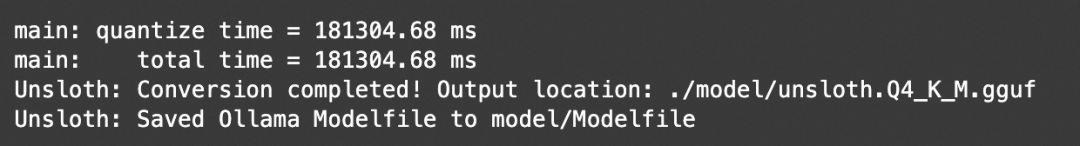
图片
11.自动创建Modelfile
Unsloth 在转化模型为GGUF格式的时候,自动生成Ollama所需的Modelfile文件,其中包括模型的路径和我们用于微调过程的聊天模板!可以打印Modelfile生成的模板,如下所示:
print(tokenizer._ollama_modelfile)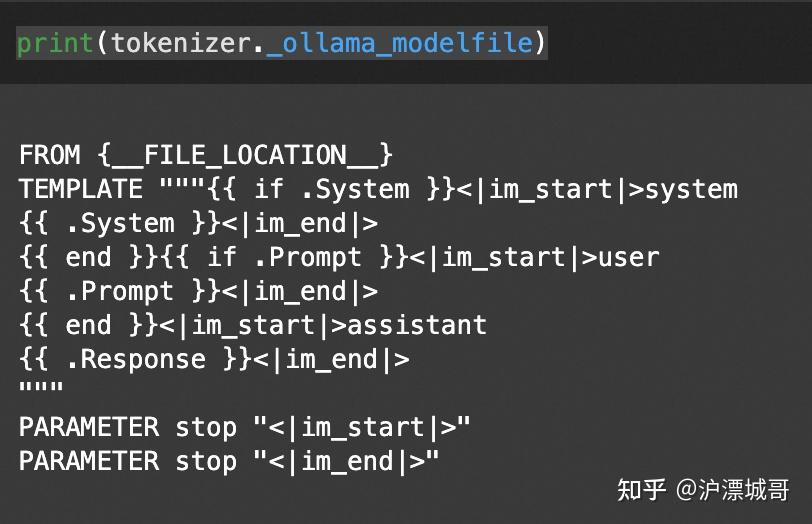
图片
12.使用Ollama创建和推理模型
Linux环境使用
Liunx用户可使用魔搭镜像环境安装【推荐】
git clone https://www.modelscope.cn/modelscope/ollama-linux.git
cd ollama-linux
sudo chmod 777 ./ollama-modelscope-install.sh
./ollama-modelscope-install.sh
启动Ollama服务
ollama serve创建自定义模型
使用ollama create命令创建自定义模型
!ollama create unsloth_qwen2 -f /mnt/workspace/model/Modelfile多轮对话测试
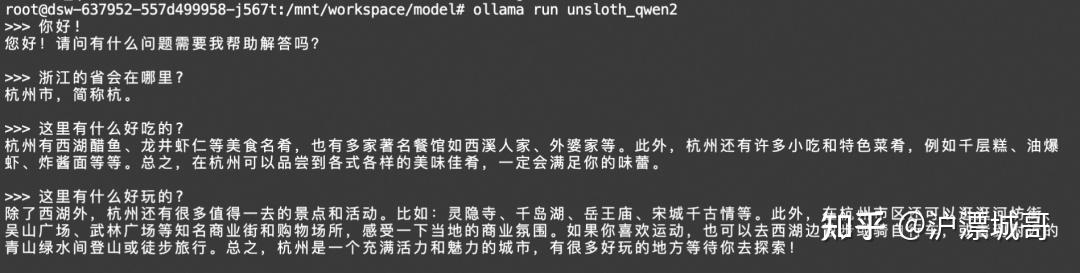
在terminal中运行gguf模型
ollama run unsloth_qwen2测试模型多轮对话效果:
图片
至此,您已经成功使用Unsloth微调了Qwen2基础模型,使之具备多轮对话能力,并导出Ollama支持本地运行,显存使用10G以内。
这份《AI产品经理学习资料包》已经上传CSDN,还有完整版的大模型 AI 学习资料,朋友们如果需要可以在文末CSDN官方认证二维码免费领取【保证100%免费】
资料包: CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享
AI产品经理,0基础小白入门指南
作为一个零基础小白,如何做到真正的入局AI产品?
什么才叫真正的入局?
是否懂 AI、是否懂产品经理,是否具备利用大模型去开发应用能力,是否能够对大模型进行调优,将会是决定自己职业前景的重要参数。
你是否遇到这些问题:
1、传统产品经理
不懂Al无法对AI产品做出判断,和技术沟通丧失话语权
不了解 AI产品经理的工作流程、重点
2、互联网业务负责人/运营
对AI焦虑,又不知道怎么落地到业务中想做定制化AI产品并落地创收缺乏实战指导
3、大学生/小白
就业难,不懂技术不知如何从事AI产品经理想要进入AI赛道,缺乏职业发展规划,感觉遥不可及
为了帮助开发者打破壁垒,快速了解AI产品经理核心技术原理,学习相关AI产品经理,及大模型技术。从原理出发真正入局AI产品经理。
这里整理了一些AI产品经理学习资料包给大家
📖AI产品经理经典面试八股文
📖大模型RAG经验面试题
📖大模型LLMS面试宝典
📖大模型典型示范应用案例集99个
📖AI产品经理入门书籍
📖生成式AI商业落地白皮书
🔥作为AI产品经理,不仅要懂行业发展方向,也要懂AI技术,可以帮助大家:
✅深入了解大语言模型商业应用,快速掌握AI产品技能
✅掌握AI算法原理与未来趋势,提升多模态AI领域工作能力
✅实战案例与技巧分享,避免产品开发弯路
这份《AI产品经理学习资料包》已经上传CSDN,还有完整版的大模型 AI 学习资料,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
资料包: CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享
AI大模型学习福利
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
大模型&AI产品经理如何学习
求大家的点赞和收藏,我花2万买的大模型学习资料免费共享给你们,来看看有哪些东西。
1.学习路线图
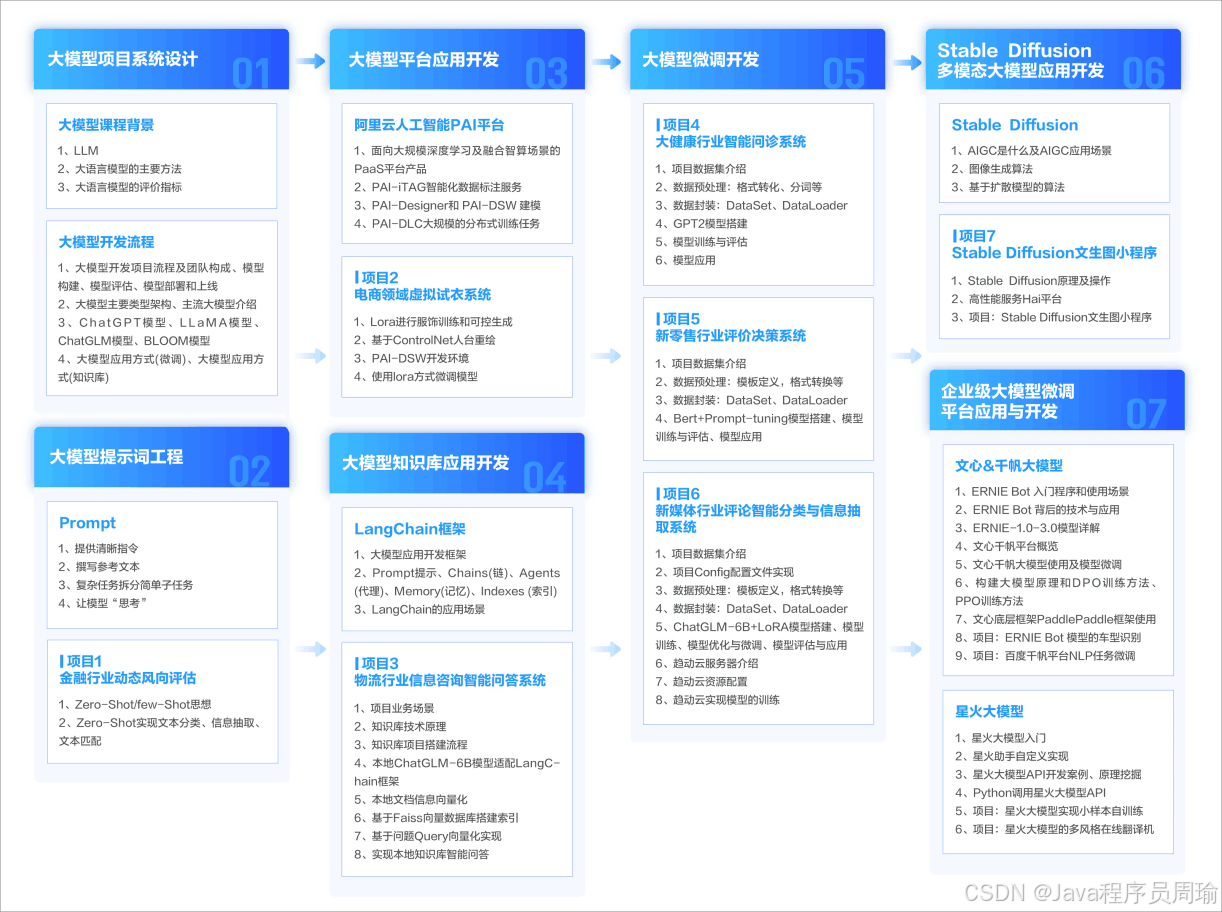
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
2.视频教程
网上虽然也有很多的学习资源,但基本上都残缺不全的,这是我自己整理的大模型视频教程,上面路线图的每一个知识点,我都有配套的视频讲解。
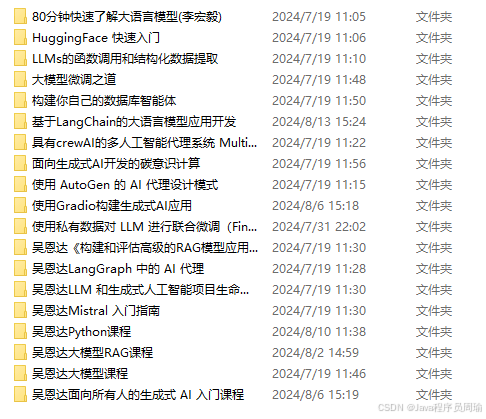
(都打包成一块的了,不能一一展开,总共300多集)
因篇幅有限,仅展示部分资料,需要点击CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享前往获取
3.技术文档和电子书
这里主要整理了大模型相关PDF书籍、行业报告、文档,有几百本,都是目前行业最新的。
4.LLM面试题和面经合集
这里主要整理了行业目前最新的大模型面试题和各种大厂offer面经合集。

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
1.AI大模型学习路线图
2.100套AI大模型商业化落地方案
3.100集大模型视频教程
4.200本大模型PDF书籍
5.LLM面试题合集
6.AI产品经理资源合集
👉获取方式:
😝有需要的小伙伴,可以CSDN大礼包:《对标阿里黑客&网络安全入门&进阶学习资源包》免费分享免费领取【保证100%免费】🆓

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 28
 0
- 0


 已为社区贡献11条内容

所有评论(0)