【论文阅读】Attack To Defend: Exploiting Adversarial Attacks for Detecting Poisoned Models
CVPR 2024
Attack To Defend: Exploiting Adversarial Attacks for Detecting Poisoned Models
本工作的三个主要贡献如下:
- 我们提出了一种名为攻击以防御(A2D)的新方法,用于检测给定目标模型是否已被篡改。A2D 框架针对参考模型生成强大的对抗性攻击,并使用这些攻击来探测目标模型。
- 我们提出了一种新的指标,称为对抗性扰动敏感性(SAP),用于量化 ML 模型在特定扰动范围内对抗性攻击的敏感性。SAP 指标使得能够对 ML 模型的对抗性敏感性(鲁棒性)进行归一化比较。如果目标模型被篡改,其 SAP 值会高于良性模型,这可以被利用来进行被篡改模型检测。
- 实验证明 A2D 方法对未见攻击具有良好的泛化能力,同时只需要对目标模型进行黑盒访问,并且只需要一个小的干净数据集。我们研究了被篡改模型的对抗性路径,并展示了被篡改模型中存在的后门路径使它们更容易受到对抗性攻击。
论文基于的原理和ANP一致:https://zhuanlan.zhihu.com/p/488059960
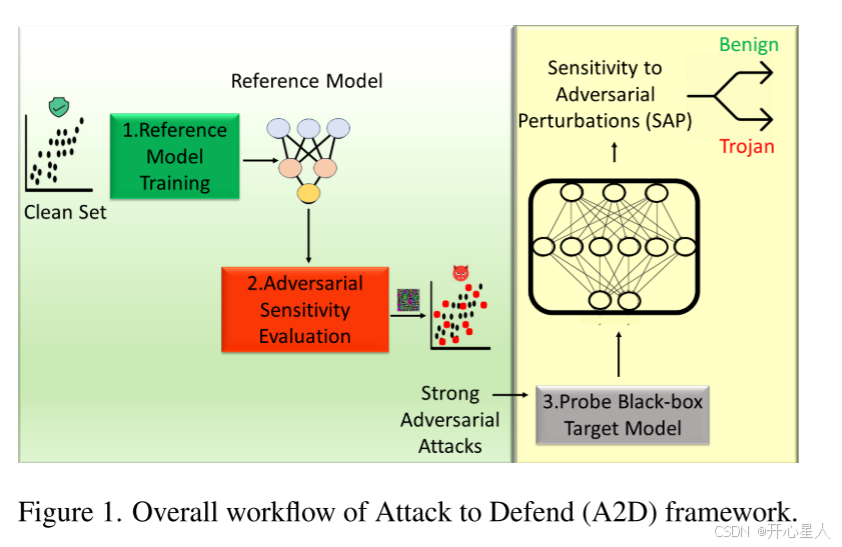
本文提出了一种名为攻击以防御(Attack To Defend,A2D)的检测被篡改模型的新方法,该方法基于观察到被篡改模型对对抗性扰动比良性模型更敏感这一现象。我们提出了一种称为对抗性扰动敏感性(sensitivity to adversarial perturbations,SAP)的指标,用于衡量 ML 模型在特定扰动范围内对抗性攻击的敏感性。我们针对一个不相关的参考模型生成强大的对抗性攻击,并通过转移这些攻击来估计目标模型的 SAP 值。如果目标模型的 SAP 值超过决策阈值,则认为该模型是特洛伊木马模型。A2D 框架只需要对目标模型进行黑盒访问,并且只需要一个小的干净数据集,同时计算效率高。
相关工作
ML 模型的中毒攻击:通过改变触发器的性质和触发器插入函数,已经提出了许多中毒攻击。这些攻击包括:修改(Modify)——在训练和预测过程中插入小的、可见的、静态的触发模式,而不覆盖原始输入(例如 BadNets [19]);输入感知动态攻击(IAD)——插入可见的但样本特定的触发模式 [33];混合(Blend)——将与输入大小相同的触发器与原始样本隐蔽地混合 [9];不可见样本特定后门攻击(ISS)——学习添加不可察觉的样本特定触发器 [27];标签一致性后门攻击(LC)——注入通过对抗性扰动或生成模型生成的输入,这些输入看似合理但难以分类,而不修改训练标签 [47];隐藏/隐蔽触发器后门攻击(HT)——在训练期间隐藏触发器,但在预测时才暴露它们 [38, 41, 48];基于变形的后门攻击(WaNet)——注入不可察觉的基于变形的触发器,而不是噪声扰动 [34];以及正弦波后门信号(SIG)——注入不可察觉且标签一致的正弦波触发器 [1]。
被篡改模型的检测与净化:通常通过构建多个良性模型和被篡改的影子模型,查询这些影子模型以提取区分性特征,并基于这些特征学习一个元分类器来检测被篡改模型。虽然元神经特洛伊木马检测(MNTD)[53] 动态优化查询集和元分类器以区分良性模型和被篡改模型,但 [24] 中学习了通用试纸模式(ULP)以实现相同的目标。在 [23] 中,通过分析 DNN 模型中对应于不同类别的关键路径来检测被篡改模型。大多数净化方法依赖于逆向工程触发器模式并取消学习这些模式。此类逆向工程防御(RED)方法的例子包括:神经净化(NC)[49]——搜索可能将所有输入推向目标类别的触发器并取消学习这些触发器;深度检查(DI)——学习条件生成模型以生成潜在触发器 [7];反后门扫描(ABS)[29]——根据激活行为识别可能被篡改的神经元;特征重用(FRE)[50]——使用特征空间约束逆向工程触发器;以及预期可转移性(ET)[52]——测量同一类别样本之间触发器模式的可转移性。
对抗性攻击与中毒攻击的交叉研究:近期的研究从多个角度探讨了对抗性攻击与中毒攻击之间的关系。其中一个研究方向是将对抗性样本用作后门攻击的触发器 [55] 或用于检测被篡改训练样本的探针 [54]。另一条有趣的研究路线是探讨对抗性训练与后门攻击之间的联系 [13–15, 32, 35, 45, 51]。例如,研究表明,使用具有更大扰动预算的对抗性样本以及“空间”对抗性训练可以更好地防御中毒攻击 [51]。尽管这些研究具有启发性,但它们都没有直接回答是否可以利用对抗性攻击来检测被篡改模型的问题。我们提出的方法在理论上最接近卡珊德拉(Cassandra,CAS)[56],因为它们基于类似的假设,即被篡改模型对对抗性攻击更敏感。在 CAS [56] 中,使用通用对抗性扰动 [31] 来探测目标模型,并使用启发式攻击难度度量来检测被篡改模型。它需要一个包含大量良性模型和被篡改模型的数据集来学习元分类器,这在训练中不存在的隐蔽攻击上泛化能力较差。在本工作中,我们克服了 CAS 的上述限制,提出了一种基于对标准对抗性攻击敏感性来检测被篡改模型的简单且合理的方法。
method
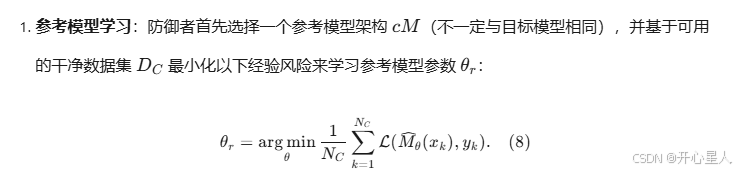
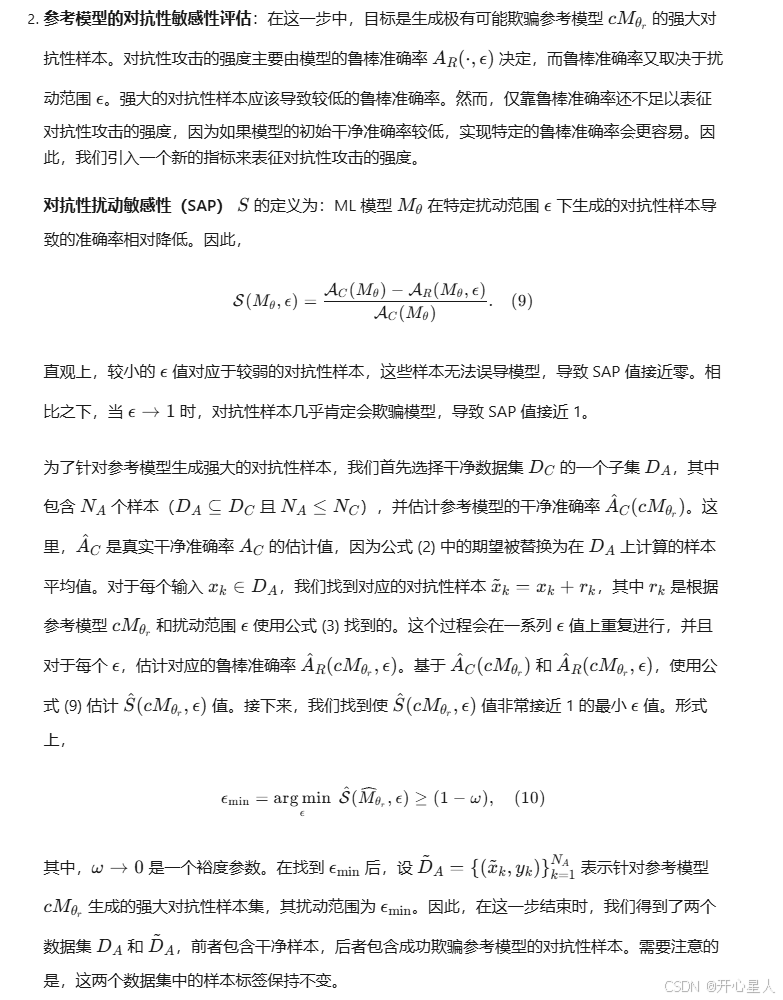
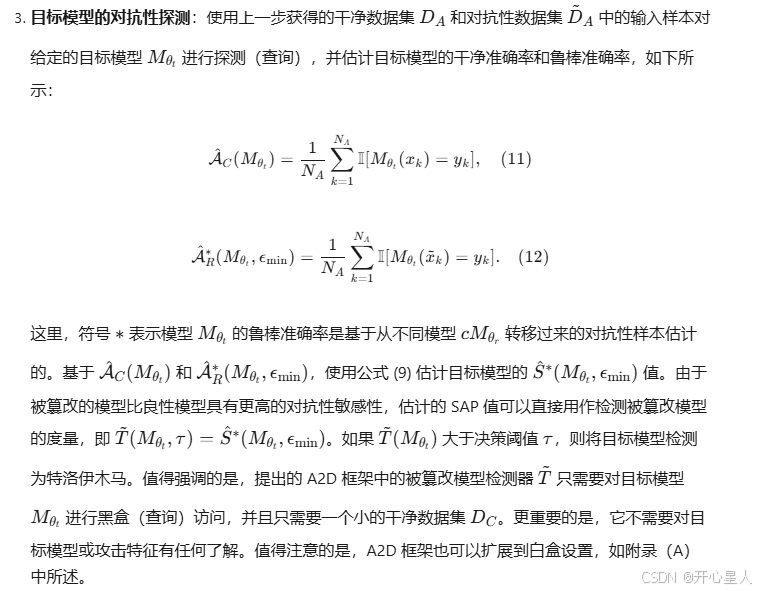
提出的攻击以防御(A2D)框架包含三个主要步骤:(i)学习一个参考模型,(ii)生成能够绕过参考模型的强大对抗性样本,(iii)基于从参考模型生成的对抗性样本来探测目标模型,以评估目标模型对对抗性攻击的敏感性。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献6条内容

所有评论(0)