The advancement in multimodal research has increased focus on Emotion Recognition in Conversations

多模态研究的进步使得对话中的情感识别(Emotion Recognition in Conversations, ERC)受到更多关注,其目标是精准捕捉情感变化。基于图卷积的方法能够更好地捕获情感的动态变化,从而提高情感识别的准确性与鲁棒性。然而,现有方法未能区分对话的交互模式,导致其在建模上下文情感关系时存在局限性。本文提出了一种动态交互双模态超图卷积网络(Dynamic Interactive Bimodal HyperGraph Convolutional Networks, DIB-HGCN),创新性地构建了两类子超图——独白子超图(monologic sub-hypergraph)和对话子超图(dialogic subhypergraph),以建模不同交互模式下的情感关系。独白子超图用于探索说话者独白交互中上下文一致的情感,而对话子超图则专注于捕捉对话交互中的情感转移。 同时,单一窗口划分机制难以适应两种交互模式下情感变化速度的差异。为此,我们在独白交互中设置动态窗口以充分利用情感一致的句子节点信息,并在对话交互中引入片段窗口以防止频繁情感转移造成的信息干扰。实验结果表明,所提方法在两个多模态ERC基准数据集上均优于现有方法。
Introduction
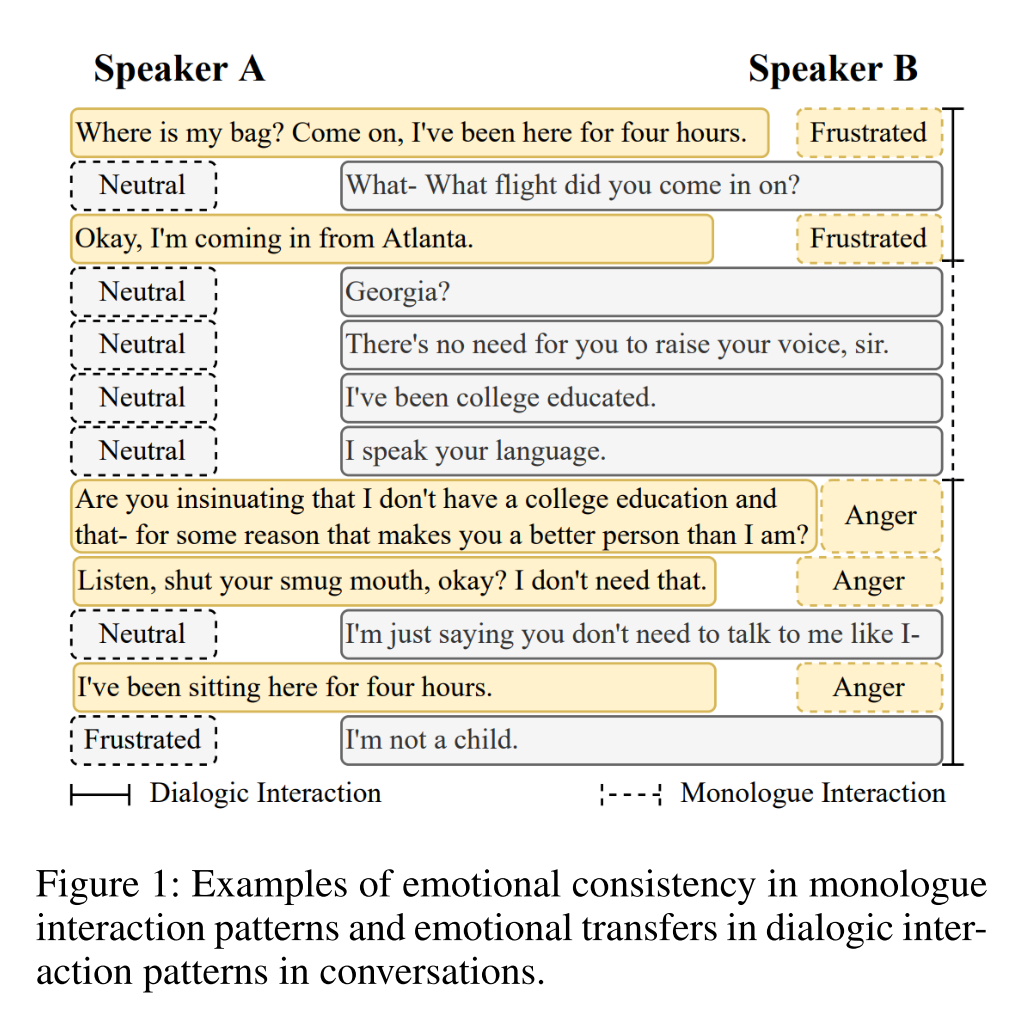
情感交流在人类互动中扮演着关键角色,既是人际关系的纽带,也是促进深度相互理解的重要途径(Zhao et al. 2023)。因此,准确识别对话中的情感已成为社会各界高度关注的议题(Gao et al. 2022)。多模态技术的发展恰好为突破情感识别(ERC)的局限性提供了解决方案,从而更全面地捕捉说话者的情感变化(Kalateh et al. 2024)。它能够深度融合来自不同模态的情感信息,显著提升人机交互及相关应用的整体用户体验(Ghosal et al. 2019)。
与传统的孤立话语情感识别相比,对话情感识别(ERC)因其复杂性和微妙性而具有显著差异,需要充分考虑对话参与者的不同角色。因此,近期研究致力于将参与者信息融入识别过程。例如,部分学者利用循环神经网络(RNN)的时序建模能力,将说话者信息整合到对话建模中(Hazarika et al. 2018a,b)。此外,对话的复杂性远超普通时序数据,这促使研究者将目光转向图卷积网络。一些研究通过构建包含说话者嵌入的图结构来有效捕捉说话者信息(Hu et al. 2022; Li et al. 2024)。CauAIN(Zhao, Zhao and Lu 2022)则从情感诱因检测的角度,建模了说话者内部及之间的依赖关系。这些方法均取得了良好效果,充分证明了对话参与者信息的重要性。然而,它们尚未区分不同交互模式,导致其难以捕捉细粒度的上下文情感关联。
图1展示了对话式交互与独白式交互的区别。对话式交互表现为多方参与的、具有应答轮转的交流过程,而独白式交互则体现为单方持续输出观点且无直接互动的单向表达。如图所示,在乘客丢失背包后的服务场景中,工作人员在独白交互阶段(如例行信息告知)保持情绪稳定;但当交互模式转为对话式(如告知失物消息时),其情绪状态因乘客愤怒辱骂的反馈而从中立转为沮丧。独白交互呈现上下文情感一致性,而对话式交互中的情绪则显著受参与者间互动影响。为解决这一问题,我们提出能适应不同交互模式的双模态超图结构,包含对话子超图与独白子超图两类组件。
在对话中,情感转移往往与上下文线索深度交织。因此,对话情感识别(ERC)需通过综合分析语句间的交互关系来精准定位每句话的情感状态。已有大量研究探索如何将对话信息建模为图结构以捕捉复杂关联:部分学者基于对话全局信息构建图模型——MMGCN(Hu et al. 2021)将对话中每句话的多模态特征作为节点,并连接相同模态节点与同一语句内的跨模态节点;M3NET(Chen et al. 2023a)则构建超图网络来分析ERC中的多元复杂关系。另一些研究则基于上下文信息建模:GraphCFC与MA-CMUSGRNet(Zhang et al. 2024)采用固定上下文窗口关联语句与相关语境;DCGCN(Yang et al. 2024)则依据提出的语篇密度概念动态调整片段窗口。
全局建模研究认为需充分利用对话中每个节点的信息,而上下文建模研究则表明远距离节点可能干扰情感识别。由于对话中情感转移速率存在差异,上述单一窗口划分机制难以适应多种交互模式。我们认为:全局信息更适用于情感渐变(如独白式交互),而局部上下文则更适合情感突变(如对话式交互)。因此,针对独白交互我们动态调节窗口大小以优化语句信息利用;针对对话交互则采用片段窗口来降低远距离语句间情感差异造成的干扰。
综上所述,我们的贡献主要包括:
-
双模态超图构建:为适应对话情感识别(ERC)的复杂性,我们通过区分对话交互模式,构建双模态超图结构——在独白式交互中捕捉同一说话者的情感一致性,在对话式交互中建模参与者间的情感转移。
-
动态窗口机制:针对独白交互设置动态可调窗口,基于连续话轮动态调整独白子超图的窗口大小以实现全局信息建模;针对对话交互则采用片段窗口进行局部建模,避免远距离情感差异造成的干扰。
-
实验验证:通过大量实验验证所提方法的先进性能,并对各模块进行消融研究以证实其有效性。
Related Work
Speaker-specific Modeling in Conversations
传统方法主要依赖于静态的说话者特定建模。ConGCN(Zhang et al. 2019)和CoGBART(Tang et al. 2022)通过将说话者信息融入每个话语单元来实施这一方法,从而定义话语间的关联关系。在对话场景中,情感因素往往错综复杂地交织在一起,其影响通过语言线索、语调变化和面部表情等渠道传递(Mariooryad and Busso 2013),这对说话者特定建模提出了更高要求。因此,SEGD(Chen et al. 2023b)等最新方法开始采用动态说话者特定建模——通过说话者状态编码器来探索说话者内部及之间的依赖关系。
静态说话者特定建模虽能捕捉对话上下文,却忽视了说话者间的动态交互;而动态建模虽考虑了说话者内及说话者间的变化,却难以应对快速情感转变,导致对话式交互中的情感识别准确性受限。这些局限性促使我们转向不针对特定说话者建模,而是直接显式建模交互模式。针对这些挑战,本研究创新性地区分对话中的独白式与对话式交互——聚焦前者中的情感一致性,捕捉后者中的情感转移。
Context Modeling in Conversations
RNN-based Methods.
LSTM(Hochreiter and Schmidhuber 1997)作为序列数据处理常用方法,适用于对话序列建模。bc-LSTM(Poria et al. 2017)与MFN(Zadeh et al. 2018)为各模态分配独立LSTM进行建模。而DialogueCRN(Hu, Wei and Huai 2021)从情感认知视角出发,通过多LSTM架构整合上下文关系,实现了对对话语境的全面理解。GRU作为轻量级替代方案,在上下文依赖建模中表现突出:CMN(Hazarika et al. 2018b)和ICON(Hazarika et al. 2018a)采用GRU(Chung et al. 2014)模拟说话者记忆与相互依赖关系;DialogueRNN(Majumder et al. 2019)则通过GRU三重编码架构(全局状态、说话者状态、情感状态)强化了序列建模能力。
Transformer-based Methods.Transformer的发明在人工智能领域掀起新浪潮,对话情感识别(ERC)等方向亦受其深刻影响。KET(Zhong, Wang and Miao 2019)采用分层自注意力机制,结合外部常识知识解析对话数据的情感底层特征;DialogXL(Shen et al. 2021)提出对话感知的自注意力框架,在保持历史上下文完整性的同时实现动态建模;Ctnet(Lian, Liu and Tao 2021)则利用Transformer架构强大的上下文建模能力,有效获取对话序列中的全局语境信息。
GNN-based Methods.
图神经网络(GNN)能有效建模对话情感识别(ERC)中的复杂节点信息。基于GNN的方法根据边特征可分为无向图、有向图和超图三类:无向图方法通常通过全局建立同一模态内节点的两两连接来构建图结构;GraphCFC则利用边的方向性刻画节点与上下文说话者关系;DCGCN进一步优化该方法,根据其图构建策略动态调整上下文窗口。HGNN(Feng et al. 2019)作为超图卷积的开创性工作,提出通用超图神经网络框架,验证了其在建模高阶数据依赖关系的有效性;M3NET则首次将超图概念引入对话情感识别领域。
除上述方法外,RGCN(Chen et al. 2019)将残差设计融入图卷积以捕捉复杂上下文特征,MA-CMU-SGRNet结合GNN与Transformer实现局部与全局语义建模,PIRNet(Lian, Liu and Tao 2022)则采用多阶段框架融合个人影响力与上下文信息。RNN虽擅长序列建模却受限于长程记忆,Transformer虽能捕获全局依赖但可能忽略序列信息,而基于超图的GNN能有效建模复杂关系。现有研究表明,基于GNN的方法在关系建模方面具有优势,其中超图结构特别适合捕捉多元高阶关联。受此启发,我们将现有超图方法扩展至细粒度对话场景,以更精准推断对话过程中的情感演变。
Methodology
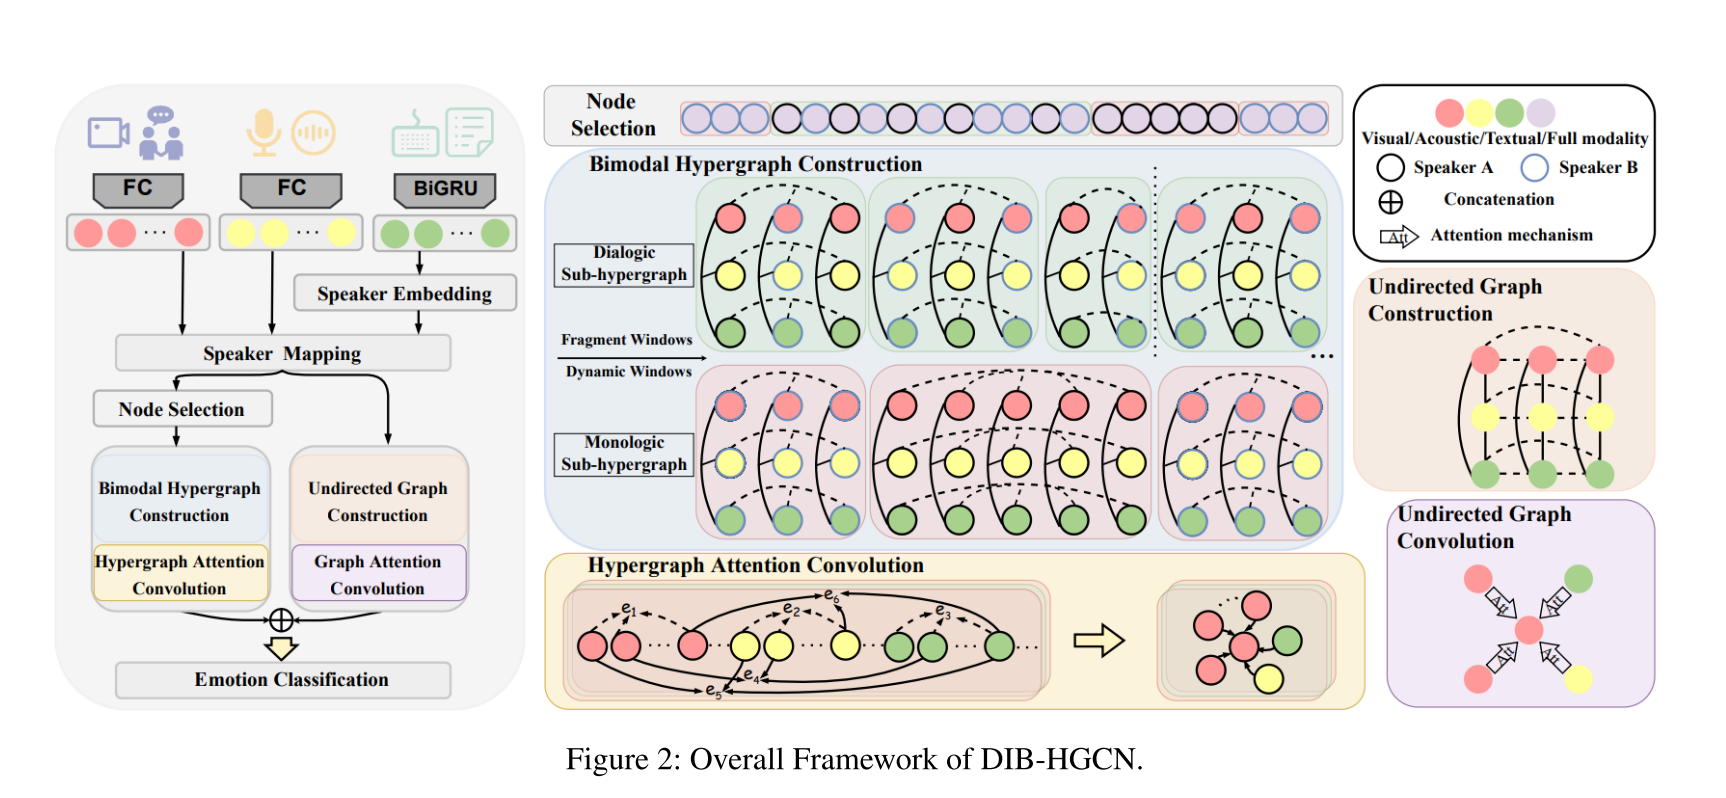
图2展示了DIB-HGCN的整体架构,该模型旨在精准捕捉不同交互模式下的上下文情感一致性及情感转移。首先获取对话的多模态数据后,我们将每个话语编码为表征向量并映射至对应说话者;接着基于说话者信息判定交互模式,将对话划分为多个片段;随后提出双模态超图,通过子超图对不同交互模式的话语信息分别建模。为更好适应不同交互模式,我们构建了动态窗口(用于独白交互)和片段窗口(用于对话交互)。进一步采用超图注意力卷积逐层更新节点信息,同时并行构建节点信息的无向图,通过无向图注意力卷积更新节点表征。最终拼接这些特征并通过输出层获得情感状态的最终表征。具体实现细节将在后续章节详细阐述。
Problem Formulation
设对话序列为U=[u1,u2,...,uN]U=[u_1,u_2,...,u_N]U=[u1,u2,...,uN],其中NNN表示对话中的语句总数。对应的说话者序列可表示为Usp=[sp1,sp2,...,spN](M≥2)U_{sp}=[sp_1,sp_2,...,sp_N](M\geq2)Usp=[sp1,sp2,...,spN](M≥2),MMM为说话者数量。单模态输入特征表示为Um=[u1m,u2m,...,uNm]U^m=[u_1^m,u_2^m,...,u_N^m]Um=[u1m,u2m,...,uNm],其中m∈{a,v,t}m\in\{a,v,t\}m∈{a,v,t}分别对应声学、视觉和文本模态。定义情感标签集合Y=[y1,y2,...,yk]Y=[y_1,y_2,...,y_k]Y=[y1,y2,...,yk],kkk为情感类别总数。对话情感识别(ERC)的任务目标是根据给定的多模态上下文数据,为每个语句ui(∀i∈[1,N])u_i(\forall i\in[1,N])ui(∀i∈[1,N])预测其对应预定义情感集合YYY中的情感标签。
Unimodal Encoding
现有研究(Yao and Shi 2024; Li et al. 2024; Chen et al. 2023a)表明,基于RNN的方法在文本特征提取方面表现优异,但在其他模态上性能提升有限。因此,针对文本模态特征,我们采用双向门控循环单元(BiGRUs)编码第iii个语句的初始表征xitx_i^txit,并通过嵌入层计算说话者嵌入,二者相加得到单模态文本表征υt\upsilon^tυt:
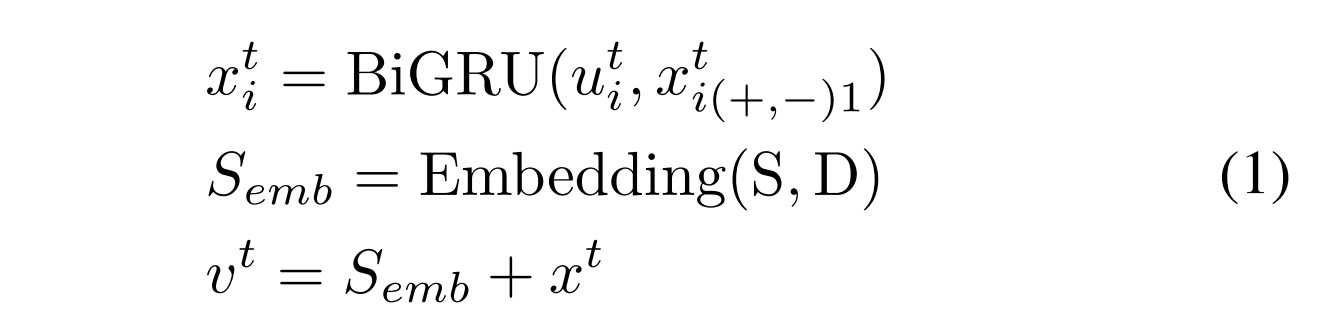
其中SSS表示说话者集合,DDD为说话者数量。
针对声学和视觉模态,我们采用全连接网络获取表征{via,viv}\{v_i^a,v_i^v\}{via,viv}:
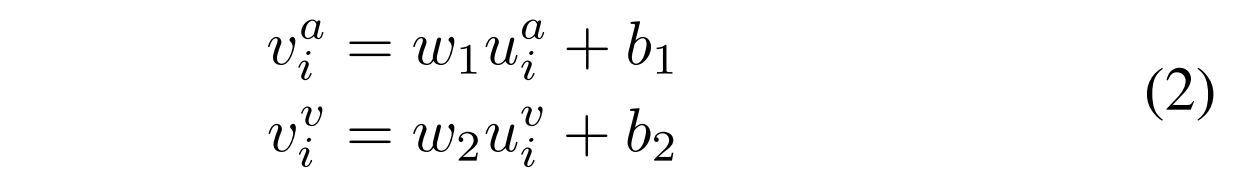
其中w1w_1w1、w2w_2w2为全连接层权重参数,b1b_1b1、b2b_2b2为对应偏置项,均为可训练参数。
Bimodal Hypergraph-based Feature Extraction
Bimodal Hypergraph Construction
在对话情感识别(ERC)任务中,对话的多种属性(如多说话者信息、多模态数据)均属于高阶信息(Chen et al. 2023a)。为此,我们创新性地采用双模态超图结构,在区分对话交互模式的同时,有效捕捉此类高阶信息特征。
Bimodal Hypergraph Partitioning:
双模态超图划分:我们构建超图G=(V,E)G = (V, E)G=(V,E)表示每个对话,其中每个节点∀v∈VH(∣VH∣=3N)\forall v \in \mathcal{V}_{\mathcal{H}}(|\mathcal{V}_{\mathcal{H}}| = 3N)∀v∈VH(∣VH∣=3N)对应一个单模态语句,记作{vit,via,viv}\{v_i^t, v_i^a, v_i^v\}{vit,via,viv}。每条超边∀e∈EH\forall e \in \mathcal{E}_{\mathcal{H}}∀e∈EH编码多模态或上下文依赖关系。每个对话进一步划分为对话式子超图GdG_dGd和独白式子超图GmG_mGm:
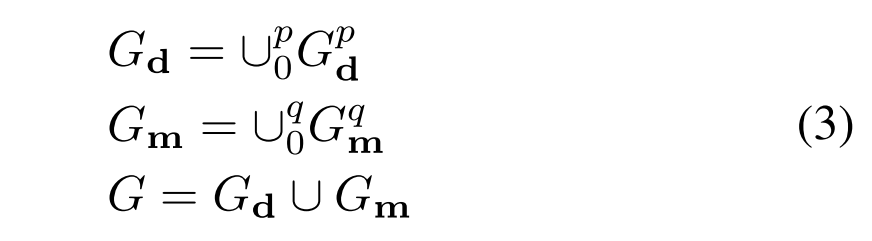
Node Selection:
将每个语句的各模态特征表示为超图中的节点,即υim\upsilon_i^mυim表示第iii个语句的特定模态节点。同时定义映射函数SSS,将节点索引关联至对应说话者,从而实现节点筛选。
在独白式交互中,对话由单一说话者持续输出观点,因此我们规定每个独白子超图的节点需满足连续3个语句对应同一说话者spspsp(sp∈[2,M]sp\in[2,M]sp∈[2,M]),其数学定义为:
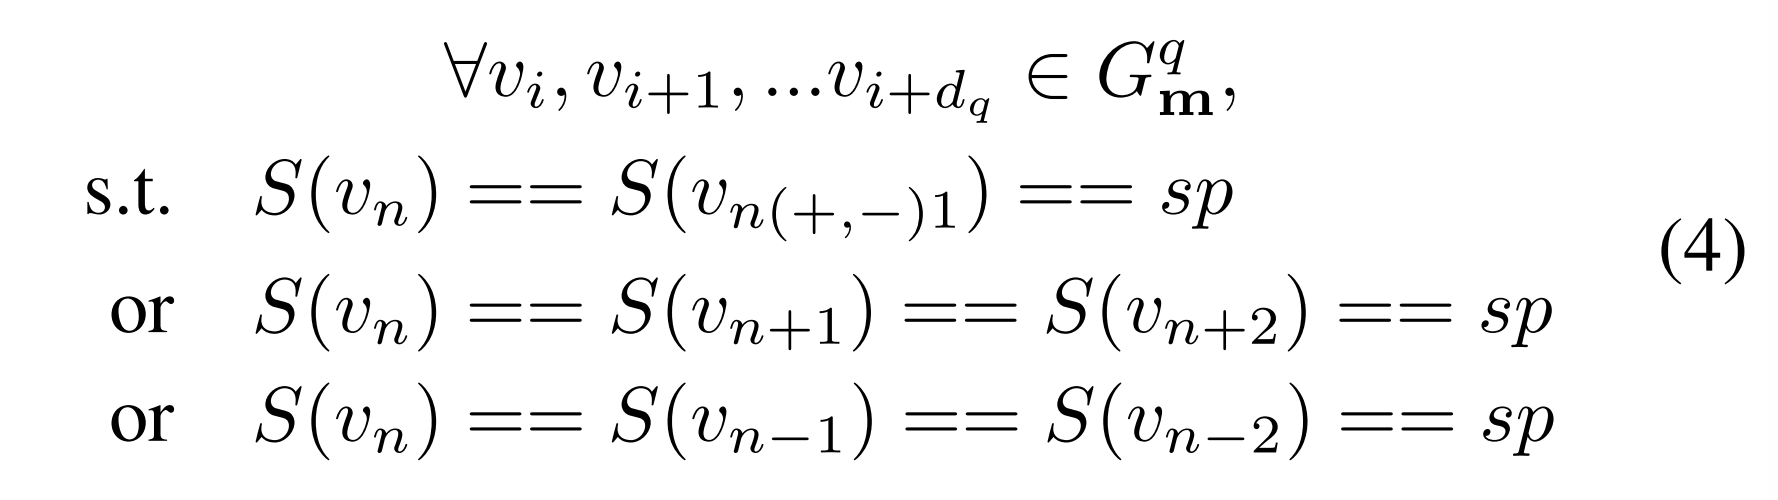
其中n∈[i,i+dq]n\in[i,i+d_q]n∈[i,i+dq],GmqG_\mathbf{m}^qGmq表示第qqq个独白子超图,dqd_qdq为其上下文距离。
在对话式交互中,双方共同参与对话以促进情感转移。我们要求当前节点前后时间步中至少存在一个节点与其说话者信息不同(对于起始/终止节点,仅需检查相邻节点是否属于不同说话者)。若同时满足两种模式,则优先归类为独白子超图。对话子超图的节点需满足以下条件:
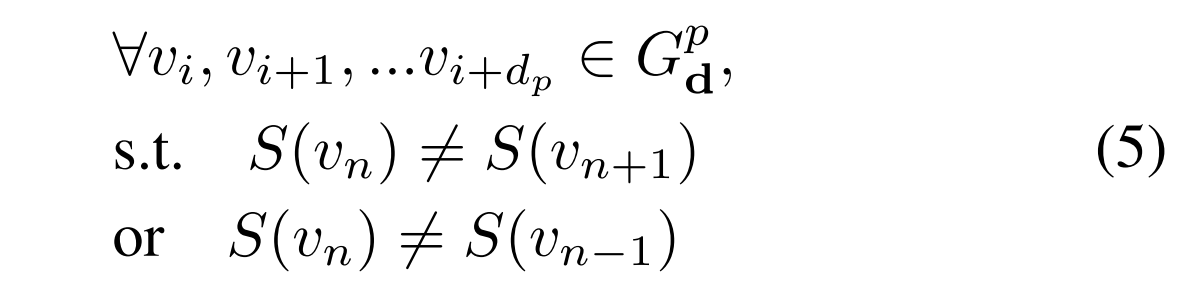
其中GdpG_\mathbf{d}^pGdp表示第ppp个对话子超图,nnn表示子超图中的第nnn个语句节点(n∈(i,i+dp)n\in(i,i+d_p)n∈(i,i+dp)),dpd_pdp表示其上下文距离。
Window Settings:
我们为两类子超图分别设置窗口。在独白交互中,基于上下文距离动态构建动态窗口集合D′={d1,d2,…,dq}D^\prime=\left\{d_1,d_2,\ldots,d_q\right\}D′={d1,d2,…,dq},将其作为超边连接的依据。
由于对话交互中情感转移频繁,当ddd超过分割阈值SegS_\mathrm{eg}Seg时,采用jjj大小的片段窗口以捕捉局部交互情感,避免引入噪声。需注意的是,若ddd不可被jjj整除,剩余节点将自动组成新子图。
Hyperedge:
对于窗口[i,i+d][i,i+d][i,i+d]内的每个节点vlmv_l^mvlm(m∈{a,v,t}m\in\{a,v,t\}m∈{a,v,t},l∈[i,i+d]l\in[i,i+d]l∈[i,i+d]),首先与同窗口同模态的其他节点建立连接:{vhm∣h∈[i,i+d],h≠l}\{v_h^m | h\in[i,i+d], h\neq l\}{vhm∣h∈[i,i+d],h=l}构成模态内超边。同时,每个节点vvv通过跨模态超边与同一语句的多模态特征相连,最终生成节点-超边关联矩阵H\mathbf{H}H,其中Hve=1\mathbf{H}_{ve}=1Hve=1表示节点vvv属于超边eee,否则为0。
Hypergraph Attention Convolution
参考先前工作(Chen et al. 2023a),我们通过基于权重的节点贡献度度量方法计算各节点对超边的贡献,以此控制网络复杂度:
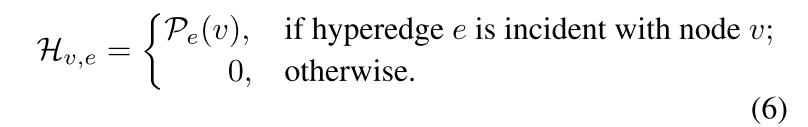
类似地,我们通过训练参数W(e)\mathcal{W}(e)W(e)获得各超边的权重,从而构建超边权重矩阵。其数学表示为:
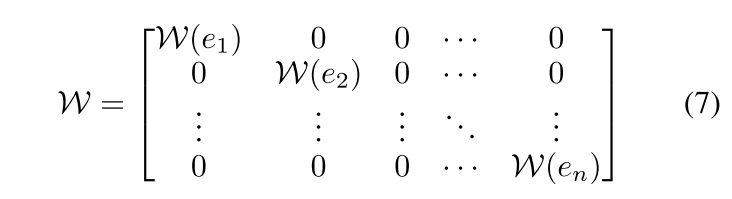
最后,我们可以使用超图注意力卷积来逐层更新节点特征:
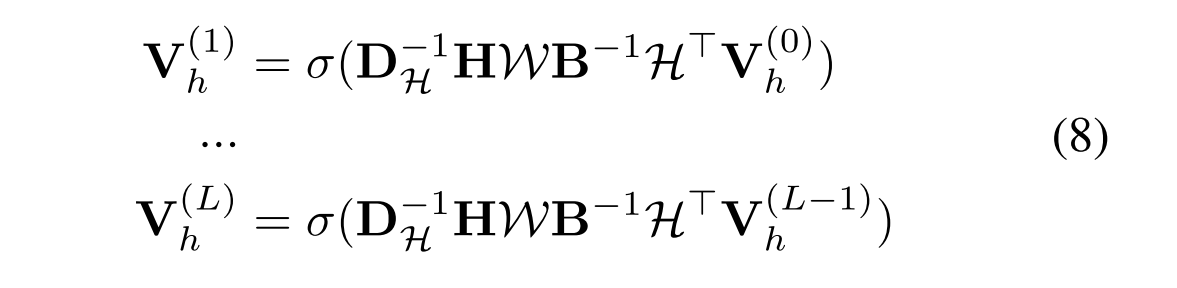
其中Vh(L)={vi,(L)m∣i∈[1,N],m∈{t,a,v}}\mathbf{V}_h^{(L)} = \{v_{i,(L)}^m | i \in [1,N], m \in \{t,a,v\}\}Vh(L)={vi,(L)m∣i∈[1,N],m∈{t,a,v}}表示第LLL层的输出,σ\sigmaσ为非线性激活函数。DH∈R∣VH∣×∣VH∣\mathbf{D}_\mathcal{H} \in \mathbb{R}^{|\mathcal{V}_\mathcal{H}| \times |\mathcal{V}_\mathcal{H}|}DH∈R∣VH∣×∣VH∣是超边度矩阵,B∈R∣EH∣×∣EH∣\mathbf{B} \in \mathbb{R}^{|\mathcal{E}_\mathcal{H}| \times |\mathcal{E}_\mathcal{H}|}B∈R∣EH∣×∣EH∣为节点度矩阵。通过该机制,高阶关系得以逐步优化。
Undirected Graph-based Feature Extraction
Undirected Graph Construction
在前述步骤中,我们通过多个子超图获取了局部信息关联。本节参考(Hu et al. 2021)构建无向图Gun=(Vun,Eun)G_{un}=(V_{un},E_{un})Gun=(Vun,Eun),利用注意力机制自适应捕获全局信息,其中节点特征与超图保持一致,记为{vit,via,viv}\{v_i^t,v_i^a,v_i^v\}{vit,via,viv}。与超图不同,无向图中的语句节点通过以下方式两两连接:
- 同模态连接:节点vimv_i^mvim连接其他语句的同模态节点{vjm∣j∈[1,N],j≠i}\{v_j^m|j\in[1,N],j\neq i\}{vjm∣j∈[1,N],j=i}
- 跨模态连接:连接同一语句的不同模态特征{viz∣z∈{a,v,t},z≠m}\{v_i^z|z\in\{a,v,t\},z\neq m\}{viz∣z∈{a,v,t},z=m}
Undirected Graph Attention Convolution
我们参考前人工作(Chen et al. 2023a),通过设计的滤波器提取注意力权重的高低频特征,其数学表示为:
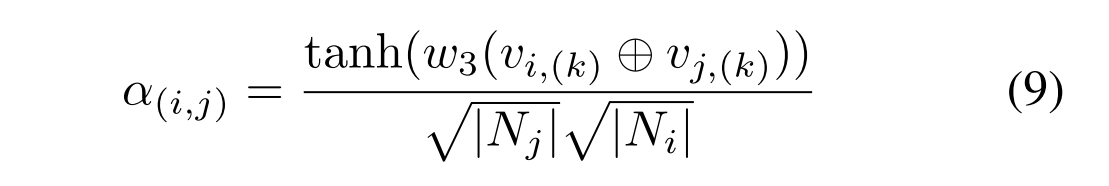
其中NjN_jNj表示节点iii的邻域节点集,⊕\oplus⊕为向量拼接操作,w3∈R2Dh×1w_3\in\mathbb{R}^{2D_h\times1}w3∈R2Dh×1为可训练权重矩阵,tanh(⋅)\tanh(\cdot)tanh(⋅)表示双曲正切函数。该机制使得注意力系数αi,j\alpha_{i,j}αi,j能有效建模不同频率成分的动态重要性。
通过KKK次迭代,使用相邻节点的信息更新每个节点的信息:
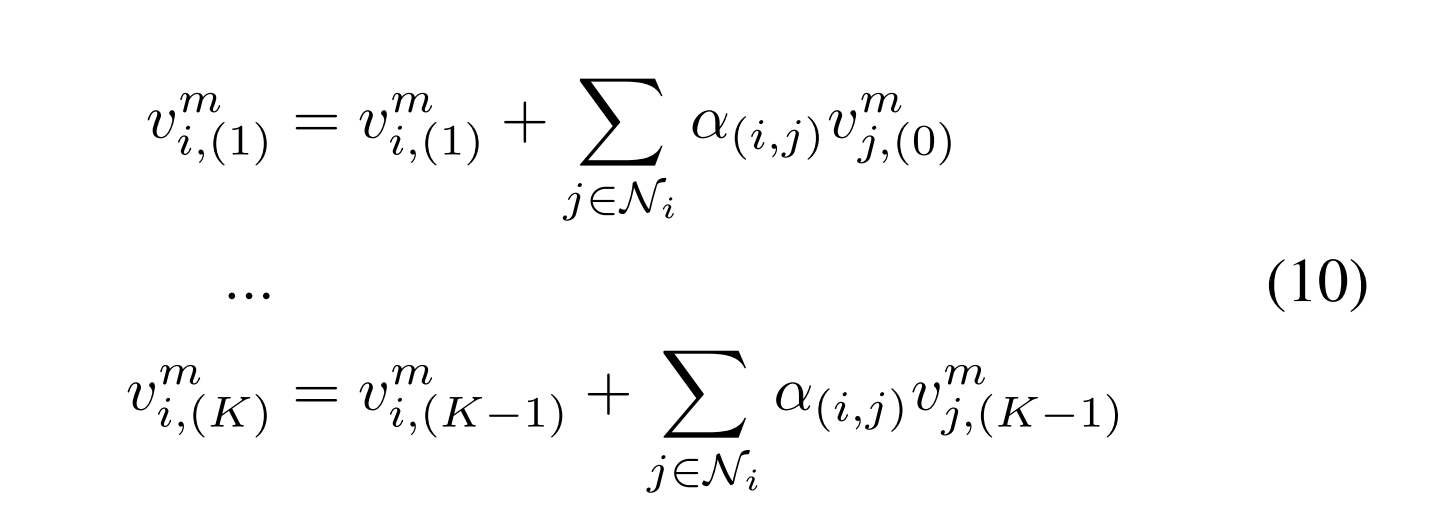
最终,我们获得各模态的表示{vi,(K)t,vi,(K)a,vi,(K)v}\{v_{i,(K)}^{t}, v_{i,(K)}^{a}, v_{i,(K)}^{v}\}{vi,(K)t,vi,(K)a,vi,(K)v},通过拼接操作得到无向图的最终特征表示:
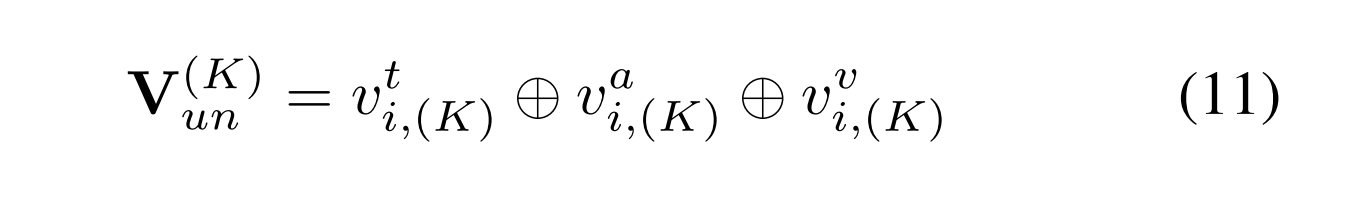
Emotion Classification and Loss Function
情感分类器将超图与无向图的最终特征表示作为联合输入进行情感分类:
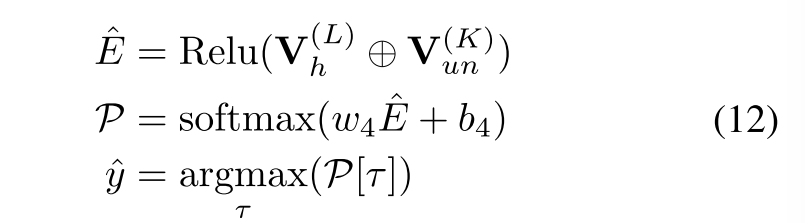
其中w4w_4w4为可训练权重,P∈RC\mathcal{P}\in\mathbb{R}^CP∈RC表示类别概率空间,y^\hat{y}y^为预测标签。我们采用分类交叉熵损失函数并结合L2L_2L2正则化计算网络总损失:
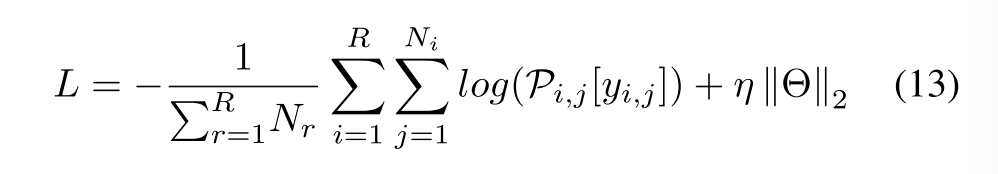
其中RRR表示训练集中的对话样本总数,NrN_rNr为第rrr个对话样本的语句数量。Pi,j\mathcal{P}_{i,j}Pi,j与yi,jy_{i,j}yi,j分别表示第iii个对话中第jjj个语句的预测类别概率分布和真实标签,Θ\ThetaΘ代表所有可训练参数,η\etaη为L2L_2L2正则化权重系数。
Experiments
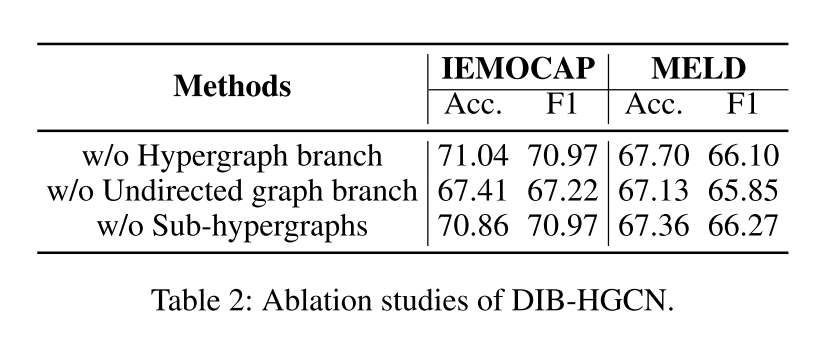
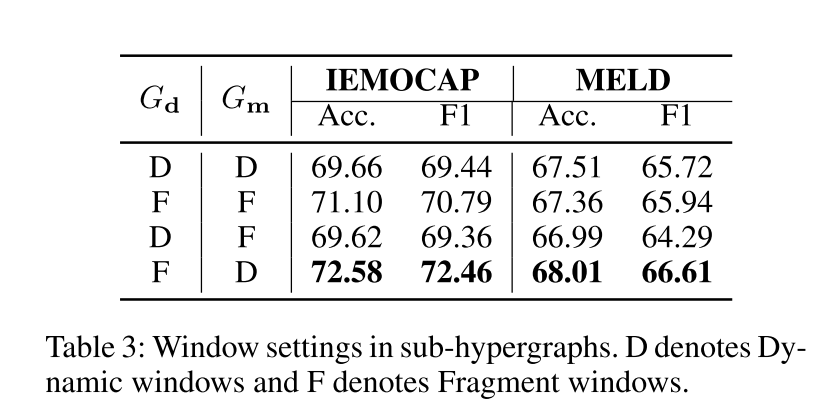
Conclusion
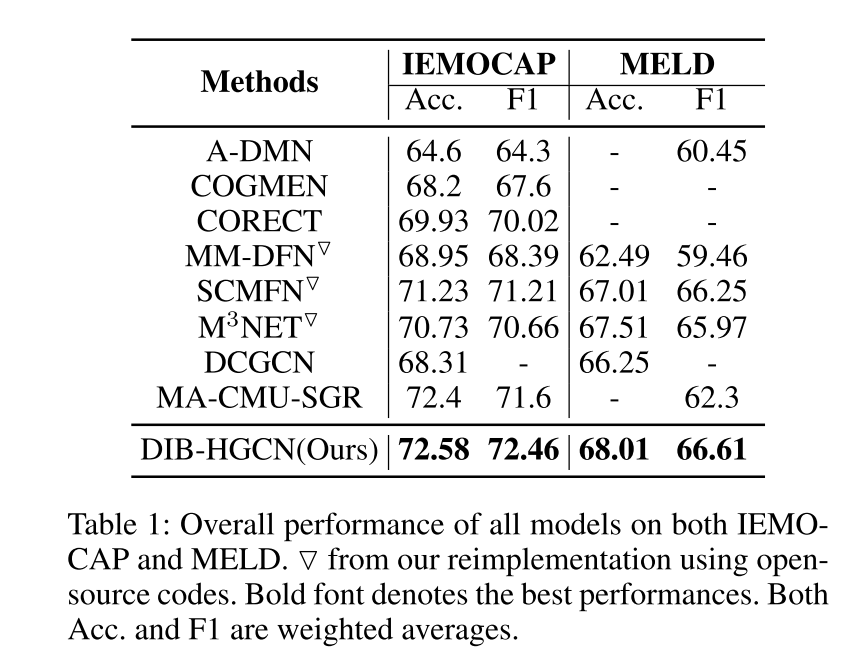
我们构建了基于超图结构的对话情感识别模型。提出的DIB-HGCN方法能够:(1)捕捉不同交互模式下的高阶关系;(2)根据情感变化速率动态融合上下文信息。在标准ERC数据集上的实验结果验证了该方法的有效性。当前研究基于完整数据实现,但实际对话场景中常存在单模态或多模态缺失的情况。为提升实用价值,后续研究将重点突破不完整数据条件下的模型优化。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献8条内容

所有评论(0)