《TimeMixer++: A General Time Series Pattern Machine for Universal Predictive Analysis》
·
全文摘要
本论文提出了T IME M IXER ++,一种通用时间序列模式机器,旨在解决传统模型在捕捉多尺度和多周期性时间序列模式方面的局限。通过多分辨率时间成像(MRTI)、时间图像分解(TID)、多尺度混合(MCM)和多分辨率混合(MRM),T IME M IXER ++能够有效提取复杂的时间序列模式。实验结果表明,该模型在八个时间序列分析任务中均表现出色,超越了现有的通用和任务特定模型,展示了其在时间序列分析中的广泛应用潜力。
研究背景
-
时间序列分析的重要性
- 时间序列分析在多个领域中扮演着关键角色,包括天气预测、医疗症状分类、航天监测中的异常检测以及可穿戴传感器中的缺失数据插补等。这些应用展示了时间序列分析在解决现实世界挑战中的多样性和重要性。
-
传统模型的局限性
- 传统的时间序列模型(如ARIMA和STL)在捕捉非线性动态方面存在困难,限制了它们在多样化任务中的有效性。深度学习模型(如RNN和TCN)虽然能够捕捉序列依赖性,但在处理长期依赖性时常常面临挑战,尤其是在季节性和趋势的建模上。
-
多尺度和多周期性问题
- 时间序列数据的生成过程具有多尺度和多周期性的特征。例如,日数据捕捉小时波动,而年数据反映长期趋势和季节性周期。这种多尺度和多周期性的特性给模型设计带来了重大挑战,因为每个尺度强调不同的时间动态,模型需要有效捕捉这些动态。
-
通用模式识别的需求
- 现有的时间序列模式机器(TSPMs)往往难以捕捉通用模式,限制了它们在不同任务中的适用性。因此,迫切需要一种能够有效提取多样化模式并适应各种时间序列分析任务的模型。
-
任务适应性与表现的矛盾
- 不同的时间序列分析任务(如预测、分类、异常检测等)可能需要不同的表示方式。有些任务需要多样化的表示以捕捉不规则模式,而另一些任务则需要一致的表示以捕捉稳定的趋势和周期模式。这种需求的矛盾使得设计一个灵活的通用模型变得复杂。
-
未来研究的方向
- 论文旨在推动下一代时间序列模式机器的发展,解决上述问题,提供一种能够在多尺度和多周期性动态中捕捉通用、任务适应性时间序列模式的模型。这将为时间序列分析的进一步进展铺平道路。
研究方法
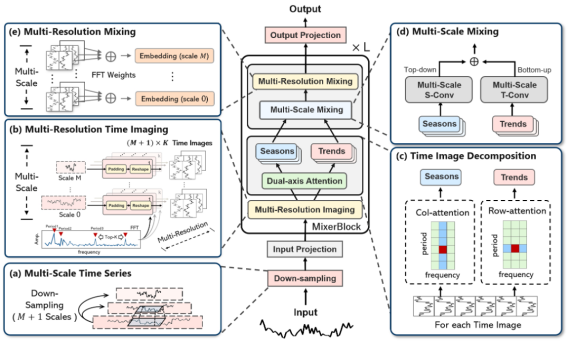
TimeMixer++的结构类似Transformer,包括了下采样、嵌入层(Input Projection),L个堆叠的MixerBlocks、和输出层。其中,每个MixerBlock内部,按顺序包括了 (1) 多分辨率时间成像(2) 时序图分解(3) 多尺度混合和 (4) 多分辨率混合。
-
下采样与嵌入
- 在输入投影阶段,采用通道混合策略以捕捉变量之间的交互作用。通过对变量维度应用自注意力机制,模型能够有效整合跨变量的信息,增强时间序列的表示能力。
-
多分辨率时间成像 (MRTI)
- 该方法将多尺度时间序列转换为多分辨率时间图像,允许在时间和频率域中提取复杂的时间序列模式。通过快速傅里叶变换 (FFT) 识别主要频率,MRTI 能够捕捉到时间序列中的周期性特征。
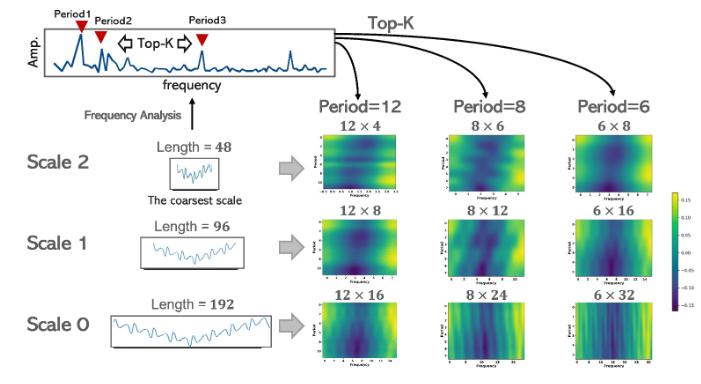
- 该方法将多尺度时间序列转换为多分辨率时间图像,允许在时间和频率域中提取复杂的时间序列模式。通过快速傅里叶变换 (FFT) 识别主要频率,MRTI 能够捕捉到时间序列中的周期性特征。
-
时间图像分解 (TID)
- TID 利用双轴注意力机制,从时间图像中分离出季节性和趋势模式。通过对时间图像应用二维卷积,TID 能够有效提取长程依赖关系,并增强时间序列的分析能力。
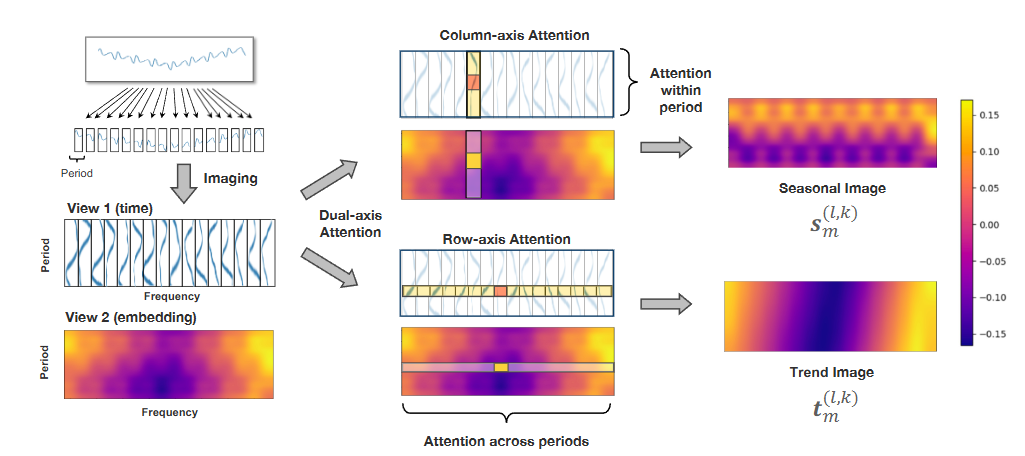
- TID 利用双轴注意力机制,从时间图像中分离出季节性和趋势模式。通过对时间图像应用二维卷积,TID 能够有效提取长程依赖关系,并增强时间序列的分析能力。
-
多尺度混合 (MCM)
- MCM 采用自下而上的信息流动策略,将细尺度的季节性模式与粗尺度的趋势模式进行混合。通过在不同尺度之间进行层次聚合,MCM 能够捕捉到时间序列中的复杂动态。
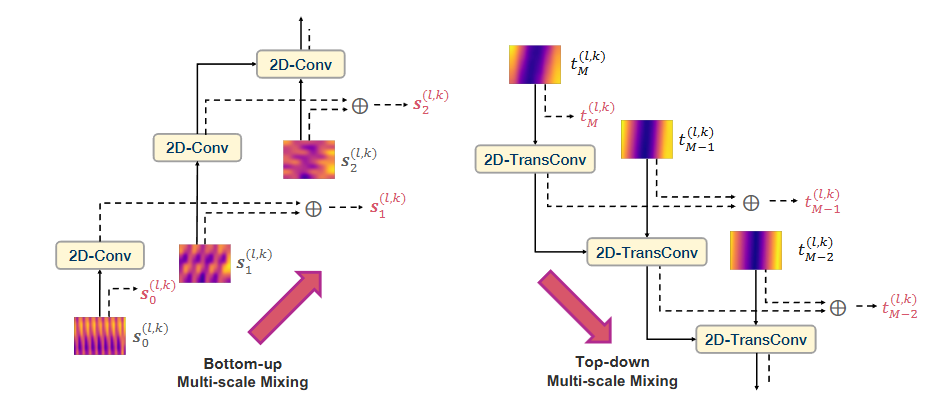
- MCM 采用自下而上的信息流动策略,将细尺度的季节性模式与粗尺度的趋势模式进行混合。通过在不同尺度之间进行层次聚合,MCM 能够捕捉到时间序列中的复杂动态。
-
多分辨率混合 (MRM)
- MRM 在每个尺度上自适应地混合多个周期的表示,利用 FFT 的幅度信息来加权每个周期的重要性。这种方法确保了在不同分辨率下的模式整合,增强了模型的表现力。
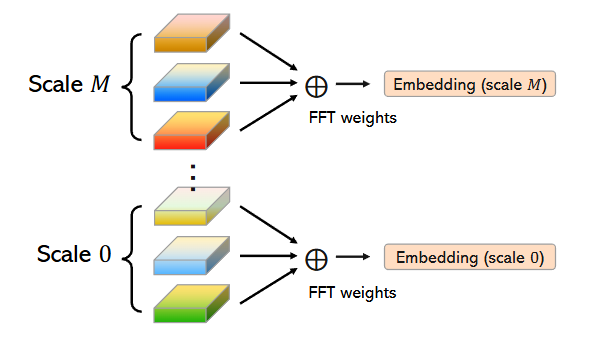
- MRM 在每个尺度上自适应地混合多个周期的表示,利用 FFT 的幅度信息来加权每个周期的重要性。这种方法确保了在不同分辨率下的模式整合,增强了模型的表现力。
-
编码器架构
- 论文提出的模型采用编码器架构,包含多个 MixerBlock 以捕捉时间序列中的复杂模式。每个 MixerBlock 负责将多尺度时间序列转换为多分辨率时间图像,并进行模式的分解与聚合。
-
层次化设计
- 该方法强调在多尺度和多分辨率框架下的层次化交互与整合,允许模型在不同层次上捕捉时间序列的多样性和复杂性。这种设计使得模型能够适应多种时间序列分析任务。
-
自适应集成
- 通过在输出阶段使用多个预测头,模型能够针对特定尺度进行任务适应,增强预测的稳健性。每个预测头专注于其尺度的相关特征,最终通过集成方法汇总信息。
实验结果
-
实验任务概述
- 本研究在8个广泛认可的时间序列分析任务上进行了实验,包括:
- 长期预测
- 单变量短期预测
- 多变量短期预测
- 缺失值填补
- 分类
- 异常检测
- 少样本预测
- 零样本预测
- 本研究在8个广泛认可的时间序列分析任务上进行了实验,包括:
-
长期预测
- 实验设置:使用8个真实世界数据集,包括ETT数据集的四个子集(ETTh1, ETTh2, ETTm1, ETTm2)、天气、太阳能、电力和交通数据集。
- 结果:在长期预测任务中,模型在多个数据集上表现优异,尤其在电力数据集上,MSE比iTransformer低7.3%,MAE低6.3%。在太阳能数据集上,MSE比第二名模型低6.0%,MAE低9.2%。
-
单变量短期预测
- 实验设置:使用M4竞赛数据集,包含100,000个不同频率的市场时间序列。
- 结果:模型在所有指标上显著优于其他模型,SMAPE减少9.7%,MASE减少15.7%。在OWA指标上,模型也表现出色,超越了TimesNet和iTransformer。
-
多变量短期预测
- 实验设置:在PeMS基准上评估,包含多个高维交通网络数据集(PEMS03, PEMS04, PEMS07, PEMS08)。
- 结果:模型在所有关键指标上表现优越,MAE减少19.9%,MAPE减少19.6%。与PatchTST相比,MAE提高了30.8%,显示出在处理高维数据集方面的有效性。
-
缺失值填补
- 实验设置:使用电力和天气领域的数据集进行缺失值填补评估。
- 结果:模型在六个数据集上表现出色,MSE和MAE均为最低,平均MSE比第二名模型TimesNet低25.7%,MAE低17.4%。
-
少样本预测
- 实验设置:在6个不同数据集上进行少样本学习,每个模型仅在10%的可用时间步上进行训练。
- 结果:模型在所有数据集上表现优越,MSE比PatchTST低13.2%。与TimeMixer相比,MSE降低9.4%,MAE降低4.6%。
-
零样本预测
- 实验设置:评估模型在不同上下文中的泛化能力,训练在数据集Da上,评估在未见数据集Db上。
- 结果:模型在所有数据集上均表现优越,MSE减少13.1%,MAE减少5.9%与iTransformer相比。
-
分类与异常检测
- 实验设置:使用10个多变量数据集进行分类评估,异常检测则在SMD、SWaT、PSM、MSL和SMAP数据集上进行。
- 结果:分类任务中,模型准确率达到75.9%,超越TimesNet。异常检测任务中,F1-score达到87.47%,超过其他模型。
-
模型分析
- 消融研究:通过去除各个组件进行消融实验,结果显示所有组件的组合表现最佳,尤其是通道混合和时间图像分解对性能提升贡献显著。
-
效率分析
- 性能比较:在天气缺失值填补和ETTm1长期预测任务中,模型在内存占用和训练速度上表现出色,内存占用最低且训练时间竞争力强。
通过上述实验,模型在多种时间序列分析任务中展现了强大的性能和适应性,证明了其作为通用时间序列模式机器的潜力。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献4条内容

所有评论(0)