一文看懂lstm&bilstm
作为一个初学者,我认为模型的输入输出是我们最开始关心的问题。
原文链接:https://blog.csdn.net/jokerxsy/article/details/106673603
1、输入输出
(1)Lstm
模型的描述
self.lstm = nn.LSTM(input_size=self.input_size,
                    hidden_size=self.hidden_size,
                    num_layers = self.num_layers,
                    )
- input_size:词向量的维度
- hidden_size:输出层(隐藏层)的维度
- num_layers:网络层的层数
输入:
input_embeded:
(batch_size * len_sen(句子长度,也就是句子有多少个单词) * input_size(单词的向量维度)
- batch_size:批次,假设数据集有1000个句子,batch_size=10,则每个batch里有100个句子
输出:
output, (h_n, c_n) = self.lstm(input_embeded)
- output:batch_size * len_sen * hidden_size
- h_n: (1*self.num_layers(lstm的层数)) * batch_size * hidden_size
- c_n: (1*self.num_layers) * batch_size * hidden_size
output容易理解,就是所有的输出。假设就一层lstm,那么h_n其实等于output[-1],也就是说h_n保留的是最后一个时间步的输出,c_n保留的是最后一个时间步的记忆细胞。其中,h_n 是 c_n 经过一个tanh激活函数,在经过一个输出门,得到的。
上面这句话可能有些难以理解,需要补充一些基础知识,看下图的原理图,图中标明了什么是c(n)(就是c(t)),什么是h(n)(就是h(t))
下图为LSTM的原理图:
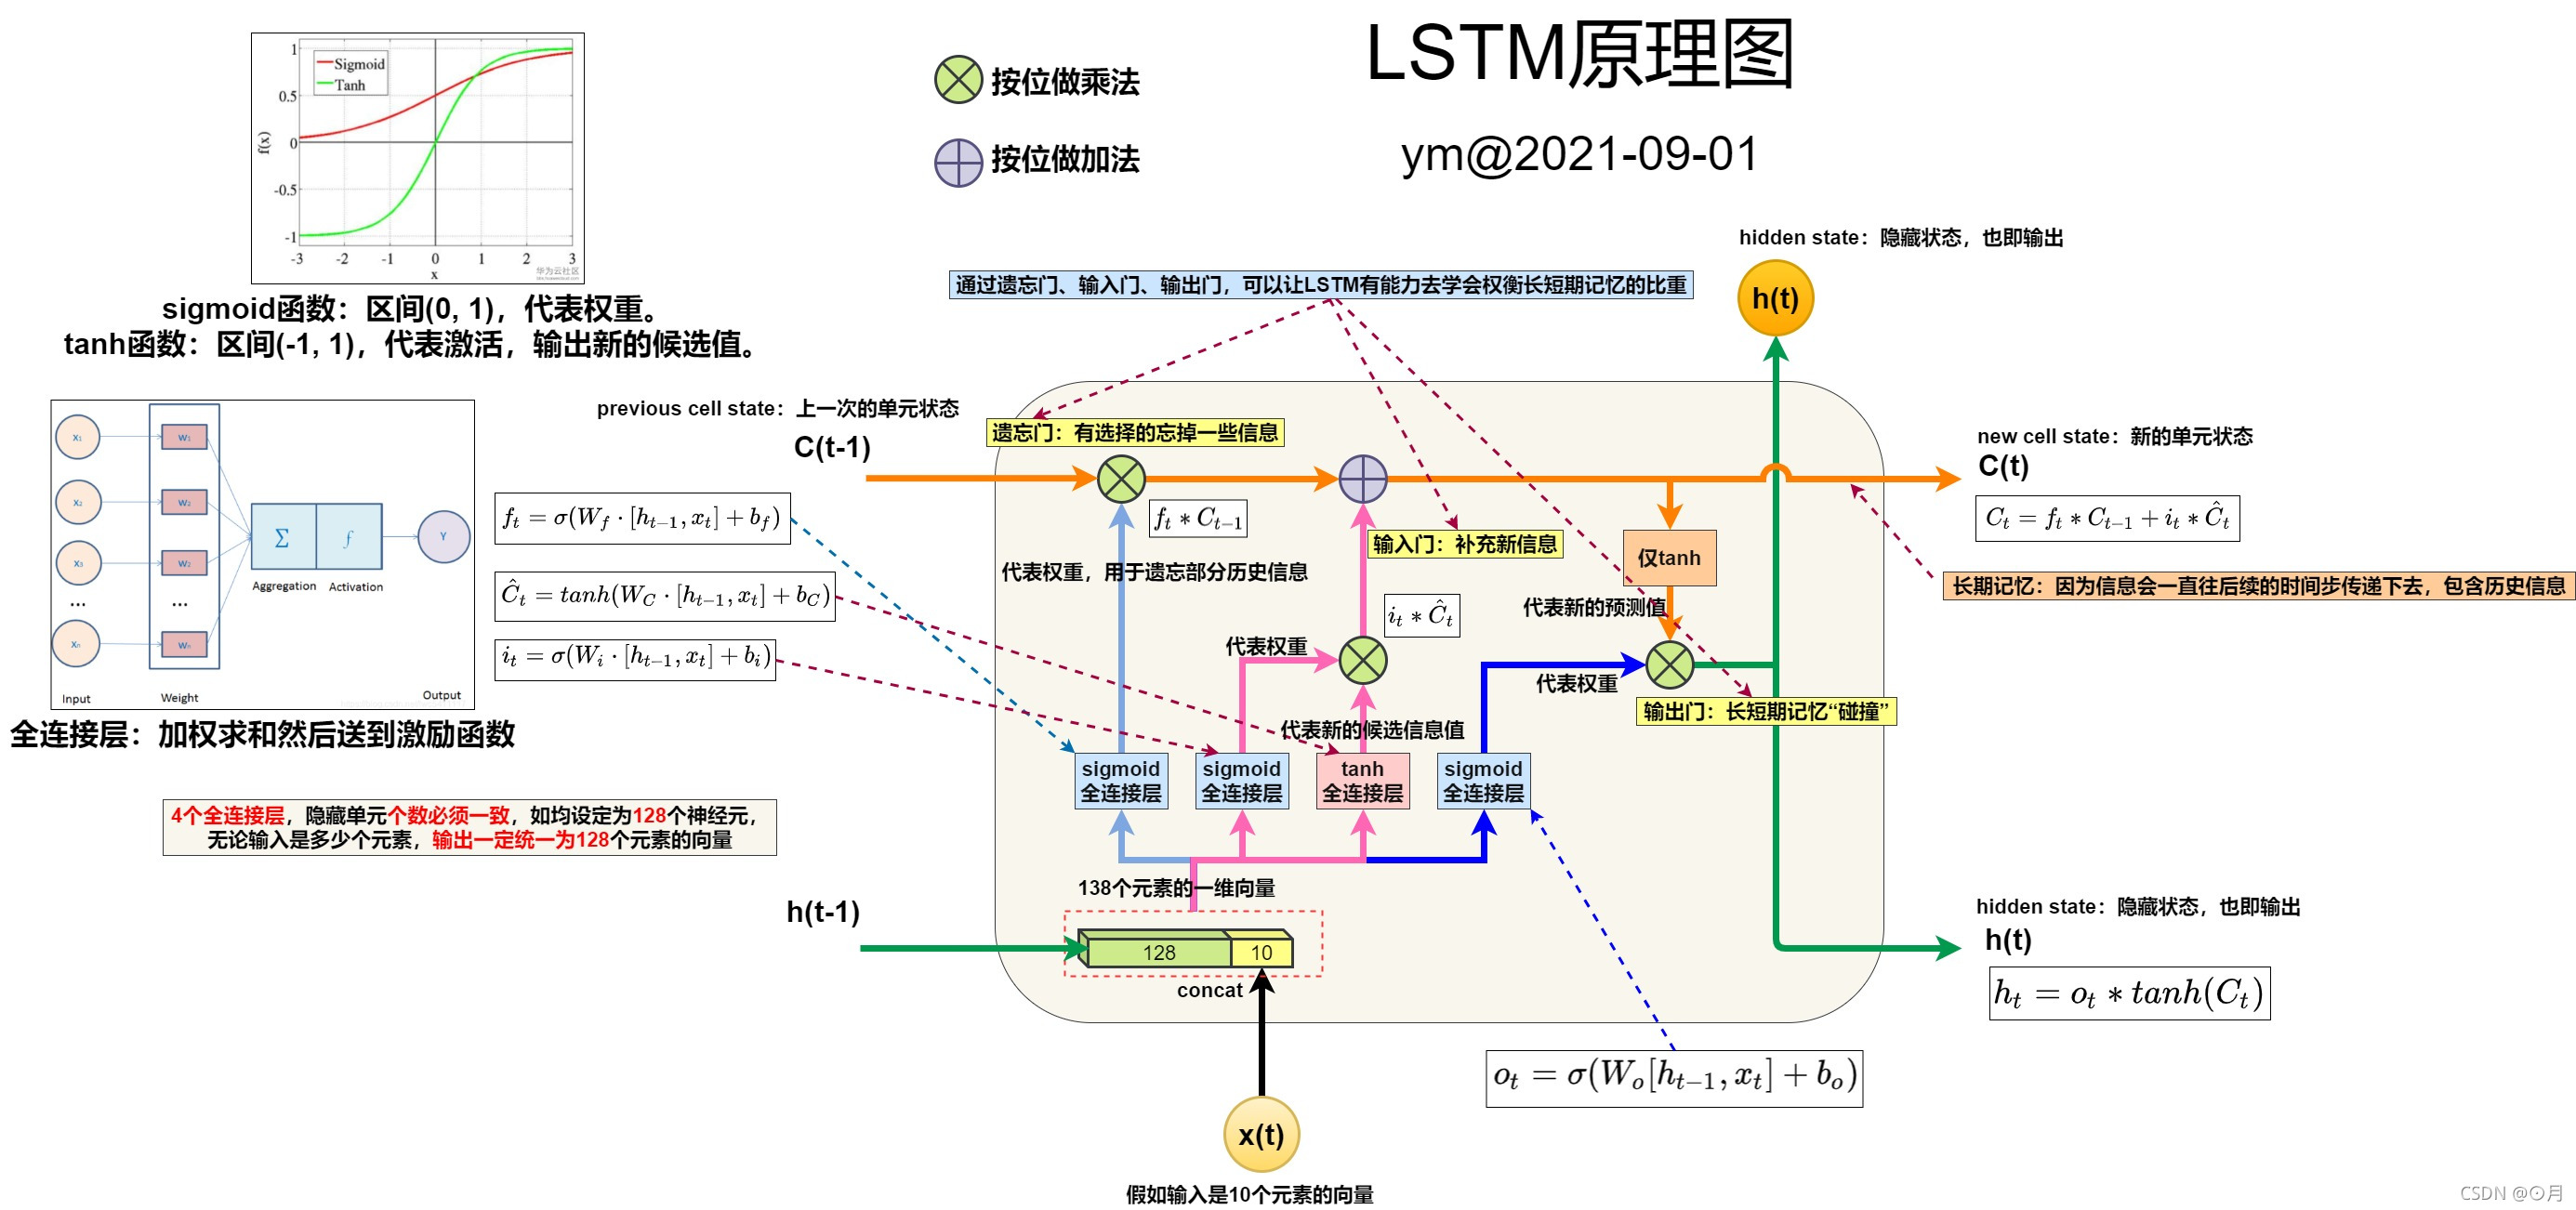
上图描述的是LSTM中隐藏层的某个时间步长t内发生的事,LSTM的整体框架如下图所示,上图的原理图就是下图中的红框里的点:
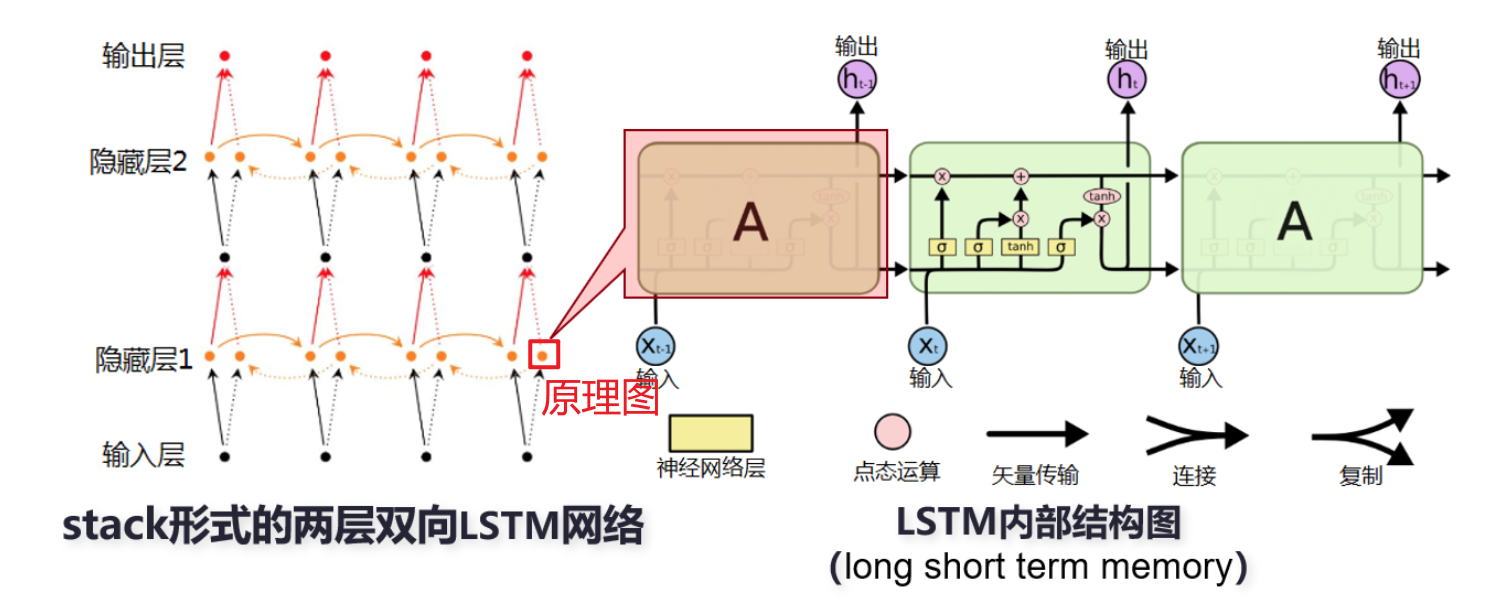
如果上图依然有些复杂,我们还可以进一步抽象,省略一些信息得到下图:
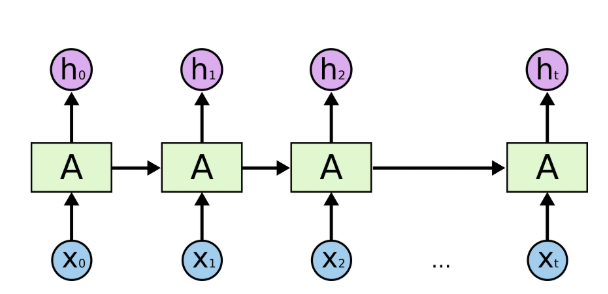
假设我们的输入信息是:我 爱 中国,我们将这个句子分成3个单词,我,爱,中国,那么x0=“我”,x1=“爱”,x2=“中国”,A就是我们原理图中所描述的处理单元,h是经过处理单元输出的权重,h0这个权重不仅会输出,还是传入下一个时刻,也就是x1对应的A中。
(2)Bilstm
原理图
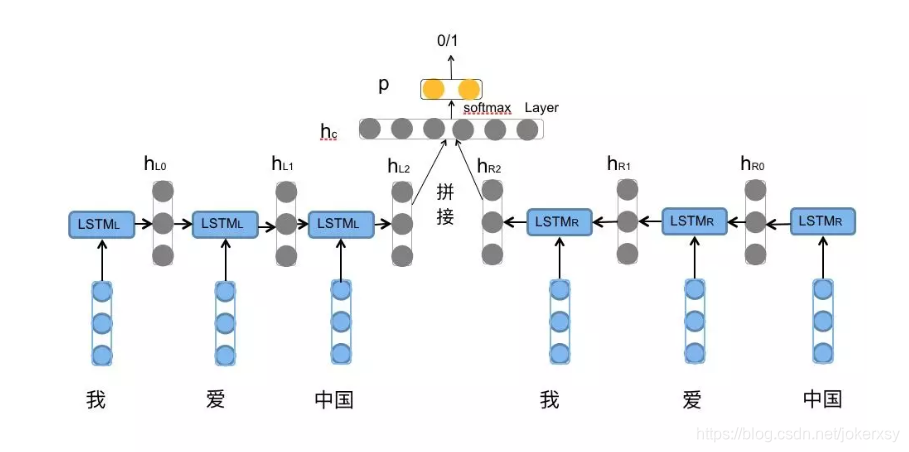
从上面的图可以看出,bilstm与lstm的不同在于,bilstm通过前向、后向,最终得到两个输出,也就是h_n,然后把他们进行拼接,接下去的步骤一样。
self.lstm = nn.LSTM(input_size=self.input_size,
                    hidden_size=self.hidden_size,
                    num_layers = self.num_layers,
                    )
Bilstm的输入和Lstm一样,但是输出会不一样,下方是经过一层lstm的输出:
output, (h_n, c_n) = self.lstm(input_embeded)
这里的h_n:(2×self.num_layers(lstm的层数)) × batch_size × hidden_size
由于bilstm是双层的,所以我们需要拼接
out = torch.cat([h_n[-1, :, :], h_n[-2, :, :]], dim=-1)
于是bilstm最终的输出为:
(2×self.num_layers(lstm的层数)) ×batch_size ×(2× hidden_size)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)