数据库隔离性的实现——mvcc(快照读,当前读、隐性与自动加锁、read view、undo log)等——mysql为例
在开始正文之前,请先看另一篇博客【数据库通用知识原理(范式、ER图、事务、隔离级别】
MVCC解决的是读写并发问题,而更新丢失是写写并发问题
https://zhuanlan.zhihu.com/p/672599351
还有小林coding
快照读和当前读&自动与隐式加锁
快照读 (一般而言都是这个),普通的select语句 不加类似for update等后缀。读取的是数据的某个历史版本,而不是最新的数据。在可重复读(Repeatable Read)和读已提交(Read Committed)隔离级别下存在,因为实现原理是mvcc+undolog
当前读是指直接读取数据库中的已提交的(未提交的不算)最新数据,并且读取时会考虑其他并发事务的影响。需要加锁实现,可能阻塞其他事务。例如:UPDATE、DELETE、INSERT(隐式加锁)以及显性加锁的SELECT … FOR UPDATE或SELECT … LOCK IN SHARE MODE
比如你select for update吧 因为你要加锁 那肯定是要给对应的行都加啊 不然里面的行被修改(行锁)或者行之间的被修改了(幻读 间隙锁)怎么办
注意 当前读不光是select update 和delete 甚至insert都算
视图 Read View
视图 是事务隔离实现的根本,数据库里面会创建一个视图,访问的时候以视图的逻辑结果为准。
在MySQL里,有两个“视图”的概念:
- 一个是view,它是一个用查询语句定义的虚拟表,在调用的时候执行查询语句并生成结果。创建视图的语法是create view … ,而它的查询方法与表一样。
- 另一个是InnoDB在实现MVCC时用到的一致性读视图,即consistent read view,用于支持RC(Read Committed,读提交)和RR(Repeatable Read,可重复读)隔离级别的实现。
在可重复读隔离级别下,这个视图是在事务启动时创建的,整个事务存在期间都用这个视图。
我们需要知道
- 聚簇索引记录中两个跟事务有关的隐藏列
- Read View 中四个字段作用;
隐藏列、版本链与undo log
在可重复读隔离级别下,事务在启动的时候就“拍了个快照”,注意,这个快照是基于整库的。
你肯定会说,这怎么可能?如果一个库有100G,那么我启动一个事务,MySQL就要拷贝100G的数据出来,这个过程得多慢啊,这谁顶得住啊?可是你回头一想,平时的事务执行起来不是很快么?
实际上,数据库并不需要拷贝出这100G的数据,那快照怎么实现的?
InnoDB里面每个事务有一个唯一的事务ID,叫作transaction id,它是在事务开始的时候向InnoDB的事务系统申请的,是按申请顺序严格递增的。
- 系统版本号:是一个递增的数字,每开始一个新的事务,系统版本号就会自动递增。
- 事务版本号:事务开始时的系统版本号。
每行数据也都是有多个版本的,每次事务更新数据的时候,都会生成一个新的数据版本,并且把transaction id赋值给这个数据版本的事务ID,记为row trx_id。同时,旧的数据版本要保留,并且在新的数据版本中,能够有信息可以直接拿到它。
也就是说,数据表中的一行记录,其实可能有多个版本(row),每个版本有自己的row trx_id。
这是一个隐藏列,还有另外一个roll_pointer:每次对某条聚簇索引记录进行改动时,都会把旧的版本写入到undo日志中,然后这个隐藏列就相当于一个指针,可以通过它来找到该记录修改前的信息
两者都在InnoDB的聚簇索引中,大概就长这样:
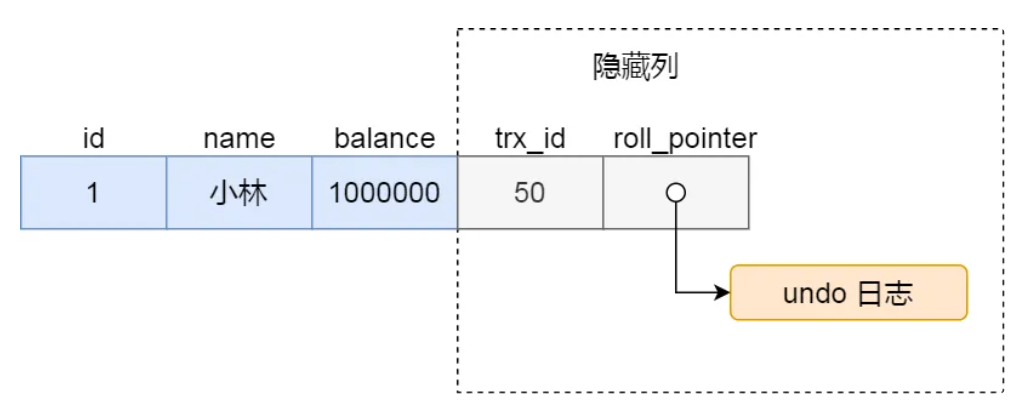
对于使用 InnoDB 存储引擎的数据库表,它的聚簇索引记录中都包含下面两个隐藏列:
- trx_id,当一个事务对某条聚簇索引记录进行改动时,就会把该事务的事务 id 记录在 trx_id 隐藏列里;也叫 创建版本号 指示创建一个数据行的快照时的系统版本号
- roll_pointer,每次对某条聚簇索引记录进行改动时,都会把旧版本的记录写入到 undo 日志中,然后这个隐藏列是个指针,指向每一个旧版本记录,于是就可以通过它找到修改前的记录。也叫删除版本号
其实除了这两个 还有两个隐藏字段
- DB_ROW_ID : 6 byte,隐含的自增ID(隐藏主键),如果数据表没有主键, InnoDB 会自动以 DB_ROW_ID 产生一个聚簇索引
- 补充:实际还有一个删除flag隐藏字段, 既记录被更新或删除并不代表真的删除,而是删除flag变了。
Undo 日志
我们之前所讲的所有机制:索引,事务,隔离性,日志等,都是在内存中完成的,即在 MySQL 内部的相关缓冲区中,保存相关数据,完成各种判断操作。然后在合适的时候,将相关数据刷新到磁盘当中的。
我们这里理解undo log,简单理解成,就是 MySQL 中的一段内存缓冲区,用来保存日志数据的就行。
MVCC 使用到的快照存储在 Undo 日志中,该日志通过回滚指针把一个数据行(Record)的所有快照连接起来。
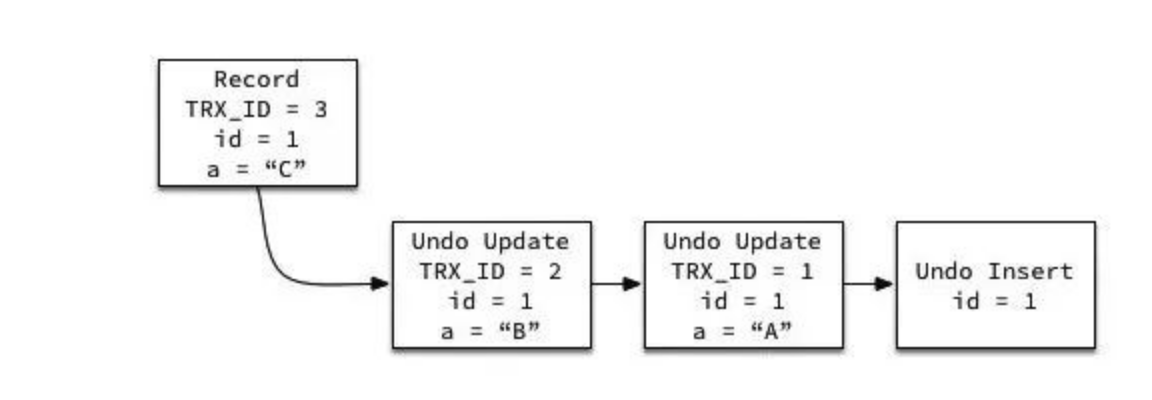
当事务对数据行进行一次更新操作时,会把旧数据行记录在一个叫做undo log的记录中,在undo log中除了记录数据行,还会记录下该行数据的对应的创建版本号,也就是生成这行数据的事务id嘛~
然后将原来数据行中的回滚指针指向undo log记录的这行数据(这就和上面版本号的内容联系起来了)。然后再在原来数据表中进行一次更新操作,如果这次更新操作回滚了,那么就可以根据回滚指针去undo log中查找之前的数据进行复原。如果后续还有更新操作的话,就会在undo log中和之前的数据行形成一条链表,链表头就是最新的数据,这条链表就叫做版本链
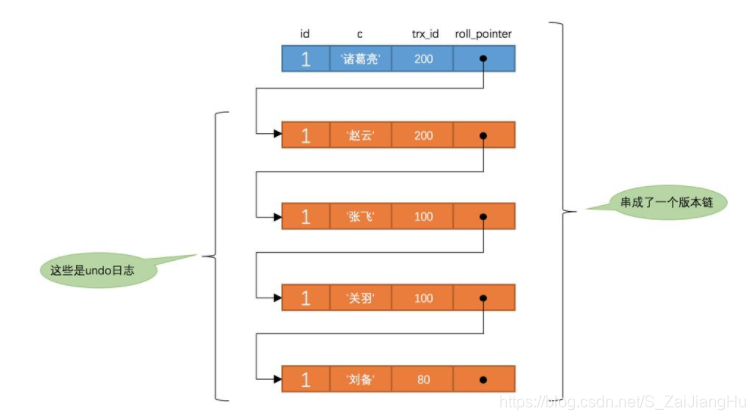
(ps:数据本来是刘备,然后事务id为100的事务先修改成了关羽,再修改成了张飞,后面事务id为200的事务先修改成了赵云,再修改成了诸葛亮)
简单来说 undo log 存的就是“还没有提交的undo的”修改
事务的可见性都是基于这个undo log来实现的
以下实现过程针对可重复读隔离级别。
实现过程
当开始一个事务时,该事务的版本号肯定大于当前所有数据行快照的创建版本号,理解这一点很关键。数据行快照的创建版本号是创建数据行快照时的系统版本号,系统版本号随着创建事务而递增,因此新创建一个事务时,这个事务的系统版本号比之前的系统版本号都大,也就是比所有数据行快照的创建版本号都大。
-
INSERT
会将当前系统版本号作为数据行快照的创建版本号(在哪个事务最新被创建的) -
DELETE
将当前系统版本号作为数据行快照的删除版本号。(在哪个事务最新被删除的) -
UPDATE
将当前系统版本号作为更新前的数据行快照的删除版本号,并将当前系统版本号作为更新后的数据行快照的创建版本号。可以理解为先执行 DELETE 后执行 INSERT。 -
SELECT
多个事务必须读取到同一个数据行的快照,并且这个快照是距离现在最近的一个有效快照。(但是也有例外,如果有一个事务正在修改该数据行,那么它可以读取事务本身所做的修改,而不用和其它事务的读取结果一致。)
update
(1)现在有一个事务 1 ,对 student 表中记录进行修改 (update) :将 name( 张三 ) 改成 name( 李四 ) 。
- 事务1,因为要修改,所以要先给该记录加行锁。
- 修改前,现将该行记录拷贝到undo log中,所以,undo log中就有了一行副本数据。(原理就是写时拷贝),现在 MySQL 中有两行同样的记录。
- 修改原始记录中的name,改成 ‘李四’。
修改原始记录的隐藏字段 :DB_TRX_ID 为当前 事务1 的ID, 我们默认从 1 开始,之后递增。
原始记录的回滚指针 DB_ROLL_PTR 列,里面写入undo log中副本数据的地址,从而指向副本记录,既表示我的上一个版本就是它。 - 事务1提交,释放锁。
最新的记录是 ’李四‘ 那条记录
之后,又有一个事务2,进行同样的操作,修改年龄
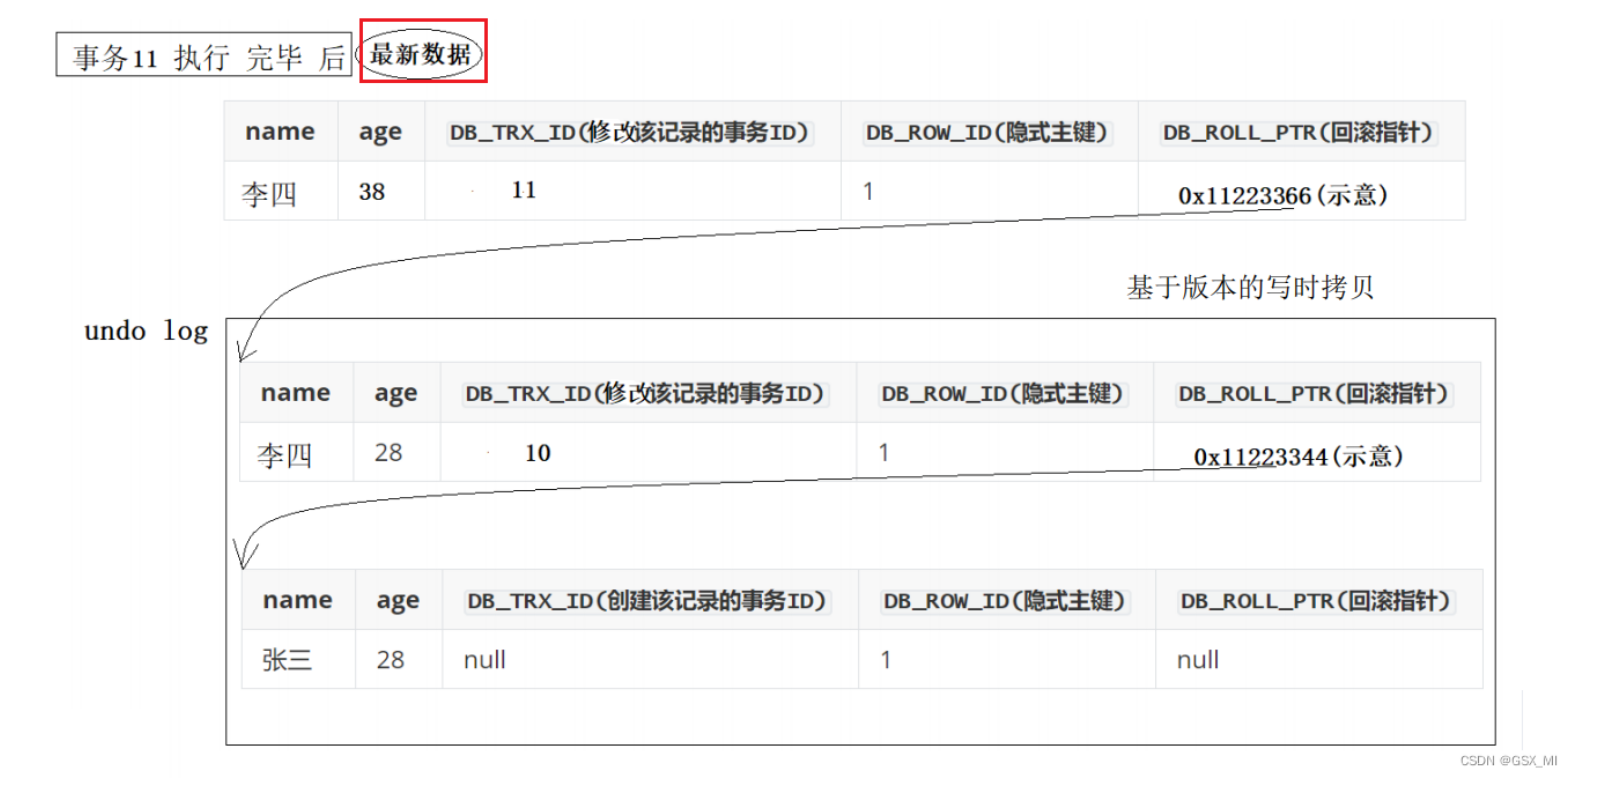
我们就有了一个基于链表记录的历史版本链。
所谓的回滚,无非就是用历史数据,覆盖当前数据上面的一个一个版本,我们可以称之为一个一个的快照。
历史版本数据不光是要形成版本,将来可能增删改访问原始数据,查的时候可能访问历史版本
delete
上面是以更新( upadte )主讲的 , 如果是 delete 呢?
一样的,删数据不是清空,而是设置flag为删除即可。也可以形成版本。
insert
因为insert是插入,也就是之前没有数据,那么insert也就没有历史版本。但是一般为了回滚操作,insert的数据也是要被放入undo log中,如果当前事务commit了,那么这个undo log 的历史insert记录就可以被清空了。
也就是我们可以理解成, update 和 delete 可以形成版本链, insert 暂时不考虑
select :当前读与快照读
刚才undolog说了更新操作,那查询操作呢?这才是实现不同隔离级别的关键地方
但如果是快照读,读取历史版本的话,是不受加锁限制的。也就是可以并行执行!换言之,提高了效率,即MVCC的意义所在。快照读就不受加锁的限制,因为是历史数据,历史版本不会被修改,被修改的永远是最新版本,只要读取历史版本就不需要加锁!
把没有对一个数据行做修改的事务称为 T
- T 所要读取的数据行快照的创建版本号必须小于等于 T 的版本号,因为如果大于 T 的版本号,那么表示该数据行快照是其它事务的最新修改,因此不能去读取它。
- 除此之外,T 所要读取的数据行快照的删除版本号必须是未定义或者大于 T 的版本号,因为如果小于等于 T 的版本号,那么表示该数据行快照是已经被删除的,不应该去读取它。
undo log 里面的内容什么时候会被清除?
当前最新的记录没有人修改,而且被提交了 且 mysql所有事物当前没有人再和undo log里面的数据有关了
Read View四字段
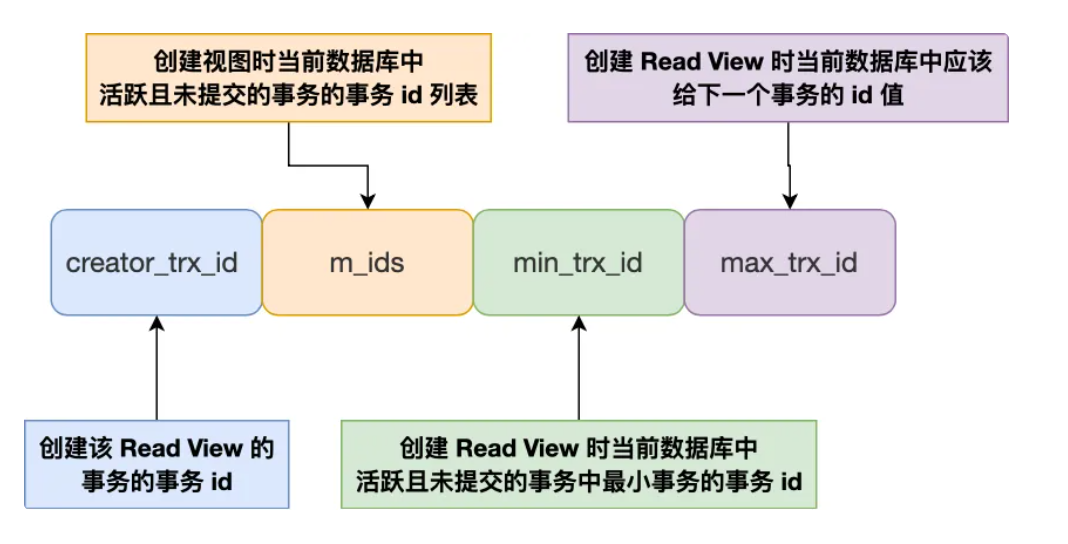
Read View 有四个重要的字段:
- m_ids :指的是在创建 Read View 时,当前数据库中「活跃事务」的事务 id 列表,注意是一个列表,“活跃事务”指的就是,启动了但还没提交的事务。
- min_trx_id :指的是在创建 Read View 时,当前数据库中「活跃事务」中事务 id 最小的事务,也就是 m_ids 的最小值。
- max_trx_id :这个并不是 m_ids 的最大值,而是创建 Read View 时当前数据库中应该给下一个事务的 id 值,也就是全局最大事务 id + 1;
- creator_trx_id :指的是创建该 Read View 的事务的事务 id。
在某事务创建 Read View 后,我们可以将记录中的 trx_id 划分这三种情况:
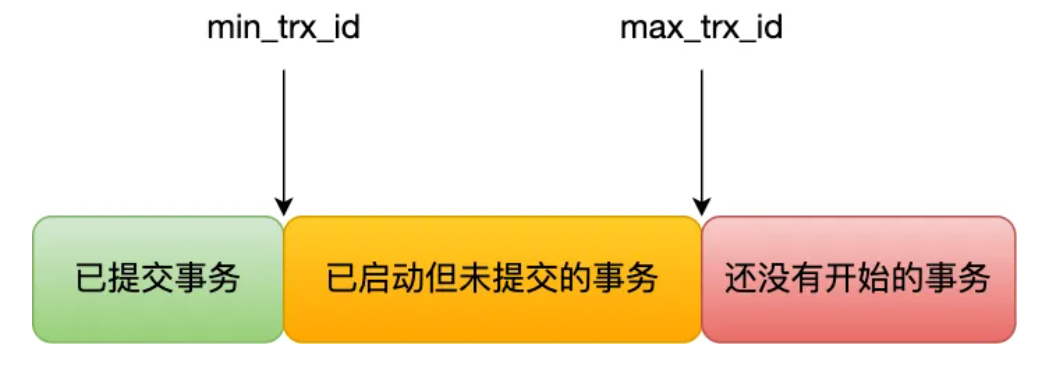
一个事务去访问记录的时候,除了自己的更新记录总是可见之外,还有这几种情况:
- 如果记录的 trx_id 值小于 Read View 中的 min_trx_id 值,表示这个版本的记录是在创建 Read View 之前已经提交的事务生成的,所以该版本的记录对当前事务可见。
- 如果记录的 trx_id 值大于等于 Read View 中的 max_trx_id 值,表示这个版本的记录是在创建 Read View 之后才启动的事务生成的,所以该版本的记录对当前事务不可见。
- 如果记录的 trx_id 值在 Read View 的 min_trx_id 和 max_trx_id 之间,需要判断 trx_id 是否在 m_ids 列表中:
- 如果记录的 trx_id 在 m_ids 列表之中,表示生成该版本记录的活跃事务依然活跃着(还没提交事务),所以该版本的记录对当前事务不可见。
- 如果记录的 trx_id 不在 m_ids 列表之中,表示生成该版本记录的活跃事务已经被提交,所以该版本的记录对当前事务可见。
这种通过「版本链」来控制并发事务访问同一个记录时的行为就叫 MVCC(多版本并发控制)。
MVCC是如何工作的
第一种,我既然要保证前后两次读取数据一致,那么我读取数据的时候,锁定我要操作的数据,不允许其他的事务修改就行了。这种方案我们叫做基于锁的并发控制 Lock Based Concurrency Control(LBCC)。
如果仅仅是基于锁来实现事务隔离,一个事务读取的时候不允许其他时候修改,那就意味着不支持并发的读写操作,而我们的大多数应用都是读多写少的,这样会极大地 影响操作数据的效率。
多版本并发控制(Multi-Version Concurrency Control, MVCC)是 MySQL 的 InnoDB 存储引擎实现隔离级别的一种具体方式,用于实现提交读和可重复读这两种隔离级别。
数据库并发场景有三种,分别为:
1、读读:不存在任何问题,也不需要并发控制
2、读写:有线程安全问题,可能会造成事务隔离性问题,可能遇到脏读、幻读、不可重复读
3、写写:有线程安全问题,可能存在更新丢失问题
MVCC是一种用来解决读写冲突的无锁并发控制,也就是为事务分配单项增长的时间戳,为每个修改保存一个版本,版本与事务时间戳关联,读操作只读该事务开始前的数据库的快照,所以MVCC可以为数据库解决以下问题:
1、在并发读写数据库时,可以做到在读操作时不用阻塞写操作,写操作也不用阻塞读操作,提高了数据库并发读写的性能
2、解决脏读、幻读、不可重复读等事务隔离问题,但是不能解决更新丢失问题
MVCC 的核心思想是: 我可以查到在我这个事务开始之前已经存在的数据,即使它在后面被修改或者删除了。在我这个事务之后新增的数据,我是查不到的。
MVCC模块在MySQL中的具体实现是由三个隐式字段,undo日志、read view三个组件来实现的。
MVCC 的查找规则:只能查找创建时间小于等于当前事务 ID 和删除时间大于当前事务 ID(或未删除undefined) 的行。
可重复读是如何工作的
可重复读隔离级别是启动事务时生成一个 Read View,然后整个事务期间都在用这个 Read View。
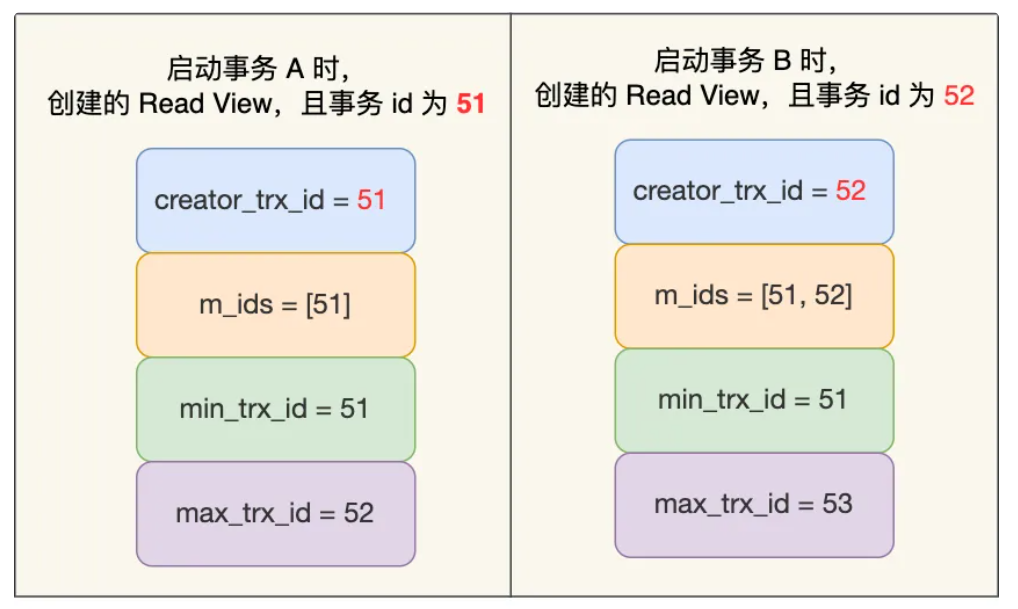
假设事务 A (事务 id 为51)启动后,紧接着事务 B (事务 id 为52)也启动了,那这两个事务创建的 Read View 如下:
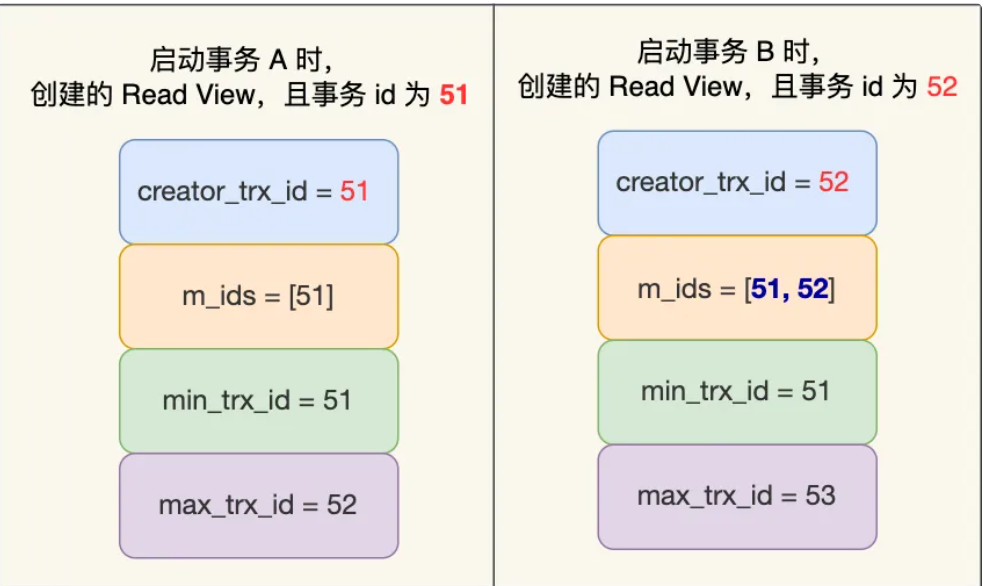
事务 A 和 事务 B 的 Read View 具体内容如下:
- 在事务 A 的 Read View 中,它的事务 id 是 51,由于它是第一个启动的事务,所以此时活跃事务的事务 id 列表就只有 51,活跃事务的事务 id 列表中最小的事务 id 是事务 A 本身,下一个事务 id 则是 52。
- 在事务 B 的 Read View 中,它的事务 id 是 52,由于事务 A 是活跃的,所以此时活跃事务的事务 i- d 列表是 51 和 52,活跃的事务 id 中最小的事务 id 是事务 A,下一个事务 id 应该是 53。
接着,在可重复读隔离级别下,事务 A 和事务 B 按顺序执行了以下操作:
- 事务 B 读取小林的账户余额记录,读到余额是 100 万;
- 事务 A 将小林的账户余额记录修改成 200 万,并没有提交事务;
- 事务 B 读取小林的账户余额记录,读到余额还是 100 万;
- 事务 A 提交事务;
- 事务 B 读取小林的账户余额记录,读到余额依然还是 100 万;
但是 B读取还是100万 好像不符合 可重复读 避免丢失更新的啊 ? 可能默认加了锁 但是因为这里事务B没改小林余额?后面思考下
接下来,跟大家具体分析下。
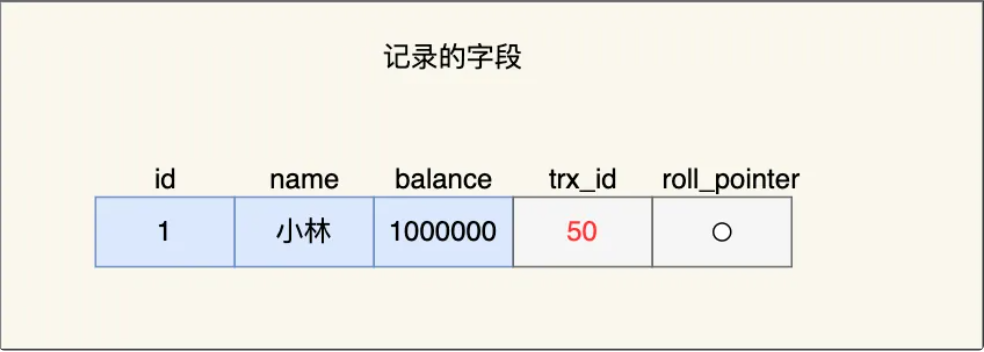
事务 B 第一次读小林的账户余额记录,在找到记录后,它会先看这条记录的 trx_id,此时发现 trx_id 为 50,比事务 B 的 Read View 中的 min_trx_id 值(51)还小,这意味着修改这条记录的事务早就在事务 B 启动前提交过了,所以该版本的记录对事务 B 可见的,也就是事务 B 可以获取到这条记录。
接着,事务 A 通过 update 语句将这条记录修改了(还未提交事务),将小林的余额改成 200 万,这时 MySQL 会记录相应的 undo log,并以链表的方式串联起来,形成版本链,如下图:
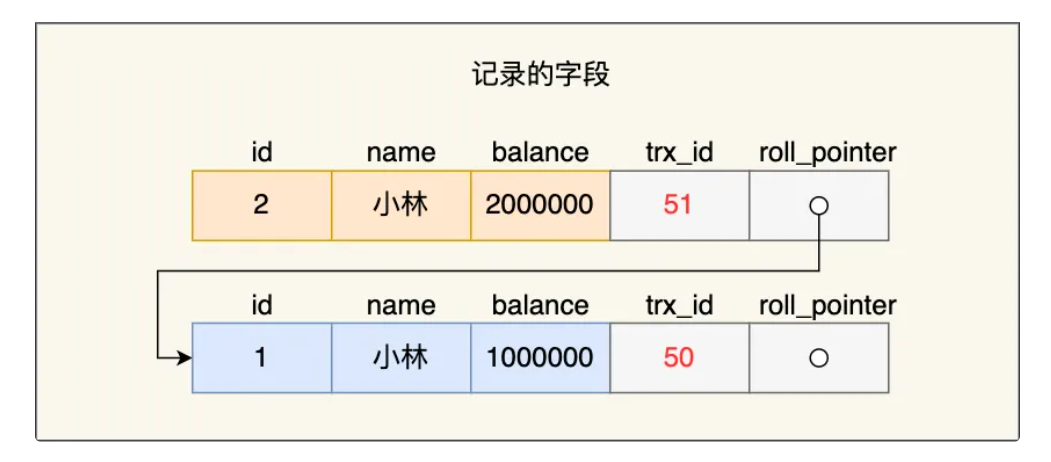
这里的id有点问题,上面黄色的是余额数据表中现在存的记录,id应该还是1. 然后下面蓝色的应该是undo log 表中的数据。 这里id应该区分下 一个是正常表中的id 一个是undo中的id 不过不算很影响理解 下面这个图更合适
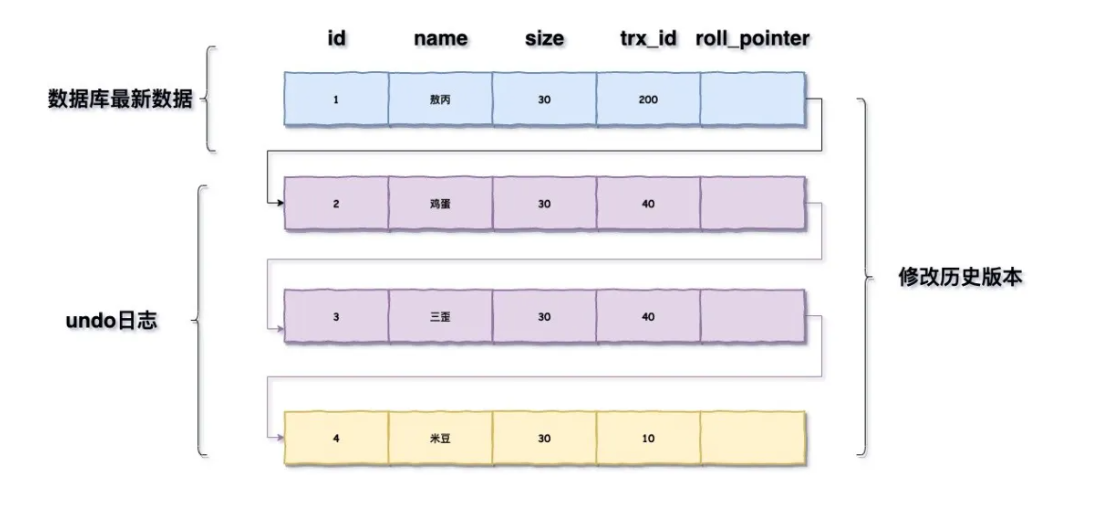
你可以在上图的「记录的字段」看到,由于事务 A 修改了该记录,以前的记录就变成旧版本记录了,于是最新记录和旧版本记录通过链表的方式串起来,而且最新记录的 trx_id 是事务 A 的事务 id(trx_id = 51)。
然后事务 B 第二次去读取该记录,发现这条记录的 trx_id 值为 51,在事务 B 的 Read View 的 min_trx_id 和 max_trx_id 之间,则需要判断 trx_id 值是否在 m_ids 范围内,判断的结果是在的,那么说明这条记录是被还未提交的事务修改的,这时事务 B 并不会读取这个版本的记录。而是沿着 undo log 链条往下找旧版本的记录,直到找到 trx_id 「小于」事务 B 的 Read View 中的 min_trx_id 值的第一条记录,所以事务 B 能读取到的是 trx_id 为 50 的记录,也就是小林余额是 100 万的这条记录。
最后,当事物 A 提交事务后,由于隔离级别时「可重复读」,所以事务 B 再次读区记录时,还是基于启动事务时创建的 Read View 来判断当前版本的记录是否可见。所以,即使事物 A 将小林余额修改为 200 万并提交了事务, 事务 B 第三次读取记录时,读到的记录都是小林余额是 100 万的这条记录。
就是通过这样的方式实现了,「可重复读」隔离级别下在事务期间读到的记录都是事务启动前的记录。
读提交是如何工作的?
读提交隔离级别是在每次读取数据时,都会生成一个新的 Read View。
也意味着,事务期间的多次读取同一条数据,前后两次读的数据可能会出现不一致,因为可能这期间另外一个事务修改了该记录,并提交了事务。
那读提交隔离级别是怎么工作呢?我们还是以前面的例子来聊聊。
假设事务 A (事务 id 为51)启动后,紧接着事务 B (事务 id 为52)也启动了,接着按顺序执行了以下操作:
- 事务 B 读取数据(创建 Read View),小林的账户余额为 100 万;
- 事务 A 修改数据(还没提交事务),将小林的账户余额从 100 万修改成了 200 万;
- 事务 B 读取数据(创建 Read View),小林的账户余额为 100 万;
- 事务 A 提交事务;
- 事务 B 读取数据(创建 Read View),小林的账户余额为 200 万;
那具体怎么做到的呢?我们重点看事务 B 每次读取数据时创建的 Read View。前两次 事务 B 读取数据时创建的 Read View 如下图:
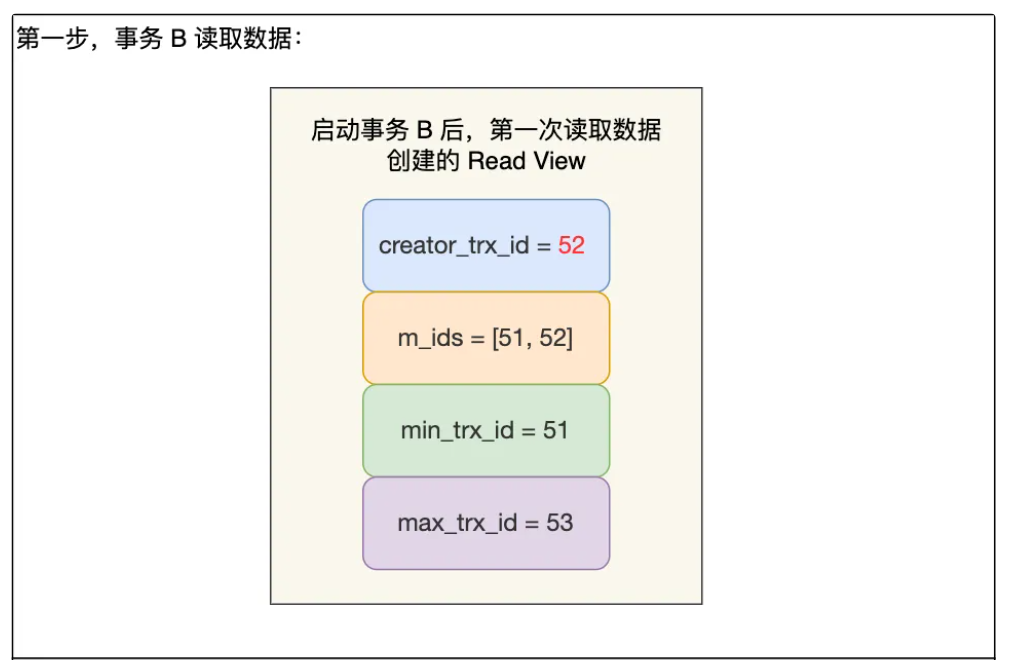
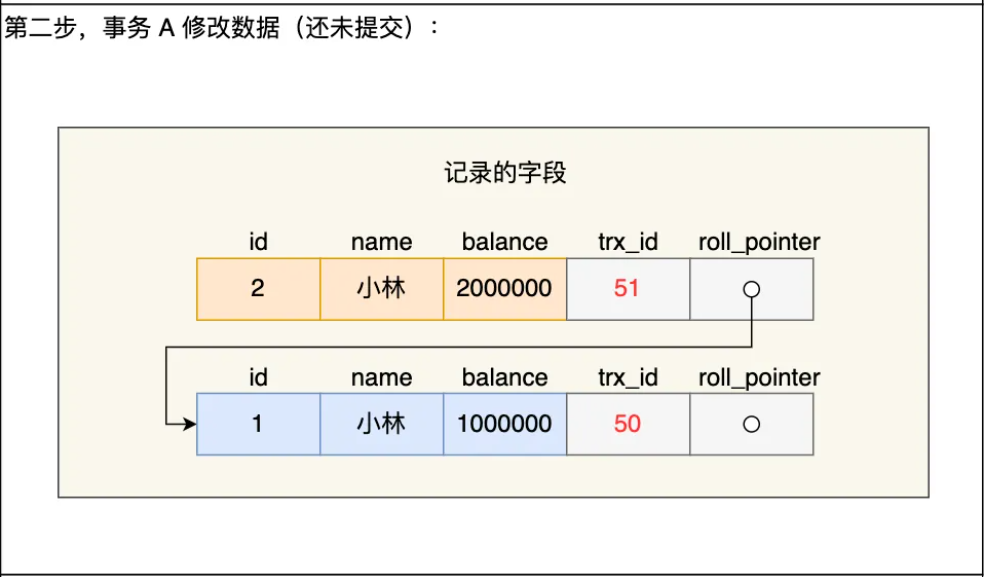
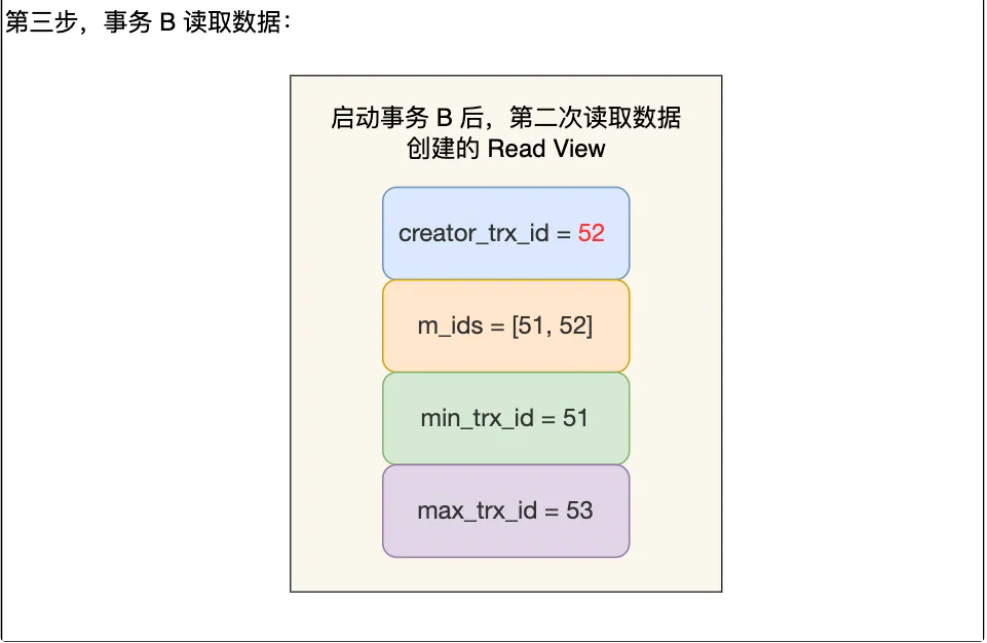
我们来分析下为什么事务 B 第二次读数据时,读不到事务 A (还未提交事务)修改的数据?
事务 B 在找到小林这条记录时,会看这条记录的 trx_id 是 51,在事务 B 的 Read View 的 min_trx_id 和 max_trx_id 之间,接下来需要判断 trx_id 值是否在 m_ids 范围内,判断的结果是在的,那么说明这条记录是被还未提交的事务修改的,这时事务 B 并不会读取这个版本的记录。而是,沿着 undo log 链条往下找旧版本的记录,直到找到 trx_id 「小于」事务 B 的 Read View 中的 min_trx_id 值的第一条记录,所以事务 B 能读取到的是 trx_id 为 50 的记录,也就是小林余额是 100 万的这条记录。
我们来分析下为什么事务 A 提交后,事务 B 就可以读到事务 A 修改的数据?
在事务 A 提交后,由于隔离级别是「读提交」,所以事务 B 在每次读数据的时候,会重新创建 Read View,此时事务 B 第三次读取数据时创建的 Read View 如下:
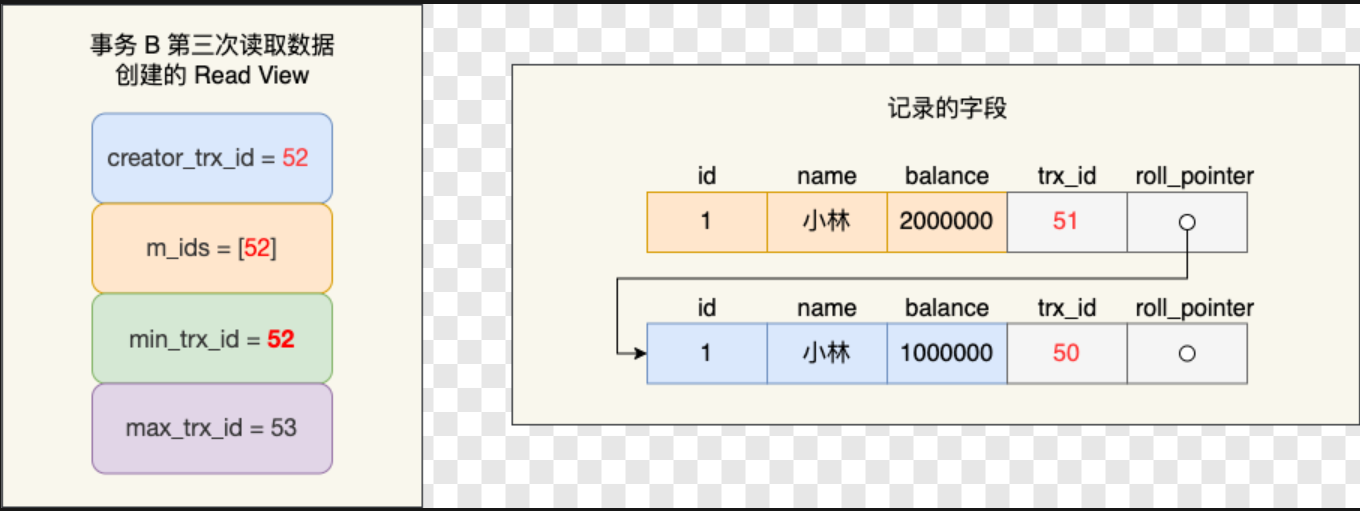
事务 B 在找到小林这条记录时,会发现这条记录的 trx_id 是 51,比事务 B 的 Read View 中的 min_trx_id 值(52)还小,这意味着修改这条记录的事务早就在创建 Read View 前提交过了,所以该版本的记录对事务 B 是可见的。
正是因为在读提交隔离级别下,事务每次读数据时都重新创建 Read View,那么在事务期间的多次读取同一条数据,前后两次读的数据可能会出现不一致,因为可能这期间另外一个事务修改了该记录,并提交了事务。
区别
对于「读提交」和「可重复读」隔离级别的事务来说,它们是通过 **Read View **来实现的,它们的区别在于创建 Read View 的时机不同:
- 「读提交」隔离级别是在每个 select 都会生成一个新的 Read View,也意味着,事务期间的多次读取同一条数据,前后两次读的数据可能会出现不一致,因为可能这期间另外一个事务修改了该记录,并提交了事务。
- 「可重复读」隔离级别是启动事务时生成一个 Read View,然后整个事务期间都在用这个 Read View,这样就保证了在事务期间读到的数据都是事务启动前的记录。
RR级别下,是如何解决幻读问题的?
首先 我们要区分RC和RR
RC级别下 那肯定是会幻读的
而RR级别要分情况:
1、针对快照读(普通 select 语句),是通过 MVCC 方式解决了幻读,因为可重复读隔离级别下,事务执行过程中看到的数据,一直跟这个事务启动时看到的数据是一致的,即使中途有其他事务插入了一条数据,是查询不出来这条数据的,所以就很好了避免幻读问题。同样 如果有delete的情况 由于有隐藏的是否被删除列 所以也能避免幻读问题。
2、针对当前读(select … for update 等语句),是通过自动加锁,准确的说是加 next-key lock(记录锁+间隙锁)方式解决了幻读,因为当执行 select … for update 语句的时候,会加上 next-key lock,如果有其他事务在 next-key lock 锁范围内插入了一条记录,那么这个插入语句就会被阻塞,无法成功插入,所以就很好了避免幻读问题。
当前读 指 select for update、select … lock in share mode、delete、insert、update
这个自动加锁 是指加的类型
RC级别自动加行锁
RR级别自动加临键锁
这两个解决方案是很大程度上解决了幻读现象,但是还是有个别的情况造成的幻读现象是无法解决的。
至于加锁的详细过程 看另一篇博客
mvcc一定能解决幻读么?
不一定,下面的情况就不行:
当你快照读和当前读混用的时候:
- T1 时刻:事务 A 先执行「快照读语句」:select * from t_test where id > 100 得到了 3 条记录。
- T2 时刻:事务 B 往插入一个 id= 200 的记录并提交;
- T3 时刻:事务 A 再执行「当前读语句」 select * from t_test where id > 100 for update 就会得到 4 条记录,此时也发生了幻读现象。
这里注意! 之前说MYSQL的RR能解决幻读 是在同为快照读或者同为当前读的情况下
ps 更详细的例子
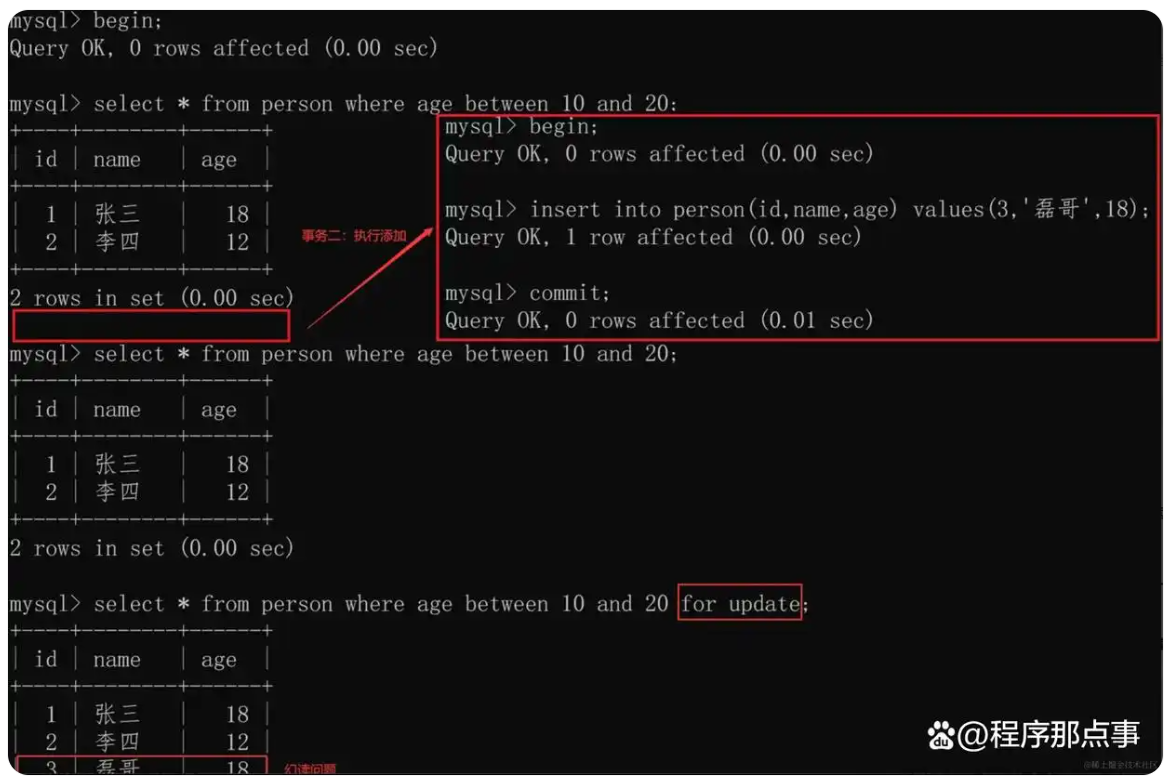
- a事务先select
- b事务insert确实会加一个gap锁(我们先不管锁是什么 而且这里不重要 因为这个锁会释放),但是如果b事务commit,这个gap锁就会释放(释放后a事务可以随意操作)
- a事务再select出来的结果在MVCC下还和第一次select一样
- 接下来
- 如果a:select for update 就会出现新行 因为是当前读
- 如果a事务不加条件地update,这个update会作用在所有行上(包括b事务新加的)。然后再select 则也会出现新行
所以就会导致此时前后读取的数据不一致,出现幻读
两个事务某些情况下的insert和update操作(少见)
因为当事务 A 更新了一条事务 B 插入的记录,那么事务 A 前后两次查询的记录条目就不一样了,所以就发生幻读。
以这张表作为例子: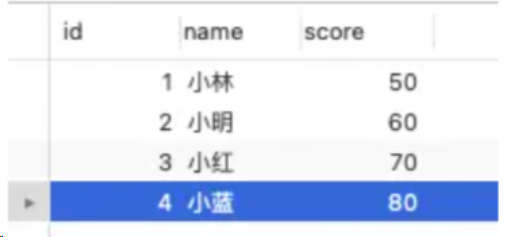
事务 A 执行查询 id = 5 的记录,此时表中是没有该记录的,所以查询不出来。
# 事务 A
mysql> begin;
Query OK, 0 rows affected (0.00 sec)

mysql> select * from t_stu where id = 5;
Empty set (0.01 sec)
然后事务 B 插入一条 id = 5 的记录,并且提交了事务。
# 事务 B
mysql> begin;
Query OK, 0 rows affected (0.00 sec)

mysql> insert into t_stu values(5, '小美', 18);
Query OK, 1 row affected (0.00 sec)

mysql> commit;
Query OK, 0 rows affected (0.00 sec)
此时,事务 A 更新 id = 5 这条记录,对没错,事务 A 看不到 id = 5 这条记录,但是他去更新了这条记录,这场景确实很违和,然后再次查询 id = 5 的记录,事务 A 就能看到事务 B 插入的纪录了,幻读就是发生在这种违和的场景。
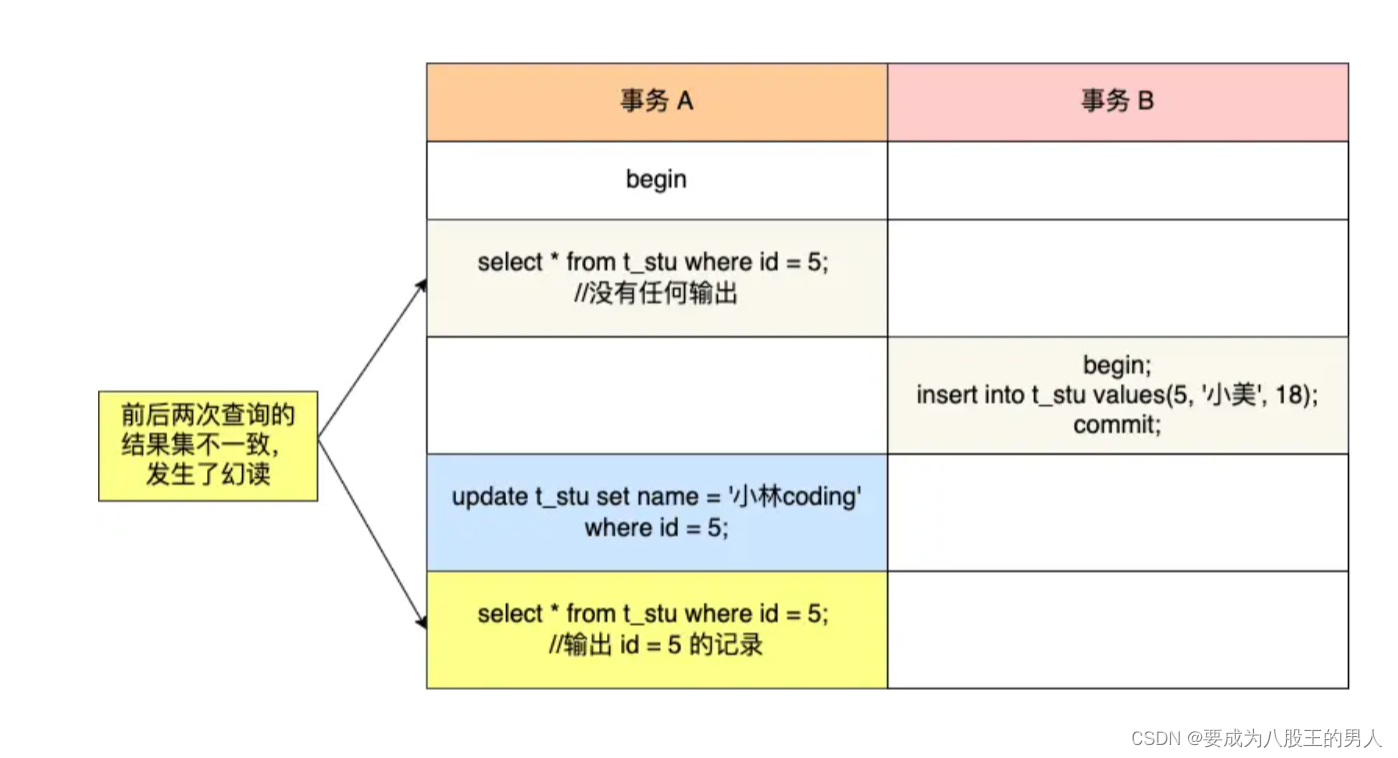
注意 因为这里 update是当前读
在可重复读隔离级别下,事务 A 第一次执行普通的 select 语句时生成了一个 ReadView,之后事务 B 向表中新插入了一条 id = 5 的记录并提交。接着,事务 A 对 id = 5 这条记录进行了更新操作,在这个时刻,这条新记录的 trx_id 隐藏列的值就变成了事务 A 的事务 id,之后事务 A 再使用普通 select 语句去查询这条记录时就可以看到这条记录了,于是就发生了幻读。
因为这种特殊现象的存在,所以MySQL Innodb 中的 MVCC 并不能完全避免幻读现象。
要避免这类特殊场景下发生幻读的现象的话,就是尽量在开启事务之后,马上执行 select … for update 这类当前读的语句,因为它会对记录加 next-key lock,从而避免其他事务插入一条新记录。
如何彻底解决幻读?
想要彻底解决幻读问题,有两个方案:
-
使用串行化(Serializable)隔离级别:官方推荐方案,但这种解决方案,并发性能比较低。
-
RR + 一开始就手动锁,如select … for update 这类当前读的语句:如下图所示:
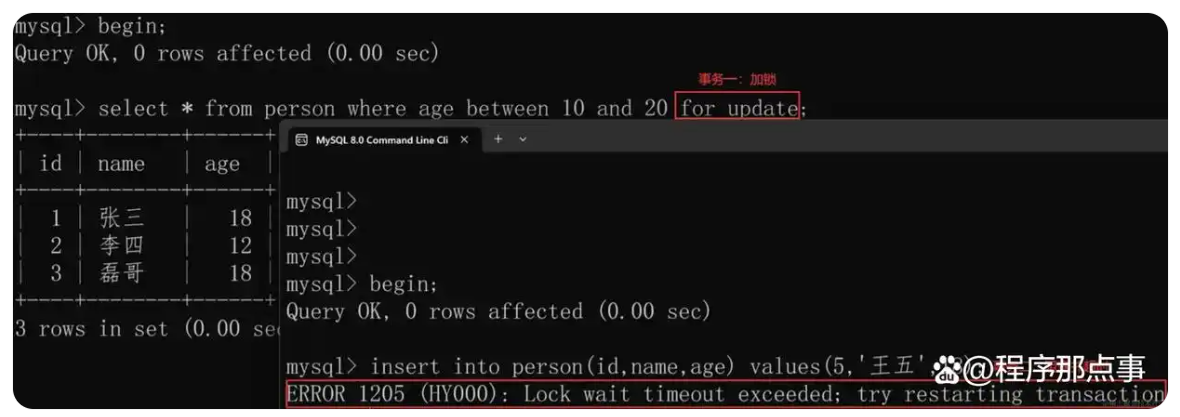
**然而,值得注意的是,间隙锁是引发死锁的重要因素,因此在使用时需要谨慎对待。**而且 在RP级别下,如果没命中索引,可能变成“表锁”
总结
事务是在 MySQL 引擎层实现的,我们常见的 InnoDB 引擎是支持事务的,事务的四大特性是原子性、一致性、隔离性、持久性,我们这次主要讲的是隔离性。
当多个事务并发执行的时候,会引发脏读、不可重复读、幻读这些问题,那为了避免这些问题,SQL 提出了四种隔离级别,分别是读未提交、读已提交、可重复读、串行化,从左往右隔离级别顺序递增,隔离级别越高,意味着性能越差,InnoDB 引擎的默认隔离级别是可重复读。
要解决脏读现象,就要将隔离级别升级到读已提交以上的隔离级别,要解决不可重复读现象,就要将隔离级别升级到可重复读以上的隔离级别。
而对于幻读现象,不建议将隔离级别升级为串行化,因为这会导致数据库并发时性能很差。InnoDB 引擎的默认隔离级别虽然是「可重复读」,但是它通过 next-key lock 锁(行锁+间隙锁的组合)来锁住记录之间的“间隙”和记录本身,防止其他事务在这个记录之间插入新的记录,这样就避免了幻读现象。
对于「读提交」和「可重复读」隔离级别的事务来说,它们是通过 **Read View **来实现的,它们的区别在于创建 Read View 的时机不同:
- 「读提交」隔离级别是在每个 select 都会生成一个新的 Read View,也意味着,事务期间的多次读取同一条数据,前后两次读的数据可能会出现不一致,因为可能这期间另外一个事务修改了该记录,并提交了事务。
- 「可重复读」隔离级别是启动事务时生成一个 Read View,然后整个事务期间都在用这个 Read View,这样就保证了在事务期间读到的数据都是事务启动前的记录。
这两个隔离级别实现是通过「事务的 Read View 里的字段」和「记录中的两个隐藏列」的比对,来控制并发事务访问同一个记录时的行为,这就叫 MVCC(多版本并发控制)。
在可重复读隔离级别中,普通的 select 语句就是基于 MVCC 实现的快照读,也就是不会加锁的。而 select .. for update 语句就不是快照读了,而是当前读了,也就是每次读都是拿到最新版本的数据,但是它还会对读到的记录加上 next-key lock 锁。
而且 在RP级别下,如果没命中索引,可能变成“表锁”
所以一般不建议设置为PR 一个是没必要 一个是加间隙锁 影响性能 特殊情况还会变成表锁

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献3条内容

所有评论(0)