毕业设计:基于协同过滤的服装购物个性化推荐系统
目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于协同过滤的服装购物个性化推荐系统
项目背景
随着电子商务的迅猛发展,服装购物成为了人们日常生活的重要组成部分。然而,用户在面对海量的商品时,往往感到选择困难,传统的推荐方法无法满足个性化需求。服装购物推荐系统的目标是根据用户的偏好和行为,提供个性化的商品推荐,提升用户购物体验和满意度。通过引入深度学习等先进技术,能够更精准地分析用户数据和商品特征,从而实现高效的推荐。提取用户行为的时间序列特征,如用户最近的购买时间、浏览频率等,帮助理解用户的兴趣变化。同时,对商品进行标注,将其类别和属性(如风格、用途等)与商品ID关联,为模型提供丰富的上下文信息。
数据集
获取用户的行为数据和商品信息是实现个性化推荐和分析的重要步骤。首先,需要收集用户的浏览历史、购买记录以及与商品相关的信息。这些信息包括品牌、颜色、尺寸、价格、商品描述和图片等。通过对用户的行为进行全面分析,可以更好地理解用户的偏好和需求,从而优化产品推荐和营销策略。
在数据处理阶段,需对收集到的数据进行清洗,以确保其质量和一致性。这包括处理缺失值,例如采用插值法或填充均值等方式来填补缺失数据。此外,还需统一商品图片的尺寸和格式,确保所有图像在展示时的一致性。数据清洗还包括去除重复项和异常值,以提高后续分析的准确性与有效性。通过这些步骤,可以构建一个高质量的数据集,为后续分析和建模奠定基础。
在特征提取过程中,需要关注用户行为的时间特征,例如用户在特定时间段的活动频率和购买习惯。对商品进行标注时,应关联类别和属性,以便于后续分析和模型训练。完成特征提取后,将处理后的数据集随机分割为训练集和测试集,通常以70%的数据用于训练,30%的数据用于测试。
设计思路
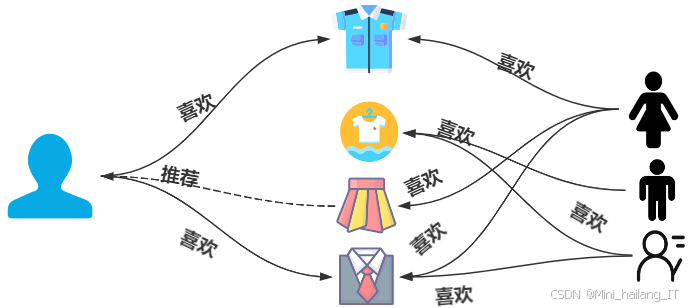
推荐算法旨在根据用户的历史行为和偏好,为其提供个性化的商品或内容推荐。这种个性化体验不仅能提高用户的满意度,还能有效提升转化率和客户忠诚度。常见的推荐算法可以分为协同过滤和基于内容的推荐两大类。协同过滤方法依赖于用户之间的相似性进行推荐,利用用户的行为数据来发现潜在的兴趣和偏好。这种方法的核心在于通过分析用户的历史行为,识别出与目标用户具有相似行为模式的其他用户,进而基于这些相似用户的偏好进行推荐。这种方式不仅适用于电商平台,还广泛应用于社交媒体、音乐和视频推荐等领域。
协同过滤又可以细分为基于用户和基于物品的两种方法。基于用户的协同过滤关注与目标用户相似的其他用户的行为,通过分析这些相似用户的偏好来推荐商品。例如,如果用户A和用户B在过去的购买历史中有很多重叠,系统可能会推荐用户B喜欢但用户A尚未购买的商品。另一方面,基于物品的协同过滤则聚焦于用户对物品的评分,推荐与用户过去喜爱物品相似度高的其他物品。这种方法通过分析物品之间的相似性,为用户推荐与其历史偏好相符的新物品。尽管协同过滤算法在捕捉用户潜在兴趣方面表现出色,但其缺点在于对新用户或新物品的冷启动问题比较敏感。当没有足够的用户数据或物品数据时,推荐系统的效果可能会受到限制。
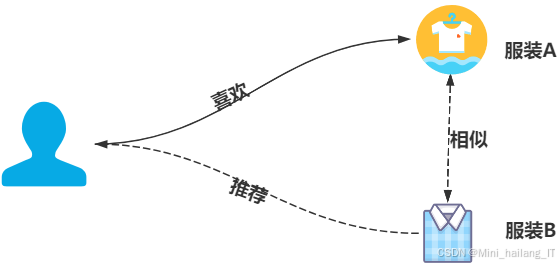
基于内容的推荐方法主要依赖于物品本身的特征,通过分析物品的属性,例如品牌、颜色、款式、描述和其他相关信息,来生成个性化推荐。这种方法的核心在于了解用户的历史偏好,并将其与物品的特征相匹配,从而提供符合用户兴趣的推荐。例如,对于一位喜欢红色运动鞋的用户,系统可以推荐其他红色或运动类型的鞋子,或者与用户之前购买的鞋子具有相似特征的新品。这种基于内容的推荐方式尤其适合于特定领域,如电子商务和媒体推荐,因为物品的特征往往能够明确区分其适用性和吸引力。
基于内容的推荐方法在处理用户偏好变化时显示出明显的优势。由于该方法直接利用物品的特征,因此能够快速适应用户的最新需求。例如,当用户的兴趣发生变化,开始关注新的时尚趋势或品牌时,系统可以通过分析新物品的特性迅速调整推荐内容,而不需要依赖于大量的用户行为数据。这种灵活性使得基于内容的推荐在新用户或新物品的冷启动问题上具有一定的优势,因为系统能够利用现有的物品特征进行有效推荐。
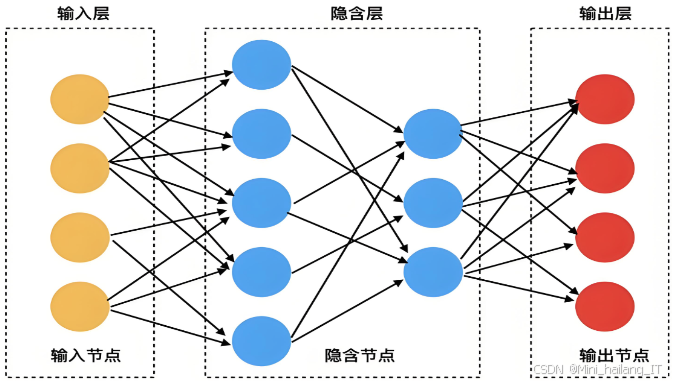
卷积神经网络(CNN)是一种深度学习模型,广泛应用于图像处理和计算机视觉领域。CNN通过卷积层提取输入图像的局部特征,利用多个卷积核对图像进行处理,以获得丰富的特征表示。每个卷积核专注于捕捉不同类型的特征,例如边缘、纹理和形状等。卷积层后通常会添加池化层,通过下采样操作减少特征图的尺寸,降低计算复杂度。池化层的引入不仅减少了数据量,还提高了模型的鲁棒性,防止过拟合。CNN的典型架构由多个卷积层和全连接层组成,通过多层卷积和池化,模型能够学习到从低级特征到高级特征的层次结构,最终通过全连接层进行分类和预测。
在服装购物个性化推荐中,CNN能够有效分析用户上传的服装图片,提取其特征,如款式、颜色和纹理等。通过将这些提取的特征与用户的历史偏好进行匹配,系统能够生成个性化的商品推荐。例如,如果用户过去偏爱某种颜色或款式的服装,系统可以识别并推荐具有相似特征的新款服装。这种基于视觉特征的推荐方法不仅提升了用户的购物体验,还增加了用户对平台的粘性。此外,结合用户的互动数据和反馈,CNN还可以持续优化推荐策略,以适应用户的需求变化,从而实现更加精准的个性化推荐。
长短期记忆网络(LSTM)是一种特殊的递归神经网络(RNN),专门用于处理序列数据,尤其是在面对时间序列和文本数据时展现出卓越的性能。传统RNN在处理长序列时常常会遇到梯度消失或爆炸的问题,这使得网络难以学习长期依赖关系。LSTM通过引入门控机制有效解决了这些问题。它的单元结构由输入门、遗忘门和输出门组成,这些门控结构可以动态控制信息的流动和存储。输入门决定了哪些新信息需要被加入到单元状态中,遗忘门则控制了哪些信息需要被丢弃,而输出门则决定了从单元状态中输出哪些信息。通过这种机制,LSTM能够在较长的时间序列中保持对重要信息的记忆,同时忽略不必要的数据,从而实现对长期依赖关系的有效建模。这种能力使得LSTM在处理复杂序列任务时表现得尤为出色,能够捕捉到数据中潜在的关联和规律。
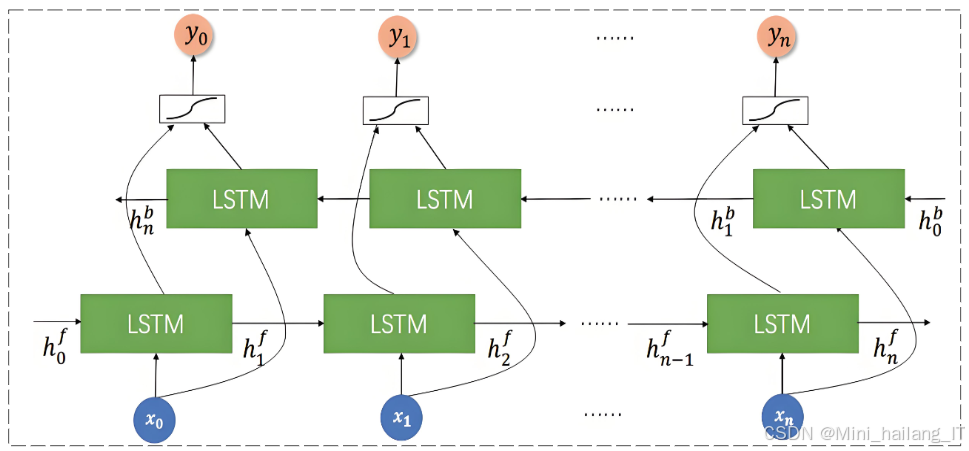
LSTM在多个领域表现出色,特别是在时间序列预测和自然语言处理等应用中。比如,在时间序列预测中,LSTM能够分析历史数据中的复杂模式,并据此预测未来的趋势和变化。这种能力使其在金融市场预测、气象预报和库存管理等领域得到广泛应用。在自然语言处理方面,LSTM被广泛应用于机器翻译、文本生成和情感分析等任务。它能够捕捉句子中的上下文关系,从而提高语言理解和生成的准确性。此外,LSTM的灵活性还允许它与其他神经网络结构结合使用,例如在图像描述生成中,结合卷积神经网络(CNN)和LSTM可以实现图像内容的理解与自然语言描述的生成。
收集用户的行为数据和商品的详细信息。用户行为数据包括浏览记录、购买记录、评分和搜索历史等,而商品信息则涵盖商品的图片、描述、品牌、颜色和款式等属性。通过网站日志、用户反馈和第三方数据源,可以获取到全面的用户行为数据。检查数据的完整性,去除无效记录或填补缺失值,以确保数据的准确性。对于用户行为数据,可能需要将用户和商品ID进行编码,以便于后续处理。对商品图片进行预处理也是一个重要步骤,通常需要将图片缩放到相同的尺寸、进行归一化等操作
from sklearn.preprocessing import LabelEncoder
from keras.preprocessing.image import ImageDataGenerator

# 示例:处理缺失值
user_data.dropna(inplace=True)

# 示例:编码用户和商品ID
user_encoder = LabelEncoder()
product_encoder = LabelEncoder()
user_data['user_id'] = user_encoder.fit_transform(user_data['user_id'])
product_data['product_id'] = product_encoder.fit_transform(product_data['product_id'])

# 示例:图像预处理
datagen = ImageDataGenerator(rescale=1./255)  # 归一化处理
使用卷积神经网络(CNN)进行图像特征提取,构建一个CNN模型,通过卷积层和池化层提取服装图片的视觉特征。卷积层能够捕捉到图像中的边缘、纹理和形状等低级特征,而池化层则通过下采样操作减少特征图的尺寸,保留重要信息并降低计算复杂度。训练CNN模型时,使用大量标注的图像数据,目标是提升模型的分类准确性和特征提取能力。经过训练的CNN模型能够有效地识别不同款式和颜色的服装,为后续的个性化推荐提供强大的特征支持。
from keras.models import Sequential
from keras.layers import Conv2D, MaxPooling2D, Flatten, Dense

# 示例:构建CNN模型
cnn_model = Sequential()
cnn_model.add(Conv2D(32, kernel_size=(3, 3), activation='relu', input_shape=(128, 128, 3)))
cnn_model.add(MaxPooling2D(pool_size=(2, 2)))
cnn_model.add(Conv2D(64, kernel_size=(3, 3), activation='relu'))
cnn_model.add(MaxPooling2D(pool_size=(2, 2)))
cnn_model.add(Flatten())
cnn_model.add(Dense(128, activation='relu'))
cnn_model.add(Dense(len(product_data['product_id'].unique()), activation='softmax'))  # 输出类别为商品的数量

cnn_model.compile(optimizer='adam', loss='categorical_crossentropy', metrics=['accuracy'])
使用预处理后的图像数据和对应的标签对CNN模型进行训练,采用交叉熵损失函数和Adam优化器。在训练过程中,可以使用数据增强技术,例如旋转、剪切、平移等,增加模型的鲁棒性,防止过拟合。通过训练,模型能够学习到图像中不同特征与商品类别之间的映射关系。训练完成后,应保存训练好的模型,以便后续使用和评估。
# 示例:训练CNN模型
cnn_model.fit(datagen.flow(train_images, train_labels, batch_size=32), epochs=20, validation_split=0.2)
cnn_model.save('cnn_model.h5')  # 保存模型
使用长短期记忆网络(LSTM)对用户行为序列进行建模。LSTM能够有效捕捉用户的行为变化和兴趣趋势,特别是在处理时间序列数据时表现出色。在这一阶段,输入为用户的历史行为数据,输出为预测的下一个可能行为。通过训练LSTM模型,能够更好地理解用户的购物习惯,识别用户潜在的兴趣变化,从而生成更加精准的个性化推荐。
from keras.models import Sequential
from keras.layers import LSTM, Dense

# 示例:构建LSTM模型
lstm_model = Sequential()
lstm_model.add(LSTM(128, input_shape=(timesteps, features)))
lstm_model.add(Dense(len(product_data['product_id'].unique()), activation='softmax'))

lstm_model.compile(optimizer='adam', loss='categorical_crossentropy', metrics=['accuracy'])

# 示例:训练LSTM模型
lstm_model.fit(train_sequences, train_labels, epochs=20, batch_size=32)
lstm_model.save('lstm_model.h5')  # 保存模型
完成CNN和LSTM的训练后,结合两者的输出,构建最终的个性化推荐模型。通过将CNN提取的服装视觉特征与LSTM预测的用户行为结合,可以生成更为精准和个性化的推荐结果。融合策略可以采用加权平均或其他方法,综合考虑图像特征和用户行为,使得推荐结果更符合用户的真实需求。
import numpy as np

# 示例:融合CNN和LSTM的输出
def recommend(user_id, image):
    cnn_features = cnn_model.predict(np.expand_dims(image, axis=0))
    lstm_prediction = lstm_model.predict(user_behavior_sequence)  # 用户行为序列

    combined_features = np.concatenate([cnn_features, lstm_prediction], axis=-1)
    recommendations = final_model.predict(combined_features)  # 最终推荐模型
    return recommendations

# 示例:生成推荐
recommended_products = recommend(user_id, uploaded_image)
通过使用测试集对融合模型进行评估,计算准确率、召回率和F1值等指标,判断模型的性能。可以通过绘制混淆矩阵等方式可视化分类结果,分析模型在不同类别上的表现。根据评估结果,调整模型参数和结构,进行模型优化。不断迭代训练和评估,以提高个性化推荐的效果,确保推荐系统能够真实反映用户的偏好。
from sklearn.metrics import accuracy_score, recall_score, f1_score, confusion_matrix

# 使用测试集进行预测
test_predictions = final_model.predict(test_data)
predicted_classes = np.argmax(test_predictions, axis=1)  # 获取预测类别
true_classes = np.argmax(test_labels, axis=1)  # 获取真实类别

# 计算评估指标
accuracy = accuracy_score(true_classes, predicted_classes)
recall = recall_score(true_classes, predicted_classes, average='weighted')  # 计算加权召回率
f1 = f1_score(true_classes, predicted_classes, average='weighted')  # 计算加权F1值

print(f'Accuracy: {accuracy:.4f}')
print(f'Recall: {recall:.4f}')
print(f'F1 Score: {f1:.4f}')
更多帮助

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献12条内容

所有评论(0)