毕业设计:基于流量特征提取的网络安全异常检测系统
目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于流量特征提取的网络安全异常检测系统
项目背景
随着信息技术的快速发展和互联网的广泛应用,网络安全问题日益突出,尤其是网络流量异常现象可能导致数据泄露、服务中断等严重后果。有效的网络流量异常检测技术能够及时发现并响应潜在的安全威胁,从而保护网络系统的安全性和稳定性。传统的检测方法往往依赖人工规则和阈值设置,难以适应复杂的网络环境。自动化的网络流量异常检测系统,能够大幅提升检测的准确性和实时性。
数据集
数据收集抓取不同时间段的网络流量,将捕获的原始数据导入到Python中,使用Pandas将其格式化为结构化的CSV文件。为了保证数据的质量,仔细处理了缺失值,采用均值插补填补了部分缺失信息并去除了异常值。提取流量统计特征,例如流量大小、包数量和持续时间并标注正常流量与异常流量完成特征提取后,将数据集划分为训练集、验证集和测试集,确保每个数据集中的样本比例合理。
设计思路
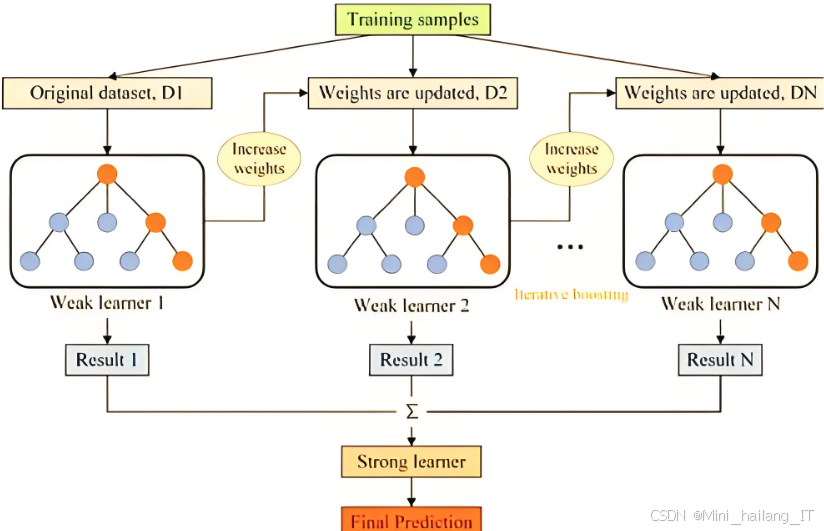
决策树通过将流量特征分层次进行分类,构建出一系列清晰的决策规则,从而使网络流量的正常行为与异常行为能够被清晰地区分。每个决策节点根据特征值将流量划分为不同的类别,最终形成树状结构,帮助分析人员快速理解流量模式并识别潜在的异常行为。这种方法的优点在于其良好的可解释性,用户可以直观地看到每个决策是如何做出的,提供了极大的便利,可以帮助快速识别出异常流量并采取相应的措施。
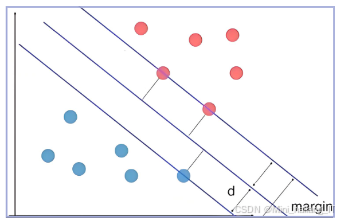
支持向量机是一种强有力的监督学习算法,广泛应用于网络流量异常检测中,用于有效识别已标记的正常与异常流量。SVM的核心思想是通过构建一个超平面,将正常流量和异常流量在特征空间中进行分隔,最大化两类之间的间隔,从而实现高效的分类。通过这种方式,SVM能够学习到流量数据中的复杂模式,并在面对新样本时迅速做出判断。该算法特别适合处理高维数据,能够在小样本情况下保持良好的表现,特别适合于网络流量数据的特性。在训练过程中,SVM会选择支持向量,即在决策边界附近的样本,这些样本对模型的影响最大,确保了模型的稳健性。
生成器是GAN模型的核心组件之一,负责生成与真实流量数据相似的流量样本。设计生成器时,需要确保其能够捕捉到真实流量的分布特征,生成的数据应尽可能与真实流量相似。可以采用多层感知机(MLP)或卷积神经网络(CNN)作为基础架构。MLP适合处理结构化数据,通过多层全连接层逐步提取特征。每一层的神经元都能够学习到输入数据的非线性关系,从而增强生成器的表达能力。CNN则在处理图像数据时表现优异,能够通过卷积操作提取局部特征,适合处理具有空间结构的流量数据。通过卷积层和池化层的组合,生成器能够更有效地学习到流量数据中的重要模式。通常使用高斯分布或均匀分布的随机噪声作为输入,生成器通过这些噪声向量生成新的流量样本。生成器的输出层通常使用Tanh或Sigmoid激活函数,以确保生成的样本在特定范围内。为了提高生成器的稳定性,可以在模型中加入批归一化层,帮助加速训练过程并改善模型收敛速度。
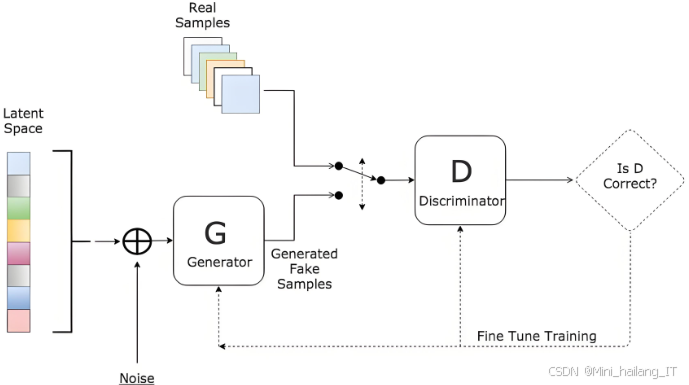
判别器是GAN模型的另一重要组件,主要任务是判断输入样本是真实流量还是生成流量。设计判别器时,需要确保其具备较强的特征提取能力,能够有效识别正常流量和异常流量之间的差异。判别器的架构通常也是基于深度学习,可以采用多层感知机(MLP)或卷积神经网络(CNN)。判别器的输入为流量样本,经过多层处理后输出一个二分类结果,表示该样本为真实流量的概率。通过使用全连接层或卷积层,判别器能够提取到流量数据的特征,识别出不同流量之间的模式。为了提高判别器的泛化能力,可以使用Dropout等正则化技术,防止过拟合现象的发生。在输出层,使用Sigmoid激活函数将网络输出映射到0和1之间,表示样本为真或假的可能性。
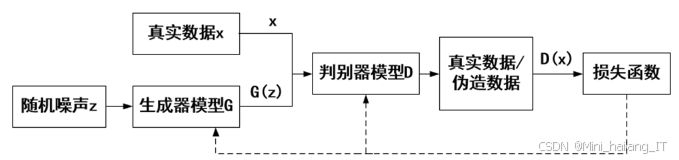
GAN的训练过程是通过对抗训练实现生成器和判别器的共同优化。训练过程通常包括两个主要步骤:生成器的训练和判别器的训练。生成器接受随机噪声作为输入,生成一批流量样本。在此基础上,判别器会对生成的样本进行评估,并给出判断结果。生成器的目标是最大化判别器对生成样本的错误判断,从而促使生成样本质量的提升。通过反向传播,生成器的参数会根据判别器的反馈进行更新,以使生成的样本更接近真实流量的分布。
通过从网络设备、入侵检测系统(IDS)、网络流量监测工具等多种来源获取网络流量数据,确保数据的多样性和代表性。收集到的原始数据通常是非结构化的,因此需要进行预处理。预处理包括数据清洗和特征选择。数据清洗的过程涉及缺失值处理和异常值检测,确保数据的质量。特征选择则是通过统计方法如卡方检验或信息增益来选择与异常检测相关的特征,减少数据维度,保留对模型训练最有价值的信息。
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.feature_selection import SelectKBest, chi2

# 读取数据
data = pd.read_csv("network_traffic.csv")

# 数据清洗(处理缺失值)
data.fillna(method='ffill', inplace=True)

# 特征选择
X = data.drop(columns=['label'])  # 特征
y = data['label']  # 标签

# 选取k个最佳特征
X_new = SelectKBest(chi2, k=10).fit_transform(X, y)
从原始流量数据中提取出能够反映流量行为的统计特征,如流量大小、包数量、持续时间等。这些特征为后续的异常检测提供了必要的数据基础。选择决策树、支持向量机(SVM)等经典机器学习算法,使用基于深度学习的模型如自编码器和生成对抗网络(GAN)。在训练模型时,需将数据集分为训练集和测试集,确保模型能够在未见过的数据上进行有效的预测。通过对训练集进行多次迭代,模型会逐渐学习到正常与异常流量之间的区别,从而提高其检测能力。
from sklearn.model_selection import train_test_split
from sklearn.svm import SVC
from sklearn.metrics import classification_report

# 划分数据集
X_train, X_test, y_train, y_test = train_test_split(X_new, y, test_size=0.2, random_state=42)

# 选择支持向量机模型
model = SVC(kernel='linear')

# 模型训练
model.fit(X_train, y_train)

# 评估模型
y_pred = model.predict(X_test)
print(classification_report(y_test, y_pred))
基于生成对抗网络(GAN)的异常检测方法为系统提供了一种创新的解决方案。GAN的生成器生成与真实流量相似的流量样本,以增强训练集的多样性。与此同时,判别器则判断输入样本的真实性,评估流量的正常与异常特征。通过对抗训练,生成器和判别器相互提升,确保生成的流量样本逐渐逼近真实流量的分布。
import tensorflow as tf
from tensorflow.keras import layers

# 生成器模型
def build_generator():
    model = tf.keras.Sequential()
    model.add(layers.Dense(256, activation='relu', input_dim=100))
    model.add(layers.Dense(512, activation='relu'))
    model.add(layers.Dense(3, activation='tanh'))  # 假设生成3个特征
    return model

# 判别器模型
def build_discriminator():
    model = tf.keras.Sequential()
    model.add(layers.Dense(512, activation='relu', input_dim=3))
    model.add(layers.Dense(256, activation='relu'))
    model.add(layers.Dense(1, activation='sigmoid'))
    return model

generator = build_generator()
discriminator = build_discriminator()

# 编译判别器
discriminator.compile(loss='binary_crossentropy', optimizer='adam', metrics=['accuracy'])
通过使用准确率、召回率、F1-score等评估指标,能够全面了解模型的检测能力。使用交叉验证方法来确保模型的泛化能力。根据评估结果,调整模型的超参数,选择合适的模型架构,进一步优化性能。
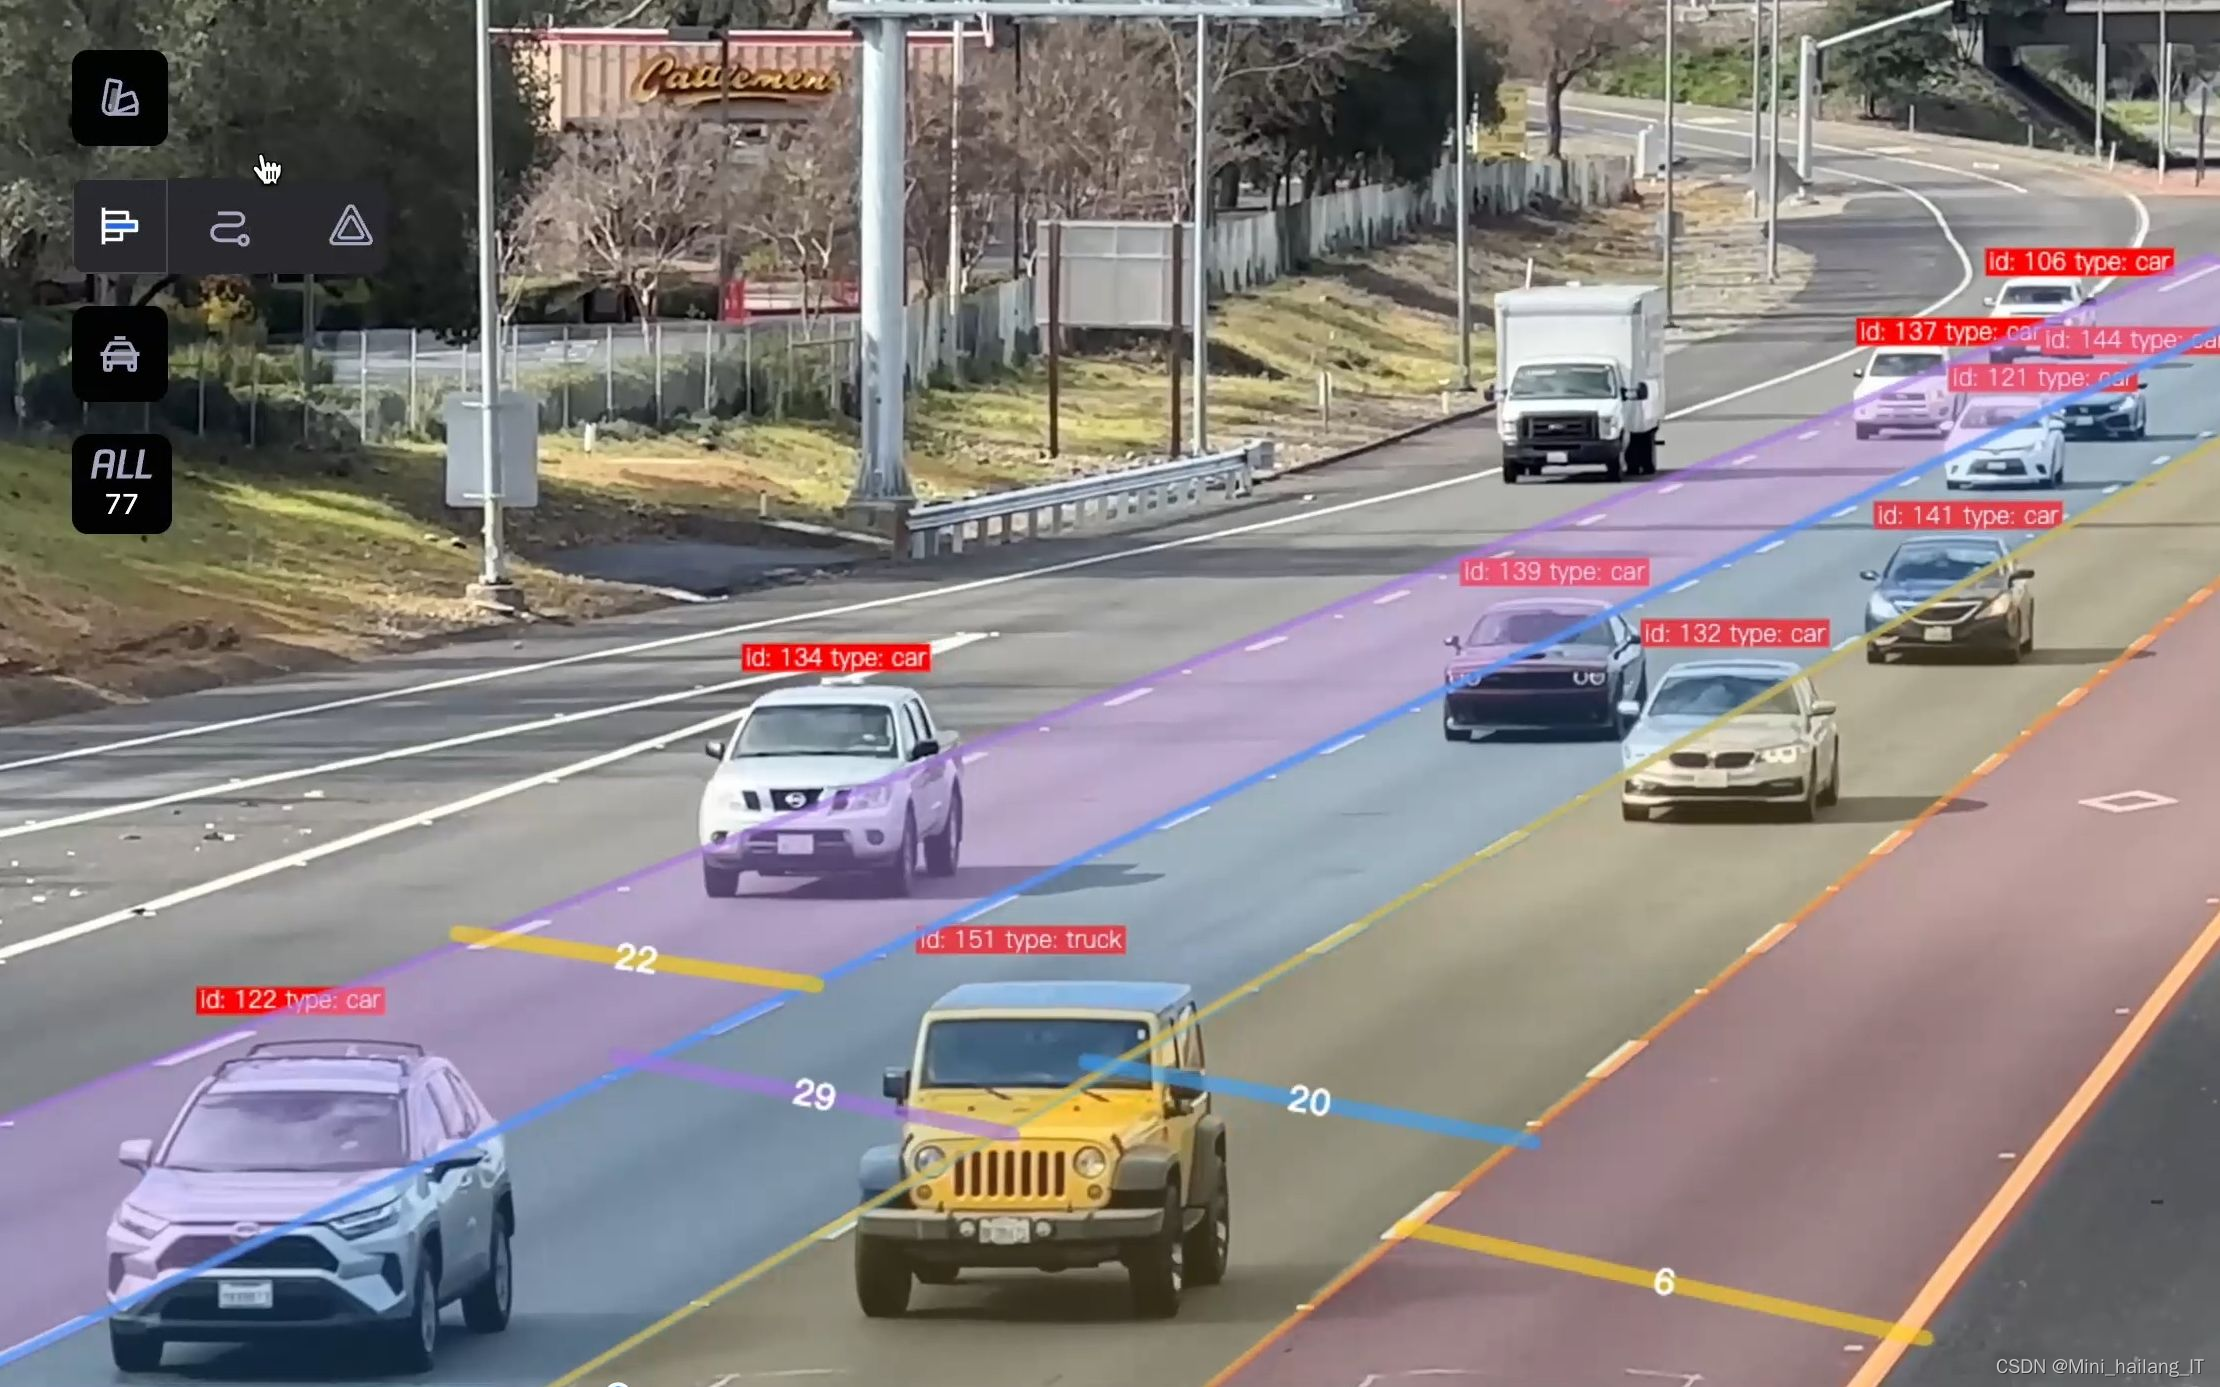
海浪学长项目示例:

更多帮助

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献12条内容

所有评论(0)