算法 - 并查集
并查集
文章目录
一:基本概念
我们以一个直观的问题引入并查集 (不相交集) 的概念。
※ 并查集: Union-Find Set ,不相交集: Disjoint Set。
亲戚问题: 有一群人,他们属于不同家族,同一个家族里的人互为亲戚,不同家族的人不是亲戚。
已知每个人都知道自己与其他人是否有亲戚关系,求问有几个家族。
亲戚问题代表着一大类能用并查集解决的所谓确定「连通分量」的问题
可以将上述问题图示化如下,不同颜色的集合代表不同家族,集合内的人 (元素) 互为亲戚。
从图论的角度来说,同一个集合内的元素是相互「连通」的,那么一个集合就是一个「连通分量」。
用集合的语言来说,问题涉及的元素可划归到互相 没有交集 的集合,因此也称这样的结构为 「不相交集」 。
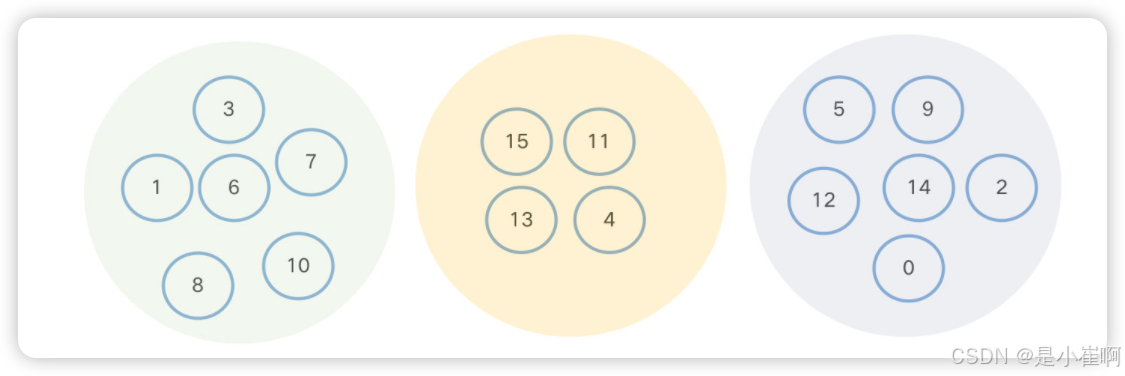
于是可以概括性的这样描述并查集
并查集 (不相交集) 是一种描述不相交集合的数据结构,即若一个问题涉及多个元素,它们可划归到不同集合
同属一个集合内的元素等价(即可用任意一个元素作为代表,比如上述的互为亲戚即互相等价),不同集合内的元素不等价。
这基本上就是对并查集的完整描述了,十分简单。
问题涉及的元素初始时总是自己构成一个单元素集合,求解问题需要通过合并操作将等价元素归入一个集合中。
为了能够合并等价元素,我们必须查询希望合并的对象元素属于哪个集合,以决定是否要执行合并。
因此 主要操作就是「查询」与「合并」。
「不相交」描述的是问题元素构成集合之后各个集合不相交的状态,「并查」描述的是处理问题时的操作。
下面通过一个具体的Leetcode问题进行说明(Leetcode 547 - 省份数量)
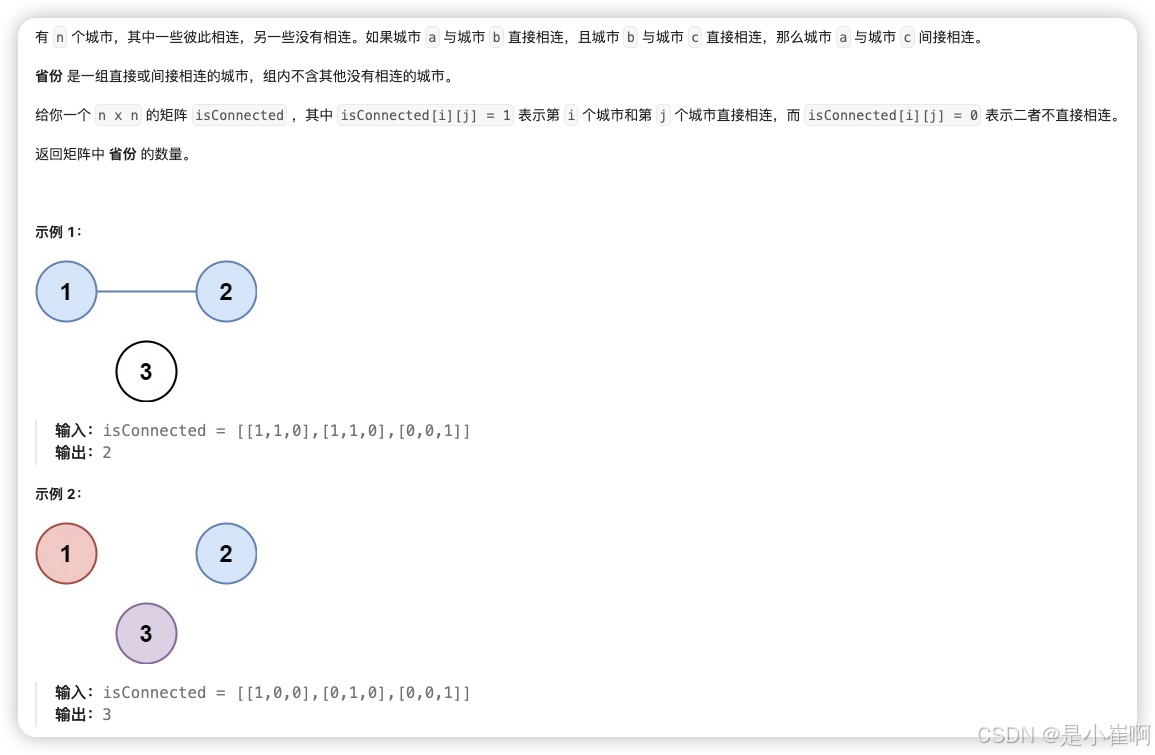
不难看出这是一个典型的并查集问题。如果我们能够通过矩阵信息将同一省份的城市都加入到同一个集合,最终有多少个省份就会有多少个不相交集合。
- 初始时,每个城市是否与其他城市同属一省是未知的,此时每个城市构成单元素集合
- 为了知道哪些城市同属一省,需要遍历矩阵,若 (i, j) 为 1,说明 i, j 两个城市同属一省,可以合并在一起,得到一个 2 元素集合。
- 在集合扩大的过程中,需要找到一个代表,以便多元素集合之间的合并。即当询问 i 与 j 是否应当合并时,需先确定 i 和 j 各自的代表,若相同,那么她们在之前就已经通过其他城市合并在一起了,若不同,则合并之,即向其中一个城市宣告它的代表,使她可以知道自己属于哪个省。现在,「查询」与「合并」变得更具体了
- 对未确定归属的城市进行上述的查询合并操作,当结束矩阵遍历时,所有城市就都知道了自己的代表。
- 此时再遍历一遍所有城市,「查询」她们的代表,有多少个不同的代表,就有多少个不同的省份,于是问题得到解决
可以发现 「代表」 在这一过程中至关重要,且所谓「同属一省的城市 (形成了集合) 」并不是静态的将这些城市放在了一起(放到表中或者其他什么静态的数据结构中),而是 动态地 查询它们的代表才知道的。
一个迫切要解决的问题就是如何保存及表示「代表」。再回顾一遍查询操作,假设集合中的某个元素 (省会城市) x 为该集合的代表,查询城市 y 是否属于 x 所在的省时,虽然不能直接得知这一信息,但 y 可能知道自己与其他城市是否在同一省,而这个其他城市又知道自己与 x 在同一省,或者经过「若干跳」来追溯到 x ,那么你就能够知道 y 与 x 为同一省。
这种向着一个方向串联的关系使你立刻想到以 (单向) 链表 来实现。于是你将每个城市想象成单向链表中的一个结点,以尾节点 (省会城市) 作为代表,每个元素 (城市) 指向它的后继 (通过矩阵中的 1 得知) ,连续地向 next 查询,一定能查询到尾结点。查询两个节点元素的尾结点是否相同,即可知道他们是否属于同一集合。
二:处理过程
1:初始化
初始时,每个元素只知道 自己与自己「等价」 ,因此创建这个数组后,遍历并使得 capital[i] = i 。这样初始化就完成了
// 初始化
int[] capital = new int[isConnected.length];
for(int i = 0; i < isConnected.length; i++) {
    capital[i] = i;
}
编写代码解题时,初始化过程可以在主方法中完成,也可以在并查集类 UnionFind 的构造器中完成。
你选择在构造器中完成初始化,并写下如下代码。
class Solution{
    // 在主方法(findCycleNum)中new UnionFind
    public int findCircleNum(int[][] isConnected) {
        int n = isConnected.length;
        UnionFind uf = new UnionFind(isConnected); // 通过构造器完成初始化

        // 求解过程 ???

        return ???;
    }
}

// UnionFind类,只写我们当前知道的。
class UnionFind{
    private int[] capital;
    // 其他字段???

    public UnionFind(int[][] isConnected){ // 构造方法
        this.capital = new int[isConnected.length];
        for(int i = 0; i < isConnected.length; i++){
            capital[i] = i;
            // 其他字段的初始化???
        }
    }
}
初始化后得到如下 5 个单元素集合。
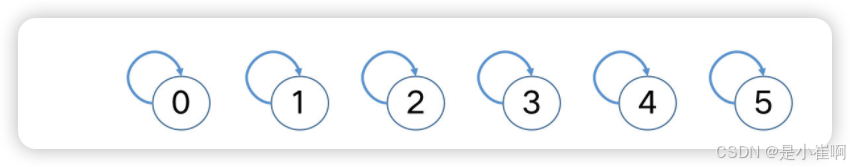
2:合并
合并的依据是查询,你先假设自己已经实现了「查询」方法 find(x) ,该方法返回 x 的当前代表。
合并 x 和 y 的前提是 find(x) != find(y) ,因为若 find(x) == find(y) ,说明二者已经在同一集合中了(同一省)。
具体做法如下,对于 x,y 两个城市:
if (find(x) != find(y)) {
    capital[find(y)] = find(x);
}
一开始可能想要写成 capital[x] = y,但马上发现这么写只能表示 yy 是 xx 的代表,而你的目的是用 yy 目前的代表 ( find(y) 的返回值) 来作为 x 的代表 ( find(x) 的返回值) 的代表,这样才能使得 x 目前的集合 整体并入 y 所在的集合。
// union方法
public void union(int x, int y) {
    if(find(x) != find(y)){
        capital[find(y)] = find(x); // 令 x 的代表作为 y 的代表的代表
    }
}
// 在main方法中遍历矩阵,调用union执行合并的过程的写法如下:
for(int i = 0; i < n; i++){
    for(int j = i + 1; j < n; j++){
        // 如果两个省份直接相连,就调用union方法合并
        if(isConnected[i][j] == 1) {
            uf.union(i, j);
        }
    }
}
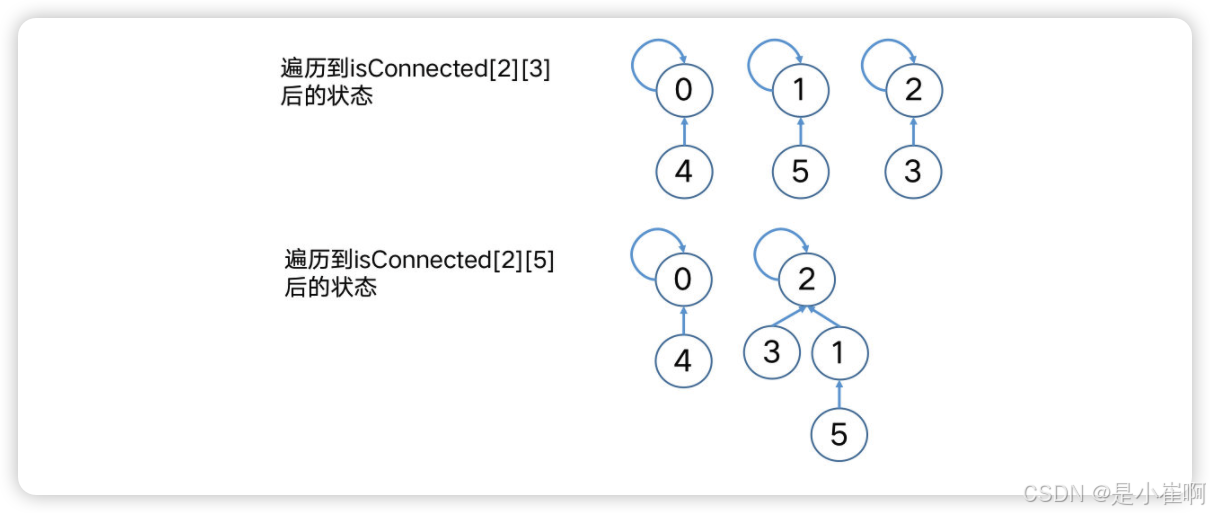
3:查询
若集合以单向链表(暂时还用链表的语言描述)的形式组织,尾结点为集合代表 (省会)。那么查询应该是一个递归的过程,熟悉链表写法的你立即写出如下 尾递归 代码。
public Node find(Node x) {
    if (x.next == null) {
        return x;
    }

    return find(x.next);
}
仿照链表,capital可以使用如下递归
public int find(int x) {
    if (capital[x] == x) {
        return x; // 根节点满足capital = x
    }
    return find(capital[x]);
}
4:小结
至此你得到了基本的并查集实现,主要方法 find 和 union 都只有数行代码,十分简洁。
- 初始化: 初始化代表下标 i (城市 i ) 的省会 ( capital[i]) 的 capitalcapital 数组,一开始令 capital[i] = i 。
- 合并: 以查询为基础,union(x, y) 将 y 当前的代表元「指向」 x 当前的代表元。
- 查询: 为尾递归方法,find(x) 不断在链上沿着 x 到它的代表元的方向前进,直到找到代表元(尾结点)。
针对此题【leetcode 547】,更聪明的做法是设置一个 unionCount = 0 ,表示合并的次数,在 unionunion 方法内添加一行代码,使得发生合并时 unionCount++ 实现累计
最后元素总数减去合并次数即为不相交集数量,也即省份数量。
class Solution {
    public int findCircleNum(int[][] isConnected) {
        int n = isConnected.length;
        UnionFindSet uf = new UnionFindSet(isConnected);  // 初始化并查集
        for (int i = 0; i < n; i++) {
            for (int j = i + 1; j < n; j++) {
                if (isConnected[i][j] == 1) {
                    // 两个城市连接,将执行合并操作
                    uf.union(i, j);
                }
            }
        }

        return n - uf.unionCount;
    }


}

class UnionFindSet {
    private int[] capital;
    int unionCount = 0; // 合并次数

    public UnionFindSet(int[][] isConnected) {
        this.capital = new int[isConnected.length];
        for (int i = 0; i < isConnected.length; i++) {
            capital[i] = i; // 初始化自己的代表是自己
        }
    }

    // x, y合并到一个集合中
    public void union(int x, int y) {
        if (find(x) != find(y)) {
            capital[find(y)] = find(x); // 以y所在集合的代表都以x所在集合的代表为代表
            unionCount += 1; // 说明执行了一次合并
        }
    }

    // 返回x所在集合的代表
    public int find(int x) {
        // 当且仅当capital[x] == x, x就是这个集合的根
        if (capital[x] == x) {
            return x;
        }
        // 否则执行尾递归
        return find(capital[x]); // 否则在当前x的代表中继续寻找
    }
}
🎉 当然本题可是使用dfs标记法解决
class Solution {
    public int findCircleNum(int[][] isConnected) {
        int n = isConnected.length;
        int count = 0; // 初始化省份的数量
        boolean[] flag = new boolean[n]; // 初始化flag,全是false
        for (int i = 0; i < n; i++) {
            if (!flag[i]) {
                dfs(isConnected, i, flag); // 如果当前的节点还没有被置为访问,进行dfs
                count += 1; // 省份+1
            }
        }
        return count;
    }


    private void dfs(int[][] isConnected, int i, boolean[] flag) {
        flag[i] = true; // 设置当前的节点已经被访问了
        for (int k = 0; k < isConnected.length; k++) {
            // 对于其他的节点,如果有没有被访问过的,并且和当前的节点相邻的,认为是同一个省份, 进行递归
            if (isConnected[i][k] == 1 && !flag[k]) {
                dfs(isConnected, k, flag);
            }
        }
    }
}
三:求并(union)优化
合并 x 和 y 所在树 (集合) 时,只是简单地将 y 所在树的根指向 x 所在树的根
capital[find(y)] = find(x),最坏的情况下将得到一棵链状的树,较高的树高将导致较高的查询 (及合并) 复杂度。你希望以某种策略使合并后得到树高较小的树。几乎不费思忖,你就得到了一个自然的想法:在合并时,不再默认将 y 所在树 (的根) 挂到 x 所在树 (的根) 上,而是先比较这两棵树的大小,让较小的树挂到较大的树上,因为较小的树的树高总是倾向于较低。-> 如果较小的那棵树低于较大的那棵树,合并后树高不变!
1:按照大小求并
// Union方法:按大小求并
public void union(int x, int y){
    int xRoot = find(x);
    int yRoot = find(y);
    // 根节点不同才求并
    if (xRoot != yRoot) {
        if(size[yRoot] <= size[xRoot]){ // 当y所在树大小小于等于x所在树大小时
            parent[yRoot] = xRoot; // 将yRoot挂在xRoot上
            size[xRoot] += size[yRoot]; // 更新x所在树的大小
        } else {
            parent[xRoot] = yRoot;
            size[yRoot] += size[xRoot];
        }
    }
}
size[i] 表示 i 结点所在树的大小。UnionFind 类中需要添加 size 数组字段和相应的初始化内容(单结点集合的大小为 1)
// 初始化
int[] parent = new int[isConnected.length];
for(int i = 0; i < isConnected.length; i++) {
    parent[i] = i;
}
UnionFind uf = new UnionFind(parent);


// UnionFind类(部分)
class UnionFind{
    private int[] parent, size; // size保存树的大小

    // 构造函数(部分)
    public UnionFind(int[] parent) {
        this.parent = parent;
        this.size = new int[parent.length];
        for (int i = 0; i < parent.length; i++) {
            this.size[i] = 1; // 初始时单节点树大小为1
        }
    }
}
2:按照高度求并
当并查集的查找方法不具有「带路径压缩」的效果时,本节所述方法就是严格的「按高度求并」。
当并查集应用了「带路径压缩」的查找方法时,height 将不能表示严格的「树高」的概念,为严谨,需改称「按高度求并」为「按秩求并」。
// union方法:按秩(高度)求并,不判断是否在同一集合
public void union(int x, int y){
    int xRoot = find(x);
    int yRoot = find(y);
    if(rank[yRoot] <= rank[xRoot]) {
        parent[yRoot] = xRoot;
    } else {
        parent[xRoot] = yRoot;
    }
    if(rank[xRoot] == rank[yRoot] && xRoot != yRoot) {
        rank[xRoot]++;
    }
}
四:代码实现
1:按秩求并 + 带路径压缩查询
class UnionFind{
    private int[] parent, rank, size; // 实际代码中,按秩求并和按大小求并选择其一
    public UnionFind(int[] parent) {
        this.parent = parent;
        this.rank = new int[parent.length];
        this.size = new int[parent.length];
        Arrays.fill(rank, 1); // 实际代码中,按秩求并和按大小求并选择其一
        Arrays.fill(size, 1); // 实际代码中,按秩求并和按大小求并选择其一
    }
    // 直接查找
    public int findDirect(int x) {
        if(parent[x] == x) return x;
        return findDirect(parent[x]);
    }
    // 带路径压缩的查找
    public int find(int x) {
        if(parent[x] == x) return x;
        return parent[x] = find(parent[x]);
    }
    // 直接求并
    public void unionDirect(int x, int y) {
        int xRoot = find(x), yRoot = find(y);
        if(xRoot != yRoot){
            parent[yRoot] = xRoot;
        }
    }
    // 按大小求并
    public void unionBySize(int x, int y){
        int xRoot = find(x), yRoot = find(y);
        if(xRoot != yRoot) { // 根节点不同才求并
            if(size[yRoot] <= size[xRoot]){
                parent[yRoot] = xRoot;
                size[xRoot] += size[yRoot];
            } else {
                parent[xRoot] = yRoot;
                size[yRoot] += size[xRoot];
            }
        }
    }
    // 按秩求并
    public void union(int x, int y){
        int xRoot = find(x);
        int yRoot = find(y);
        if( xRoot != yRoot){
            if(rank[yRoot] <= rank[xRoot]) {
                parent[yRoot] = xRoot;
            } else {
                parent[xRoot] = yRoot;
            }
            if(rank[xRoot] == rank[yRoot]) {
                rank[xRoot]++;
            }
        }
    }
}
2:无需大小/秩数组空间的技巧
/**
 * 应用负数技巧的并查集
 */
class UnionFind2{
    private int[] parent;
    public UnionFind2(int[] parent) {
        this.parent = parent;
    }
    // 直接查找
    public int findDirect(int x) {
        if(parent[x] < 0) return x; // 只有代表元满足 parent[x] < 0
        return findDirect(parent[x]);
    }
    // 带路径压缩的查找
    public int find(int x) {
        if(parent[x] < 0) return x;
        return parent[x] = find(parent[x]);
    }
    // 直接求并
    public void unionDirect(int x, int y) {
        int xRoot = find(x), yRoot = find(y);
        if(xRoot != yRoot){
            parent[yRoot] = xRoot;
        }
    }
    // 按大小求并
    public void unionBySize(int x, int y){
        int xRoot = find(x), yRoot = find(y);
        if(xRoot != yRoot) { // 根节点不同才求并
            if(parent[xRoot] <= parent[yRoot]){ // 负数比较,较小者树较大,xRoot所在树更大(或相等)
                parent[xRoot] += parent[yRoot]; // 更新树的大小
                parent[yRoot] = xRoot;
            } else {
                parent[yRoot] += parent[xRoot];
                parent[xRoot] = yRoot;
            }
        }
    }
    // 按秩求并
    public void union(int x, int y){
        int xRoot = find(x), yRoot = find(y);
        if(xRoot != yRoot) {
            if(parent[xRoot] < parent[yRoot]){
                // xRoot所在树秩更大,yRoot挂到xRoot之下
                parent[yRoot] = xRoot;
            } else if(parent[xRoot] > parent[yRoot]){
                // yRoot所在树秩更大,xRoot挂到yRoot之下
                parent[xRoot] = yRoot;
            } else{
                // 秩等大,yRoot挂到xRoot之下
                parent[xRoot]--; // xRoot所在树秩加1 (负数,实际减1)
                parent[yRoot] = xRoot;
            }
        }
    }
}
五:复杂度分析
1:时间复杂度
带路径压缩的按秩求并的并查集,其查询与合并操作的时间复杂度均为 O(α(n)) ( α(n) 表示增长十分缓慢的反阿克曼函数)
对于任何实际的问题的 n ,α(n) 不会超过 5 。因此可以认为此复杂度为 O(1)。
初始化 parent[] / size[] / rank[] 数组的时间复杂度为 O(n) 。
2:空间复杂度
取决于 parent[] / size[] / rank[] 数组所占空间,为 O(n) 。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献7条内容

所有评论(0)