软件测试 - 测试用例篇
目录
1. 前言
在笔试面试中, 我们常用 "万能公式" 来设计测试用例:
功能测试 + 性能测试 + 界面测试 + 兼容性测试 + 易用性测试 + 安全测试 (+ 弱网测试 + 安装卸载测试)
但是, 在实际工作中, 设计测试用例通常基于以下两点:
- 基于需求进行设计
- 基于具体的设计方法(黑盒测试)
设计方法有以下几种:
- 等价类
- 边界值
- 正交法
- 判定表法
- 错误猜测法
- 场景法
本篇博客, 就来具体的聊一聊这些设计方法.
2. 等价类
等价类法, 依据需求将输入(特殊情况下会考虑输出)划分为若干个等价类, 每个等价类中包含多个测试用例, 从每个等价类中任意选出一个测试用例作为代表, 如果这个测试用例测试通过, 则认为所代表的等价类测试通过, 这样就可以用较少的测试用例达到尽量多的功能覆盖, 解决了不能穷举测试的问题.
等价类分为两种:
- 有效等价类: 满足需求文档的, 正确的数据构成的集合
- 无效等价类: 不满足需求文档的, 错误的数据构成的集合
举个例子:
大家在注册账号时, 密码长度是会有限制的. 假设密码长度只能为 6-15 位.
如果使用穷举法, 需要依次测试6 位, 7 位, 8 位, ..., 15 位.
如果使用等价类法, 那我们设计测试用例时, 就可以将测试用例分为三个等价类:
- 有效等价类: 长度为 6-15 位
- 无效等价类1: 长度小于 6 位
- 无效等价类2: 长度大于 15 位
那么, 我们就可以分别从这三个等价类中, 任意抽取一个测试用例:
- 从有效等价类中: 抽取长度为 7 位进行测试
- 从无效等价类1中: 抽取长度为 4 位进行测试
- 从无效等价类2中: 抽取长度为 30 位进行测试
如果抽取的测试用例测试通过, 那么就认为这个测试用例所在的等价类中所有的测试用例都通过.
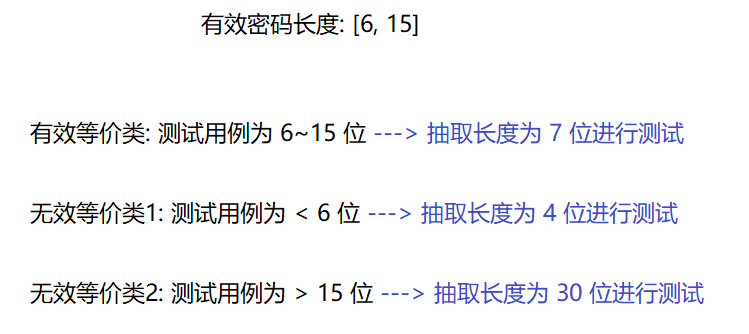
以上基于密码长度来测试用例, 密码长度是有范围限制的, 因此可以从等价类中任意抽取一个进行测试, 如果通过, 则代表该等价类测试通过.
但是, 当测试用例没有范围限制, 是具体的测试点时, 那么这些测试点都必须进行测试.
比如需求: 只接收香蕉, 桃子, 苹果这三种水果. 那么:
- 有效等价类: 香蕉, 桃子, 苹果
- 无效等价类: 非香蕉, 非桃子, 非苹果 --- 梨, 西瓜, 哈密瓜, ....
此时, 有效等价类中的这三种水果, 都必须进行测试.
3. 边界值
边界值分析法就是对输入或输出的边界值进行测试的一种黑盒测试方法.
通常边界值分析法是作为对等价类划分法的补充, 这种情况下, 其测试用例来自等价类的边界.
上文所讲的等价类法, 虽然解决了穷举的问题, 但是缺点也很明显 --- 不能测试边界数据.
在工作中, 边界数据的测试是至关重要的, 举个例子:
天猫双 11 当天, 活动时间为 9 点 - 10 点, 那么就需要将活动时间严格控制为 9:00:00 - 9:59:59, 保证在 8:59:59 和 10:00:00 时没有优惠.
而边界值法, 就是为了杜绝上述的 "边界漏洞".
边界值包含: 边界值 + 次边界值.
其中, 边界值就是给定数据中, 最左边和最右边的数据.
边界值并非就是有效的数据, 次边界值也并非就是无效数据. 但是这两者必须是相对的, 也就是说, 一方是有效数据, 那另一方必定是无效数据:
- 若边界值是有效数据, 则次边界值为无效数据
- 若边界值是无效数据, 则次边界值为有效数据
举个例子:
(1) 假设有效数据范围为 [10, 20], 则:
- 边界值: 10 和 20 (有效数据)
- 次边界值: 9 和 21 (无效数据)
(2) 假设有效数据范围为 (10, 20), 则:
- 边界值: 10 和 20 (无效数据)
- 次边界值: 11 和 19 (有效数据)
因此, 设计测试用例时, 可以结合等价类法和边界值法一起设计:
还是设计测试密码长度的测试用例:
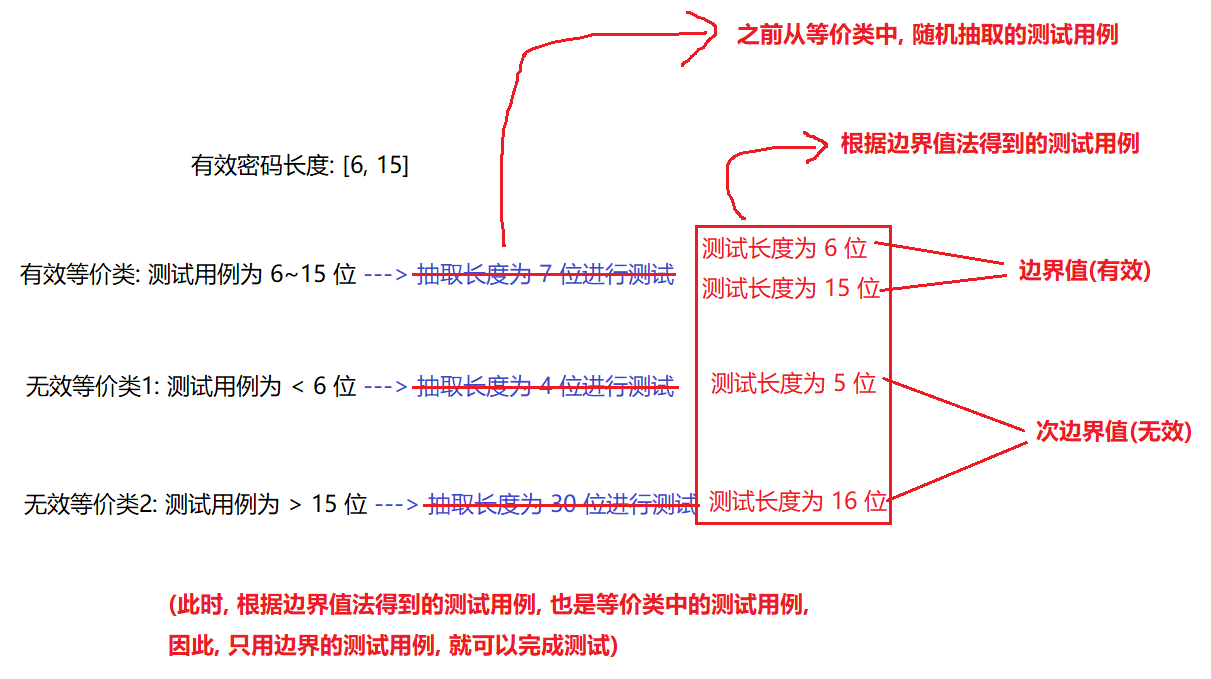
(此时, 根据边界值法得到的测试用例, 也是等价类中的测试用例, 因此, 只用边界法得到的测试用例, 就可以完成测试)
4. 正交法
正交试验设计(Orthogonalexperimentaldesign)是研究多因素多水平的一种设计方法, 它是根据正交
性, 由试验因素的全部水平组合中挑选出部分有代表性的点进行试验, 通过对这部分试验结果的分析
了解全面试验的情况, 找出最优的水平组合. 正交试验设计是一种基于正交表的、高效率、快速、经
济的试验.
简单来说, 正交法就是从所有的测试用例中, 挑选出一些关键的, 具有代表性的测试用例来进行测试, 只要这些代表性的测试用例通过测试, 那么就代表所有的测试用例都通过测试.
正交法的目的是为了减少用例数目. 用尽量少的用例覆盖输入的所有组合数.
举个例子:
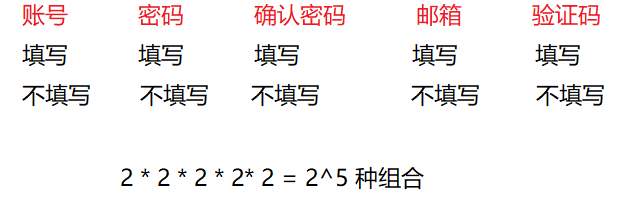
用户在注册时, 需要填写账号, 密码, 确认密码, 邮箱, 验证码. 假设这五个属性都是选填的, 既可填写, 也可不填写, 那么一共有 2^5 种组合方式:
如果对这 2^5 种组合都进行测试, 那么测试量是巨大的, 此时就可以使用正交法, 筛选出具有代表性的测试用例, 仅对这些用例进行测试既可.
4.2 正交表
正交表由三个要素构成:
- 因素: 存在的条件(列)
- 水平: 因素的取值
- 行数: 表的行数
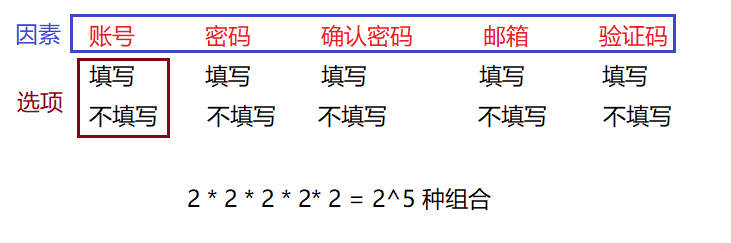
正交表的性质如下:
- 每一列中, 不同的数字出现的次数相等
- 任意两列中数字的排列方式齐全而且均衡
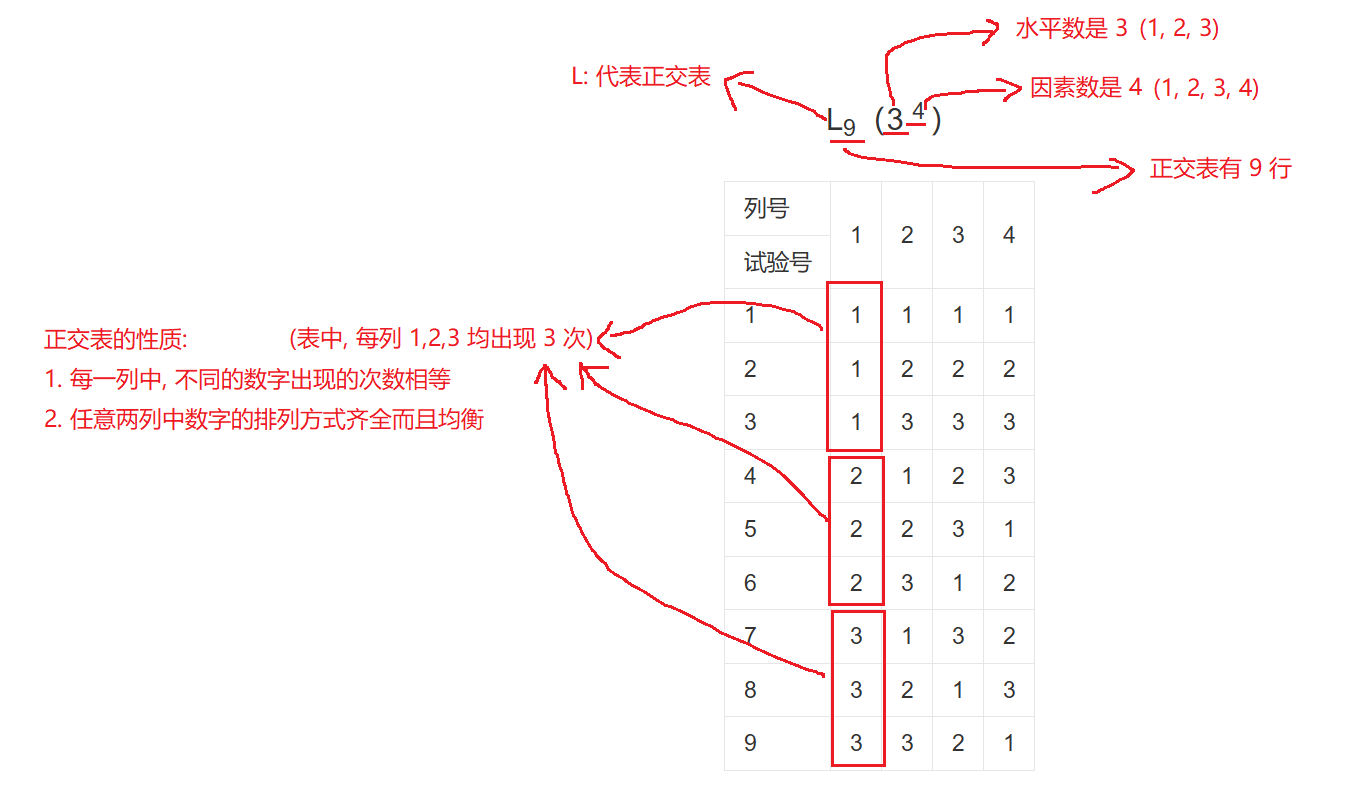
并且, 行数受因素数和水平数的影响, 计算公式如下:
- 行数 = 因素数 * (水平数 - 1) + 1
虽然, 正交法能够从诸多组合中, 筛选出具有代表性的测试用例, 但是由于正交表的性质限制, 很难人工制作出正交表, 因此, 正交法在工作中很少使用.
5. 判定表法
上文所讲的几种方法, 都适用于不同的场景中:
- 等价类/边界值 ==> 适用于测试的数据在一个范围中
- 正交表法 ==> 适用于测试的数据有多种组合
而判定表法, 适用于逻辑判断, 不同数据的组合, 对应不同结果的场景下.
举个例子:
假设, 用户注册时, 如果想拥有管理员权限, 那么以下两个条件必须满足其一:
- 账号中包含 admin 字符, 并点击注册按钮
- 账号中包含 super 字符, 并点击注册按钮
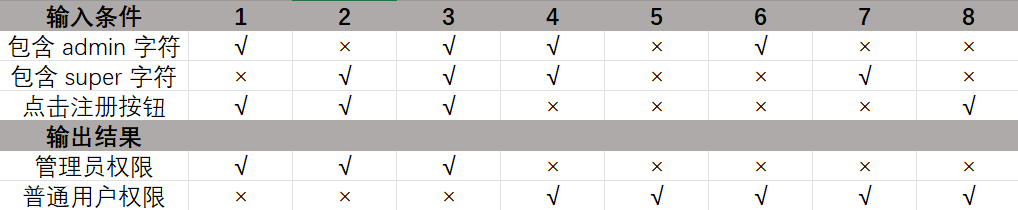
1. 首先, 我们可以先确认需求中的输入条件和输出结果:
- 输入条件: 包含 admin 字符, 包含 super 字符, 点击注册按钮
- 输出结果: 管理员权限, 普通用户权限
2. 接着, 确定不同输入组合下, 对应的输出结果:
- 包含 admin + 点击注册 => 管理员
- 包含 super + 点击注册 => 管理员
- 包含 admin + 包含 super => 普通用户
- 包含 admin + 包含 super + 点击注册 => 管理员
- 什么也不做 => 普通用户
- 只包含 admin => 普通用户
- 只包含 super => 普通用户
- 只点击注册 => 管理员
3. 画判定表:
6. 错误猜测法
错误猜测法(Error Guessing)很大程度上依赖于经验、直觉和对系统潜在弱点的了解, 推测出程序可能存在的缺陷, 从而针对性的设计测试用例的方法.
它是一种基于经验的测试技术,而不是像等价类划分或边界值分析那样的系统化方法。
这个方法的缺点是难以系统化, 并且过度依赖个人能力.
举个例子:
场景:收货地址超出配送范围
猜测: 如果用户填写的收货地址超出配送范围,结算功能会如何处理?
测试: 填写一个偏远地区的地址,然后尝试结算。
预期结果: 系统应该能够检测到该地址超出配送范围,并给出提示,或不允许结算。
7. 场景法
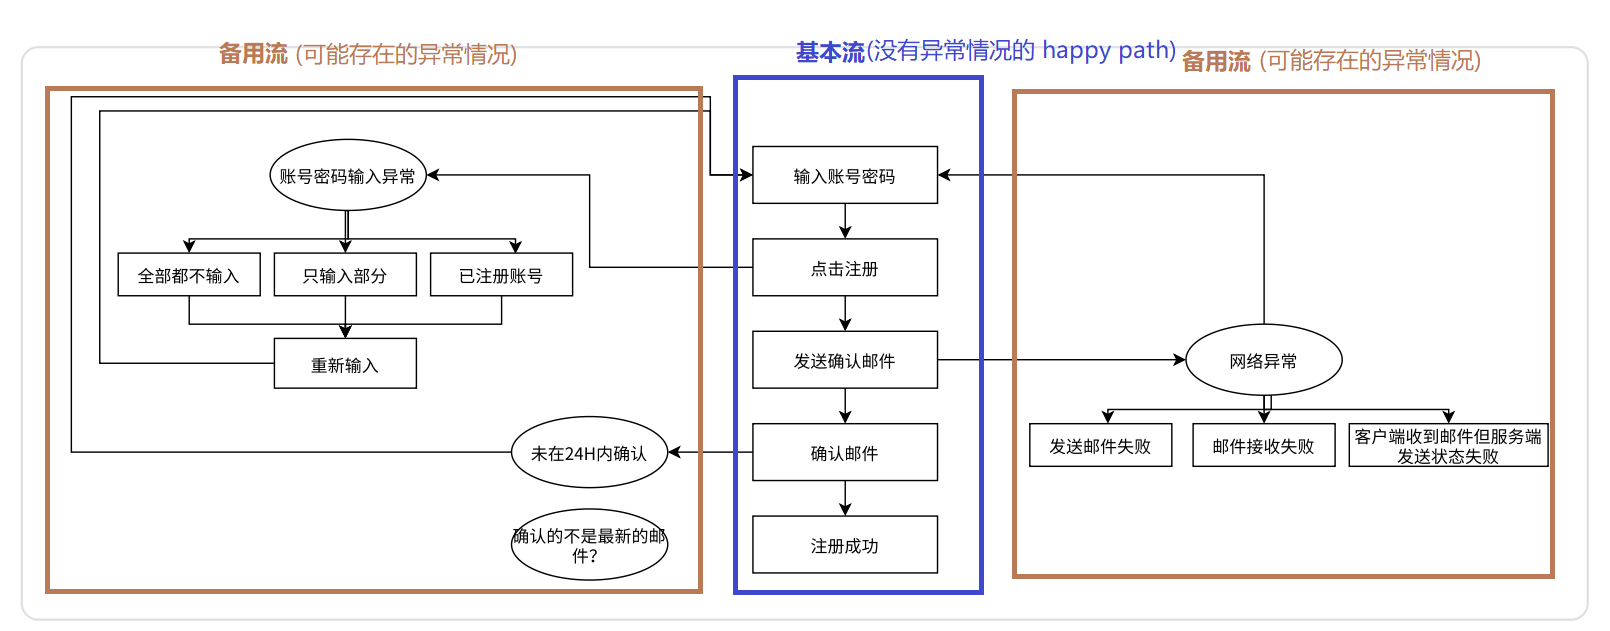
场景法:一种基于用户场景的黑盒测试方法, 通过模拟用户行为流程, 覆盖基本流和备用流, 设计测试用例以验证软件功能正确性和健壮性.
简单来说, 就是把测试过程当成 “讲故事”、“拍电影”,通过模拟用户在使用软件时的各种情景,来发现软件中可能存在的问题. 它是一种非常实用和有效的测试方法,可以帮助我们更好地保证软件的质量.
场景法分为基本流和备用流:
- 基本流(Basic Flow):也称为主流程、正常流程、Happy Path. 它是指在理想情况下,用户按照正常步骤、没有任何错误或异常情况下完成任务的流程. 基本流描述了最常见、最顺利的执行路径.
-
备用流(Alternative Flow):也称为异常流、例外流. 它是指在执行任务的过程中,由于各种原因(例如,用户输入错误、系统故障、条件不满足等)导致流程无法按照基本流执行的情况。 备用流描述了各种可能的异常情况以及系统如何处理这些情况。
END

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献10条内容

所有评论(0)