毕业设计:基于混合推荐算法的音乐推荐系统
目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
选题指导:
大家好,这里是海浪学长毕设专题,本次分享的课题是
🎯基于混合推荐算法的音乐推荐系统
设计思路
一、课题背景与意义
随着在线音乐平台的迅猛发展,用户面临着海量的音乐选择,如何高效地为用户推荐符合其兴趣的音乐成为了一个关键问题。个性化推荐技术通过分析用户的历史行为和偏好,能够提供更为精准的音乐推荐,提升用户体验。传统的推荐方法主要依赖于基于内容的推荐和协同过滤,但在处理冷启动问题和用户兴趣变化时常常面临挑战。近年来,深度学习技术的应用为音乐推荐提供了新的思路,通过构建复杂的模型和特征提取,可以更好地捕捉用户的偏好变化。本研究旨在探讨个性化音乐推荐方法,以期提高推荐系统的准确性和用户满意度。
二、算法理论原理
2.1 推荐算法
基于用户的协同过滤方法主要依赖于用户之间的相似性来进行推荐。在这一方法中,首先需要计算用户之间的相似度,这通常使用皮尔逊相关系数或余弦相似度等统计方法。皮尔逊相关系数通过衡量两个用户评分的线性相关性来判断其相似性,而余弦相似度则通过计算用户评分向量之间的夹角来评估相似度。这两种方法在处理用户评分数据时均表现良好,能够有效捕捉用户之间的偏好相似性。一旦计算出用户之间的相似度,就可以为目标用户推荐那些与其相似用户喜欢的音乐。例如,如果用户A和用户B的相似度很高,且用户B喜欢某首歌曲而用户A未听过,那么系统就会将该歌曲推荐给用户A。通过这一过程,基于用户的协同过滤能够为用户提供个性化的音乐推荐。
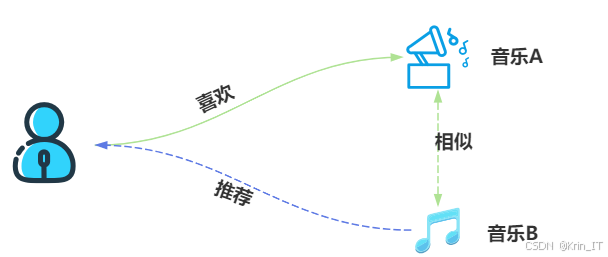
基于物品的协同过滤方法则专注于音乐本身之间的相似性。首先,系统会分析用户对音乐的评分数据,从中计算出不同音乐之间的相似度。常用的方法包括基于用户评分的加权平均法和基于内容的相似度计算。通过这些方法,可以得到一张音乐相似度矩阵,记录每首音乐之间的相似性。一旦计算出相似度,当用户喜欢一首音乐时,系统会推荐与之相似的其他音乐。这个过程的优点在于它能够捕捉到音乐间的潜在关系,例如相同流派或相似风格的音乐,从而为用户提供更加丰富的音乐选择。基于物品的协同过滤在处理稀疏性问题时通常表现得更好,因为音乐的数量远大于用户的数量,因此获取音乐之间的相似性数据更为可靠。
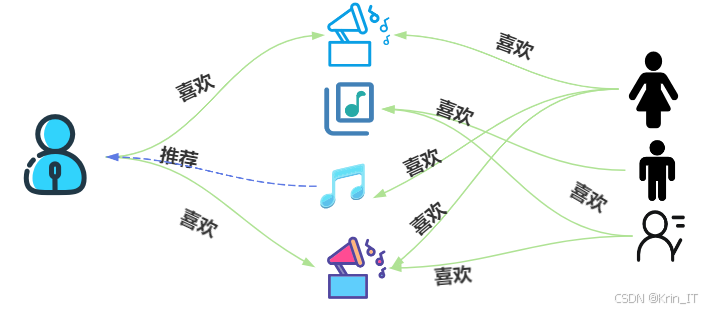
基于用户和物品的协同过滤往往可以结合使用,以提高推荐系统的准确性和鲁棒性。混合使用这两种方法可以充分利用用户数据和音乐数据之间的互补关系,从而生成更加全面和个性化的推荐结果。然而,协同过滤算法也面临一些挑战,尤其是在数据稀疏性和冷启动问题上。当用户对音乐的评分数据不足时,系统可能难以准确计算相似性,导致推荐效果下降。
2.2 知识图谱
知识图谱是以图结构形式表示知识的一种技术,它将现实世界中的实体及其之间的关系以节点和边的方式进行建模。每个节点代表一个实体(如音乐、艺术家、专辑等),而边则表示这些实体之间的关系(如“演唱”、“包含”、“属于”等)。通过这种结构,知识图谱能够有效整合来自多种数据源的信息,并为复杂问题提供丰富的上下文。音乐推荐领域知识图谱能够帮助系统更全面地理解用户的偏好和音乐之间的关系,从而实现更高效的个性化推荐。在音乐推荐的背景下,知识图谱不仅仅依赖于用户的评分和行为数据,还能够引入音乐的丰富背景信息。
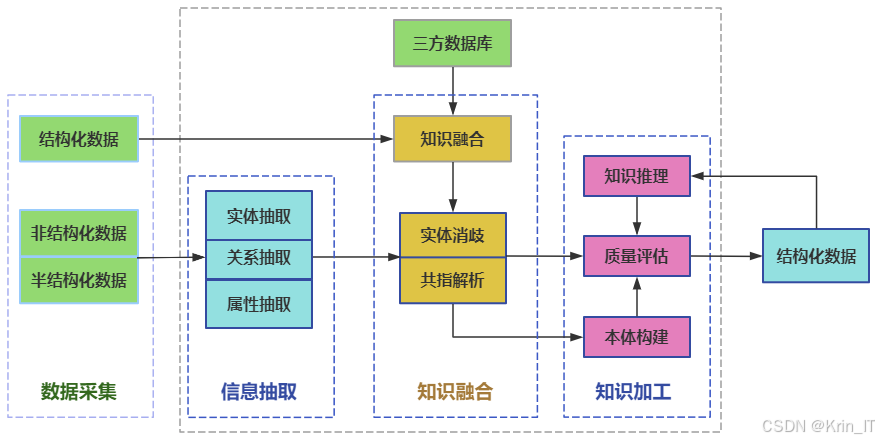
在音乐推荐系统中,知识图谱的构建与应用主要围绕以下几个方面展开。首先,通过将用户的历史行为与音乐的多维特征映射到知识图谱中,可以实现更为精准的用户画像。这一过程通常涉及用户对音乐的播放次数、收藏、分享等行为数据的分析。基于这些数据,推荐系统可以识别用户的偏好类型,挖掘出潜在的兴趣点。若用户频繁收听某一类型的音乐,系统可以通过知识图谱分析出该类型音乐的共同特征,从而推荐更多相似的音乐。
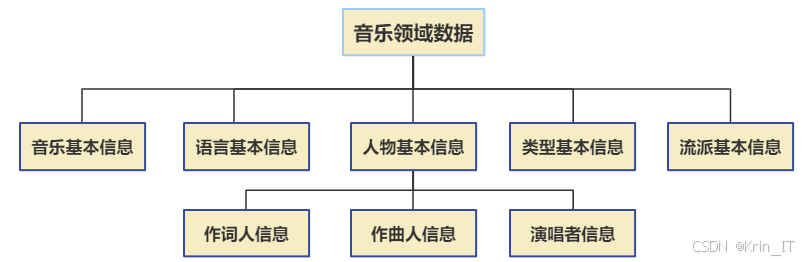
知识图谱能够实现基于内容的推荐与协同过滤的有效结合。通过知识图谱,系统可以不仅依赖于用户的直接反馈,还可以利用音乐之间的关系进行推荐。当用户喜欢某位艺术家的作品时,知识图谱可以帮助系统找到该艺术家与其他艺术家的合作关系,从而推荐与之相关的音乐。这种基于关系的推荐机制能够更好地捕捉音乐的上下文信息,提升推荐的多样性和相关性。知识图谱的引入还可以丰富推荐系统的解释能力,使得用户可以更好地理解推荐结果的来源和理由,从而增强用户的信任感和满意度。
三、检测的实现
3.1 数据集
通过网络爬虫,可以从各种在线音乐平台(如Spotify、Last.fm、YouTube等)抓取用户行为数据、音乐特征信息及用户评分等。常用的爬虫工具包括Scrapy和Beautiful Soup等。这一过程需要合理设计爬虫程序,确保能够抓取到有价值的信息,并遵循网站的爬虫规则和隐私政策。一旦数据被爬取,通常需要对数据进行清洗和处理,以去除重复记录和无效信息,并将其转换为适合分析和建模的格式。
3.2 实验训练
混合推荐算法结合了基于内容的推荐和协同过滤的优势,以提高推荐系统的准确性和鲁棒性。首先,需要从爬取的数据集中提取用户行为数据和音乐特征数据,构建用户-音乐评分矩阵和音乐特征矩阵。使用基于用户和物品的协同过滤方法计算相似性,并利用基于内容的推荐方法分析音乐的特征。然后,将这两种推荐结果进行加权融合,生成最终的推荐列表。通过不断迭代训练模型,可以不断优化推荐结果。
import numpy as np
from sklearn.metrics.pairwise import cosine_similarity

# 构建用户-音乐评分矩阵
def create_rating_matrix(user_data, music_data):
    # 假设user_data是用户对音乐的评分数据
    rating_matrix = np.zeros((len(user_data), len(music_data)))
    for user in user_data:
        for music in user['ratings']:
            rating_matrix[user['id'], music['id']] = music['rating']
    return rating_matrix

# 计算相似性示例
def calculate_similarity(matrix):
    return cosine_similarity(matrix)

# 示例调用
rating_matrix = create_rating_matrix(user_data, music_data)
similarity_matrix = calculate_similarity(rating_matrix)
知识图谱在音乐推荐系统中扮演着重要的角色,它帮助系统理解音乐及其相关属性之间的关系。首先,需要构建音乐领域的知识图谱,包括音乐、艺术家、专辑、流派和歌词等实体,并定义它们之间的关系。然后,通过从用户行为数据中提取用户偏好,将这些信息映射到知识图谱中,进而可以为用户提供基于关系的推荐。
import networkx as nx

# 构建知识图谱示例
def build_knowledge_graph(music_data):
    G = nx.Graph()
    for music in music_data:
        G.add_node(music['title'], type='music')
        G.add_node(music['artist'], type='artist')
        G.add_edge(music['title'], music['artist'], relation='performed_by')
    return G

# 示例调用
knowledge_graph = build_knowledge_graph(music_dataset)
为了评估音乐推荐系统的性能,需要选择合适的评价指标。常用的评价指标包括准确率、召回率、F1-score、均方根误差和覆盖率等。准确率和召回率用于衡量推荐结果的相关性和全面性。可视化不仅可以帮助用户更直观地看到推荐结果,还能有效展示推荐系统的性能评估指标。通过绘制推荐结果的分布图、用户偏好的变化趋势图以及系统性能指标的对比图,可以增强用户的参与感和信任感。
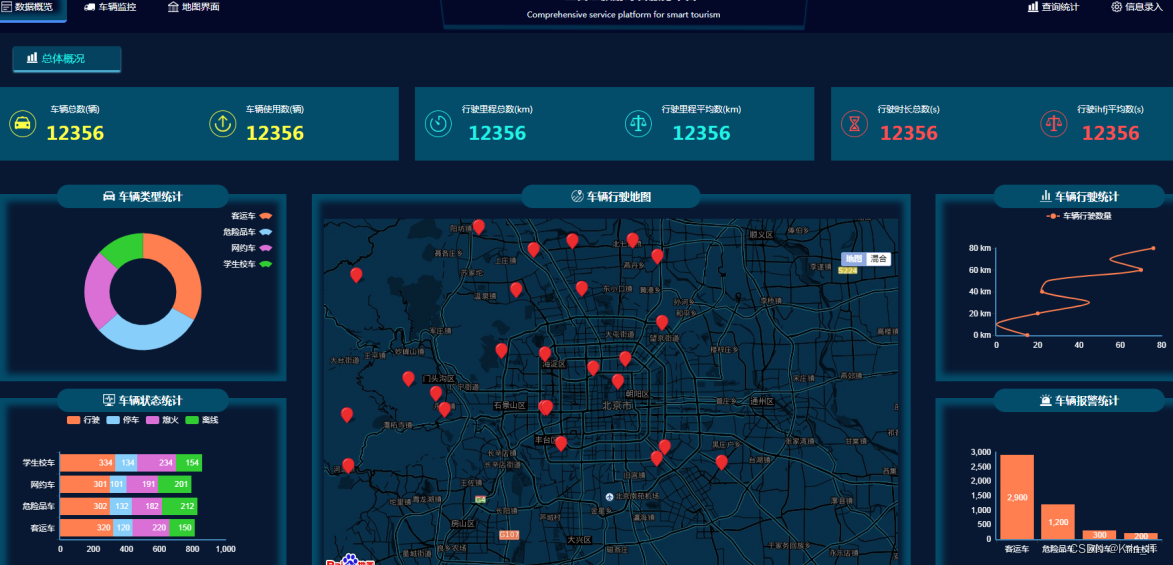
实现效果图样例:


创作不易,欢迎点赞、关注、收藏。
毕设帮助,疑难解答,欢迎打扰!
最后

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献21条内容

所有评论(0)