蓝桥杯之BFS&DFS
搜索算法一共有两种:DFS和BFS。
一、BFS
BFS:
BFS即Breadth First Search,广度优先搜索。简单理解就是在每一个岔路口都要往前走一步。
下面是一个《算法图解》的例子。
假设你经营着一个芒果农场。需要寻找芒果销售商,以便将芒果卖给他。在Fackbook,你与芒果销售商有联系吗?为此,你可以在朋友中查找。

如果使用BFS的算法思想来进行查找。
首先,创建一个朋友名单。

然后,依次检查名单的每个人,看看他是否是芒果销售商。
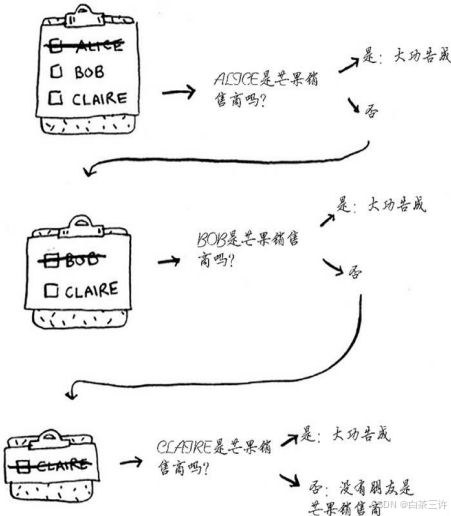
假设你没有朋友是芒果销售商,那么你就必须在朋友的朋友中查找。
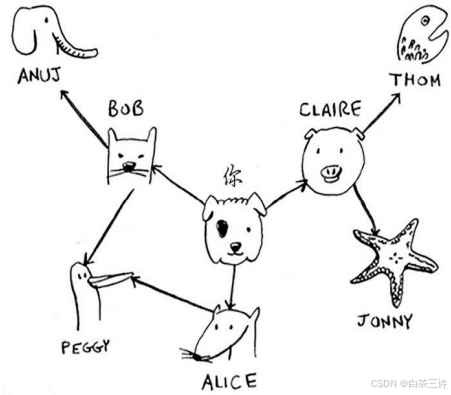
检查名单中的每个人,你都将其朋友加入名单。
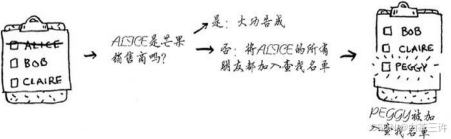
这样一来,你不仅在朋友中查找,还在朋友的朋友中查找。别忘了,你的目标是在你的人际关系网中找到一位芒果销售商。因此,如果Alice不是芒果销售商,就将其朋友也加入名单中。这就意味着你将在她的朋友、朋友的朋友等中查找。使用这种算法将搜遍你的整个人际关系网,直到找到芒果销售商。这就是广度优先搜索算法。
graph = {
    "You": ["Bob", "Claire", "Alice"],
    "Bob": ["Anuj", "Peggy"],
    "Claire": ["Thom", "Jonny"],
    "Peggy": [],
    "Anuj": [],
    "Thom": [],
    "Jonny": [],
    "Alice": ["Peggy"]
}

def bfs(graph, start):
    # 创建一个名单 用于存储已经被访问过的朋友
    visited = set()

    # 创建一个列表 用于存储按顺序访问的朋友
    result = [start]

    # 创建一个队列 将起始节点加入队列中
    queue = [start]

    # 遍历队列 当队列为空时结束循环
    while queue:
        # 获取队列中的队头元素
        person = queue.pop(0)

        # 获取队头元素的朋友关系网
        friends = graph[person]

        # 遍历当前元素的关系网
        for friend in friends:
            # 如果当前朋友并未被访问过
            if friend not in visited:
                # 将当前朋友加入已访问集合中 表示已访问
                visited.add(friend)
                # 把当前朋友加入result列表中,表示访问的顺序
                result.append(friend)
                # 如果当前朋友不是芒果销售商 则将当前朋友加入队列中 以便遍历他的关系网
                # 这里少了一步判断 因为我并没有给每个元素设置它们的职业
                queue.append(friend)

    return result


res = bfs(graph, "You")
print("-->".join(res))
1、迷宫问题
链接:迷宫问题
【问题描述】
给你一个 m x n 的迷宫矩阵 maze (下标从 0 开始),矩阵中有空格子(用 ‘.’ 表示)和墙(用 ‘+’ 表示)。同时给你迷宫的入口 entrance ,用 entrance = [entrancerow, entrancecol] 表示你一开始所在格子的行和列。
每一步操作,你可以往 上,下,左 或者 右 移动一个格子。你不能进入墙所在的格子,你也不能离开迷宫。你的目标是找到离 entrance 最近 的出口。出口 的含义是 maze 边界 上的 空格子。entrance 格子 不算 出口。
请你返回从 entrance 到最近出口的最短路径的 步数 ,如果不存在这样的路径,请你返回 -1 。
def bfs(maze, entrance):
    """
    使用BFS解决里入口最近的出口问题
    :param maze:迷宫矩阵
    :param entrance:入口坐标
    :return:
    """
    # 定义一个方法 用于判断当前坐标是否满足为空格子并且在迷宫中
    def is_exit(x, y):
        return 0 <= x < rows and 0 <= y < cols and maze[x][y] == "."

    # 获取列长以及行款
    rows, cols = len(maze), len(maze[0])

    # 确定往左、上、右、下的坐标变化
    dx = [0, -1, 0, 1]
    dy = [-1, 0, 1, 0]

    # 创建队列 并将入口坐标以及步数放进队列
    queue = [(entrance[0], entrance[1], 0)]
    # 将入口坐标标记为已访问
    maze[entrance[0]][entrance[1]] = "+"

    # 开始BFS搜索遍历
    while queue:
        # 取出队头元素
        current = queue.pop(0)

        # 遍历队头元素的左、上、右、下格子
        for k in range(len(dx)):
            # 获取队头元素左、上、右、下格子的坐标
            new_x = current[0] + dx[k]
            new_y = current[1] + dy[k]
            # 如果当前遍历的格子满足是空格子并且在迷宫中的条件
            if is_exit(new_x, new_y):
                # 判断当前格子是否在边界 如果在边界说明为出口 直接返回步长
                if new_x == 0 or new_x == rows-1 or new_y == 0 or new_y == cols-1:
                    return current[2] + 1
                # 如果不满足在边界的条件 则将当前格子加入队列并设置为已访问
                maze[new_x][new_y] = "+"
                queue.append((new_x, new_y, current[2] + 1))
    # 如果遍历了所有空格子都没有找到出口 则直接返回-1
    return -1


maze = [
    ["+","+",".","+"],
    [".",".",".","+"],
    ["+","+","+","."]
]
entrance = [1,2]
print(bfs(maze, entrance))
2、状态搜索问题
状态搜索问题通常是在一个状态空间中寻找从初始状态到目标状态的某种最优解(如最短路径、最少操作次数等)。在这种问题中,状态可以是各种形式,比如棋盘的布局、拼图的排列、节点的组合等,搜索过程就是通过一系列合法的操作,从一个状态转移到另一个状态,直到目标状态或者确定无法达到目标状态。
状态搜索问题常用的搜索算法有广度优先遍历(BFS)以及深度优先遍历(DFS),其中BFS更适合用于寻找最短路径或最少操作次数的问题,因为它是按层次遍历状态空间的,一旦找到目标状态,当前的步数就是最短的。而DFS则更适合用于寻找所有可能的解或者判断是否存在解。
下面,我们通过一个滑动拼图的问题,来深度的学习一下BFS在求解最少操作次数问题中的使用。
【问题描述】
在一个 2 × 3 的板上(board)有5块砖瓦,用数字 1~5 来表示,以及一块空缺用 0 来表示。一次移动定义为选择 0 与一个相邻的数字(上下左右)进行交换。最终当板 board 的结果是[[1, 2, 3], [4, 5, 0]] 密板被解开。给出一个谜板的初始状态,返回最少可以通过多少次移动来解开谜板,如果不能解开谜板,则返回-1。
【解题思路】
我们先将二维的拼图布局转换为一个字符串,例如 [[1, 2, 3], [4, 0, 5]] 可以表示为 “123405”。这样比较方便存储和交换。
通过找到数字0的位置,然后将其与相邻的数字进行交换,得到新的状态。
使用BFS从初始状态开始,逐层扩展状态,直到找到目标状态或者队列为空。
输入:board = [[1,2,3],[4,0,5]]
输出:1
解释:交换 0 和 5 ,1 步完成
Python代码实现如下:
from collections import deque

def bfs(board):
    # 定义目标状态
    target = "123450"
    # 定义一个空字符串 用于进行二维数组转成字符串的操作
    start = ""
    # 将二维数组转换为字符串
    for rows in board:
        for num in rows:
            start += str(num)

    # 判断当前字符串是否包含"0" 维持算法的健壮性
    if "0" not in start:
        return -1

    # 定义一个集合 记录已经访问过的状态
    visited = set()
    # 定义上、下、左、右四个方向的坐标变化
    directions = [(-1, 0), (1, 0), (0, -1), (0, 1)]
    # 申请一个双端队列
    queue = deque()
    # 向队列中添加元素(当前字符串状态,"0"字符的索引,移动次数)的数据形式
    queue.append((start, start.index('0'), 0))

    # 开始进行BFS广度优先搜索
    while queue:
        # 取出队头元素
        state, index, step = queue.popleft()
        # 如果当前状态等于目标状态 则直接返回移动的次数
        if state == target:
            return step
        # 将一维索引转为二维索引
        x, y = index // 3, index % 3
        # 遍历当前"0"的上、下、左、右四个方向的字符
        for dx, dy in directions:
            new_x, new_y = x + dx, y + dy
            # 判断是否超出边界
            if 0 <= new_x < len(board) and 0 <= new_y < len(board[0]):
                # 计算新的字符0的索引
                new_0_index = new_x * 3 + new_y
                # 将字符串转换为列表进行交换操作
                state_list = list(state)
                # 进行交换操作
                state_list[index], state_list[new_0_index] = state_list[new_0_index], state_list[index]
                # 再将列表转换为字符串进行下一步的遍历
                new_state = "".join(state_list)
                if new_state not in visited:
                    visited.add(new_state)
                    queue.append((new_state, new_0_index, step + 1))

    # 遍历完所有的情况都没有找出目标字符串
    return -1

# 测试数据
test_cases = [
    # 示例测试用例
    ([[1, 2, 3], [4, 0, 5]], 1),
    # 简单情况,初始状态已经是目标状态
    ([[1, 2, 3], [4, 5, 0]], 0),
    # 较为复杂的情况
    ([[4, 1, 2], [5, 0, 3]], 5),
    # 无法到达目标状态的情况
    ([[3, 2, 4], [1, 5, 0]], -1)
]

# 执行测试
for board, expected in test_cases:
    result = bfs(board)
    if result == expected:
        print(f"测试通过: 输入 {board}, 预期输出 {expected}, 实际输出 {result}")
    else:
        print(f"测试失败: 输入 {board}, 预期输出 {expected}, 实际输出 {result}")
二、DFS
DFS即Depth First Search,深度优先搜索。简单地理解为一条路走到黑。
例如使用DFS遍历下面的这棵二叉树。
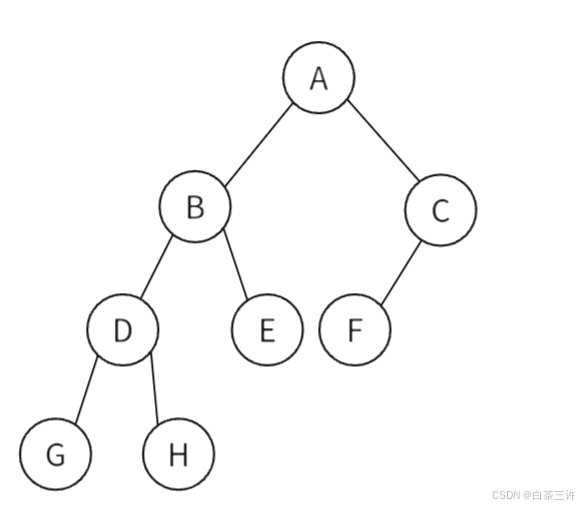
首先,访问A节点,然后访问B节点,因为DFS的思想,一条路走到黑,会继续访问B节点的子节点,也就是继续访问D节点,然后继续访问G节点。
因为G节点下面没有节点可以继续访问了,所以会回溯到D节点来访问D节点下并未被访问的节点,也就是H节点,然后继续回溯到D节点,而在D节点的子节点的中并没有未被访问的节点了,所以会继续回溯到B节点;
然后继续访问B节点的子节点中未被访问的节点,也就是E节点。E节点下没有子节点可以继续访问了,所以回溯到B节点。
B节点下的子节点已经全部被访问过了,所以继续回溯到A节点。
然后继续访问A节点下没被访问的节点C,继续深入访问C的子节点F。然后回溯到C节点,继续回溯到A节点,最后程序结束。
具体代码实现如下:
gra = {
    "A": ["B", "C"],
    "B": ["D", "E"],
    "C": ["F"],
    "D": ["G", "H"],
    "E": [],
    "F": [],
    "G": [],
    "H": []
}


def dfs(graph, start, res: list, visited=None):
    # 创建一个集合 用于存储已访问的节点
    if visited is None:
        visited = set()

    # 将访问节点添加到已访问集合中
    visited.add(start)
    res.append(start)

    for person in graph[start]:
        if person not in visited:
            # 如果当前节点并没有被访问
            # 继续往下递归
            dfs(graph, person, res, visited)
    # 如果当前节点的邻居节点被访问完了 往上进行回溯
    return res


result = dfs(gra, "A", [])

print("->".join(result))
1、排列组合问题
【问题描述】
给定一个整数n,将数字1~n排成一排,将会有很多种排列方法。
现在,请你按照字典序将所有的排列方法输出。
输入格式:
共一行,包含一个整数n
输出格式:
按字典序输出所有排列方案,每个方案占一行
数据范围:
1 <= n <= 7
输入样式:
3
输出样式:
1 2 3
1 3 2
2 1 3
2 3 1
3 1 2
3 2 1
【分析】
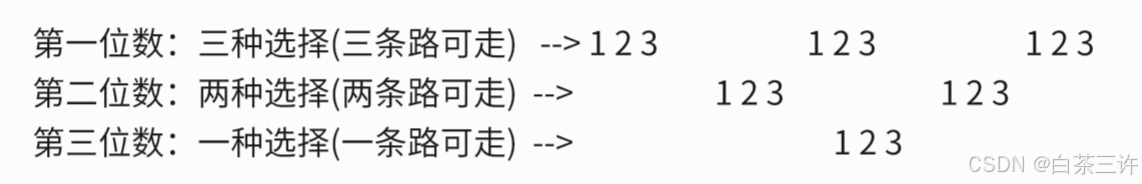
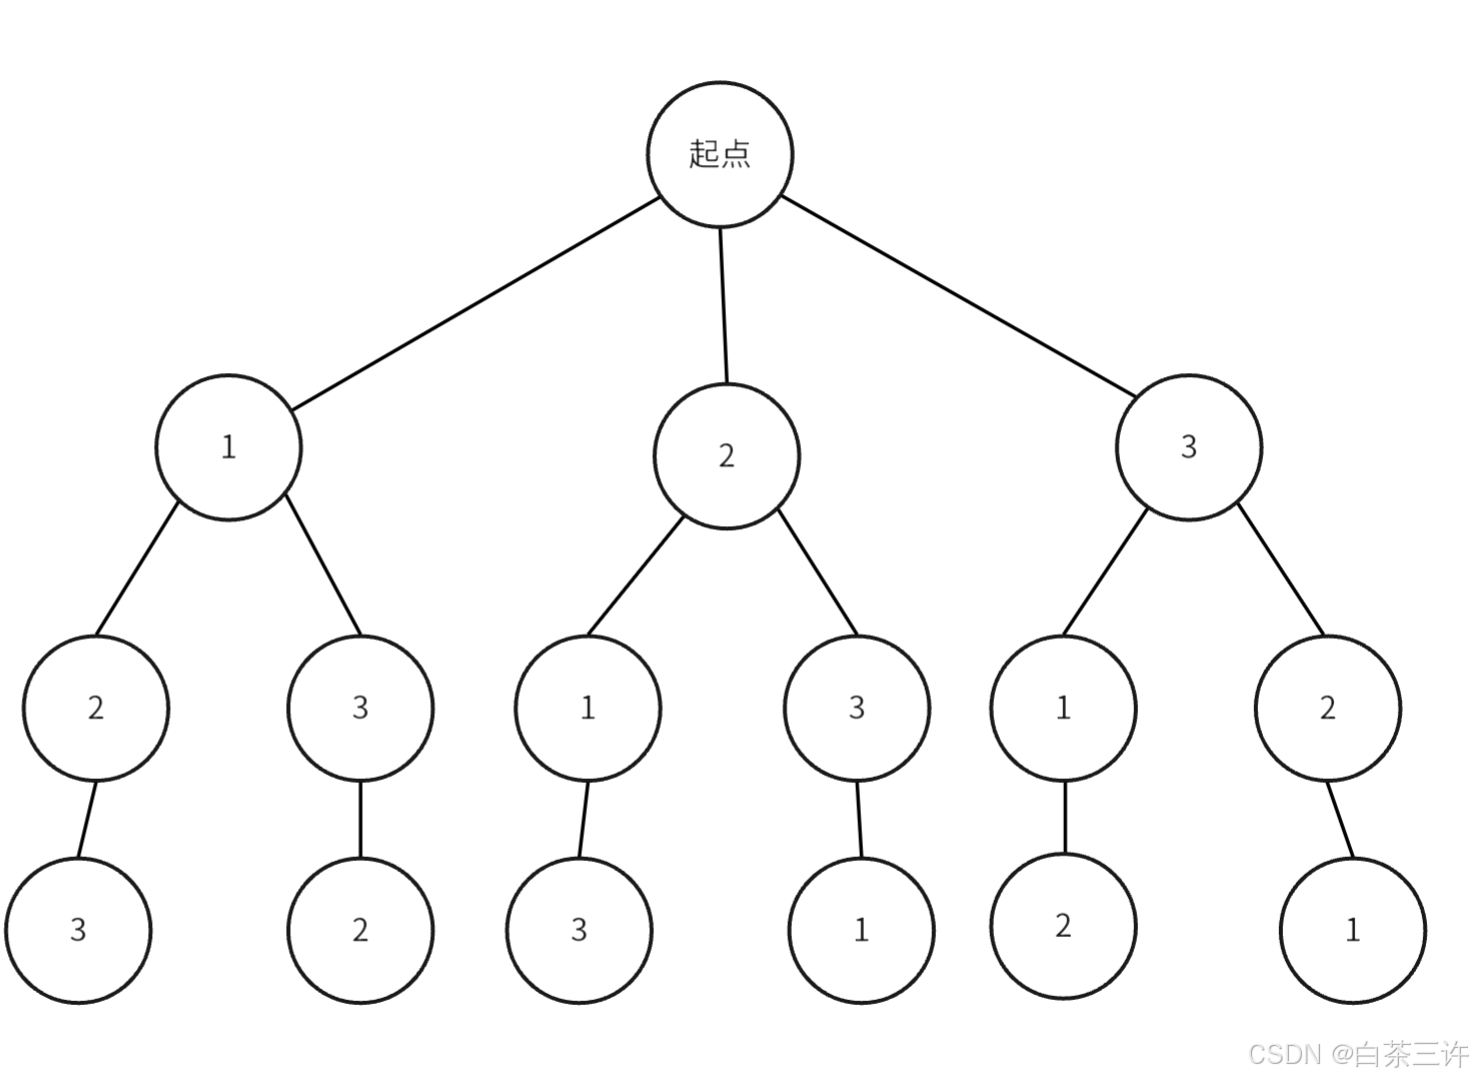
接下来,将各种选择,继续画成一棵树。
def permutation():
    # 获取用户输入
    n = int(input())
    # 创建一个列表 用于存储循环每一次的排列
    ans = []
    # 用于判断当前数字是否已经被使用
    mark = []

    # 现将所有数字标记为未使用
    mark = [False] * (n + 1)

    def dfs(index):
        # 终止条件
        # 如果排列的长度达到n 说明已经生成了一个完整的序列
        if index == n:
            # 将列表中的每个元素转换为字符串,用空格连接打印
            print(" ".join(map(str, ans)))
            return

        # 枚举当前位所填的数字的可能性
        for i in range(1, n+1):
            # 如果没有被使用过
            if not mark[i]:
                # 因为已经使用了 所以标记为已使用
                mark[i] = True
                # 将当前枚举的数字加入到结果列表中
                ans.append(i)
                # 当前位置确定后 在当前位置的基础上选择下一位(即当前这一位已经选择过了 不能再次选择)
                dfs(index + 1)
                # 当我们回溯过来之后 相当于已经列举完一次排列组合 将之前标记的数字全部改为未使用
                # 相当于吃了一次后悔药 之前的都能不算数了 需要擦除这一次的痕迹 好进行下一次的排列组合
                mark[i] = False
                # 将当前位置上的数字删除 好进行下一次的排列组合
                ans.pop()
    dfs(0)


permutation()
2、连通块问题
连通块问题最经典的问题就是岛屿问题。
【问题描述】
给定一个有‘1’(陆地)和‘0’(水)组成的二维网格,计算岛屿的数量。一个岛被水包围,并且它是通过水平或者垂直方向上的陆地连接而成的。可以假设网格的四个边均被水包围。
输入:
输入:
grid = [
[“1”,“1”,“1”,“1”,“0”],
[“1”,“1”,“0”,“1”,“0”],
[“1”,“1”,“0”,“0”,“0”],
[“0”,“0”,“0”,“0”,“0”]
]
输出:
1
Python代码实现如下:
def numIslands(grid):
    """
    用于实现记录给的图中有多少快岛屿
    :param grid: 图
    :return:
    """
    # 排除异常输入 维持算法的健壮性
    if not grid or not grid[0]:
        return
    # 获取图的行数和列数
    rows, cols = len(grid), len(grid[0])
    # 定义一个二维列表 用于记录已经被访问的网格
    # 未访问标记为False 已访问标记为True 先将图全部初始化为未访问
    mark = [[False] * cols for _ in range(rows)]

    # 定义一个变量 用于记录岛屿的个数
    count = 0

    # 定义深度优先搜索算法 开始搜索岛屿的数量
    def dfs(r, c):
        """
        用于搜索当前位置是否有岛屿
        :param r: 横坐标
        :param c: 纵坐标
        :return:
        """
        # 判断当前位置是否越界 是否为水 是否已经被访问
        if r < 0 or r >= rows or c < 0 or c >= cols or grid[r][c] == "0" or mark[r][c] == True:
            return

        # 先标记当前位置已经被访问
        mark[r][c] = True
        # 向四个方向进行深度搜索
        dfs(r + 1, c)
        dfs(r - 1, c)
        dfs(r, c + 1)
        dfs(r, c - 1)

    # 遍历地图
    for r in range(rows):
        for c in range(cols):
            if grid[r][c] == "1" and not mark[r][c]:
                # 如果当前坐标为一个岛屿 并且未被访问过
                # 进行深度搜索并增加岛屿数量

                # 当越界、为水、已被访问时进行回溯 说明当前一大片岛屿组成的一整个岛屿已经被访问完了
                # 只有中间有水的 新出现的岛屿才会被count记录
                dfs(r, c)
                count += 1
    return count


# 测试代码
grid = [
    ["1", "1", "1", "1", "0"],
    ["1", "1", "0", "1", "0"],
    ["1", "1", "0", "0", "0"],
    ["0", "0", "0", "0", "0"]
]
print(numIslands(grid))

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献1条内容

所有评论(0)