机器学习校招面经二
·
快手 机器学习算法
一、冷启动的目的
冷启动问题是推荐系统中一个重要的挑战,主要出现在以下三种场景中:新用户、新物品或新系统上线时。冷启动的目的是解决这些场景下的数据稀疏性和缺乏历史信息的问题,从而提升用户体验和系统性能。
1.1. 新用户冷启动
- 目的: 当新用户加入系统时,由于缺乏该用户的交互数据(如浏览、购买、评分等),推荐系统难以准确了解其偏好。冷启动的目的是通过其他可用信息(如用户注册时填写的个人信息、社交网络数据、人口统计学特征等)快速构建用户画像,提供个性化的推荐。
- 方法: 可以采用基于规则的推荐、协同过滤中的基于群体的推荐(利用相似用户的历史行为)或者结合内容特征的推荐。
1.2. 新物品冷启动
- 目的: 当新物品被引入到推荐系统中时,由于没有用户与该物品的交互记录,系统无法评估其受欢迎程度或匹配潜在用户。冷启动的目的是通过物品的内容特征(如标题、描述、类别、标签等)或与已有物品的相似性来推广新物品,增加其曝光率。
- 方法: 常用的方法包括基于内容的推荐、混合推荐策略以及利用物品的元数据进行关联分析。
1.3. 新系统冷启动
- 目的: 当一个新的推荐系统上线时,系统可能没有任何用户或物品的历史数据。冷启动的目的是在没有先验知识的情况下,快速积累数据并建立有效的推荐模型。这通常需要设计激励机制鼓励用户参与互动,或者迁移已有系统的数据(如果适用)。
- 方法: 包括使用通用的热门物品推荐、随机探索策略、A/B测试以及跨域推荐技术。
二、LGB Rank 和 Classification 的区别
LightGBM(LGB)是一个高效的梯度提升框架,支持多种任务类型,包括排名(Rank)、分类(Classification)、回归(Regression)。尽管三者都基于决策树模型,但它们在目标、损失函数以及应用场景上存在显著差异。以下是 LGB Rank 和 Classification 的主要区别:
2.1. 任务目标
LGB Rank
- 目的: 解决排序问题,优化项目的排列顺序。
- 应用场景: 常用于信息检索、搜索引擎、推荐系统等场景,例如为用户推荐最相关的内容或商品。
- 目标: 最大化相关性排序的准确性,确保高相关性的项目排在前面。
Classification
- 目的: 对样本进行类别预测。
- 应用场景: 常用于二分类或多分类任务,例如垃圾邮件检测、疾病诊断、图像分类等。
- 目标: 准确预测每个样本所属的类别。
2.2. 损失函数
LGB Rank
- 使用与排序相关的损失函数,例如:
- LambdaRank: 基于成对排序的思想,直接优化排序指标(如 NDCG 或 MAP)。
- Approximate-RRank: 通过近似方法计算排序目标。
- 损失函数关注的是项目之间的相对顺序,而非绝对评分值。
Classification
- 使用与分类相关的损失函数,例如:
- Log Loss(交叉熵损失):用于二分类或多分类任务。
- Softmax Loss:用于多分类任务。
- 损失函数关注的是预测概率分布与真实标签之间的差异。
2.3. 评估指标
LGB Rank
- 使用与排序相关的评估指标,例如:
- NDCG(Normalized Discounted Cumulative Gain)
- MAP(Mean Average Precision)
- Precision@K
这些指标衡量的是排序结果的质量。
Classification
- 使用与分类相关的评估指标,例如:
- Accuracy(准确率)
- F1-Score
- AUC(Area Under the ROC Curve)
- Log Loss
这些指标衡量的是分类结果的正确性。
2.4. 模型输出
LGB Rank
- 输出是每个样本的排序分数(score),表示该样本在排序中的优先级。分数本身没有明确的概率意义,主要用于比较不同样本的相对顺序。
Classification
- 输出是每个类别的预测概率或直接的类别标签。对于二分类任务,通常输出正类的概率;对于多分类任务,输出每个类别的概率分布。
2.5. 总结
| 特性 | LGB Rank | Classification |
|---|---|---|
| 任务目标 | 排序 | 分类 |
| 损失函数 | LambdaRank, Approx-RRank | Log Loss, Softmax Loss |
| 评估指标 | NDCG, MAP, Precision@K | Accuracy, F1-Score, AUC |
| 模型输出 | 排序分数 | 类别概率或标签 |
选择使用 LGB Rank 或 Classification 应根据具体的应用场景和任务需求来决定。如果目标是优化排序结果,则应选择 LGB Rank;如果目标是对样本进行分类,则应选择 Classification。
三、Stacking的核心思想?
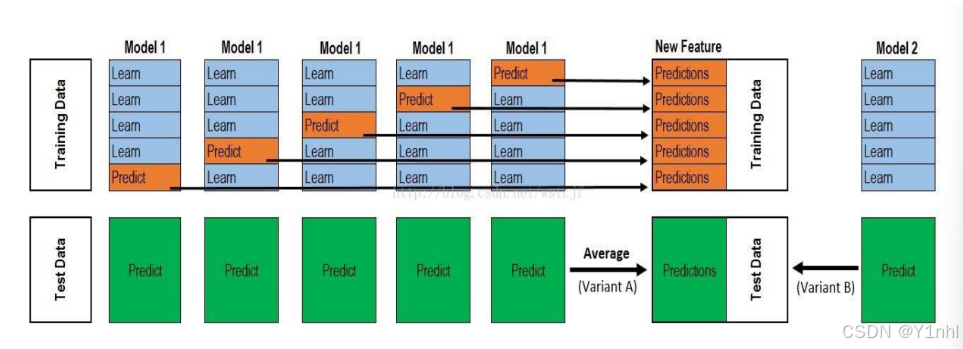
Stacking(堆叠)是一种集成学习方法,通过结合多个模型的预测结果来构建一个更强大的模型。其核心思想是利用层次化建模的方式,将不同模型的预测结果作为新特征输入到更高层的模型中,从而提升整体预测性能。
3.1. 分层结构
Stacking 的关键在于构建一个多层模型结构:
- 第一层(Base Models): 使用多种不同的基础模型(如线性回归、决策树、SVM 等)对数据进行训练,并生成预测结果。
- 第二层(Meta Model): 将第一层模型的预测结果作为特征,训练一个元模型(Meta Model),用于整合第一层模型的输出并生成最终预测。
3.2. 核心思想
四、322.零钱兑换(力扣hot100_动态规划_中等)
class Solution:
    def coinChange(self, coins: List[int], amount: int) -> int:
        @cache  # 回溯的题,都需要加上一个cache
        def dfs(i: int, c: int) -> int:
            if i < 0:
                return 0 if c == 0 else inf
            if c < coins[i]:
                return dfs(i - 1, c)
            return min(dfs(i - 1, c), dfs(i, c - coins[i]) + 1)
        ans = dfs(len(coins) - 1, amount)
        return ans if ans < inf else -1
五、3. 无重复字符的最长子串(力扣hot100_滑动窗口_中等)
class Solution:
    def lengthOfLongestSubstring(self, s: str) -> int:
        dic = {}
        left = -1
        res = 0
        for right, s1 in enumerate(s):
            if s1 in dic:                     # 出现重复字符
                left = max(dic[s1], left)     # 计算当前重复字符上一个位置和字串的初始位置的最大
            dic[s1] = right
            res = max(res, right-left)
        return res

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 37
 0
- 0


 已为社区贡献22条内容

所有评论(0)