算法竞赛——图论知识全家桶
单源最短路径
单源最短路径问题(Single Source ShortestPath,SSSP问题)是说,给定一张有向图 G = ( V , E ) , V G=(V,E),V G=(V,E),V 是点集, E E E是边集, ∣ V ∣ = n , ∣ E ∣ = m |V|=n,|E|=m ∣V∣=n,∣E∣=m,节点以 [ 1 , n ] [1,n] [1,n]之间的连续整数编号, ( x , y , z ) (x,y,z) (x,y,z)描述一条从 x x x出发,到达 y y y,长度为 z z z的有向边。设 1 1 1号点为起点,求长度为 n n n 的数组 d i s t dist dist,其中 d i s t [ i ] dist[i] dist[i] 表示从起点1到节点i的最短路径的长度。
Dijkstra 算法
Dijkstra 算法的流程如下。
1.初始化
d
i
s
t
[
1
]
=
0
dist[1]=0
dist[1]=0,其余节点的
d
i
s
t
dist
dist值为正无穷大。
2.找出一个未被标记的、
d
i
s
t
[
x
]
dist[x]
dist[x] 最小的节点
x
x
x,然后标记节点
x
x
x。
3.扫描节点
x
x
x的所有出边
(
x
,
y
,
z
)
(x,y,z)
(x,y,z),若
d
i
s
t
[
y
]
>
d
i
s
t
[
x
]
+
z
dist[y] > dist[x]+z
dist[y]>dist[x]+z,则使用
d
i
s
t
[
x
]
+
z
dist[x]+ z
dist[x]+z更新
d
i
s
t
[
y
]
dist[y]
dist[y]。
4.重复上述 2~3 两个步骤,直到所有节点都被标记。
Dijkstra 算法基于贪心思想,它只适用于所有边的长度都是非负数的图。
算法正确性证明:
令
S
S
S表示 Dijkstra 算法中已经找到最短路径的节点集合
反证法:假设存在另一条更短的路径
P
′
P '
P′使得
d
′
(
u
)
<
d
(
u
)
d'(u)<d(u)
d′(u)<d(u),那么
P
′
P'
P′必然会经过某个不在
S
S
S中的节点
w
w
w(否则它应该在之前的步骤中就被选取)。由于
u
u
u是当前未在
S
S
S中但具有最小暂定距离的节点,因此
d
(
w
)
≥
d
(
u
)
d(w)≥d(u)
d(w)≥d(u),这与假设
d
′
(
u
)
<
d
(
u
)
d ' (u)<d(u)
d′(u)<d(u) 矛盾。
朴素版
时间复杂度
O
(
n
2
)
O(n^2)
O(n2)
int dijkstra()
{
    memset(dist, 0x3f, sizeof dist);
    dist[1] = 0;
    for (int i = 1; i <= n; i ++ )
    {
        int t = -1;
        for (int j = 1; j <= n; j ++ )
            if (!st[j] && (t == -1 || dist[t] > dist[j]))
                t = j;
        st[t] = true;
        for (int j = 1; j <= n; j ++ )
            dist[j] = min(dist[j], dist[t] + g[t][j]);
    }
    if (dist[n] == 0x3f3f3f3f) return -1;
    return dist[n];
}
堆优化版
时间复杂度
O
(
m
l
o
g
n
)
O(mlogn)
O(mlogn)
int dijkstra()
{
    memset(dist, 0x3f, sizeof dist);
    dist[1] = 0;
    priority_queue<PII, vector<PII>, greater<PII>> heap;
    heap.push({0, 1});
    while (heap.size())
    {
        auto t = heap.top();
        heap.pop();
        int ver = t.second, distance = t.first;
        if (st[ver]) continue;
        st[ver] = 1;
        for (int i = h[ver]; ~i; i = ne[i])
        {
            int j = e[i];
            if (dist[j] > dist[ver] + w[i])
            {
                dist[j] = dist[ver] + w[i];
                heap.push({dist[j], j});
            }
        }
    }
    if (dist[n] == 0x3f3f3f3f) return -1;
    return dist[n];
}
Bellman-Ford 算法和 SPFA算法
给定一张有向图,若对于图中的某一条边
(
x
,
y
,
z
)
(x,y,z)
(x,y,z),有
d
i
s
t
[
y
]
≤
d
i
s
t
[
x
]
+
z
dist[y] ≤ dist[x]+z
dist[y]≤dist[x]+z成立,则称该边满足三角形不等式。若所有边都满足三角形不等式,则
d
i
s
t
dist
dist数组就是所求最短路。
我们先介绍基于迭代思想的Bellman-Ford算法。它的流程如下。
1.扫描所有边
(
x
,
y
,
z
)
(x,y,z)
(x,y,z),若
d
i
s
t
[
y
]
>
d
i
s
t
[
x
]
+
z
dist[y] > dist[x] + z
dist[y]>dist[x]+z,则用
d
i
s
t
[
x
]
+
z
dist[x] +z
dist[x]+z更新
d
i
s
t
[
y
]
dist[y]
dist[y]。
2.重复上述步骤,直到没有更新操作发生。Bellman-Ford算法的时间复杂度为
O
(
n
m
)
O(nm)
O(nm)。
int bellman_ford()
{
    memset(dist, 0x3f, sizeof dist);
    dist[1] = 0;
    for (int i = 1; i <= k; i ++ )
    {
        memcpy(backup, dist, sizeof dist);
        for (int j = 1; j <= m; j ++ )
        {
            int a = edges[j].a, b = edges[j].b, c = edges[j].c;
            dist[b] = min(dist[b], backup[a] + c);
        }
    }
    if (dist[n] > 0x3f3f3f3f / 2) return 0x3f3f3f3f;
    return dist[n];
}
SPFA 算法的流程如下。
1.建立一个队列,最初队列中只含有起点1。
2.取出队头节点 x,扫描它的所有出边
(
x
,
y
,
z
)
(x,y,z)
(x,y,z),若
d
i
s
t
[
y
]
>
d
i
s
t
[
x
]
+
z
dist[y] > dist[x]+z
dist[y]>dist[x]+z,则使用
d
i
s
t
[
x
]
+
z
dist[x] +z
dist[x]+z更新
d
i
s
t
[
y
]
dist[y]
dist[y]。同时,若
y
y
y不在队列中,则把y入队。
3.重复上述步骤,直到队列为空。
SPFA在随机图上运行效率为
O
(
k
m
)
O(km)
O(km)级别,其中
k
k
k是一个较小的常数。但在特殊构造的图上,该算法很可能退化为
O
(
n
m
)
O(nm)
O(nm),必须谨慎使用。
算法正确性证明:
因为SPFA是Bellman-Ford的优化,所以我们只需要证明Bellman-Ford的正确性。
最外层执行到第
k
k
k层,相当于我们考虑在路径边数不超过
k
k
k的情况下到达每个点的最短距离,因为
d
i
s
t
[
j
]
=
m
i
n
(
d
i
s
t
[
j
]
,
d
i
s
t
[
t
]
+
w
[
i
]
)
dist[j] = min (dist[j], dist[t] + w[i])
dist[j]=min(dist[j],dist[t]+w[i])相当于在边数为
k
k
k的路径和通过边数不超过
k
−
1
k-1
k−1的路径中选择到达
j
j
j的距离最小值。所以如果图中不存在负权回路,
n
−
1
n-1
n−1次循环就一定可以找到起点到各个点的最短距离。
int spfa(int start)
{
    memset(dist, 0x3f, sizeof dist);
    dist[start] = 0;
    int hh = 0, tt = 1;
    q[0] = start;
    while (hh != tt)
    {
        int t = q[hh ++ ];
        st[t] = 0;
        if (hh == N) hh = 0;
        for (int i = h[t]; ~i; i = ne[i])
        {
            int j = e[i];
            if (dist[j] > dist[t] + w[i])
            {
                dist[j] = dist[t] + w[i];
                if (!st[j])
                {
                    q[tt ++ ] = j;
                    if (tt == N) tt = 0;
                    st[j] = 1;
                }
            }
        }
    }
    return dist[n];
}
例题:图论——单源点最短路径建图方式
例题:图论——单源最短路的综合应用
例题:图论——单源最短路的扩展应用
任意两点间最短路径
为了求出图中任意两点间的最短路径,当然可以把每个点作为起点,求解N 次单源最短路径问题。不过,在任意两点间最短路问题中,图一般比较稠密。使用
f
l
o
y
d
floyd
floyd 算法可以在
O
(
N
3
)
O(N^3)
O(N3)的时间内完成求解,并且程序实现非常简单。
Floyd 算法
设
D
[
k
,
i
,
j
]
D[k,i,j]
D[k,i,j]表示“经过若干个编号不超过k的节点”从
i
i
i到
j
j
j的最短路长度。该问题可划分为两个子问题,经过编号不超过k-1的节点从i到j或者从i先到
k
k
k再到
j
j
j。于是
D
[
k
,
i
,
j
]
=
m
i
n
(
D
[
k
−
1
,
i
,
j
]
,
D
[
k
−
1
,
i
,
k
]
+
D
[
k
−
1
,
k
,
j
)
D[k,i,j]= min(D[k - 1,i,j],D[k - 1,i,k]+ D[k - 1,k,j)
D[k,i,j]=min(D[k−1,i,j],D[k−1,i,k]+D[k−1,k,j)。可以看到,
F
l
o
y
d
Floyd
Floyd 算法的本质是动态规划。
k
k
k是阶段,所以必须置于最外层循环中。
与背包问题的状态转移方程类似,
k
k
k这一维可被省略。最初,我们可以直接用
D
D
D保存邻接矩阵,然后执行动态规划的过程。当最外层循环到k时,内层有状态转移:
D
[
i
,
j
]
=
m
i
n
(
D
[
i
,
j
]
,
D
[
i
,
k
]
+
D
[
k
,
j
]
)
D[i, j] = min(D[i, j], D[i, k] + D[k,j])
D[i,j]=min(D[i,j],D[i,k]+D[k,j])最终
D
i
[
i
,
j
]
Di[i,j]
Di[i,j]就保存了
i
i
i到
j
j
j的最短路长度。
void floyd()
{
    for (int k = 1; k <= n; k ++ )
        for (int i = 1; i <= n; i ++ )
            for (int j = 1; j <= n; j ++ )
                d[i][j] = min(d[i][j], d[i][k] + d[k][j]);
    return ;

}
例题:图论——floyd算法
最小生成树
给定一张边带权的无向图 G = ( V , E ) , n = ∣ V ∣ , m = ∣ E ∣ G=(V,E),n=|V|,m=|E| G=(V,E),n=∣V∣,m=∣E∣。由 V V V中全部 n n n个顶点和 E E E中 n − 1 n-1 n−1跳变构成的无向连通子图被称为 G G G的一棵生成树。边的权重之和最小的生成树被称为无向图 G G G的最小生成树。
prim算法
prim 算法采用的是一种贪心的策略。
每次将离连通部分的最近的点和点对应的边加入的连通部分,连通部分逐渐扩大,最后将整个图连通起来,并且边长之和最小。
prim算法的贪心策略为什么是正确的?
当我们循环到某一部中,当前的连通块为图中绿色虚线内部分,离连通部分的最近的点和点对应的边如下图所示。

假设最小生成树中不包含这条边,那么为了最后保证联通,当前该点一定会通过其他路径与该连通块连起来,假设通过下图中红色路径。

红色路径中一定存在下图中橙色两个点,两点间存在一条边,因为灰色两点间边长一定不大于橙色两点间边长,否则一开始我们选择出的就不是灰色的这个点,所以我们如果把橙色两点间的边删掉,换做灰色两个点的连接,同样可以保持联通,并且一定不会得到更差的结果,也正因此肯证明prim算法贪心策略的正确性,每次将离连通部分的最近的点和点对应的边加入的连通部分。

int prim()
{
    int res = 0;
    memset(dist, 0x3f, sizeof dist);
    dist[1] = 0;
    for (int i = 1; i <= n; i ++ )
    {
        int t = -1;
        for (int j = 1; j <= n; j ++ )
        {
            if (!st[j] && (t == -1 || dist[j] < dist[t]))
                t = j;
        }
        st[t] = 1;
        res += dist[t];
        for (int j = 1; j <= n; j ++ )
            dist[j] = min(dist[j], g[t][j]);
    }
    return res;
}
kruskal算法
将所有边按照边权升序排序,枚举每条边 (a,b),如果这两个点不连通则把这条边加入最小生成树。
kruskal算法的正确性证明:
如下图所示,绿色部分分别是两个连通块,当我们枚举到某一步时,存在一条边可以联通这两个连通块。

我们假设最小生成树中不包含这一条边,那么为了保证这两个连通块最后能够联通,那么这两个点最后肯定会通过其他路径连起来,假设通过下图中红色路径相连。

在该红色路线中,一定存在橙色和蓝色点对之间的距离不小于灰色点对之间的距离,因为在我们枚举到灰色点对时,橙色点对和蓝色点对之间还没联通,并且此时我们没有选择这两条边。所以该我们把灰色点对之间的边去替换掉橙色点对或者蓝色点对一定可以得到不差于当前的答案,也正因此我们把灰色点对联通是最优的。

struct Edge{
    int a, b, c;
    bool operator < (const Edge & t) const {
        return c < t.c;
    }
}e[M];
int find(int x)
{
    return x == fa[x] ? x : fa[x] = find(fa[x]);
}
sort(e + 1, e + m + 1);
    for (int i = 1; i <= n; i ++ ) fa[i] = i;
    for (int i = 1; i <= m; i ++ )
    {
        int a = e[i].a, b = e[i].b, c = e[i].c;
        if (find(a) != find(b)) fa[fa[a]] = b;
        else res += c;
    }
例题:图论——最小生成树
例题:图论——最小生成树的扩展应用
负环
图 G G G中存在一个回路,该回路边权之和为负数,称之为负环。
spfa求负环
方法1:统计每个点入队次数, 如果某个点入队n次, 说明存在负环。
证明:一个点入队n次,即被更新了n次。一个点每次被更新时所对应最短路的边数一定是递增的,也正因此该点被更新n次那么该点对应的的最短路长度一定大于等于n,即路径上点的个数至少为n+1。根据抽屉原理,路径中至少有一个顶点出现两次, 也就是路径中存在环路。 而算法保证只有距离减少才会更新, 所以环路权值之和为负数。
方法2:统计从起点到任意顶点最短路经过的边数, 若某点对应边数
c
n
t
≥
n
cnt≥n
cnt≥n, 则也说明负环。
方法2根据抽屉原理易证。
我们一般采用方法2才求负环。
bool spfa()
{
    memset(dist, 0, sizeof dist);
    memset(cnt, 0, sizeof cnt);
    memset(st, 0, sizeof st);
    int hh = 0, tt = 0;
    for (int i = 1; i <= n; i ++ )
    {
        q[tt ++] = i;
        st[i] = 1;
    }
    while (hh != tt)
    {
        int t = q[hh ++];
        if (hh == N) hh = 0;
        st[t] = 0;
        for (int i = h[t]; ~i; i = ne[i])
        {
            int j = e[i];
            if (dist[j] > dist[t] + w[i])
            {
                dist[j] = dist[t] + w[i];
                cnt[j] = cnt[t] + 1;
                if (cnt[j] == n) return true;
                if (!st[j])
                {
                    st[j] = 1;
                    q[tt ++ ] = j;
                    if (tt == N) tt = 0;
                }
            }
        }
    }
    return false;
}
例题:图论——spfa判负环
差分约束
差分约束是一类特殊的不等式约束问题,其形式为 x i ≤ x j + c x_i \leq x_j + c xi≤xj+c,其中 x i , x j x_i, x_j xi,xj 为变量, c c c 为常数。这类问题可以通过转换为单源最短路问题来求解其可行解。
我们证明一个差分约束和一个最短路问题是等价的:
1.假设我们已经通过最短路算法求出了一个图中从源点 s s s 到所有节点的最短路径 d i s t [ i ] dist[i] dist[i],根据最短路的松弛性质,对于任意一条边 j → i , w j \to i, w j→i,w,都有 d i s t [ i ] ≤ d i s t [ j ] + w dist[i] \leq dist[j] + w dist[i]≤dist[j]+w,因此,最短路的解满足所有的边权约束条件。由此,一个最短路问题对应了一组差分约束问题的不等式组。
2.将差分约束 x i ≤ x j + w x_i \leq x_j + w xi≤xj+w 映射为一条从 j j j 到 i i i 的边,权值为 w w w。构造图后,通过单源最短路算法求得从某个源点到所有节点的最短距离 d i s t [ i ] dist[i] dist[i],可以证明该最短距离是满足差分约束的不等式组的一个解。
综上,一个差分约束和一个最短路问题是等价的。
1.求不等式的可行解
源点需要满足的条件:从源点出发,一定能走到所有的边。
走到所有边等价于所有条件都会被满足,如果没有走到所有边就说明存在没有被满足的条件,不允许。走到所有边不等价于走遍所有点,如果存在孤立的点则说明不存在和他相关的约束,也正因此不用去管它。
步骤:
1.先将每个不等式
x
i
≤
x
j
+
c
k
x_i\leq x_j+c_k
xi≤xj+ck转换为一条从
x
j
x_j
xj走向
x
i
x_i
xi,长度为
c
k
c_k
ck的边。
2.找一个超级源点,使得该源点一定能遍历到所有边。
3.从源点求一遍单源最短路
结果1:如果存在负环,则原不等式组一定无解。
接过2:如果没有负环,则
d
i
s
t
[
i
]
dist[i]
dist[i]就是原不等式组的一个可行解。
2.如何求最大值或最小值(每个变量的最值)
结论:如果求的是最小值,则应该求最长路,如果求的是最大值,则应该求最短路。
如果我们想要求最小值,那么一定是要去找下界的,其中一个下界对应的是一条从源点到该节点的路线,为了满足要求,我们要在所有下界中找一个最大值,也正因此我们要求最长路。求最大值同理。
以求 x i x_i xi的最大值为例:求所有从 x i x_i xi出发,构成不等式链 x i ≤ x j + c 1 ≤ x k + c 2 + c 1 ≤ . . . ≤ c 1 + c 2 + . . . x_i \leq x _j + c_1 \leq x_k+c_2+c_1 \leq ...\leq c_1+c_2+... xi≤xj+c1≤xk+c2+c1≤...≤c1+c2+...所计算出的上界,最终 x i x_i xi的最大值等于所有上界的最小值。
问题:如何转化
x
i
≤
c
x_i \leq c
xi≤c,其中c是一个常数,这类的不等式。
方法:建立一个超级源点0,然后建立
0
→
i
0\to i
0→i,长度是
c
c
c的边即可。
图论——差分约束
最近公共祖先
方法1:向上标记法
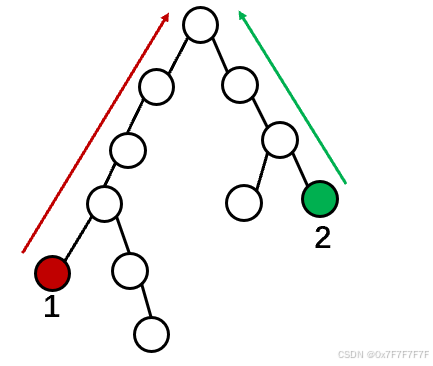
1.先从一号点往上走,走过的点都标记。
2.再从二号点往上走,走到的第一个带标记的点就是最近公共祖先。
时间复杂度:
O
(
n
)
O(n)
O(n)
方法2:倍增法
1.预处理:预处理出每个点向上走
2
k
2^k
2k步的节点的父亲是谁,用
f
[
i
]
[
j
]
f[i][j]
f[i][j] 从
i
i
i开始向上走
2
j
2^j
2j步所能走到的节点
0
<
=
j
<
=
l
o
g
n
0<=j<=logn
0<=j<=logn。
f
a
[
i
]
[
j
]
=
=
f
a
[
f
a
[
i
]
[
j
−
1
]
]
[
j
−
1
]
fa[i][j] = = fa[fa[i][j-1]][j-1]
fa[i][j]==fa[fa[i][j−1]][j−1]
同时预处理出每个点的深度
d
e
p
t
h
[
j
]
=
d
e
p
t
h
[
t
]
+
1
depth[j]=depth[t]+1
depth[j]=depth[t]+1
把
d
e
p
t
h
[
r
o
o
t
]
depth[root]
depth[root]初始化为1;把
d
e
p
t
h
[
0
]
depth[0]
depth[0]初始化为0,作为哨兵。
时间复杂度为
O
(
n
l
o
g
n
)
O(nlogn)
O(nlogn)。
2.查询:
步骤1:让节点
a
a
a和
b
b
b走到同一深度下,假设
a
a
a的深度更深,则从
a
a
a跳到
b
b
b,从
a
a
a跳
2
k
2^k
2k步后的点的深度
d
e
p
t
h
(
f
[
a
]
[
k
]
)
>
=
d
e
p
t
h
(
b
)
depth(f[a][k]) >= depth(b)
depth(f[a][k])>=depth(b)时 就可以继续跳,
k
k
k从
l
o
g
n
logn
logn到0枚举。
步骤2:让节点
a
a
a和
b
b
b在满足
f
a
[
a
]
[
k
]
!
=
f
a
[
b
]
[
k
]
fa[a][k]!=fa[b][k]
fa[a][k]!=fa[b][k]的条件下一起向上走,最后一定会停留在
l
c
a
lca
lca的下一层,最后
f
a
[
a
]
[
0
]
fa[a][0]
fa[a][0]即是答案。
时间复杂度
O
(
l
o
g
n
)
O(logn)
O(logn)
void bfs()
{
    memset(depth, 0x3f, sizeof depth);
    depth[root] = 1, depth[0] = 0;
    int hh = 0, tt = 0;
    q[0] = root;
    while (hh <= tt)
    {
        int t = q[hh ++ ];
        for (int i = h[t]; ~i; i = ne[i])
        {
            int j = e[i];
            if (depth[j] > depth[t] + 1)
            {
                depth[j] = depth[t] + 1;
                fa[j][0] = t;
                q[++ tt] = j;
                for (int k = 1; k <= 15; k ++ )
                    fa[j][k] = fa[fa[j][k - 1]][k - 1];
            }
        }
    }
}
int lca(int a, int b)
{
    if (depth[a] < depth[b]) swap(a, b);
    for (int k = 15; k >= 0; k -- )
    {
        if (depth[fa[a][k]] >= depth[b])
            a = fa[a][k];
    }
    if (a == b) return b;
    for (int k = 15; k >= 0; k -- )
    {
        if (fa[a][k] != fa[b][k])
        {
            a = fa[a][k], b = fa[a][k];
        }
    }
    return fa[a][0];
}
方法3:tarjan(离线做法)
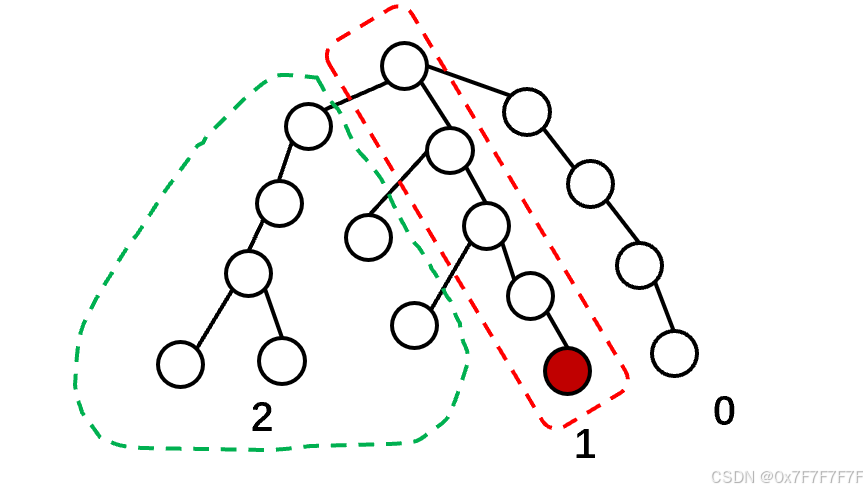
我们把所有的点分成三类:
2类节点为我们已经访问过并回溯过的
1类节点是我们正在访问的
0类节点是还没有访问到的
我们可以发现,2类节点和1类节点的 l c a lca lca一定在和这个2类节点相连的第一个1类节点上,所以我们在每一个节点回溯时,可以直接合并到它父节点的集合里,最后我们求1个1类节点和2类节点的 l c a lca lca时可以直接返回这个2类节点的集合编号。
我们提前存储每一次的查询,在我们搜索到某一个节点时取出和这个节点有关的所有查询,然后判断另一个节点是否是2类节点,如果是则可以直接返回他们俩的最近公共祖先。
我们对图进行了一次遍历,同时考虑了每一个查询,总共的时间复杂度是 O ( n + m ) O(n+m) O(n+m)。
void dfs(int u, int fa)
{
    for (int i = h[u]; ~i; i = ne[i])
    {
        int j = e[i];
        if (j == fa) continue;
        dist[j] = dist[u] + w[i];
        dfs(j, u);
    }
    return ;
}
void tarjan(int u, int fa)
{
    st[u] = 1;
    for (int i = h[u]; ~i; i = ne[i])
    {
        int j = e[i];
        if (j != fa)
        {
            tarjan(j, u);
            p[j] = u;
        }
    }
    for (auto i : query[u])
    {
        int y = i.first, id = i.second;
        if (st[y] == 2)
        {
            int anc = find(y);
            res[id] = dist[y] + dist[u] - 2 * dist[anc];
        }

    }
    st[u] = 2;
    return ;
}
例题:图论——最近公共祖先
有向图的强连通分量
连通分量:对于分量中任意两点u,v 必然可以从u走到v 且从v走到u
强连通分量:极大连通分量
有向图的强连通分量无非是以下两种情况:

1.绿色:存在后向边指向祖先结点
2.红色:存在横插边指向的点有指向这两个点公共祖先节点
tarjan算法求强连通分量模板
void tarjan(int u)
{
	//dfn[u]dfs遍历到u的时间(如上图中的数字)
	//low[u]从u开始走所能遍历到的最小时间戳
    dfn[u] = low[u] = ++ timestamp; //打时间戳
    stk[++ top] = u; //入栈
    in_stk[u] = 1; //标记当前节点在栈中
    for (int i = h[u]; ~i; i = ne[i])
    {
        int j = e[i];
        if (!dfn[j]) //1.如果子节点未访问
        {
            tarjan(j);
            low[u] = min(low[u], low[j]);
        }
        else if (in_stk[j]) //2.访问过且在栈中
        {
            low[u] = min(low[u], dfn[j]);
        }
        //3.如果访问过且不在栈中说明已经确定了强连通分量归属,这里不在考虑
    }
    if (dfn[u] == low[u]) //说明是某个强连通分量中编号最小的点
    {
        int y;
        ++ scc_cnt;
        do{
            y = stk[top -- ];
            in_stk[y] = 0;
            id[y] = scc_cnt;
            scc_size[scc_cnt] ++ ;
        }while (y != u);
    }
}
从实际应用的角度来说,我们在求完强连通分量之后会进行缩点的操作。
for i=1;i<=n;i++
 for i的所有邻点j
   if i和j不在同一scc中:
    加一条新边id[i]→id[j]
缩点之后,该图就变成了有向无环图(拓扑图)了,这样处理起来就会很方便。
无向图的双连通分量
无向图的割点与桥
给定无向图
G
=
(
V
,
E
)
G=(V,E)
G=(V,E):
若对于
x
∈
V
x\in V
x∈V,从图中删去节点
x
x
x以及所有与
x
x
x关联的边后,
G
G
G分裂成两个不连通的子图,则称
x
x
x是
G
G
G的割点。
若对于
e
∈
E
e\in E
e∈E,从图中删去边
e
e
e之后,
G
G
G分裂成两个不相连的子图,则称
e
e
e为
G
G
G的桥或割边。
割边的判定
无向边
(
x
,
y
)
(x,y)
(x,y)是桥,当且仅当搜索树上存在
x
x
x的一个子节点
y
y
y,满足:
d
f
n
[
x
]
<
l
o
w
[
y
]
dfn[x]<low[y]
dfn[x]<low[y]
在无向图中不存在横插边,所以说如果满足以上条件,要么说明以
y
y
y为根的子树只存在树边,要么说明下图中存在类似于红色这样的后向边,即无法通过其他路径到达
x
x
x或以上的部分,即把
(
x
,
y
)
(x,y)
(x,y)删掉之后,
s
u
b
t
r
e
e
(
y
)
subtree(y)
subtree(y)会形成一个封闭的部分。如果不满足条件,则存在类似于绿色这样的边,即可以到达
x
x
x或之前的点。

割点的判定
若
x
x
x不是搜索树的根节点,则
x
x
x是割点当且仅当搜索树上存在
x
x
x的一个子节点
y
y
y,满足:
d
f
n
[
x
]
≤
l
o
w
[
w
]
dfn[x]\leq low[w]
dfn[x]≤low[w]
特别的,若
x
x
x是搜索树的根节点,则
x
x
x是割点当且仅当搜索树存在两个子节点
y
1
y1
y1,
y
2
y2
y2满足上面的条件。
无向图的双连通分量
若一张无向图不存在割点,则称它为"点双连通图"。若一张无向连通图不存在桥,则称它为"边双连通图"。
无向图的极大点双连通图被称为“点双连通分量”,简记为"v-DCC"。无向图的极大边双连通子图被称为“边双连通分量”,简记为"e_DCC"。两者统称为边双连通分量,简记为"DCC”。
二分图
如果一张无向图的 N N N个节点 ( N ≥ 2 ) (N\geq 2) (N≥2)可以分成 A , B A,B A,B两个非空集合,其中 A ∩ B = ∅ A\cap B =\varnothing A∩B=∅,并且在同一集合内的点都没有边相连,那么成这张无向图为一张二分图。
二分图的判定
1.一张图是二分图 等价于 2.染色法不存在矛盾 等价于 3.不存在奇数环
先证明2、3的等价性:
2
→
3
2 \to 3
2→3:假设存在奇数环,那么我们在环中每个点进行1、2、1、2…的染色,最后一定头尾颜色相同,染色法存在矛盾,假设不成立。
3
→
2
3 \to 2
3→2:假设染色法存在矛盾,那么唯一的情况就形如以下形式:

即一定存在奇数环,假设不成立。
综上,2和3等价。
再证明1和2、3等价:
1
→
3
1\to 3
1→3:假设存在奇数环,那么在二分图中一定是以下的形式:
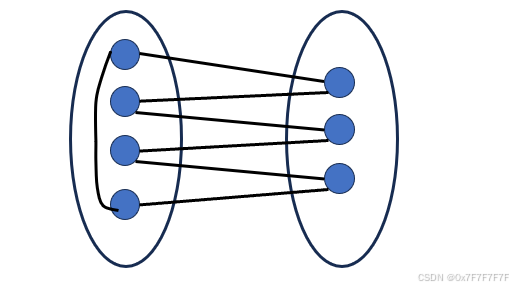
即同一集合内的点有边相连,该图不是二分图,假设不成立。
2
→
1
2\to 1
2→1:如果染色法不存在矛盾,那么我们可以把编号为1的点放在一个集合,编号为2的点放在一个集合,显然最后会构成一个二分图。
综上,以上1、2、3等价。
二分图的最大匹配
任何两条边没有公共端点的边的集合称为图的一组匹配。在二分图中,包含边数最多的一组匹配被称为二分图的最大匹配。
对于任意一组匹配
S
S
S(
S
S
S是一个边集),属于
S
S
S的边被称为"匹配边",不属于
S
S
S的边被称为"非匹配边"。匹配边的端点被称为"匹配点",其他节点被称为“非匹配点”。如果在二分图中存在一条连接两个非匹配点的路径
p
a
t
h
path
path,使得非匹配边与匹配边在
p
a
t
h
path
path上交替出现,那么称
p
a
t
h
path
path是匹配
S
S
S的增广路,也称交错路。
增广路具有以下性质:
1.长度
l
e
n
len
len是奇数。
2.路径上第
1
,
3
,
5
,
.
.
.
,
l
e
n
1,3,5,...,len
1,3,5,...,len条边是非匹配边,第
2
,
4
,
6
,
.
.
.
,
l
e
n
−
1
2,4,6,...,len-1
2,4,6,...,len−1条边是匹配边。
二分图的一组匹配
S
S
S是最大匹配,当且仅当图中不存在
S
S
S的增广路。
证明:前推后比较好推,假设存在增广路,那么我们可以把非匹配边变成匹配边,把匹配边变成非匹配边,这样匹配的边数还能比原先多1,所以假设不成立。
后推前比较困难,此处略。
我们求二分图最大匹配的算法的匈牙利算法
//match[j]=a,表示女孩j的现有配对男友是a
int match[N];
//st[]数组我称为临时预定数组,st[j]=a表示一轮模拟匹配中,女孩j被男孩a预定了。
int st[N];
//这个函数的作用是用来判断,如果加入x来参与模拟配对,会不会使匹配数增多
int find(int x)
{
    //遍历自己喜欢的女孩
    for(int i = h[x] ; i != -1 ;i = ne[i])
    {
        int j = e[i];
        if(!st[j])//如果在这一轮模拟匹配中,这个女孩尚未被预定
        {
            st[j] = true;//那x就预定这个女孩了
            //如果女孩j没有男朋友,或者她原来的男朋友能够预定其它喜欢的女孩。配对成功,更新match
            if(!match[j]||find(match[j]))
            {
                match[j] = x;
                return true;
            }
        }
    }
    //自己中意的全部都被预定了。配对失败。
    return false;
}
//记录最大匹配
int res = 0;
for(int i = 1; i <= n1 ;i ++)
{
    //因为每次模拟匹配的预定情况都是不一样的所以每轮模拟都要初始化
    memset(st,false,sizeof st);
    if(find(i))
        res++;
}
匈牙利算法的正确性基于贪心策略,对于左侧的 a a a能够和右侧的点成功匹配,我们假设不让 a a a匹配,那么最后最多只是多剩下一个右侧的点,如果右侧这个点不能再和其他左侧点匹配,那么答案总数是少了1的;假设能和其他左侧点匹配,那么最终答案总数不变,但是左侧少了一个候选点。综上,如果能匹配我们就匹配,这样一定能得到最优解。
二分图的最小点覆盖
给定一张二分图,求出一个最小的点集 S S S,使得图中任意一条边都有至少一个端点属于 S S S,这个问题被称为二分图的最小点覆盖问题。
二分图最小点覆盖包含的点数等于二分图最大匹配包含的边数。
证明:
1.二分图最小点覆盖包含的点数
≥
\geq
≥二分图最大匹配包含的边数
因为最大匹配是二分图中所有边的一个子集,并且所有边都没有公共点,也正因此至少要在每条匹配边中选择一个端点才能将所有匹配边覆盖。
2.二分图最小点覆盖包含的点数
=
=
=二分图最大匹配包含的边数
采用以下构造方法:
1.求二分图的最大匹配
2.从左侧每一个非匹配点出发寻找增广路径(一定不会成功,如果成功则说明1中求的不是最大匹配),标记每一个访问过的节点。
3.取左侧未被标记的点、右侧被标记的点,就得到了二分图的最小点覆盖。
证明该构造方法的正确性:
1.左边非匹配点一定都被标记,因为我们是从左侧每一个非匹配点出发寻找增广路径的。
2.右侧非匹配点都一定没有被标记,否则的话就得到了增广路。
3.一对匹配点要么都被标记,要么都没被标记,因为在寻找增广路的过程中,左侧点只能由右侧点到达。
在构造中,我们取了左侧未被标记的点、右侧被标记的点。根据以上讨论可以发现,恰好是每条匹配边都选取了一个点,所以选出来的点数等于最大匹配包含的边数。
再来讨论这种选法是否覆盖了所有边
1.匹配边一定被覆盖了,因为恰好有一条端点被取走了。
2.不存在连接两个非匹配点的边,否则就存在长度为1的增广路了。
3.连接左部非匹配点
i
i
i,右部匹配点
j
j
j的边也被覆盖,左部非匹配点是起点,所以说一定可以标记
j
j
j,所以
j
j
j一定被选取了,所所以这条边一定被覆盖。
4.连接左部匹配点
i
i
i,右部非匹配点
j
j
j的边也被覆盖,右部非匹配点一定没有被标记,说明没有通过
i
i
i到达,
i
i
i没有被标记,所以
i
i
i一定被选取了,所所以这条边一定被覆盖。
二分图最大独立集
给定一张无向图
G
=
(
V
,
E
)
G=(V,E)
G=(V,E),满足以下条件的点集
S
S
S被称为图的独立集。
1.
S
⊆
V
S\subseteq V
S⊆V
2.
∀
x
,
y
∈
S
,
(
x
,
y
)
∉
E
\forall x,y\in S, (x,y)\notin E
∀x,y∈S,(x,y)∈/E
即图的独立集就是任意两点之间都没有边相连的点集。包含点数最多的一个就是图的最大独立集。
对应地,任意两点之间都有一条边相连的子图被称为无向图的“团”。点数最多的团被称为图的最大团。
无向图
G
G
G的最大团等于其补图
G
′
G'
G′的最大独立集。
正确性显然。
设
G
G
G是有
n
n
n个节点的二分图,
G
G
G的最大独立集的大小等于
n
n
n减去最大匹配数。
证明:选出最多的点构成独立集
等价于 在图中去掉最少的点,使剩下的点之间没有边
等价于 用最少的点覆盖所有的边
有向无环图的最小路径点覆盖
给定一张有向无环图,要求用尽量少的不相交的简单路径,覆盖有向无环图的所有顶点(也就是各个顶点恰好被覆盖一次)。这个问题被称为有向无环图的最小路径点覆盖,简称“最小路径覆盖”。
设原先的有向无环图为 G = ( V , E ) , n = ∣ V ∣ G=(V,E),n=|V| G=(V,E),n=∣V∣。把 G G G中的每个点 x x x拆成编号为 x x x和 x + n x+n x+n的两个点。建立一张新的二分图, 1 ~ n 1~n 1~n作为二分图左部点, n + 1 ~ 2 n n+1~2n n+1~2n作为二分图右部点,对于原图的每条有向边 ( x , y ) , (x,y), (x,y),,在二分图的左部点 x x x与右部点 x + n x+n x+n之间连边。最终得到的二分图称为 G G G的拆点二分图,记为 G 2 G_2 G2。
有向无环图 G G G的最小路径点覆盖包含的路径条数,等于 n n n减去拆点二分图 G 2 G_2 G2的最大匹配数。
证明:
在有向无环图
G
=
(
V
,
E
)
G=(V,E)
G=(V,E)的最小路径覆盖中,对于任意的
x
∈
V
x∈V
x∈V,因为路径不相交,所以
x
x
x的入度和出度都不超过
1
1
1。因为每个节点都被覆盖,所以x的入度和出度至少有一个是
1
1
1。
因此,最小路径覆盖中的所有边,在拆点二分图
G
2
G_2
G2中构成一组匹配。最小路径覆盖中每条边
(
x
,
y
)
(x,y)
(x,y)的起点
x
x
x与二分图每条匹配边
(
x
,
y
+
n
)
(x,y+n)
(x,y+n) 的左部点
x
x
x 是一一对应的。
特别地,对于每条路径的终点
t
t
t,因为
t
t
t没有出边,所以在二分图中,
t
t
t匹配失败。即路径的终点和二分图左部的非匹配点是一一对应的。
路径覆盖包含的路径条数最少
路径的终点数(出度为0的点数)最少二分图左部非匹配点最少
故
G
G
G 的最小路径覆盖的路径数等于n减去拆点二分图
G
2
G_2
G2的最大匹配数。证毕。
给定一张有向无环图,要求用尽量少的可相交的简单路径,覆盖有向无环图的所有顶点(也就是一个节点可以被覆盖多次)。这个问题被称为有向无环图的最小路径可重复点覆盖。
在最小路径可重复点覆盖中,若两条路径
…
→
u
→
p
→
v
→
.
…→u→p→v→.
…→u→p→v→.和
.
→
x
→
p
→
y
→
…
.→x→p→ y→ …
.→x→p→y→… 在点
p
p
p相交,则我们在原图中添加一条边
(
x
,
y
)
(x,y)
(x,y),让第二条路径直接走
x
→
y
x→y
x→y,就可以避免重复覆盖点
p
p
p。
进一步地,如果我们把原图中所有间接连通的点对
x
,
y
x,y
x,y直接连上有向边
(
x
,
y
)
(x,y)
(x,y),那么任何“有路径相交的点覆盖”一定都能转化成“没有路径相交的点覆盖”。
综上所述,有向无环图
G
G
G的最小路径可重复点覆盖,等价于先对有向图传递闭包,得到有向无环图
G
′
G'
G′,再在
G
′
G'
G′上求一般的(路径不可相交的)最小路径点覆盖。
例题:图论——二分图
欧拉回路与欧拉路径
给定一张无向图,若存在一条从节点
S
S
S到节点
T
T
T的路径,恰好不重不漏地经过每条边一次(可以重复经过图中的节点),则称该路径为
S
S
S到
T
T
T的欧拉路。
特别地,若存在一条从节点
S
S
S出发地路径,恰好不重不漏地经过每条边一次(可以重复经过图中的节点),最终回到起点
S
S
S,则称该路径为欧拉回路,存在欧拉回路的无向图被称为欧拉图。
一、无向图
1 存在欧拉路径的充要条件 : 度数为奇数的点只能有0或2个
2 存在欧拉回路的充要条件 : 度数为奇数的点只能有0个
二、有向图
1 存在欧拉路径的充要条件 : 要么所有点的出度均=入度;要么除了两个点之外,其余所有点的出度=入度 剩余的两个点:一个满足出度-入度=1(起点) 一个满足入度-出度=1(终点)
2 存在欧拉回路的充要条件 : 所有点的出度均等于入度
拓扑排序
对一个有向无环图 G G G进行拓扑排序,是将 G G G中所有顶点排成一个线性序列,使得图中任意一对顶点 u u u和 v v v,若边 < u , v > ∈ E ( G ) <u,v>∈E(G) <u,v>∈E(G),则 u u u在线性序列中出现在v之前。通常,这样的线性序列称为满足拓扑次序(Topological Order)的序列,简称拓扑序列。简单的说,由某个集合上的一个偏序得到该集合上的一个全序,这个操作称之为拓扑排序。
void toposort()
{
    int hh = 0, tt = -1;
    for (int i = 1; i <= n; i ++ )
        if (!d[i]) q[++ tt] = i;
    while (hh <= tt)
    {
        int t = q[hh ++ ];
        for (int i = h[t]; ~i; i = ne[i])
        {
            int j = e[i];
            if ((-- d[j]) == 0)
                q[++ tt] = j;
        }
    }
    return ;
}
例题:图论——拓扑排序

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 36
 0
- 0


 已为社区贡献9条内容

所有评论(0)