【论文笔记】基于相关性解耦的知识蒸馏在多模态情感分析中的应用
1.背景
本文解决多模态情感分析任务中模态缺失的问题。在现实世界的应用中,由于背景噪声、传感器限制和隐私问题等因素,模态数据往往不完整,这会严重影响基于完整模态训练的模型的性能。例如,当某些模态完全缺失或部分帧级特征丢失时,模型可能会做出错误的情感预测。尽管已有研究尝试解决模态缺失问题,但现有方法仍存在以下局限性:
1.缺乏样本间整体语义的挖掘:仅基于单个样本的交互,无法充分利用样本间的结构化语义信息。
2.未能建模跨类别相关性:导致情感相关信息丢失,类别分布混淆。
3.监督信号粗糙:忽略了语义和分布对齐的潜在需求。
为了解决上述问题,本文提出了一种名为Correlation-decoupled Knowledge Distillation (CorrKD) 的框架,专门用于处理不确定模态缺失情况下的多模态情感分析任务。CorrKD框架的贡献主要体现在以下三个方面:
1. 样本级对比蒸馏机制:通过样本级对比学习,捕捉跨样本的相关性,并将这些有价值的监督信号传递给学生网络,从而更准确地重建缺失的语义信息。
2.类别引导的原型蒸馏机制:利用类别原型捕捉跨类别的相关性,通过建模类别内和类别间的特征变化,传递情感相关信息,生成更鲁棒的联合多模态表示。
3.响应解耦的一致性蒸馏策略:通过解耦模型响应中的目标类别响应和非目标类别响应,优化情感决策边界,并通过最大化互信息鼓励分布对齐。
2.模型
2.1总体框架
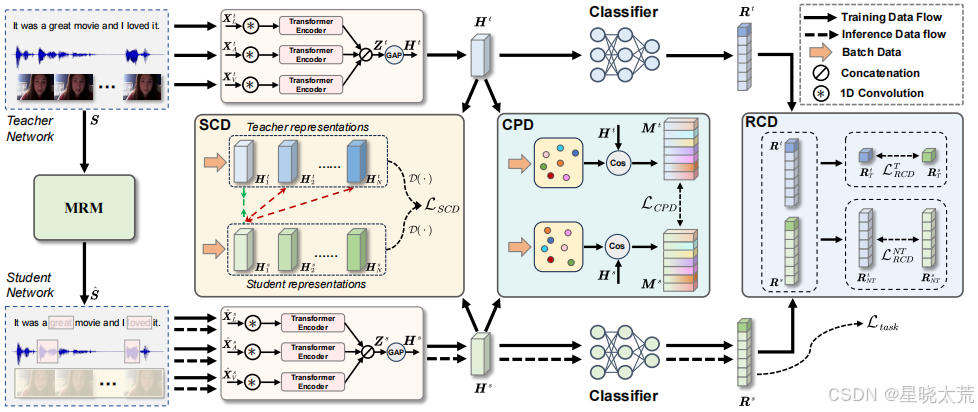
本文提出的CorrKD框架总体上是一个基于知识蒸馏的多模态情感分析模型,专门用于处理不确定模态缺失的情况。框架的核心在于通过教师网络和学生网络的协作,利用三种机制(样本级对比蒸馏、类别引导的原型蒸馏和响应解耦的一致性蒸馏)来捕捉和传递跨样本、跨类别以及跨响应的相关性,从而增强学生网络对缺失模态的重建能力和情感分析的鲁棒性。具体来说,教师网络首先在完整模态数据上进行训练并固定参数,然后通过随机生成的缺失模态样本,将丰富的语义知识从教师网络传递到学生网络,最终使学生网络能够在缺失模态的情况下准确地进行情感分析。
2.2模态的融合
以学生网络为例,首先三种不完整模态的(其中
)输入学生网络。首先,
通过一个核大小为 3×3 的一维时间卷积层,并加上位置嵌入以获得初步表示,记作
。
每个 被输入到一个Transformer编码器
中,通过自注意力机制捕捉每个序列的模态动态,以产生表示
,表示为
。将表示
连接起来以获得
,表示为
。随后,将
输入到全局平均池化中以进一步增强和提炼特征,得到联合多模态表示
。类似地,教师网络生成的联合多模态表示表示为
。
2.3样本级对比蒸馏
在CorrKD框架中,样本级对比蒸馏( SCD)的核心目标是通过对比学习,让学生网络能够从教师网络中学习到跨样本的相关性,从而更好地重建缺失模态下的语义信息.。核心思想是:对于同一个输入样本,教师网络和学生网络的表示应该尽可能相似;而对于不同的样本,它们的表示则应该尽可能不同。具体的对比损失函数定义如下:
其中:表示两个表示之间的欧几里得距离。
是一个预定义的距离阈值,用于控制不同样本之间的最小距离。当两个不同样本的距离大于这个阈值时,损失函数会忽略它们之间的差异,从而让模型更关注那些距离较近的样本对。
2.4类别引导的原型蒸馏
类别引导的原型蒸馏(CPD)指在多模态情感分析中,每个情感类别(如“快乐”“悲伤”“愤怒”“中性”)都有其独特的特征。CPD机制的核心思想是:为每个情感类别定义一个“原型”(prototype),这个原型可以看作是该类别所有样本特征的“中心点”或“代表特征”。通过比较每个样本与这些原型的相似性,模型能够更好地理解不同类别之间的差异,并将这种差异传递给学生网络。
假设我们有一个迷你批次的数据,其中包含不同情感类别的样本。对于每个情感类别 ,我们计算该类别所有样本特征的平均值,作为该类别的原型
:
其中,是迷你批次中属于类别
的样本集合,
是样本
的特征表示。
对于每个样本 ,我们通过余弦相似度计算它与每个类别原型的相似性。如果样本
属于类别
,那么它与
的相似性表示该样本在类别内的特征变化;如果
不属于
,那么相似性表示跨类别的特征变化:
教师网络和学生网络分别计算出每个样本与所有类别原型的相似性矩阵 和
。CPD机制的目标是让这两个相似性矩阵尽可能一致,从而确保学生网络能够学习到与教师网络相似的类别特征分布:
其中,是样本数量,
是类别数量。通过最小化这个损失函数,学生网络能够更好地对齐特征分布,从而在处理模态缺失时也能生成鲁棒的情感特征。
2.5响应解耦的一致性蒸馏
响应解耦一致性蒸馏(RCD)是一种用于优化知识蒸馏过程中的情感决策边界的方法。在传统的知识蒸馏中,模型的响应(即预测结果)通常包含目标类别和非目标类别的预测概率。这些响应之间存在耦合关系,高置信度的目标类别响应可能会抑制非目标类别响应,从而限制了知识的有效传递。RCD通过解耦这些响应,分别优化它们的一致性,使得学生网络能够更有效地学习教师网络的情感决策逻辑。将模型的响应分为两部分:
1.目标类别响应(TCR):表示模型对目标类别的预测置信度。
2.非目标类别响应(NTCR):表示模型对非目标类别的预测置信度。
将响应解耦为
和
。定义 Q∈Q 和 U∈U 为两个随机变量。Q 和 U 的边缘概率密度函数分别记作 P(Q) 和 P(U),而 P(Q,U) 表示联合概率密度函数。互信息 I(Q,U) 定义如下:
互信息 可以表示为联合概率分布
与边缘分布乘积
之间的 KL 散度,即
。为了高效稳定的计算,我们在本研究中采用 JS 散度来估计互信息,定义如下:
最终,总训练目标:
3.实验
作者在三个具有词对齐数据的多模态情感分析(MSA)数据集上进行了广泛的实验,包括 MOSI、MOSEI 和 IEMOCAP 。
3.1特征提取
1.语言模态:使用 Glove 嵌入将视频字幕转换为 300 维向量。
2.音频模态:使用 COVAREP 工具包 提取 74 维声学特征,包括 12 个 Mel 频率倒谱系数(MFCC)、有声/无声段特征和声门源参数。
3.视觉模态:使用 Facet 提取 35 个面部动作单元,记录面部运动以表达情感。
3.2对比试验
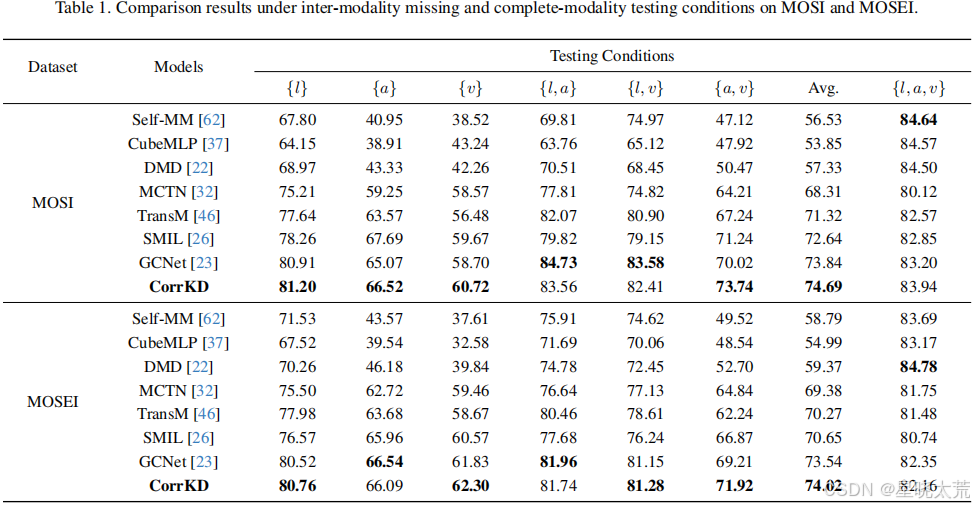
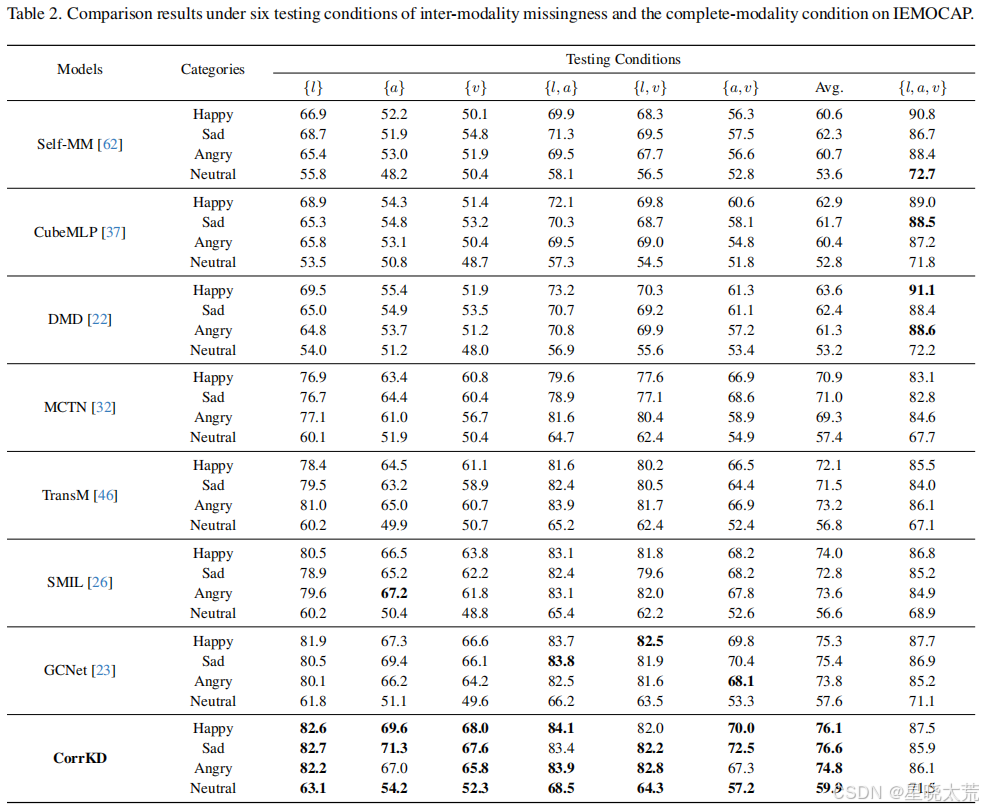
作者比较了 CorrKD 与七种代表性且可复现的最新方法(SOTA),包括完整模态方法(Self-MM 、CubeMLP 和 DMD )和缺失模态方法(联合学习方法,如 MCTN 和 TransM ;生成方法,如 SMIL 和 GCNet )。我们通过广泛的实验彻底评估了 CorrKD 在模态内缺失和模态间缺失情况下的鲁棒性和有效性。如下图
3.3消融实验
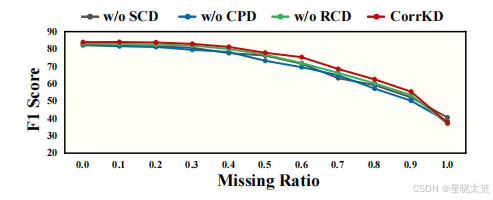
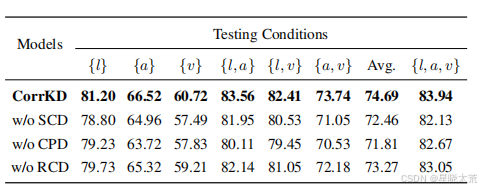
为了验证 CorrKD 中所提出机制和策略的有效性和必要性,我们在 MOSI 数据集上针对两种缺失模态情况进行了消融研究,结果如下图 和表所示。主要发现如下:
-
移除样本级对比蒸馏(SCD):在两种缺失模态情况下,移除 SCD 后模型性能显著下降。这表明挖掘和传递全面的跨样本相关性对于在学生网络中重建缺失语义至关重要。
-
移除类别引导的原型蒸馏(CPD):在两种缺失模态情况下,移除 CPD 后结果更差。这表明捕捉跨类别特征变化和相关性有助于在两个网络之间深度对齐特征分布,从而生成鲁棒的联合多模态表示。
-
移除响应解耦的一致性蒸馏(RCD):用 KL 散度损失替换所提出的 RCD 后,性能下降。这表明解耦异构响应并最大化同构响应之间的互信息,能够激励学生网络充分重建有意义的情感语义。
4.结论
在本文中,作者提出了一种相关解耦的知识蒸馏框架(CorrKD),用于解决多模态情感分析(MSA)任务中的多样化缺失模态问题。具体而言,作者提出了一个样本级对比蒸馏机制,利用对比学习捕捉并传递跨样本相关性,以精确重建缺失语义。此外,还提出了一个类别引导的原型蒸馏机制,通过类别原型学习跨类别相关性,提炼情感相关信息以改进联合表示。还提出了一个响应解耦的一致性蒸馏策略,以促进教师网络和学生网络之间的分布对齐。广泛的实验验证了框架的有效性。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献1条内容

所有评论(0)