408数据结构—树和二叉树
一、树的基本概念
1.树的定义
树是一种逻辑结构,一种分层结构,更是一种递归的数据结构
树具有以下两个特点:
- 根节点没有前驱,除了根节点以外的所有节点有且只有一个前驱(即不可能出现一个结点有多个双亲,两个结点不能共享一个儿子)
- 树中所有结点都可以有零个或多个后继
树中的某个结点(除根节点)最多只和上一层的一个结点有直接关系,n个结点的树有n-1条边
树中的每个结点可以与其下一层的零个或多个结点有直接关系
2.基本术语
- 祖先,子孙,双亲,孩子,兄弟,堂兄弟
- 结点的度:结点的孩子个数;树的度:树中结点的最大度数
- 分支结点,叶结点
- 结点的层次:根节点是第1层,从上往下依次增加层数
结点的深度:结点所在的层数
结点的高度:以该结点为根的子树高度
树的高度(深度):树中结点的最大层数 - 有序树,无序树
- 路径:两结点之间经过结点的序列(从上到下,同一双亲的两个孩子之间不存在路径)
路径长度:路径上经过的边的个数
3.区分两个概念
- 度为m的树
*至少有一个结点的度=m
*一定是非空树 - m叉树
*允许所有结点的度数<m,即不一定非得有度为m的结点
*可以是空树
4.树的性质
1.结点数n =所有结点的度数之和+1
解释:所有结点的度数之和其实就是树中边数之和,边数和所有节点数相差1
2.度为m的树的第i层最多有m的(i-1)次方个结点(同m叉树)
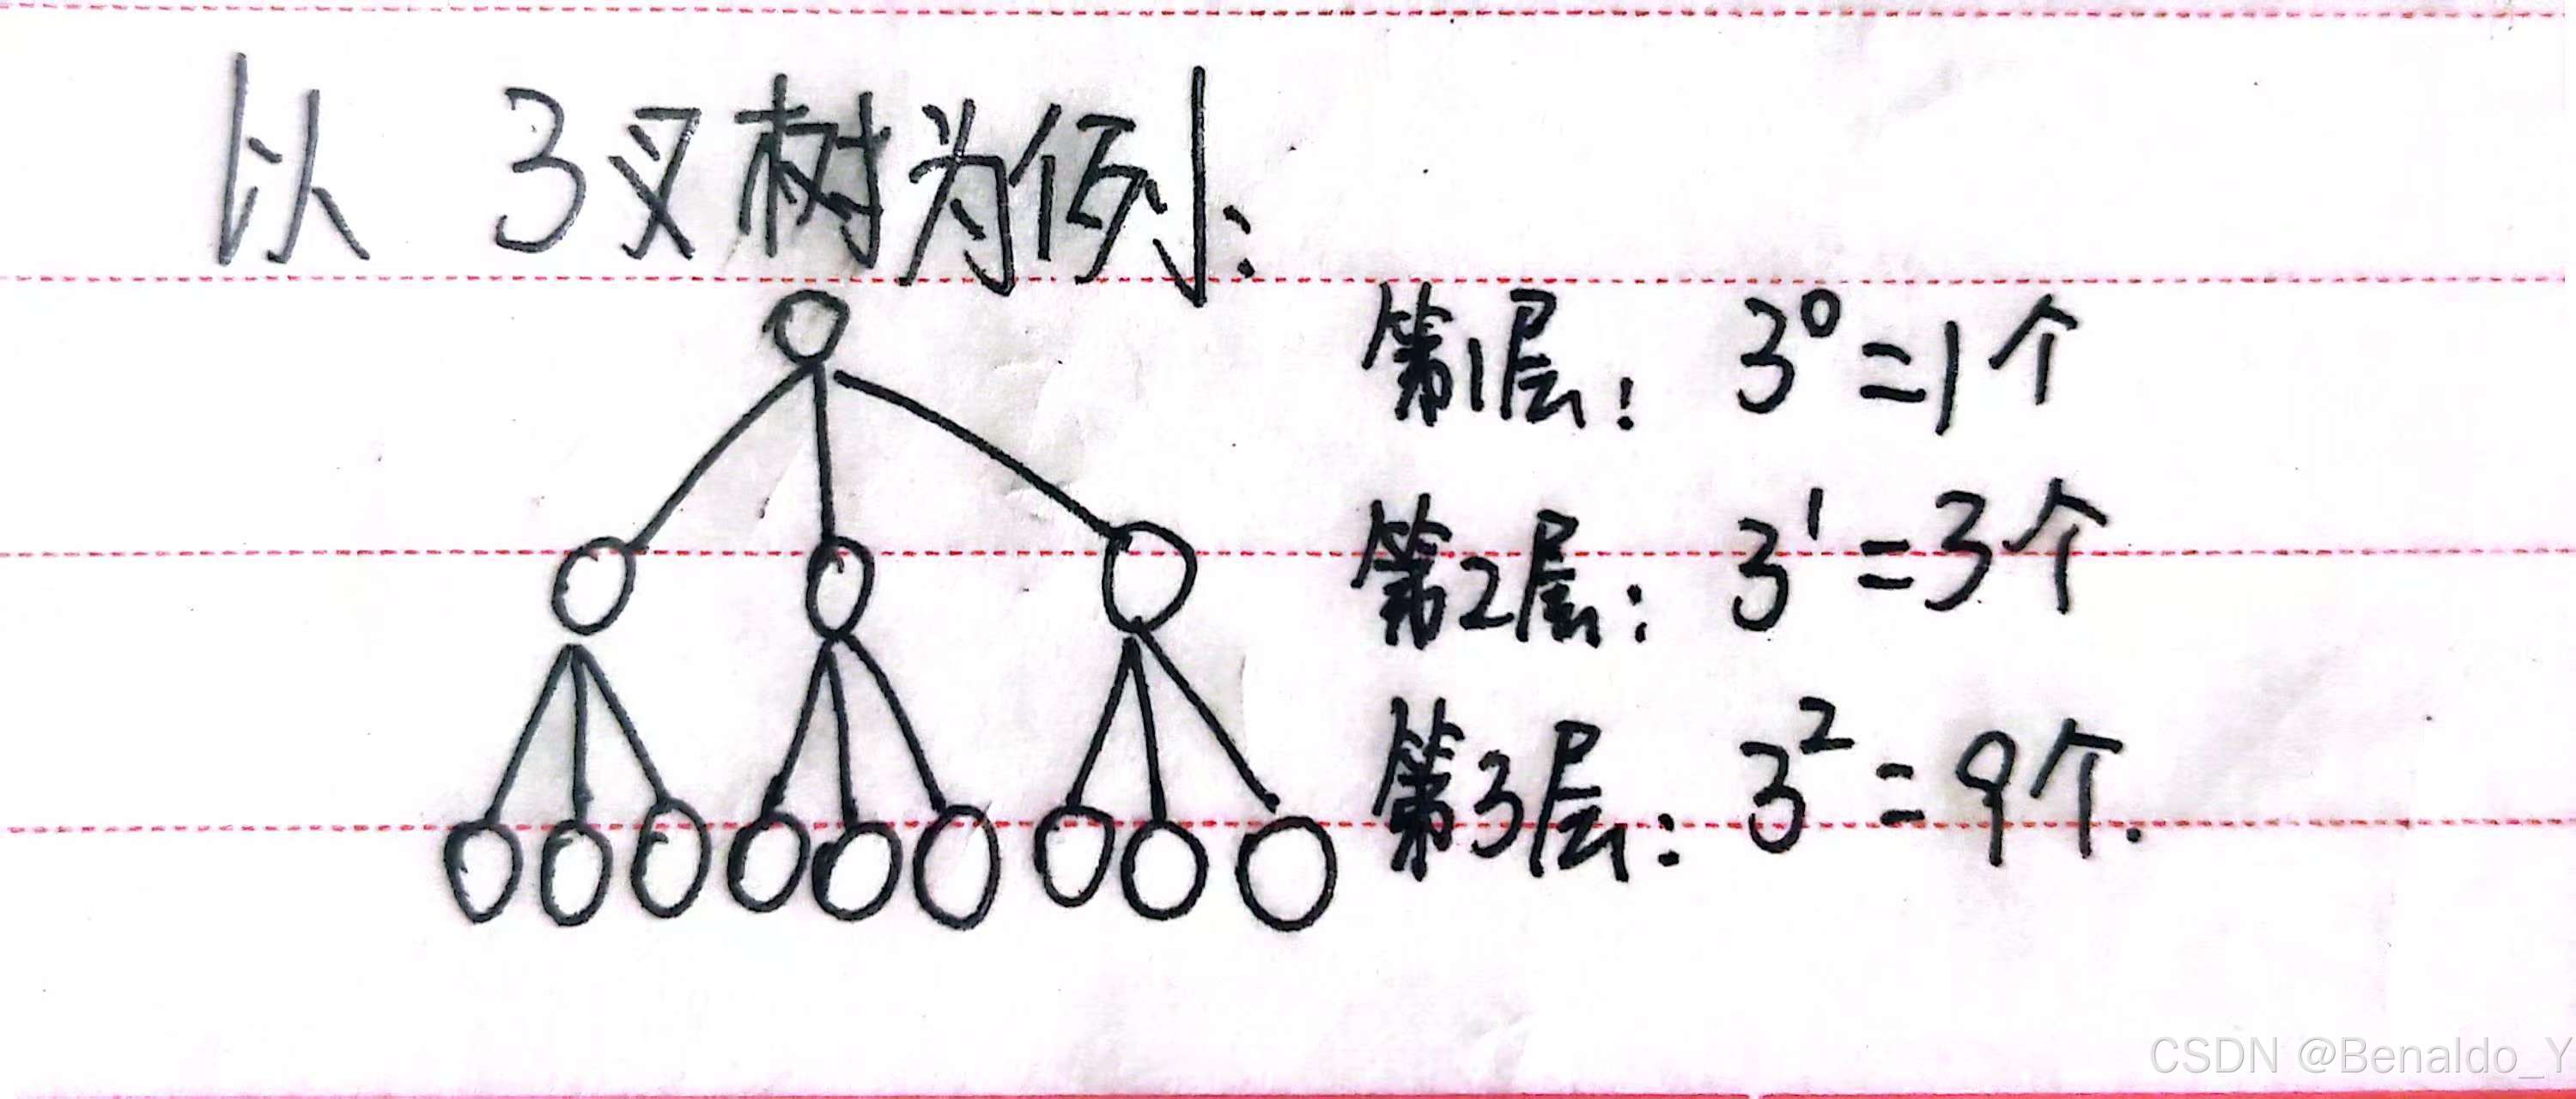
3.高度为h的m叉树最多有(m的h次方-1)/(m-1)个结点等比数列,首项1,公比m,项数为h
上图例子中,总节点数:1+3+3²+3³+……=(3的h次方-1)/2
概括一下,知道度数m,高度h的情况下:
- 用h直接可以得到最多(完全二叉树)的总节点数
- 要得到单独这一层的结点树,需要用h-1,用到的公式如上
如果求最少有多少个结点:
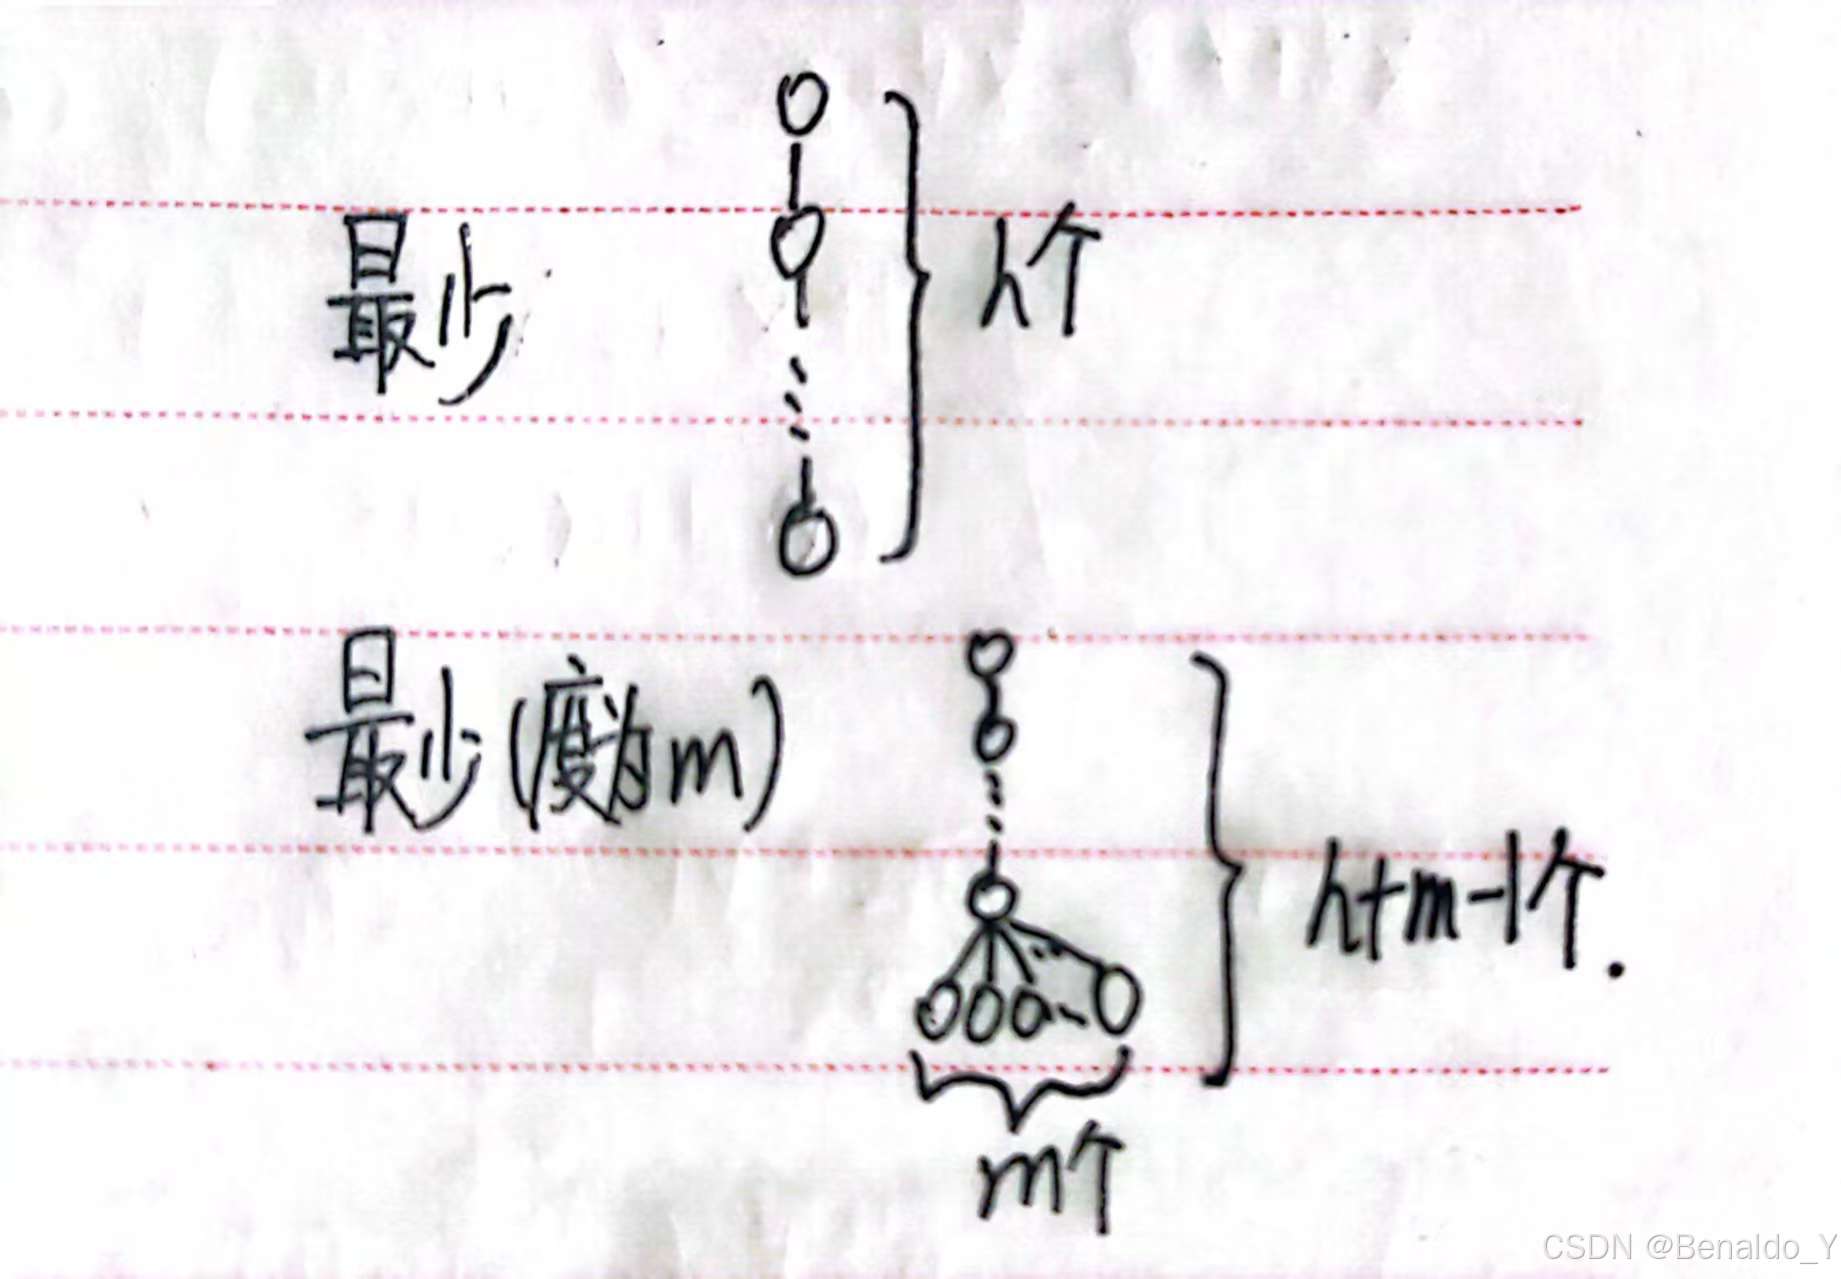
4.若求度为m,具有n个结点的树的最小高度是多少
利用不等式,因为是最小高度,所以孩子越多越好,考虑完全二叉树
(m的h-1次方-1)/(m-1)≤n≤(m的h次方-1)/(m-1)
5.度为m,具有n个结点的树的最大高度h为 n-m+1(见上图2)
二、二叉树
1.定义
每个节点至多只有两棵子树,度为2,左右次序不可颠倒,是有序树
2.几种特殊的二叉树
- 满二叉树
没有度为1的结点
若高度为h,一共有2的h次方-1个结点(公式再记一下)
叶节点都集中在最下一层
若从根节点开始为1,从上到下从左至右编号,i号结点左儿子为2i,右儿子为2i+1
叶节点数=上面的非叶节点数+1=2的h-1次方 - 完全二叉树
满二叉树是完全二叉树的一个子集
和满二叉树的规则几乎一样,但是可以不满
最多有1个度为1的结点,且这个节点只可能有左孩子不可能有右孩子
若一个节点只有左孩子,那么它之后的所有结点全部都是叶节点
n为奇数,则不会出现度为1的点;n为偶数,就有一个结点只有左孩子
叶节点只会在最后两层出现
以n/2(向下取整)为分界线,编号i小于分界就是分支节点,大于就是叶节点 - 二叉排序树(左<根<右)
- 平衡二叉树(任何一个节点的左右子树高度之差绝对值不超过1)
- 正则二叉树(树中只有度为0和2的结点)
3.二叉树的性质
1. 非空二叉树的叶节点数=度为2的节点数+1,即n0=n2+1
证明(这个思想做题常见):
我们想一棵树结点个数有这样两种的表示方法
- 度为0的点个数+度为1的点个数+度为2的点个数+……+度为m的点个数
- 所有结点的度数之和+1(上节提过)
所以表示一棵树的结点总数n,我们有
n0+n1+n2=n1+2×n2+1
化简得n0=n2+1
在完全二叉树中,可以有以下的推论:
由n0=n2+1
可得n0+n2=2×n2+1,这说明度为0和度为2得结点数之和是个奇数
我们还知道度为1的节点数是0或者1
所以总结点数n:
n=2k-1奇数,说明没有n1,n0=k,n1=0,n2=k-1
n=2k偶数,说明有一个n1,n0=k,n1=1,n2=k-1
2. 某层节点数,高度为h的节点数分别可以用上届的公式计算
3. 结点i所在的层次为log2i(向下取整)+1,和上节不等式的公式一样
4.二叉树的存储结构
- 顺序存储结构
取一段连续的存储空间,按从上到下,从左至右的顺序依次存储完全二叉树中的各个结点
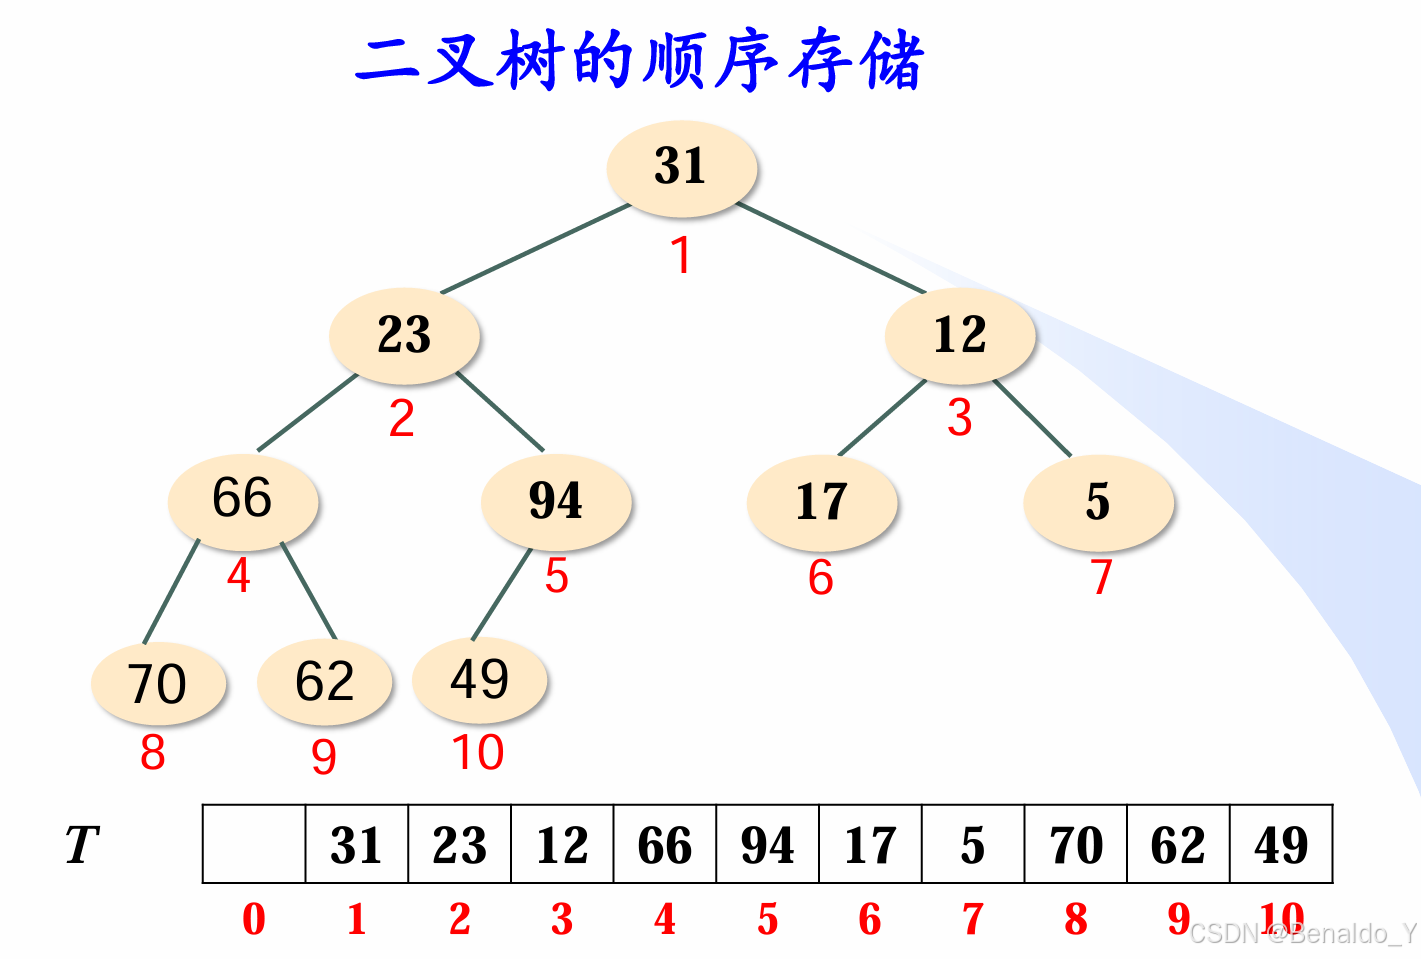
它实际上只存储了结点数据域之值,而未存储其左孩子和右孩子地址,通过下标的计算可找到一个结点的子结点和父结点。T[0]=NULL,保证数组下标和节点编号一致
非常适合于完全二叉树。但是,应用到非完全二叉树时,空的话在数组里也空着,造成空间浪费
在遇见非完全二叉树时也无法表示父子的逻辑关系(完全二叉树有i,2i,2i+1的关系)
struct TreeNode{
       ElemType value;
       bool IsEmpty;//判断结点是否为空
}
- 链式存储结构
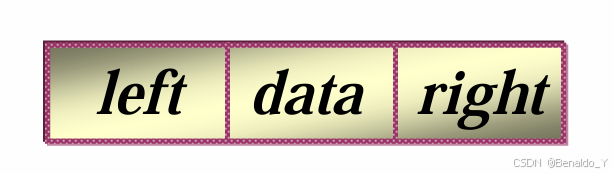
描述如下:
typedef struct BiTNode{
        ElemType data;
        struct BiTNode *lchild,*rchild;
}BiNode,*BiTree;
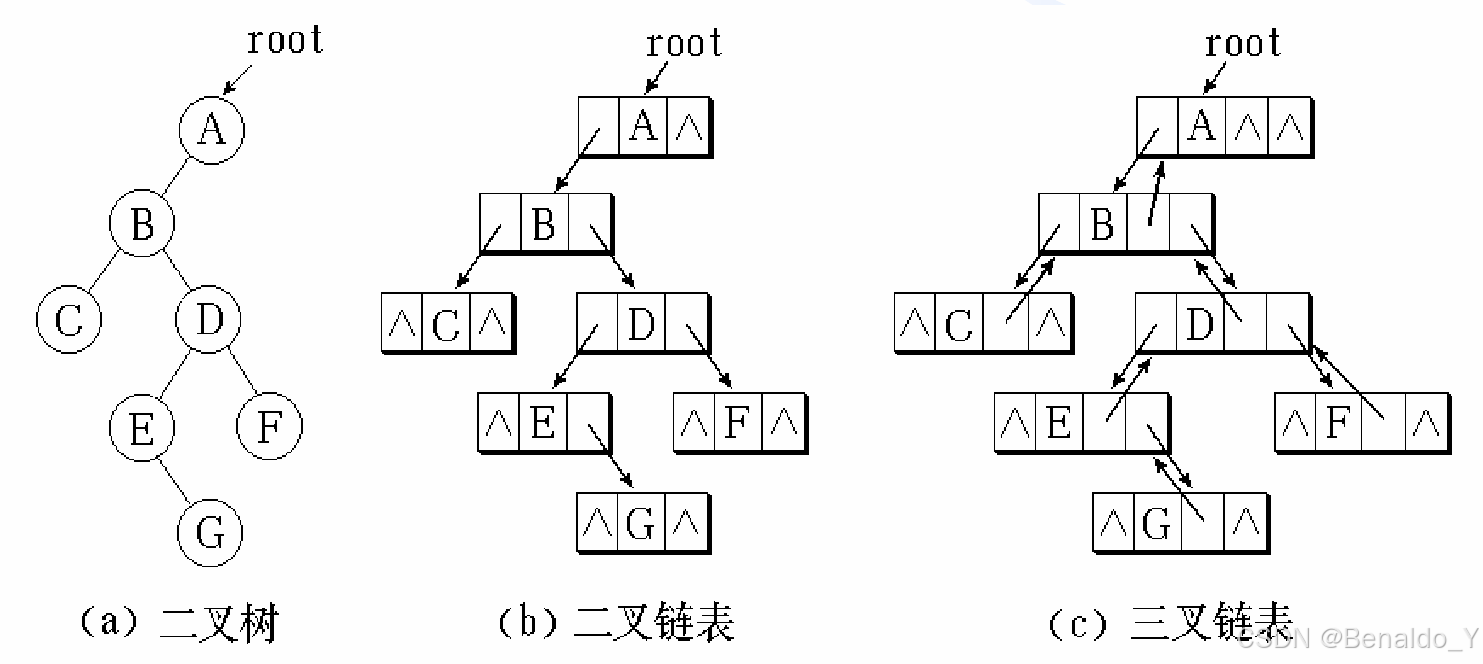
在含有n个节点的二叉链表中,有n+1个空链域
解释:2n个指针域,n-1个头上有东西(除根结点),相减得n+1
5.二叉树的遍历
- 递归遍历(需要用栈,递归工作栈)
先序遍历,中序遍历,后序遍历
先序遍历
void PreOrder(BiTree T){
     if(T==NULL) return;
     visit(T);
     PreOrder(T->lchild);
     PreOrder(T->rchild);
}
中序遍历
void InOrder(BiTree T){
     if(T==NULL) return;
     InOrder(T->lchild);
     visit(T);
     InOrder(T->rchild);
}
后序遍历
void PostOrder(BiTree T){
     if(T==NULL) return;
     PostOrder(T->lchild);
     PostOrder(T->rchild);
     visit(T);
}
在上面三种遍历方式中,每个节点都访问一次且只访问一次,时间复杂度是O(N)
在递归遍历中,递归工作栈深恰好为树的深度,所以最坏情况n个节点深度为n的单支树,空间复杂度O(N)
特别的,后序遍历是逐步压栈的,在遍历完左右子树之后弹栈可返回根结点,也就是说,给定任一个结点,我能通过后序遍历序列找到他的双亲,于是后序遍历可以找到从m到n的路径
- 非递归遍历(也需要用栈),防止递归太多层导致系统栈溢出
- 层次遍历(需要用到队列)
按层数由小至大,同层从左至右的顺序访问二叉树
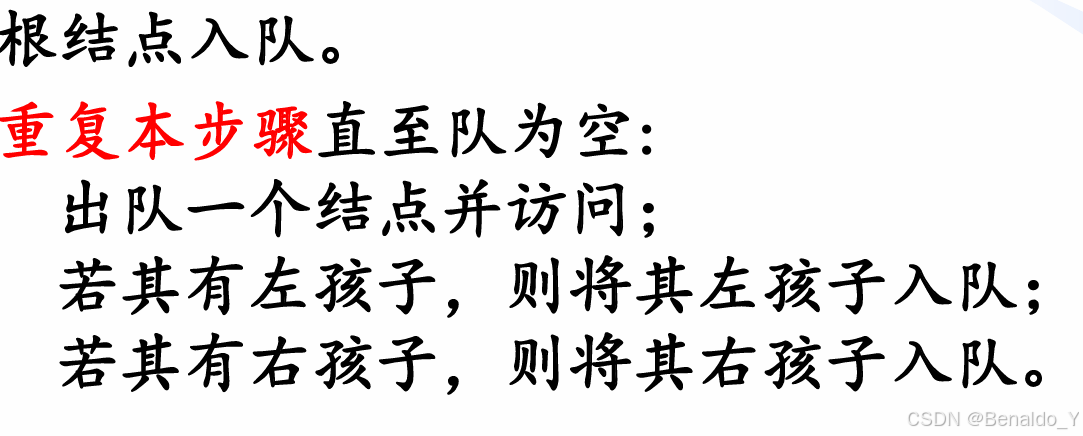
void LevelOrder(BiTree T){
     InitQueue(Q);
     BiTree p;
     Enqueue(Q,T);
     while(!IsEmpty(Q)){
          Dequeue(Q,p);
          visit(p);
          if(p->lchild!=NULL) Enqueue(Q,p->lchild);
          if(p->rchild!=NULL) Enqueue(Q,p->rchild);
  }
}
完全二叉树的辅助队列最大规模:n/2(向上取整)
想:队列元素最多的时候应该是全是最后一层的叶结点的时候,叶节点数=n/2
- 由遍历序列构造二叉树
中序序列+任意一种序列=一棵确定的二叉树
因为中序能找到根的左和右子树
做题时常出,给定两种序列让求对应的二叉树或者可能的二叉树
先序,中序的关系相当于:先序为入栈顺序,中序为出栈顺序
于是若问一个先序序列能对应多少种不同的二叉树,就按卡特兰数公式计算
6.线索二叉树
二叉树是一种逻辑结构,而线索二叉树既表示逻辑又有存储,所以是一种物理结构
- 动机
在二叉树(结点无父指针域)上只能找到结点的左孩子、右孩子,找结点的中(先、后)根前驱和后继只能通过从头到尾遍历 - 如何通过遍历找前驱后继?(pre指针)
我们在没有对二叉树进行任何改进的时候,想找到某一个结点的遍历序列(比如中序)的前驱和后继,注意这里的前驱后继不是结点的双亲孩子这一套,而是在中序遍历后得到的遍历序列中某一个结点的前驱与后继。
我们可以使用指针pre来记录前驱的结点
就比如,假设我们要研究的结点是p,先用一个指针q指向序列的第一个节点(因为这是只能从前往后遍历),对应pre指针指向NULL(第一个结点没有前驱结点),随后看看q是否等于p,如果是则pre为所找的前驱,否则q,pre指针向后移。当然,如果pre和p相等,那么此时的q就自然是p的后继
伪代码,找前驱
while(q!=p){
  pre=q;
  q=q->next;
}
return pre;
找后继
while(pre!=p){
  pre=q;
  q=q->next;
}
return q;
- 线索二叉树的基本概念
我们知道,在n个节点的二叉树中,一共有n+1个空指针域(2n-(n-1)),于是我们想利用这些空指针来保存其指向前驱或后继的指针
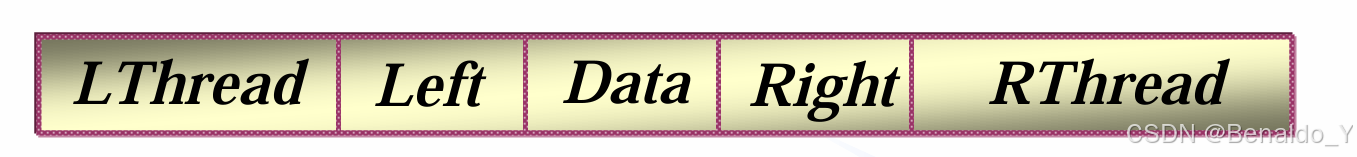
这里,lthread(或lchild),rthread(或rchild)表示左右两个指针
在线索二叉树中,这些指针域会被完全使用
于是乎,这些指针要不指向自己的孩子,要不就指向前驱后继
如何区分指针到底是二者中的哪一个含义呢?我们又引入int型的left(ltag)和right(rtag)的标志域
标志域的含义如下
前驱左,后驱右
标志域等于0,代表指向左右孩子
标志域等于1,代表指向前驱后驱,我们把这种指针成为线索
typedef struct ThreadNode{
   ElemType data;
   struct ThreadNode *lchild,*rchild;
   int ltag,rtag;
}
- 中序线索化
所谓线索化,无论什么序,其主要思想是,一开始二叉树里只有指向孩子的指针,现在要遍历找到那些空的指针,如果p的左指针空就指向前驱,如果pre的右指针就指向后继
void InThread(ThreadTree &q,ThreadTree &pre){
     if(q!=NULL){
       InThread(q->lchild,pre);//递归线索化左子树
       //以下为visit
       if(q->lchild!=NULL){
         q->lchild=pre;
         q->ltag=1;
       }
       if(pre!=NULL&&q->rchild!=NULL){
         pre->rchild=q;
         pre->rchild=1;
       }
       pre=q;
       InThrea(q->rchild,pre);//递归线索化右子树
     }
}
最后记得把最后一个节点的右指针指向NULL,表示没有后继
void CreatInThread(ThreadTree T){
     ThreadTree pre=NULL;
     if(T!=NULL){
       InThread(T,pre);
       pre->rchild=NULL;
       pre->rtag=1;
     }
}
先序,后序线索化只用调整visit的位置即可,和遍历相同
考虑这样的情况(先序):
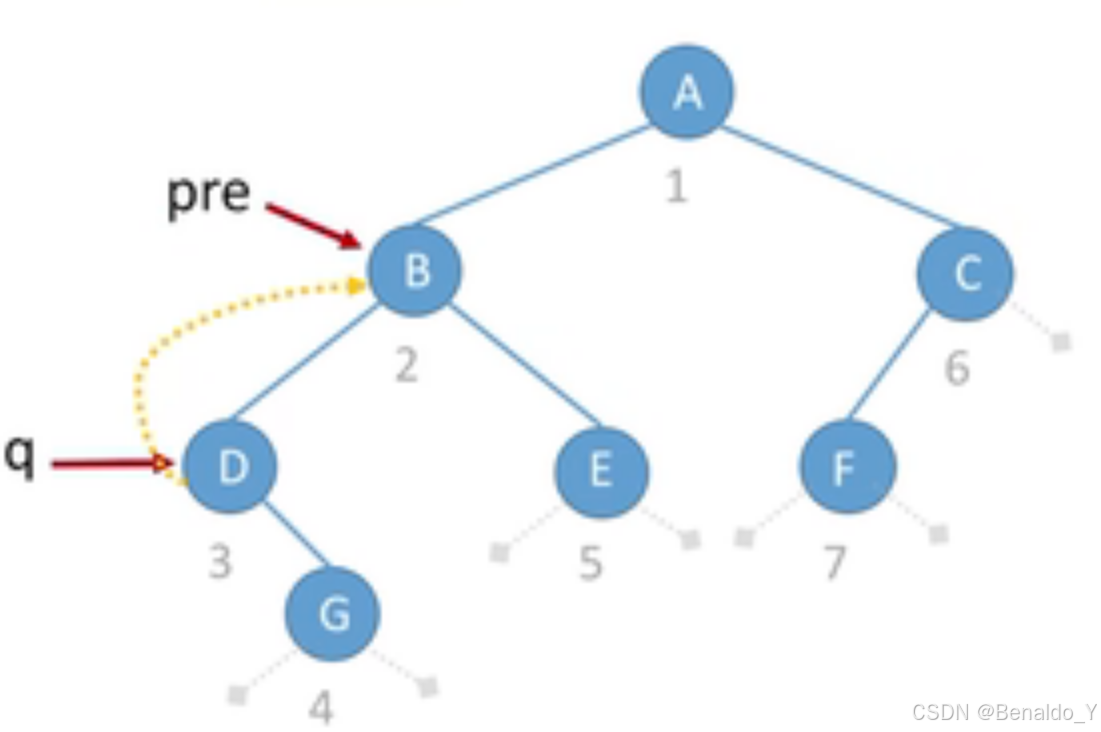
在先序线索化的过程中,先visit,再线索化左子树,最后是右子树
但是上图中q在第三个点D的时候,visit时由于左指针为空指向pre,之后线索化左子树的时候就走回去了
为了防止这种倒退,转圈的情况,我们加一句限制:跳过已经被改为线索的指针
if(q->ltag==0){
  PreThread(q->lchild,pre);
}
- 中序线索二叉树的遍历
求中序线索二叉树中序序列下的第一个节点
ThreadNode *FirstNode(ThreadNode *p){
    while(p->ltag==0) p->p-lchild;//考虑中序第一个节点的特点,最左下结点(不一定是叶节点)
    return p;
}
求中序线索二叉树p在中序序列下的后继
ThreadNode *NextNode(ThreadNode *p){
    if(p->rtag==0) return FirstNode(p->rchild);//右子树的左下结点
    else return p->rchild;//如果右指针是线索直接就是后继了
}
推论:叶节点没有左右儿子,所以叶节点的前后继直接就能通过线索找到
求中序遍历序列
void Inorder(ThreadNode *T){
     for(ThreadNode *p=FirstNode(T);p!=NULL;p=NextNode(p)) visit(p);
}
不同方式遍历,求前后继的方法是不一样的
分析时想这么一幅图
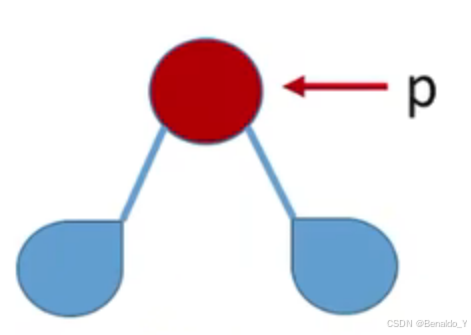
把红点当作现在要分析的点,求他的前驱后继在各规则下的结果是什么
比如中根求前驱:如果左指针是线索直接找到,否则是p的左子树的中根序列的最后一个结点
求中根序列的最后一个结点方法:沿右分支下行,找第一个没有右孩子的结点
- 特殊说明
1.若结点结构中没有父指针:
✓前序线索二叉树不能解决高效查找结点的先根前驱的问题。
后驱:有左儿子就是左儿子,没左儿子有右儿子是右儿子,叶节点直接是右指针
✓后序线索二叉树不能解决高效查找结点的后根后继的问题。
前驱:右子树最后一个结点
2.前序,中序线索树遍历不需要使用栈
后序线索树,普通二叉树需要使用栈
解释一下后序线索,因为我们说后序线索找后继困难,右子树遍历完没有指针回到根了,所以需要栈来保存信息;二叉树不用说,递归非递归都得使用栈
三、树与森林
1.树的存储结构
- 双亲表示法
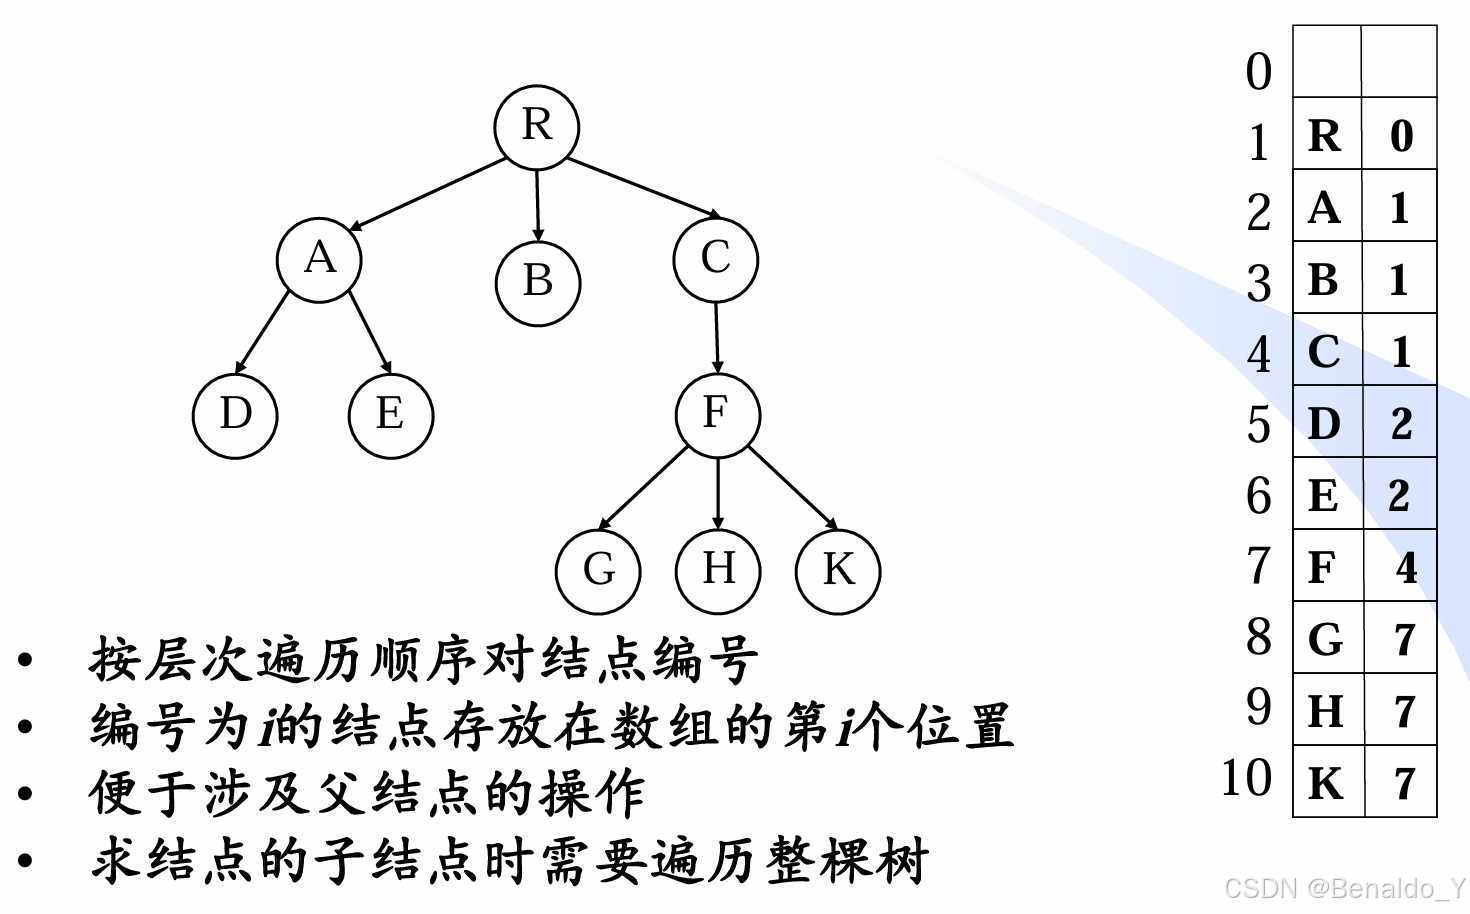
右边一列是伪指针,代表其双亲结点在数组中的位置 - 孩子表示法
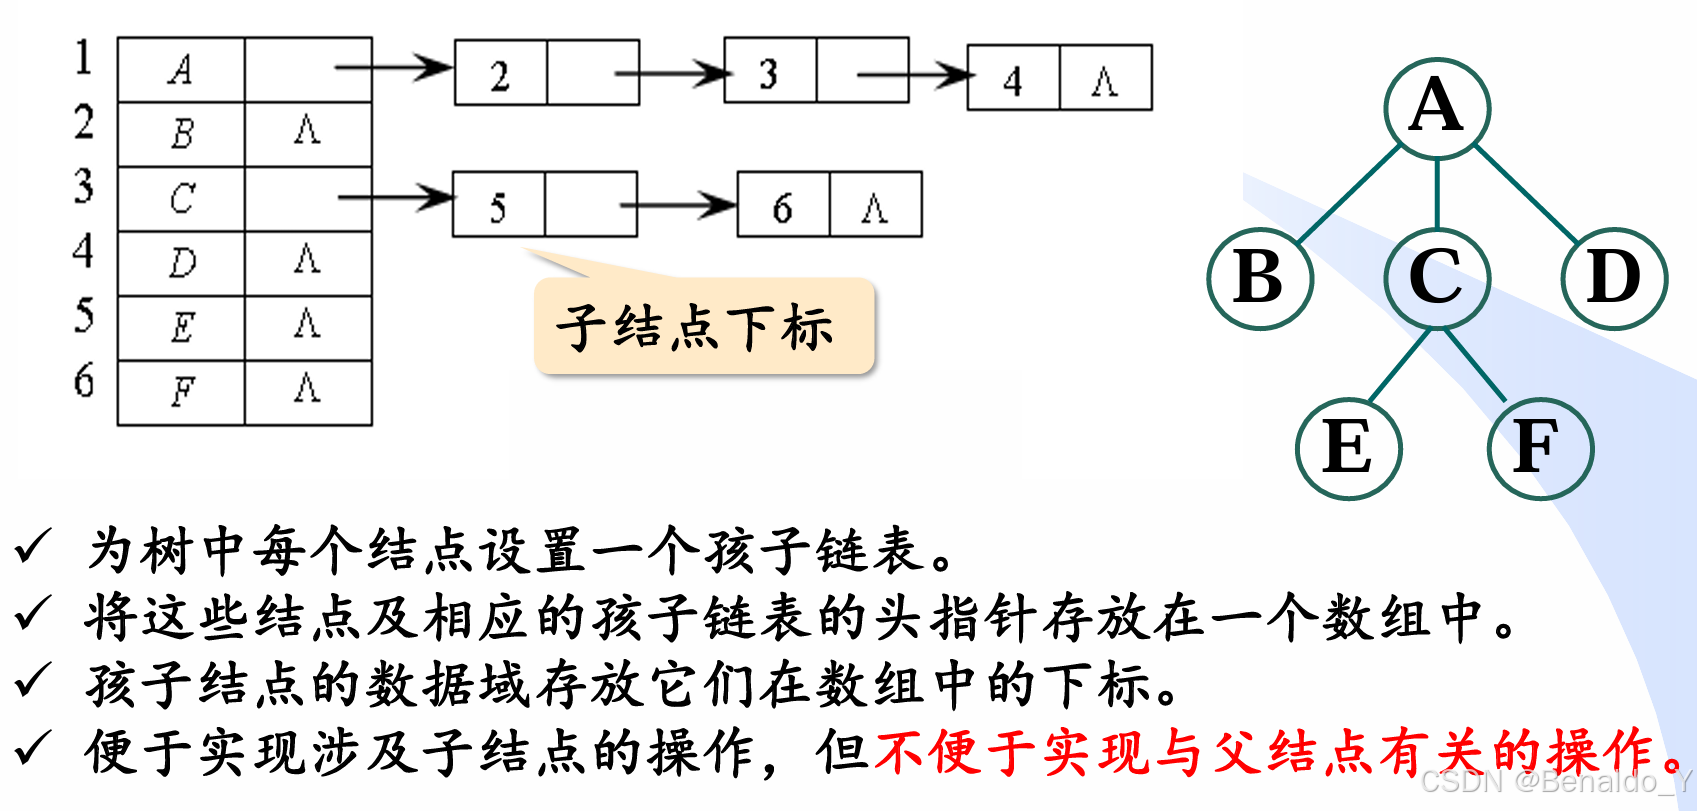
- 孩子兄弟表示法
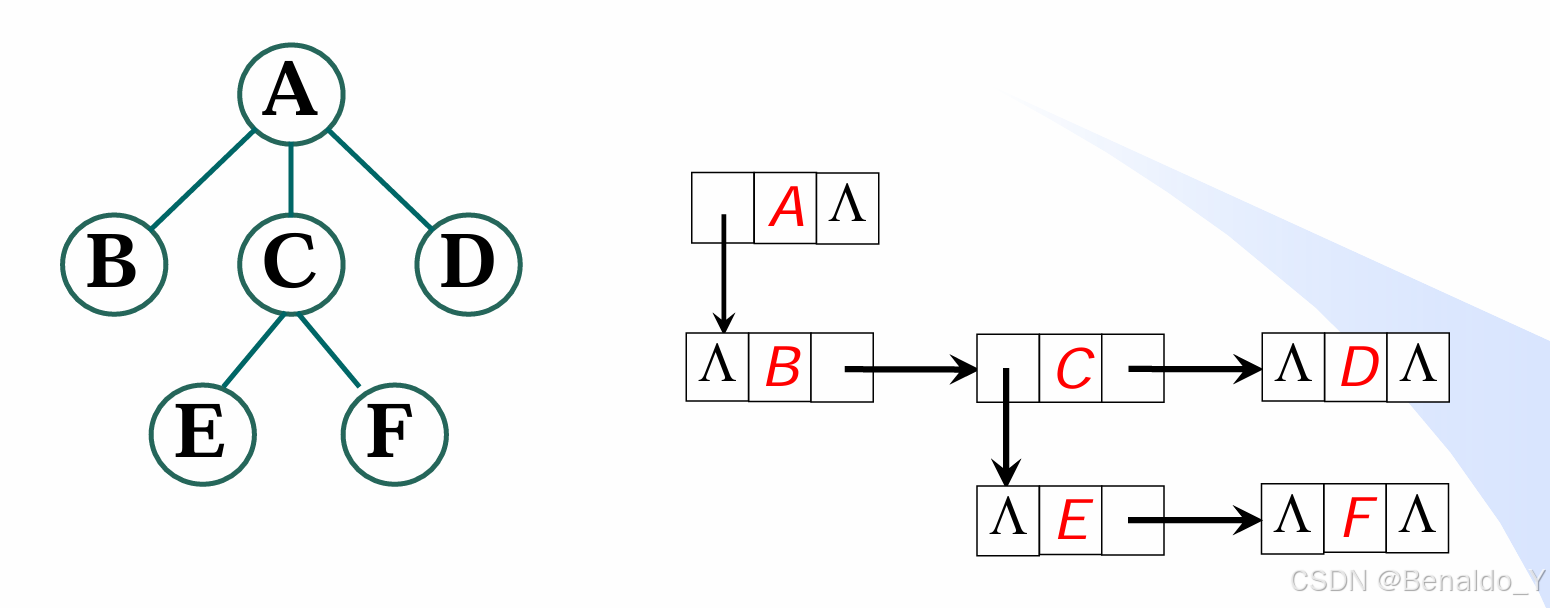
孩子兄弟表示法又称为二叉树表示法
结点包含三部分内容:**第一个孩子的指针,data,右边下一个兄弟的指针
typedef struct CSNode{
  ElemType data;
  struct CSNode *firstchild,*nextsibling;
}CSNode,*CSTree;
这种方法方便实现树转换为二叉树的操作,但是想从当前节点找到其双亲比较麻烦。
2.树,森林,二叉树的转换
完成这三种数据结构的核心是孩子兄弟表示法
- 树转为二叉树
无论每个结点的度是多少,转换为孩子兄弟表示法也就可以转换为二叉树
事实上按着左孩子右兄弟的规则推就行
当然,也有专门的画法:
1.在兄弟结点之间连一条线
2.对于每个节点,保留它与第一个孩子的连线,而与其他孩子的连线全部抹掉
3.以树根为轴心,顺时针旋转45°(事实上这一步就是美观一下) - 森林转为二叉树
画法:
1.把每一棵树转为二叉树
2.把每一棵树的根连线连起来,当作兄弟
3.以第一棵树根为轴心,顺时针旋转45°(美观) - 二叉树转为森林
事实上就是森林转二叉树的过程退回去,是个逆过程
画法:
1.先把第一级的根拆开
2.分别按孩子兄弟法进行还原
3.树和森林的遍历
- 树的遍历
遵循先,中,后根遍历
-森林的遍历
1.先序遍历
法1:对各个子树按照先序遍历的规则进行遍历
法2:先把森林转化为二叉树,再对二叉树进行先序遍历
2.中序遍历
法1:依次对各个子树进行后序遍历(注意)
法2:先把森林转化为二叉树,再对二叉树进行先序遍历
| 树 | 森林 | 二叉树 |
|---|---|---|
| 先根遍历 | 先序遍历 | 先序遍历 |
| 后根遍历 | 中序遍历 | 中序遍历 |
树的后根遍历等于森林或二叉树的中序遍历
4.分支法分析树
做题时遇见的一个比较巧妙的方法,就是说一棵树是由一条分支为开始,从某个节点延伸出很多很多分支的情况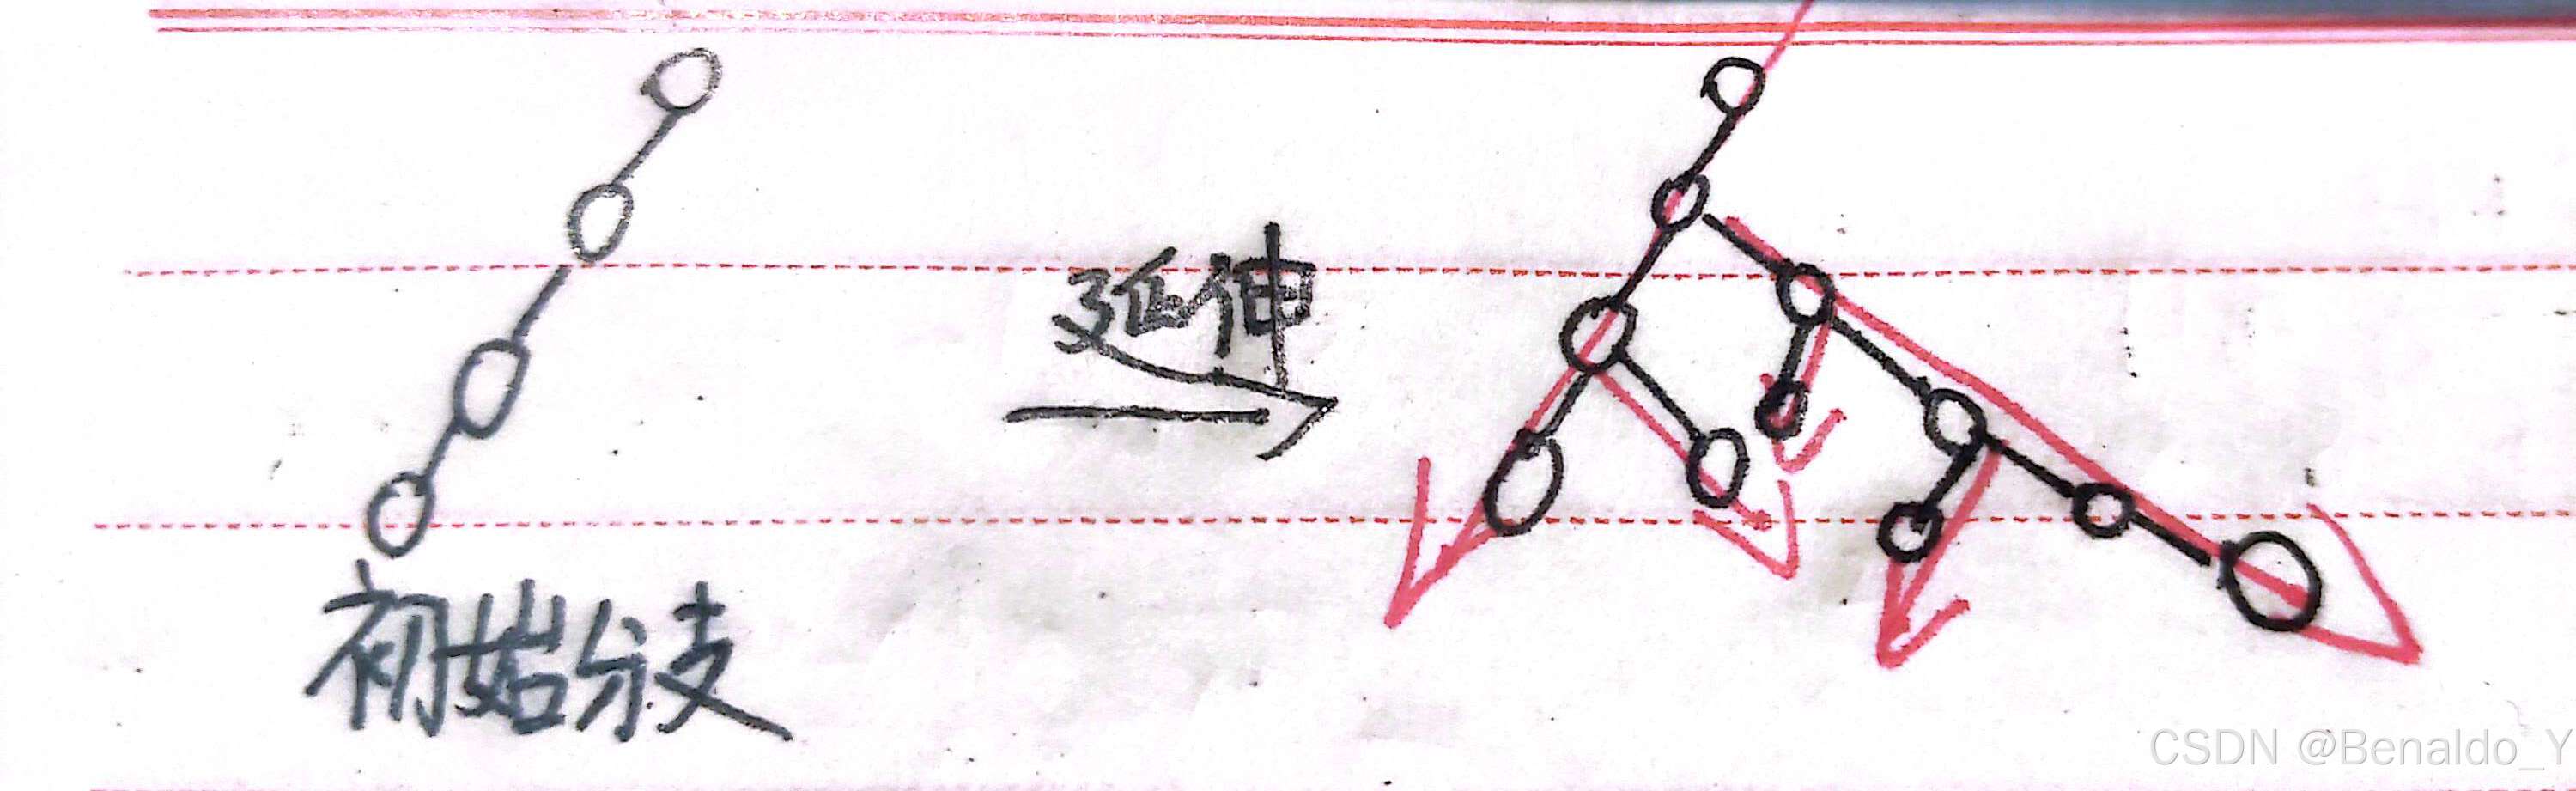
二叉树如此,三叉树等也是一样的
每伸出一个分支,代表那个结点多了一个兄弟
每条分支的尽头是一个叶节点,所以一棵树有多少个叶节点代表着有多少个分支
【2011统考】已知一棵有2011个结点的树,其叶节点的个数为116,求该树对应的二叉树中无右孩子的节点个数是多少?
分析:采用分支的思想
先看题目,树对应的二叉树是孩子兄弟表示法,没有右孩子就说明此结点没有兄弟
于是二叉树的问题被我们转换为了树的问题,分支法启动
有116个叶节点,说明有116个分支,第一个主分支不算,延申出了115个分支
也就是有115个结点有了兄弟
没有兄弟的节点数:2011-115=1896个
四、树与二叉树的应用
1.哈夫曼树和哈夫曼编码
- 定义
路径:树中一个结点到另一个结点的分支
路径长度:路径上的分支数目
权:结点被赋予的数值
结点的带权路径长度:根到这个结点的路径长度与该点权值的乘积
树的带权路径长度:所有叶节点的带权路径长度之和
WPL=w1l1+w2l2+…+wnln
哈夫曼树:含有n个带权节点的二叉树中,WPL最小的二叉树。也称最优二叉树
注意一点,哈夫曼树不是唯一的,但是WPL一定是最小且最优的 - 哈夫曼树的构造
方法:
1.把n个结点分别作为仅含有一个节点的二叉树,构成森林F
2.不断挑最小权值的两个结点合并,生成一个新的结点,权值为两权值之和
3.直至F中只剩下一棵树为止 - 哈夫曼树的性质
1.每个初始结点最终都称为叶节点,权值越小的离根节点的路径长度越大
2.新建了n-1个结点,所以哈夫曼树一共有2n-1个结点
3.不存在度为1的结点 - 哈夫曼编码
这是哈夫曼树真正的应用,我们想要用不同的编码表示不同的字符,同时又想方便简单,即使用频率最多的字符编码简单,频率少的字符编码便没那么重要,所以WPL就是需要考虑到的因素
编码分为两种:
固定长度编码:每个字符用相等长度的二进制位表示
可变长度编码:允许长度不等,可利用哈哈夫曼编码进行数据压缩
前缀编码:没有一个编码是另一个编码的前缀,避免歧义
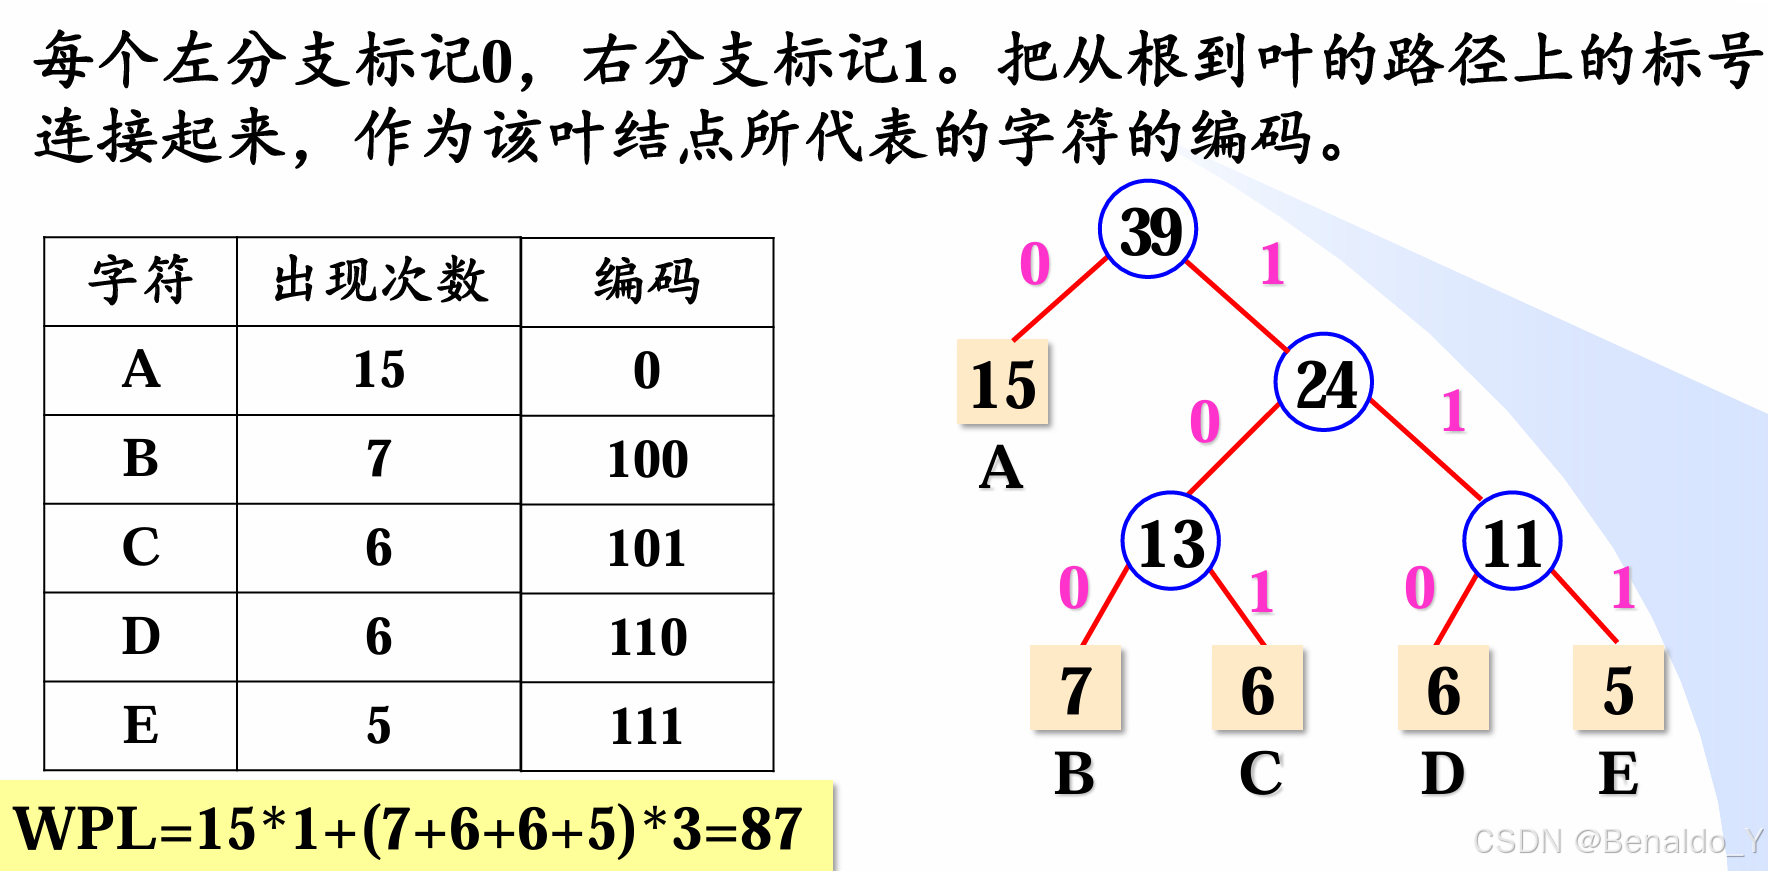
规则是自己定的,并没有统一的标准,比如上图左分支为0,右分支为0
哈夫曼树的结点权值就是出现频率,从根到叶节点路径上的分支标记的字符串作为该字符的编码。
任意一个叶结点不可能是其他叶结点的祖先,每个叶结点对应的编码不可能是其他叶结点对应的编码
的前缀,故哈夫曼编码是无前缀冲突编码。
2.并查集
一些应用问题涉及将n个不同的元素分成一组不相交的集合。
经常需要进行两种操作:
①查询某个元素所属的集合
②合并两个集合。
将维护该不相交集合的数据结构称为并查集。
如何实现集合的概念?使用树,同一集合一棵树,不同集合用根节点区分
- 并查集的存储结构
我们通常使用双亲表示法,因为需要进行查找元素属于那个集合的操作时,可以用来一次一次找根结点
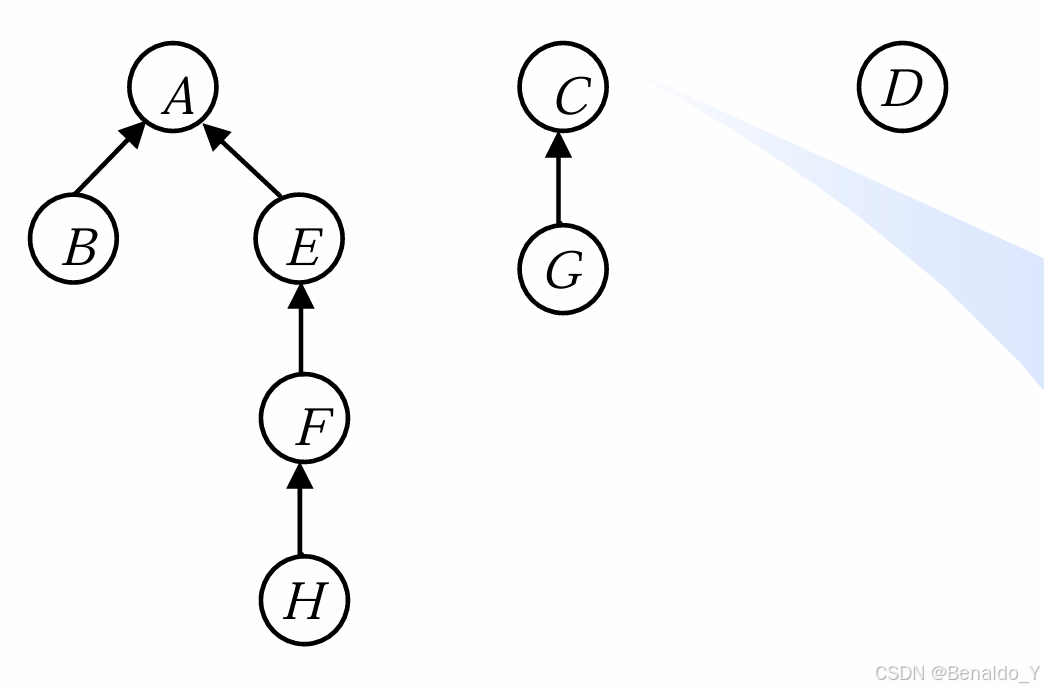
并且使用双亲表示数组存储,数组元素下标表示元素名,用根节点的下标代表元素名
废话不多说,直接上图:
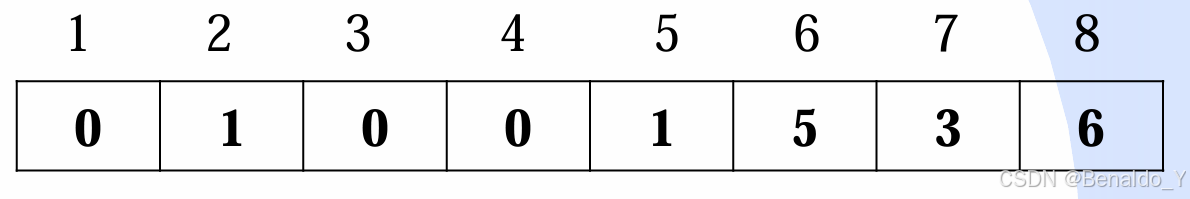
为了得到两个集合的并,秩序将一个自己和的根节点的双亲指针指向另一个集合的根节点
我们可以做出改进:根节点的双亲域为负数,且绝对值为子集合元素的个数 - 并查集的操作
初始化:
void Initial(int s[]){
    for(int i=0;i<SIZE;i++) s[i]=-1;
}
在并查集s中查找元素x并且返回元素x的树的根(时间复杂度:O(d),d为树的深度)
void Find(int s[],int x){
     while(s[x]>0) x=x[x];
     return x;
}
求两个不相交的集合的并集,就是把一个集合树的根指向另一棵树的根(时间复杂度O(1))
void Union(int s[],int root1,int root2){
    if(root1==root2) return ;
    s[root2]=root[1];
}
- 并查集的优化
我们知道,在上面思路下,Find在最坏情况下的时间复杂度为O(d),Union的时间复杂度为O(1)
我们要解决的问题是,将n个独立元素通过多次Union合为一个集合
既然Union已经是O(1),所以我们尽可能优化的是Find
1.改进的Union
如果要优化,我们就想办法让其中Find里的深度d尽可能小,或者说不要增加的那么快
所以在Union的时候做出改进,使小树接在大树上
void Union(int s[],int root1,int root2){
    if(root1==root2) return ;
    if(root1>root2){//都是负数,数值大代表绝对值小,是小树
         s[root2]=s[root2]+s[root1];
         s[root1]=root[2];
    }
    else{
         s[root1]=s[root1]+s[root2];
         s[root2]=root[1];
    }
}
用这种方法得到的集合树,其深度不超过floor(log2n)+1
所以Find变成O(logn),Union还是O(1)
2.改进的Find
这次的优化同样也是针对于树的深度来的,从Find的角度出发,while(s[x]>0)这一步减少循环的次数,让其更快的找到自己的根,是这个方法的核心,即对Find函数“压缩路径”
int Find(int s[],int x){
   int root=x;
   while(s[root]>=0) root=s[root];//这两步和之前一样,都是找根
   while(x!=root){
      int t=s[x];
      s[x]=root;
      x=t;
   }
   return root;
}
它的意思是说,压缩路径,因为我们已经找到了x的根了,x就在一个确定的集合里,由于我们Find的时候是让x一步一步找父节点最后找到根节点,所以x这条路径上的所有结点肯定属于这个集合,也就是说让传入的x及它的祖先们全部挂到根root底下。这样我们下次while循环到这些节点的时候就能一步到位,不用一层一层向上找
这种“压缩路径”可使集合树的深度不超过O(α (n)),其中α (n)是一个增长极其缓慢的函数
综合来看,两种改进最后优化的都是Find,Union始终是O(1)
再回到一开始的问题,将n个独立元素通过多次Union合为一个集合
无论怎么优化,时间复杂度都应是O(n×Find的时间复杂度)
这里的n意思是做了(n-1)次的Union

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 23
 0
- 0


 已为社区贡献1条内容

所有评论(0)