数据结构——哈希表(C语言)
哈希函数
哈希表(hash table),又称散列表,它通过建立键 key 与值 value 之间的映射,实现高效的元素查询。具体而言,我们向哈希表中输入一个键 key ,则可以在 O(1) 时间内获取对应的值 value 。
如图所示,给定 n 个学生,每个学生都有“姓名”和“学号”两项数据。假如我们希望实现“输入一个学号,返回对应的姓名”的查询功能,则可以采用图所示的哈希表来实现。
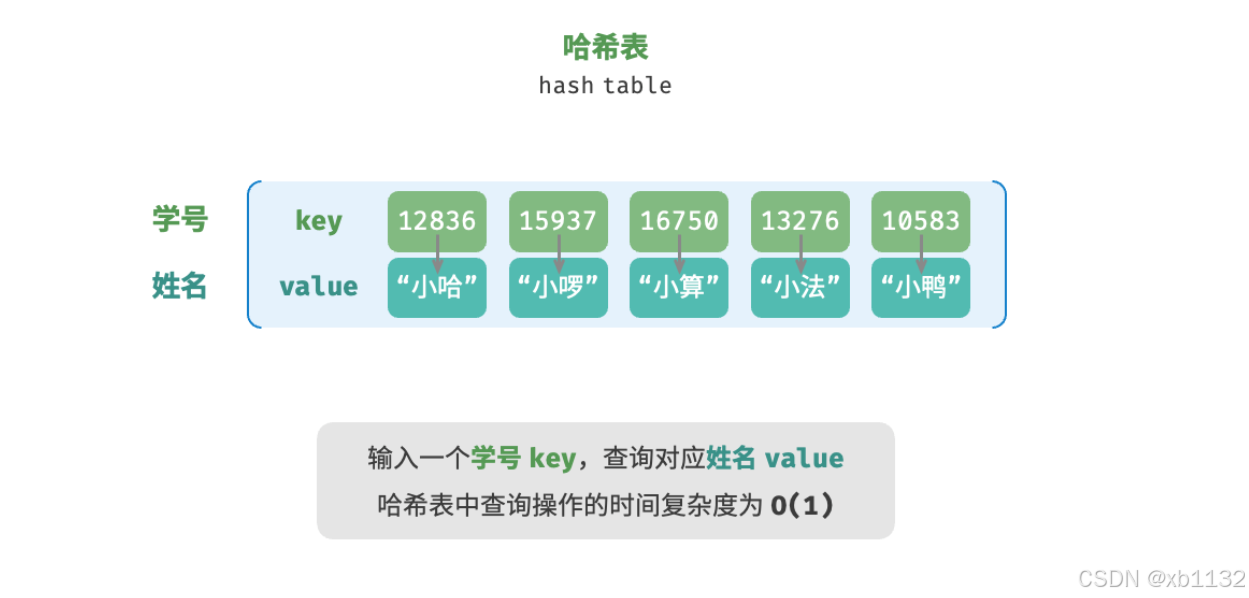
我们先考虑最简单的情况,仅用一个数组来实现哈希表。在哈希表中,我们将数组中的每个空位称为桶(bucket),每个桶可存储一个键值对。因此,查询操作就是找到 key 对应的桶,并在桶中获取 value 。
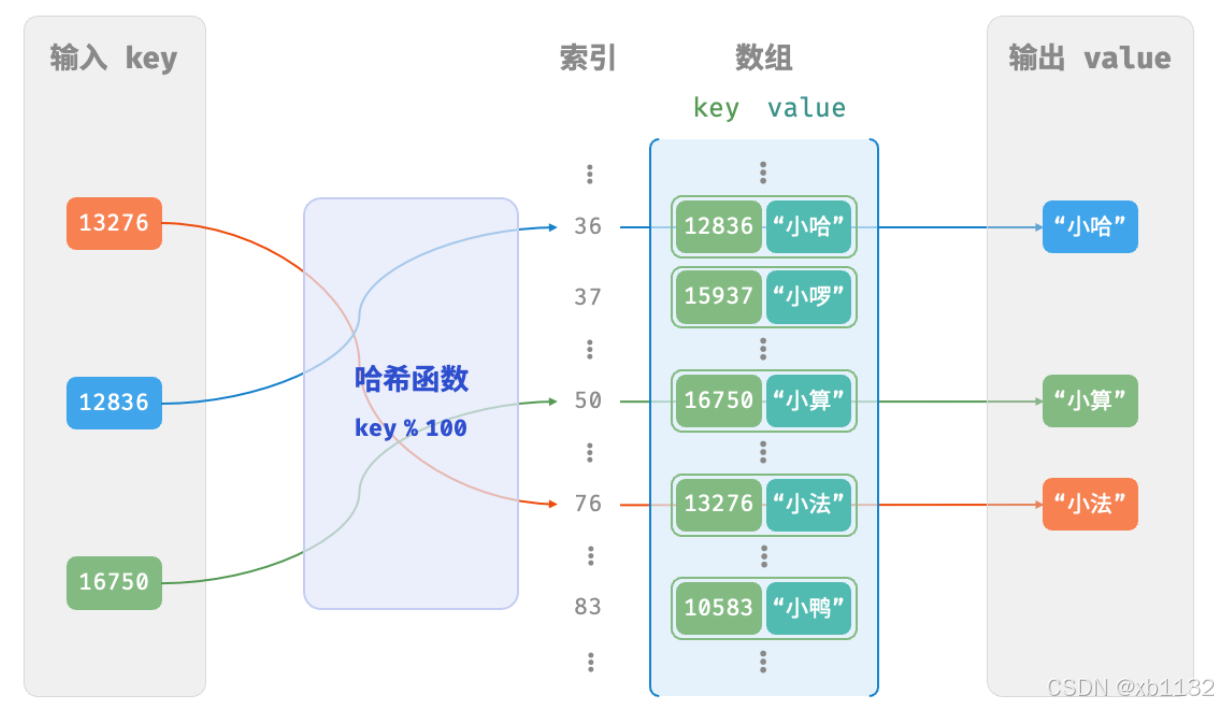
那么,如何基于 key 定位对应的桶呢?这是通过哈希函数(hash function)实现的。哈希函数的作用是将一个较大的输入空间映射到一个较小的输出空间。在哈希表中,输入空间是所有 key ,输出空间是所有桶(数组索引)。换句话说,输入一个 key ,我们可以通过哈希函数得到该 key 对应的键值对在数组中的存储位置。
输入一个 key ,哈希函数的计算过程分为以下两步。
- 通过某种哈希算法
hash()计算得到哈希值。 - 将哈希值对桶数量(数组长度)
capacity取模,从而获取该key对应的数组索引index。
index = hash(key) % capacity
随后,我们就可以利用 index 在哈希表中访问对应的桶,从而获取 value 。
设数组长度 capacity = 100、哈希算法 hash(key) = key ,易得哈希函数为 key % 100 。图 6-2 以 key 学号和 value 姓名为例,展示了哈希函数的工作原理。
代码实现
#include<stdio.h>
#include<stdlib.h>
#define MaxSize 10
#define NullKey -32768
typedef int DataType;

typedef struct HashTable {
	DataType* data;//用数组的形式储存数据
	int count;
}HashTable;

//初始化哈希表
void Init_HashTable(HashTable* H) {
	//分配空间
	H->count = 0;
	H->data = (DataType*)malloc(MaxSize * sizeof(DataType));
	//置零
	for (int i = 0; i < MaxSize; i++) {
		H->data[i] = NullKey;
	}
	printf("已初始化哈希表\n\n");
}

//定义哈希函数
int Hash(DataType key) {
	return key % MaxSize;
}

//添加键值对(key--data)
void Insert_HashTabel(DataType key, HashTable* H) {
	//取出下标地址
	int address = Hash(key);
	printf("\n插入关键字 %d, 哈希地址 = %d\n", key, address);
	if (H->data[address] == NullKey) {
		H->data[address] = key;
		//哈希表元素加一
		H->count++;
		printf("插入下标地址[%d], 插入成功!\n\n", address);
	}
	else {
		printf("插入下标地址[%d], 发生冲突!\n\n", address);
	}
}

//打印哈希表
void print_HashTable(HashTable H) {
		int i;
		printf("哈希表:\n");
		for (i = 0; i < MaxSize; i++)
		{
			printf("%d\t", i);
		}
		printf("\n");
		for (i = 0; i < MaxSize; i++)
		{
			if (H.data[i] != NullKey)
			{
				printf("%d\t", H.data[i]);
			}
			else
			{
				printf("-\t");
			}
		}
		printf("\n\n");
	}
int main()
{
	int i;
	DataType key;
	HashTable H;
	Init_HashTable(&H);
	printf("构建哈希表:");
	for (i = 0; i < MaxSize; i++)
	{
		// 参考用例: 50 81 192 33 64 75 86 97 88 109
		scanf_s("%d", &key);
		Insert_HashTabel(key, &H);
	}
	print_HashTable(H);

	while (1)
	{
		int address;
		printf("查找关键字: ");
		scanf_s("%d", &key);
		address = Hash(key);
		// 查找结果
		if (H.data[address] == key)
		{
			printf("查找成功, 目标地址 = %d\n", address);
		}
		else
		{
			printf("查找失败\n");
		}
	}
	return 0;
}
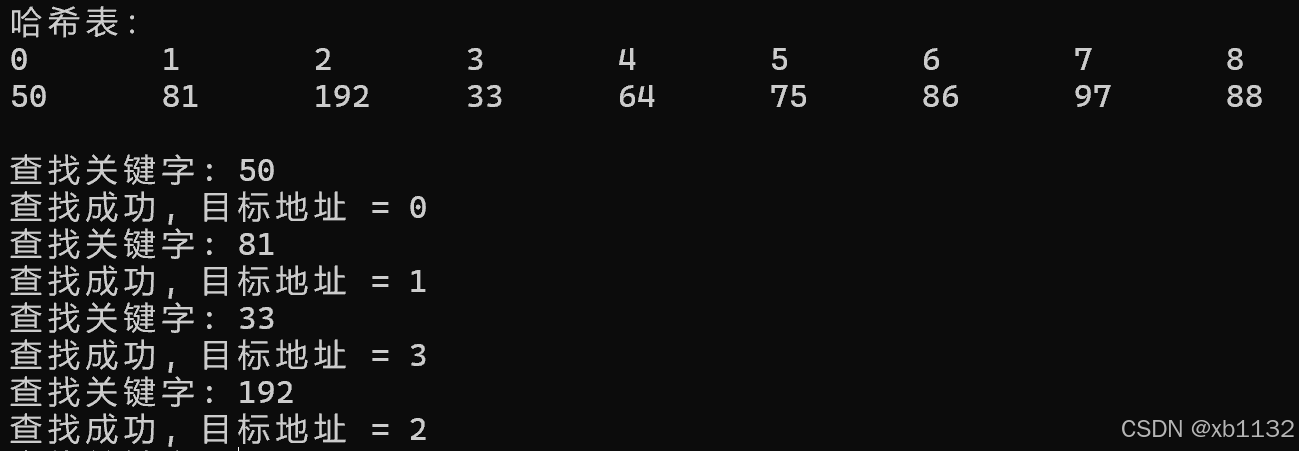
测试结果:
哈希冲突
上一节提到,通常情况下哈希函数的输入空间远大于输出空间,因此理论上哈希冲突是不可避免的。比如,输入空间为全体整数,输出空间为数组容量大小,则必然有多个整数映射至同一桶索引。
哈希冲突会导致查询结果错误,严重影响哈希表的可用性。为了解决该问题,每当遇到哈希冲突时,我们就进行哈希表扩容,直至冲突消失为止。此方法简单粗暴且有效,但效率太低,因为哈希表扩容需要进行大量的数据搬运与哈希值计算。为了提升效率,我们可以采用以下策略。
- 改良哈希表数据结构,使得哈希表可以在出现哈希冲突时正常工作。
- 仅在必要时,即当哈希冲突比较严重时,才执行扩容操作。
哈希表的结构改良方法主要包括“链式地址”和“开放寻址”。
开放地址法
开放地址法:发生冲突时,寻找下一个空的哈希地址
其中查找下一个空的哈希地址的常用方法包括【线性探测法】和【二次探测】
- 线性探测法:每次向后移动d个位置(0 < d < MaxSize - 1)
- 二次探测法:每次向后移动12、22、32… d2个位置
代码实现
#include<stdio.h>
#include<stdlib.h>
#define MaxSize 10
#define NullKey -32768
typedef int DataType;

typedef struct HashTable {
	DataType* data;//用数组的形式储存数据
	int count;
}HashTable;

//初始化哈希表
void Init_HashTable(HashTable* H) {
	//分配空间
	H->count = 0;
	H->data = (DataType*)malloc(MaxSize * sizeof(DataType));
	//置零
	for (int i = 0; i < MaxSize; i++) {
		H->data[i] = NullKey;
	}
	printf("已初始化哈希表\n\n");
}

//定义哈希函数
int Hash(DataType key) {
	return key % MaxSize;
}

//添加键值对(key--data)
void Insert_HashTabel(DataType key, HashTable* H) {
	//取出下标地址
	int address = Hash(key);
	printf("\n插入关键字 %d, 哈希地址 = %d\n", key, address);
	int d = 1;
	//如果发生冲突就寻找下一个地址
	while (H->data[address] != NullKey) {
		printf("插入下标地址[%d], 发生冲突\n", address);
		//1.线性探测法
		address = (address + d) % MaxSize;
		//2.平方探测方法
		//address=(address+d*d)%MaxSize;
		d++;
	}
	//在最终地址插入数据
	H->data[address] = key;
	printf("插入下标地址[%d], 插入成功!\n\n", address);
}

//查找关键字
int search_HashKey(HashTable H, DataType key) {
	int address = Hash(key);
	int p = address;
	//线性探测
	while (H.data[p] != key) {
		p = (p + 1) % MaxSize;
		// 指针遍历到空数据,或者指针回到原位置,则代表查找失败
		if (H.data[p] == NullKey || p == address)
		{
			return -1;
		}
	}
	return p;
}

//打印哈希表
void print_HashTable(HashTable H) {
		int i;
		printf("哈希表:\n");
		for (i = 0; i < MaxSize; i++)
		{
			printf("%d\t", i);
		}
		printf("\n");
		for (i = 0; i < MaxSize; i++)
		{
			if (H.data[i] != NullKey)
			{
				printf("%d\t", H.data[i]);
			}
			else
			{
				printf("-\t");
			}
		}
		printf("\n\n");
	}
int main()
{
	int i = 0;
	DataType key;
	HashTable H;
	Init_HashTable(&H);
	printf("构建哈希表:");
	for (i = 0; i < MaxSize; i++)
	{
		// 参考用例: 50 81 191 32 65 75 9 97 88 109
		scanf_s("%d", &key);
		Insert_HashTabel(key, &H);
	}
	print_HashTable(H);

	while (1)
	{
		int address;
		printf("查找关键字: ");
		scanf_s("%d", &key);
		// 查找关键字地址
		address = search_HashKey(H, key);
		if (address != -1)
		{
			printf("查找成功, 目标地址 = %d\n", address);
		}
		else
		{
			printf("查找失败\n");
		}
	}
	return 0;
}
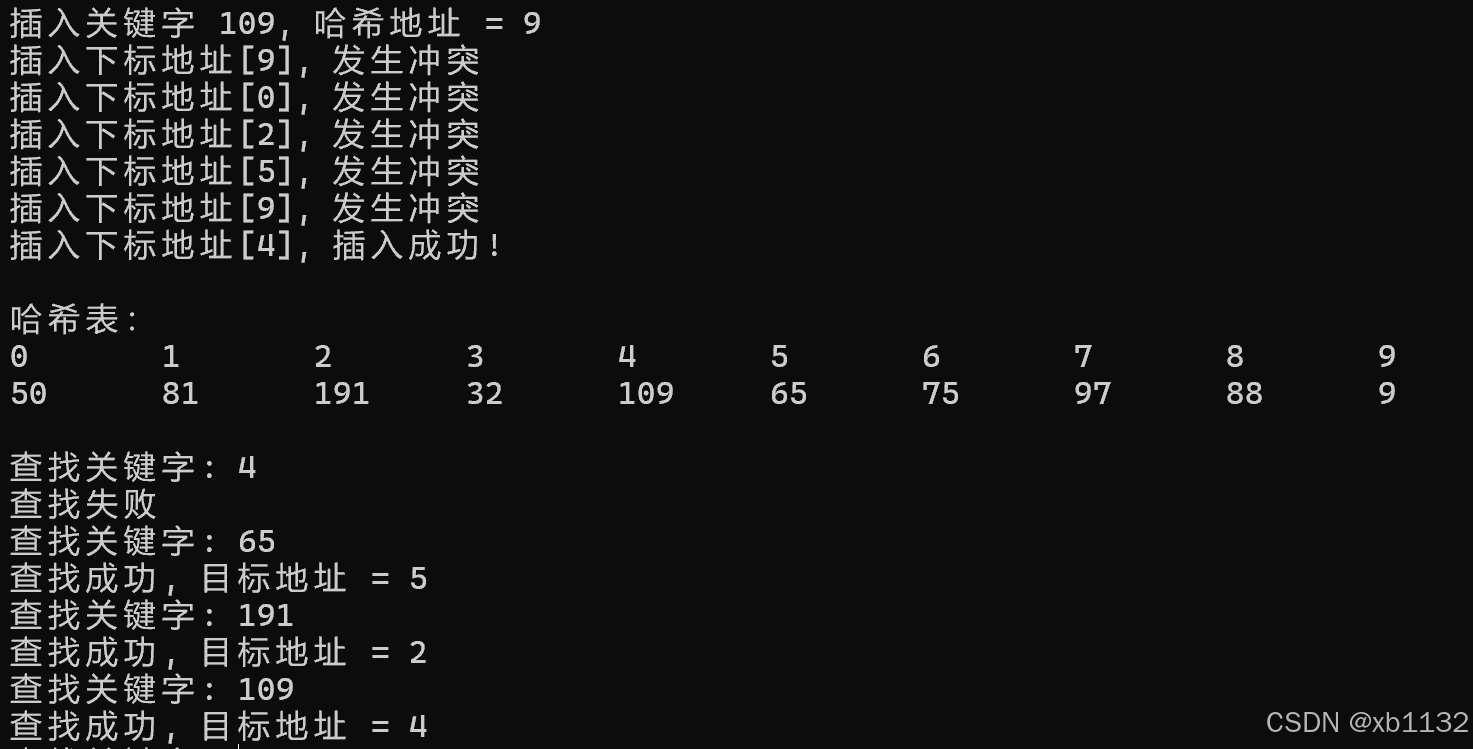
测试结果:
拉链法
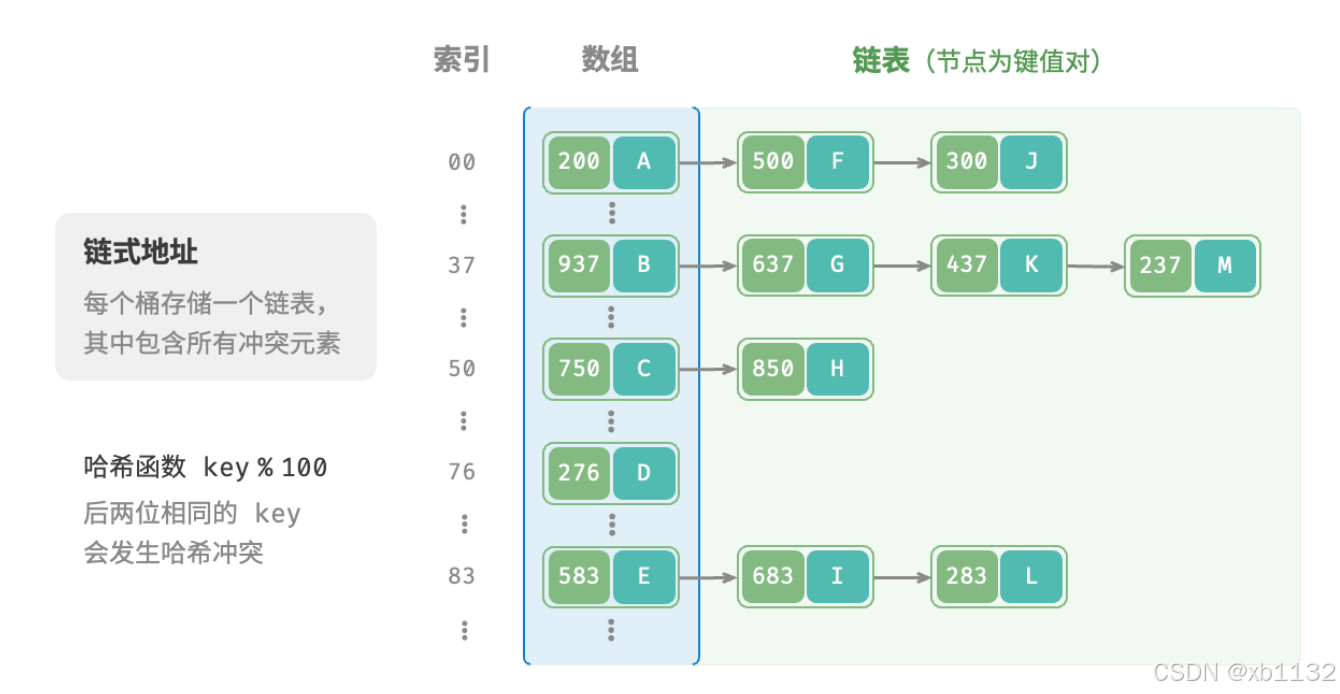
在原始哈希表中,每个桶仅能存储一个键值对。链式地址(separate chaining)将单个元素转换为链表,将键值对作为链表节点,将所有发生冲突的键值对都存储在同一链表中。下图展示了一个链式地址哈希表的例子。
#include <stdio.h>
#include <stdlib.h>
#define MaxSize 10
#define NullKey -32768

typedef int DataType;
// 链表结点
typedef struct LNode
{
    DataType data;
    struct LNode *next;
}LNode, *LinkList;
// 哈希表
typedef struct hashTable
{
    LinkList list;
    int count;
}hashTable;

// 初始化哈希表
void InitHashTable(hashTable *H)
{
    // 分配多个链表头结点空间
    H->list = (LNode *)malloc(MaxSize * sizeof(LNode));
    H->count = 0;

    // 初始化链表头结点(头结点存储初始值,链表后序结点存储冲突值)
    int i;
    for (i = 0; i < MaxSize; i++)
    {
        H->list[i].data = NullKey;
        H->list[i].next = NULL;
    }
    printf("已初始化哈希表!\n");
}

// 定义哈希函数
int Hash(DataType key)
{
    //  除留余数法
    return key % MaxSize;
}

// 插入关键字
void InsertHashKey(hashTable *H, DataType key)
{
    // 根据哈希函数得到下标地址
    int address = Hash(key);
    printf("\n插入关键字 %d, 哈希地址 = %d\n", key, address);

    if(H->list[address].data == NullKey)
    {
        // 若未发生冲突,则直接赋值给头结点
        H->list[address].data = key;
        printf("插入下标地址[%d], 插入成功!\n\n", address);
    }
    else
    {
        // 若发生冲突,则在该头结点的链表下进行头插
        // 创建新结点
        LNode *s;
        s = (LNode *)malloc(sizeof(LNode));
        s->data = key;
        // 头插法插入
        s->next = H->list[address].next;
        H->list[address].next = s;

        printf("插入下标地址[%d], 发生冲突! 已插入该地址的链表下\n\n", address);
    }
    H->count++;
}

// 查找关键字
LNode* SearchHashKey(hashTable H, DataType key)
{
    int address = Hash(key);
    // 根据哈希地址获取对应链表的头结点
    LNode *p = &H.list[address];
    // 在链表中查找关键字
    while (p != NULL && p->data != key)
    {
        // 线性探测
        p = p->next;
    }
    return p;
}

void DisplayHashTable(hashTable H)
{
    int i;
    printf("哈希表:\n**********************************\n");
    for (i = 0; i < MaxSize; i++)
    {
        printf("%d\t", i);
    }
    printf("\n");

    LNode *p;
    int j, k = 0, flag = 1;

    while (flag)
    {
        flag = 0;
        for (i = 0; i < MaxSize; i++)
        {
            j = 0;
            p = &H.list[i];
            while (j < k && p)
            {
                p = p->next;
                j++;
            }
            if (p && p->data != NullKey)
            {
                printf("%d\t", p->data);
                flag = 1;
            }
            else
            {
                printf(" \t");
            }
        }
        k++;
        printf("\n");
    }
    printf("*********************************\n");
}

int main()
{
    int i;
    DataType key;
    hashTable H;
    InitHashTable(&H);
    printf("构建哈希表:");
    for (i = 0; i < MaxSize; i++)
    {
        // 参考用例: 50 81 191 32 65 75 9 97 88 109
        scanf("%d", &key);
        InsertHashKey(&H, key);
    }
    DisplayHashTable(H);

    while (1)
    {
        LNode *result;
        printf("查找关键字: ");
        scanf("%d", &key);
        // 查找关键字地址
        result = SearchHashKey(H, key);
        if (result != NULL)
        {
            printf("查找成功, 目标地址 = %x\n", result);
        }
        else
        {
            printf("查找失败\n");
        }
    }
    return 0;
}
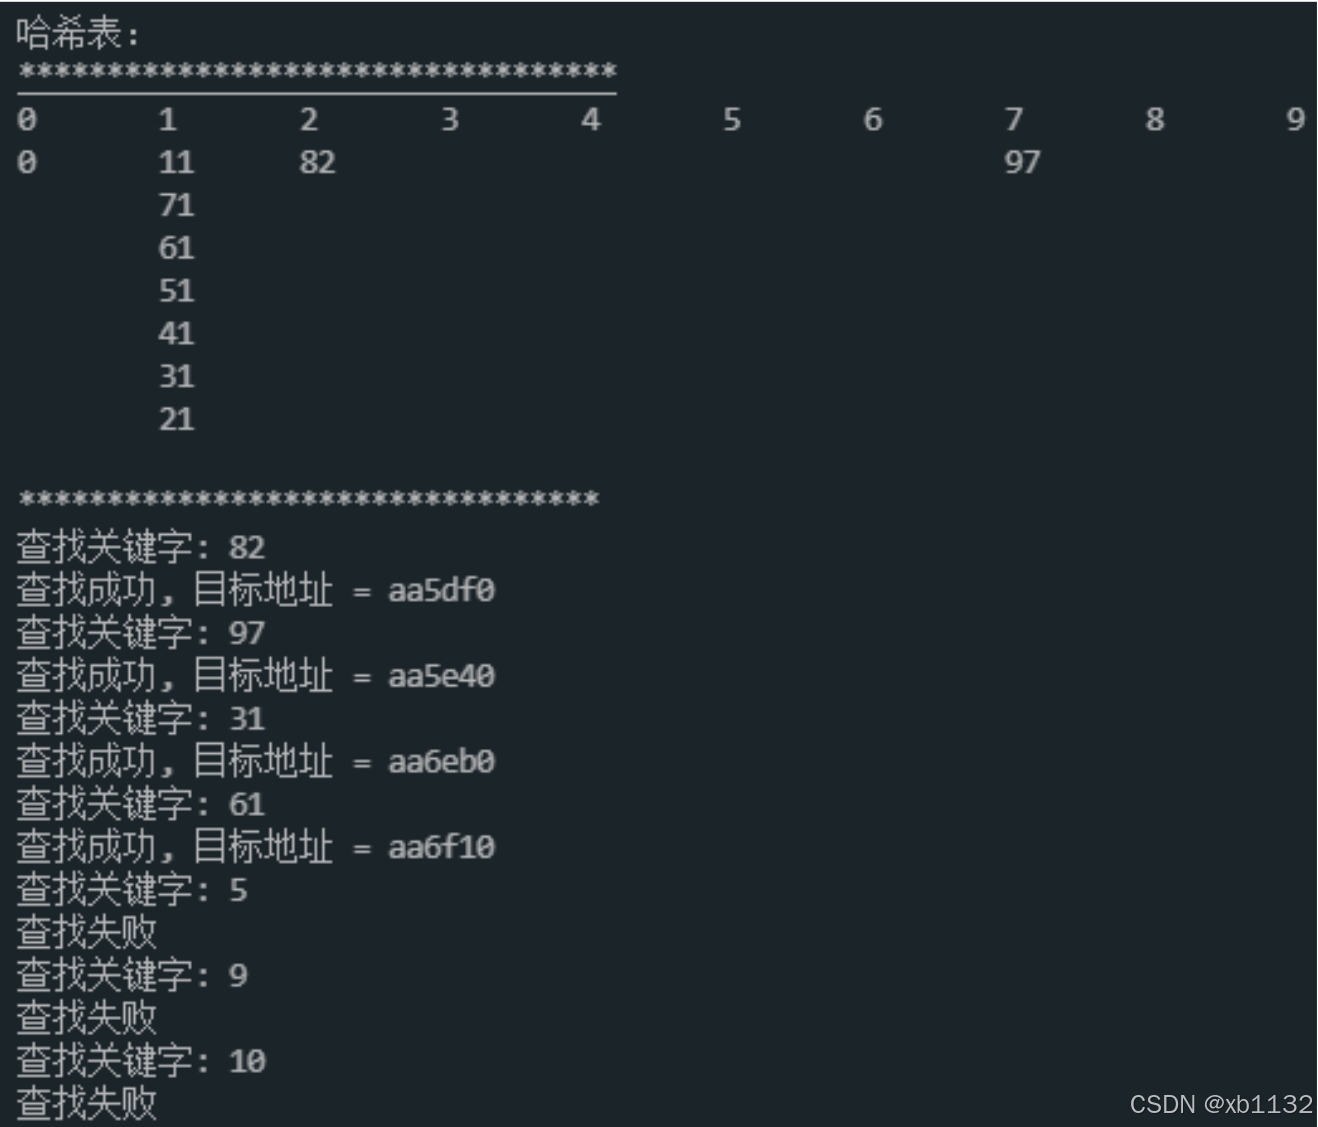
测试结果:
多次哈希
顾名思义,多次哈希方法使用多个哈希函数 f1(x)、f2(x)、f3(x)、… 进行探测。
- 插入元素:若哈希函数 f1(x) 出现冲突,则尝试 f2(x) ,以此类推,直到找到空位后插入元素。
- 查找元素:在相同的哈希函数顺序下进行查找,直到找到目标元素时返回;若遇到空位或已尝试所有哈希函数,说明哈希表中不存在该元素,则返回
None。
与线性探测相比,多次哈希方法不易产生聚集,但多个哈希函数会带来额外的计算量。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献1条内容

所有评论(0)