C++高阶数据结构 -- 《 图 》
图的基本概念
- 图是由顶点集合及顶点间的关系组成的一种数据结构:G = (V, E),其中:
- 顶点集合V = {x|x属于某个数据对象集}是有穷非空集合;
- E = {(x,y)|x,y属于V}或者E = {<x, y>|x,y属于V && Path(x, y)}是顶点间关系的有穷集合,也叫做边的集合。
- (x, y)表示x到y的一条双向通路,即(x, y)是无方向的;Path(x, y)表示从x到y的一条单向通路,即Path(x, y)是有方向的。
- 顶点和边:图中结点称为顶点,第i个顶点记作vi。两个顶点vi和vj相关联称作顶点vi和顶点vj之间有一条边,图中的第k条边记作ek,ek = (vi,vj)或<vi,vj>。
- 有向图和无向图:在有向图中,顶点对<x, y>是有序的,顶点对<x,y>称为顶点x到顶点y的一条边(弧),<x, y>和<y, x>是两条不同的边,比如下图G3和G4为有向图。在无向图中,顶点对(x, y)是无序的,顶点对(x,y)称为顶点x和顶点y相关联的一条边,这条边没有特定方向,(x, y)和(y,x)是同一条边,比如下图G1和G2为无向图。注意:无向边(x, y)等于有向边<x, y>和<y, x>。
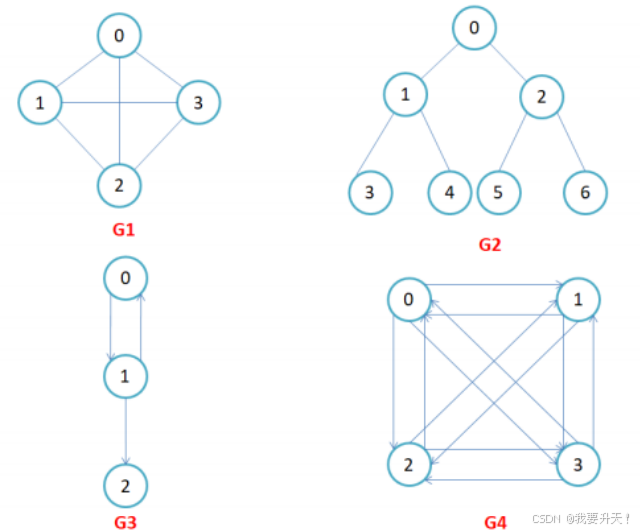
- 完全图:在有n个顶点的无向图中,若有n * (n-1)/2条边(本质上,可以使用等差数列来计算),即任意两个顶点之间有且仅有一条边,则称此图为无向完全图,比如上图G1;在n个顶点的有向图中,若有n * (n-1)条边,即任意两个顶点之间有且仅有方向相反的边,则称此图为有向完全图,比如上图G4。
总结:任意两个顶点都直接相连,完全图也是最稠密的图。
- 邻接顶点:在无向图中G中,若(u, v)是E(G)中的一条边,则称u和v互为邻接顶点,并称边(u,v)依附于顶点u和v;在有向图G中,若<u, v>是E(G)中的一条边,则称顶点u邻接到v,顶点v邻接自顶点u,并称边<u, v>与顶点u和顶点v相关联。
- 顶点的度: 顶点v的度是指与它相关联的边的条数,记作deg(v)。在有向图中,顶点的度等于该顶点的入度与出度之和,其中顶点v的入度是以v为终点的有向边的条数,记作indev(v);顶点v的出度是以v为起始点的有向边的条数,记作outdev(v)。因此:dev(v) = indev(v) + outdev(v)。注意:对于无向图,顶点的度等于该顶点的入度和出度,即dev(v) = indev(v) = outdev(v)。
- 路径:在图G = (V, E)中,若从顶点vi出发有一组边使其可到达顶点vj,则称顶点vi到顶点vj的顶点序列为从顶点vi到顶点vj的路径(该路径可以有多条)。
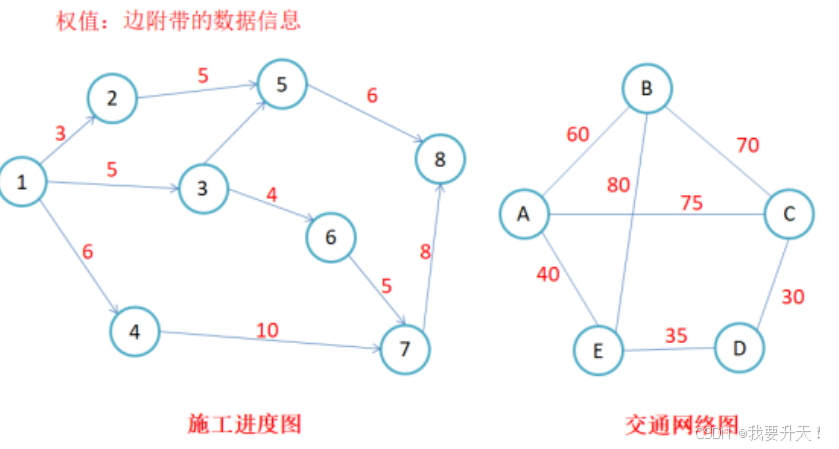
- 路径长度:对于不带权的图,一条路径的路径长度是指该路径上的边的条数;对于带权的图,一条路径的路径长度是指该路径上各个边权值的总和。
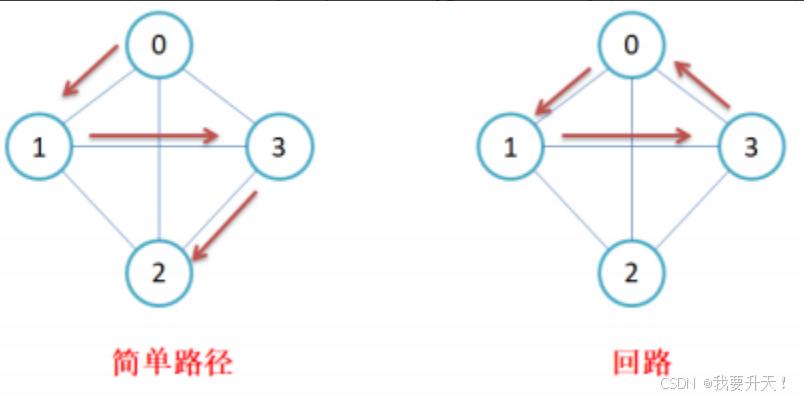
- 简单路径与回路:若路径上各顶点v1,v2,v3,…,vm均不重复,则称这样的路径为简单路径。若路径上第一个顶点v1和最后一个顶点vm重合,则称这样的路径为回路或环。
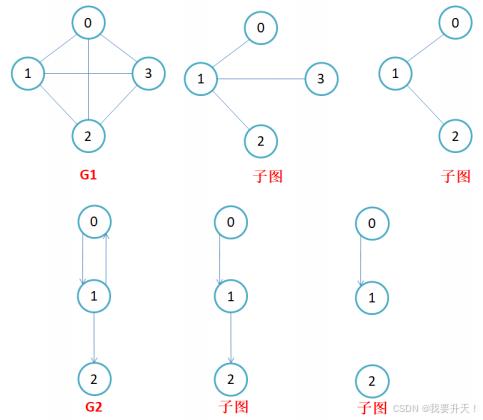
- 子图:设图G = {V, E}和图G1 = {V1,E1},若V1属于V且E1属于E,则称G1是G的子图。(顶点和边都是原图的一部分)
- 连通图:在无向图中,若从顶点v1到顶点v2有路径,则称顶点v1与顶点v2是连通的。如果图中任意一对顶点都是连通的,则称此图为连通图。
- 强连通图:在有向图中,若在每一对顶点vi和vj之间都存在一条从vi到vj的路径,也存在一条从vj到vi的路径,则称此图是强连通图。
- 生成树:在无向图中,一个连通图的最小连通子图称作该图的生成树。有n个顶点的连通图的生成树有n个顶点和n-1条边。
树和图的差异
1.树是一种特殊的(无环连通)图,图不一定是树
2.树关注的是节点(顶点)中存的值,图关注的是顶点及边的权值
3.树是存储某一种值,图是表示型的数据结构,表示某种场景
图的存储结构
- 因为图中既有节点,又有边(节点与节点之间的关系),因此,在图的存储中,只需要保存:节点和边关系即可。节点保存比较简单,只需要一段连续空间即可,那边关系该怎么保存呢?
邻接矩阵
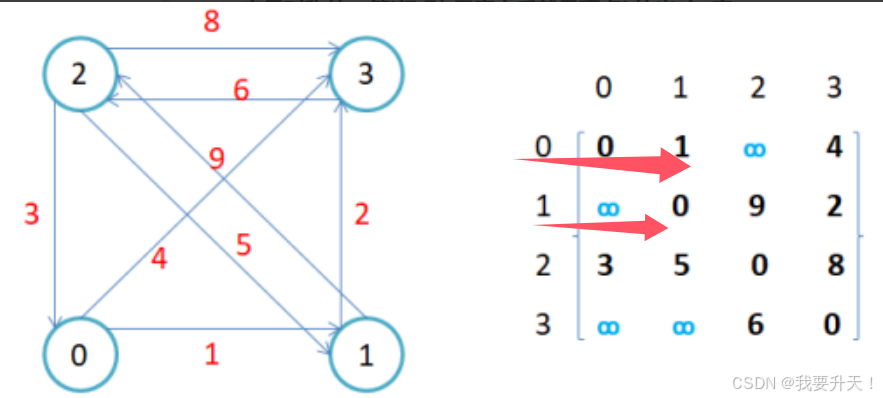
- 因为节点与节点之间的关系就是连通与否,即为0或者1,因此邻接矩阵(二维数组)即是:先用一个数组将定点保存,然后采用矩阵来表示节点与节点之间的关系。
注意:
- 无向图的邻接矩阵是对称的,第i行(列)元素之和,就是顶点i的度。有向图的邻接矩阵则不一定是对称的,第i行(列)元素之后就是顶点i 的出(入)度。
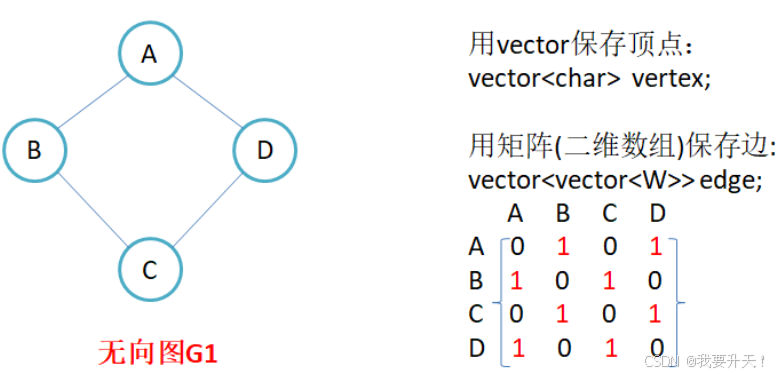
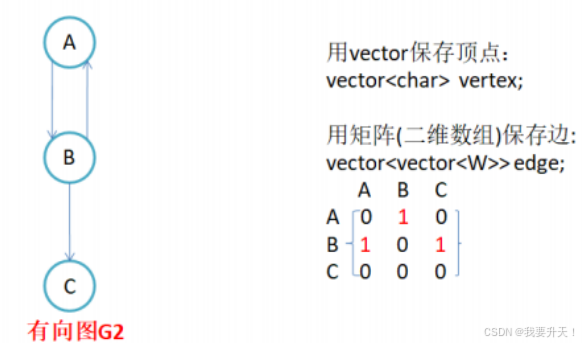
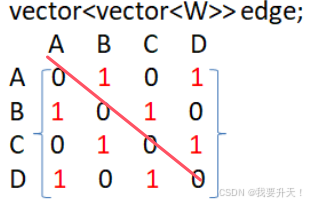
2 .如果边带有权值,并且两个节点之间是连通的,上图中的边的关系就用权值代替,如果两个顶点不通,则使用无穷大代替。
3.用邻接矩阵存储图的有点是能够快速知道两个顶点是否连通,缺陷是如果顶点比较多,边比较少时,矩阵中存储了大量的0成为系数矩阵,比较浪费空间,并且要求两个节点之间的路
径不是很好求。总结: 领阶矩阵优缺点
优点:领阶矩阵存储方式非常适合稠密图(边多边少都可以表示),O(1)的时间判断两个顶点的是否有连接关系,并取到权值。
缺点:不适合查找一个顶点所连接的边,O(N)的时间复杂度。(N指的是顶点的数量)
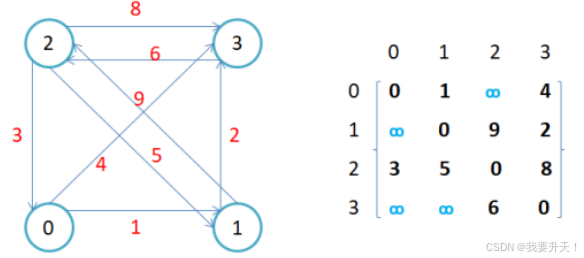
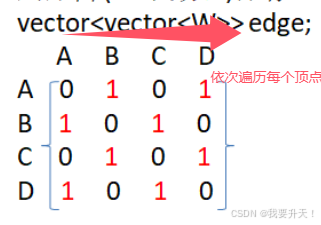
图使用领接矩阵来实现
1.我们可以实现成模板
2.类的成员变量
3.类的构造函数

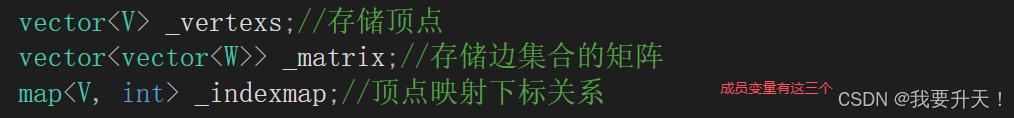
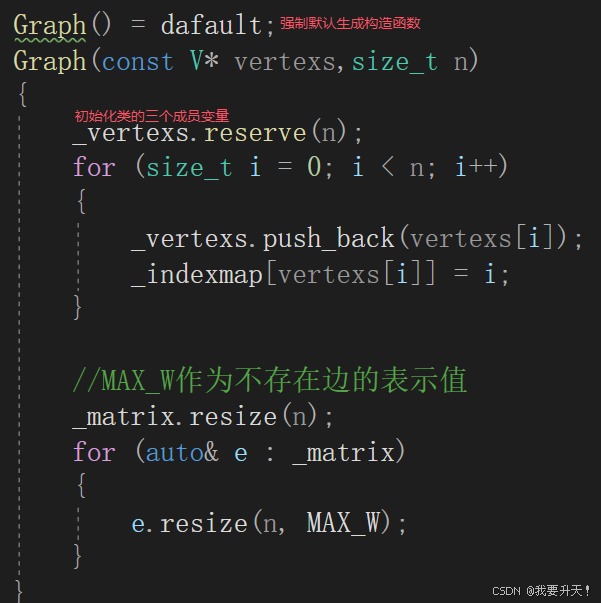
使用领阶矩阵
namespace Matrix
{
	template<class V,class W,W MAX_W = INT_MAX,bool Direction = false>
	class Graph
	{
	public:
		Graph() = default;
		Graph(const V* vertexs, size_t n)
		{
			_vertexs.reserve(n);
			for (int i = 0; i < n; i++)
			{
				_vertexs.push_back(vertexs[i]);
				_indexMap[vertexs[i]] = i;
			}

			_matrix.resize(n);
			for (auto& e : _matrix)
			{
				e.resize(n, MAX_W);
			}
		}

		size_t GetIndexMap(const V& v)
		{
			auto ret = _indexMap.find(v);
			if (ret != _indexMap.end())
			{
				return ret->second;
			}
			else
			{
				throw invalid_argument("未知顶点");
				return -1;
			}
		}
		void AddEdge(const V& src, const V& dest, const W& w)
		{
			size_t srci = GetIndexMap(src);
			size_t desti = GetIndexMap(dest);

			_matrix[srci][desti] = w;
			if (Direction == false)
			{
				_matrix[desti][srci] = w;
			}
		}

		void _DFS(size_t srci, vector<bool>& visited)
		{
			cout << _vertexs[srci] << ":" << srci << endl;
			visited[srci] = true;
			for (int i = 0; i < _vertexs.size(); i++)
			{
				if (_matrix[srci][i] != MAX_W && visited[i] == false)
				{
					_DFS(i, visited);
				}
			}
		}
		void DFS(const V& src)
		{
			vector<bool> visited(_vertexs.size(), false);
			size_t srci = GetIndexMap(src);
			_DFS(srci, visited);
		}
	/*	void BFS(const V& src)
		{
			vector<bool> visited(_vertexs.size(), false);
			size_t srci = GetIndexMap(src);
			queue<int> q;
			q.push(srci);
			visited[srci] = true;
			while (!q.empty())
			{
				int front = q.front();
				q.pop();
				cout << _vertexs[front] << ":" << front;
				for (int i = 0; i < _vertexs.size(); i++)
				{
					if (_matrix[front][i] != MAX_W && visited[i] == false)
					{
						q.push(i);
						visited[i] = true;
					}
				}
				cout << endl;
			}
		}*/

		void BFS(const V& src)
		{
			vector<bool> visited(_vertexs.size(), false);
			size_t srci = GetIndexMap(src);
			queue<int> q;
			q.push(srci);
			visited[srci] = true;
			size_t levesize = 1;
			while (!q.empty())
			{
			//一层一层的出
				for (size_t j = 0; j < levesize; j++)
				{
					int front = q.front();
					q.pop();
					cout << _vertexs[front] << ":" << front << endl;
					for (int i = 0; i < _vertexs.size(); i++)
					{
						if (_matrix[front][i] != MAX_W && visited[i] == false)
						{
							q.push(i);
							visited[i] = true;
						}
					}
				}
				levesize = q.size();
				cout << endl;
			}
		}
		void Print()
		{
			//顶点
			for (int i = 0; i < _vertexs.size(); i++)
			{
				cout << "[" << i << "]" << ":" << _vertexs[i] << endl;
			}
			cout << endl;
			cout << "  ";
			for (int i = 0; i < _vertexs.size(); i++)
			{
				cout << i << " ";
			}
			cout << endl;
			for (int i = 0; i < _vertexs.size(); i++)
			{
				cout << i << " ";
				for (int j = 0; j < _vertexs.size(); j++)
				{
					if (_matrix[i][j] != MAX_W)
						cout << _matrix[i][j] << " ";
					else
						cout << "* ";
				}
				cout << endl;
			}
		}
	private:
		vector<V> _vertexs;//顶点
		vector<vector<W>> _matrix;//矩阵
		map<V, int> _indexMap;//顶点映射下标
	};
	void TestGraph1()
	{
		Graph<char, int, INT_MAX, true> g("0123", 4);
		g.AddEdge('0', '1', 1);
		g.AddEdge('0', '3', 4);
		g.AddEdge('1', '3', 2);
		g.AddEdge('1', '2', 9);
		g.AddEdge('2', '3', 8);
		g.AddEdge('2', '1', 5);
		g.AddEdge('2', '0', 3);
		g.AddEdge('3', '2', 6);

		g.Print();
	}

	void TestBDFS()
	{
		string a[] = { "张三", "李四", "王五", "赵六", "周七" };
		Graph<string, int> g1(a, sizeof(a) / sizeof(string));
		g1.AddEdge("张三", "李四", 100);
		g1.AddEdge("张三", "王五", 200);
		g1.AddEdge("王五", "赵六", 30);
		g1.AddEdge("王五", "周七", 30);
		g1.Print();

		g1.BFS("张三");
		//g1.DFS("张三");
	}
}
邻接表
- 邻接表:使用数组表示顶点的集合,使用链表表示边的关系。
- 无向图邻接表存储
注意:无向图中同一条边在邻接表中出现了两次。如果想知道顶点vi的度,只需要知道顶点vi边链表集合中结点的数目即可
2.有向图邻接表存储一般情况下,有向图存储一个出边表即可。
注意:有向图中每条边在邻接表中只出现一次,与顶点vi对应的邻接表所含结点的个数,就是该顶点的出度,也称出度表,要得到vi顶点的入度,必须检测其他所有顶点对应的边链表,看有多少边顶点的dst取值是i。
- 邻接表优缺点总结:
- 优点:适合存储稀疏图,适合查找一个顶点连接出去的所有边(遍历链表就可以了),时间复杂度是O(n),n是边的数量。
- 缺点:不适合确定两个顶点是否相连,以及权值(需要遍历,如果是领阶矩阵,直接使用下标就可以确定了)。
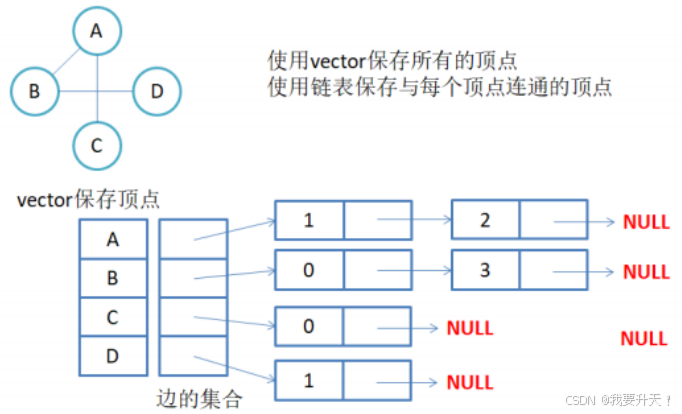
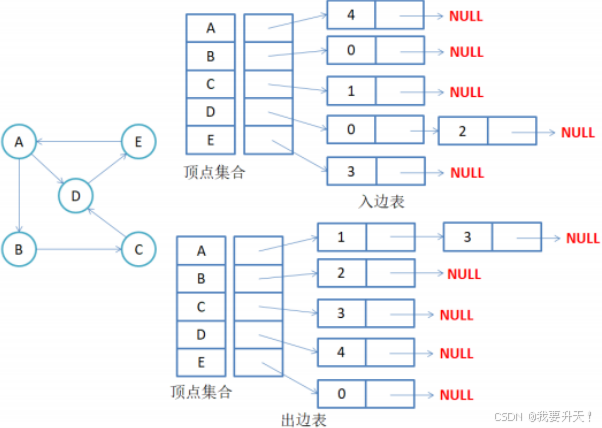
领阶矩阵和邻接表相辅相成,各有各的优缺点,是互补的结构!!!
使用邻接表
namespace Link_Table
{
	template<class W>
	struct Edge
	{
		int desti;
		W _w;
		Edge<W>* _next;
		Edge(size_t dest,const W& w)
			:desti(dest)
			,_w(w)
			,_next(nullptr)
		{}
	};

	template<class V, class W, W MAX_W = INT_MAX, bool Direction = false>
	class Graph
	{
	public:
		typedef Edge<W> Edge;
		Graph() = default;
		Graph(const V* vertexs, size_t n)
		{
			_vertexs.reserve(n);
			for (int i = 0; i < n; i++)
			{
				_vertexs.push_back(vertexs[i]);
				_indexMap[vertexs[i]] = i;
			}

			_linkTable.resize(n, nullptr);
		}

		size_t GetIndexMap(const V& v)
		{
			auto ret = _indexMap.find(v);
			if (ret != _indexMap.end())
			{
				return ret->second;
			}
			else
			{
				throw invalid_argument("未知顶点");
				return -1;
			}
		}
		void AddEdge(const V& src, const V& dest, const W& w)
		{
			size_t srci = GetIndexMap(src);
			size_t desti = GetIndexMap(dest);

			Edge* ptr = new Edge(desti, w);
			ptr->_next = _linkTable[srci];
			_linkTable[srci] = ptr;
			if (Direction == true)
			{
				Edge* ptr = new Edge(srci, w);
				ptr->_next = _linkTable[desti];
				_linkTable[desti] = ptr;
			}
		}

	void _DFS(size_t srci, vector<bool>& visited)
{
	cout << _vertexs[srci] << ":" << srci << endl;
	visited[srci] = true;
	Edge* ptr = _linkTable[srci];
	while (ptr)
	{
		if (visited[ptr->desti] == false)
			_DFS(ptr->desti, visited);
		ptr = ptr->_next;
	}
}
void DFS(const V& src)
{
	vector<bool> visited(_vertexs.size(), false);
	size_t srci = GetIndexMap(src);
	_DFS(srci, visited);
}
void BFS(const V& src)
{
	vector<bool> visited(_vertexs.size(), false);
	size_t srci = GetIndexMap(src);
	queue<int> q;
	q.push(srci);
	visited[srci] = true;
	size_t levesize = 1;
	while (!q.empty())
	{
		for (size_t j = 0; j < levesize; j++)
		{
			int front = q.front();
			q.pop();
			cout << _vertexs[front] << ":" << front << endl;
			Edge* ptr = _linkTable[front];
			while (ptr)
			{
				if (visited[ptr->desti] == false)
				{
					q.push(ptr->desti);
					visited[ptr->desti] = true;
				}
				ptr = ptr->_next;
			}
		}
		levesize = q.size();
		cout << endl;
	}
}
		void Print()
		{
			//顶点
			for (int i = 0; i < _vertexs.size(); i++)
			{
				cout << "[" << i << "]" << ":" << _vertexs[i] << endl;
			}
			cout << endl;

			for (int i = 0; i < _vertexs.size(); i++)
			{
				cout << _vertexs[i] << ":" << i << "->";
				Edge* cur = _linkTable[i];
				while (cur)
				{
					cout << "[" << _vertexs[cur->desti] << "]" << cur->_w << "->";
					cur = cur->_next;
				}
				cout << endl;
			}
		}
	private:
		vector<V> _vertexs;//顶点
		map<V, int> _indexMap;//顶点映射下标
		vector<Edge*> _linkTable;
	};

	void TestBDFS()
	{
		string a[] = { "张三", "李四", "王五", "赵六", "周七" };
		Graph<string, int> g1(a, sizeof(a) / sizeof(string));
		g1.AddEdge("张三", "李四", 100);
		g1.AddEdge("张三", "王五", 200);
		g1.AddEdge("王五", "赵六", 30);
		g1.AddEdge("王五", "周七", 30);
		g1.Print();

		//g1.BFS("张三");
		//g1.DFS("张三");
	}
}
图的遍历
图的深度优先遍历
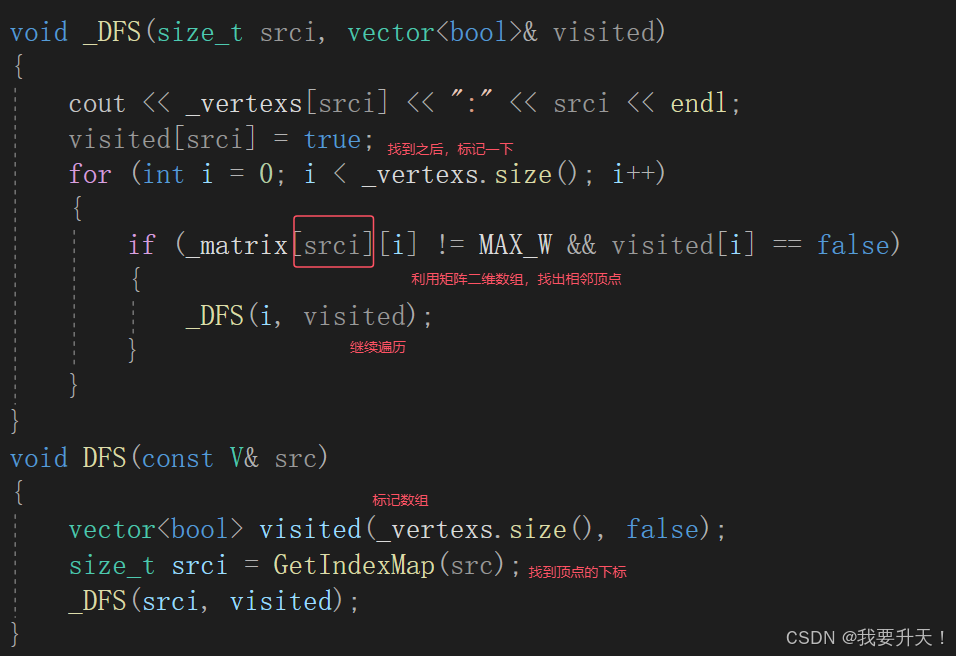
思路:总的思想是需要递归。以第一个节点开始遍历连接顶点,再从连接顶点开始递归,遇到遍历过的顶点,使用标记数组标记一下就可以了。
void _DFS(size_t srci, vector<bool>& visited)
{
	cout << _vertexs[srci] << ":" << srci << endl;
	visited[srci] = true;
	for (int i = 0; i < _vertexs.size(); i++)
	{
		if (_matrix[srci][i] != MAX_W && visited[i] == false)
		{
			_DFS(i, visited);
		}
	}
}
void DFS(const V& src)
{
	vector<bool> visited(_vertexs.size(), false);
	size_t srci = GetIndexMap(src);
	_DFS(srci, visited);
}
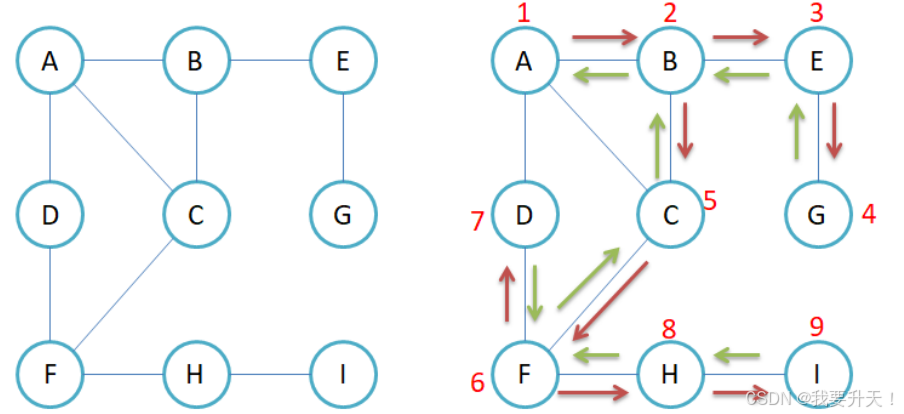
注意:这里是一层一层的遍历,假如第一个顶点是0,就先遍历0,然后从0开始,找连接顶点。由图可得,第二个顶点是1。就继续遍历1顶点,再从1顶点开始遍历,找连接顶点找到2,以此类推…
图的广度优先遍历
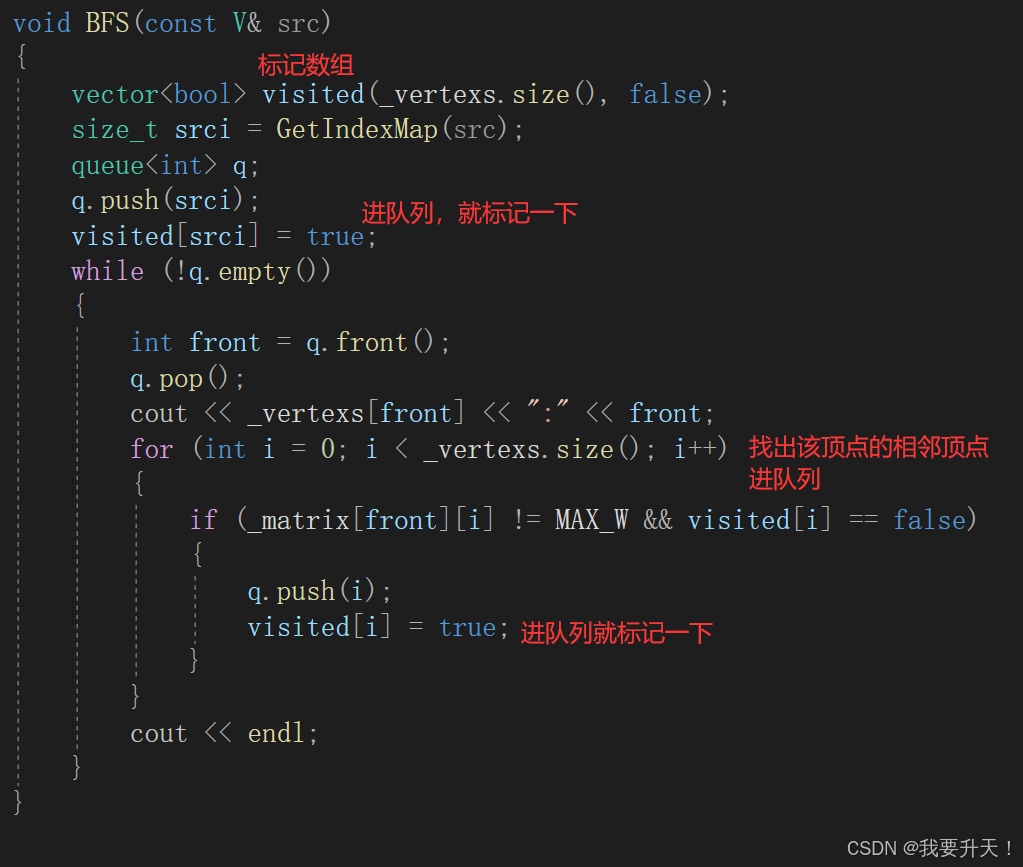
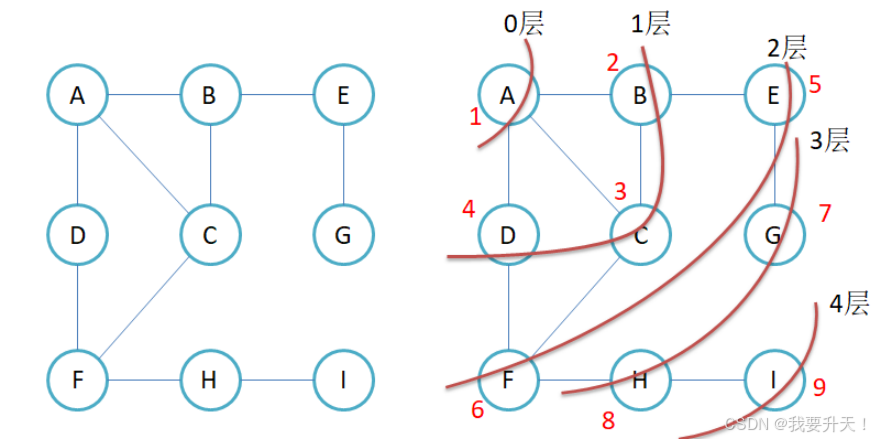
思路:使用队列,一层一层的遍历,要到遍历过的数组就标记一下。先把第一个顶点入队列,然后开始遍历该顶点的连接顶点,如果还没有被标记过,就直接入队列,以此类推。
	void BFS(const V& src)
	{
		vector<bool> visited(_vertexs.size(), false);
		size_t srci = GetIndexMap(src);
		queue<int> q;
		q.push(srci);
		visited[srci] = true;
		while (!q.empty())
		{
			int front = q.front();
			q.pop();
			cout << _vertexs[front] << ":" << front;
			for (int i = 0; i < _vertexs.size(); i++)
			{
				if (_matrix[front][i] != MAX_W && visited[i] == false)
				{
					q.push(i);
					visited[i] = true;
				}
			}
			cout << endl;
		}
	}
注意:假如第一个顶点是A,那么A进队列,出队列时,把相邻顶点B,C,D(使用循环遍历矩阵)进队列,再依次出队列。出队列时,把相邻顶点入队列,每次入队列都需要标记一下。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)